从零搭一个抖音竞品监控 Agent
端到端教程:搭一个每天自动跟踪竞品抖音账号、检测新视频、生成分析简报的 Agent,每天约 30 次数据调用。
先说结论 — 一个完整的 Python agent,每天监控最多 10 个竞品抖音账号:在每个账号的作品第一页里检测新视频、追踪粉丝变化、用 LLM 生成竞品简报。用量:每天最多约 30 次抖音数据 API 调用(截至 2026-10-01,用到的三个端点在 SandBase 目录里都标为 Free),外加 1 次 LLM 调用,按 token 数估算每天几美分。完整代码在下面,cron 或任何调度器都能跑。
每天早上人工刷 10 个竞品抖音账号、记笔记、写总结?一个月你花 15 小时做这件事。这个 agent 用 SandBase 上的抖音数据 API,每天约 30 次数据调用加 1 次 LLM 调用,7 点按计划自动跑。
Agent 做什么
每天早 7 点:
- 拉每个竞品的用户资料(粉丝数、简介)
- 拉他们作品列表的第一页(请求
count=20) - 和昨天的快照对比,找出新发的视频
- 对新视频批量拉播放量(一次调用)
- 全部数据喂给 LLM 分析
- 把简报写成 Markdown 文件(想推 Slack 或发邮件可以自己接)
需要什么
- SandBase API Key(数据和 LLM 都用同一把):获取 SandBase API Key
- Python 3.10+
requests和openai包(pip install requests openai)
本文只用公开、只读的抖音数据,需要 SandBase API Key,不代表与抖音有官方合作;看不到私密账号、私信、仅账号主可见的数据分析,也不能发布内容或操作任何账号。如果你要处理自有或已授权账号的数据,走抖音官方开放平台的授权流程。
| SandBase 公开数据端点 | 抖音开放平台 | |
|---|---|---|
| 数据范围 | 公开、只读数据(主页、视频、计数) | 已授权你应用的账号的数据 |
| 鉴权 | 一个 SandBase API Key(Bearer) | 开发者注册并创建应用,账号数据还需用户授权 |
| 操作 | 无,只读 | 针对已授权账号的账号关联操作,以平台文档为准 |
| 适用场景 | 监控公开的竞品账号,即本教程 | 处理自有账号或已授权你应用的账号 |
代码通过 SandBase 的 Model API 路由调用三个端点:POST https://api.sandbase.ai/v1/api/<vendor>/<path>,JSON body 里只放该端点自己的参数(抖音目录页截至 2026-10-01 列出 262 个端点,展示的是另一套 GET /apis/v1/... 路径,本教程不用它):
douyin/app-v3/user-profile(sec_user_id)douyin/app-v3/user-post-videos(sec_user_id、max_cursor、count,最大 20)douyin/app-v3/multi-video-statistics(aweme_ids,逗号分隔,最多 50 个)
端点总数和这些条目的 Free 状态可以直接在目录页看到:
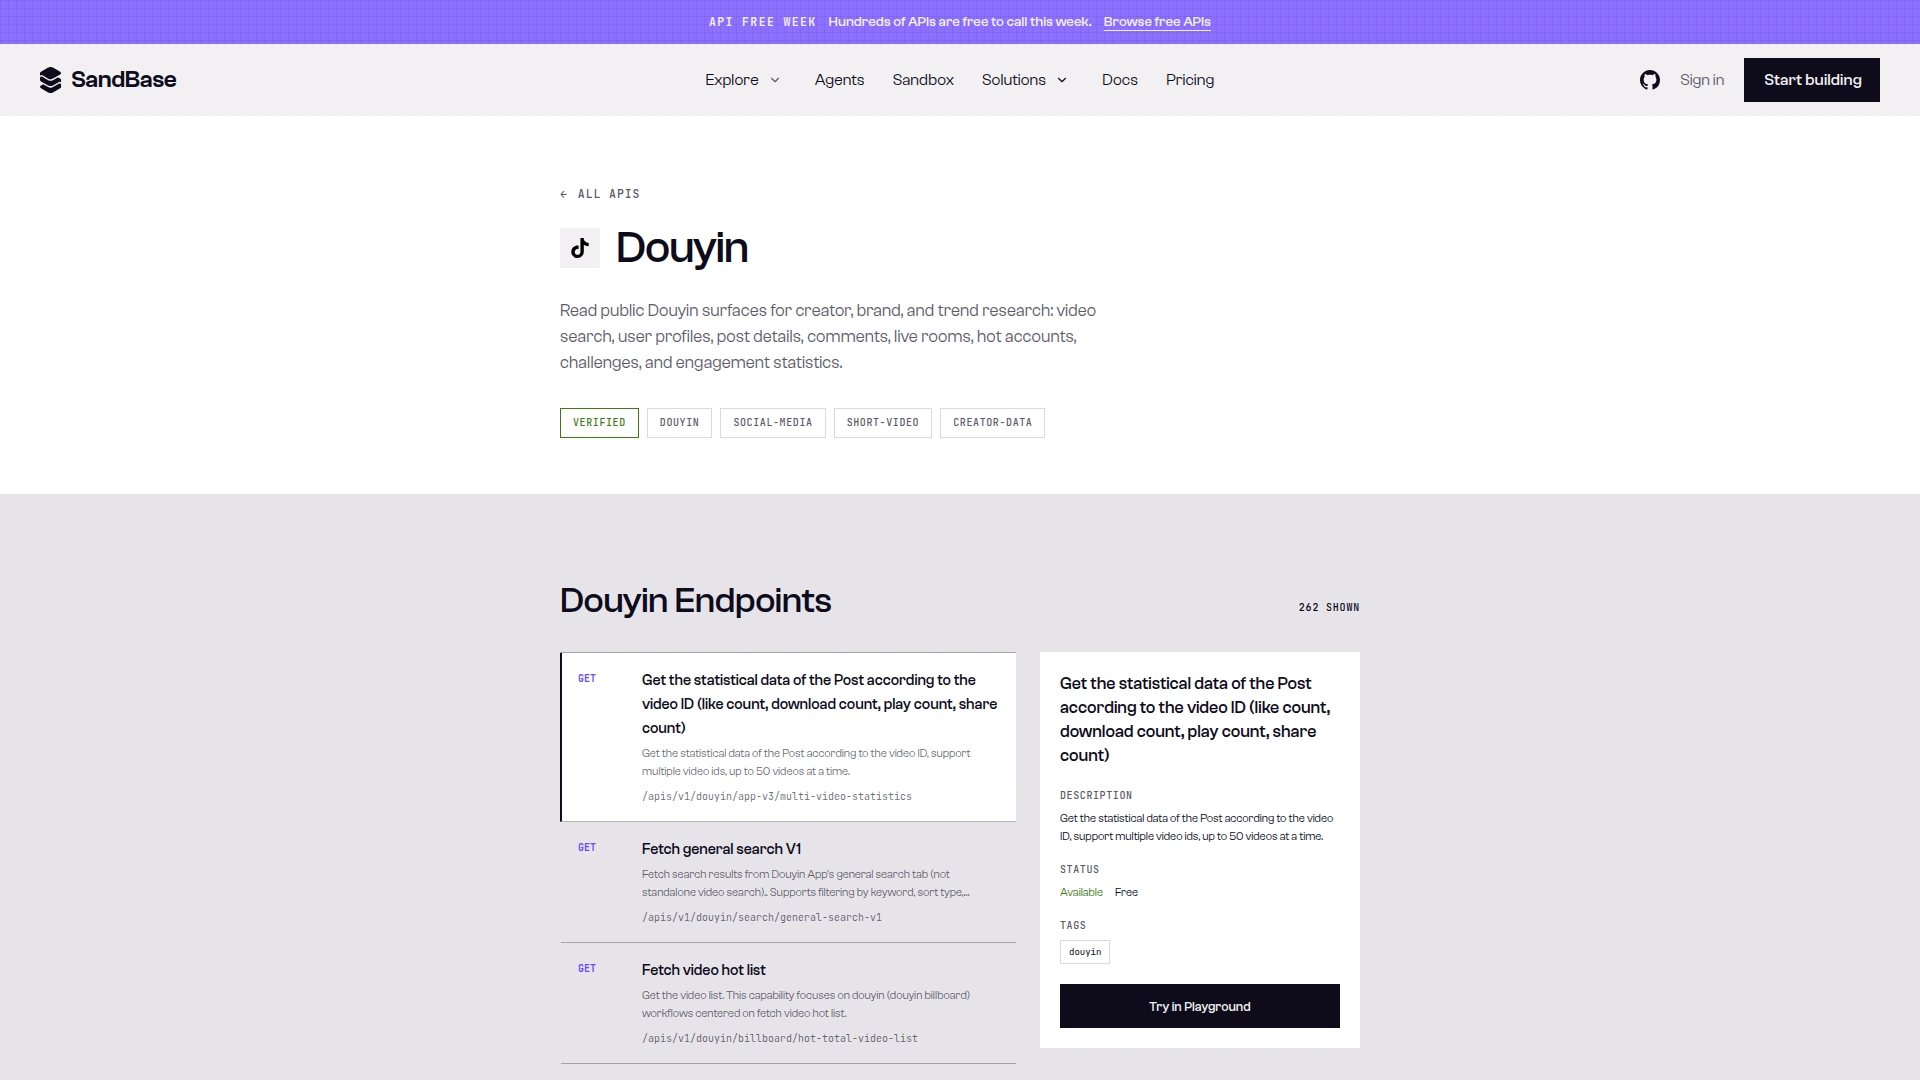
截图:SandBase 抖音目录显示“262 SHOWN”,选中的 douyin/app-v3/multi-video-statistics 状态为 Available · Free(2026-10-02 截取)。
完整代码
#!/usr/bin/env python3
"""抖音竞品监控 agent。

追踪竞品账号、检测新视频、分析趋势。
每天 cron 跑一次:0 7 * * * python3 /path/to/monitor.py
"""

import json
import os
from datetime import datetime, timezone
from pathlib import Path

import requests
from openai import OpenAI

# --- 配置 ---
# 下面是测试时用的两个公开品牌账号;换成或加上你自己的竞品
# (10 个以内大约每天 30 次数据调用)
COMPETITORS = [
    {"sec_user_id": "MS4wLjABAAAAqToDPmMuXPVGt7jNJTgewNGXmImMr0EgMwiN0VygLOQ", "name": "瑞幸咖啡"},
    {"sec_user_id": "MS4wLjABAAAAtI0BhriyYFCrLtBZ9G3zwUsXD5O_6tOcI-s1gfphuGM", "name": "瑞幸咖啡官方旗舰店"},
]

SNAPSHOT_DIR = Path("./snapshots")
SNAPSHOT_DIR.mkdir(exist_ok=True)

SANDBASE_API_KEY = os.environ["SANDBASE_API_KEY"]
HEADERS = {
    "Authorization": f"Bearer {SANDBASE_API_KEY}",
    "Content-Type": "application/json",
}

# OpenAI 客户端仅用于 LLM 调用
client = OpenAI(
    base_url="https://api.sandbase.ai/v1",
    api_key=SANDBASE_API_KEY,
)


# --- 数据获取(POST /v1/api/<model>) ---
def run_data_api(model: str, params: dict) -> dict:
    """POST /v1/api/<model>,body 只放端点参数;返回 outputs[0].data。"""
    resp = requests.post(
        f"https://api.sandbase.ai/v1/api/{model}",
        headers=HEADERS,
        json=params,
        timeout=90,
    )
    resp.raise_for_status()
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def fetch_profile(sec_user_id: str) -> dict:
    """拿用户资料。"""
    data = run_data_api("douyin/app-v3/user-profile", {"sec_user_id": sec_user_id})
    user = data.get("user") or {}
    return {
        "nickname": user.get("nickname"),
        "signature": user.get("signature"),
        "follower_count": user.get("follower_count", 0),
        "aweme_count": user.get("aweme_count"),
    }


def fetch_video_list(sec_user_id: str, count: int = 20) -> list:
    """拿最近发布的视频列表(第一页)。"""
    data = run_data_api("douyin/app-v3/user-post-videos", {
        "sec_user_id": sec_user_id,
        "max_cursor": 0,
        "count": count,
    })
    videos = []
    for a in data.get("aweme_list") or []:
        stats = a.get("statistics") or {}
        videos.append({
            "aweme_id": str(a.get("aweme_id")),
            "desc": a.get("desc"),
            "create_time": a.get("create_time"),
            "digg_count": stats.get("digg_count"),
            "comment_count": stats.get("comment_count"),
            "share_count": stats.get("share_count"),
        })
    return videos


def fetch_play_counts(aweme_ids: list[str]) -> dict:
    """一次最多拿 50 条视频的播放量。
    作品列表里 play_count 是 0,播放量从这里取。"""
    data = run_data_api("douyin/app-v3/multi-video-statistics",
                        {"aweme_ids": ",".join(aweme_ids[:50])})
    return {
        str(s.get("aweme_id")): s.get("play_count")
        for s in data.get("statistics_list") or []
    }


def load_previous(name: str) -> dict:
    path = SNAPSHOT_DIR / f"{name}.json"
    if path.exists():
        return json.loads(path.read_text())
    return {"videos": [], "follower_count": 0}


def save_snapshot(name: str, data: dict):
    path = SNAPSHOT_DIR / f"{name}.json"
    path.write_text(json.dumps(data, ensure_ascii=False, indent=2))


def detect_new(current: list, previous: list) -> list:
    prev_ids = {v.get("aweme_id") for v in previous}
    return [v for v in current if v.get("aweme_id") not in prev_ids]


def generate_briefing(all_data: list[dict]) -> str:
    """LLM 生成竞品简报。"""
    prompt = f"""你是一个专注抖音的竞品分析师。

分析以下竞品活动数据,产出简洁的每日简报。

重点关注:
1. 谁发了新内容,什么主题/形式
2. 显著粉丝变化(>1% 涨跌)
3. 互动异常高的视频(相对其平均水平)
4. 跨竞品的内容策略共性或转变

数据:
{json.dumps(all_data, ensure_ascii=False, indent=2)}

输出结构化简报:
- 一句话总结(不超过 3 句)
- 新内容亮点(按竞品)
- 互动异常
- 给我们品牌的建议动作
"""
    resp = client.chat.completions.create(
        model="anthropic/claude-sonnet-4",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    return resp.choices[0].message.content


def run():
    today = datetime.now(timezone.utc).strftime("%Y-%m-%d")
    print(f"[{today}] 开始竞品监控...")

    all_data = []
    calls = 0

    for comp in COMPETITORS:
        sec_user_id, name = comp["sec_user_id"], comp["name"]
        print(f"  检查 {name}...")

        profile = fetch_profile(sec_user_id)
        videos = fetch_video_list(sec_user_id)
        calls += 2

        prev = load_previous(name)
        new_videos = detect_new(videos, prev.get("videos", []))

        details = new_videos[:5]  # 每个竞品最多 5 条新视频
        if details:
            plays = fetch_play_counts([v["aweme_id"] for v in details])
            for v in details:
                v["play_count"] = plays.get(v["aweme_id"])
            calls += 1

        all_data.append({
            "name": name,
            "follower_count": profile.get("follower_count", 0),
            # 第一次运行还没有快照,记为 None
            "follower_change": (profile.get("follower_count", 0) - prev["follower_count"]
                                if prev.get("follower_count") else None),
            "new_videos_count": len(new_videos),
            "new_videos": details,
        })

        save_snapshot(name, {
            "videos": videos,
            "follower_count": profile.get("follower_count", 0),
            "date": today,
        })

    print(f"  生成简报({calls} 次数据调用)...")
    briefing = generate_briefing(all_data)
    calls += 1

    out = SNAPSHOT_DIR / f"briefing-{today}.md"
    out.write_text(f"# 竞品简报:{today}\n\n{briefing}")
    print(f"  简报已存:{out}")
    print(f"  数据调用:{calls - 1}(另有 1 次 LLM 调用)")


if __name__ == "__main__":
    run()
逐步拆解
实测记录:2026-10-01(UTC)
公开资源:瑞幸咖啡官方品牌账号,https://www.douyin.com/user/MS4wLjABAAAAqToDPmMuXPVGt7jNJTgewNGXmImMr0EgMwiN0VygLOQ。
curl -s https://api.sandbase.ai/v1/api/douyin/app-v3/user-profile \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"sec_user_id": "MS4wLjABAAAAqToDPmMuXPVGt7jNJTgewNGXmImMr0EgMwiN0VygLOQ"}'
截短后的返回(run id e69e529b-f7c3-4bd7-a2d0-cb88a88e20c8):
{
  "id": "e69e529b-f7c3-4bd7-a2d0-cb88a88e20c8",
  "status": "completed",
  "model": "douyin/app-v3/user-profile",
  "outputs": [{"data": {"user": {
    "nickname": "瑞幸咖啡",
    "unique_id": "luckincoffee01",
    "follower_count": 7369643,
    "aweme_count": 2292
  }}}]
}同一天,user-post-videos 传 {"sec_user_id": "<同上>", "max_cursor": 0, "count": 20}(run id 16b6f726-7eb6-4c7c-ab8b-80ef7ac7866d),outputs[0].data.aweme_list[] 返回 22 条,has_more: 1,并带 max_cursor。截取其中一条:
{"aweme_id": "7475625096317521164", "create_time": 1740554604, "is_top": 1,
 "statistics": {"play_count": 0, "digg_count": 25208, "comment_count": 2804, "share_count": 4708}}
multi-video-statistics 传 {"aweme_ids": "7688258340685679882,7475625096317521164"}(run id 94ef9077-351e-4c08-9f8e-228b9f48145f)返回:
{"statistics_list": [
  {"aweme_id": "7688258340685679882", "digg_count": 179, "play_count": 12222, "share_count": 2},
  {"aweme_id": "7475625096317521164", "digg_count": 25208, "download_count": 458, "play_count": 9997938, "share_count": 1400}
]}端点参考文档只保证信封(id、status、model、outputs[0].data),不保证 data 里面的业务字段。上面的字段名来自这几次调用,仅为观测结果、不是文档保证,所以代码每个字段都用 .get() 读。我还把上面的完整 agent 原样跑了一遍(两个瑞幸账号,LLM 调用打桩):6 次数据调用全部 completed(run id 2dad8674-…、f7f1b8ef-…、aec4e5a6-…、1fd0227d-…、12da6c6d-…、a2c3e02c-…)。
第 1 步:用户资料(每个账号 1 次)
每个竞品账号查一次粉丝数、昵称、简介。agent 存下今天的粉丝数,把和昨天相比的 follower_change 交给 LLM,prompt 要求它点出超过 1% 的变化。代码里没有写死的告警阈值(想加见「扩展思路」)。第一次运行还没有快照,follower_change 为 None。
第 2 步:视频列表(每个账号 1 次)
只请求第一页(max_cursor=0、count=20,文档上限),拿视频的 ID、发布时间和点赞/评论/分享。和昨天的快照 diff 就知道谁今天发了新视频。一天发很多条的账号会把旧作品挤出第一页,这不影响发现新作品,但 agent 看不到完整历史。
20 条上限和游标规则出自 user-post-videos 参考页:
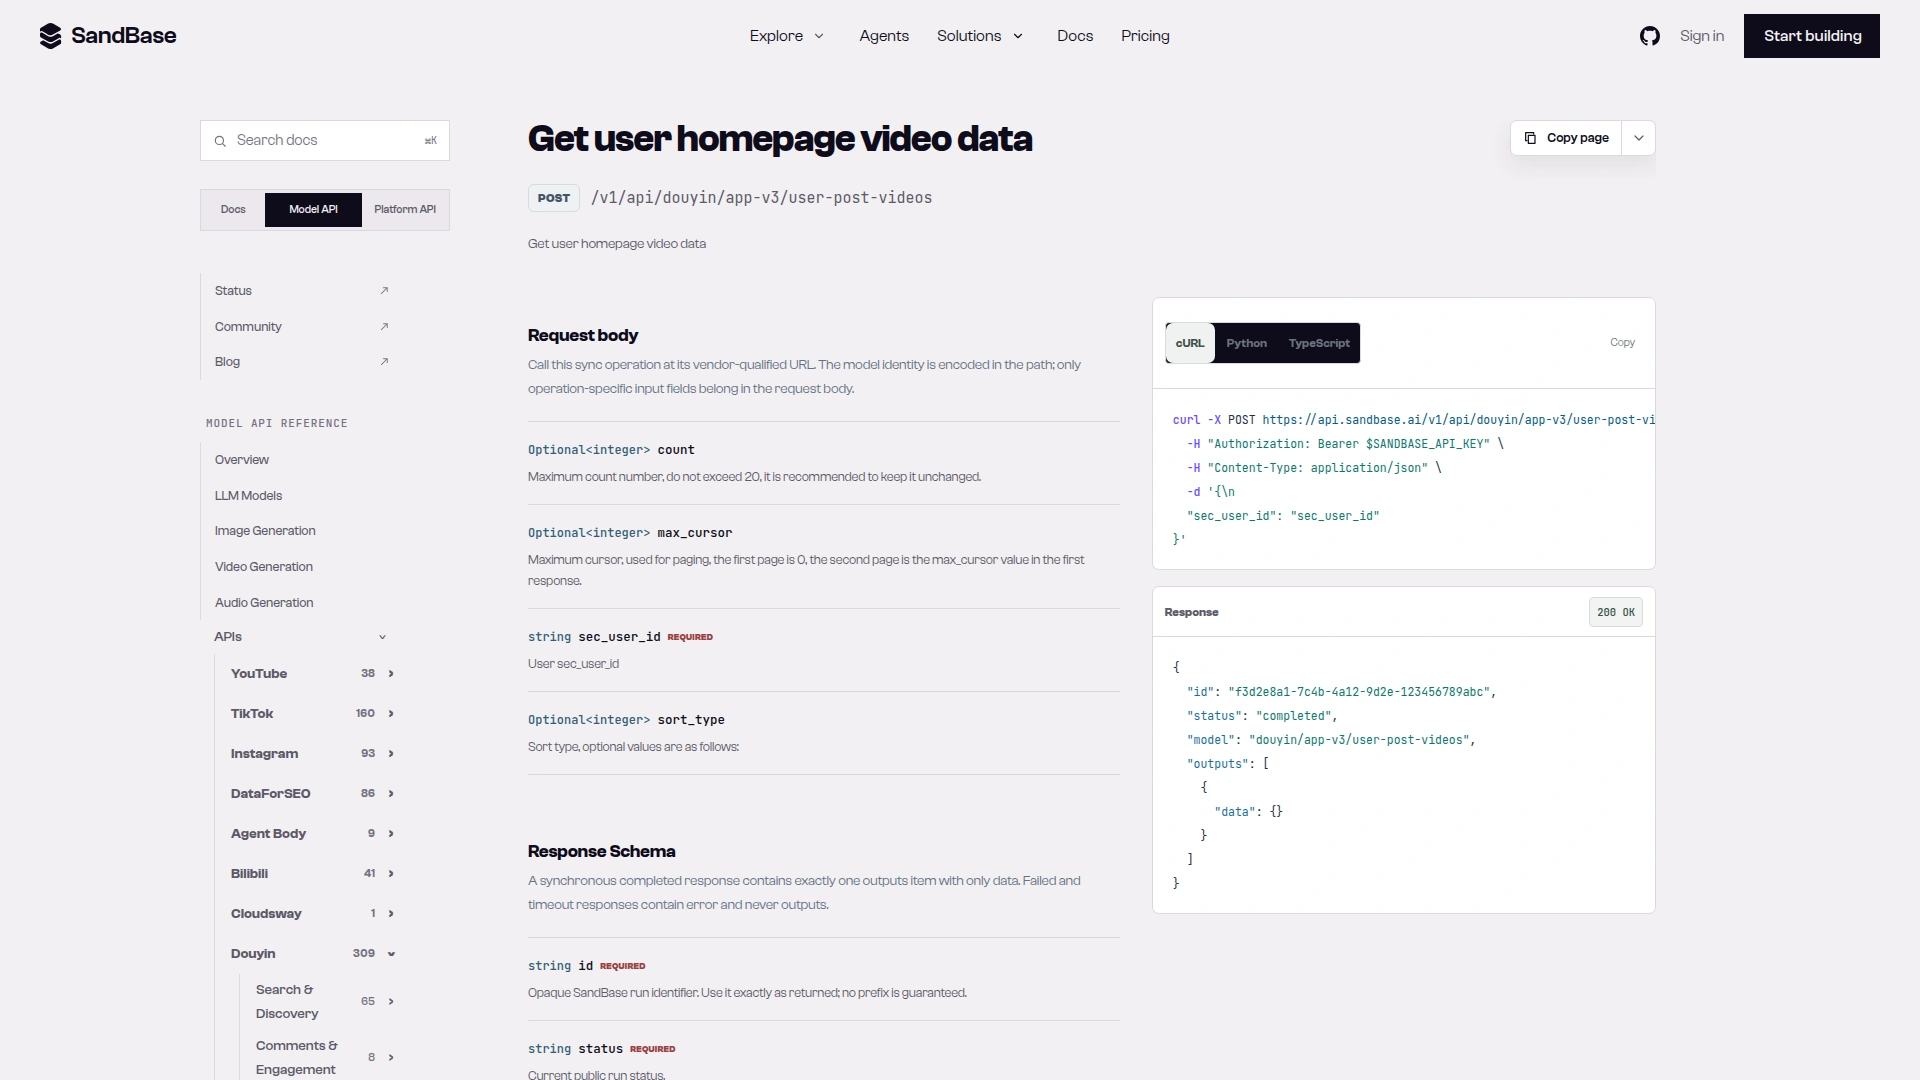
截图:user-post-videos 参考页写明 POST /v1/api/douyin/app-v3/user-post-videos,count 不超过 20,max_cursor 第一页传 0(2026-10-02 截取)。
第 3 步:新视频播放量(每个账号 0 或 1 次)
只对昨天快照里没有的新视频拉播放量,每个竞品一次批量调用。我 2026-10-01 实测时作品列表返回了点赞、评论、分享,但 play_count 是 0,douyin/app-v3/one-video 也是 0(run id 85e7f8c5-6977-4499-9872-ff2aeff82b61);douyin/app-v3/multi-video-statistics(参考文档写明每次最多 50 个 id)能补上播放量。所以 agent 只从它取 play_count,其他指标沿用作品列表。代码每个竞品最多补 5 条新视频的播放量;一天发得更多时,其余的只计入 new_videos_count,没有播放量。
那几次 count 传 20,每个账号返回了 22 到 23 条,第一页开头是标了 is_top: 1 的较早作品(置顶),之后才是近期作品,所以代码按 aweme_id 做 diff,不假设列表顺序。
第 4 步:LLM 分析(1 次)
整批数据一次性喂给 Claude Sonnet 4(max_tokens=2000),输出结构化简报,含建议动作。
费用
按 10 个竞品账号算:
| 组件 | 每天调用 | 价格(SandBase,截至 2026-10-01) |
|---|---|---|
douyin/app-v3/user-profile | 10 | Free(目录) |
douyin/app-v3/user-post-videos | 10 | Free(目录) |
douyin/app-v3/multi-video-statistics | 0–10 | Free(目录) |
anthropic/claude-sonnet-4 简报 | 1 | 输入 $3/百万 token,输出 $15/百万 token |
截至 2026-10-01,三个抖音端点在 SandBase 抖音目录里都标为 Free;扩量前再看一眼目录,标价可能调整。有一处不一致需要知道:multi-video-statistics 参考文档的描述里仍留着一行上游文字「Price: 0.025$ each time」,而截至 2026-10-01,目录条目(「STATUS Available Free」)和模型页(「Base price Free」)都标为 Free。能估算的成本就剩 LLM 这一次调用。
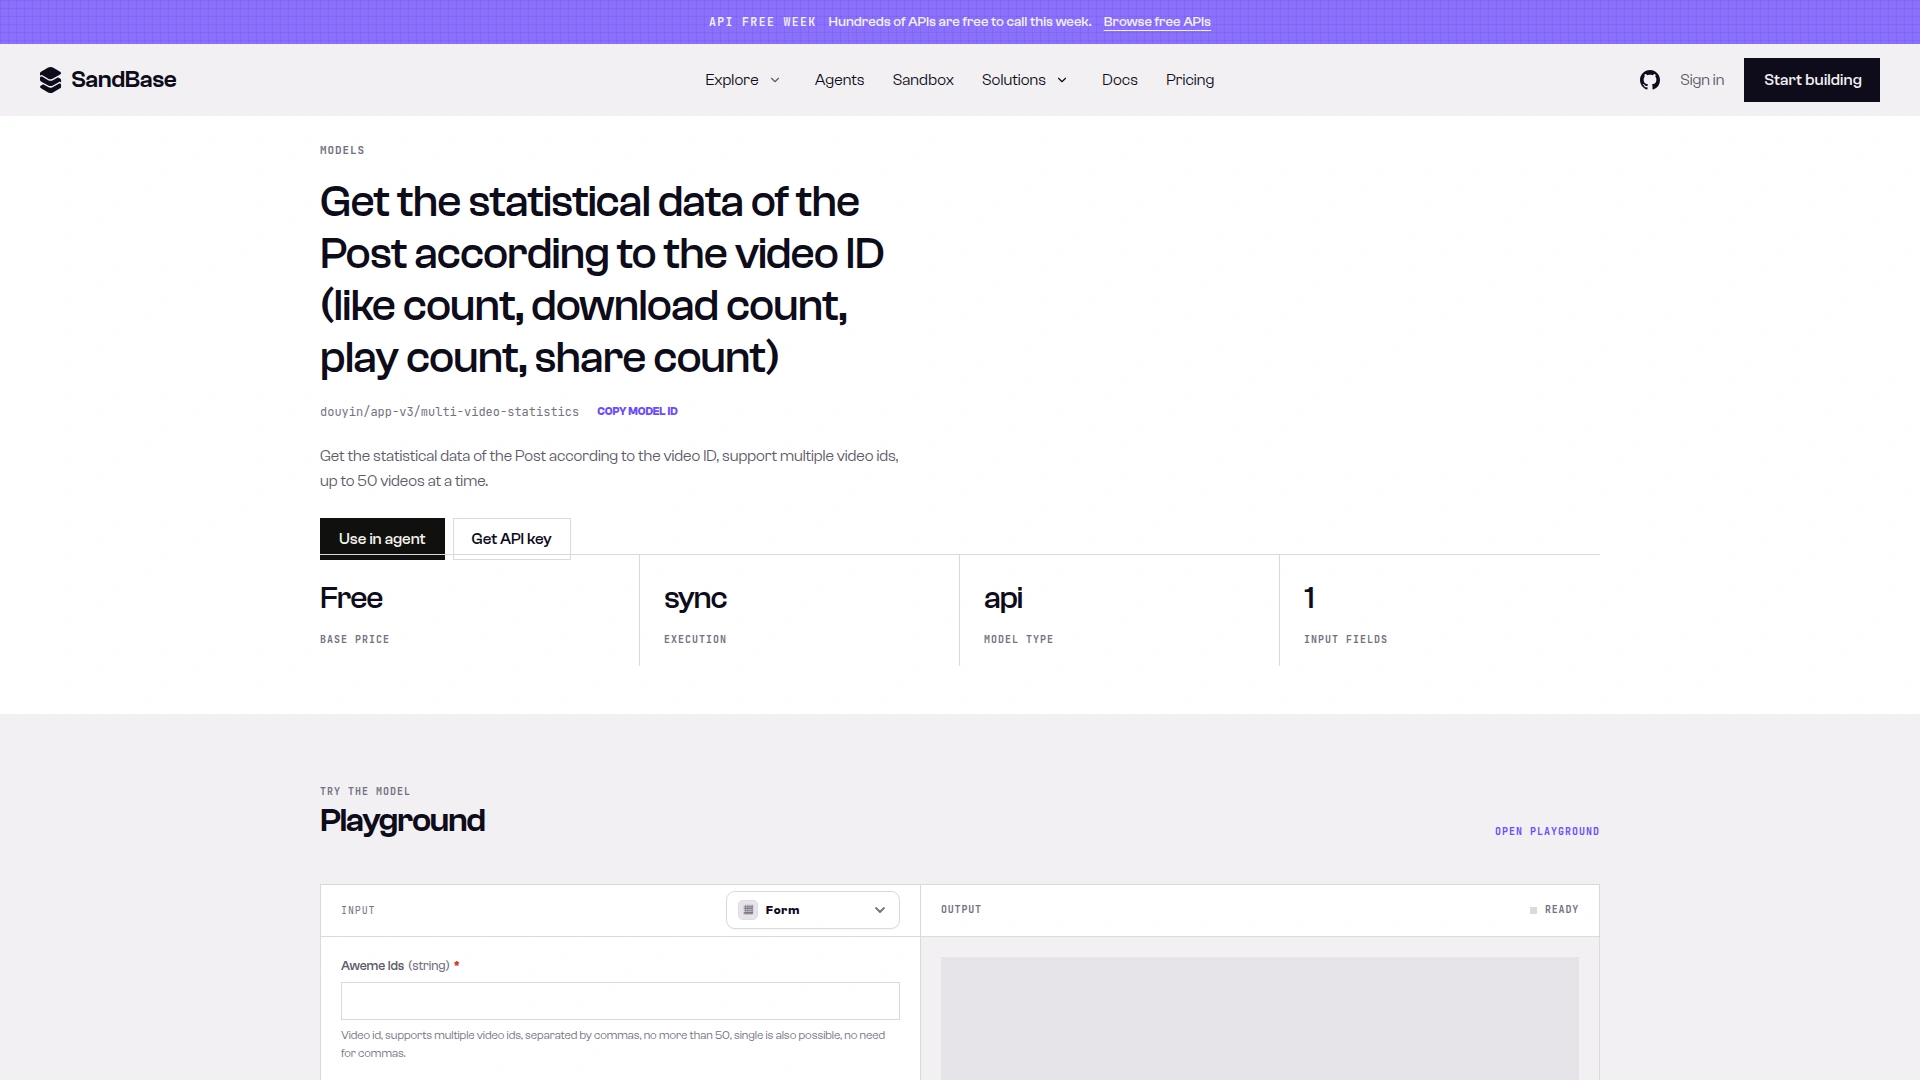
截图:multi-video-statistics 模型页标注 Base price 为 Free、执行方式 sync,唯一输入 aweme_ids 最多 50 个 id,即上文引用的 Free 标注(2026-10-02 截取)。
LLM 估算(不是报价,按实际 token 计费):我测试时两个账号、各 5 条新视频,prompt 约 3,700 个字符,大约 1,500 token。按 10 个账号放大:
| 场景 | 输入 token | 输出 token | 每次 | 30 次 |
|---|---|---|---|---|
| 平静的一天(新视频少) | ~2,000 | ~800 | 2,000 × $3/M + 800 × $15/M = $0.018 | ~$0.54 |
忙的一天(每个账号 5 条新视频,输出打满 max_tokens) | ~6,000 | 2,000 | 6,000 × $3/M + 2,000 × $15/M = $0.048 | ~$1.44 |
视频描述更长、账号更多或调大 max_tokens 都会推高费用;换成 openai/gpt-4.1-mini(输入 $0.40/M、输出 $1.60/M),忙的一天每次约 $0.0056。
和每天早上人工翻 10 个账号相比,agent 每天按计划跑。但它比人窄:每个账号只看作品第一页,每个账号最多补 5 条新视频的播放量。
怎么跑
Cron(最简单)
0 7 * * * SANDBASE_API_KEY=sk-... python3 /path/to/monitor.py >> /var/log/monitor.log 2>&1GitHub Actions
要不要花钱取决于你的 GitHub 套餐和其中包含的 Actions 分钟数;每天一个短任务通常在额度内。
name: 竞品监控
on:
  schedule:
    - cron: '0 23 * * *'  # 北京时间 7 AM = UTC 23:00 前一天
jobs:
  monitor:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: '3.12'
      - run: pip install requests openai
      - run: python monitor.py
        env:
          SANDBASE_API_KEY: ${{ secrets.SANDBASE_API_KEY }}
扩展思路
加告警:上面的代码没有阈值。想加的话,判断 follower_change 是否超过你定的比例,超过就向 Slack incoming webhook 发 {"text": ...},不等每日简报。
加微博交叉验证:竞品抖音爆了一条视频时,查他们微博是否同步发了(用 weibo/app/user-timeline,传对方的微博 uid),揭示跨平台分发策略。
加趋势:存 30 天快照,让 LLM 识别周趋势:“品牌 A 本月产品演示类内容比上月多 40%“。
局限
- 需要知道
sec_user_id:即竞品公开主页 URL 里MS4wLjABAAAA...那一段,也可以用搜索查(见 FAQ) - 第一次运行:还没有快照,第一页的所有视频都会被当成新视频,
follower_change为None。从第二天起的简报才有意义 - 调用量:代码是逐个顺序调用。本文参考的端点文档没有公布频率限制,扩量时给瞬时错误加带退避的重试,不要假设某个固定的安全频率
- 数据时效:互动数据是查询时刻的快照。刚发 1 小时的视频互动还没起来,不代表最终表现
- 只有公开数据:私信、私密视频、限制账号不可访问
FAQ
能监控超过 10 个账号吗?
能。数据调用线性增长:20 个 ≈ 每天 60 次,50 个 ≈ 每天 150 次;每天那 1 次 LLM 简报随 prompt 长度增长,token 费用也一样。规模大了以后给 run_data_api 加带退避的重试;本文用到的参考文档没有写明频率限制。
竞品删视频能检测到吗?
文中代码不检测删除,只找新 id。你可以在 detect_new 基础上加 deleted = prev_ids - current_ids,但 agent 只读第一页,被新作品挤出第一页的视频也会看起来像被删了。当成删除之前,先用 douyin/app-v3/one-video 确认一下。
能用 GPT-4o 替代 Claude Sonnet 4 吗?
能。把 model="anthropic/claude-sonnet-4" 改成 model="openai/gpt-4o",同一个端点、同一把 key。截至 2026-10-01,GPT-4o 标价输入 $2.50/M、输出 $10/M,上面「忙的一天」场景每次是 6,000 × $2.50/M + 2,000 × $10/M = $0.035,Sonnet 4 是 $0.048。
怎么拿竞品 sec_user_id?
从公开主页 URL:https://www.douyin.com/user/{sec_user_id}。也可以用 douyin/search/user-search-v2(keyword、cursor)按名字搜。我 2026-10-01 用 {"keyword": "瑞幸咖啡", "cursor": 0} 实测(run id b76520df-b3dc-477e-b9e9-e4e1a856720e),结果在 outputs[0].data.data.user_list[],第一项的 user_id 是 MS4wLjABAAAAqToDPmMuXPVGt7jNJTgewNGXmImMr0EgMwiN0VygLOQ(就是上面用的 sec_user_id),旁边有 nick_name: "瑞幸咖啡" 和 fans_cnt(仅为观测结果)。
抖音接口详情看 抖音公开数据 API。社媒数据整体选型看 选型指南。