抖音用户搜索API教程:按关键词查找创作者
抖音用户搜索 API 教程:通过 SandBase Model API 按关键词查找创作者,附 curl、Python 示例和 2026-10-01 实测结果,适用于 KOL 发现和监控。
抖音用户搜索API教程:按关键词查找创作者
先说结论 —
douyin/search/user-search-v2通过POST /v1/api/douyin/search/user-search-v2按关键词搜索抖音公开创作者账号,请求体只有keyword和cursor。2026-10-01 实测每页返回 30 个账号,翻页结果可能重复,所以在has_more为真时沿cursor翻页,并按user_id去重。截至 2026-10-01,目录把这个端点标为 Free。
想通过API查找特定领域的抖音创作者?无论你是在构建KOL发现工具、监控竞品账号,还是自动化社交媒体研究,SandBase的抖音用户搜索API都能让你在自己的代码里按关键词搜索抖音公开创作者账号。
本教程将教你如何调用接口、解析响应数据,并将其集成到实际工作流中,附带 2026-10-01(UTC)实测过的curl和Python示例。
为什么需要通过API搜索抖音用户?
抖音的创作者规模很大,通过App手动搜索创作者既费时又无法规模化。基于API的方案让你能够:
- 发现KOL(关键意见领袖):通过搜索相关关键词,找到美妆、科技、美食、健身等任何垂类的达人。
- 监控竞品:定期重跑关键词搜索,看你的品牌或品类下出现了哪些账号。
- 构建社交聆听工具:自动化发现讨论你品牌或行业的创作者。
- 驱动营销自动化:将创作者数据接入你的CRM或商务合作工具。
- 进行市场调研:了解抖音上各品类中较活跃的声音。
SandBase是什么?
SandBase是一个统一API网关,将众多社交媒体和数据API聚合在一个一致的接口下。你不需要处理每个平台不同的认证方式和响应格式,只需调用一个端点、使用一个API密钥。
针对抖音,截至 2026-10-01,SandBase 抖音目录列出 262 个端点,包括用户搜索、视频搜索、创作者主页等,全部通过 POST https://api.sandbase.ai/v1/api/<model>、使用同一个API密钥调用。
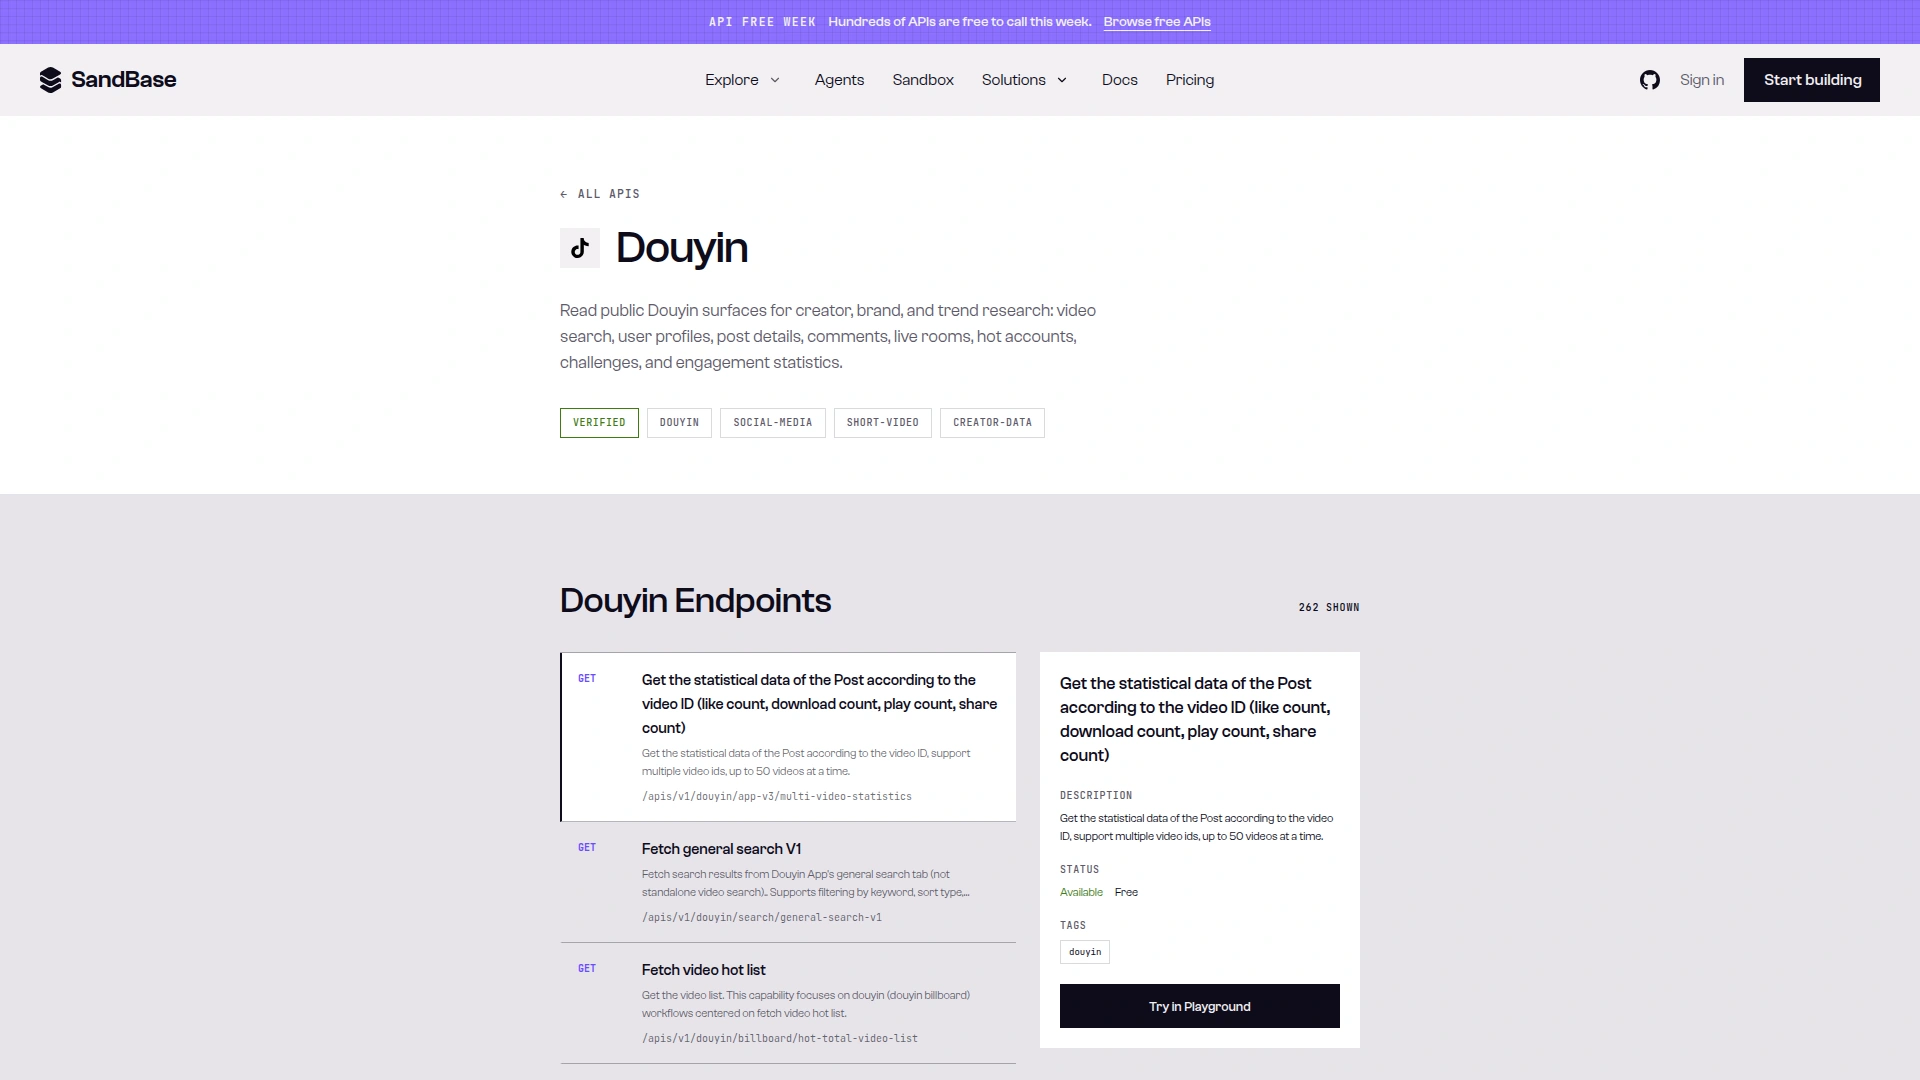
截图:SandBase 抖音目录显示“262 SHOWN”,上文的端点数量即出自这里(2026-10-02 截取)。
适用范围:公开、只读数据
本教程的工作流只返回抖音公开、只读数据。调用需要 SandBase API 密钥,SandBase 不是抖音官方合作方。它不提供私密账号数据、私信、账号所有者专属分析,也不支持发布、私信或任何账号操作。
SandBase user-search-v2 | 抖音开放平台(open.douyin.com) | |
|---|---|---|
| 认证 | 一个 SandBase API 密钥 | 开发者应用加用户/账号授权 |
| 访问范围 | 公开的创作者搜索结果 | 经授权、绑定账号的工作流 |
| 典型用途 | 关键词发现创作者、调研 | 代表已授权抖音用户操作的应用 |
准备工作
开始之前,你需要:
- SandBase账号:在 sandbase.ai 注册
- API密钥:在SandBase控制台生成
- 额度:SandBase采用额度系统;截至 2026-10-01,目录里
douyin/search/user-search-v2标的是 Free
调用这个端点不需要注册抖音开发者应用,也不需要实现抖音 OAuth 流程;请求里唯一的凭证是 SandBase API 密钥。
API概览
按关键词搜索抖音创作者的关键信息:
| 参数 | 值 |
|---|---|
| 端点 | https://api.sandbase.ai/v1/api/douyin/search/user-search-v2 |
| 方法 | POST |
| 模型 | douyin/search/user-search-v2 |
| 认证 | Bearer token(你的SandBase API密钥) |
| 输入 | keyword(字符串)、cursor(整数,首页传 0) |
| 输出 | 一页匹配的创作者账号 |
完整请求 schema 见 user-search-v2 API 参考。这里用的是端点参考里的 Model API POST /v1/api/... 路由,不是目录页展示的 GET /apis/v1/...。请求 schema 只有 keyword 和 cursor 两个参数,没有控制返回条数的参数,需要条数限制就在本地截取。
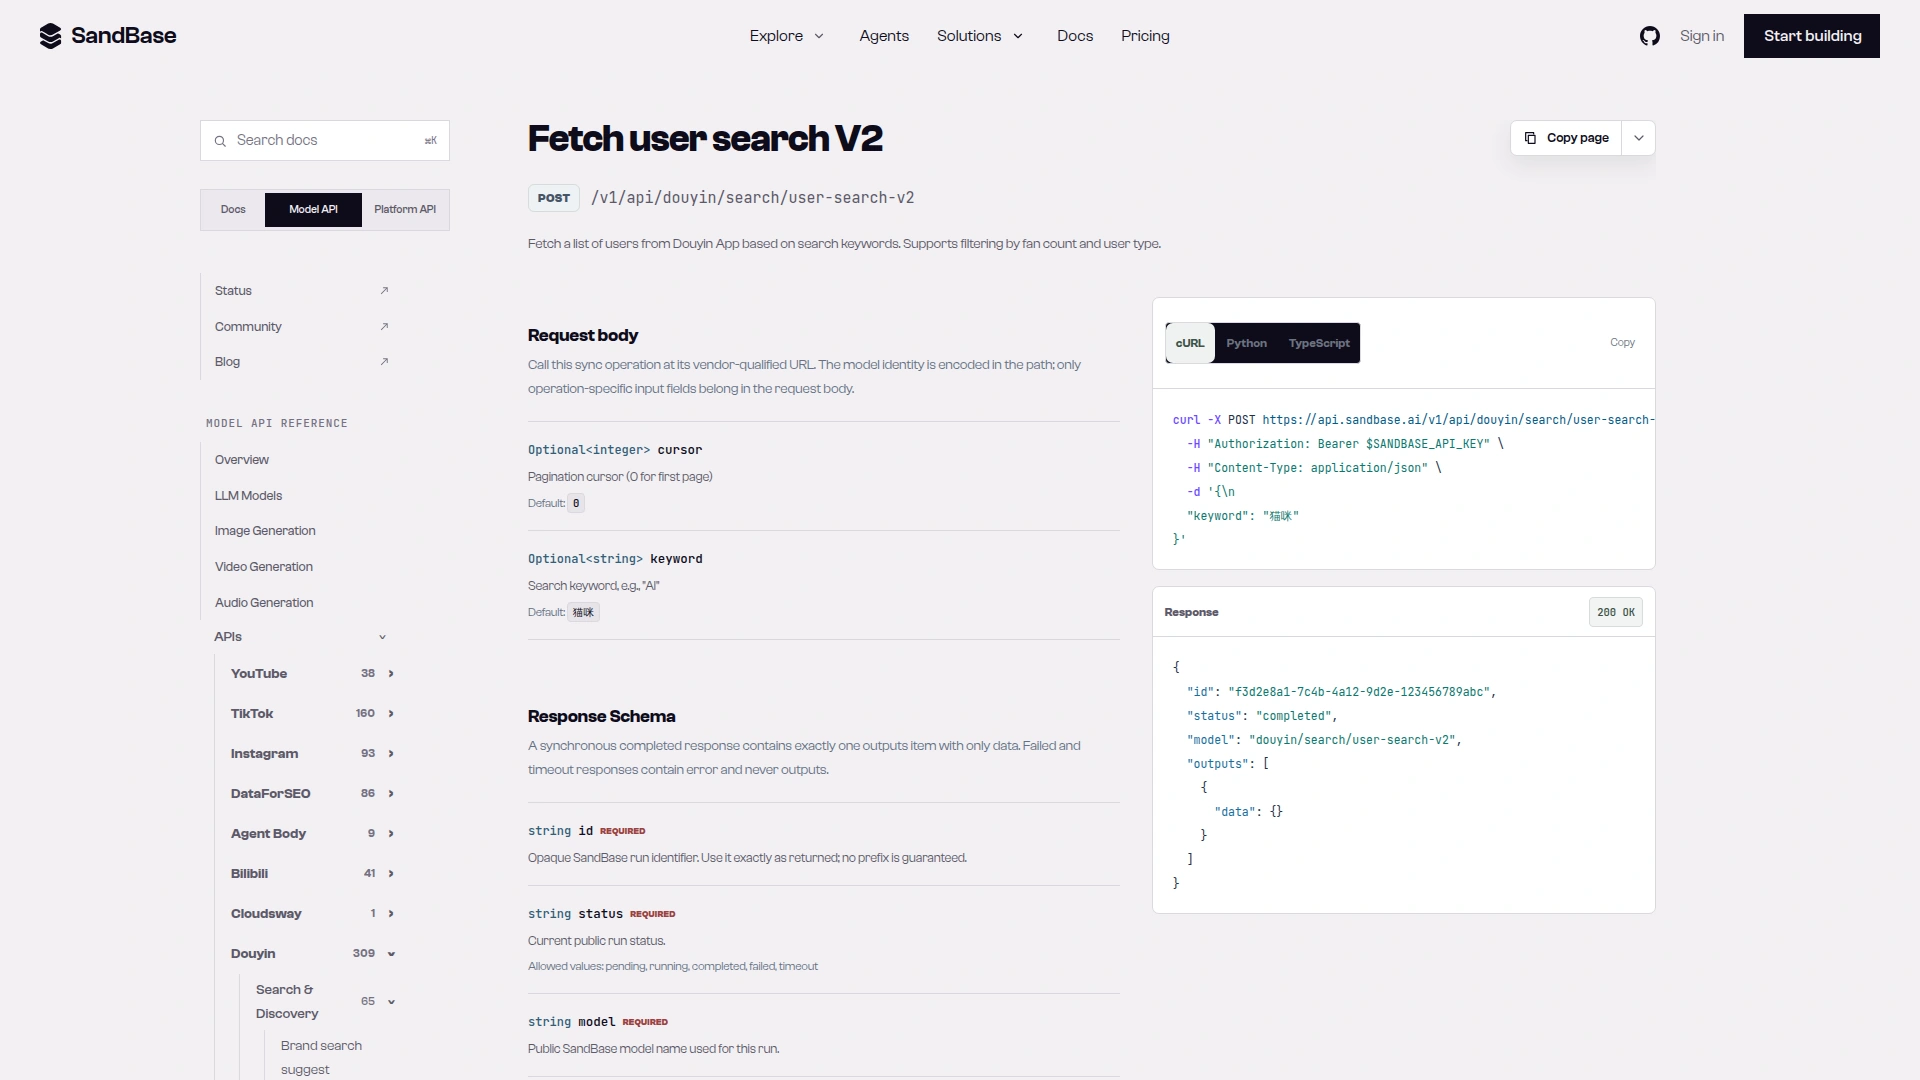
截图:user-search-v2 参考页写明 POST /v1/api/douyin/search/user-search-v2,请求体只有 cursor(首页传 0)和 keyword 两个字段(2026-10-02 截取)。
如果你已经知道创作者的名字或抖音号,douyin/creator/user-search(必填 user_name)是更轻量的查找方式。我在 2026-10-01 用 {"user_name": "人民日报"}(人民日报媒体账号)调用了一次(run id db1e6236-5baf-43b4-824e-d14c557ce9de),返回的 user_infos[] 只有 avatar、nick_name、short_id 和数字字符串形式的 user_id(第一条:人民日报,short_id 为 rmrbxmt),没有粉丝数。所以本教程用 user-search-v2 做关键词发现。
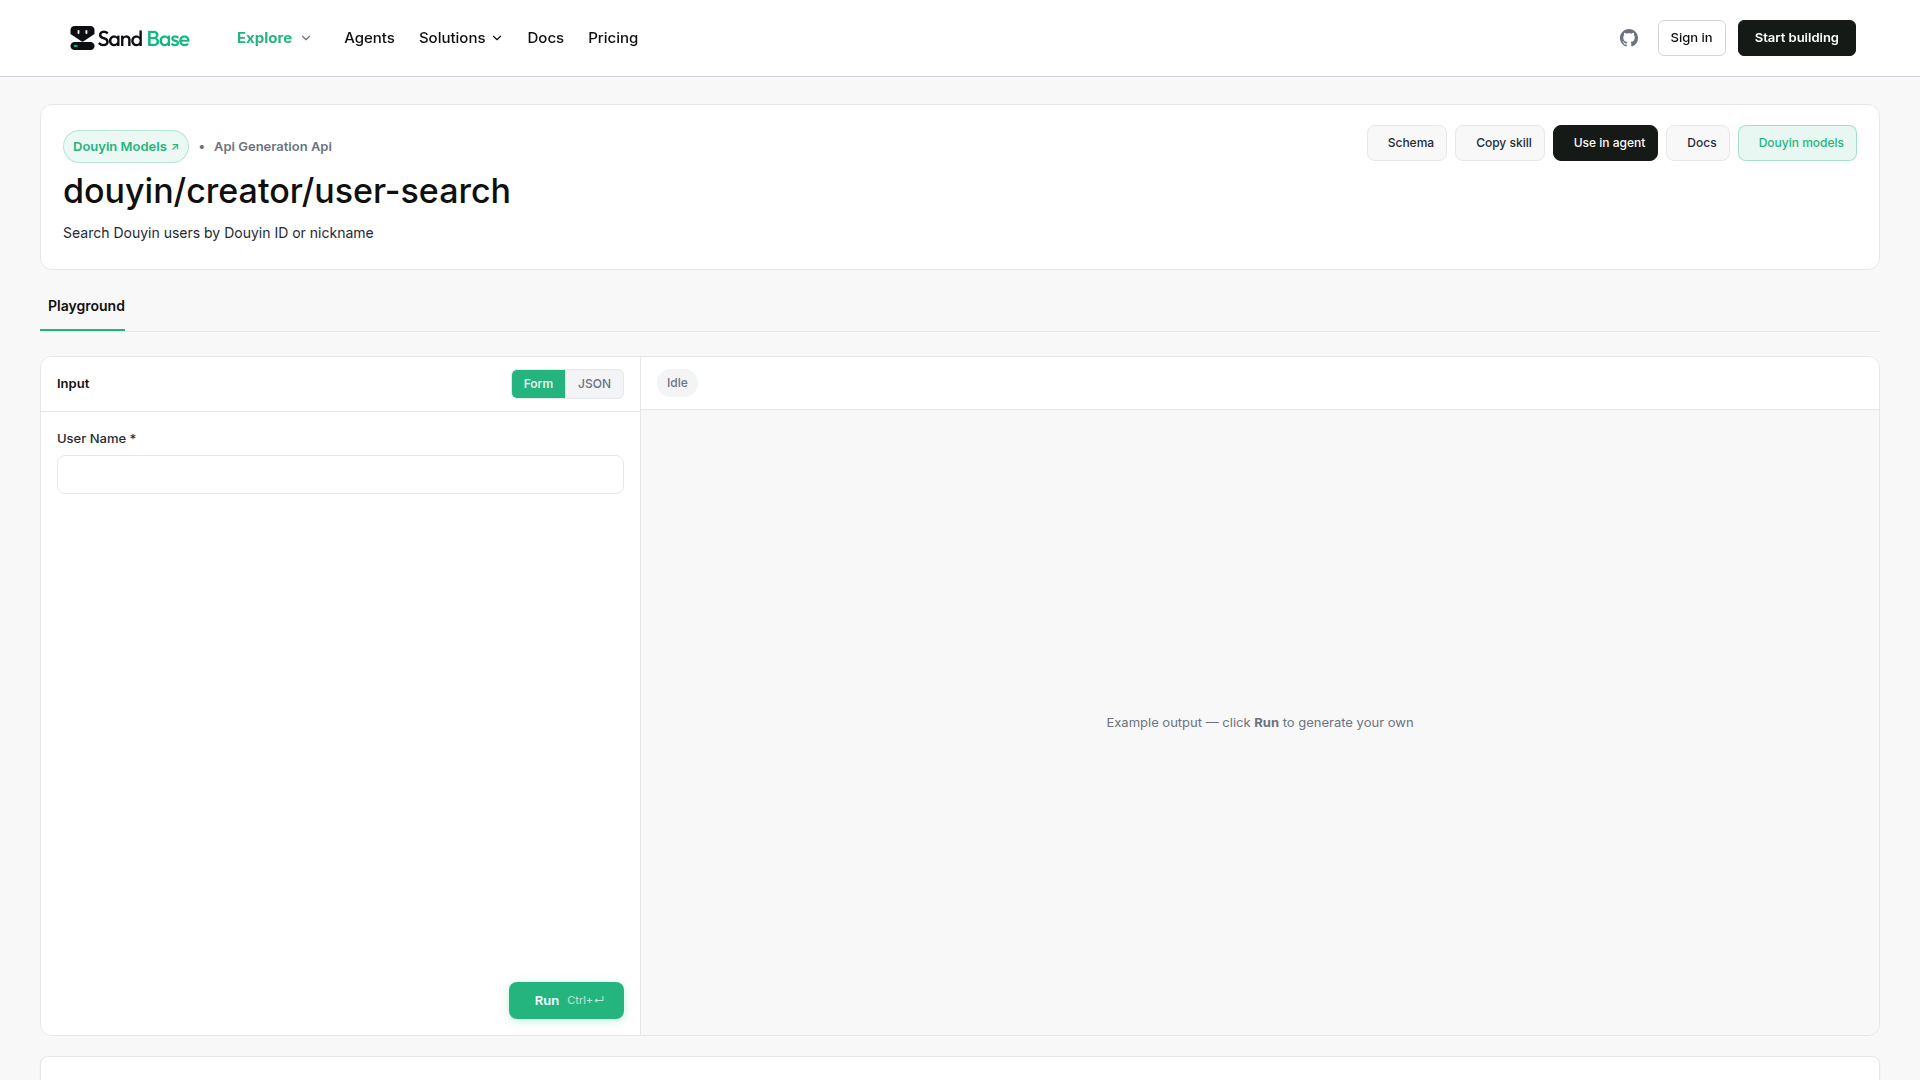
截图:douyin/creator/user-search 参考页只有一个必填的 user_name,即上文提到的按名称/抖音号的轻量查找;这张图早于 2026-10-02 这批截图。
在我 2026-10-01 的 user-search-v2 调用里,每条结果带有(不限于):
nick_name:昵称fans_cnt:粉丝数like_cnt:获赞总数publish_cnt:作品数avatar_url:头像user_id:sec_user_id格式的值(MS4wLjABAAAA...),可用于主页和作品列表接口
这些字段名来自实测观察,不是文档保证。结果里没有出现简介和认证标签。
第一步:发起第一个API调用(curl)
让我们搜索与”咖啡”相关的抖音创作者:
curl -X POST https://api.sandbase.ai/v1/api/douyin/search/user-search-v2 \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -d '{"keyword": "咖啡", "cursor": 0}'
理解响应数据
实测于 2026-10-01(UTC),使用通用关键词”咖啡”:上面的请求返回 HTTP 200、status: completed,一页共 30 个账号(run id c3e55399-822e-4fa4-83ac-42aba82f93b2)。端点参考把负载记录在 outputs[0].data。在负载内部,这个端点又包了一层 data,与 code、message 并列。以下是真实返回,只保留第一条结果和其中六个字段:
{
  "id": "c3e55399-822e-4fa4-83ac-42aba82f93b2",
  "status": "completed",
  "model": "douyin/search/user-search-v2",
  "outputs": [
    {
      "data": {
        "code": 0,
        "message": "",
        "data": {
          "cursor": 30,
          "has_more": true,
          "user_list": [
            {
              "nick_name": "咖啡",
              "fans_cnt": 2803302,
              "like_cnt": 20239511,
              "publish_cnt": 381,
              "avatar_url": "https://p26.douyinpic.com/aweme/100x100/aweme-avatar/...",
              "user_id": "MS4wLjABAAAA..."
            }
          ]
        }
      }
    }
  ]
}
负载字段来自这次实测,不是文档化的 schema。翻页时,我在 has_more 为 true 时把返回的 cursor 作为下一次请求的 cursor。2026-10-01 我用”护肤”测试,第一页(cursor: 0)和第二页(cursor: 30)各返回 30 个账号,其中有 1 个账号两页都出现了(runs be6a6551-9d72-4c38-b629-5ac1cf2ed33c、7edbfcce-79ca-45d6-a911-374351ffdd84)。合并多页时请按 user_id 去重。
第二步:Python集成
以下是适用于生产环境的Python实现:
import requests


class DouyinUserSearch:
    """通过 SandBase Model API 搜索抖音创作者。"""

    def __init__(self, api_key: str):
        self.api_key = api_key
        self.endpoint = "https://api.sandbase.ai/v1/api/douyin/search/user-search-v2"

    def search_page(self, keyword: str, cursor: int = 0) -> dict:
        """拉取一页结果,返回内层负载
        (我的调用里是 {"cursor", "has_more", "user_list"})。"""
        headers = {
            "Content-Type": "application/json",
            "Authorization": f"Bearer {self.api_key}",
        }
        payload = {"keyword": keyword, "cursor": cursor}

        response = requests.post(self.endpoint, headers=headers, json=payload, timeout=60)
        response.raise_for_status()
        body = response.json()

        outputs = body.get("outputs") or []
        if body.get("status") != "completed" or not outputs:
            raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
        data = outputs[0].get("data") or {}
        return data.get("data") or {}

    def search(self, keyword: str, count: int = 10) -> list[dict]:
        """返回最多 count 个不重复的创作者;has_more 为 true 时按 cursor 继续翻页。"""
        users, seen, cursor = [], set(), 0
        while len(users) < count:
            page = self.search_page(keyword, cursor)
            for user in page.get("user_list") or []:
                if user.get("user_id") not in seen:
                    seen.add(user.get("user_id"))
                    users.append(user)
            if not page.get("has_more") or page.get("cursor") is None:
                break
            cursor = page["cursor"]
        return users[:count]


# 使用示例
api_key = "your_sandbase_api_key_here"
client = DouyinUserSearch(api_key)

# 搜索咖啡相关创作者
users = client.search("咖啡", count=10)

for user in users:
    print(f"昵称: {user.get('nick_name')}")
    print(f"粉丝数: {user.get('fans_cnt', 0):,}")
    print(f"作品数: {user.get('publish_cnt')}")
    print(f"sec_user_id: {user.get('user_id')}")
    print("---")
添加错误处理
生产系统中建议加入重试逻辑和错误处理:
import time
from typing import Optional

def search_with_retry(
    client: DouyinUserSearch,
    keyword: str,
    count: int = 10,
    max_retries: int = 3
) -> Optional[list]:
    """带指数退避的搜索重试。"""
    for attempt in range(max_retries):
        try:
            return client.search(keyword, count)
        except requests.exceptions.HTTPError as e:
            if e.response.status_code == 429:
                wait_time = 2 ** attempt
                print(f"触发速率限制,{wait_time}秒后重试...")
                time.sleep(wait_time)
            else:
                raise
        except requests.exceptions.RequestException as e:
            print(f"请求失败: {e}")
            if attempt < max_retries - 1:
                time.sleep(2 ** attempt)
    return None
第三步:实际应用场景
场景一:营销活动的KOL发现
查找护肤垂类的创作者并按粉丝数筛选:
users = client.search("护肤", count=60)

# 筛选腰部达人(10万-50万粉丝)
mid_tier_kols = [
    user for user in users
    if 100_000 <= user.get("fans_cnt", 0) <= 500_000
]

print(f"找到 {len(mid_tier_kols)} 位腰部护肤达人")
for kol in mid_tier_kols:
    print(f"  {kol.get('nick_name')} — {kol.get('fans_cnt', 0):,} 粉丝")
场景二:竞品监控
追踪与你品牌或竞品相关的账号:
competitors = ["品牌A", "品牌B", "品牌C"]

for brand in competitors:
    users = client.search(brand, count=5)
    print(f"\n{brand}: 找到 {len(users)} 个相关账号")
    for user in users:
        print(f"  @{user.get('nick_name')} ({user.get('fans_cnt', 0):,} 粉丝)")
场景三:构建社交监控Agent
将创作者关键词搜索与AI Agent框架结合,构建自动化社交情报系统:
# AI Agent工作流伪代码
keywords = ["你的品牌名", "行业关键词", "竞品名称"]

for keyword in keywords:
    creators = client.search(keyword, count=10)

    # 将结果存入数据库
    for creator in creators:
        save_to_db(creator)  # 以 creator["user_id"] 作为主键

    # 发现新的高粉账号时告警
    new_accounts = filter_new_accounts(creators)
    if new_accounts:
        send_alert(f"关键词'{keyword}'发现新账号: {new_accounts}")
与其他SandBase API组合使用
你可以组合几个搜索端点做跨平台研究。下表只列关键字段,完整请求 schema 请看各自的参考页:
| 平台 | API模型 | 关键字段 | 用途 |
|---|---|---|---|
| 抖音用户搜索 | douyin/search/user-search-v2 | keyword、cursor | 查找创作者 |
| 抖音视频搜索 | douyin/search/video-search-v2 | keyword、cursor(另有可选筛选项) | 按关键词查找内容 |
| 小红书笔记搜索 | xiaohongshu/app-v2/search-notes | keyword、page(另有可选字段) | 跨平台研究 |
| 微博用户搜索 | weibo/web-v2/user-search | query、page(另有可选筛选项) | 查找相关微博账号 |
在我 2026-10-01 的调用里,这几个接口用”咖啡”都返回了非空结果(runs a102bf5b-61bf-42ac-803a-da55633a38e6、846c4b40-b260-401c-ac2f-254175315626、4e4e6cf4-9170-49f2-aa42-efd1e0be090d)。它们的负载结构各不相同,解析前请先看各自的参考文档。
搜索结果里的 user_id 是 sec_user_id,douyin/web/user-profile 和 douyin/web/user-post-videos 都接受它。这些下游端点有各自的条件(作品列表的参考注明 Web 接口可能不稳定,并可选传入用户 cookie),请逐个查看参考,不要默认它们和 user-search-v2 表现一致。
更多关于抖音数据API的详情,请查看我们的指南:SandBase上的抖音数据API。如果你正在构建消费社交数据的AI Agent,请阅读2026年社交媒体数据API与AI Agent。
定价与速率限制
SandBase 按调用次数从额度余额中计费,可以在控制台查看额度使用情况。截至 2026-10-01,目录里 douyin/search/user-search-v2 标的是 Free,模型页也一样:
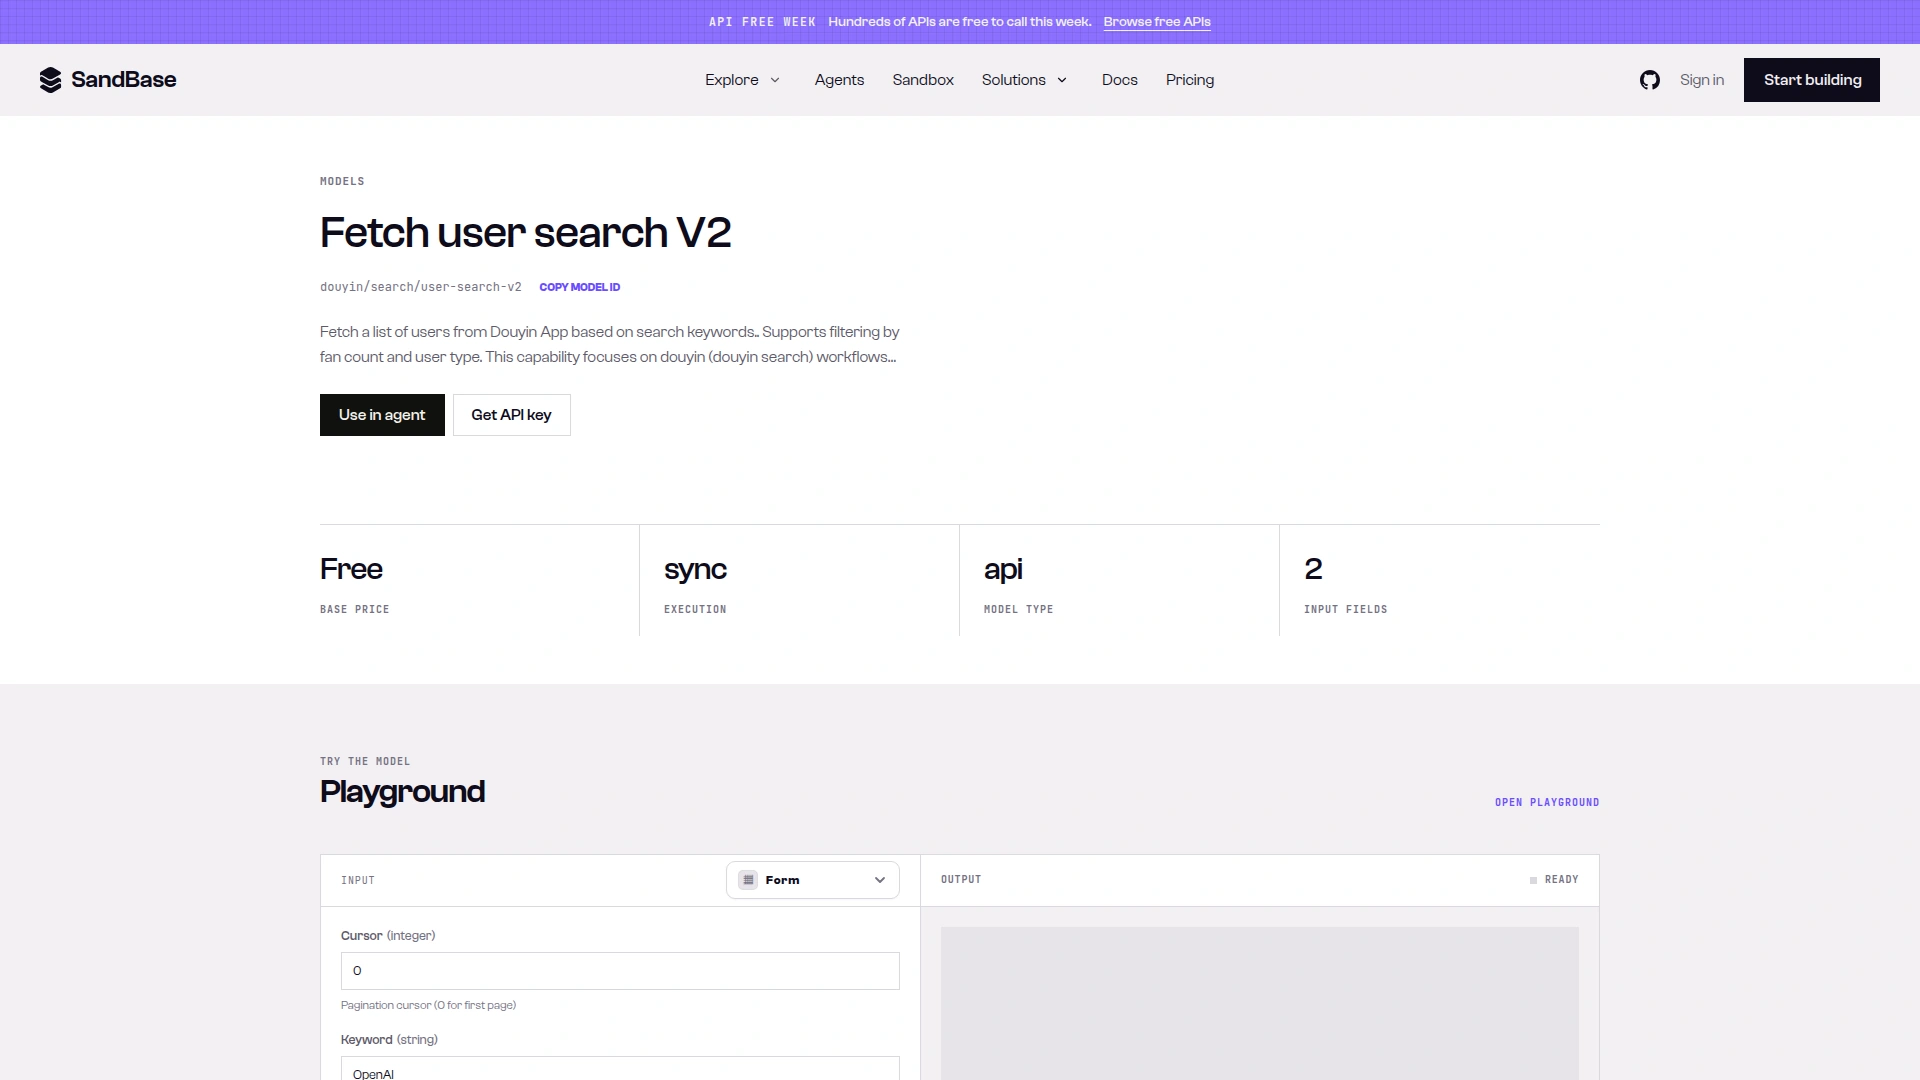
截图:douyin/search/user-search-v2 模型页标注 Base price 为 Free、执行方式 sync、输入字段 2 个(2026-10-02 截取)。
当前套餐请查看 SandBase定价页面。遇到 HTTP 429 时,按上文的方式退避重试。
最佳实践
- 优先试中文关键词:抖音用户以中文为主,中文关键词是合理的起点;也可以和你所在垂类的英文词对比一下。
- 关键词要具体:“精品咖啡”这类更窄的关键词,通常比”咖啡”得到更有针对性的列表。
- 组合多次搜索:使用相关关键词多次搜索,构建更全面的创作者列表。
- 缓存结果:如果不需要每次都拿最新数字,就缓存结果,按适合你场景的频率刷新。
- 遵守速率限制:实现退避逻辑以优雅处理429响应。
总结
SandBase 的 user-search-v2 端点让你可以用简单的方式按关键词搜索抖音公开创作者账号。每页一次API调用,你就能:
- 为营销活动找到相关KOL
- 监控竞品关键词下出现的账号
- 构建自动化社交聆听工具
- 为AI Agent提供公开创作者数据
立即注册SandBase,然后打开 user-search-v2 API 参考,开始你的第一次调用。