2026 最佳抖音数据 API:服务、价格与对比
2026 年抖音数据 API 怎么选:从覆盖范围、计费模型、同步/异步设计、鉴权和可靠性评估公开数据服务,附 2026-10-01 实测调用示例。
先说结论 — 抖音有官方开放平台,但它服务的是经过授权、绑定账号的场景;没有面向任意抖音公开数据、无需授权的通用数据 API。第三方服务商填补了这块空白,它们在覆盖范围、计费模型、可靠性和架构设计上差异很大。本文不评”谁是第一”,而是帮你搞清哪些评估维度对你的场景真正重要。
抖音是中国最大的短视频平台之一。对 AI Agent、市场研究和数据驱动应用来说,程序化读取抖音公开数据常常是刚需;而官方的抖音开放平台围绕授权和账号绑定场景设计,并不是开放的数据消费接口。
这催生了一个抖音数据服务市场,每家服务商有不同的取舍。选择时需要理解你的 Agent 架构真正需要什么,而不是简单比较功能列表。
为什么抖音数据接入难
评估服务之前,先了解背景:
- 官方 API 限定在授权场景。 抖音开放平台提供授权、内容发布、账号管理和账号绑定数据等 OpenAPI/SDK 能力,巨量引擎服务广告主。两者都不是读取任意公开数据的通用接口。
- 反爬措施。 抖音使用设备指纹、限流和行为校验,自建爬虫很脆弱。
- 多数据面。 Web、移动 App、创作者平台、广告工具、星图(达人合作平台)各自暴露不同数据。
- 前端变化频繁。 客户端和网页的改动经常打断爬虫和非官方集成。
- 法律义务。 中国的《个人信息保护法》适用于个人信息处理活动。是否适用、如何适用取决于你的具体用途;请自行评估自身义务和各服务商条款,不要默认用了某个 API 就自动合规。
结果是:自己维护抖音数据管道成本很高。第三方 API 存在的原因是这个问题足够难,值得专门服务。
六大评估维度
一、操作覆盖范围
最直观的差异化指标。“操作”指有特定数据获取能力的独立 API 端点。下表是用来思考适配度的示意分档,不是市场统计:
| 覆盖层级 | 操作数 | 典型数据面 | 适用场景 |
|---|---|---|---|
| 基础 | 20–50 | 用户主页、基本视频信息 | 简单监控 |
| 中等 | 50–150 | + 评论、搜索、热榜 | 市场研究 |
| 全面 | 150–250 | + 创作者平台、广告、达人市场 | 竞品情报 |
| 全谱 | 250+ | + 星图、DOU+、大部分频道 | 完整 Agent 集成 |
关注重点: 不只是总数,而是跨频道覆盖。抖音公开数据分散在多个数据面:
- Index/信息流 — 推荐内容、hashtag 页面、热门
- Web — 公开主页、视频页、搜索结果
- App (v3) — 移动端视角的公开主页、视频和互动计数
- Billboard/排行榜 — 官方榜单、热点话题
- Xingtu/星图 — 达人市场的公开列表和达人信号
- Creator/创作者 — 创作者平台的热点、音乐、道具榜单和课程
- DOU+ — DOU+ 达人分类和视频榜单
- Search/搜索 — 关键词内容和用户发现
一个 100 操作全集中在 Web 面的服务,可能不如 80 操作但横跨 Web、App、星图和创作者频道的服务有用。
二、定价模型
市场上三种主流模型。下面的金额都是为了说明差异而设的假设值,不是任何服务商的报价。
按次计费:
示例:$0.001–0.005/次
优势:用多少付多少,单位经济可预测
劣势:大量使用时价格上涨
最适合:用量不稳定的 Agent 工作负载
订阅套餐:
示例:$99–499/月,含 X 次调用
优势:月度成本可预测,大量时通常更便宜
劣势:用量不稳定时浪费,阶梯边界有断崖
最适合:用量稳定的应用
积分制:
购买积分,按操作类型消费(不同操作成本不同)
优势:灵活分配到高/低成本操作
劣势:成本预测复杂,积分可能过期
最适合:使用多种操作类型的团队
按量级成本对比(假设值)
| 月请求量 | 按次 $0.001 | 按次 $0.003 | 订阅 $299/10 万次 |
|---|---|---|---|
| 1 万次 | $10 | $30 | $299(多付) |
| 5 万次 | $50 | $150 | $299(合理) |
| 10 万次 | $100 | $300 | $299(持平) |
| 50 万次 | $500 | $1,500 | 需升级套餐 |
对 AI Agent 来说,按次计费通常更合适:Agent 工作负载有突发性,你不希望在一周需要 5,000 次、下周需要 50,000 次时被锁定在某个套餐。
三、同步 vs 异步设计
对 Agent 架构影响很大。
同步 API:
- 请求 → 等待 → 响应
- 直接嵌入 Agent 工具调用模式
- 不需要 webhook 基础设施
- 错误处理简单(HTTP 状态码)
- 约束:操作要在请求超时内完成
异步 API:
- 请求 → 任务 ID → 轮询/webhook → 结果
- 支持长时间操作(批量导出、深度爬取)
- 需要回调基础设施
- Agent 集成更复杂(状态机、轮询循环)
- 更适合批量任务
Agent 需要什么: 实时决策循环需要同步。Agent 在推理竞品最新视频表现时,需要在同一个工具调用回合拿到数据,而不是之后才到达的回调。
单对象查询(一个主页、一条视频的统计、一页评论或搜索结果)天然适合同步。延迟请在你要用的端点上自己实测(见下文测试清单)。异步只在批量任务时才划算,比如”导出某账号全部视频”或”爬取某条有数万评论的帖子”。
四、认证与访问模型
| 认证方式 | 复杂度 | 安全性 | Agent 适配 |
|---|---|---|---|
| API Key | 最简 | 中等 | 最容易接入 |
| OAuth/Token | 中等 | 高 | 增加 token 生命周期管理 |
| SDK 封装 | 低(表面) | 依实现 | 有锁定风险 |
对 Agent 集成来说,简单 API Key + REST 端点最容易接入。你的 Agent 工具调用机制已经能处理 HTTP 请求,再加 OAuth token 管理或 SDK 依赖只会增加复杂度。
五、可靠性与 SLA
评估要点:
- 有书面 SLA 吗? 找有文档化可用性承诺、并有宕机赔偿的。
- 如何处理抖音侧变更? 平台更新会打断数据访问,恢复时间很关键。
- 单操作错误率? 整体可用性高,也可能掩盖个别操作更高的失败率。
- 有状态页吗? 问题透明度体现成熟度。
- 延迟分布? P50 和 P99 比平均值更重要。
危险信号:
- 无可用性承诺
- “尽力而为”措辞
- 无状态页或事件历史
- 声称”无限制”速率(抖音上没有什么是无限的)
六、数据新鲜度
| 新鲜度级别 | 含义 | 典型用途 |
|---|---|---|
| 实时 | 每次请求现取 | 热点检测、实时监控 |
| 准实时 | 缓存数分钟 | 大多数 Agent 工作流 |
| 缓存 | 缓存约一小时 | 批量分析、报告 |
| 快照 | 每日/每周刷新 | 历史分析 |
对大多数 Agent 用例,准实时就够了。只在 Agent 真正需要秒级感知变化时才为实时付费。
2026 市场格局
不点名具体服务商(格局变化很快),市场大致分四类:
第一类:全谱平台
- 数百个操作
- 多平台(抖音 + 微博 + 小红书 + TikTok)
- 统一认证和计费
- 按次计费
- 同步优先设计
- 目标受众:Agent 开发者、企业数据团队
SandBase 属于此类。截至 2026-10-01,SandBase 抖音目录显示 262 个抖音端点,覆盖 index、web、app-v3、billboard、xingtu-v2、xingtu、creator、DOU+(douplus)和 search 频道;creator-v2 频道目前没有可调用的端点。截至 2026-10-01,目录把这些数据 API 标为 Free;价格可能调整,做预算前请看实时的模型卡片。范围说明:公开、只读数据,用一个 SandBase API Key 调用。SandBase 不是抖音官方合作方,主目录不涉及私密账号、私信、仅账号所有者可见的分析数据、发布或账号操作。详见抖音公开数据 API 总览。
端点数量和 Free 标注都以目录页本身为准:
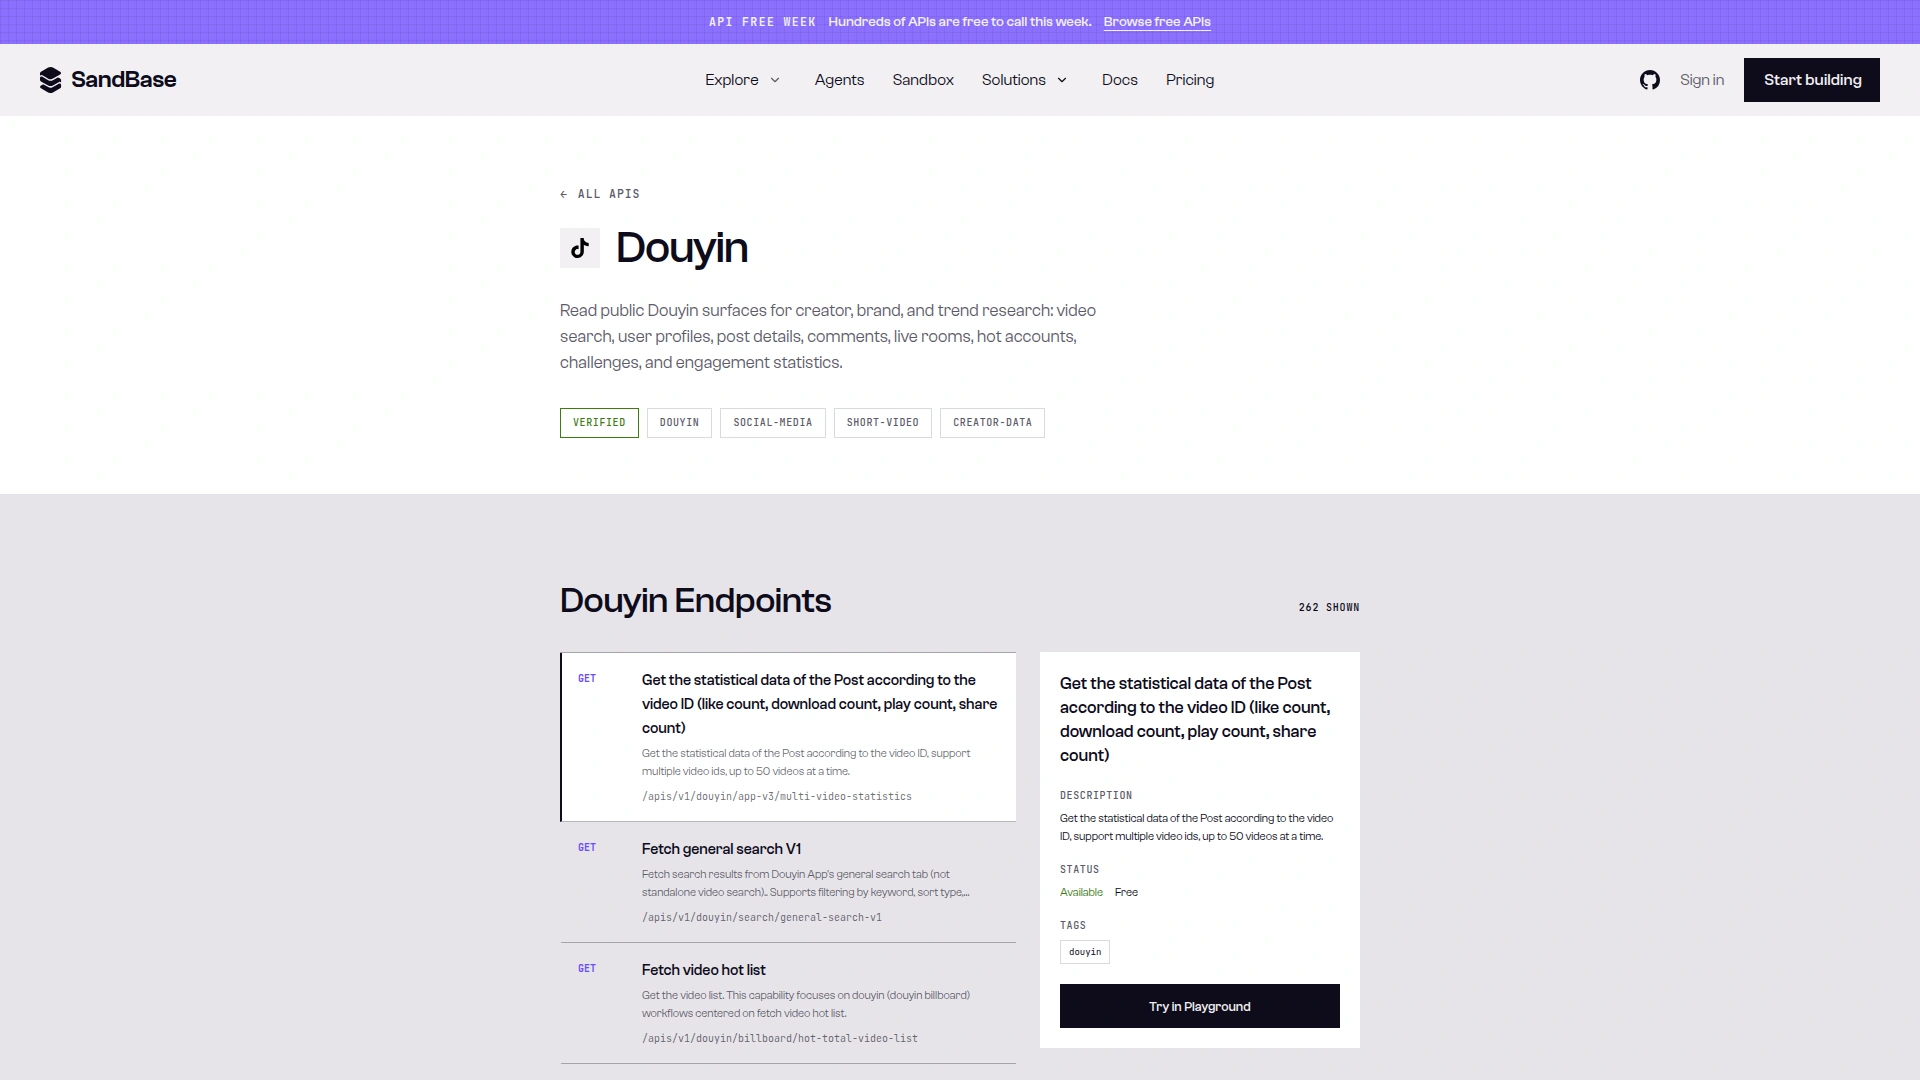
截图:SandBase 抖音目录显示“262 SHOWN”,选中的端点状态为 Available · Free(2026-10-02 截取)。
依赖登录态的能力。 目录里少数条目基于会话而不是公开查询,例如 douyin/web/query-user(需要传入用户 ttwid cookie)和 douyin/index/get-user-sub-word(描述为当前登录用户订阅的关键词)。它们不在本文的公开数据流程之内。
第二类:专门供应商
- 操作数较少,常聚焦单一数据面
- 仅抖音或有限平台覆盖
- 通常订阅制定价
- 同步/异步混合
- 目标受众:营销团队、研究机构
第三类:爬虫即服务
- 覆盖范围不固定(取决于能爬到什么)
- 通常异步(API 背后是无头浏览器)
- 每次请求都要驱动浏览器,通常比结构化端点更慢、更不稳定
- 极端量级下可能更便宜
- 目标受众:一次性研究、价格敏感用户
第四类:官方平台
- 抖音开放平台:授权、内容发布、账号管理和账号绑定数据
- 巨量引擎:广告业务
- 需要开发者/企业入驻和用户授权
- 当你代表自己或用户的账号操作时,这是正确选择
| 需求 | 抖音开放平台(官方) | 公开数据 API(如 SandBase) |
|---|---|---|
| 数据范围 | 授权给你应用的账号数据 | 公开、只读数据 |
| 账号授权 | 需要(用户 OAuth) | 不需要;一个 SandBase API Key |
| 发布 / 账号操作 | 对已授权账号支持 | 不支持 |
| 接入流程 | 开发者与应用审核 | 注册并创建 API Key |
| 适合 | 为自有用户服务的应用 | 公开数据上的研究、监控、Agent 工具 |
按场景选择
AI Agent 开发
优先级: 同步设计 → 覆盖范围 → 按次计费 → 可靠性
Agent 需要同步响应嵌入工具调用模式。操作广度决定 Agent 能做什么决策。按次计费匹配突发工作负载。可靠性要高到 Agent 能信任数据。
竞品情报
优先级: 覆盖范围(公开的创作者 + 星图市场数据) → 数据新鲜度 → 历史数据 → 定价
你需要跨频道的公开创作者、内容和达人市场数据。新鲜度决定发现趋势的速度;自己存下的历史快照支持趋势分析。
达人营销
优先级: 星图覆盖 → 公开达人指标 → 定价 → 批量能力
星图市场是公开达人列表所在的地方。评估候选达人时你会发起大量调用。
热点检测
优先级: 排行榜 + 搜索覆盖 → 延迟 → 实时新鲜度 → 成本
速度比广度重要。需要快速拿到热榜数据,并用搜索验证信号。
集成模式
基础:直接 REST 调用
示例只调用一个端点 douyin/app-v3/user-profile(端点参考)。你需要一个 SandBase API Key;抖音目录里的其他端点用法相同。
import os
import httpx

SANDBASE_API_KEY = os.environ["SANDBASE_API_KEY"]
ENDPOINT = "https://api.sandbase.ai/v1/api/douyin/app-v3/user-profile"


async def get_douyin_user(sec_user_id: str) -> dict:
    async with httpx.AsyncClient(timeout=30) as client:
        response = await client.post(
            ENDPOINT,
            json={"sec_user_id": sec_user_id},
            headers={"Authorization": f"Bearer {SANDBASE_API_KEY}"},
        )
        response.raise_for_status()
        body = response.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(
            f"SandBase call did not complete: {body.get('status')} {body.get('error')}"
        )
    data = outputs[0].get("data") or {}
    return data.get("user") or {}
这里用的是 SandBase 的 Model API 路由(POST /v1/api/douyin/app-v3/user-profile,Bearer 鉴权,JSON body 只放 sec_user_id),不是目录页展示的 GET 视图。下面的端点参考页能看到这条路由和唯一的必填字段:
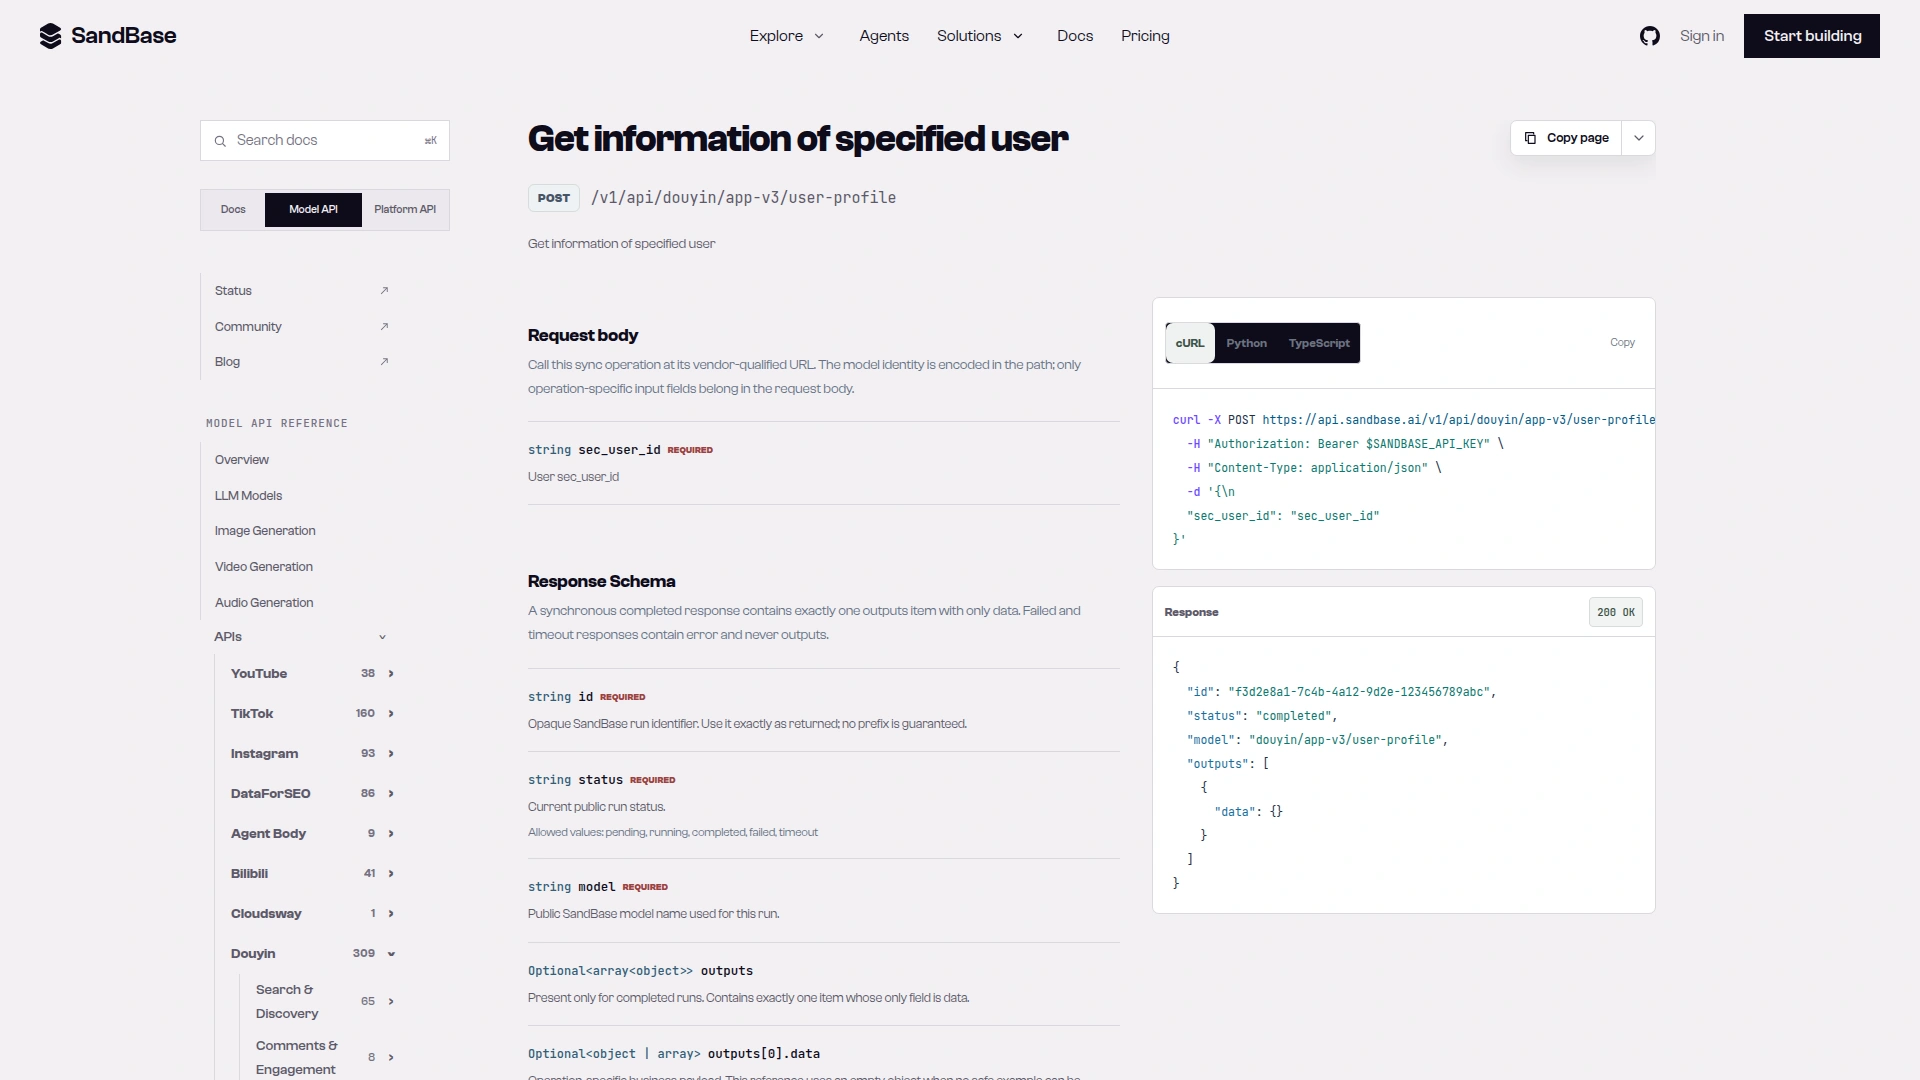
截图:user-profile 参考页写明 POST /v1/api/douyin/app-v3/user-profile,请求体只有 sec_user_id,与上面的代码一致(2026-10-02 截取)。
参考文档记录的完成态负载在 outputs[0].data;调用未完成时代码会直接抛错。用别家服务的话,换成对应的 URL 和参数即可。
Tested on 2026-10-01(UTC),测试对象是人民日报的公开官方账号:
curl -X POST https://api.sandbase.ai/v1/api/douyin/app-v3/user-profile \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"sec_user_id": "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4"}'
截短后的返回(删掉了大部分字段):
{
  "id": "54cc210f-6dff-487b-ad3e-21a3ccce34cb",
  "status": "completed",
  "model": "douyin/app-v3/user-profile",
  "outputs": [{
    "data": {
      "status_code": 0,
      "user": {
        "nickname": "人民日报",
        "unique_id": "rmrbxmt",
        "enterprise_verify_reason": "人民日报官方账号",
        "follower_count": 203209774,
        "aweme_count": 12276
      }
    }
  }]
}
上面 user 里的字段(nickname、unique_id、follower_count、aweme_count)来自这次调用,属于实测观察,不是文档保证,读取时用 .get()。
做预算前,到端点的模型页确认价格:
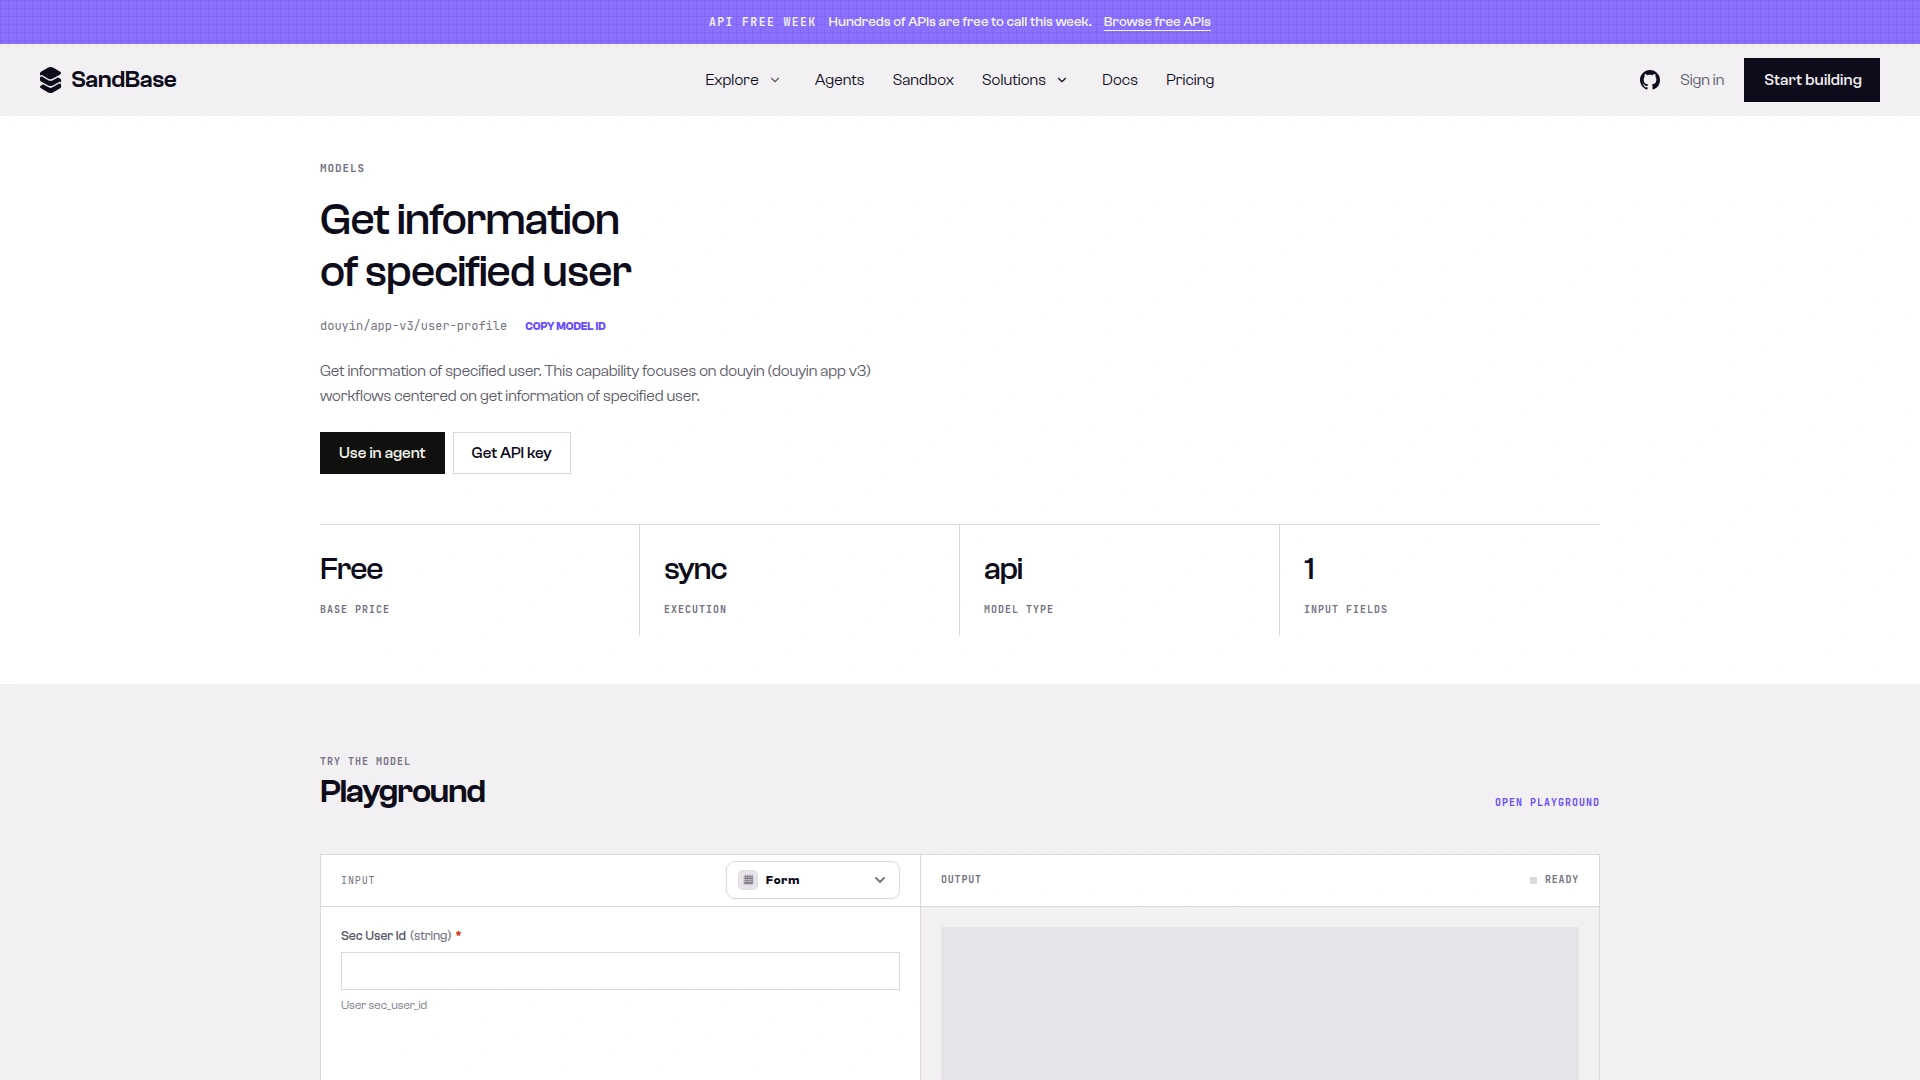
截图:douyin/app-v3/user-profile 模型页标注 Base price 为 Free、执行方式 sync、输入字段 1 个,对应上文的同步调用和定价说明(2026-10-02 截取)。
Agent 工具模式
把同一个函数暴露成工具,让模型在推理循环里调用:
tools = [{
    "type": "function",
    "function": {
        "name": "get_douyin_user",
        "description": "按 sec_user_id 获取抖音账号的公开主页信息",
        "parameters": {
            "type": "object",
            "properties": {
                "sec_user_id": {"type": "string", "description": "抖音 sec_user_id"}
            },
            "required": ["sec_user_id"]
        }
    }
}]

# 模型返回 get_douyin_user 工具调用时,执行
# get_douyin_user(args["sec_user_id"]),把结果作为 tool 消息发回去。
批量模式
import asyncio


async def batch_get_profiles(sec_user_ids: list[str]) -> list[dict]:
    tasks = [get_douyin_user(s) for s in sec_user_ids]
    results = await asyncio.gather(*tasks, return_exceptions=True)
    return [r for r in results if not isinstance(r, Exception)]
承诺前要做的测试
- 延迟测试。 对最常用操作发 100 次请求。检查 P50 和 P99。
- 错误率测试。 跑 1,000 次请求。失败百分比?失败可重试吗?
- Schema 稳定性。 连续一周每天调同一端点。响应结构变了吗?
- 限流行为。 超限时什么表现?优雅的 429 还是静默丢弃?
- 边界情况。 试已注销账号、没有公开视频的账号、无评论视频。API 怎么处理?
- 成本预估。 估算月请求量 × 单价 + 20% 重试缓冲。
生态视角
抖音数据 API 不是孤立存在的。对跨中国社媒平台的 AI Agent 来说,你大概率还需要微博、小红书甚至 TikTok 数据。选择覆盖多平台且接口一致的供应商,能减少集成负担并简化 Agent 工具定义。
统一平台意味着:
- 所有平台一种认证机制
- 一致的错误处理模式
- 单一计费关系
- 跨平台数据关联时更少的 schema 映射
这是生态平台相对于单平台供应商的优势:不是某个具体端点更好,而是集成开销被分摊到了整个数据面上。
想动手试试:创建 SandBase API Key、浏览抖音目录,或打开 user-profile 端点参考。
结论
“最佳”抖音数据 API 取决于你在构建什么。Agent 开发者:优先同步设计、按次计费和跨频道操作广度。研究人员:优先数据新鲜度和历史深度。营销人员:优先星图覆盖和公开达人指标。
难点不再是”能否程序化获取抖音公开数据”,而是”哪个服务匹配我的架构和场景”。向服务商要文档化的 SLA 和价格,再用你自己的调用验证延迟和错误率。
按以上六个维度评估,执行描述的测试,选择强项对齐你最高优先需求的供应商。