用 Agent 自动筛小红书 KOL
教程:用公开的蒲公英和笔记数据搭一个小红书 KOL 筛选 Agent,按单篇平均互动、收藏占比、30 天涨粉和 LLM 内容匹配度排名。
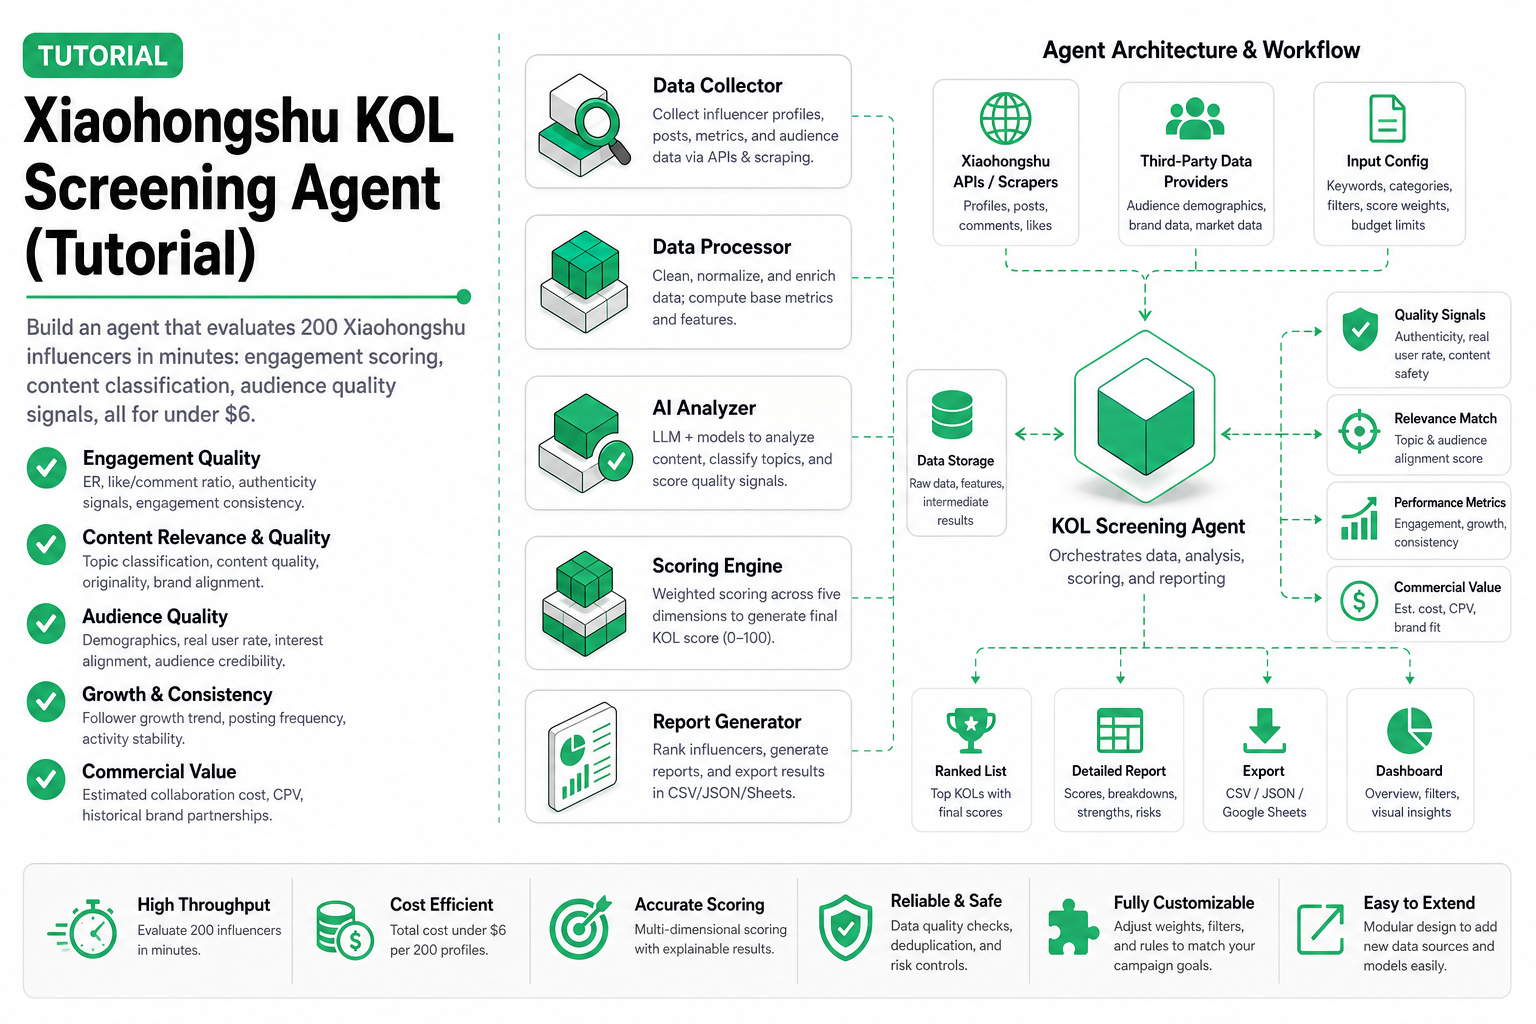
先说结论 — 一个 Python agent:从蒲公英(PGY)拉 KOL 候选人,抽样每个人的近期笔记,按「抽样笔记单篇平均互动」「30 天涨粉」「蒲公英互动中位数信号」和「LLM 内容匹配度」打分,输出排名 CSV。200 个候选人约 610 次数据调用。其中 410 次蒲公英调用不在每日免费调用范围内,从第一次调用起就按 SandBase 目录价计费;只有 200 次
app-v2/user-posted-notes调用能使用组织每天 100 次免费调用,用完后同样按次计费。此外还有 200 次简短的 LLM 调用,LLM 部分按 token 数估算约 $0.50 到 $1.20。
品牌选小红书 KOL 做投放,传统做法:一个个打开主页、刷帖子、肉眼估互动、跨候选人比较,最后排名。这个 agent 接手重复的部分:对每个候选人拉同样的公开数据、按同一套规则打分,写出一份排好序的 CSV 给团队复核。
Agent 输出什么
每个候选 KOL 的评估结果:
| 输出 | 数据来源 | SandBase 价格 |
|---|---|---|
候选人列表(userId) | xiaohongshu/pgy/blogger-list | 按次计费(见目录页) |
蒲公英博主资料(name、fansNum、互动中位数 interMidNum) | xiaohongshu/pgy/blogger-detail | 按次计费(见目录页) |
| 粉丝序列(最近 30 个日点) | xiaohongshu/pgy/blogger-fans-history | 按次计费(见目录页) |
| 抽样近期笔记的文字和互动数(第一页,最多 10 条) | xiaohongshu/app-v2/user-posted-notes | 按次计费(见目录页) |
| 抽样笔记单篇平均互动、收藏占比 | 从笔记样本计算 | — |
| LLM 内容匹配度(1-10)和一句话理由 | anthropic/claude-sonnet-4 | 按 token 计费(见费用) |
最终产出:按总分排名的 CSV,含上面的指标、总分、LLM 理由和红旗标记。
评分模型
总分 = 0.3 × 互动分
     + 0.25 × 内容匹配
     + 0.25 × 增长分
     + 0.2 × 粉丝质量信号
每一项都是 0–10 分,和代码的算法完全一致:
- 互动分:抽样笔记的单篇平均互动(互动 =
likes + comments_count + collected_count)除以 500,封顶 10。这是原始平均值,不是比率:分母里没有曝光,也没有粉丝数。 - 内容匹配:LLM 读最多 10 条抽样笔记的标题(没有标题用正文),按品牌品类给 1–10 分。它只看文字,不看图片。
- 增长分:蒲公英粉丝序列最近 30 个日点的
(末值 − 首值) / 首值,× 100,限制在 0–10(涨 10% 及以上记 10 分,掉粉记 0 分)。 - 粉丝质量信号:蒲公英
interMidNum(互动中位数)除以fansNum,× 200,封顶 10(5% 及以上记 10 分)。
写进 CSV 的红旗:
- 粉丝超过 10 万,但抽样笔记单篇平均互动不到 100
- 30 天窗口里任意一天粉丝变化超过首日粉丝数的 10%
- 收藏不到抽样互动的 5%
数据边界
本文只用公开、只读的小红书数据,需要 SandBase API Key,不代表与小红书有官方合作;不访问私密账号、私信、仅账号主可见的数据分析,也不做发布或任何账号操作。
| SandBase 公开数据端点 | 小红书官方开放平台 | |
|---|---|---|
| 鉴权 | 一把 SandBase API Key | 小红书开发者或账号授权 |
| 范围 | 公开的博主、笔记、蒲公英列表数据 | 你被授权的账号和业务 |
| 写操作(发布、私信、下单) | 无 | 取决于授权的集成 |
| 适合 | 在大量公开博主里做调研和初筛 | 需要账号主级别数据或要操作账号 |
端点和实测记录
所有数据调用都走 SandBase 的 Model API 路由 POST https://api.sandbase.ai/v1/api/<vendor>/<path>,JSON body 只放该端点自己的参数,鉴权用 Authorization: Bearer $SANDBASE_API_KEY。端点参考:
xiaohongshu/pgy/blogger-list(必填brand_user_id;page_num从 1 开始,page_size1–100;粉丝区间筛选见下文「blogger-list哪种筛选字段真正生效」)xiaohongshu/pgy/blogger-detail(user_id)xiaohongshu/pgy/blogger-fans-history(user_id,date_type:1 ≈ 7 天、2 ≈ 30 天、3 ≈ 90 天)xiaohongshu/app-v2/user-posted-notes(user_id;首次请求cursor留空)
小红书目录页截至 2026-10-01 列出 34 个端点。目录页展示的是另一套 GET /apis/v1/... 路径,本教程用的是上面的 POST 路由。
目录页上能直接看到 34 这个数,以及这个 agent 要调的蒲公英端点,选中的卡片标着 Available。
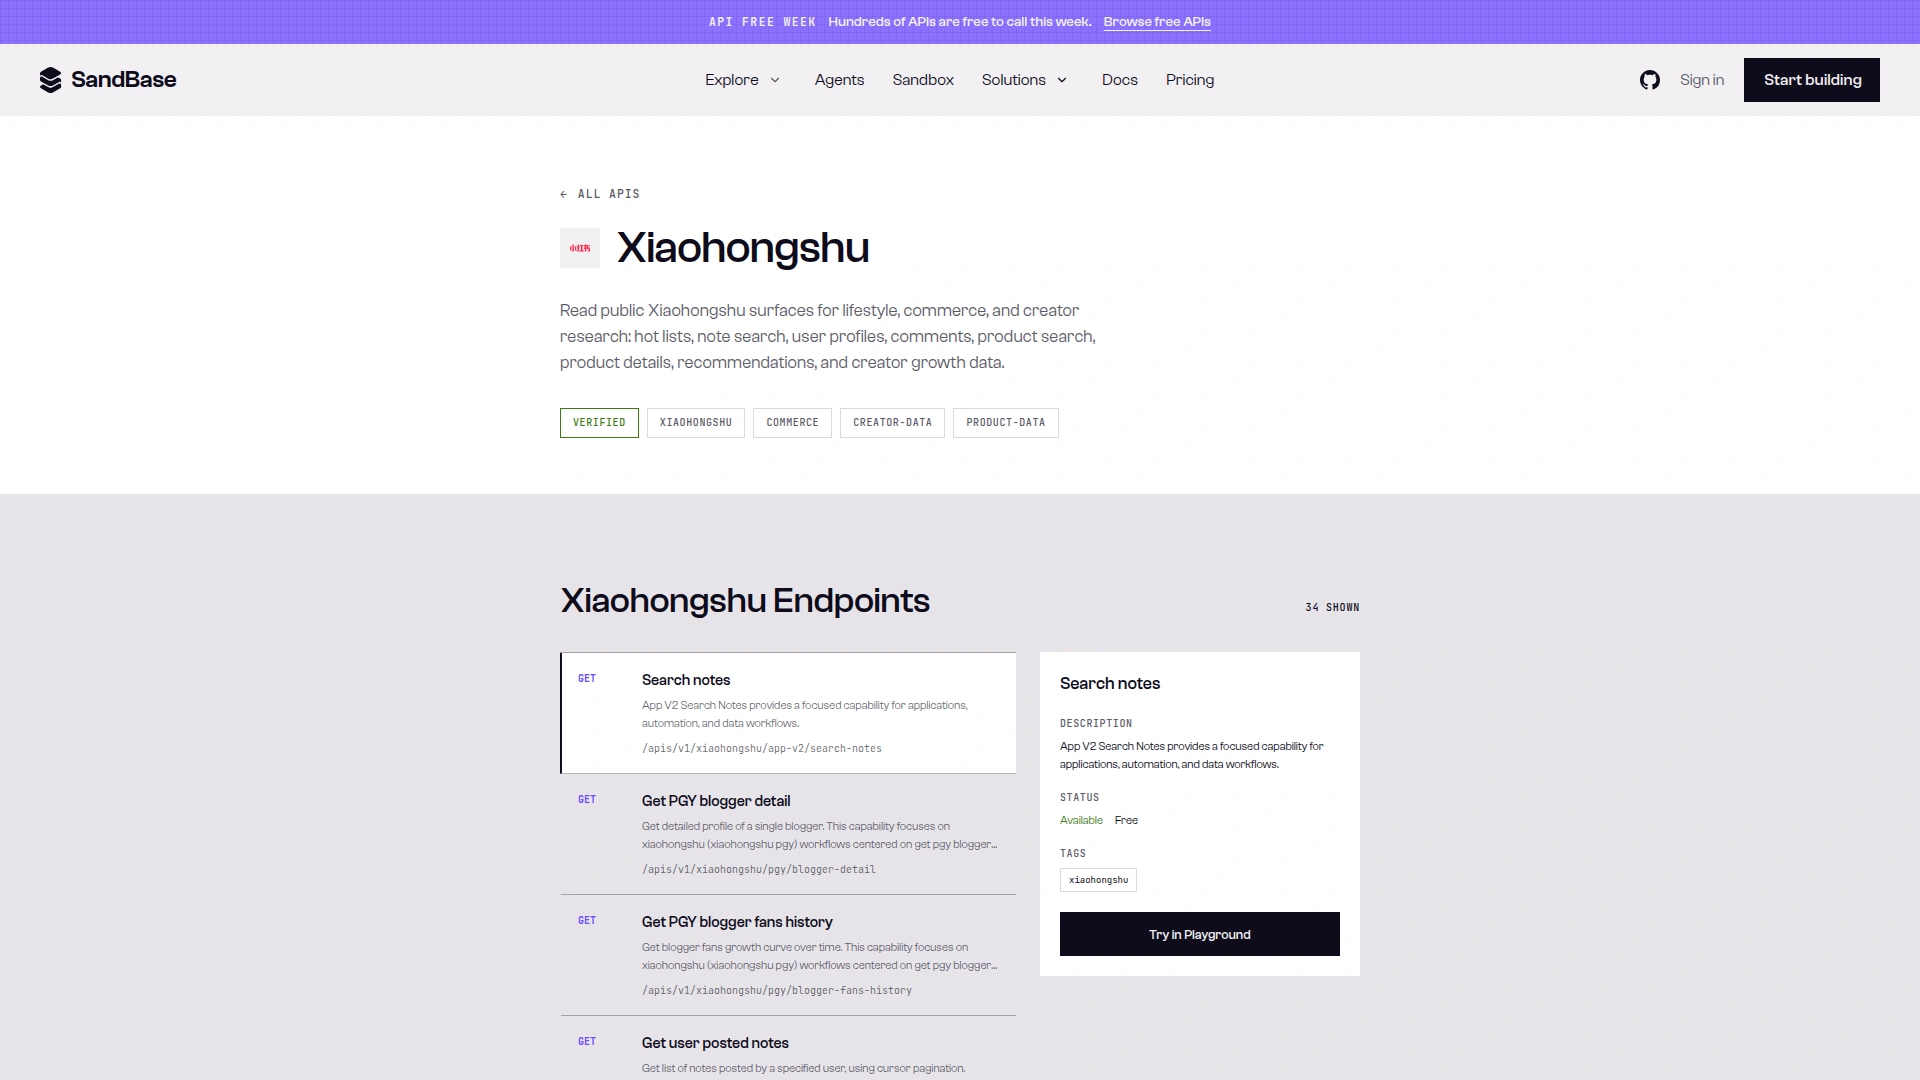
截图:SandBase 小红书目录页列出 34 个端点,其中有 pgy/blogger-detail 和 pgy/blogger-fans-history,选中卡片显示 Available 和 Free(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
实测记录:2026-10-01(UTC)
公开资源:完美日记(Perfect Diary)官方品牌账号,user id 59ae4dfc5e87e72475fb3bf3。
curl -s https://api.sandbase.ai/v1/api/xiaohongshu/pgy/blogger-detail \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"user_id": "59ae4dfc5e87e72475fb3bf3"}'
截短后的返回(run id 7476e66a-35d3-4e41-8c8d-a345ca4c7237):
{
  "id": "7476e66a-35d3-4e41-8c8d-a345ca4c7237",
  "status": "completed",
  "model": "xiaohongshu/pgy/blogger-detail",
  "outputs": [{"data": {"code": 0, "data": {
    "userId": "59ae4dfc5e87e72475fb3bf3",
    "name": "Perfect Diary完美日记",
    "fansNum": 1835170,
    "interMidNum": 0
  }}}]
}
blogger-fans-history 传 {"user_id": "59ae4dfc5e87e72475fb3bf3", "date_type": 2}(run id 2b0cdf3e-6597-47c3-8ca3-60fed77ef5c3)返回了 60 个日点,所以代码只取最后 30 个:
{"code": 0, "data": {"fansNumInc": -9214, "list": [
  {"dateKey": "2026-08-02", "num": 1842991}, "…",
  {"dateKey": "2026-09-30", "num": 1833777}
]}}
user-posted-notes 传 {"user_id": "59ae4dfc5e87e72475fb3bf3"}(run id f30a6744-3ef2-4204-8081-bc64645e3fc5)返回 20 条笔记,has_more: true。截取一条:
{"id": "6abcd6f600000000020115f9", "cursor": "6abcd6f600000000020115f9",
 "title": "🦌新成员集结|小鹿限定线上开售",
 "likes": 37, "comments_count": 33, "collected_count": 22}
blogger-list 哪种筛选字段真正生效
两个公开页面对粉丝区间的传法说法不一致。端点参考文档列的是扁平的字符串参数 fans_number_lower / fans_number_upper;模型页列了 16 个输入字段,其中有嵌套的 blogger(博主属性,比如 content_tag)和 fans(粉丝画像,比如 count: {min, max}),没有 fans_number_*。我在 2026-10-01(UTC)把两种写法都发了一遍,都带 brand_user_id = 完美日记、page_num: 1、page_size: 20,然后比较返回的 20 条 kols[] 的 fansNum:
| 额外发送的字段 | Run id | data.total | 20 条结果的 fansNum 范围 |
|---|---|---|---|
| 无(基线) | b9923cbd-a6ac-43a5-864a-d733835c5eaa | 5000 | 10,394 – 679,562 |
"fans_number_lower": "100000", "fans_number_upper": "200000" | 82513a86-a5ea-457d-a427-80a8e420bc63 | 5000 | 10,394 – 679,562 |
"fans": {"count": {"min": 100000, "max": 200000}} | 81e9474f-220b-4673-9a8f-2cc9afddb1c3 | 10000 | 100,253 – 199,199 |
"fans_number_lower": "10000", "fans_number_upper": "500000" + "blogger": {"content_tag": ["美妆"]} | 6890bd60-e050-48d4-b642-2ccd064f1af0 | 10000 | 6,486 – 2,654,665 |
"fans": {"count": {"min": 10000, "max": 500000}} + "blogger": {"content_tag": ["美妆"]} | 3e77814e-7fe1-4a09-9de9-c3b0e427995c | 10000 | 13,525 – 331,423 |
说法不一致的两个页面如下。端点参考文档在 brand_user_id、page_num、page_size 旁边列的是扁平的 fans_number_lower / fans_number_upper:
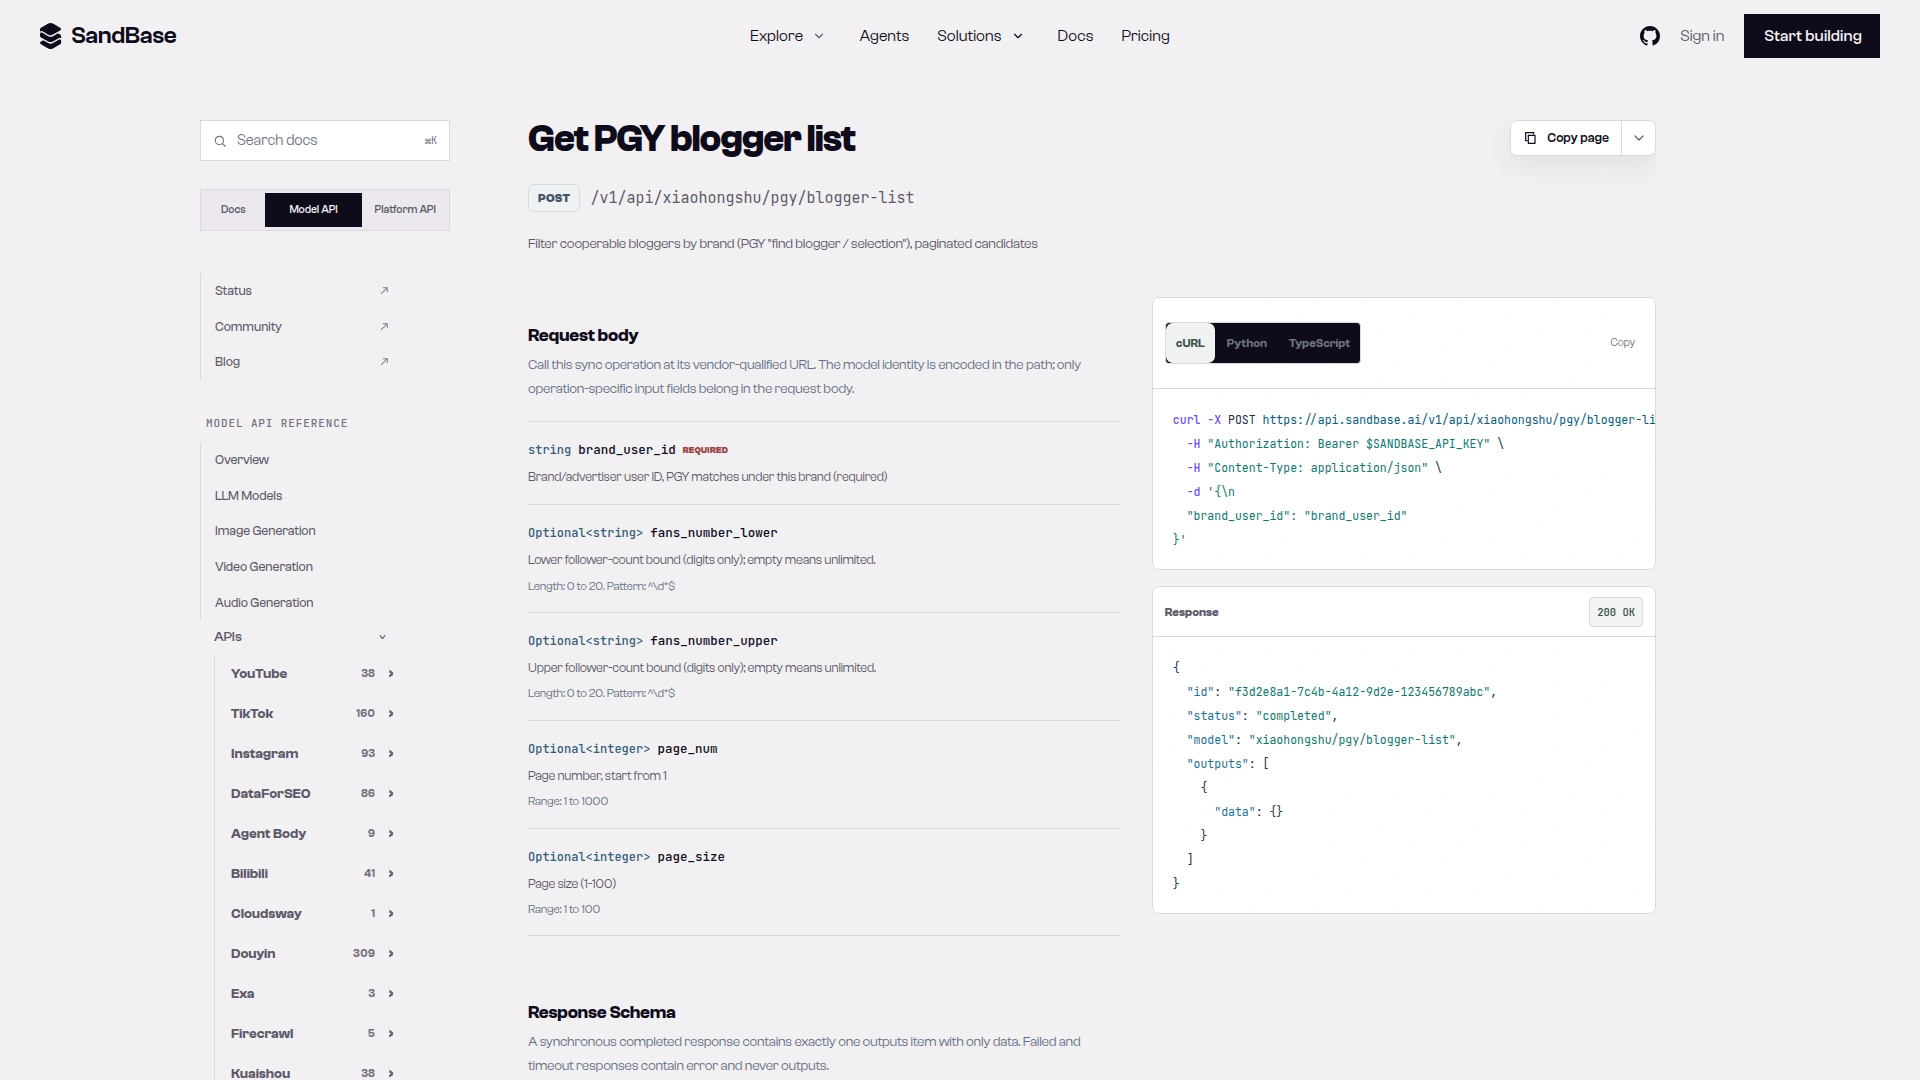
截图:xiaohongshu/pgy/blogger-list 参考页显示 POST /v1/api/xiaohongshu/pgy/blogger-list 路由,以及上面实测中不生效的扁平参数 fans_number_lower / fans_number_upper(2026-10-02 截取)。
模型页则显示 16 个输入字段:
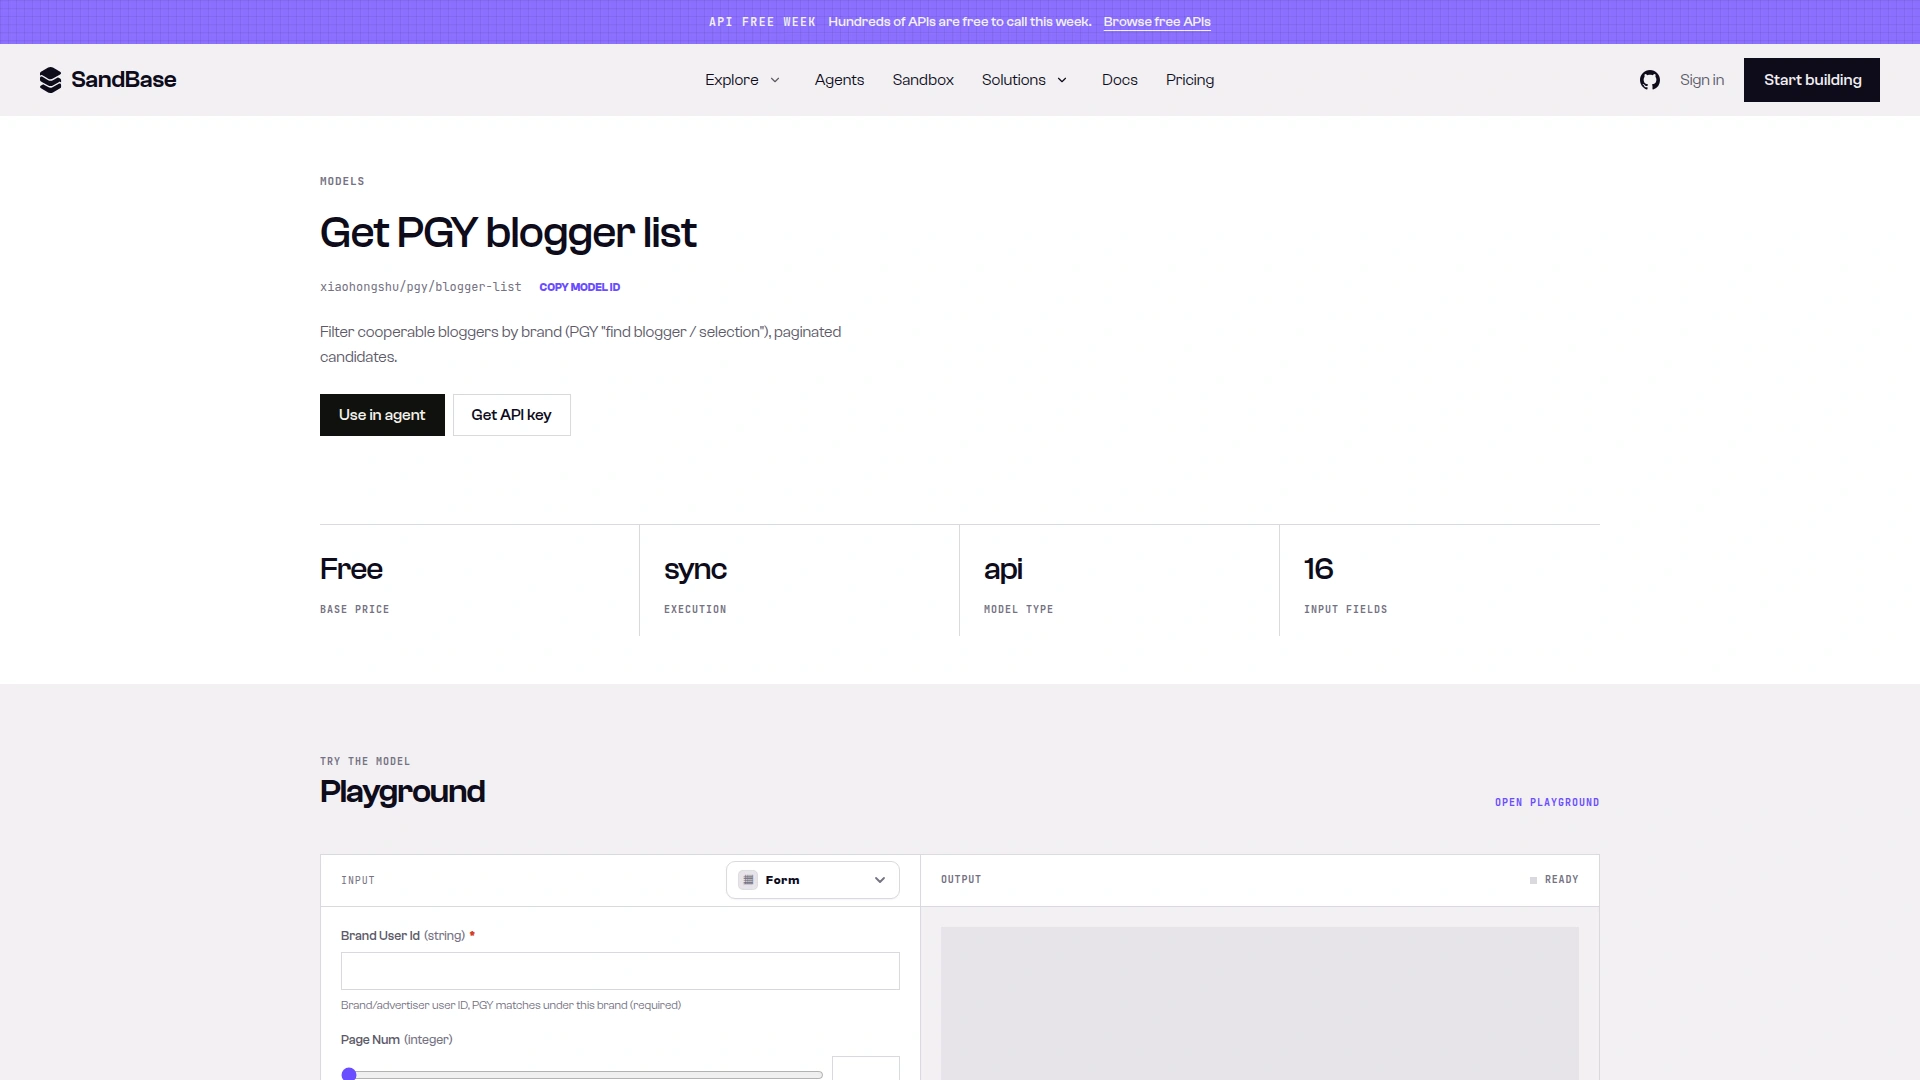
截图:xiaohongshu/pgy/blogger-list 模型页显示基础价格 Free、同步执行、16 个输入字段,嵌套的 fans 和 blogger 筛选就在这套字段里(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
fans_number_* 参数被接受了(状态 completed),但没有起筛选作用,结果和基线一样;嵌套的 fans.count 生效了,每条结果都落在区间内。所以下面的代码用 blogger.content_tag 和 fans.count。这是这几次调用的实测行为,不是文档保证;如果以后参考文档和接口对齐了,用之前再测一次。返回的都是个人博主,这里只给汇总数字;每条都带 userId、fansNum、interMidNum、contentTags。
哪些是文档、哪些是观测:端点参考文档记录了请求参数(blogger-list 嵌套的 blogger / fans 筛选见模型页)和信封(id、status、model、outputs[0].data)。data 里面的业务字段(name、fansNum、interMidNum、list[].num、notes[].likes、comments_count、collected_count、kols[].userId)来自上面这些调用,仅为观测结果、不是文档保证,代码一律用 .get() 读。品牌账号不是蒲公英博主,这大概就是 interMidNum 为 0 的原因;blogger-list 返回的博主这个值不为 0。
完整代码
#!/usr/bin/env python3
"""小红书 KOL 筛选 agent。

从蒲公英拉候选人,抽样笔记,打分,输出排名 CSV。
"""

import csv
import json
import os
import time
from dataclasses import dataclass

import requests
from openai import OpenAI

SANDBASE_API_KEY = os.environ["SANDBASE_API_KEY"]
HEADERS = {
    "Authorization": f"Bearer {SANDBASE_API_KEY}",
    "Content-Type": "application/json",
}

# OpenAI 客户端仅用于 LLM 调用
client = OpenAI(
    base_url="https://api.sandbase.ai/v1",
    api_key=SANDBASE_API_KEY,
)


@dataclass
class KOLScore:
    blogger_id: str
    nickname: str
    follower_count: int
    avg_interactions_per_note: float
    save_share: float
    growth_30d: float
    audience_score: float
    content_fit: float
    total_score: float
    reasoning: str
    red_flags: list[str]


def run_model(model: str, **params) -> dict:
    """POST /v1/api/<model>,返回 outputs[0].data 里上游的 `data` 对象。"""
    resp = requests.post(
        f"https://api.sandbase.ai/v1/api/{model}",
        headers=HEADERS,
        json=params,
        timeout=90,
    )
    resp.raise_for_status()
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    payload = outputs[0].get("data") or {}
    return payload.get("data") or {}


def fetch_candidates(brand_user_id: str, content_tag: str, min_fans: int, max_fans: int,
                     pages: int = 10, page_size: int = 20) -> list[str]:
    """翻页调用蒲公英 blogger-list,返回候选人 userId。"""
    ids = []
    for page in range(1, pages + 1):
        data = run_model(
            "xiaohongshu/pgy/blogger-list",
            brand_user_id=brand_user_id,
            blogger={"content_tag": [content_tag]},
            fans={"count": {"min": min_fans, "max": max_fans}},
            page_num=page,
            page_size=page_size,
        )
        kols = data.get("kols") or []
        ids += [k["userId"] for k in kols if k.get("userId")]
        if not kols:  # 返回条数少于 page_size 不代表到底了,空页才停
            break
    return ids


def fetch_blogger_detail(blogger_id: str) -> dict:
    """蒲公英博主概况(昵称、粉丝数、互动中位数)。"""
    return run_model("xiaohongshu/pgy/blogger-detail", user_id=blogger_id)


def fetch_fans_history(blogger_id: str) -> dict:
    """粉丝历史(参考文档里 date_type=2 约为 30 天)。"""
    return run_model("xiaohongshu/pgy/blogger-fans-history", user_id=blogger_id, date_type=2)


def fetch_recent_notes(blogger_id: str, count: int = 10) -> list:
    """抽样博主自己发布笔记的第一页(不传 cursor 即第一页)。"""
    data = run_model("xiaohongshu/app-v2/user-posted-notes", user_id=blogger_id)
    return (data.get("notes") or [])[:count]


def compute_engagement_metrics(notes: list) -> dict:
    """抽样笔记单篇平均互动,以及收藏在互动中的占比。"""
    if not notes:
        return {"avg_interactions_per_note": 0, "save_share": 0}

    total_likes = sum(n.get("likes") or 0 for n in notes)
    total_comments = sum(n.get("comments_count") or 0 for n in notes)
    total_saves = sum(n.get("collected_count") or 0 for n in notes)
    total_interactions = total_likes + total_comments + total_saves

    return {
        "avg_interactions_per_note": total_interactions / len(notes),
        "save_share": total_saves / max(total_interactions, 1),
    }


def compute_growth(fans_history: dict) -> dict:
    """最近 30 个日点的粉丝增长,外加单日暴涨检查。"""
    data_points = (fans_history.get("list") or [])[-30:]
    if len(data_points) < 2:
        return {"growth_30d": 0, "spike_detected": False}

    first = data_points[0].get("num") or 0
    last = data_points[-1].get("num") or 0
    growth_rate = (last - first) / max(first, 1)

    max_daily_change = 0
    for i in range(1, len(data_points)):
        daily_change = abs((data_points[i].get("num") or 0) - (data_points[i - 1].get("num") or 0))
        max_daily_change = max(max_daily_change, daily_change)

    spike_threshold = first * 0.1  # 单日变化超过 10% 视为可疑
    return {
        "growth_30d": growth_rate,
        "spike_detected": max_daily_change >= spike_threshold > 0,
    }


def score_content_fit(notes: list, brand_category: str) -> dict:
    """LLM 根据抽样笔记标题/正文给内容匹配度打分。"""
    if not notes:
        return {"score": 0, "reasoning": "没有笔记"}

    titles = [(n.get("title") or n.get("desc") or "")[:100] for n in notes[:10]]

    resp = client.chat.completions.create(
        model="anthropic/claude-sonnet-4",
        messages=[{
            "role": "user",
            "content": f"""给这个博主的内容和「{brand_category}」品类的匹配度打分 1-10。

近期笔记标题/正文(最多 10 条):
{json.dumps(titles, ensure_ascii=False)}

评分标准:
- 1-3:完全无关
- 4-6:有交集但不是核心
- 7-9:品类高度对齐
- 10:完美匹配,正是目标受众

回复 JSON:{{"score": N, "reasoning": "一句话理由"}}"""
        }],
        max_tokens=200,
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"score": 5, "reasoning": "无法解析 LLM 回复"}


def screen_kol(blogger_id: str, brand_category: str) -> KOLScore:
    """完整筛一个候选人(3 次数据调用 + 1 次 LLM 调用)。"""
    detail = fetch_blogger_detail(blogger_id)
    fans = fetch_fans_history(blogger_id)
    notes = fetch_recent_notes(blogger_id, count=10)

    engagement = compute_engagement_metrics(notes)
    growth = compute_growth(fans)
    content = score_content_fit(notes, brand_category)

    red_flags = []
    follower_count = detail.get("fansNum") or detail.get("fansCount") or 0
    if follower_count > 100000 and engagement["avg_interactions_per_note"] < 100:
        red_flags.append("粉丝多互动少")
    if growth.get("spike_detected"):
        red_flags.append("单日涨粉超过 10%")
    if engagement["save_share"] < 0.05:
        red_flags.append("收藏不到互动的 5%")

    # 每一项都是 0-10 分
    engagement_score = min(engagement["avg_interactions_per_note"] / 500, 10)
    growth_score = max(0, min(growth["growth_30d"] * 100, 10))  # 涨 10% = 10 分,掉粉 = 0 分
    median_interactions = detail.get("interMidNum") or 0
    audience_score = min(median_interactions / max(follower_count, 1) * 200, 10)  # 5% = 10 分
    content_score = content.get("score", 5)

    total = (
        0.3 * engagement_score
        + 0.25 * content_score
        + 0.25 * growth_score
        + 0.2 * audience_score
    )

    return KOLScore(
        blogger_id=blogger_id,
        nickname=detail.get("name") or "未知",
        follower_count=follower_count,
        avg_interactions_per_note=engagement["avg_interactions_per_note"],
        save_share=engagement["save_share"],
        growth_30d=growth["growth_30d"],
        audience_score=round(audience_score, 2),
        content_fit=content_score,
        total_score=round(total, 2),
        reasoning=content.get("reasoning", ""),
        red_flags=red_flags,
    )


def run_screening(blogger_ids: list[str], brand_category: str, output_path: str):
    """筛完所有候选人,输出排名 CSV。"""
    results: list[KOLScore] = []

    for i, blogger_id in enumerate(blogger_ids):
        print(f"[{i+1}/{len(blogger_ids)}] 筛选 {blogger_id}...")
        try:
            results.append(screen_kol(blogger_id, brand_category))
        except Exception as e:
            print(f"  出错:{e}")
        time.sleep(0.5)  # 候选人之间稍作停顿(不是文档规定的限制)

    results.sort(key=lambda x: x.total_score, reverse=True)

    with open(output_path, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.writer(f)
        writer.writerow([
            "排名", "昵称", "博主 ID", "粉丝数", "单篇平均互动",
            "收藏占比", "30 天增长", "粉丝质量信号", "内容匹配",
            "总分", "理由", "红旗"
        ])
        for rank, r in enumerate(results, 1):
            writer.writerow([
                rank, r.nickname, r.blogger_id, r.follower_count,
                f"{r.avg_interactions_per_note:.0f}", f"{r.save_share:.2%}",
                f"{r.growth_30d:.1%}", r.audience_score, r.content_fit,
                r.total_score, r.reasoning, "; ".join(r.red_flags) or "无"
            ])

    print(f"\n筛选完成,共 {len(results)} 个 KOL。")
    print(f"输出:{output_path}")
    for r in results[:5]:
        print(f"  {r.nickname}: {r.total_score}({r.reasoning})")


if __name__ == "__main__":
    # 完美日记的公开品牌账号 id,上面实测时用作 brand_user_id;换成你自己品牌的账号 id
    BRAND_USER_ID = "59ae4dfc5e87e72475fb3bf3"
    candidate_ids = fetch_candidates(BRAND_USER_ID, "美妆", 10_000, 500_000, pages=10)  # 最多 200 个
    run_screening(candidate_ids, brand_category="美妆护肤", output_path="kol_ranking.csv")
我在 2026-10-01(UTC)用 pages=1, page_size=5 重新跑了这段程序,LLM 调用打桩,其余和上面的代码一致。blogger-list(run id 1738b066-86cc-488f-b14e-cea628ee40c0,发送 blogger.content_tag: ["美妆"] 和 fans.count: {min: 10000, max: 500000})在 page_size 为 5 时返回了 4 个候选人,所以循环以空页而不是短页作为结束条件。这 4 人的 blogger-detail 粉丝数在 30,070 到 241,830 之间,都在请求的区间内。之后 12 次逐个候选人的调用都通过 /v1/api/... 返回 completed(例如 fa8a3863-b10a-4b3e-a0ee-a150be90cb39、5a754f3d-eac2-4d27-b202-47eacca26c10、284084d3-121e-4703-a725-3022859187aa),CSV 得到 4 行排名。user-posted-notes 是游标分页;代码有意只读第一页,因为样本就是最近 10 条。想往前翻,按参考文档把最后一条笔记的 cursor 作为下一次请求的 cursor 传入。
下一步:获取 SandBase API Key、浏览小红书目录,或打开 blogger-detail 参考文档。
200 人费用估算
| 操作 | 调用次数 | SandBase 价格 |
|---|---|---|
pgy/blogger-list(每页 20) | 10 | 从第一次调用起计费,不在免费调用范围内(见目录页) |
pgy/blogger-detail | 200 | 从第一次调用起计费,不在免费调用范围内(见目录页) |
pgy/blogger-fans-history | 200 | 从第一次调用起计费,不在免费调用范围内(见目录页) |
app-v2/user-posted-notes | 200 | 可使用每日免费调用,用完后按次计费(见目录页) |
anthropic/claude-sonnet-4 内容匹配 | 200 | 输入 $3/百万 token,输出 $15/百万 token |
每个组织每天(UTC)在符合条件的 API 上有 100 次免费数据调用。三个蒲公英端点(610 次里的 410 次)不符合条件,从第一次调用起就按目录价计费。只有 200 次 app-v2/user-posted-notes 调用会用到免费调用,每天最多覆盖其中 100 次,其余按次计费。大批量跑之前,用上面的调用次数乘以各端点在小红书目录(或 sandbase inspect)里的单价。
LLM 估算(不是报价,按实际 token 计费):每次评分的 prompt 带最多 10 条、每条不超过 100 字的笔记标题,加一段简短指令。我测试时,英文版 prompt 在 564 到 594 个字符之间,本页中文版 prompt 在 366 到 396 个字符之间。回复是一个 JSON 分数加一句话(max_tokens=200 封顶),两种场景:
| 场景 | 输入 token | 输出 token | 每次 | 200 次 |
|---|---|---|---|---|
| 标题较短,和测试时一样 | ~500 | ~60 | 500 × $3/M + 60 × $15/M = $0.0024 | ~$0.48 |
| 标题较长,回复打满上限 | ~1,000 | 200 | 1,000 × $3/M + 200 × $15/M = $0.006 | ~$1.20 |
省钱的办法:
- 第一轮跳过粉丝历史:先按互动和内容匹配排序,只给前 50 名查粉丝历史。需要小改
screen_kol,数据调用从约 610 次降到约 460 次。 - 内容匹配换便宜模型:用
openai/gpt-4.1-mini(输入 $0.40/M、输出 $1.60/M),「标题较长」场景每次 1,000 × $0.40/M + 200 × $1.60/M ≈ $0.0007,200 次约 $0.14。 - 10 个 KOL 合成一个 prompt 能把调用次数降到 20 次,但只省掉重复的指令文字;笔记标题和回复照样随 KOL 数量增长。
局限
- 蒲公英覆盖:不是所有博主都在蒲公英上。不在的账号(比如实测里的品牌账号)
interMidNum返回 0,粉丝质量信号就是 0 分。候选池用blogger-list返回的博主,它们都是蒲公英博主 - 原始平均,不是比率:互动分是抽样笔记的单篇平均互动,对大号有利。想要按粉丝算的比率,自己除以
fansNum再重新缩放 - 样本小:只取第一页的 10 条,可能包含置顶或较早的笔记
- LLM 主观性:只看标题。建议先用 10 个已知好 + 10 个已知差的 KOL 校准 prompt
- 不能检测刷量:单日暴涨检查只是启发式。高投入活动建议结合专门的审计工具
FAQ
怎么拿 200 个候选 ID?
上面的 fetch_candidates() 按内容标签和粉丝区间翻页调用 xiaohongshu/pgy/blogger-list。参考文档把 brand_user_id 标为必填;我测试时用完美日记的公开账号 id 可以跑通。候选人在 data.kols[] 下,每条带 userId,可以直接传给其他函数(实测观察)。
美妆以外的品类能用吗?
能。改传给 fetch_candidates() 的 content_tag(比如「美食」「母婴」)和给 LLM 的 brand_category。
200 人跑多久?
取决于上游响应时间,波动较大。程序大约顺序发 610 次数据调用和 200 次 LLM 调用,每个候选人之间停 0.5 秒。我 2026-10-01 测试的 38 次数据调用(LLM 打桩)里,中位数约 2.6 秒,最慢约 16 秒;有 1 次返回瞬时 HTTP 503,循环会记录错误并跳过这个候选人。不能丢候选人的话,给 run_model 加重试。先用 pages=1 跑一小批计时,再自己推算。
总分多少算好?
没有通用分数线。先给 10 个你已经知道合适的 KOL 打分,用他们的分数区间当基准。
小红书数据覆盖看 小红书公开数据 API。社媒数据全景看 选型指南。