抖音公开数据 API | SandBase
用一个 REST API 读取抖音公开的榜单、搜索、视频和评论。无需抖音登录,无需 SDK,一把 SandBase key,为 agent 而建。
抖音是为十亿观众定义趋势的中国短视频引擎——排名榜单、品牌热搜、视频搜索,还有直接对应到趋势调研、品牌监测和内容分析的评论流。但想用程序拿到这些数据,通常得逆向 app、轮换设备 token,还要在 app 每次改版时重建爬虫。
SandBase 的抖音公开数据 API 把这层搭建成本去掉了。它通过普通 REST 端点读取抖音公开的榜单、搜索结果、视频和评论——一把 SandBase API key,不用抖音登录,也不用 SDK。端点 API 参考是每个参数和响应信封(id/status/model/outputs[0].data)的权威来源;下面展示的业务载荷字段名只是一个示例结构、并非保证的 schema,请以一份真实响应为准核对。
这不是抖音的官方开放平台。 如果你需要已认证的成员操作或一份授权的数据协议,请用抖音官方渠道;当你的流程需要的是公开、只读的数据(调研、监测)时,用 SandBase。想直接试?领取 SandBase API key,再浏览抖音端点。
先说结论
- 一个 API 读取抖音公开的榜单、品牌热搜、搜索结果、视频和评论。
- 本文的 Model API 端点用
POST /v1/api/douyin/<path>调用——只传该端点的参数,不用 SDK,一把SANDBASE_API_KEY。- 端点以自然标识为入参:视频用
aweme_id,搜索用keyword,或用视频url。- 它只返回公开、只读数据。不能发帖、你这边无需平台登录或 OAuth、也拿不到私密或账号授权的数据;鉴权用 SandBase API key。
你到底需要哪个抖音 API?
| 你的需求 | 选择 | 原因 |
|---|---|---|
| 发帖、以成员身份操作,或用账号授权数据 | 抖音官方渠道 | 成员和账号操作走抖音官方。 |
| 读取公开的榜单、搜索、视频或评论 | SandBase 抖音公开数据 API | 普通 REST、一把 SandBase key、面向只读流程的结构化 JSON。 |
| 创作者后台或账号授权的分析 | 都不适用于公开流程 | 需要登录的后台数据不在本篇公开数据的范围内。 |
从抖音 API 能拿到什么
整个目录横跨几个面(榜单、搜索、web 和 app 读取)。按用途归类:
- 榜单 —— 像高赞视频榜和品牌热搜这样的排名列表。
- 搜索 —— 按关键词搜视频、图片、音乐和挑战。
- 视频 —— 从 URL 解析出
aweme_id,再读视频和评论数据。 - 评论 —— 按
aweme_id读视频评论。
动手前请查每个端点的在线 API 参考,确认它所在的面和参数;可用性因端点而异,部分创作者后台端点需要的认证不在本篇范围内。
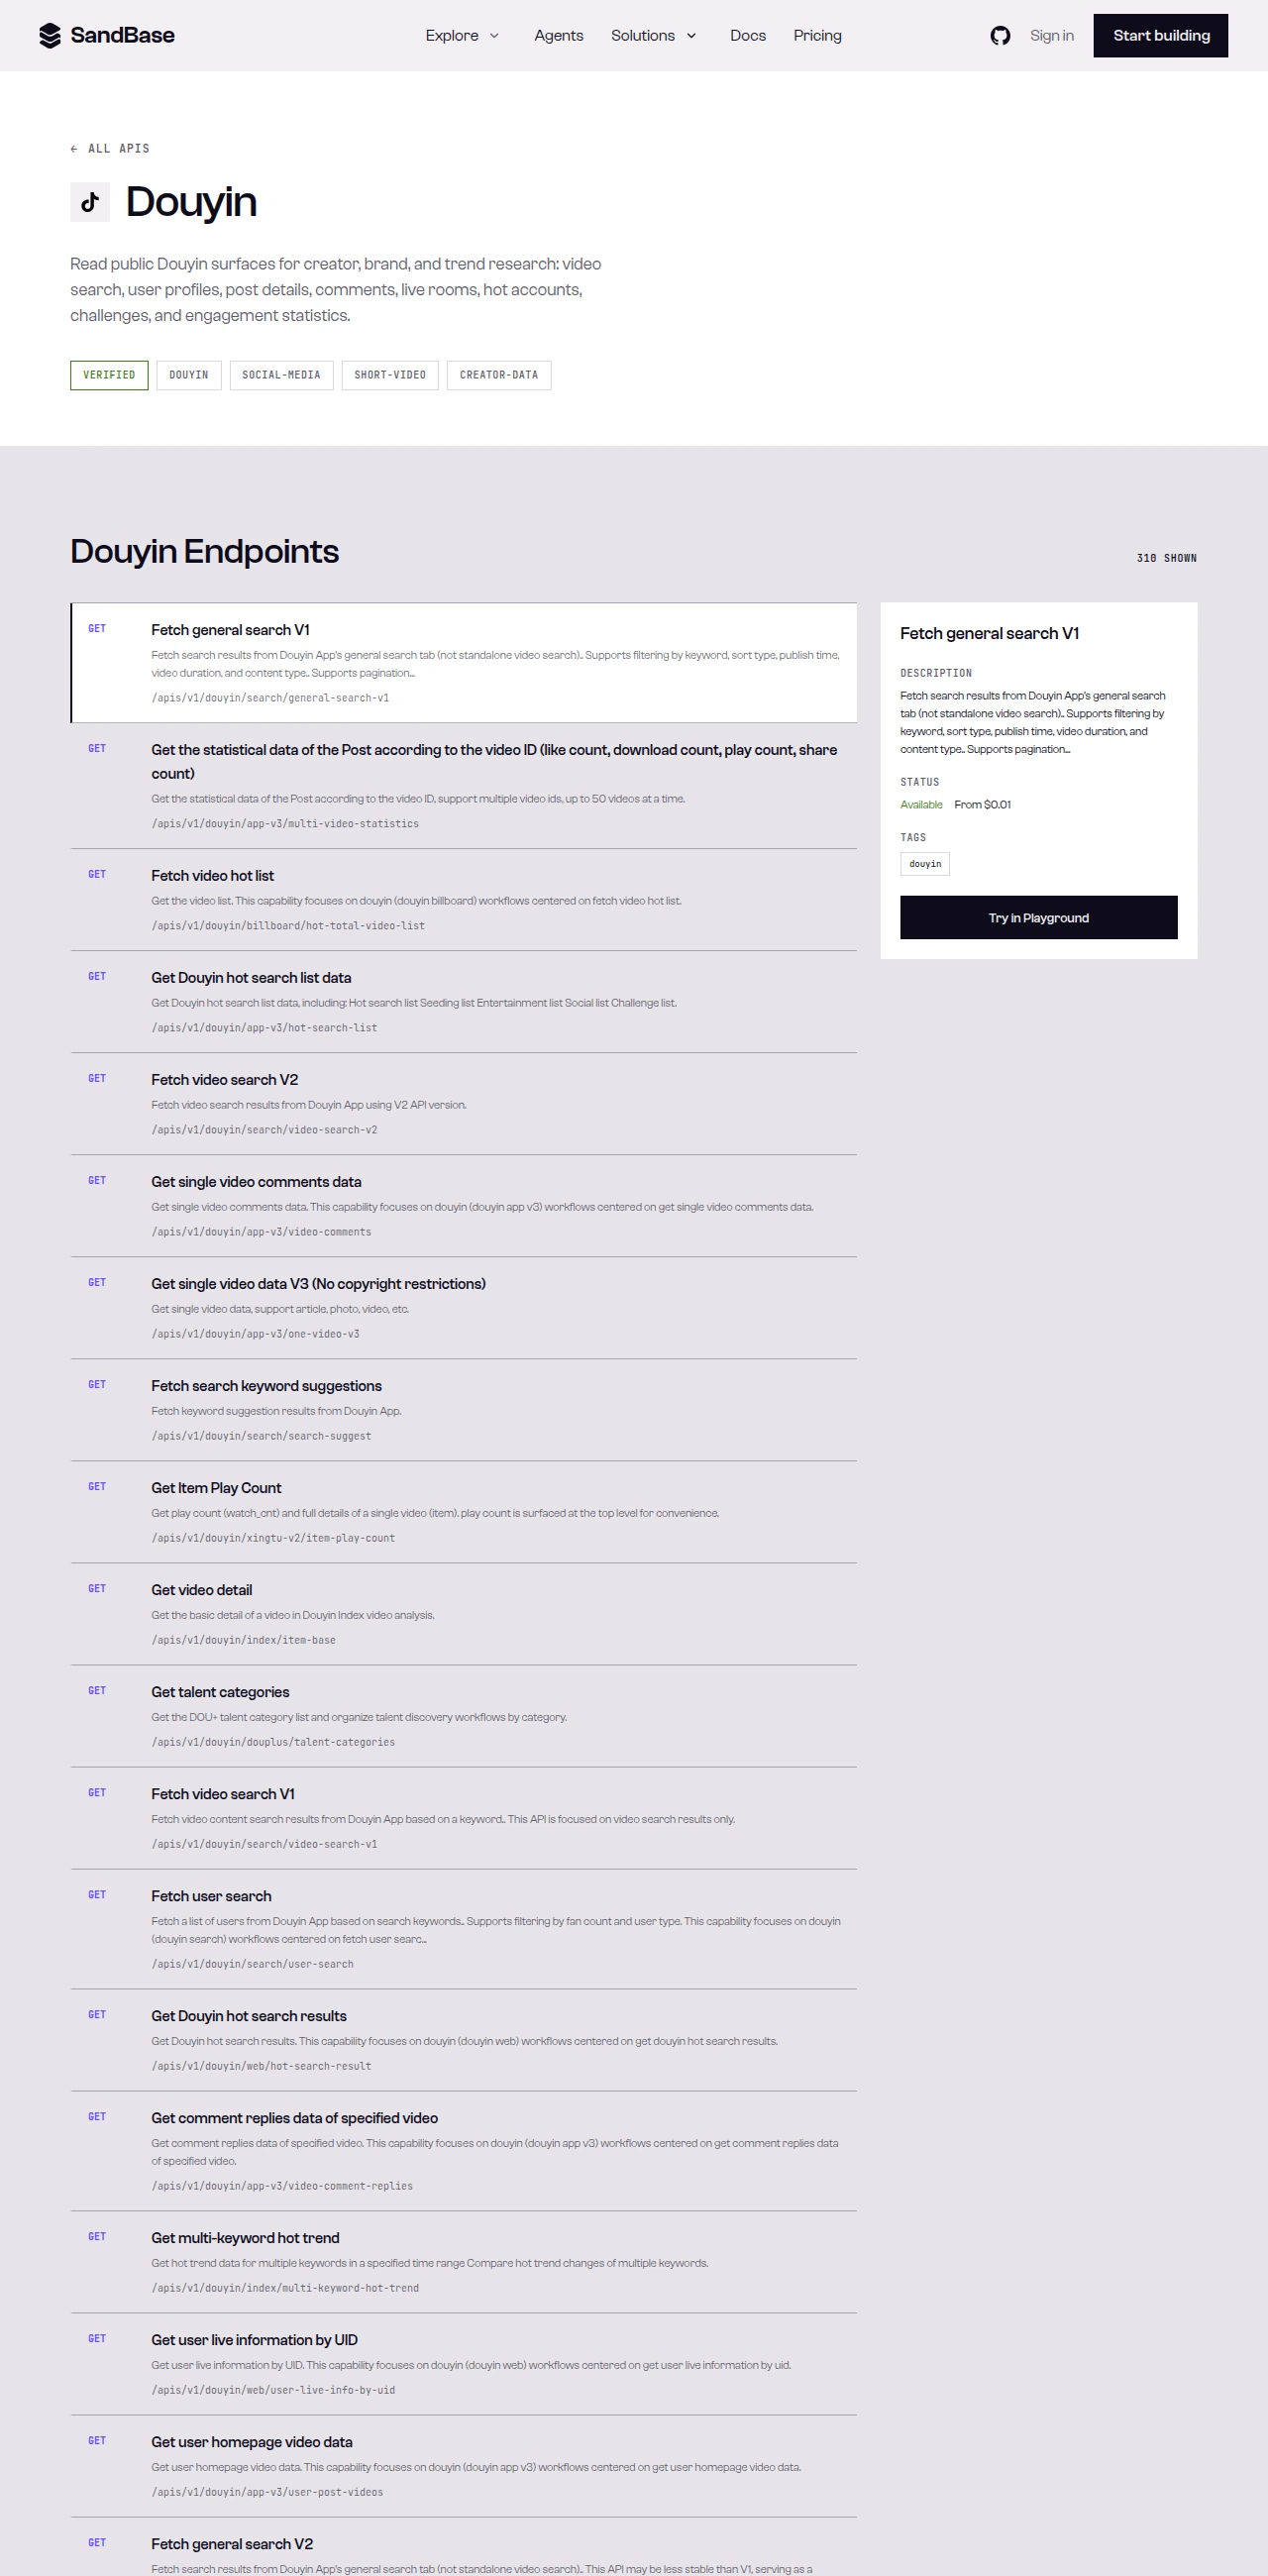 SandBase 上的抖音 API 页面——带标签的概览,加上端点列表,每个端点标有路径。
抖音提供的 vs. SandBase 补上的
公开数据来自抖音。SandBase 并不拥有或运营抖音,它只是为符合条件的公开数据流程提供一个统一的 API 层。每一项能力变成一个稳定端点,鉴权收敛成一把 key,响应都是可预期的 JSON——于是 agent 可以沿着同一套约定串起”读一个榜单 → 搜一个关键词 → 读某个视频的评论”,而不用再维护一个爬虫。
快速上手:第一次调用
SandBase 有不止一个 API 面。目录里可能会展示 /apis/v1/... 下的 GET 路径;本文用的是每个端点 API 参考里带厂商前缀的 Model API 路径。不要替换 HTTP 方法或 URL——按你所选端点的参考文档来。
读取高赞视频榜:
import os
import requests

resp = requests.post(
    "https://api.sandbase.ai/v1/api/douyin/billboard/hot-total-high-like-list",
    headers={
        "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={},
)
resp.raise_for_status()
body = resp.json()
if body.get("status") != "completed":
    error = body.get("error", {})
    raise RuntimeError(error.get("message", "Douyin request did not complete"))

# 参考只保证信封,业务字段随端点而定、以真实响应为准。
data = body["outputs"][0]["data"].get("data", {})
items = data.get("objs", [])
for it in items[:5]:
    print(it.get("item_title"), it.get("fans_cnt"))
curl -X POST https://api.sandbase.ai/v1/api/douyin/billboard/hot-total-high-like-list \
-H "Authorization: Bearer $SANDBASE_API_KEY" \
-H "Content-Type: application/json" \
-d '{}'每个响应都用同一个信封:一个 id、一个 status、model 名称,以及一个 outputs 数组,其中唯一一项在 data 下携带载荷。读 outputs[0].data 之前先判 status,并查每个端点的参考了解它的运行模式。抖音端点常常把载荷包在一个上游的 { code, data, message } 对象里,所以有用的列表在 data.data.objs 下。下面是一个示例响应结构——字段名并非保证的 schema、以真实响应为准,请把字段名和数值当作示例核对(载荷会变、数值也会随时间变):
{
  "id": "f243b2d6-b103-4ed3-b372-28f2b150cbab",
  "status": "completed",
  "model": "douyin/billboard/hot-total-high-like-list",
  "outputs": [
    {
      "data": {
        "code": 0,
        "data": {
          "objs": [
            { "item_id": "…", "item_title": "…", "fans_cnt": 0, "item_url": "…" }
          ]
        }
      }
    }
  ]
}
failed 或 timeout 的请求会带上 error 而没有 outputs。不同端点的响应结构不一样——先看一份真实响应,再按端点逐一对准字段路径。
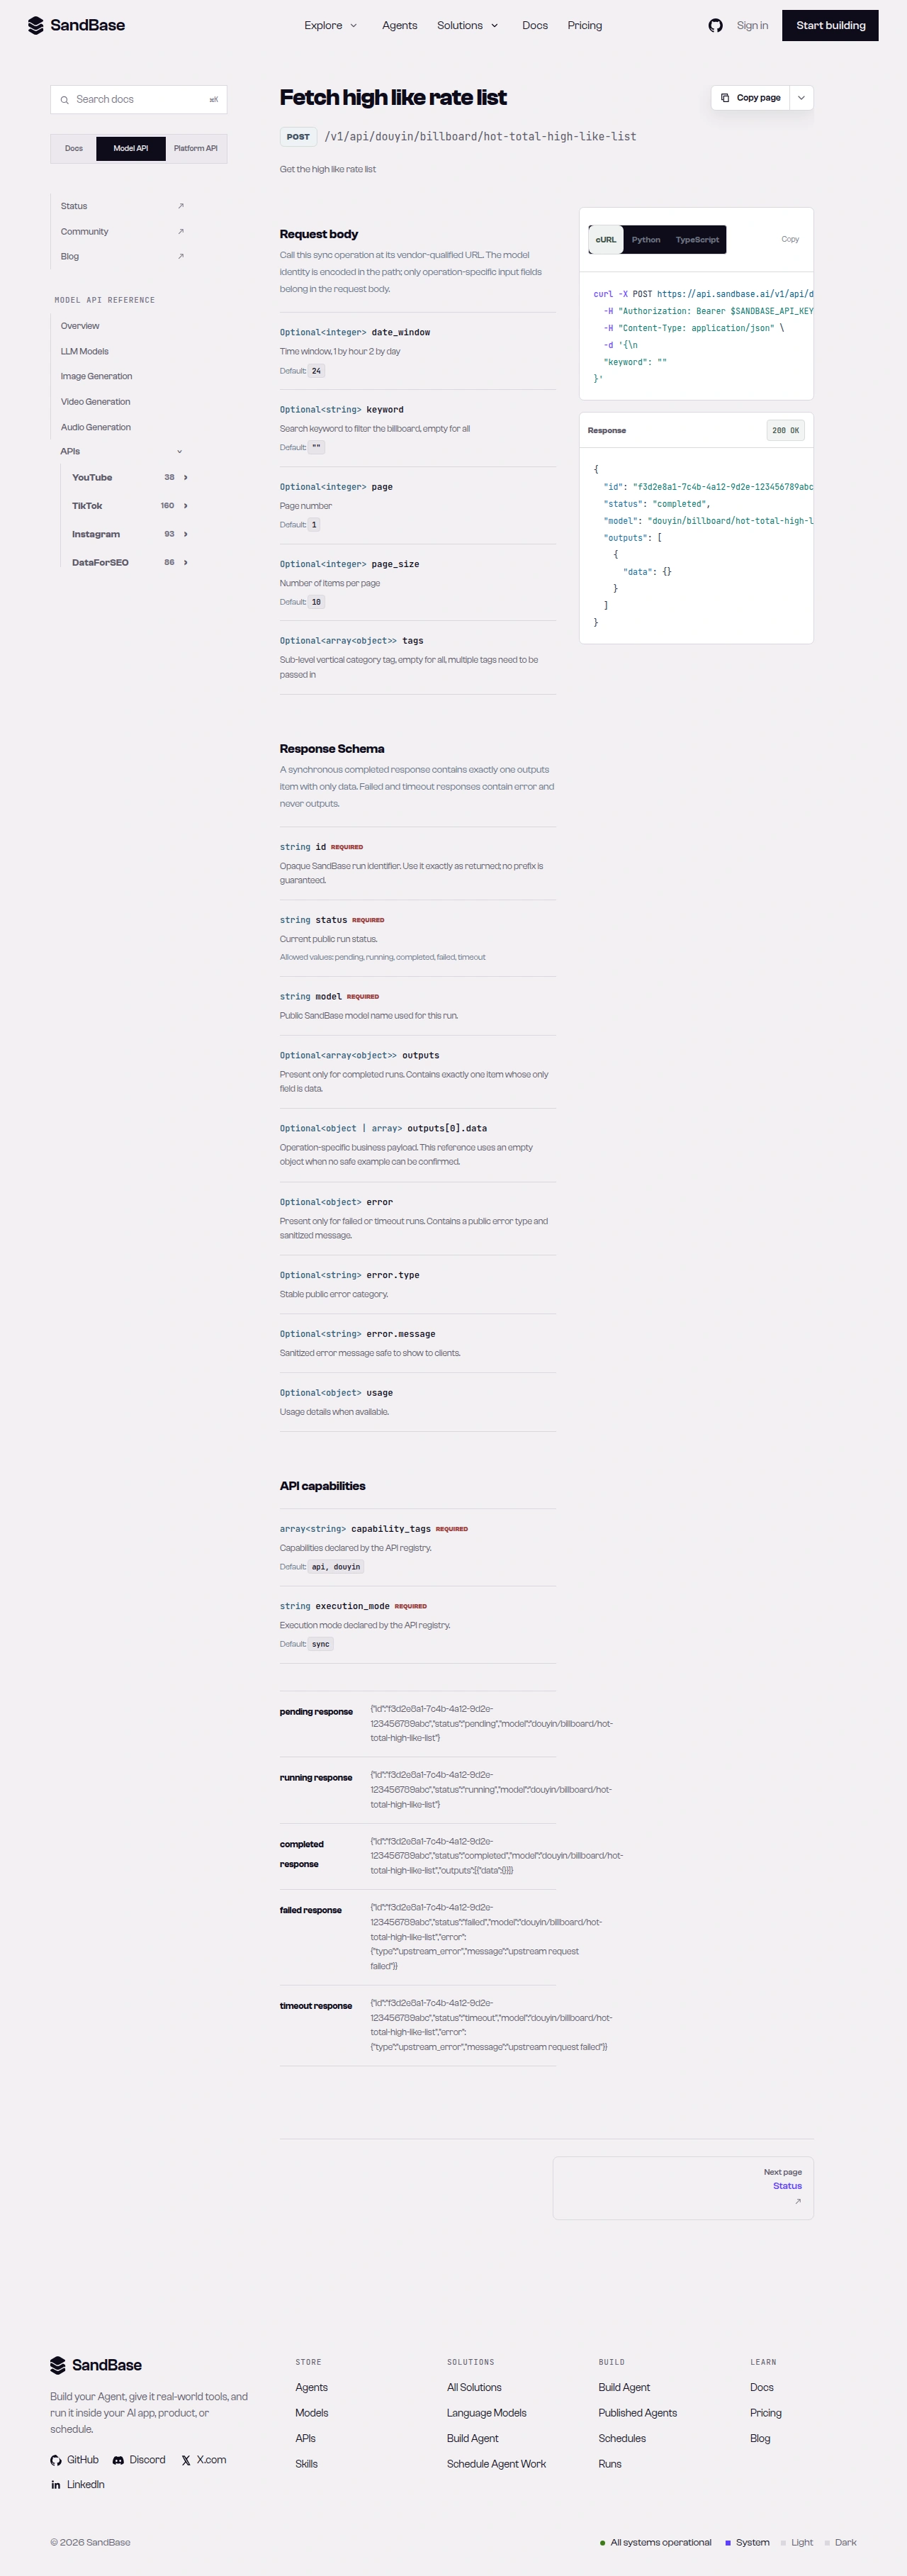 端点的 API 参考是每个参数名和响应路径的权威来源。
能力地图
| 能力簇 | 代表端点 | 典型用途 |
|---|---|---|
| 视频榜单 | douyin/billboard/hot-total-high-like-list | 头部内容趋势监测 |
| 品牌热搜 | douyin/app-v3/brand-hot-search-list | 品牌与品类追踪 |
| 搜索 | douyin/search/image-search-v3 | 关键词内容发现 |
| 视频解析 | douyin/web/aweme-id | 把视频 URL 转成 aweme_id |
| 视频评论 | douyin/app-v3/video-comments | 互动与情感分析输入 |
分页方式因端点而异——若干端点接受一个像 cursor 这样的请求参数。具体看每个端点的 schema。
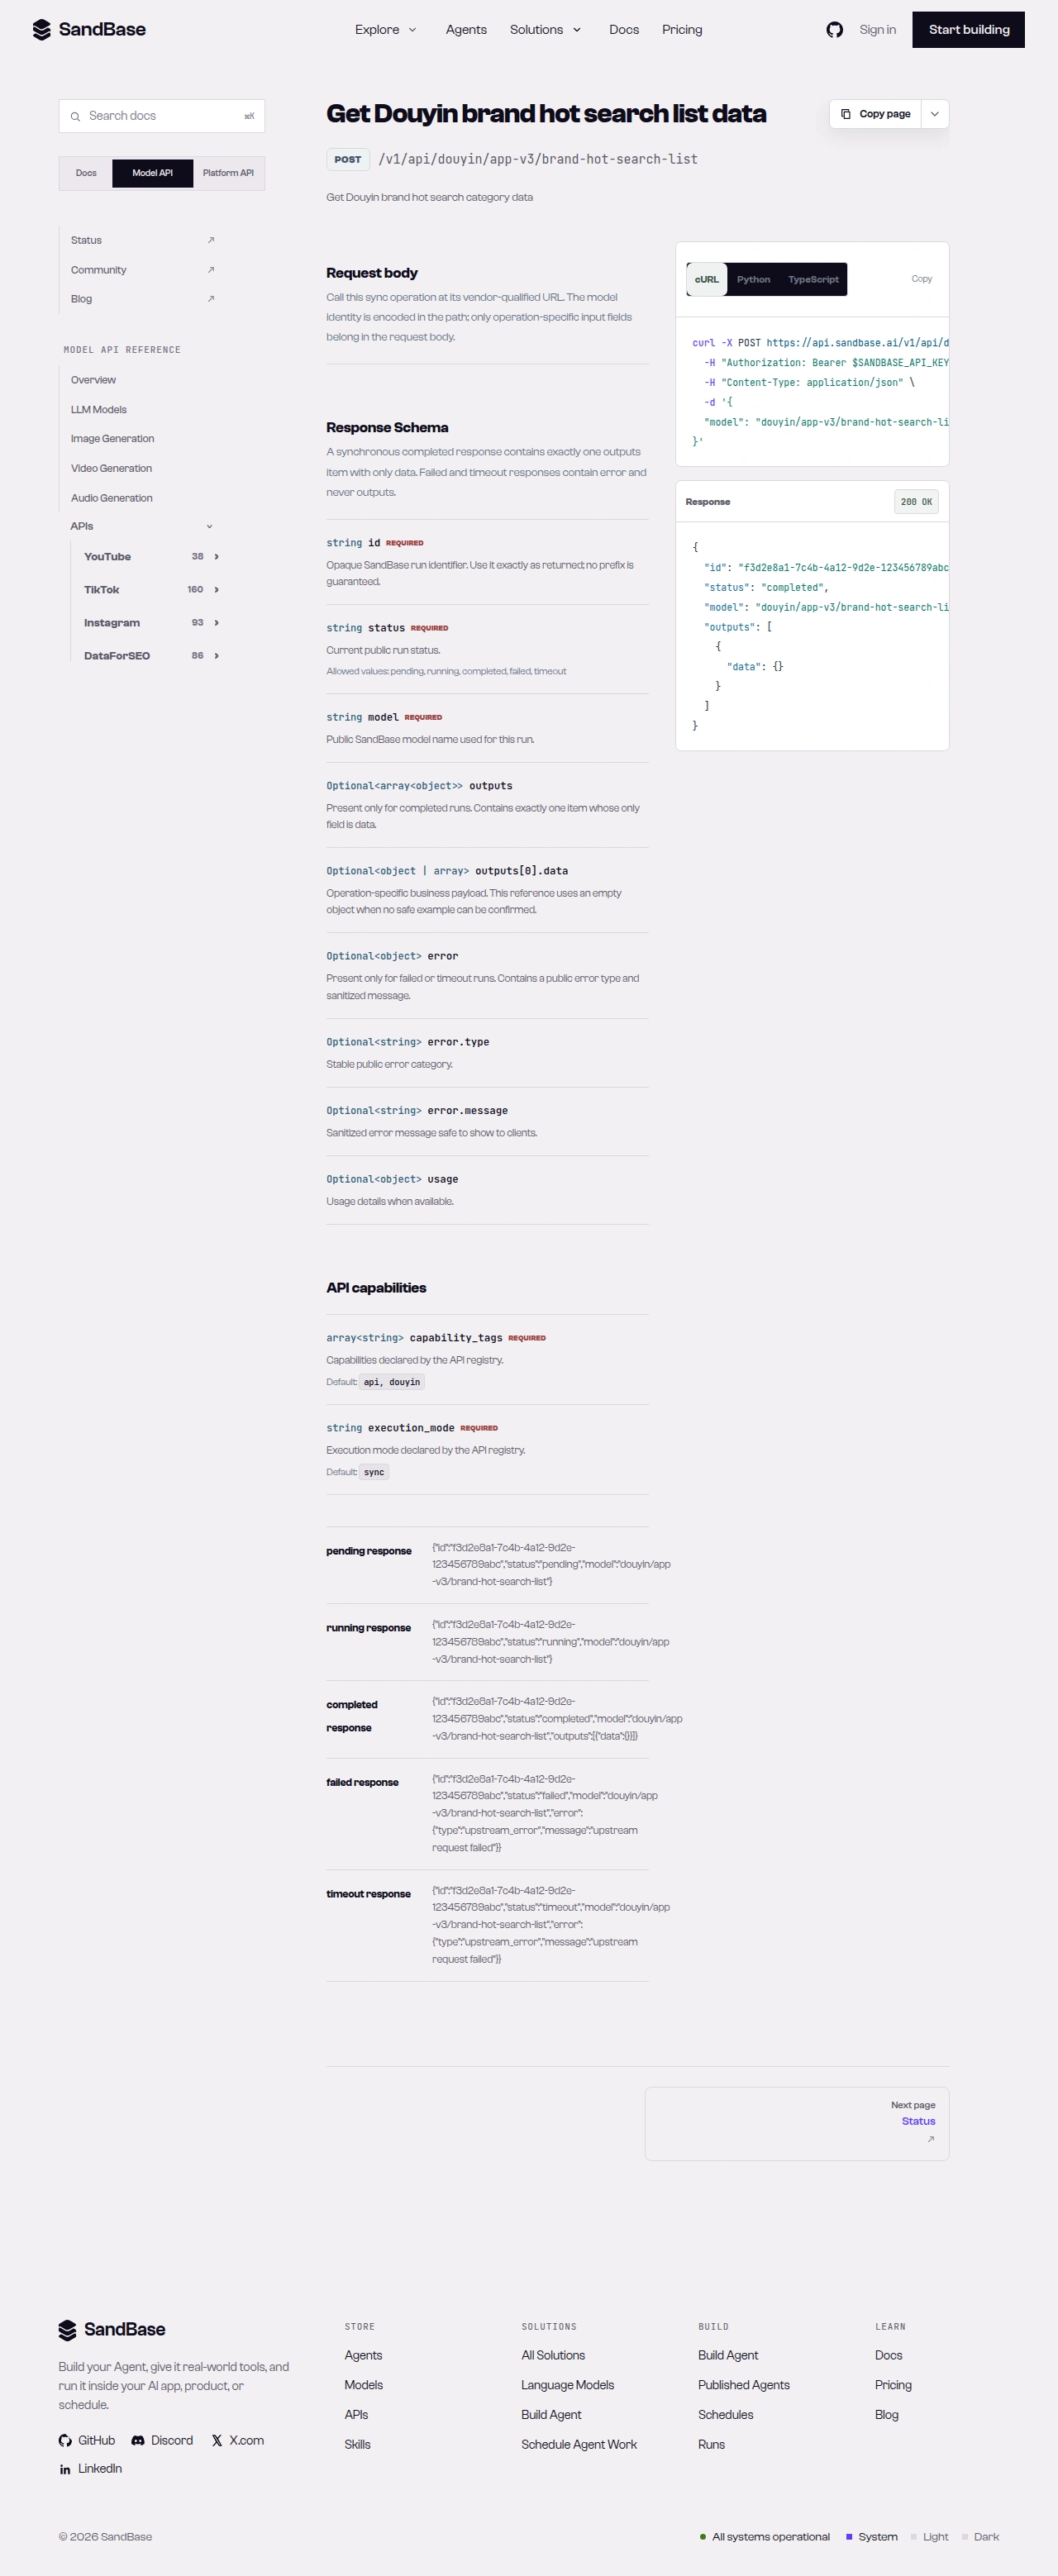 抖音端点列表的一部分,横跨榜单、搜索、web 和 app 几个面。
在 agent 工作流里串联调用
因为每个端点共用同一套鉴权和同一个响应信封,agent 可以从一个榜单走到一个视频的评论,而不用为每个页面单独写特例。一个常见的内容调研模式是这样:
- 读一个榜单。 调
douyin/billboard/hot-total-high-like-list拿高赞视频,再挑你关心的。 - 解析一个视频。 用视频
url调douyin/web/aweme-id拿它的aweme_id。 - 读评论。 用
aweme_id调douyin/app-v3/video-comments拿互动和情感输入。
每一步都返回同样的 { id, status, model, outputs } 结构,所以你的 agent 只需判一次 status,读 JSON 的那段代码在每一步都能复用。
常见用例
用抖音榜单 API 做趋势监测
按计划定时轮询 douyin/billboard/hot-total-high-like-list 追踪头部内容——每一项带一个标题和创作者信号。输入:无。输出:排名的视频列表。端点:hot-total-high-like-list。
用抖音品牌 API 做品牌追踪
读 douyin/app-v3/brand-hot-search-list 拿品牌热搜品类。输入:无。输出:品牌热搜品类。端点:brand-hot-search-list。
用抖音搜索 API 做内容发现
用一个关键词调 douyin/search/image-search-v3,围绕某话题摸清内容。输入:关键词。输出:匹配结果。端点:image-search-v3。
达人层面的工作流,看抖音达人视频研究教程(按关键词找达人、读主页、按播放和点赞给作品排序)和抖音星图达人评估教程(投放前对比基础信息、粉丝画像、视频表现和报价)。
为什么在 API 层做这件事
你当然可以让无头浏览器去抓抖音、解析 app 的载荷,但那条路很脆:app 会变,token 会轮换,你维护的是一个爬虫而不是在做功能。通过一个统一 API 读取,意味着你的代码依赖命名的 JSON 字段和一个统一的响应信封,而不是 app 内部结构。鉴权是一把 key;而且因为每个端点都返回同样的 { id, status, model, outputs } 结构,重试、日志和错误处理都集中在一个你写一次、到处复用的帮助函数里。
这种一致性正是让工作流对 agent 可组合的原因。把一个榜单换成另一个、把一个关键词换成另一个,代码路径完全一样。再加第四次读取——比如某个视频的统计——它就接在同一个判状态的帮助函数后面。实际的回报是:你把时间花在数据对你的调研意味着什么上,而不是花在跟一个不断变化的目标较劲、维持爬虫存活上。当你需要的不止单次读取时,查线上列表找到合适的端点,接入前先确认它的参数。
边界与限制
- 只读、公开数据。 不能发帖、关注,也拿不到私密/仅账号可见的数据。需要登录的创作者后台端点不在范围内。
- 速率与量级。 把响应当作尽力而为的读取;作为客户端韧性措施,遇到 HTTP 429 这类瞬时错误时用退避重试。
- 参数与结构随上游而定。 标识各异(
aweme_id、keyword、视频url);载荷常嵌在上游的data对象下;分页是各端点自己的请求参数。先看真实响应、读 schema。 - 对照在线参考确认端点。 可用性和字段可能变化;在依赖某个具体端点之前先确认。
- 这不是抖音官方合作。 SandBase 只是提供对公开数据的统一访问;请遵守抖音的条款以及你使用场景下适用的规则。
常见问题
我需要抖音开发者应用或登录吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权。这些读取端点不需要抖音账号或你这边的 OAuth。
用什么来标识视频?
视频的 aweme_id。用 web/aweme-id 把视频 URL 转成 aweme_id,再传给视频和评论端点。搜索用 keyword。
为什么数据嵌在 data.data 下?
抖音端点常常透传上游的 { code, data, message } 信封,所以有用的载荷在 data.data 下。读每个端点的 schema 确认确切路径。
能读创作者后台分析吗? 公开数据流程里不行。需要账号登录的端点不在范围内;本篇覆盖的是公开、只读的读取。
从一个榜单开始
创建一把 SandBase API key,调 hot-total-high-like-list,先看清返回的 schema,再扩展到搜索、视频或评论。准备好之后: