搭个舆情监控 Agent:微博 + 抖音
教程:搭一个每 15 分钟巡检微博热搜和抖音热门账号榜的舆情监控 Agent,LLM 判断品牌和行业相关性,命中后推送 Slack 告警。含完整代码、2026-10-01 实测返回和按 token 单价算的成本估算。
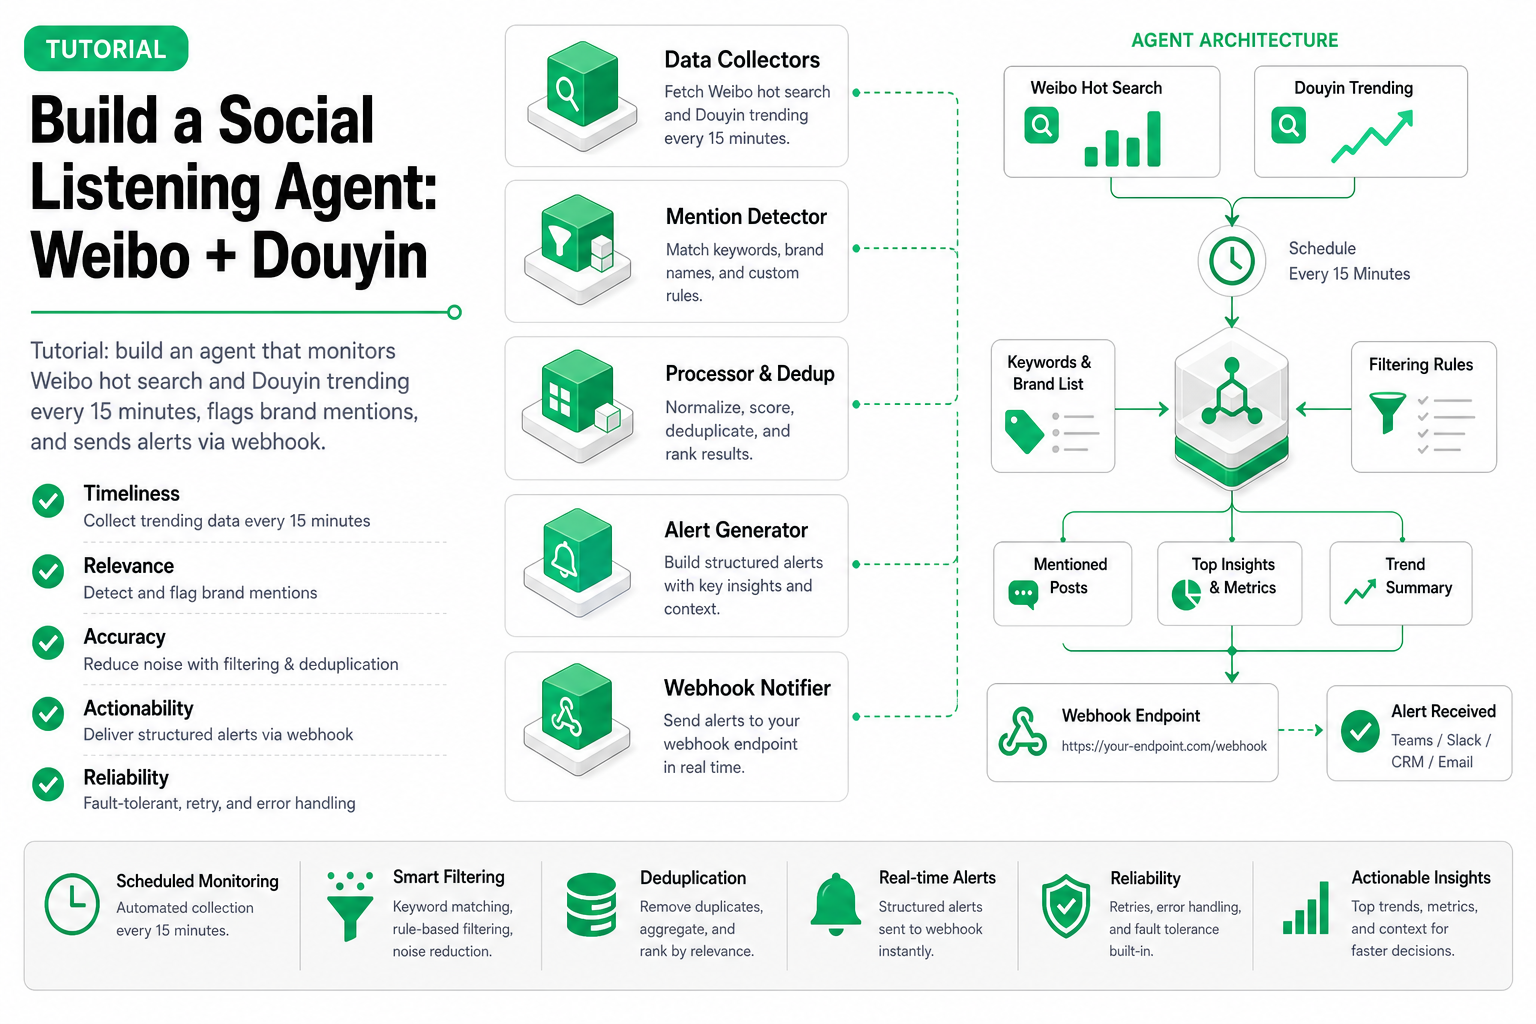
先说结论 — 一个 Python agent,每 15 分钟拉微博热搜和抖音热门账号榜,让 LLM 判断哪些条目和你的品牌或行业相关,有命中就推送 Slack 告警。每个周期 2 次数据调用 + 1 次 LLM 调用:每天 192 次数据调用、96 次 LLM 调用。每个组织每天(UTC)在符合条件的 API 上有 100 次免费数据调用,超出部分按 SandBase 目录单价按次计费;LLM 部分按下面的 token 假设约 $0.72/天(估算)。完整代码在下面,实测日期 2026-10-01(UTC)。
品牌危机不等你早上 9 点上班。凌晨 2 点开始发酵的负面帖子,在 9 点才查看的团队看到之前,有 7 个小时可以扩散。这段空窗是「反应迅速」和「被打了个措手不及」的区别。
这个舆情监控 Agent 把空窗压到一个 15 分钟轮询间隔,再加上 API、LLM 和 Slack 调用本身的几秒钟。
Agent 做什么
每 15 分钟,7×24:
- 拉微博当前热搜(2026-10-01 多次实测为 50–51 个话题 + 热度分)
- 拉抖音热门账号榜(榜单上的账号,带粉丝数和新增粉丝;这是账号榜,不是热搜话题榜)
- 两份列表连同品牌关键词、行业关键词和分类规则一起送给 LLM
- 命中品牌提及或行业信号 → 推送到 Slack incoming webhook
- 每个周期追加一行日志:条数、命中的条目和 LLM 总结
用的是什么数据
微博热搜和抖音热门账号榜都是公开、只读的榜单,任何人在 App 里都能看到。需要一个 SandBase API key。SandBase 不是微博或抖音的官方合作方;这个 Agent 读不到私密账号数据、私信或账号主才能看的后台分析,也不能发布内容或执行账号操作。
| 本教程(SandBase 公开数据 API) | 官方开放平台(微博开放平台、抖音开放平台) | |
|---|---|---|
| 接入方式 | 一把 SandBase API key | 注册应用并通过平台审核 |
| 范围 | 公开榜单和公开帖子:热搜、热门账号榜、关键词搜索 | 面向授权、绑定账号的场景,针对授权了你应用的账号 |
| 账号操作(发布、回复、私信) | 不支持 | 平台授予权限时可用 |
| 账号后台分析 | 不支持 | 限已授权账号 |
| 适合 | 盯公开热点,及时发现自己品牌 | 需要操作或读取你管理的账号的私有数据 |
两个平台都没有面向任意公开数据、无需授权的通用 API,这正是本方案补上的部分。
架构
┌─────────────────┐     ┌──────────────┐     ┌─────────────┐     ┌──────────────┐
│ 调度             │────▶│ 拉数据       │────▶│ LLM 分类    │────▶│ Slack        │
│(每 15 分钟)    │     │ 微博 + 抖音  │     │ 相关吗?    │     │ webhook      │
└─────────────────┘     └──────────────┘     └─────────────┘     └──────────────┘
                                                    │
                                                    ▼
                                             ┌────────────┐
                                             │ 周期日志   │
                                             │(JSONL)   │
                                             └────────────┘
下面代码每个周期的调用:2 次数据调用 + 1 次 LLM 调用。每天 96 个周期:192 次数据调用 + 96 次 LLM 调用。
完整代码
每个数据调用都用 POST https://api.sandbase.ai/v1/api/<端点>,JSON body 只放该端点的参数。端点参考:
weibo/web-v2/hot-search(无参数)douyin/billboard/hot-account-list(page_num、page_size)weibo/web-v2/realtime-search(query;可选的补查函数用到)
参考文档记录的完成态响应是 {id, status, model, outputs: [{data: ...}]},所以代码只读 outputs[0].data,调用没完成就抛错。这里用的是 Model API 的 POST 路由,不是微博和抖音目录页展示的 GET 路由。
每个周期依赖的两页端点参考,能直接对上代码里的请求体:微博热搜没有任何请求字段,所以 fetch_weibo_hot_search() 发的是 {};抖音热门账号榜接受可选的 page_num 和 page_size。
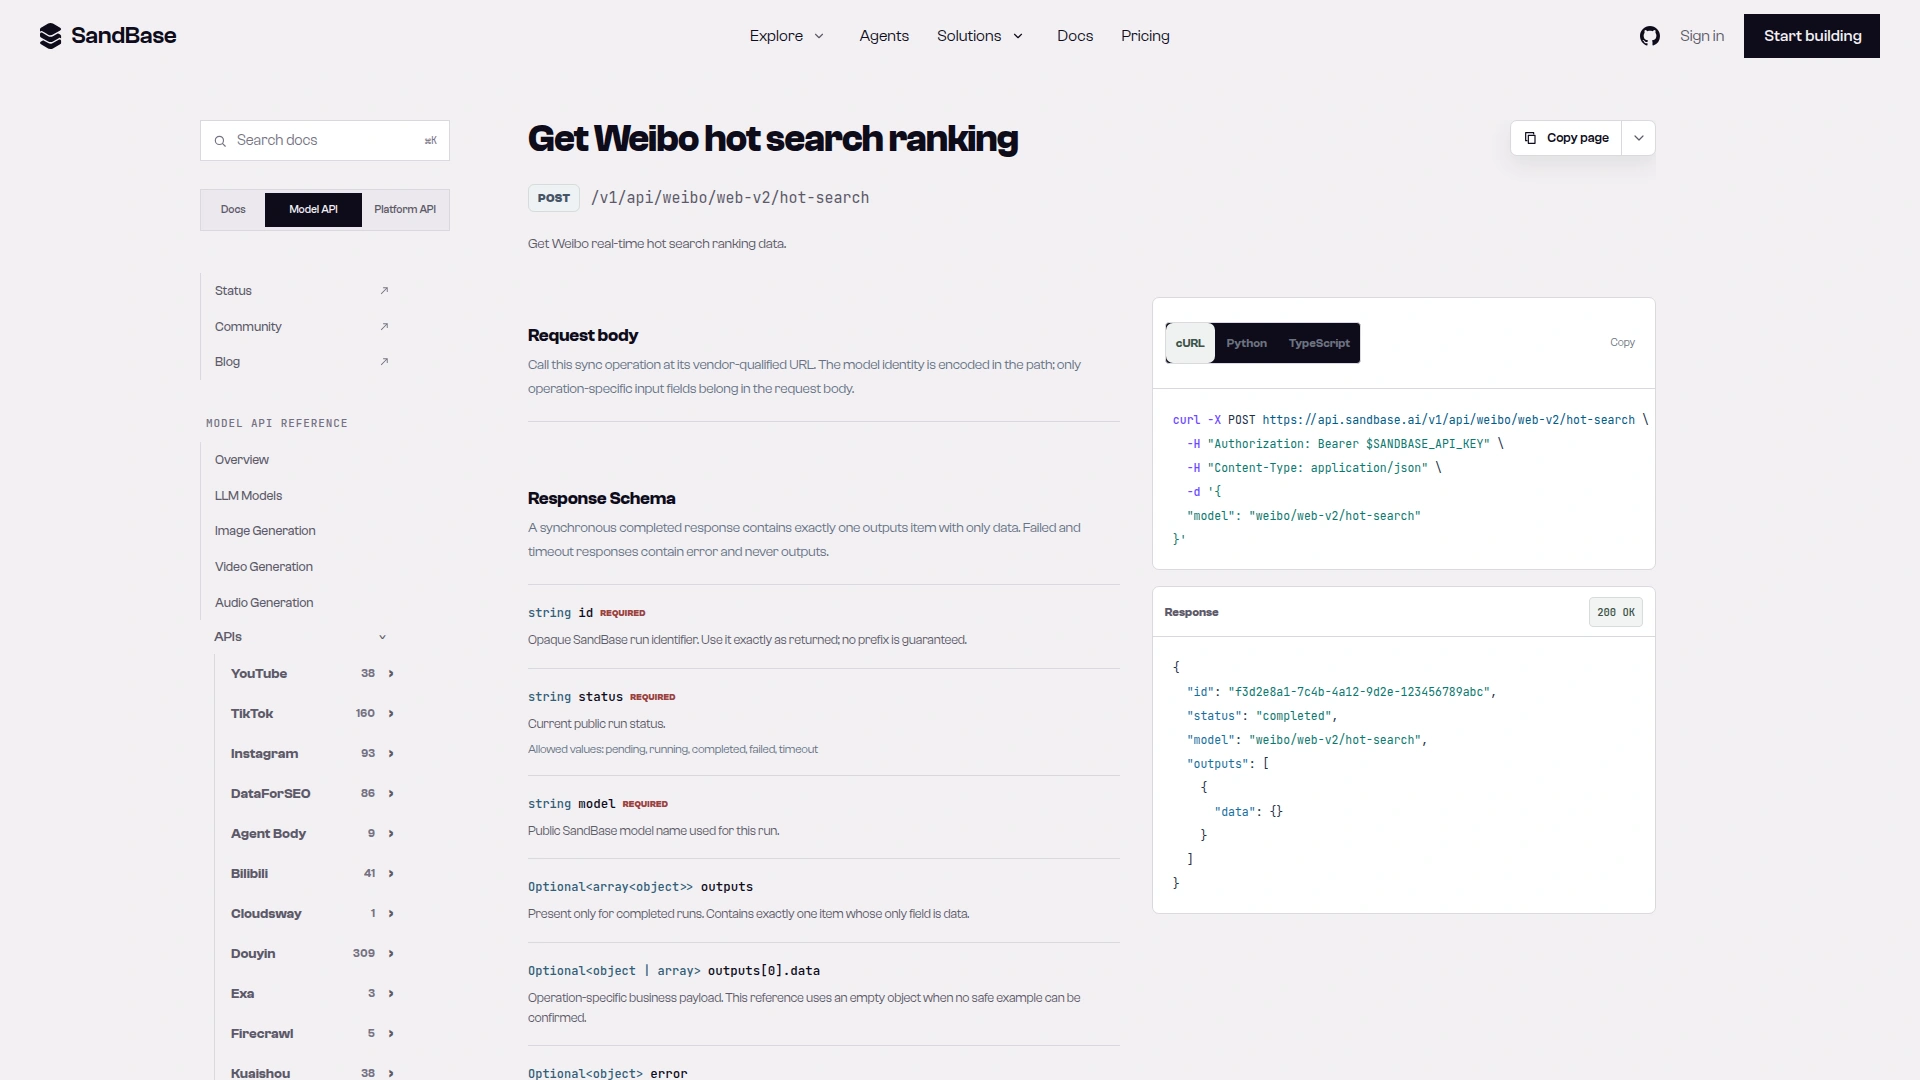
截图:weibo/web-v2/hot-search 端点参考页,路由为 POST /v1/api/weibo/web-v2/hot-search,没有业务参数,响应包含 id、status、model 和 outputs(2026-10-02 截取)。
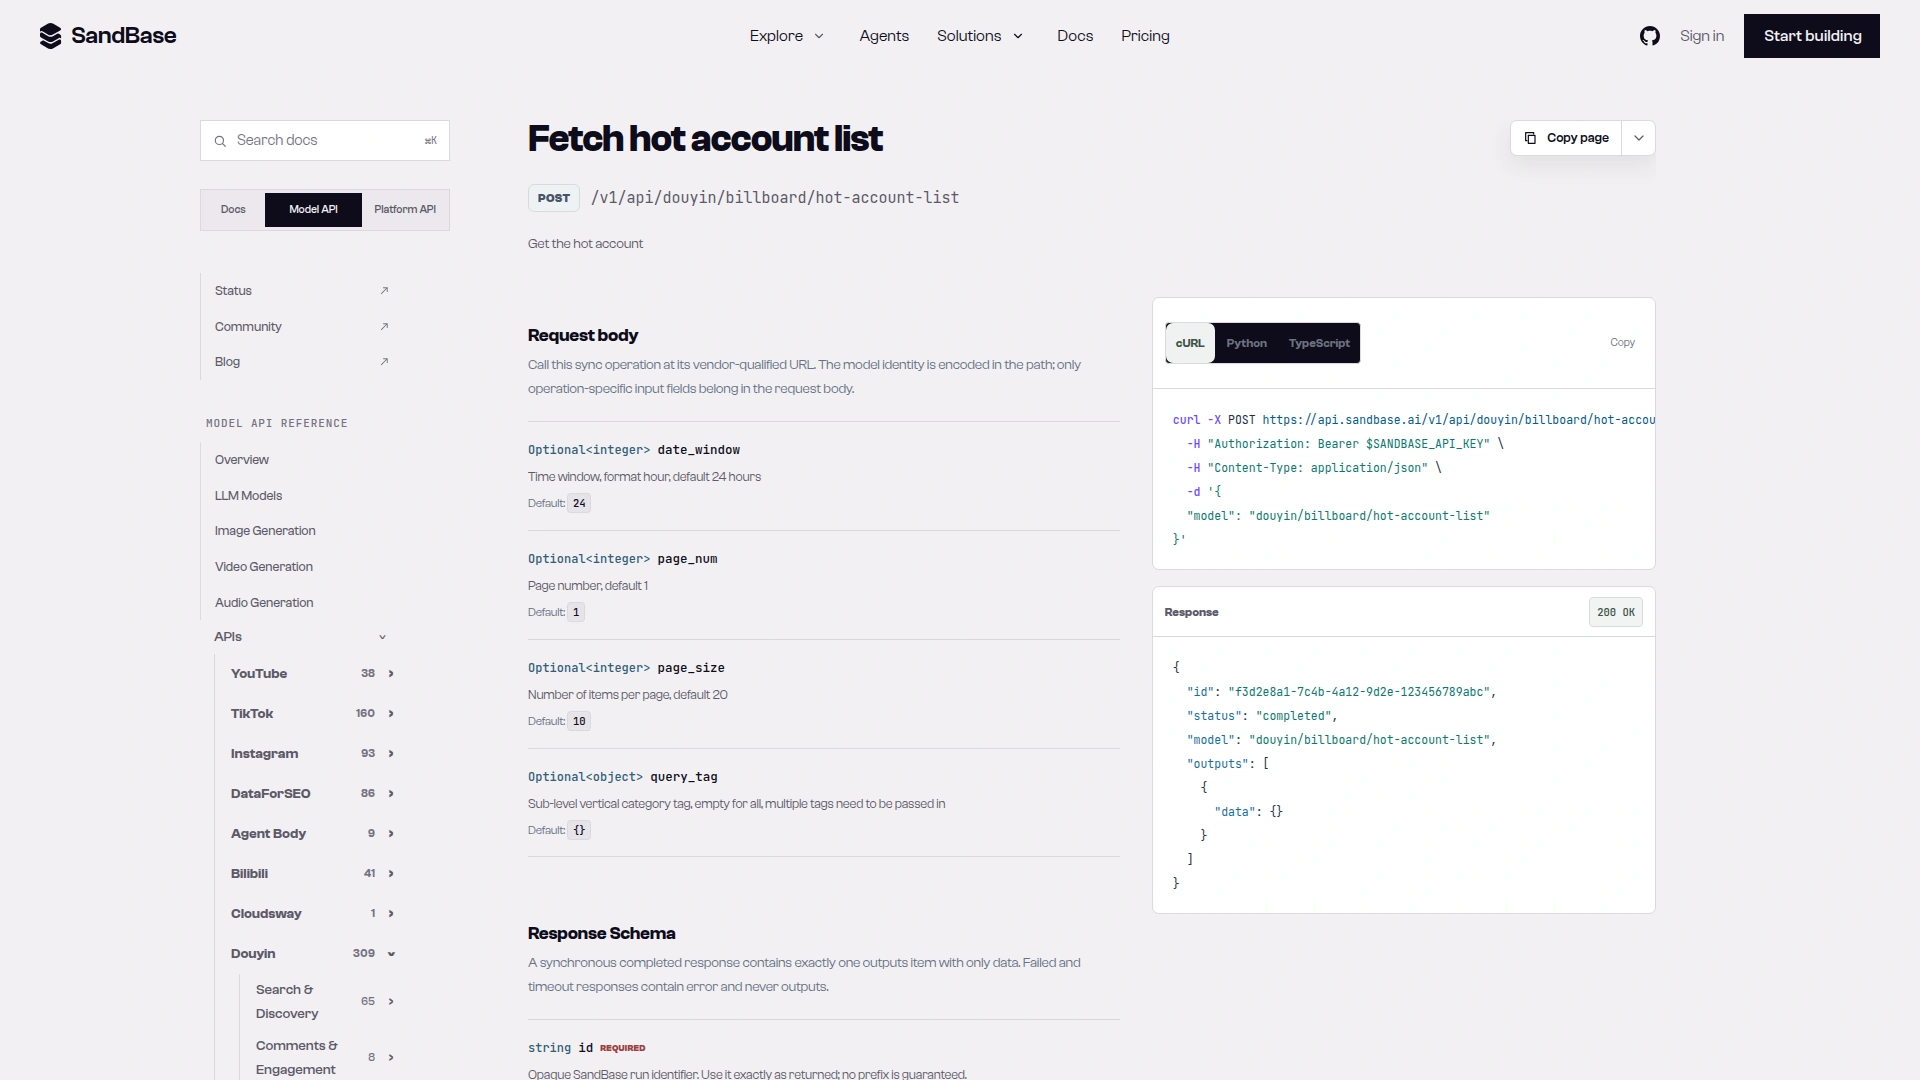
截图:douyin/billboard/hot-account-list 端点参考页,列出可选的 date_window、page_num、page_size 和 query_tag;Agent 只设置了 page_num 和 page_size(2026-10-02 截取)。
#!/usr/bin/env python3
"""舆情监控 agent:微博 + 抖音。

每 15 分钟检查微博热搜和抖音热门账号榜,用 LLM 判断相关性,
把告警推送到 Slack incoming webhook。
可以常驻运行,也可以用 cron 加 --once 调用。
"""

import json
import os
import sys
import time
from datetime import datetime, timezone
from pathlib import Path

import requests
from openai import OpenAI

# --- 配置 ---
BRAND_KEYWORDS = ["你的品牌名", "YourBrand", "竞品A", "竞品B"]
INDUSTRY_KEYWORDS = ["AI", "大模型", "agent", "智能体"]
SLACK_WEBHOOK_URL = os.environ.get("SLACK_WEBHOOK_URL", "")  # Slack incoming webhook
CHECK_INTERVAL = 900  # 15 分钟
LOG_DIR = Path("./listening_logs")
LOG_DIR.mkdir(exist_ok=True)

SANDBASE_API_KEY = os.environ["SANDBASE_API_KEY"]
API_BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {SANDBASE_API_KEY}",
    "Content-Type": "application/json",
}

# OpenAI 客户端仅用于 LLM 调用
client = OpenAI(
    base_url="https://api.sandbase.ai/v1",
    api_key=SANDBASE_API_KEY,
    timeout=60,
)


# --- 拉数据:POST /v1/api/<端点>,只读 outputs[0].data ---
def call_data_api(endpoint: str, params: dict | None = None, retries: int = 3) -> dict:
    """调用一个 SandBase 数据端点;HTTP 429/5xx 按 1s、2s 退避重试。"""
    for attempt in range(retries):
        resp = requests.post(f"{API_BASE}/{endpoint}", headers=HEADERS, json=params or {}, timeout=90)
        if (resp.status_code == 429 or resp.status_code >= 500) and attempt < retries - 1:
            time.sleep(2 ** attempt)
            continue
        resp.raise_for_status()
        body = resp.json()
        outputs = body.get("outputs") or []
        if body.get("status") != "completed" or not outputs:
            raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
        return outputs[0].get("data") or {}


def fetch_weibo_hot_search() -> list:
    """微博热搜,整理成 [{title, heat}]。"""
    data = call_data_api("weibo/web-v2/hot-search")
    # 字段名来自 2026-10-01 实测,仅供参考、非文档保证:realtime[].word / .num
    return [
        {"title": t.get("word") or t.get("note"), "heat": t.get("num")}
        for t in data.get("realtime") or []
    ]


def fetch_douyin_hot_accounts() -> list:
    """抖音热门账号榜(榜单上的账号,不是热搜话题)。"""
    data = call_data_api("douyin/billboard/hot-account-list", {"page_num": 1, "page_size": 10})
    # 字段名来自 2026-10-01 实测:data.user_list[].nick_name / .fans_cnt / .new_fans_cnt
    users = (data.get("data") or {}).get("user_list") or []
    return [
        {"title": u.get("nick_name"), "fans": u.get("fans_cnt"), "new_fans": u.get("new_fans_cnt")}
        for u in users
    ]


def fetch_weibo_keyword_posts(keyword: str) -> list:
    """可选补查,run_cycle 不调用:按命中关键词拉微博实时帖子。"""
    data = call_data_api("weibo/web-v2/realtime-search", {"query": keyword})
    # 字段名来自 2026-10-01 实测:parsed_data.results[].content / .post_url
    return (data.get("parsed_data") or {}).get("results") or []


# --- 分类 ---
def classify_relevance(weibo_topics: list, douyin_accounts: list) -> dict:
    """LLM 判断哪些话题和品牌/行业相关。"""
    prompt = f"""你是品牌舆情分析师。把下面的微博热搜话题和抖音热门账号逐条分类:
- "brand_mention":直接提到我们品牌或竞品
- "industry_relevant":和行业相关但非直接提及
- "irrelevant":不相关

品牌关键词:{json.dumps(BRAND_KEYWORDS, ensure_ascii=False)}
行业关键词:{json.dumps(INDUSTRY_KEYWORDS, ensure_ascii=False)}

微博热搜(前 20):
{json.dumps(weibo_topics[:20], ensure_ascii=False, indent=2)}

抖音热门账号(前 10):
{json.dumps(douyin_accounts[:10], ensure_ascii=False, indent=2)}

只回复 JSON,不要 markdown:
{{
  "brand_mentions": [{{"source": "weibo|douyin", "title": "...", "heat": N, "reason": "..."}}],
  "industry_relevant": [{{"source": "weibo|douyin", "title": "...", "heat": N, "reason": "..."}}],
  "summary": "一句话总结"
}}

只列真正相关的条目。没有命中就返回空列表。"""

    resp = client.chat.completions.create(
        model="anthropic/claude-sonnet-4",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=1500,
    )
    if resp.usage:  # 打印真实 token 数,用来核对成本估算
        print(f"  LLM tokens: {resp.usage.prompt_tokens} 输入 / {resp.usage.completion_tokens} 输出")
    text = (resp.choices[0].message.content or "").strip()
    if text.startswith("```"):  # 兼容带代码块围栏的回复
        text = text.strip("`").removeprefix("json").strip()
    try:
        return json.loads(text)
    except json.JSONDecodeError:
        return {"brand_mentions": [], "industry_relevant": [], "summary": "解析失败"}


# --- 告警(Slack incoming webhook 负载:{"text": ...}) ---
def send_slack_alert(classification: dict, timestamp: str):
    """把品牌提及和行业信号推送到 Slack。"""
    if not SLACK_WEBHOOK_URL:
        print("  未配置 Slack webhook,跳过告警")
        return

    brand_mentions = classification.get("brand_mentions") or []
    industry = classification.get("industry_relevant") or []
    if not brand_mentions and not industry:
        return  # 没有要告警的

    blocks = []
    if brand_mentions:
        blocks.append("🚨 *品牌提及*\n" + "\n".join(
            f"• [{m.get('source', '?').upper()}] {m.get('title')}(热度:{m.get('heat', '?')})— {m.get('reason', '')}"
            for m in brand_mentions
        ))
    if industry:
        blocks.append("📡 *行业信号*\n" + "\n".join(
            f"• [{i.get('source', '?').upper()}] {i.get('title')} — {i.get('reason', '')}"
            for i in industry[:5]  # 行业条目最多 5 条
        ))

    message = {
        "text": f"舆情告警 — {timestamp}\n\n" + "\n\n".join(blocks)
                + f"\n\n_{classification.get('summary', '')}_"
    }
    try:
        resp = requests.post(SLACK_WEBHOOK_URL, json=message, timeout=10)
        resp.raise_for_status()
        print(f"  告警已发送:HTTP {resp.status_code}")
    except requests.RequestException as e:
        print(f"  告警失败:{e}")


# --- 日志 ---
def log_cycle(timestamp: str, weibo: list, douyin: list, classification: dict):
    """每个周期追加一行 JSON:条数、命中条目、总结。"""
    log_entry = {
        "timestamp": timestamp,
        "weibo_count": len(weibo),
        "douyin_count": len(douyin),
        "brand_mentions": classification.get("brand_mentions") or [],
        "industry_relevant": classification.get("industry_relevant") or [],
        "summary": classification.get("summary", ""),
    }
    log_file = LOG_DIR / f"listening-{timestamp[:10]}.jsonl"
    with open(log_file, "a", encoding="utf-8") as f:
        f.write(json.dumps(log_entry, ensure_ascii=False) + "\n")


# --- 主循环 ---
def run_cycle():
    """执行一个巡检周期:2 次数据调用 + 1 次 LLM 调用。"""
    timestamp = datetime.now(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")
    print(f"\n[{timestamp}] 巡检中...")

    weibo = fetch_weibo_hot_search()
    print(f"  微博热搜 {len(weibo)} 条")
    douyin = fetch_douyin_hot_accounts()
    print(f"  抖音热门账号 {len(douyin)} 个")

    classification = classify_relevance(weibo, douyin)
    brand_count = len(classification.get("brand_mentions") or [])
    industry_count = len(classification.get("industry_relevant") or [])
    print(f"  品牌提及 {brand_count} 条,行业信号 {industry_count} 条")

    # 品牌提及和仅有行业信号的情况都推送到 Slack
    if brand_count > 0:
        print("  ⚠️ 检测到品牌提及!发送告警...")
        send_slack_alert(classification, timestamp)
    elif industry_count > 0:
        print("  📡 检测到行业信号,发送摘要...")
        send_slack_alert(classification, timestamp)
    else:
        print("  ✓ 本周期无相关内容")

    log_cycle(timestamp, weibo, douyin, classification)
    return classification


def run_continuous():
    """常驻运行,每 15 分钟一次。"""
    print("舆情监控 Agent 启动")
    print(f"  品牌关键词:{BRAND_KEYWORDS}")
    print(f"  行业关键词:{INDUSTRY_KEYWORDS}")
    print(f"  间隔:{CHECK_INTERVAL}s")
    print(f"  Slack webhook:{'已配置' if SLACK_WEBHOOK_URL else '未配置'}")

    while True:
        try:
            run_cycle()
        except Exception as e:
            print(f"  错误:{e}")
        time.sleep(CHECK_INTERVAL)


if __name__ == "__main__":
    if "--once" in sys.argv:
        run_cycle()  # 单次运行,用于测试或 cron
    else:
        run_continuous()
实测:2026-10-01(UTC)
我用 LLM 桩替代、数据调用走真实请求,跑了上面的代码。两个榜单端点都不需要关键词,下面的请求就是代码实际发出的内容。字段名来自这些调用,仅为实测观察、不是文档保证,所以每次读取都用 .get()。返回已截短。
POST https://api.sandbase.ai/v1/api/weibo/web-v2/hot-search
{}

{"id": "1e56f2e0-3eca-4242-b371-0a4e2f4cc060", "status": "completed", "model": "weibo/web-v2/hot-search",
 "outputs": [{"data": {"realtime": [
   {"word": "鸿蒙智行问界业务升级", "num": 1116159, "realpos": 1, "label_name": "新", ...},
...], "hotgov": {...}, "hotgovs": [...]}}]}POST https://api.sandbase.ai/v1/api/douyin/billboard/hot-account-list
{"page_num": 1, "page_size": 10}
{"id": "c38e0333-4f1d-4104-b5bc-f41dbb8a06ad", "status": "completed", "model": "douyin/billboard/hot-account-list",
"outputs": [{"data": {"code": 0, "message": "", "data": {"has_more": true, "user_list": [
{"nick_name": "人民日报", "fans_cnt": 203210991, "new_fans_cnt": 51760, ...},
{"nick_name": "央视新闻", "fans_cnt": 187596558, "new_fans_cnt": 38735, ...},
...]}}}]}这次返回了 51 个热搜话题和 10 个账号(榜首是人民日报、央视新闻等官方媒体账号)。五个测试周期里,Agent 在品牌提及和仅有行业信号时都发出了告警,没有命中时不发;预过滤版本在没有关键词命中时跳过了 LLM。Slack 负载发到的是本地测试端点,不是真实的 Slack 工作区。
费用
每个组织每天前 100 次数据调用免费(端点需符合条件),其余按次计费,数据侧成本约等于每天超出的 92 次调用 × 各端点的目录单价(可用 sandbase inspect 查看),另加 LLM 费用。截至 2026-10-01,SandBase 上 anthropic/claude-sonnet-4 的价格是输入 $3/百万 token、输出 $15/百万 token。
Token 假设(示意):用我 2026-10-01 的数据拼出的分类 prompt 约 2,300–2,700 个字符(中英文两版 prompt;大部分是 JSON 空白和 ASCII),我按约 1,000 输入 token 估;一次典型回复按约 300 输出 token 估。每次调用:1,000 × $3/M + 300 × $15/M = $0.003 + $0.0045 = $0.0075。
| 组件 | 每周期 | 每天(96 周期) |
|---|---|---|
| 微博热搜 | 1 次数据调用 | 96 次 |
| 抖音热门账号榜 | 1 次数据调用 | 96 次 |
| LLM 分类 | 1 次,约 $0.0075(估算) | 96 次,约 $0.72 |
| 合计 | 2 次数据调用 + 1 次 LLM | 192 次数据调用 + LLM 约 $0.72 |
按 30 天算,LLM 约 $21.60/月,另加每天超出 100 次免费额度的数据调用按次费用。输出上限是 max_tokens=1500;如果每次回复都打满,单次是 $0.003 + 1,500 × $15/M = $0.0255,即每天 $2.45。代码打印的 LLM tokens: 那一行就是你重算这笔账要用的真实数字。
优化版:关键词预过滤
美元开销基本全在 LLM,所以原始榜单里没有出现关键词时就跳过它:
def quick_keyword_check(items: list, keywords: list) -> bool:
    """快速检查:关键词是否出现在任何条目里。不调用 API。"""
    text = " ".join(json.dumps(i, ensure_ascii=False) for i in items).lower()
    return any(kw.lower() in text for kw in keywords)


def run_cycle_optimized():
    """和 run_cycle 一样,但只在关键词出现时才调 LLM。"""
    timestamp = datetime.now(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")
    weibo = fetch_weibo_hot_search()
    douyin = fetch_douyin_hot_accounts()

    if quick_keyword_check(weibo + douyin, BRAND_KEYWORDS + INDUSTRY_KEYWORDS):
        classification = classify_relevance(weibo, douyin)
        send_slack_alert(classification, timestamp)  # 品牌或行业条目都会发
    else:
        classification = {"brand_mentions": [], "industry_relevant": [], "summary": "无关键词命中"}
    log_cycle(timestamp, weibo, douyin, classification)
    return classification
代价是:预过滤只做字面匹配,不包含你关键词的行业话题永远到不了 LLM。能省多少取决于关键词出现的频率。举例来说,如果 30% 的周期有命中,每天约 29 次 LLM 调用而不是 96 次,按同样的 token 假设约 28.8 × $0.0075 × 30 ≈ $6.48/月。
部署方式
方式 1:常驻进程(VPS/容器)
SANDBASE_API_KEY=sk-... SLACK_WEBHOOK_URL=https://hooks.slack.com/services/... python3 listener.py用 systemd 或 Docker 重启策略保活。
方式 2:Cron 每 15 分钟
*/15 * * * * SANDBASE_API_KEY=sk-... SLACK_WEBHOOK_URL=... python3 listener.py --once更简单。每次调用都从零开始,磁盘上的 JSONL 日志是唯一的状态,所以同一条目跨周期留在榜上会重复告警。嫌吵的话,和上一行日志比对去重。
方式 3:GitHub Actions
on:
  schedule:
    - cron: '*/15 * * * *'  # 每 15 分钟
GitHub 文档说明,高负载期间定时工作流可能延迟,时效敏感的告警不太合适。
告警触发后怎么办
Agent 检测,人来决策。建议响应流程:
| 告警类型 | 响应 | 时限 |
|---|---|---|
| 品牌提及 + 负面 + 高热 | 启动危机预案 | 30 分钟内 |
| 品牌提及 + 中性 | PR 团队评估 | 2 小时内 |
| 行业信号 | 纳入周策略简报 | 本周内 |
| 竞品提及 | 记录竞品情报 | 下次复盘 |
扩展
加情感深度:品牌命中后调 fetch_weibo_keyword_posts()(weibo/web-v2/realtime-search,参数 query),按关键词拉实时帖子做情感分析。2026-10-01 用 {"query": "小米"} 调用(run 973c3249-af8e-462c-b001-34e2fbf1ffac),返回 10 条,位于 parsed_data.results(字段名仅为实测观察)。run_cycle 里没有调用它;接上之后,每次告警(不是每个周期)多 1 次数据调用和 1 次情感分析 LLM 调用。
这个补查端点的参考页显示,唯一必填的字段是 query,page 默认为 1。
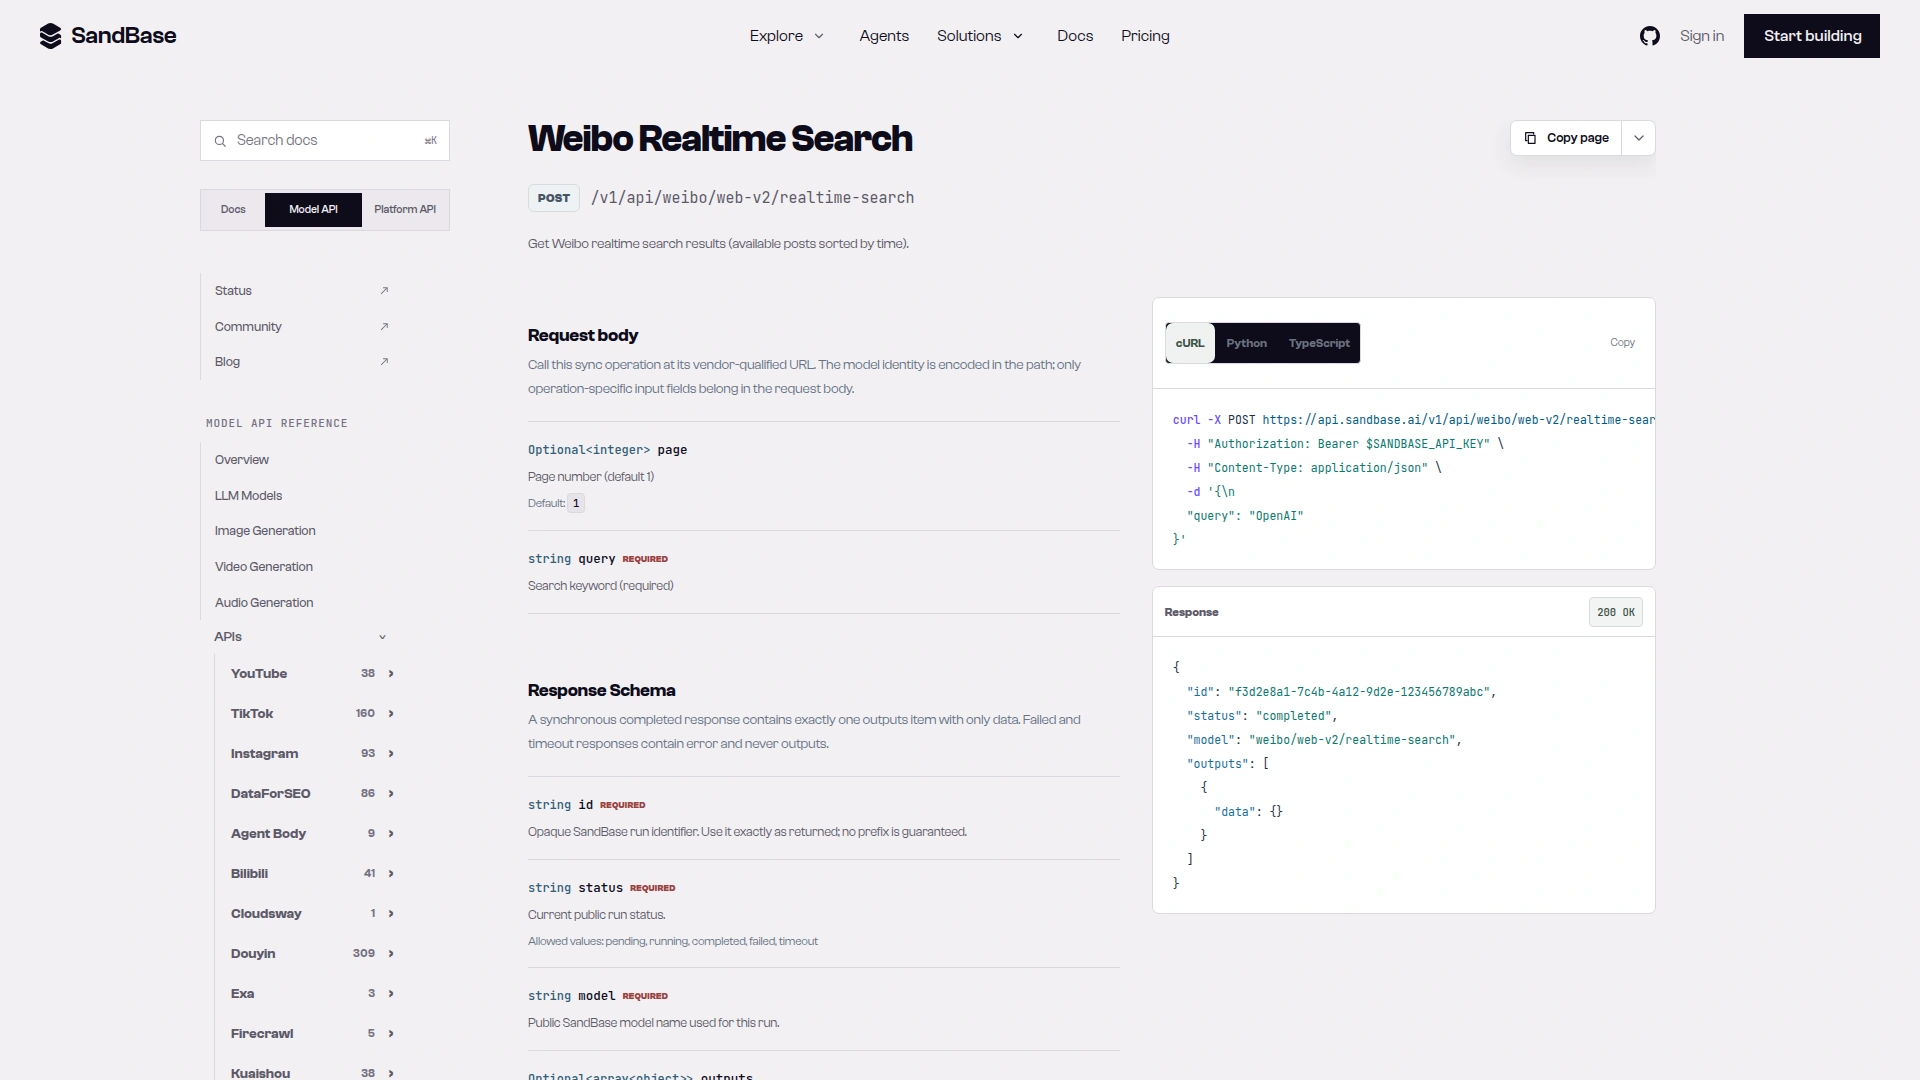
截图:fetch_weibo_keyword_posts() 调用的 weibo/web-v2/realtime-search 端点参考页,query 必填,page 默认 1(2026-10-02 截取)。
加小红书:按关键词搜索的 xiaohongshu/app-v2/search-notes(参数 keyword)可以作为第三个源:2026-10-01 用 {"keyword": "小米"} 调用(run eae32bb2-f69c-4c98-8091-e60a139240cc),返回 20 条笔记,位于 data.items[].note(字段名仅为实测观察)。同样模式,每周期多 1 次数据调用(每天多 96 次)。
历史趋势:每行日志都保留了命中条目,积累 30 天后可以让 LLM 分析哪些行业话题每周反复出现。
局限
- 15 分钟粒度:不是实时。危机可以在一个间隔内发酵。要求更高就改成 5 分钟间隔(调用量和 LLM 费用都是 3 倍)
- LLM 分类不完美:会有误报。prompt 偏向多报,最终由人判断
- 热搜不全面:话题轮转快,一直没上热搜的品牌投诉根本不会出现。加关键词搜索(见 FAQ)做补充
- 不分析视频内容:只看热门账号元数据,不看视频本身。关心某个视频时,可以调
douyin/app-v3/one-video(参数aweme_id)取视频详情;2026-10-01 实测(run8d56b7aa-d98d-4559-b6da-cc2d17a47a2c)详情位于aweme_detail(仅为实测观察)
FAQ
能只监控特定关键词而不是热搜吗?
能。用 weibo/web-v2/advanced-search(关键词放 q;2026-10-01 用 {"q": "小米"} 调用,run 93a2caa9-42fe-497a-8dbf-3ffabfbc6fd4,返回 20 条,位于 parsed_data.results,仅为实测观察)或 weibo/web-v2/realtime-search(关键词放 query)配你自己的关键词,替代或补充热搜。能抓到不上榜但相关的内容。
多快能发现品牌危机?
前提是话题上了微博热搜,或账号上了抖音榜单。从那一刻起,最慢是一个完整间隔(15 分钟),再加上两次数据调用、一次 LLM 调用和 Slack 推送的耗时;2026-10-01 两轮测试中共 22 次热搜和热门账号调用,每次耗时 1.5–5.2 秒。
支持什么 webhook?
代码发送的是 Slack incoming webhook 的负载 {"text": "..."}。我只把请求发到本地测试端点做了核对,没有发到真实的 Slack 工作区。Discord、PagerDuty、飞书和钉钉各自要求不同的 JSON 结构,需要单独写负载构造函数。
能同时监控多个品牌吗?
能。方式一:扩大关键词列表,让 LLM 按品牌分类。方式二:跑多个实例各用不同关键词。前者每个周期只调一次 LLM,而不是每个品牌一次。
微博接口详情看微博 + 小红书数据接口上线 SandBase,抖音接口看抖音公开数据 API。
获取 SandBase API key · 浏览微博 API 目录 · 浏览抖音 API 目录