2026 社媒数据 API 选型:Agent 能用的有哪些
从 Agent 视角盘点 2026 年社媒数据获取方式:结构化 API、爬虫、代理、官方平台,各自适合什么场景。
先说结论 — 2026 年 Agent 获取社媒数据有五条路。Agent 需要在一个 turn 内拿到 JSON 时,结构化数据 API 最省事:SandBase 目录里每个平台有几十到几百个公开数据端点(抖音、TikTok、微博、小红书、Instagram 等),同步调用,每个组织每天(UTC)在符合条件的 API 上有 100 次免费数据调用,超出后按次计费,单价以目录页为准。结构化端点覆盖不到的网站或字段,Apify 更合适。真正的问题不是”选哪个 API”,而是”你的 agent 决策循环到底需要什么”——这个答案决定了从架构到预算的一切。
你的 agent 需要社媒数据。不是仪表盘,不是 CSV 导出,不是周报——是在做决策的那个瞬间拿到 JSON。
听起来简单,真做起来就发现:大部分平台没有面向任意公开数据、无需授权的通用 API。官方开放平台是给授权、绑定账号的场景用的,OAuth 流程假设有个人类坐在那里点授权按钮。第三方选项从”一次 HTTP 请求直接返回 JSON”到”跑一个浏览器任务,等它跑完,解析出来什么算什么”全都有。
这些方式之间的差异不是细节。它决定了你的 agent 一小时能做多少个决策。
四个场景暴露真实差异
在比较各种方式之前,先用具体场景定义”agent 友好”到底是什么意思。
场景 1:竞品监控(每日循环)
一个 agent 跟踪 10 个竞品抖音账号。每天早上检查:发了什么新视频、互动数据变化、内容主题偏移。
每个周期需要:
- 10× 用户资料(粉丝数、简介变化)
- 10× 最新视频列表(每个账号作品列表第一页,带点赞/评论/分享数)
- 10× 视频详情(针对越过阈值的视频)
总计约 30 次调用/天。
关键要求:30 次调用最好在一个 agent turn 内完成。如果每次调用都变成”提交任务再轮询”,agent 的决策窗口会随每个任务的排队和运行时间一起膨胀。早报变成了早上白费的时间。
场景 2:KOL 筛选(批量 + 判断)
一个品牌 agent 评估 200 个小红书博主做投放。每个 KOL 需要:粉丝数、近期笔记互动、内容主题、粉丝质量信号。
需要:
- 200× 用户资料
- 200× 近期笔记(每人 10 条 = 2,000 次笔记请求)
- 可选:200× 粉丝增长历史(如果有)
总计约 2,400 次调用,整批筛选完成。
关键要求:结构化响应 schema 一致。Agent 把每个 KOL 的数据喂给打分函数。如果有些响应字段名不一样或缺字段,打分函数就会在这些记录上报错——处理这些异常的工程时间比数据本身贵得多。
场景 3:实时趋势检测(持续)
一个 agent 每 15 分钟检查一次微博热搜,检测品牌提及或行业热点,触发 Slack 告警。
每个周期需要:
- 1× 热搜列表
- 3-5× 话题详情(针对命中的条目)
- 可选:热门评论情感抽样
总计约 5 次/15 分钟 = 480 次/天。
关键要求:延迟低且可预测。如果每轮调用耗时波动很大,agent 无法维持稳定的 15 分钟节奏。要么漏掉窗口,要么积压。
场景 4:跨平台内容分析(研究)
一个策略 agent 采集抖音、微博、小红书三个平台某个话题下的 Top 50 内容,分析跨平台内容模式。
需要:
- 3× 搜索端点(每平台一个,各 50 条结果)
- 150× 帖子/视频详情
- 150× 互动数据
总计约 303 次调用跨 3 个平台。 挑战:三个不同 API,三套鉴权,三种响应 schema,三套错误码。
这时契约归一化最重要。如果调抖音搜索和小红书搜索需要不同代码路径,agent 实现复杂度直接三倍。
五种方式在四个场景下的表现
这张表是定性的设计对比,不是基准测试。Apify、Bright Data、RapidAPI 的延迟和稳定性取决于你选的具体 Actor、产品或提供商;Bright Data 的数据集和 Scraper API 情况也不同。
| 方式 | 场景 1(监控) | 场景 2(批量) | 场景 3(实时) | 场景 4(跨平台) |
|---|---|---|---|---|
| 结构化数据 API | ✅ 一次请求直接返回 JSON | ✅ 每个端点 schema 稳定 | ✅ 适合 15 分钟循环 | ✅ 如果覆盖全部 3 平台 |
| Apify | ⚠️ 取决于 Actor 运行时间 | ⚠️ 输出 schema 由各 Actor 决定 | ⚠️ 取决于 Actor 运行时间 | ⚠️ 每个网站一个 Actor,各自 schema |
| Bright Data(数据集 / Scraper API) | ⚠️ 数据集按你选的周期刷新,不是逐条查询;Scraper API 按请求采集 | ✅ 批量数据集适合 | ⚠️ Scraper API 取决于爬虫运行时间;数据集取决于上次刷新时间 | ⚠️ schema 由各数据集或爬虫决定 |
| RapidAPI | ⚠️ 因提供商而异 | ⚠️ schema 因提供商而异 | ⚠️ 因提供商而异 | ❌ 跨提供商无一致性 |
| 官方 API | ❌ 需授权、绑定账号 | ❌ 限于审核通过的用途 | ⚠️ 审批通过则可用 | ❌ 每平台鉴权不同 |
1. 结构化数据 API — 同步优先
这类服务按平台提供结构化端点,在同一个 HTTP 响应里返回 JSON。截至 2026-10-01,SandBase 公开目录显示:
| 平台 | 目录端点数(2026-10-01) | SandBase 价格 |
|---|---|---|
| 抖音 | 262 | 按次计费(见目录页) |
| TikTok | 145 | 按次计费(见目录页) |
| 81 | 按次计费(见目录页) | |
| 微博 | 52 | 按次计费(见目录页) |
| 小红书 | 34 | 按次计费(见目录页) |
目录里还有 YouTube、Twitter/X 等平台的端点。
每个数量都取自对应平台的目录页,下面是 Instagram 目录页。
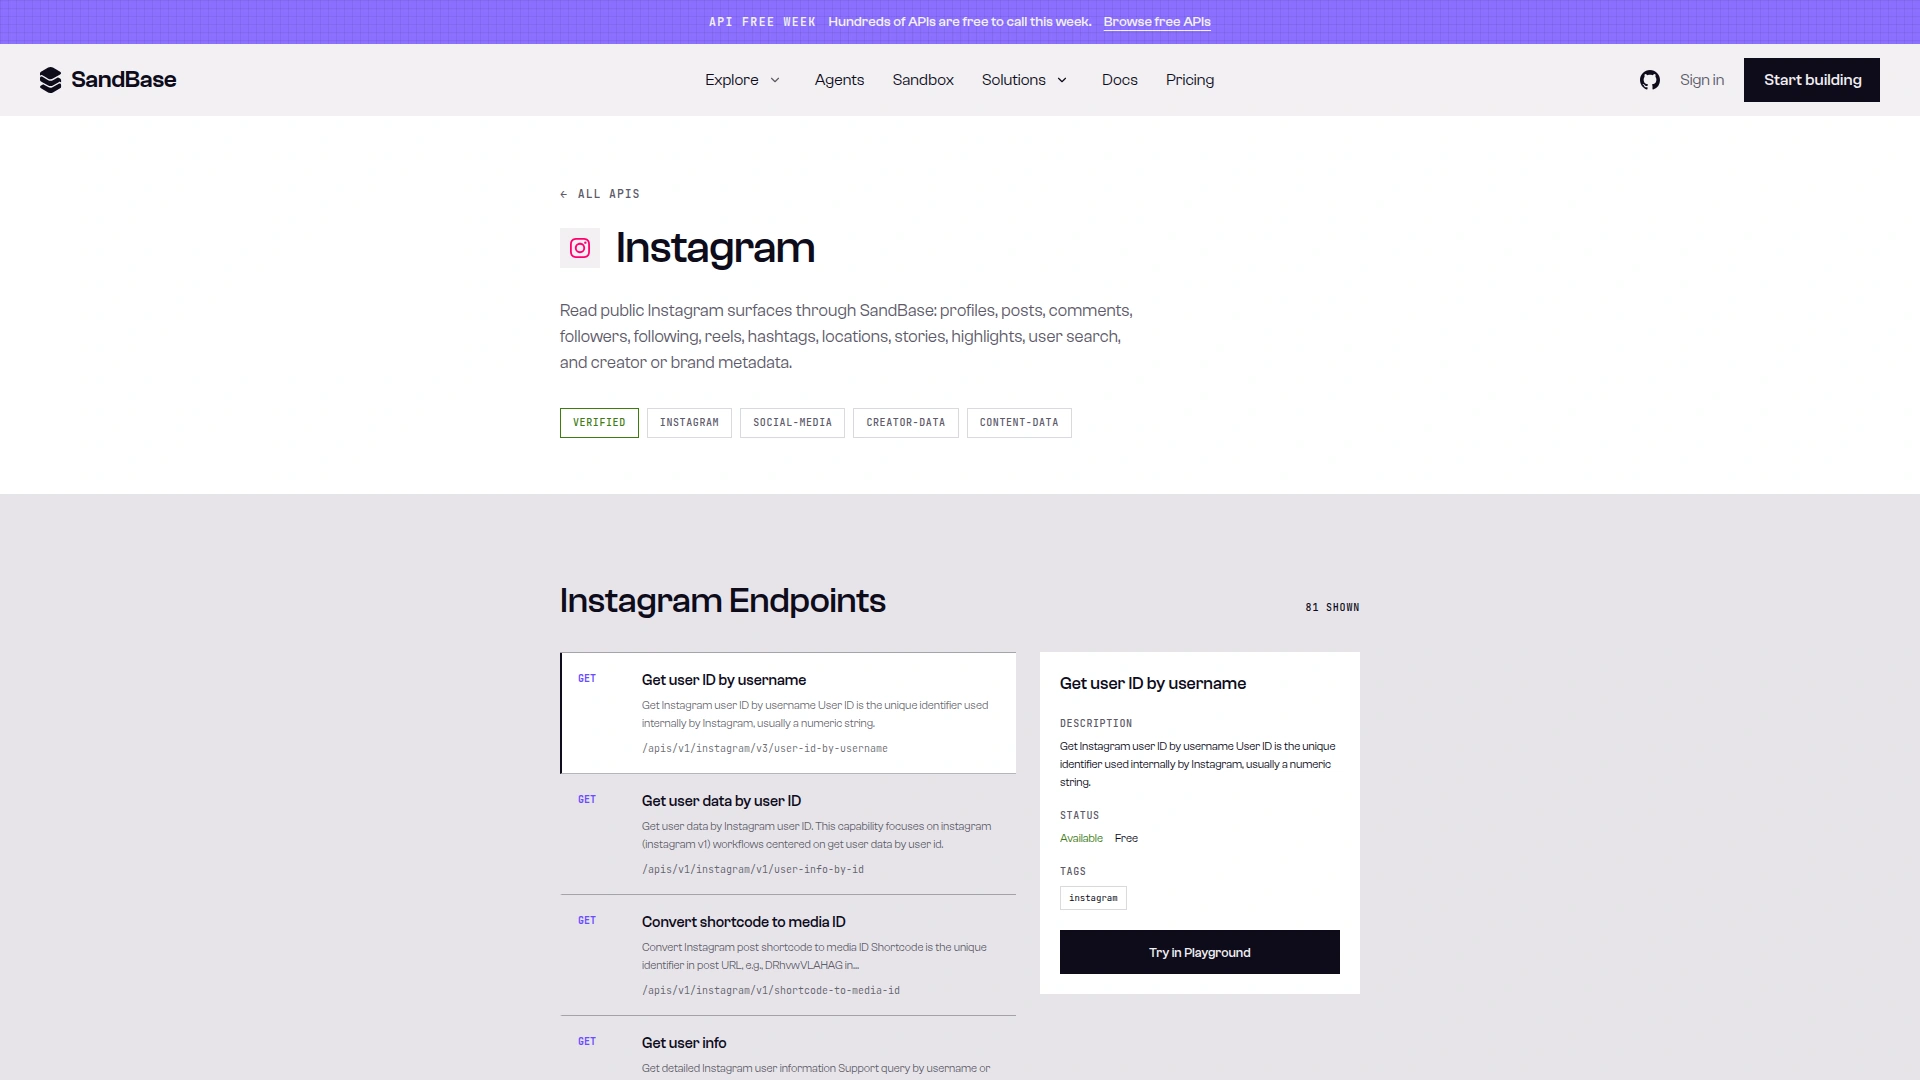
截图:Instagram 目录页显示「81 SHOWN」,与表格一致,user-id-by-username 标注为 Available · Free(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
范围说明:本文调用的端点(douyin/app-v3/one-video、instagram/v3/user-id-by-username、instagram/v1/user-info-by-id、weibo/web-v2/hot-search)是公开、只读的数据端点。需要 SandBase API key,且不是与这些平台的官方合作。这些端点不返回私密账号数据、私信或仅账号所有者可见的分析数据,也不做发布或任何账号操作。上面的目录数量包含所有上架端点,不只是公开数据端点。
依赖鉴权的能力。 目录里有些端点不在上述范围内。例如 tiktok/creator/account-insights-overview 需要传入用户 cookie 做鉴权,返回 TikTok Shop 创作者账号的指标(收入、曝光、点击、订单)。本文不使用它。另外,xiaohongshu/pgy/blogger-fans-profile 返回某个达人在蒲公英平台上的粉丝分布数据(性别、年龄、地域、兴趣、设备);其参考文档列出的唯一输入是达人 user_id。
所有数据调用走同一个路由:POST https://api.sandbase.ai/v1/api/<vendor>/<path>,API key 放在 Bearer 头里,JSON body 只放该端点的参数。完成态响应是信封 { id, status, model, outputs: [{ data }] },平台数据在 outputs[0].data。下面用到的端点参考:douyin/app-v3/one-video、instagram/v3/user-id-by-username、instagram/v1/user-info-by-id。
one-video 参考页列出了路由,以及下面第一个调用发送的唯一必填字段。
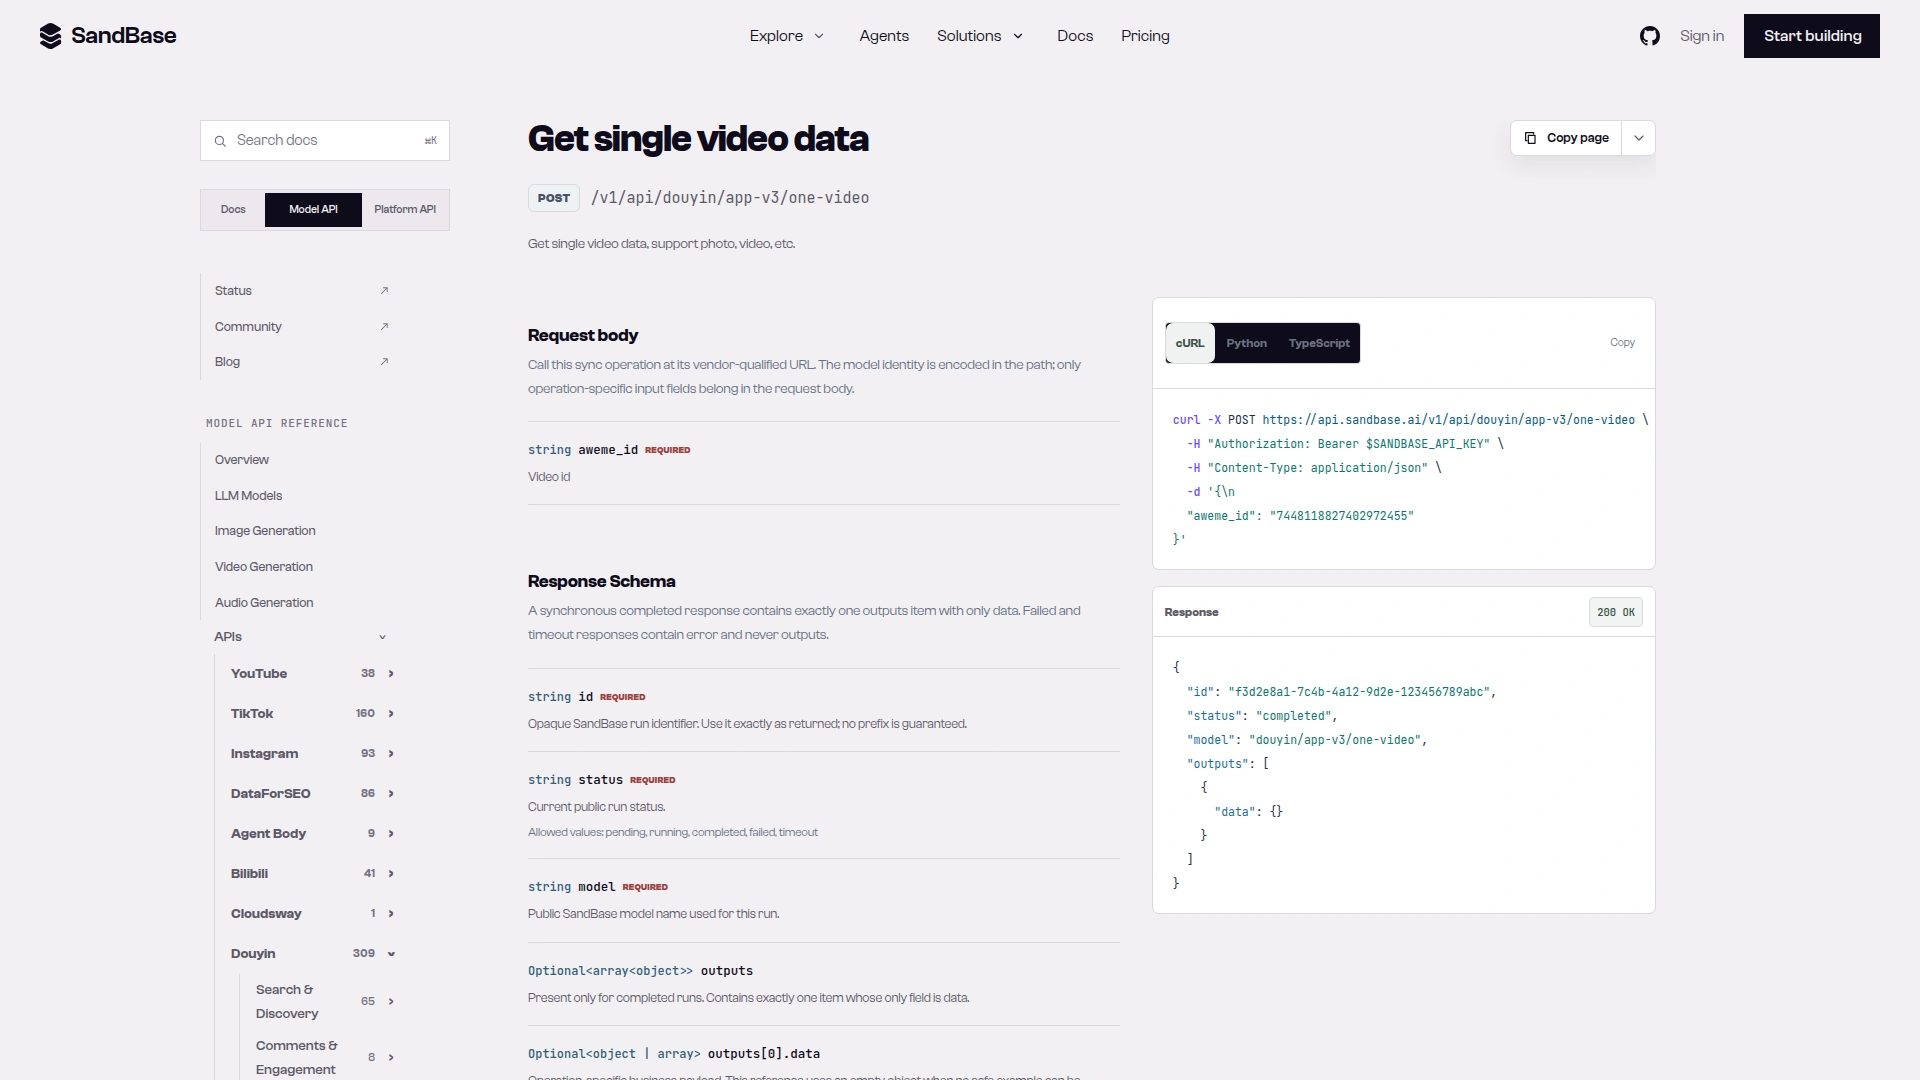
截图:douyin/app-v3/one-video 参考页显示 POST /v1/api/douyin/app-v3/one-video、一个必填的 aweme_id 字符串字段,以及 outputs[0].data 信封(2026-10-02 截取)。
import os
import requests

def run(model: str, params: dict) -> dict:
    """调用 SandBase 数据 API,返回 outputs[0].data。"""
    resp = requests.post(
        f"https://api.sandbase.ai/v1/api/{model}",
        headers={"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"},
        json=params,
        timeout=120,
    )
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}

video = run("douyin/app-v3/one-video", {"aweme_id": "7688258340685679882"})["aweme_detail"]
print(video["desc"], video["statistics"])

ig_id = run("instagram/v3/user-id-by-username", {"username": "natgeo"})["user_id"]
profile = run("instagram/v1/user-info-by-id", {"user_id": ig_id})
print(profile["full_name"], profile["edge_followed_by"]["count"])
Tested on 2026-10-01(UTC)。 使用的公开资源:瑞幸咖啡抖音官方账号的一条视频、National Geographic 的 Instagram 官方账号(natgeo)。请求与上面代码完全一致。截短后的真实返回(outputs[0].data):
douyin/app-v3/one-video,参数 {"aweme_id": "7688258340685679882"}:
{
  "aweme_detail": {
    "aweme_id": "7688258340685679882",
    "desc": "在瑞幸,LOVE的意思是……#love转场#国庆节#节假日#瑞幸最美门店#瑞幸咖啡",
    "create_time": 1790823600,
    "statistics": {
      "digg_count": 184,
      "comment_count": 23,
      "share_count": 19,
      "collect_count": 18,
      "play_count": 0
    },
    "author": { "nickname": "瑞幸咖啡", "unique_id": "luckincoffee01" }
  }
}instagram/v3/user-id-by-username,参数 {"username": "natgeo"};再用返回的 {"user_id": "787132"} 调 instagram/v1/user-info-by-id:
{ "user_id": "787132" }{
"id": "787132",
"username": "natgeo",
"full_name": "National Geographic",
"is_verified": true,
"is_private": false,
"edge_followed_by": { "count": 268469840 },
"edge_follow": { "count": 194 }
}Run id:b4d4888f-7814-4a31-bbfa-f614a25193d7、1883959b-97d8-4a69-a56c-b905cff99650、2b730378-b3d8-41c6-b538-2896b14d5774。业务字段名只是这几次调用观察到的,不是文档保证,生产代码里用 .get() 防御式读取。注意这条视频的 play_count 返回的是 0,不核实就别把它当播放量。
每个端点形状稳定,是场景 2(批量)可靠和场景 3(实时)可行的根基。
实际场景的调用量(每个组织每天(UTC)在符合条件的 API 上有 100 次免费数据调用,所以端点符合条件时,每天 30 次的竞品监控用得下;更大的场景,把每天超出 100 次的调用乘以各端点的目录单价,就是数据预算):
| 场景 | 每天调用 | 每月调用 |
|---|---|---|
| 10 个账号竞品监控 | 30 | 约 900 |
| 每周 200 KOL 筛选 | 343(均摊) | 约 10,290 |
| 15 分钟趋势检测 | 480 | 约 14,400 |
| 跨平台研究(每周) | 43(均摊) | 约 1,300 |
每个端点的模型页都会显示当前的按次单价,比如上文用到的 Instagram ID 查询。下面的截图摄于 2026-10-02,当时页面还显示促销期的 Free。
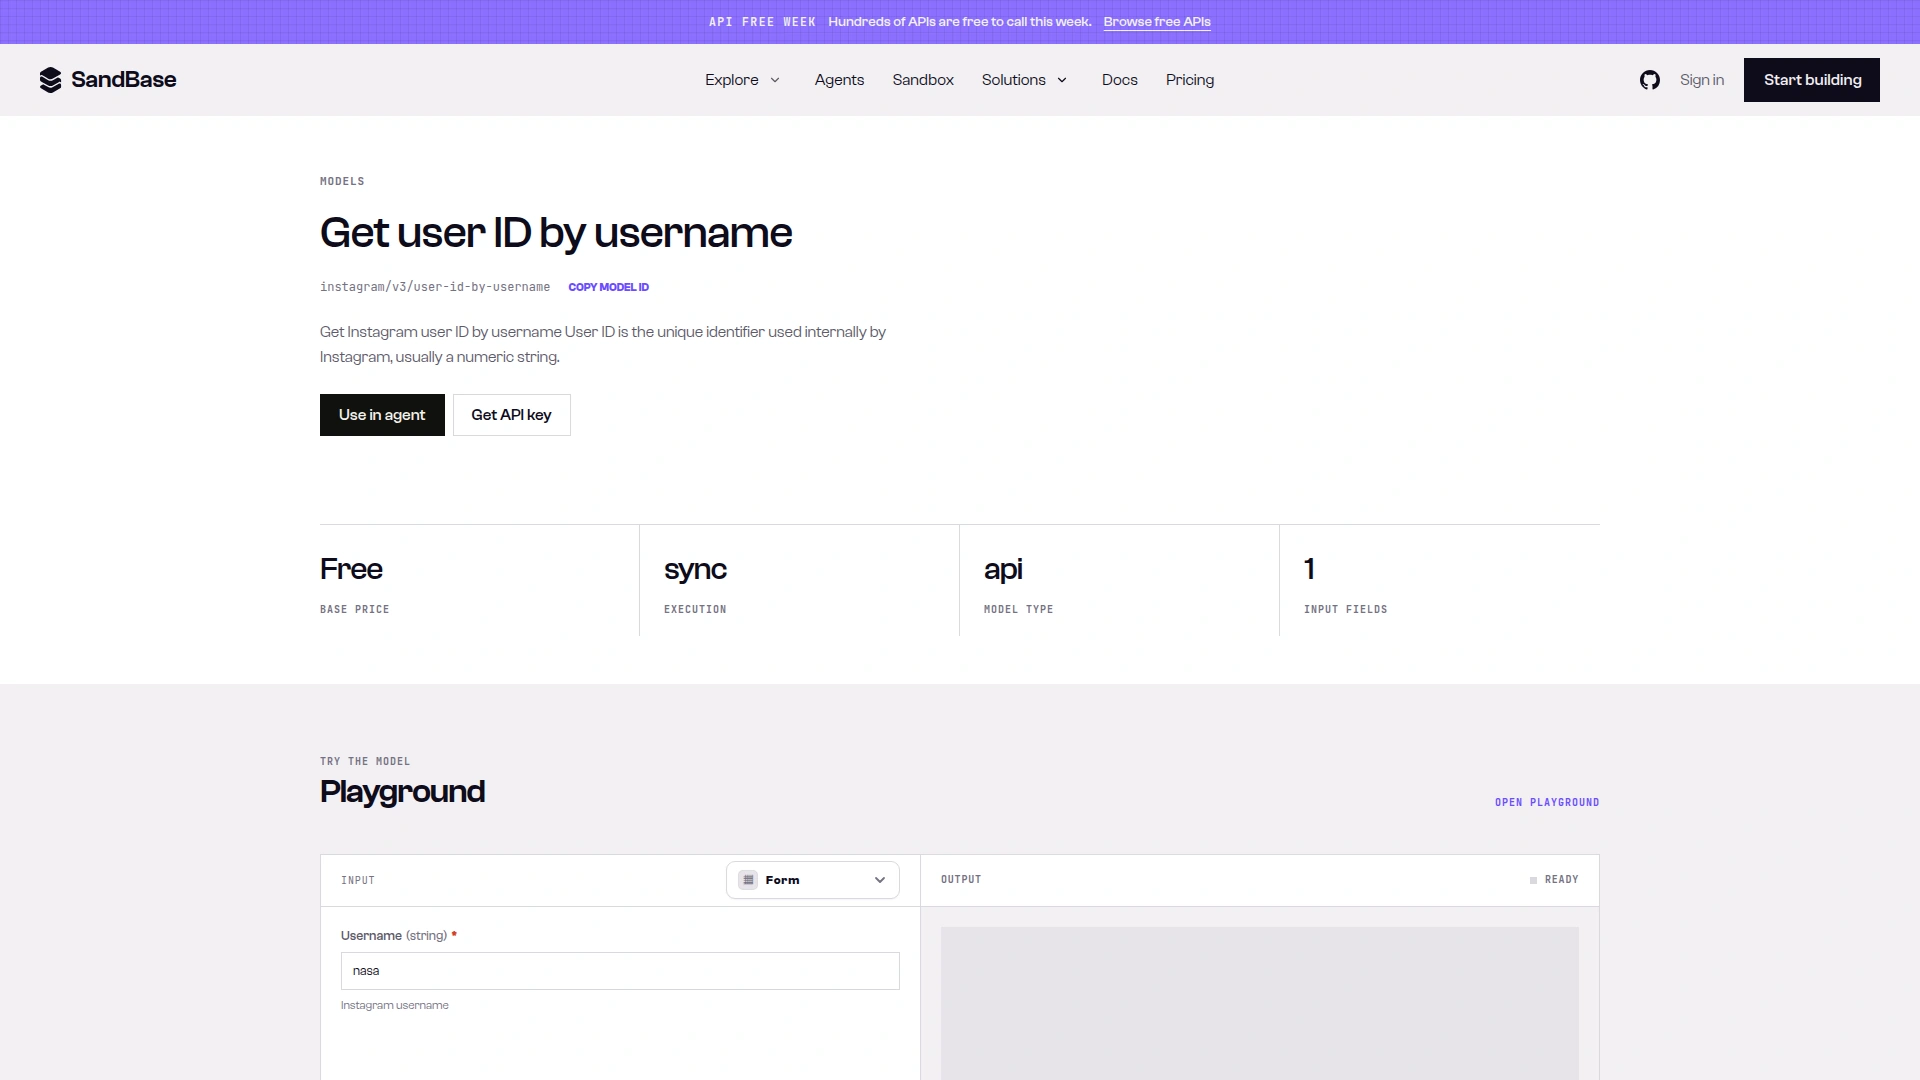
截图:instagram/v3/user-id-by-username 模型页显示基础价格「Free」、执行方式「sync」和一个输入字段(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
真正的局限:覆盖是按平台、按端点来的。围绕它设计之前,先在目录里确认 agent 需要的数据确实有;目录里没有的网站或字段,就得看 Apify 这类爬取工具。
2. Apify — 结构化端点覆盖不到时的选择
Apify 的模型不一样。按 Apify 文档的说法,Actor 是接收 JSON 输入、执行网页抓取或浏览器自动化等任务的无服务器云程序。Apify Store 里有很多公开 Actor,由作者各自开发和定价。
你可以通过 API 启动一次 Actor 运行,跑完再取结果;也可以用同步运行接口,它会等运行结束直接返回 dataset 数据。不管哪种,响应时间就是 Actor 的运行时间,取决于 Actor 做了什么(比如用浏览器加载页面)。输出 schema 由各个 Actor 自己定义,不同网站的两个 Actor 通常返回不同结构。
Apify 真正适合的地方:
- 结构化目录里没有的网站或字段——选一个或自己写一个 Actor,正好抓你要的
- 定制爬取——导航、提取、调度都由你控制
- 一次性或定时的批量任务,能接受等一次运行跑完
价格取决于具体 Actor 和你的 Apify 套餐,估算前先看 Actor 页面和 Apify 的定价页。放进 agent 循环时,要为运行时间波动做准备:超时、重试,必要时加队列。
3. Bright Data — 数据集做批量,Scraper API 做按需采集
Bright Data 的产品线包括代理网络、Scraper API 和数据集。数据集和 Scraper API 的行为不同,要按产品来选。
数据集是市场现成或定制的记录集合。根据其数据集页面(2026-10-01 UTC 查看),你可以选立即可用的预采集数据,也可以选新采集的数据,可以按周期订阅刷新、只买新增或更新的记录,并通过 API、webhook 或云存储筛选和获取数据。页面写的是按记录计价、有最低起订额,具体条款以页面为准。你拿到的仍是一个筛选后下载的数据集,而不是对某条具体内容的查询。
需要按请求采集时,Bright Data 有另一个产品 Scraper API:用目标 URL 调用现成的爬虫,通过 API、webhook 或云存储拿到解析后的结果。输出字段和响应时间取决于你选的爬虫。
最适合:数据集适合场景 2 和场景 4(批量和研究)。「给我上个月 TikTok 上一大批关于烹饪的视频」是数据集查询。「给我这个创作者现在最新的视频」则应该看对应网站的 Scraper API,并对照你的循环检查它的交付方式和运行时间。
代理方式是另一回事——你自己的爬虫代码走他们的网络。控制力最大,但解析、反封锁和维护全在你身上。
4. RapidAPI 聚合 — 原型快,生产难
RapidAPI 是一个市场,独立提供商在上面挂 API,其中有不少社媒数据 API。每家提供商各自决定 schema、价格、限额和稳定性。做个快速原型很方便。生产环境的 agent 要每 15 分钟跑一次场景 3,就得逐家确认:schema 和文档是否一致、出错时怎么失败、平台改版后谁来修。跨平台(场景 4)混用多家提供商,也就意味着混用多套 schema 和鉴权。
5. 官方开放平台 — 合规选择
| 平台 | 设计用途 | 鉴权 |
|---|---|---|
| 抖音开放平台 | 代表已授权用户和企业的应用 | OAuth 2.0 + 应用审核 |
| TikTok for Developers | 登录、展示和内容类 API;另有面向审批通过研究者的 Research API | OAuth + 审核 |
| 微博开放平台 | 代表已授权用户的应用 | OAuth 2.0 |
| Meta 的 Instagram 平台 | 企业/创作者账号及代表这些账号的应用 | Meta 应用 + 账号授权 |
| 小红书(商业) | 合作伙伴和电商集成 | 商务协议 |
审核周期和限流因产品和应用而异,以各开放平台的当前说明为准。
根本矛盾:这些 API 假设有人授权了自己账号或数据的访问。agent 监控竞品的公开帖子——竞品不会给你 OAuth token。官方 API 适合你自己运营的账号(分析后台、内容管理、电商集成),不适合情报场景。
架构影响
数据方式的选择直接塑造 agent 架构:
同步路径(结构化 API):
Agent turn 开始 → 调数据 API → 拿到 JSON → 推理 → 决策 → 执行任务式路径(Actor/爬虫):
Agent turn 开始 → 启动爬取任务 → 等运行结束/轮询 → 拿到数据 → 推理 → 决策 → 执行任务式路径迫使你要么:(a) turn 时间被最慢的任务拉长(面向用户的 agent 不行),要么 (b) 两阶段架构把数据采集和推理解耦(多一层复杂度)。
对频繁决策要新数据的 agent(场景 1、3),同步 API 省掉了这一层基础设施。
让原始 API 可编排
拿到数据是第一步。让它在 agent workflow 里真正好用是第二步。零散的 API 调用如果能被:
- 归一成统一契约——调抖音用户资料和微博热搜用同一种请求格式
- 组合进多步流程——搜索结果直接喂给打分步骤,不用手动解析
- 通过 MCP 暴露——支持 Model Context Protocol 的 agent 可以直接发现和调用数据 API,不用写集成代码
- 可观测——追踪 agent 调了哪些数据、做了什么决策
- 封装成 Skill——“筛选 200 个 KOL”打包一次,别的 agent 直接用
MCP 的角度
现在越来越多 agent 框架支持 Model Context Protocol(MCP)做工具发现。社媒数据 API 如果以 MCP tool 的形式暴露,Claude Desktop、Cursor、OpenHands 等 MCP 兼容的 agent 都能直接使用,不用写集成代码。
模式:不是在代码里硬编 API 调用,而是把数据端点声明为带 schema 的 MCP tool。Agent 在运行时发现它、用正确参数调用、处理结果。这对社媒数据很合适,因为同一个”获取用户资料”工具,不管哪个 agent 框架来编排都能用。这是一种通用架构模式;本文不涉及把 SandBase 端点接入某个具体外部 MCP 客户端。
——价值就从”一次 API 调用”升维到”agent 行为”了。
这是 agent 平台做的事。以 SandBase 为例,截至 2026-10-01 目录显示抖音 262、TikTok 145、Instagram 81、微博 52、小红书 34 个端点,不管上游是 GET 还是 POST,全部通过同一个 POST /v1/api/<vendor>/<path> 路由调用、返回同一种信封。契约怎么搭起来的,见几百个异构社媒接口怎么归一成一个 Agent 契约。数字不是重点,重点是 agent 能把”跨平台竞品分析”组合成一个可复用的 skill。
有好的 API 想让 AI Agent 用起来?联系我们——我们持续在找优质能力接入生态。
FAQ
完整的竞品监控搭起来要多少钱?
10 个抖音账号每天监控,用结构化数据 API:每天约 30 次数据调用,端点符合条件时用得下每个组织每天 100 次的免费数据调用(超出后按 SandBase 目录单价按次计费),再加 LLM 分析。LLM 费用是估算,取决于你的 prompt:每天一次总结,约 3,000 输入 token、500 输出 token,用 openai/gpt-4.1-mini(截至 2026-10-01 SandBase 价格为输入 $0.40/M、输出 $1.60/M),即 3,000 × $0.40/M + 500 × $1.60/M = $0.0012 + $0.0008 = 每天 $0.002,30 天约 $0.06。对同一批品牌加上微博和小红书监控,数据调用大约每天 60 次。
我的 agent 需要 Instagram 数据,最靠谱的选择是什么?
先用结构化公开数据端点。截至 2026-10-01,SandBase 目录显示 81 个 Instagram 端点,和其他平台一样同步调用:比如 instagram/v3/user-id-by-username 把 natgeo 解析成 787132,instagram/v1/user-info-by-id 返回该账号的公开资料(见上文实测返回;完整查询流程见 Instagram 用户ID查询API使用教程)。这些只覆盖公开资料和内容。账号所有者侧的洞察数据或发布操作,用 Meta 官方 Instagram 平台并获得账号授权。两者都没有的字段,再考虑 Apify 上的爬取 Actor。
官方抖音 API 能做竞品情报吗?
不现实。抖音官方 OAuth 要求账号所有者授权你的应用。你的竞品不会授权你的情报工具。官方 API 面向的是用户操作自己数据的场景——数据分析后台、内容管理、电商集成。
同步 API 和爬虫做趋势检测的延迟差多少?
取决于具体工具,最好自己测。作为一个数据点:2026-10-01 共 9 次调用(douyin/app-v3/one-video、instagram/v1/user-info-by-id、weibo/web-v2/hot-search 各 3 次),从我们客户端看每次耗时 1.7 到 5.9 秒。样本很小,不是保证。爬取任务对应的数字是任务运行时间加轮询时间。一个 15 分钟循环每轮 5 次调用,关键是最坏情况也能稳稳落在窗口里。
跨平台分析怎么不维护三套集成?
用一个做契约归一化的平台层。调抖音搜索和小红书搜索用同一个请求格式和鉴权时,agent 的跨平台逻辑是一条代码路径而不是三条。在 SandBase 上就是上面那个统一的 POST /v1/api/<vendor>/<path> 路由和 outputs[0].data 信封。
关于搜索类 API 的更多对比,可以看我们之前写的 AI 搜索 API 横评和 Agent 搜索 API Top 6。
要点
- 选数据方式首先是架构决策,不是供应商对比——同步还是任务式,决定了 agent 整体设计
- 结构化数据 API(一次请求返回 JSON;每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按 SandBase 目录单价按次计费)对频繁基于公开社媒数据做决策的 agent 最省事,中国平台和 Instagram 都适用
- 结构化端点覆盖不到的网站或字段用 Apify——要为 Actor 运行时间、超时和重试做准备
- 每日社媒监控 agent 的真实成本主要是 LLM 花费和调用量——数据便宜,用好它的架构才是真正的投入
- 乘数效应来自平台层:契约归一、skill 组合、可观测性,把零散 API 调用变成可复用的 agent 能力