用 OpenAI SDK 搭社媒监控 Agent
用 Python 搭一个抖音 + 微博品牌监控 Agent:requests 调 SandBase 公开数据 API(POST /v1/api),OpenAI SDK 负责 tool-calling 和情绪告警。完整代码、实测返回和按 token 单价算的成本估算。
先说结论 — 一个可用的 Python 社媒监控 Agent(约 340 行的参考实现,不是最小片段)。用
requests调 SandBase 公开数据 API(POST /v1/api/<端点>),用 OpenAI SDK 做 LLM tool-calling。它在抖音和微博搜索你的关键词,让 LLM 给出情绪评估;LLM 标记需要告警,或它报告的负面占比超过阈值时,产生告警。实测日期:2026-10-01(UTC)。
我们在构建什么
一个社媒监控 Agent:
- 定期在抖音和微博搜索指定关键词
- 让 LLM 阅读结果,评估情绪和紧急程度
- LLM 标记需要告警,或它报告的负面占比高于
ALERT_THRESHOLD_NEGATIVE时,产生结构化告警 - 数据获取用 requests 直接 HTTP,LLM 推理用 OpenAI SDK
它不做量级飙升检测:每次搜索只读一页结果,单周期的结果条数不能代表声量。需要什么条件见添加趋势对比。
为什么这样分
SandBase 的每个平台数据 API 都有自己的路由:POST https://api.sandbase.ai/v1/api/<vendor>/<path>,JSON body 只放该端点的参数。LLM 走 OpenAI 兼容的 chat completions 接口。所以:
requests做数据获取(每个端点同步返回结构化 JSON)- OpenAI SDK 做 LLM 推理(chat completions + tool-calling)
- 一把 API key 同时认证两者(同一个
Authorization: Bearer头)
用的是什么数据
这里用到的都是公开、只读数据:任何人在抖音、微博上都能看到的搜索结果和公开评论。需要一个 SandBase API key。SandBase 不是抖音或微博的官方合作方;这个 Agent 读不到私密账号数据、私信或账号主才能看的后台分析,也不能发布内容或执行账号操作。
| 本教程(SandBase 公开数据 API) | 官方开放平台(抖音开放平台、微博开放平台) | |
|---|---|---|
| 接入方式 | 一把 SandBase API key | 注册应用并通过平台审核 |
| 范围 | 公开内容:关键词搜索、公开评论 | 面向授权、绑定账号的场景,针对授权了你应用的账号 |
| 账号操作(发布、回复、私信) | 不支持 | 平台授予权限时可用 |
| 账号后台分析 | 不支持 | 限已授权账号 |
| 适合 | 跨平台盯某个关键词的公开讨论 | 需要操作或读取你管理的账号的私有数据 |
两个平台都没有面向任意公开数据、无需授权的通用 API,这正是本方案补上的部分。
前置要求
pip install openai requests pydantic你需要一个 SandBase API key,并能访问:
LLM 客户端走 SandBase 兼容 OpenAI 的 POST /v1/chat/completions 接口,说明见 Chat Completions 指南;模型 ID 保留服务商前缀(openai/gpt-4.1-mini)。2026-10-01(UTC)我们用 model: "openai/gpt-4.1-mini" 加一个 tools 定义请求该接口,返回 HTTP 200,finish_reason 为 "tool_calls",并带有一条 tool_calls。
代码里每个数据调用的端点参考:
douyin/search/general-search-v2(keyword、cursor、sort_type)weibo/web-v2/realtime-search(query、page)douyin/web/video-comments(aweme_id、cursor、count)
execute_tool 里抖音搜索的请求体就照着下面这页端点参考写:路由是 POST /v1/api/douyin/search/general-search-v2,可选字段里有 keyword、cursor 和 backtrace。
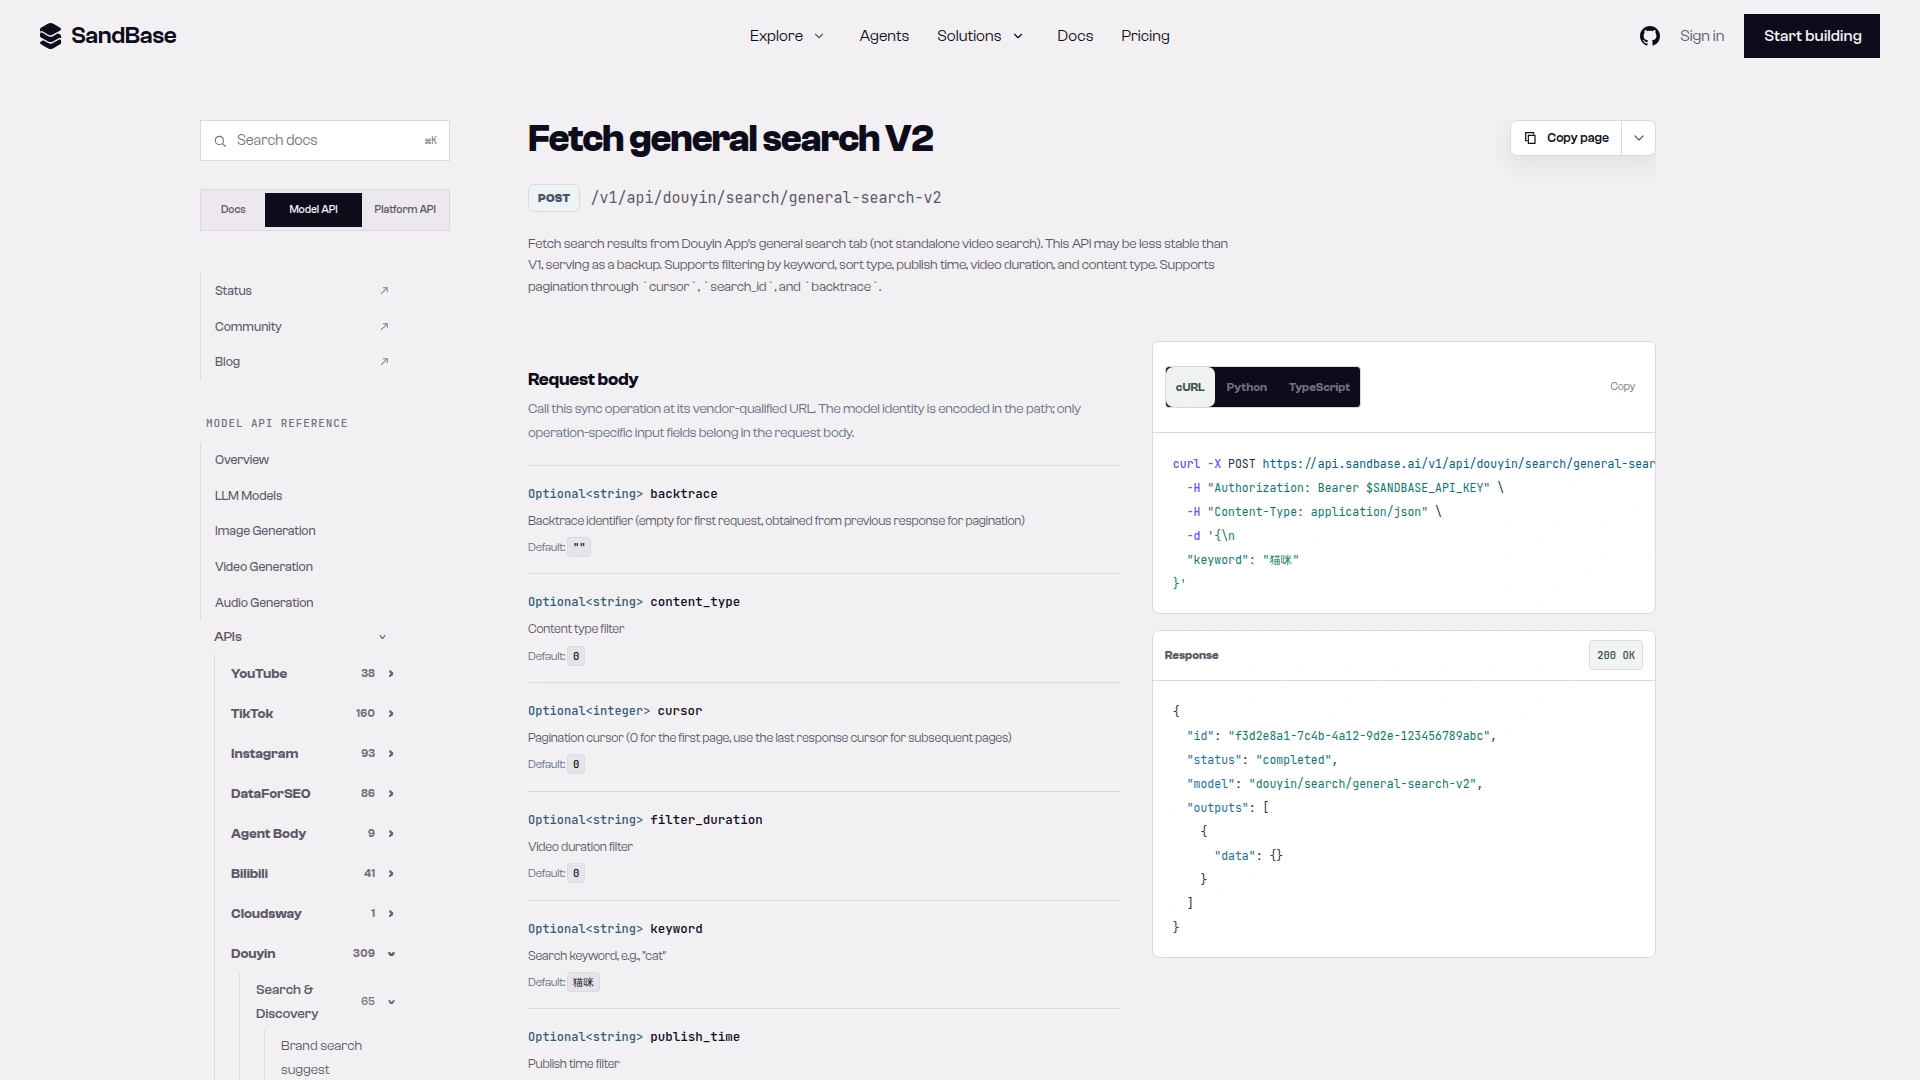
截图:douyin/search/general-search-v2 端点参考页,能看到 POST 路由、backtrace、cursor、keyword 字段,以及 helper 读取的 outputs[0].data 响应结构(2026-10-02 截取)。
完整 Agent 代码
"""
社媒监控 Agent — OpenAI SDK + 直接 HTTP 模式
监控抖音和微博品牌提及,分析情绪。
数据获取用 requests 调 SandBase 数据 API,LLM 推理用 OpenAI SDK。
"""

import json
import os
import time
from collections import deque
from datetime import datetime
import requests
from openai import OpenAI
from pydantic import BaseModel

# --- 配置 ---
SANDBASE_API_KEY = os.environ["SANDBASE_API_KEY"]
API_BASE = "https://api.sandbase.ai/v1/api"
MONITOR_KEYWORDS = ["你的品牌", "YourBrand", "品牌产品名"]
CHECK_INTERVAL_SECONDS = 900      # 15 分钟
ALERT_THRESHOLD_NEGATIVE = 30     # LLM 报告的负面占比 > 30% 时告警
MAX_ITERATIONS = 4                # 每个关键词 tool-use LLM 调用上限
MAX_DATA_CALLS_PER_KEYWORD = 4    # 每个关键词数据 API 调用上限
MAX_RETRIES = 3

# --- 客户端设置 ---
HEADERS = {
    "Authorization": f"Bearer {SANDBASE_API_KEY}",
    "Content-Type": "application/json",
}

# OpenAI SDK 客户端,仅用于 LLM 推理
client = OpenAI(
    base_url="https://api.sandbase.ai/v1",
    api_key=SANDBASE_API_KEY,
)

# --- 数据模型 ---
class Alert(BaseModel):
    timestamp: str
    severity: str  # "low", "medium", "high", "critical"
    keyword: str
    platform: str
    reason: str
    details: str

# --- 限流(你自己设定的客户端节奏,不是 SandBase 文档里的限额) ---
class RateLimiter:
    def __init__(self, max_calls: int, window_seconds: float):
        self.max_calls = max_calls
        self.window = window_seconds
        self.calls = deque()

    def wait(self):
        now = time.monotonic()
        while self.calls and self.calls[0] <= now - self.window:
            self.calls.popleft()
        if len(self.calls) >= self.max_calls:
            time.sleep(self.calls[0] + self.window - now)
        self.calls.append(time.monotonic())

limiter = RateLimiter(max_calls=30, window_seconds=60)

# --- 工具名 -> SandBase 端点 ---
TOOL_ENDPOINTS = {
    "search_douyin_content": "douyin/search/general-search-v2",
    "search_weibo_topics": "weibo/web-v2/realtime-search",
    "get_douyin_video_comments": "douyin/web/video-comments",
}

# --- 工具定义 ---
tools = [
    {
        "type": "function",
        "function": {
            "name": "search_douyin_content",
            "description": "搜索抖音匹配关键词的视频,返回近期视频及互动指标。",
            "parameters": {
                "type": "object",
                "properties": {
                    "keyword": {"type": "string", "description": "搜索关键词"},
                    "count": {"type": "integer", "description": "返回结果数(最多 20)", "default": 10}
                },
                "required": ["keyword"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "search_weibo_topics",
            "description": "搜索微博匹配关键词的近期帖子,返回帖子及互动数据。",
            "parameters": {
                "type": "object",
                "properties": {
                    "keyword": {"type": "string", "description": "搜索关键词"},
                    "count": {"type": "integer", "description": "返回结果数(最多 20)", "default": 10}
                },
                "required": ["keyword"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "get_douyin_video_comments",
            "description": "获取特定抖音视频的公开评论,用于情绪分析。",
            "parameters": {
                "type": "object",
                "properties": {
                    "video_id": {"type": "string", "description": "抖音视频 ID(search_douyin_content 返回的 video_id)"},
                    "count": {"type": "integer", "description": "返回评论数(最多 20)", "default": 20}
                },
                "required": ["video_id"]
            }
        }
    }
]

# --- 数据 API 调用:POST /v1/api/<端点>,只读 outputs[0].data ---
def call_data_api(endpoint: str, params: dict) -> dict:
    """先过限流;网络错误、HTTP 429 和 5xx 时退避重试。"""
    last_error = None
    for attempt in range(MAX_RETRIES):
        limiter.wait()
        try:
            resp = requests.post(f"{API_BASE}/{endpoint}", headers=HEADERS, json=params, timeout=90)
        except (requests.ConnectionError, requests.Timeout) as e:
            last_error = e
        else:
            if resp.status_code != 429 and resp.status_code < 500:
                resp.raise_for_status()  # 其他 4xx(参数错、key 错)重试也没用
                body = resp.json()
                outputs = body.get("outputs") or []
                if body.get("status") != "completed" or not outputs:
                    raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
                return outputs[0].get("data") or {}
            last_error = RuntimeError(f"HTTP {resp.status_code} from {endpoint}")
        if attempt < MAX_RETRIES - 1:
            time.sleep(2 ** attempt)  # 1s、2s
    raise RuntimeError(f"{endpoint} 重试 {MAX_RETRIES} 次仍失败:{last_error}")

def execute_tool(tool_name: str, arguments: dict) -> str:
    """把工具调用路由到对应的 SandBase 端点。
    原始响应很大,每个工具只把精简列表交给 LLM。"""
    count = min(int(arguments.get("count", 10)), 20)
    endpoint = TOOL_ENDPOINTS.get(tool_name)
    if endpoint is None:
        return json.dumps({"error": f"未知工具: {tool_name}"}, ensure_ascii=False)

    if tool_name == "search_douyin_content":
        data = call_data_api(endpoint, {"keyword": arguments["keyword"], "cursor": 0, "sort_type": "0"})
        items = []
        for card in data.get("business_data") or []:
            aweme = (card.get("data") or {}).get("aweme_info")
            if not aweme:
                continue  # 跳过相关搜索等非视频卡片
            stats = aweme.get("statistics") or {}
            items.append({
                "video_id": aweme.get("aweme_id"),
                "desc": aweme.get("desc"),
                "author": (aweme.get("author") or {}).get("nickname"),
                "likes": stats.get("digg_count"),
                "comments": stats.get("comment_count"),
                "shares": stats.get("share_count"),
            })
        return json.dumps(items[:count], ensure_ascii=False)

    if tool_name == "search_weibo_topics":
        data = call_data_api(endpoint, {"query": arguments["keyword"], "page": 1})
        posts = []
        for p in (data.get("parsed_data") or {}).get("results") or []:
            inter = p.get("interaction") or {}
            posts.append({
                "weibo_id": p.get("weibo_id"),
                "user": p.get("user_name"),
                "content": p.get("content"),
                "publish_time": p.get("publish_time"),
                "reposts": inter.get("repost_count"),
                "comments": inter.get("comment_count"),
                "likes": inter.get("like_count"),
            })
        return json.dumps(posts[:count], ensure_ascii=False)

    # get_douyin_video_comments
    data = call_data_api(endpoint, {"aweme_id": arguments["video_id"], "cursor": 0, "count": 20})
    comments = [
        {"text": c.get("text"), "likes": c.get("digg_count"), "replies": c.get("reply_comment_total")}
        for c in data.get("comments") or []
    ]
    return json.dumps(comments[:count], ensure_ascii=False)

# --- Agent 循环 ---
def run_monitoring_cycle(keywords: list[str]) -> list[Alert]:
    """运行一个监控周期:搜索、分析、告警。"""
    alerts = []

    for keyword in keywords:
        # 步骤 1:让 Agent 监控此关键词
        messages = [
            {
                "role": "system",
                "content": """你是社媒监控 Agent。对每个关键词:
1. 搜索抖音和微博的近期提及
2. 分析结果的情绪
3. 识别紧急项(投诉、危机、负面病毒内容)
4. 产出结构化评估

简洁明了。聚焦可操作信号,不要总结中性内容。
如果负面内容互动异常高,立即标记。"""
            },
            {
                "role": "user",
                "content": f"监控关键词:'{keyword}'。搜索两个平台并提供情绪分析。"
            }
        ]

        # 步骤 2:Agent 推理并调用工具(两层循环都有上限)
        data_calls = 0
        for _ in range(MAX_ITERATIONS):
            response = client.chat.completions.create(
                model="openai/gpt-4.1-mini",
                messages=messages,
                tools=tools,
                tool_choice="auto"
            )
            message = response.choices[0].message
            messages.append(message)

            # 没有工具调用,说明推理结束
            if not message.tool_calls:
                break

            # 每个工具调用都要有一条 tool 消息,即使被拒绝或失败
            for tool_call in message.tool_calls:
                if data_calls >= MAX_DATA_CALLS_PER_KEYWORD:
                    result = json.dumps({"error": "本关键词的数据调用额度已用完,请用已有结果作答"}, ensure_ascii=False)
                else:
                    data_calls += 1
                    try:
                        arguments = json.loads(tool_call.function.arguments)
                        result = execute_tool(tool_call.function.name, arguments)
                    except Exception as e:
                        result = json.dumps({"error": str(e), "tool": tool_call.function.name}, ensure_ascii=False)
                messages.append({
                    "role": "tool",
                    "tool_call_id": tool_call.id,
                    "content": result
                })

        # 步骤 3:提取结构化评估
        assessment_prompt = messages + [{
            "role": "user",
            "content": """基于你的分析,输出 JSON:
{
    "keyword": "关键词",
    "platforms_checked": ["douyin", "weibo"],
    "total_mentions": <你看过的结果条数>,
    "sentiment": {"positive": <百分比>, "neutral": <百分比>, "negative": <百分比>},
    "alert_needed": true/false,
    "alert_severity": "low|medium|high|critical",
    "alert_reason": "告警原因(不需要告警则留空)",
    "urgent_items": ["具体的问题内容"],
    "summary": "一段话总结"
}
只输出 JSON,不要 markdown。"""
        }]

        assessment_response = client.chat.completions.create(
            model="openai/gpt-4.1-mini",
            messages=assessment_prompt
        )

        try:
            assessment = json.loads(assessment_response.choices[0].message.content)
        except json.JSONDecodeError:
            print(f"? {keyword}:评估不是合法 JSON,跳过")
            continue

        # 步骤 4:LLM 标记需要告警,或报告的负面占比超过阈值,就告警
        try:
            negative_pct = float((assessment.get("sentiment") or {}).get("negative") or 0)
        except (TypeError, ValueError):
            negative_pct = 0.0
        over_threshold = negative_pct > ALERT_THRESHOLD_NEGATIVE

        if assessment.get("alert_needed") or over_threshold:
            reason = assessment.get("alert_reason") or (
                f"负面 {negative_pct:.0f}%(阈值 {ALERT_THRESHOLD_NEGATIVE}%)")
            alert = Alert(
                timestamp=datetime.now().isoformat(),
                severity=assessment.get("alert_severity") or "medium",
                keyword=keyword,
                platform=", ".join(assessment.get("platforms_checked") or ["douyin", "weibo"]),
                reason=reason,
                details=assessment.get("summary", "")
            )
            alerts.append(alert)
            print(f"🚨 告警 [{alert.severity.upper()}] — {alert.keyword}: {alert.reason}")
        else:
            print(f"✓ {keyword}:正常(看过 {assessment.get('total_mentions', 0)} 条结果,"
                  f"负面 {negative_pct:.0f}%,{data_calls} 次数据调用)")

    return alerts

# --- 告警投递 ---
def deliver_alerts(alerts: list[Alert]):
    """打印告警。要推到 Slack,把 {"text": ...} POST 到 incoming webhook URL。"""
    for alert in alerts:
        if alert.severity in ("high", "critical"):
            print(f"\n{'='*60}")
            print(f"🔴 {alert.severity.upper()} 告警 — {alert.timestamp}")
            print(f"   关键词:{alert.keyword}")
            print(f"   平台:{alert.platform}")
            print(f"   原因:{alert.reason}")
            print(f"   详情:{alert.details}")
            print(f"{'='*60}\n")
        else:
            # 低优先级:记入每日汇总
            print(f"📋 [{alert.severity}] {alert.keyword}: {alert.reason}")

# --- 主循环 ---
def main():
    """按计划运行监控 Agent。"""
    print("🔍 社媒监控 Agent 启动")
    print(f"   关键词:{MONITOR_KEYWORDS}")
    print(f"   间隔:{CHECK_INTERVAL_SECONDS} 秒")
    print(f"   告警阈值:负面 > {ALERT_THRESHOLD_NEGATIVE}%(LLM 报告)")
    print()

    while True:
        print(f"--- 周期开始:{datetime.now().isoformat()} ---")
        alerts = run_monitoring_cycle(MONITOR_KEYWORDS)

        if alerts:
            deliver_alerts(alerts)
        else:
            print("本周期无告警。")

        print(f"--- 下一周期 {CHECK_INTERVAL_SECONDS}s 后 ---\n")
        time.sleep(CHECK_INTERVAL_SECONDS)

if __name__ == "__main__":
    main()
模式工作原理
数据 API 走直接 HTTP,LLM 调用走 OpenAI SDK:
# LLM 推理 — OpenAI SDK(chat completions)
client.chat.completions.create(model="openai/gpt-4.1-mini", messages=...)

# 数据获取 — 每个端点一条路由,body 只放该端点的参数
requests.post("https://api.sandbase.ai/v1/api/douyin/search/general-search-v2",
    headers=HEADERS,
    json={"keyword": "...", "cursor": 0, "sort_type": "0"})
SandBase 的数据 API 不是 LLM,不接受 messages,也不返回 chat completions。TOOL_ENDPOINTS 把每个工具映射到一个端点,call_data_api 只发送该端点的参数。端点参考记录的完成态响应是 {id, status, model, outputs: [{data: ...}]},所以 helper 只读 outputs[0].data;调用没有完成时,抛出带 status 和 error 的错误。这里用的是端点参考里的 Model API POST 路由,不是目录页展示的 GET 路由。
两个搜索端点都没有结果条数参数,所以工具在本地截断。Agent 只读第一页。各端点分页方式不同:抖音综合搜索翻页时要把上一次响应里的 cursor、search_id 和 backtrace 一起传回;微博实时搜索用 page 页码;视频评论用 cursor。
另外两页参考把这些参数列得很清楚:微博实时搜索是 query(必填)和 page;视频评论是 aweme_id(必填)、count(默认 20)和 cursor(默认 0)。
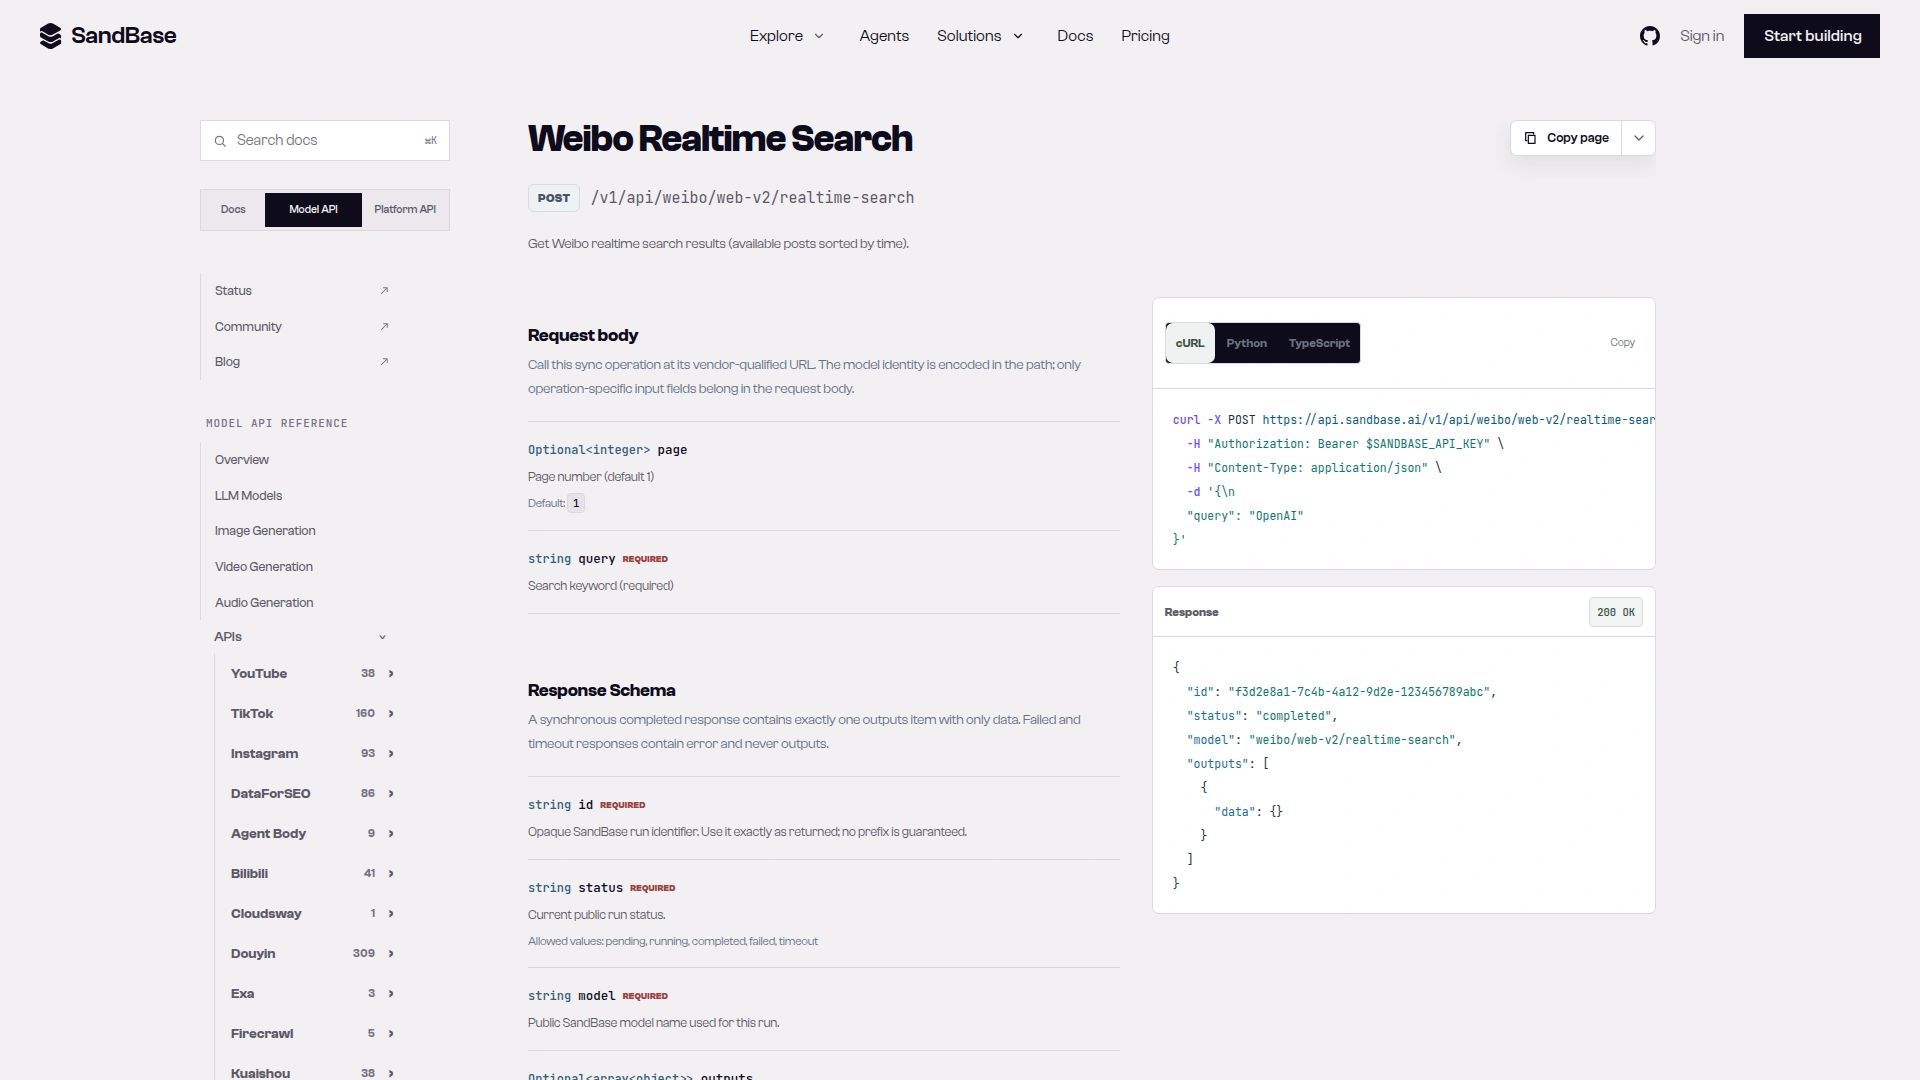
截图:weibo/web-v2/realtime-search 端点参考页,query 必填、page 默认 1,与 Agent 发送的 {"query": ..., "page": 1} 一致(2026-10-02 截取)。
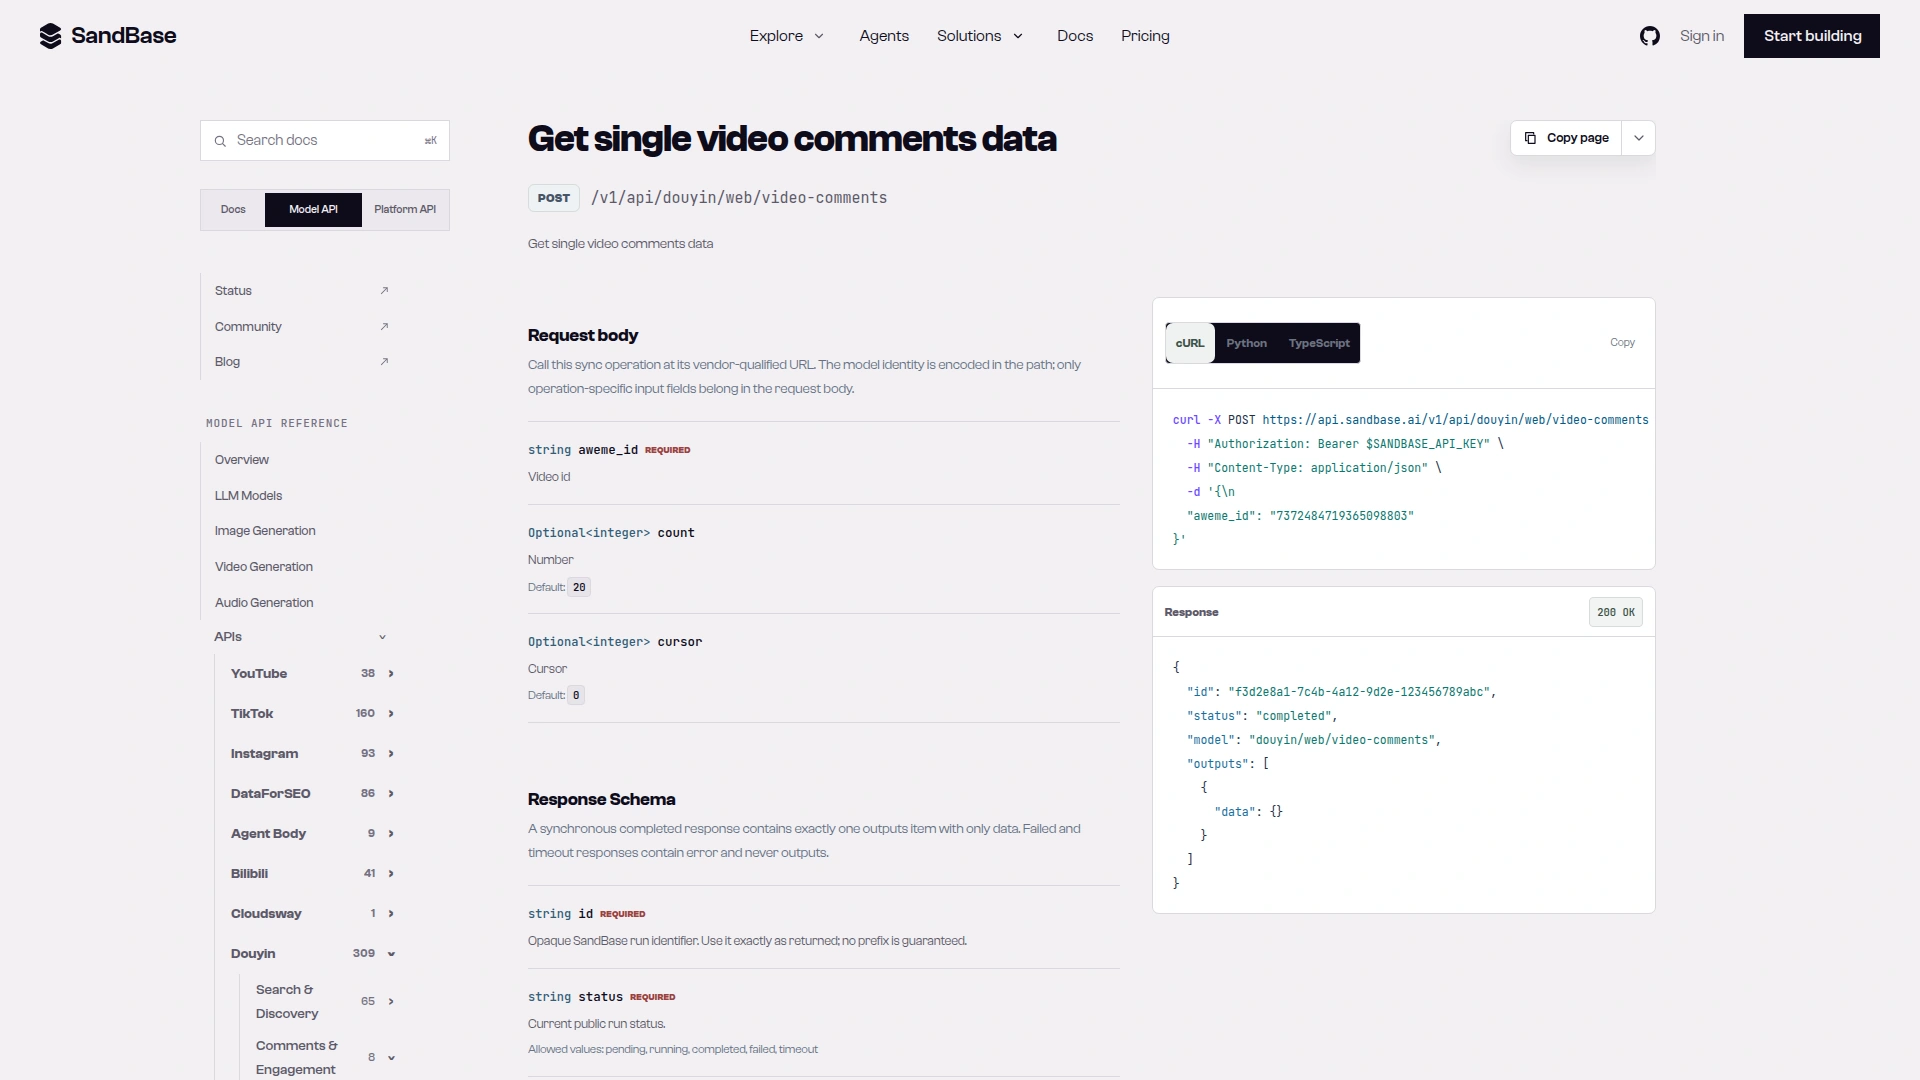
截图:douyin/web/video-comments 端点参考页,必填 aweme_id,另有 count(默认 20)和 cursor(默认 0),正是 get_douyin_video_comments 发送的三个字段(2026-10-02 截取)。
每次 call_data_api 都先等 RateLimiter(这里是每 60 秒 30 次,这是你自己定的节奏,不是 SandBase 配额),遇到网络错误、HTTP 429 和 5xx 按 1s/2s 退避重试。工具出错会以 {"error": ...} 交回给 LLM,一次调用失败不会中断整个周期。
实测:2026-10-01(UTC)
我用品牌关键词 瑞幸咖啡 跑了上面的完整代码,LLM 用桩替代,所有数据调用都是真实请求。工具读取的业务字段名来自这些调用,仅为实测观察、不是文档保证,所以每次读取都用 .get()。下面把创作者昵称和正文替换成 <redacted>,数字为原样返回。
POST https://api.sandbase.ai/v1/api/douyin/search/general-search-v2
{"keyword": "瑞幸咖啡", "cursor": 0, "sort_type": "0"}

{"id": "a7e4f79e-0231-4a05-821f-7db4d4799a76", "status": "completed", "model": "douyin/search/general-search-v2",
 "outputs": [{"data": {"business_data": [{"data": {"aweme_info": {
   "aweme_id": "<redacted>", "desc": "<redacted> #瑞幸 ...",
   "author": {"nickname": "<redacted>"},
   "statistics": {"digg_count": 943163, "comment_count": 12982, "share_count": 215170, ...}}}}, ...]}}]}
POST https://api.sandbase.ai/v1/api/weibo/web-v2/realtime-search
{"query": "瑞幸咖啡", "page": 1}
{"id": "0c118fd2-0dda-4b11-9cad-b2cfe1cccefe", "status": "completed", ...
"outputs": [{"data": {"parsed_data": {"results": [{
"weibo_id": "<redacted>", "user_name": "<redacted>", "content": "<redacted>",
"publish_time": "2分钟前", "interaction": {"comment_count": 0, "like_count": 0, "repost_count": 0}}, ...]}}}]}POST https://api.sandbase.ai/v1/api/douyin/web/video-comments
{"aweme_id": "<上面搜索返回的 video_id>", "cursor": 0, "count": 20}
{"id": "a0ed3f3d-0c2f-412b-9159-9bfc91569a5e", "status": "completed", ...
"outputs": [{"data": {"comments": [{"text": "<redacted>", "digg_count": 18, "reply_comment_total": 2}, ...]}}]}这一轮工具在截断前拿到 17 条视频、9 条微博和 19 条评论。两轮测试(EN 和 ZH 代码)共 28 次数据调用,有 2 次返回 HTTP 503,重试后都成功了。这些调用里抖音搜索的原始负载接近 1 MB,所以工具返回精简列表,而不是把整个响应塞进 LLM 上下文。
成本拆解
数据 API:截至 2026-10-01,这三个端点在 SandBase 目录里标的是 Free,所以数据侧按调用次数算。LLM:截至 2026-10-01,SandBase 上 openai/gpt-4.1-mini 的价格是输入 $0.40/百万 token、输出 $1.60/百万 token。
每个关键词的调用次数有代码上限:tool-use LLM 调用 1 到 MAX_ITERATIONS(4)次,评估调用 1 次,数据调用 0 到 MAX_DATA_CALLS_PER_KEYWORD(4)次。典型路径是:两个平台各搜一次、取一个视频的评论、作答,即 3 次 tool-use、1 次评估、3 次数据调用。
按示意性的 token 假设估算(tool-use 每次约 2K 输入 + 500 输出;评估每次约 1K 输入 + 200 输出):
tool-use 调用:2,000 × $0.40/M + 500 × $1.60/M = $0.0008 + $0.0008   = $0.0016
评估调用:     1,000 × $0.40/M + 200 × $1.60/M = $0.0004 + $0.00032  = $0.00072

每关键词(典型,3 次 tool-use + 1 次评估):3 × $0.0016 + $0.00072 = $0.00552
每关键词(上限,4 + 1):                  4 × $0.0016 + $0.00072 = $0.00712

每周期,3 个关键词:  典型 $0.01656   上限 $0.02136
每周期数据调用:      典型 9 次       上限 12 次
每 15 分钟运行一次(每天 96 个周期,按 30 天/月):
典型:  $0.01656 × 96 = $1.59/天,× 30 ≈ $47.69/月;每天 864 次数据调用
上限:  $0.02136 × 96 = $2.05/天,× 30 ≈ $61.52/月;每天 1,152 次数据调用
这是估算,不是实测。实际输入 token 会随着工具结果在 messages 里累积而增长,评估调用还会把整段对话重发一遍,所以先记录几天 response.usage,再用你的真实数字重算。
扩展 Agent
添加更多平台
# 添加小红书监控:在 TOOL_ENDPOINTS 里加
#   "search_xiaohongshu_notes": "xiaohongshu/app-v2/search-notes"
# 并在 execute_tool 里用 {"keyword": ..., "page": 1} 路由
{
    "type": "function",
    "function": {
        "name": "search_xiaohongshu_notes",
        "description": "搜索小红书匹配关键词的笔记。",
        "parameters": {
            "type": "object",
            "properties": {
                "keyword": {"type": "string"},
                "count": {"type": "integer", "default": 10}
            },
            "required": ["keyword"]
        }
    }
}
2026-10-01 用 {"keyword": "瑞幸咖啡", "page": 1} 调用 xiaohongshu/app-v2/search-notes,返回 20 条笔记,位于 data.items[](run 1a422dd3-d11a-446b-a0ea-0ba15c3a2a9c,仅为实测观察)。加工具时记得调高 MAX_DATA_CALLS_PER_KEYWORD。
添加趋势对比
上面的 Agent 每个周期都是无状态的。做飙升检测还缺两样东西:一个不受每页条数限制的声量信号(比如之前没见过的微博 weibo_id 数量),以及能跨重启保存的历史。下面是一个起点,没有接入主循环:
# 内存里的历史;实际使用请持久化(SQLite、JSON 文件)
class TrendTracker:
    def __init__(self):
        self.history = {}  # keyword -> [(timestamp, new_posts)]

    def record(self, keyword: str, new_posts: int):
        self.history.setdefault(keyword, []).append((time.time(), new_posts))

    def detect_spike(self, keyword: str, window_hours: int = 24) -> bool:
        """最新一次数量是否为窗口内均值的 3 倍。"""
        cutoff = time.time() - (window_hours * 3600)
        recent = [n for t, n in self.history.get(keyword, []) if t > cutoff]
        if len(recent) < 10:
            return False
        avg = sum(recent[:-1]) / len(recent[:-1])
        return avg > 0 and recent[-1] > avg * 3
添加自动回复草拟
def draft_response(alert: Alert) -> str:
    """用 LLM 草拟回复,交给人审核。"""
    response = client.chat.completions.create(
        model="openai/gpt-4.1-mini",
        messages=[
            {"role": "system", "content": "你是品牌公关专家。"
             "为以下社媒问题草拟简短、共情的回复。"
             "保持专业,承认关切,提供下一步。"},
            {"role": "user", "content": f"问题:{alert.reason}\n详情:{alert.details}\n"
             "草拟一条适合在社媒发布的回复。"}
        ]
    )
    return response.choices[0].message.content
数据 API 是只读的,草稿要由你的团队通过平台自己的工具发布。
要点总结
- 两个客户端,一把 API key。
requests调 SandBase 数据 API(POST /v1/api/<端点>),OpenAI SDK 做 LLM 推理,两者用同一个 key 认证。 - Tool-calling 是集成模式。 每个工具对应一个端点,让 LLM 决定何时调用,并给 LLM 循环和数据调用都设上限。
- 只读
outputs[0].data,失败要报错。 调用没完成就抛错,不要静默返回{}。 - 美元成本来自 LLM。 截至 2026-10-01 这些数据端点标为 Free;记录 token 用量,先优化 LLM 层。
- Sync API 让循环简洁。 因为社媒数据 API 是 sync-only,没有回调和任务管理。响应 schema 里也列了
pending和running状态;这个 Agent 不轮询,只要不是completed就按错误处理。
获取 SandBase API key · 浏览抖音目录 · 浏览微博目录