微博 + 小红书数据接口上线 SandBase
截至 2026-10-01,SandBase 目录展示 52 个微博、34 个小红书公开数据接口,覆盖热搜、实时搜索、蒲公英标签的达人研究数据和笔记详情。
先说结论 — 截至 2026-10-01,SandBase 目录展示微博 52 个端点(热搜、实时搜索、公开时间线、App 级用户数据)和小红书 34 个端点(蒲公英标签的达人研究数据、笔记详情、商品推荐),每个组织每天(UTC)有 100 次免费数据 API 调用,由符合条件的 API 共享;超出后本文调用的微博端点和小红书
app-v2/web-v3端点按次计费。小红书蒲公英(xiaohongshu/pgy/*)端点不在每日免费调用范围内,从第一次调用起就按目录价计费。当前单价以各端点目录卡片(或sandbase inspect)为准。目录页展示的是GET /apis/v1/...形式;本文用的是各端点参考文档里记录的 Model API 路由POST /v1/api/...。本文的微博和小红书数据调用都是POST https://api.sandbase.ai/v1/api/<vendor>/<path>,用一个 SandBase API key;LLM 那一步用同一个 key 调POST /v1/chat/completions。
两个平台,两种完全不同的数据性质。微博是中国的实时公共广场:突发新闻、热门观点、品牌危机最先在这里爆发。小红书是中国的消费决策引擎:产品评测、生活方式内容、KOL 推荐直接驱动购买行为。SandBase 的微博 + 小红书数据接口让 agent 能读取两边的公开数据。
一个同时监控两者的 agent,能捕捉完整光谱:人们在说什么(微博)和人们在买什么(小红书)。
范围。 这些是公开、只读的数据端点,本文的每次调用都需要 SandBase API key。SandBase 不是微博或小红书的官方合作方,这些端点不覆盖私密账号数据、私信、仅账号所有者可见的分析数据、发布或账号操作。
微博:52 个端点,2 个频道
数字取自 2026-10-01 微博目录页的展示数。
52 这个数可以直接在目录页核对:标题右侧写着“52 SHOWN”,选中的端点卡片显示 Available。
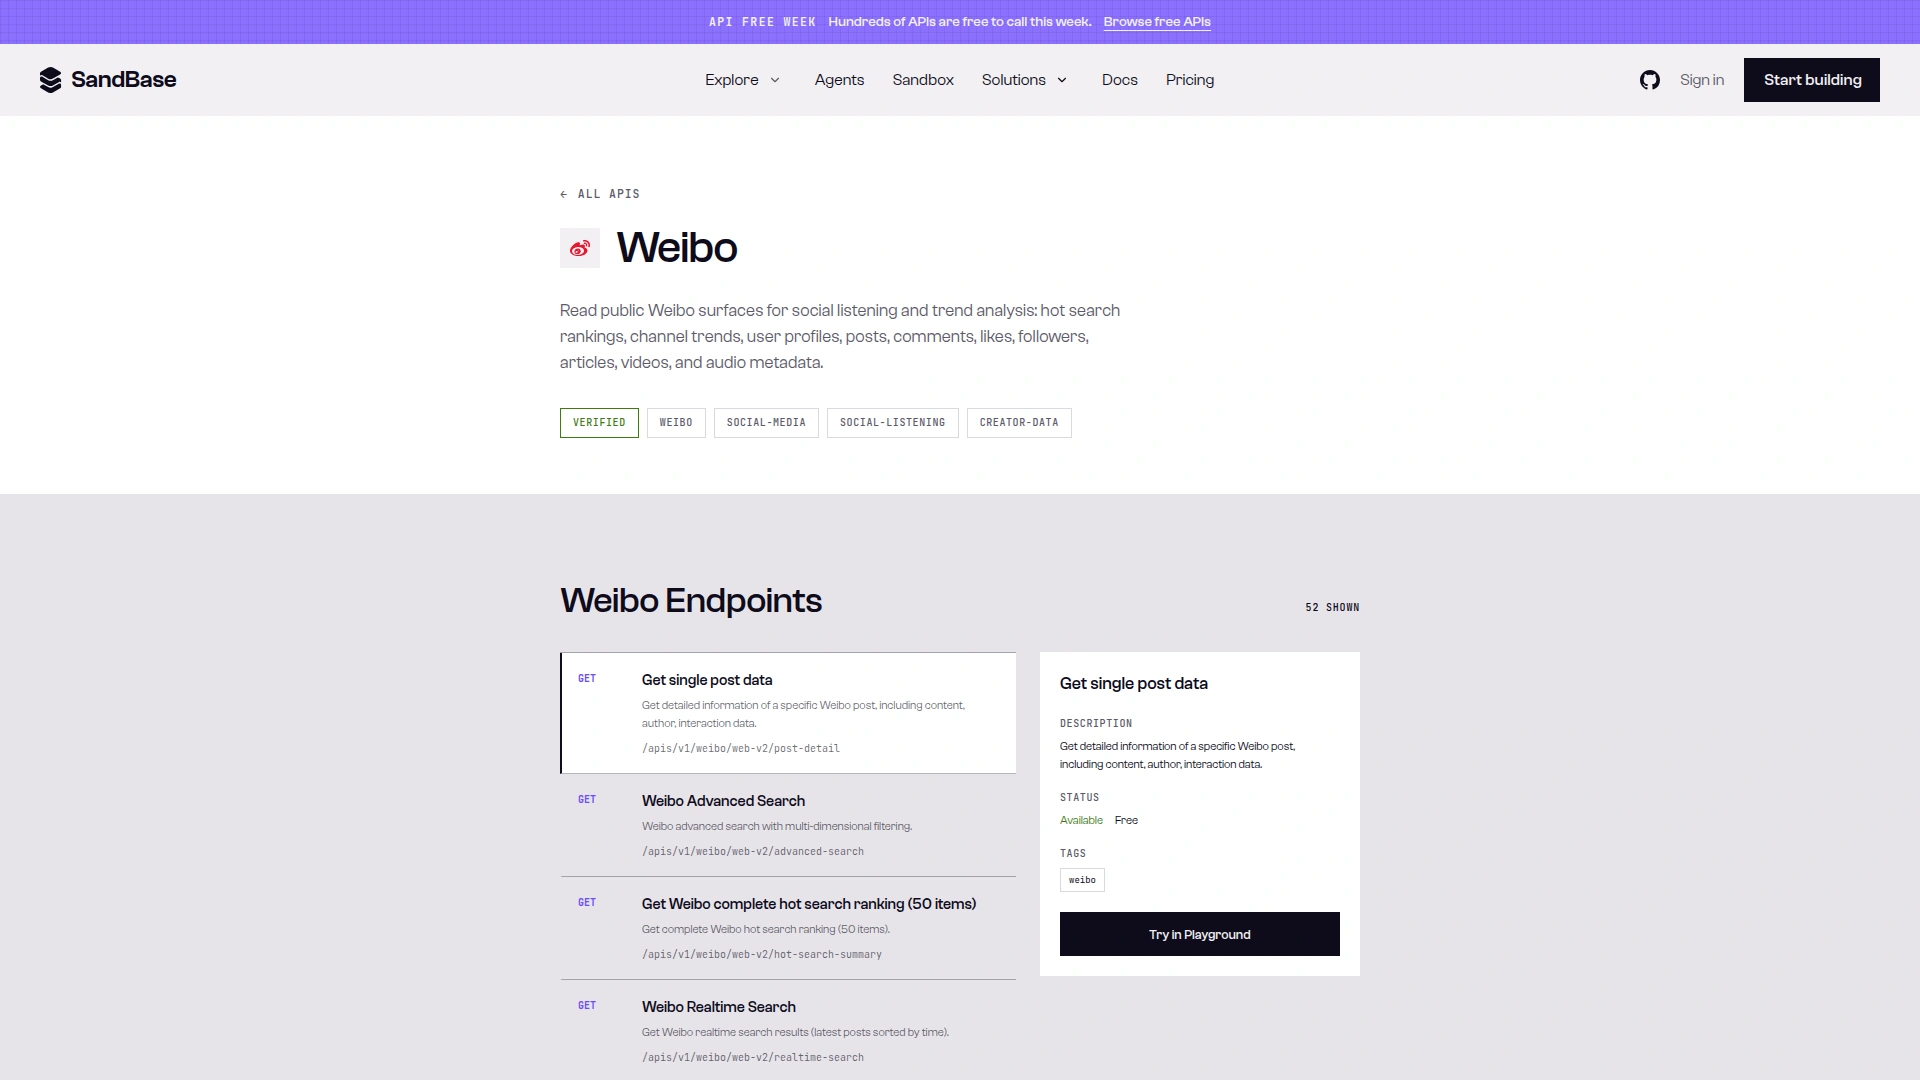
截图:SandBase 微博目录页列出 52 个端点,选中的 web-v2/post-detail 卡片显示 Available 和 Free(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
| 频道 | 端点数 | 覆盖内容 |
|---|---|---|
weibo/web-v2/* | 33 | 热搜、话题趋势、公开帖子、用户时间线 |
weibo/app/* | 19 | App 级用户数据、关系图谱、帖子详情 |
旧的 weibo/web/* 端点截至当天不在目录里,请改用 weibo/web-v2/* 或 weibo/app/*。本文用到的微博端点在每天 100 次免费调用之后按目录单价按次计费。
微博数据能让 agent 做什么
实时热点检测:weibo/web-v2/hot-search 不需要任何输入,返回当前热搜列表。在下面的实测里,每一条有 word 和热度数值 num。Agent 每 15 分钟 poll 一次,就能在一个周期内捕捉品牌提及、行业趋势或危机信号。
舆情抽样:热搜命中后,用 weibo/web-v2/realtime-search(必填 query,可选 page,默认 1)按话题关键词拉实时帖子,喂给 LLM 做情感分类。
竞品定位:追踪竞品在微博上的讨论。weibo/app/user-timeline 给你竞品官方微博的发帖历史;weibo/web-v2/post-comments 给你公众反应。
示例:品牌危机检测流程
热搜参考页记录了这个流程调用的路由 POST /v1/api/weibo/web-v2/hot-search,以及 id、status、model、outputs[0].data 这套响应结构。
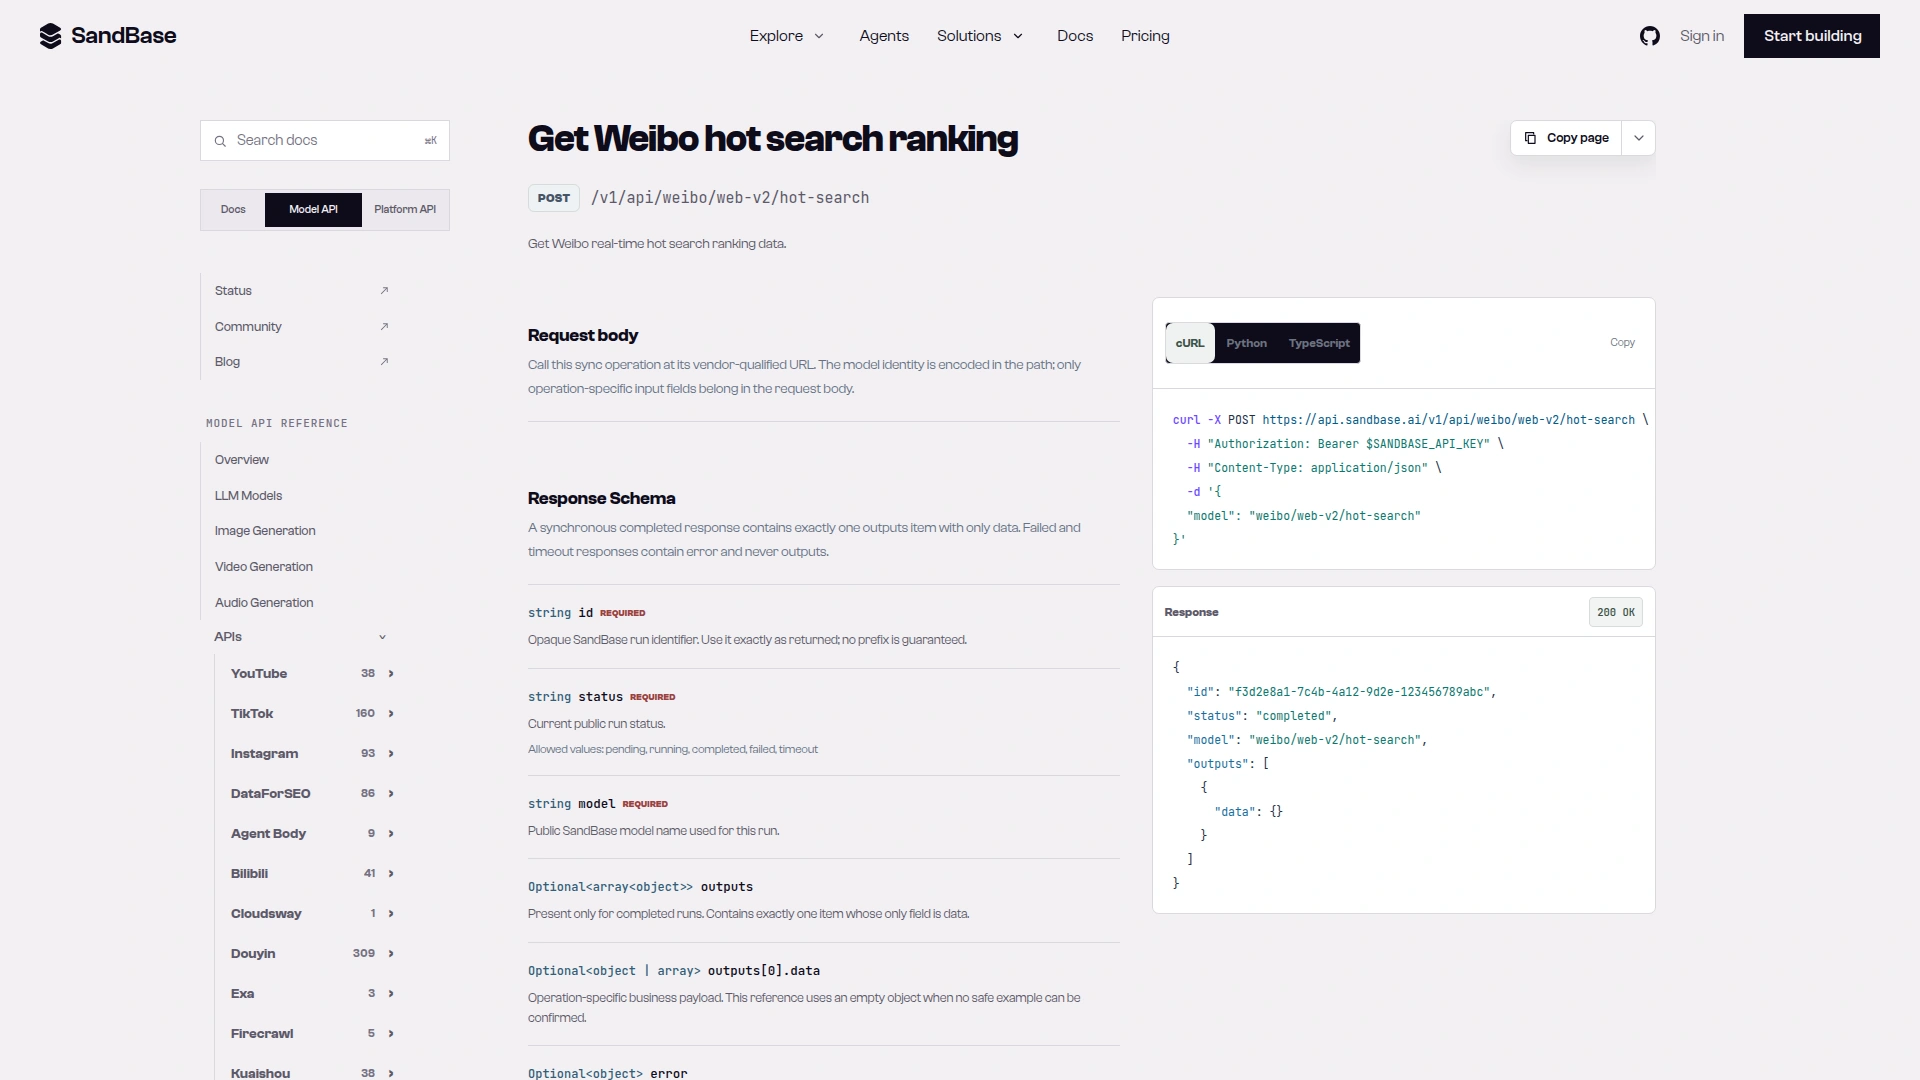
截图:weibo/web-v2/hot-search 参考页显示 POST /v1/api/weibo/web-v2/hot-search 路由,以及代码读取的 outputs[0].data 响应结构(2026-10-02 截取)。
下面用到的端点参考:weibo/web-v2/hot-search、weibo/web-v2/realtime-search。LLM 那一步用的是 SandBase 的 OpenAI 兼容 chat 端点。
import os
import requests
from openai import OpenAI

SANDBASE_API_KEY = os.environ["SANDBASE_API_KEY"]
HEADERS = {
    "Authorization": f"Bearer {SANDBASE_API_KEY}",
    "Content-Type": "application/json",
}

# OpenAI 客户端仅用于 LLM 调用
client = OpenAI(base_url="https://api.sandbase.ai/v1", api_key=SANDBASE_API_KEY)


def call_sandbase(model: str, params: dict):
    """POST /v1/api/<model>,body 只放该端点的参数;返回 outputs[0].data。"""
    body = requests.post(
        f"https://api.sandbase.ai/v1/api/{model}", headers=HEADERS, json=params, timeout=90
    ).json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


# 第 1 步:检查热搜是否有品牌提及
hot_search = call_sandbase("weibo/web-v2/hot-search", {})
topics = [t.get("word") for t in hot_search.get("realtime", []) or []]
flagged = [w for w in topics if w and "华为" in w]  # 换成你的品牌关键词

# 第 2 步:命中话题按关键词拉实时帖子
posts = []
for word in flagged[:3]:
    result = call_sandbase("weibo/web-v2/realtime-search", {"query": word})
    for p in (result.get("parsed_data") or {}).get("results", []) or []:
        posts.append(p.get("content", ""))

# 第 3 步:LLM 情感分析(OpenAI SDK,只用于 LLM 调用)
if posts:
    analysis = client.chat.completions.create(
        model="openai/gpt-4.1-mini",
        messages=[{
            "role": "user",
            "content": "分析这些微博帖子对我们品牌的情感倾向:\n" + "\n".join(posts[:30])
        }]
    )
LLM 这一步走 SandBase 兼容 OpenAI 的 Chat Completions 接口(指南),模型用 openai/gpt-4.1-mini;2026-10-02(UTC)按这个请求结构实测返回 HTTP 200。Claude 模型按 LLM 参考走 /v1/messages 协议,不适用这段代码。
实测于 2026-10-01(UTC)
公开资源:微博公开热搜榜,以及实时搜索用的品牌关键词 华为。请求:
curl -s -X POST https://api.sandbase.ai/v1/api/weibo/web-v2/hot-search \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{}'

curl -s -X POST https://api.sandbase.ai/v1/api/weibo/web-v2/realtime-search \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"query": "华为"}'
截短后的真实响应。热搜(run id ae42ad80-b743-4e61-9bfc-ea373edeff6f;realtime 共 51 条,展示 4 条,其他键已删):
{
  "status": "completed",
  "model": "weibo/web-v2/hot-search",
  "outputs": [{"data": {"realtime": [
    {"word": "鸿蒙智行问界业务升级", "num": 1106725, "rank": 0},
    {"word": "国庆假期流动的中国具象化了", "num": 618715, "rank": 2},
    {"word": "Mate90系列今日发布即开售", "num": 526587, "rank": 2},
    {"word": "央视国庆晚会", "num": 517475, "rank": 3}
  ]}}]
}
华为 实时搜索(run id 295b5c3f-d101-44d4-99b4-5bb914c66bff;共 10 条,展示 1 条;发帖人是个人,帖子正文和用户字段已脱敏):
{
  "status": "completed",
  "model": "weibo/web-v2/realtime-search",
  "outputs": [{"data": {"parsed_data": {
    "parse_success": true,
    "result_count": 10,
    "results": [
      {"content": "<帖子正文已脱敏>", "interaction": {"comment_count": 0, "like_count": 0, "repost_count": 0}}
    ]
  }}}]
}信封(status、model、outputs)在端点参考里有文档。代码读取的负载字段(realtime[].word、parsed_data.results[].content)只是实测观察,不是文档保证。
每个周期的调用:1 次热搜 + 最多 3 次关键词搜索 + 最多 1 次 LLM(只在有命中时)。每 15 分钟跑一次:每天最多 384 次数据调用、最多 96 次 LLM 调用。
小红书:34 个端点,3 个频道
数字取自 2026-10-01 小红书目录页的展示数。
小红书目录页同样能核对 34 这个数,后文用到的蒲公英达人端点也在列表里。
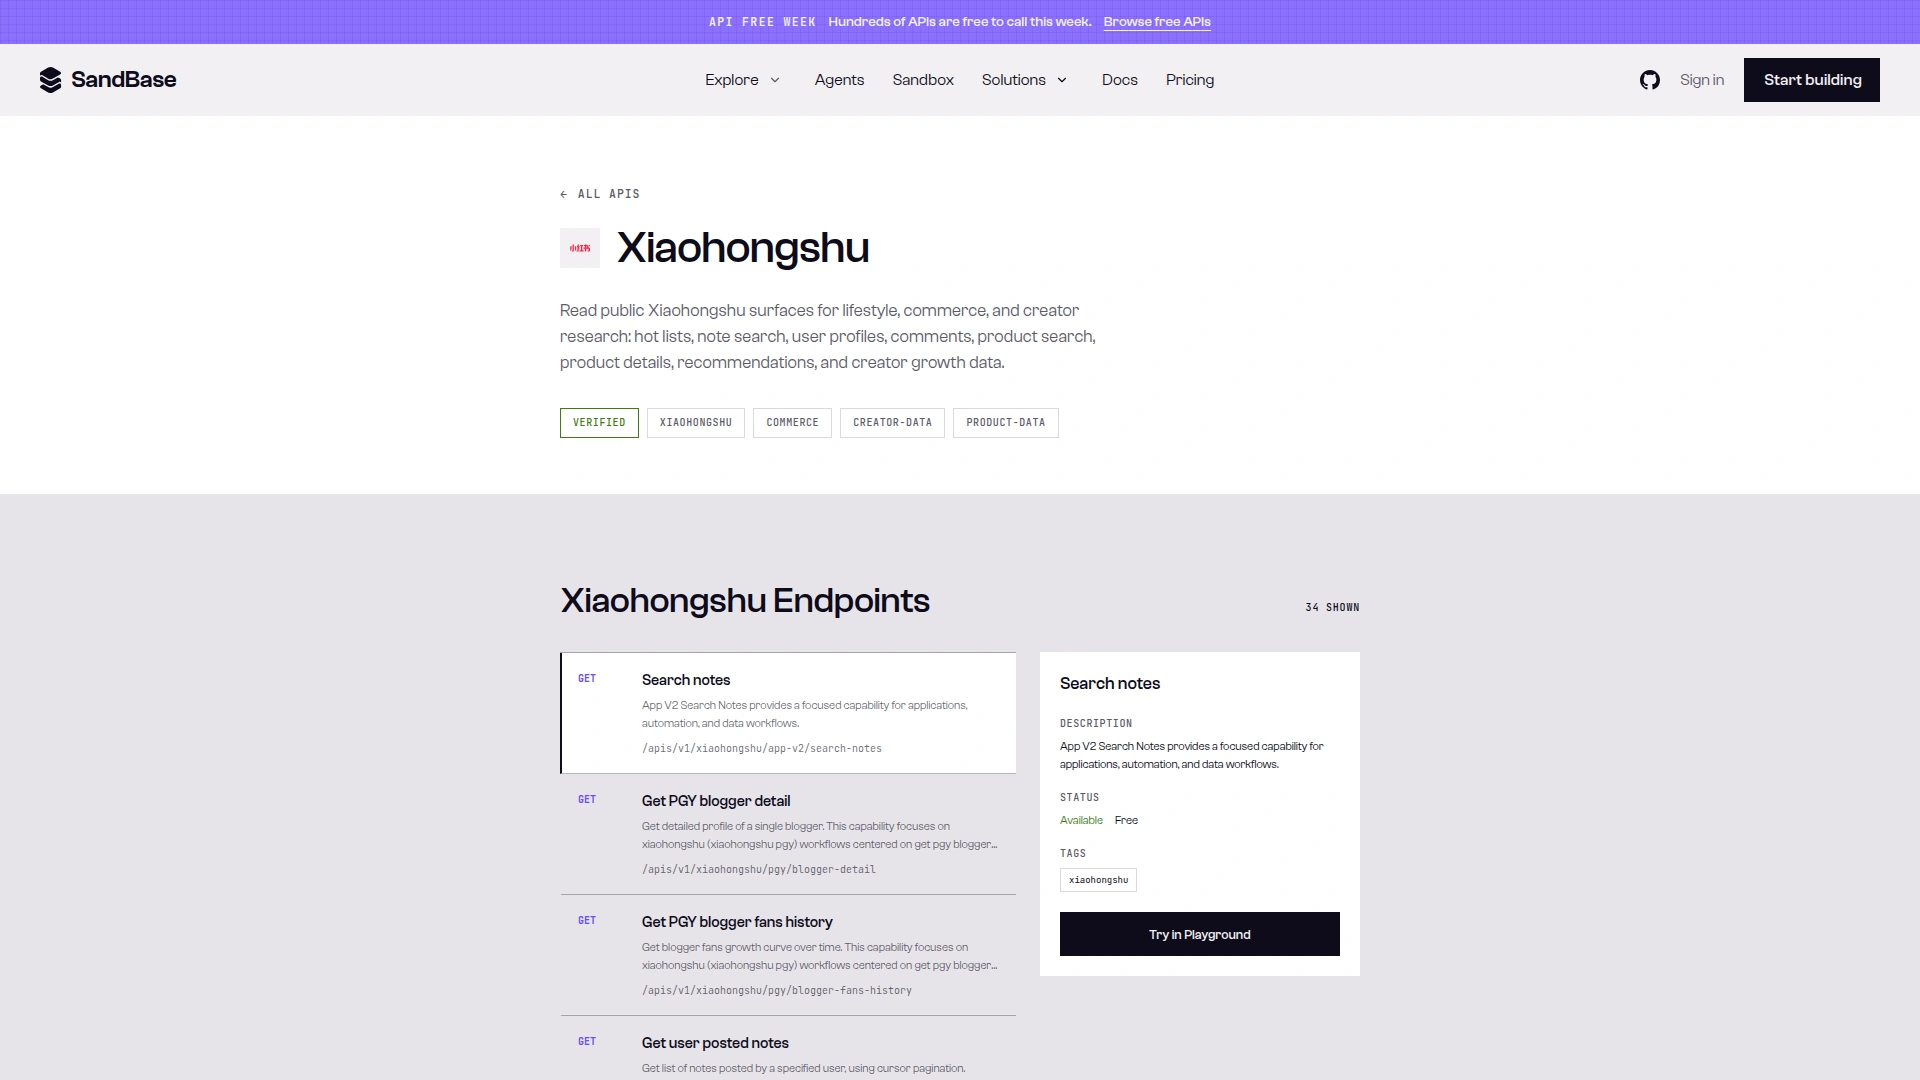
截图:SandBase 小红书目录页列出 34 个端点,其中有 pgy/blogger-detail 和 pgy/blogger-fans-history,选中卡片显示 Available 和 Free(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
| 频道 | 端点数 | 覆盖内容 |
|---|---|---|
xiaohongshu/app-v2/* | 19 | 笔记详情、用户资料、搜索、商品推荐、收藏笔记 |
xiaohongshu/pgy/* | 10 | 蒲公英(PGY)标签的达人研究数据:博主列表、详情、粉丝历史 |
xiaohongshu/web-v3/* | 5 | 首页推荐、笔记详情、搜索联想 |
本文用到的小红书 app-v2 和 web-v3 端点在每天 100 次免费调用之后按目录单价按次计费。蒲公英标签的 xiaohongshu/pgy/* 端点不在每日免费调用范围内,从第一次调用起就按目录价计费。
小红书数据能让 agent 做什么
KOL 筛选:xiaohongshu/pgy/blogger-list 必填 brand_user_id(在该品牌下匹配博主),用 page_num(从 1 开始)和 page_size(1–100)分页。参考页还列出了 fans_number_lower / fans_number_upper,但 2026-10-01 的实测里这两个参数被接受却不生效,模型页上的嵌套筛选 fans.count 和 blogger.content_tag 则会生效;测试记录见blogger-list 哪种筛选字段真正生效。xiaohongshu/pgy/blogger-detail 和 xiaohongshu/pgy/blogger-fans-history 再用每个博主的 user_id 查。筛 200 个候选人:page_size 100 时 2 次列表调用,加 400 次详情/粉丝历史调用,约 402 次。
内容趋势:目录里有 xiaohongshu/web-v3/homefeed(首页推荐笔记,按其参考用 cursor_score 分页)可作趋势信号,本文没有测试。配合 xiaohongshu/app-v2/search-images 找你产品品类的视觉内容模式。
商品情报:xiaohongshu/app-v2/product-recommendations 显示哪些商品和你的产品一起被推荐。xiaohongshu/app-v2/user-faved-notes 显示公开主页收藏了什么内容(高意向信号)。
示例:单个 KOL 评估
参考:blogger-detail、blogger-fans-history。下面的 user_id 是完美日记(Perfect Diary)的公开品牌账号,换成 blogger-list 返回的 userId 即可。
# 博主概览
curl -s -X POST https://api.sandbase.ai/v1/api/xiaohongshu/pgy/blogger-detail \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"user_id": "59ae4dfc5e87e72475fb3bf3"}'

# 粉丝趋势(date_type 2 ≈ 30 天)
curl -s -X POST https://api.sandbase.ai/v1/api/xiaohongshu/pgy/blogger-fans-history \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"user_id": "59ae4dfc5e87e72475fb3bf3", "date_type": 2}'
实测于 2026-10-01(UTC),请求与上面完全一致。截短后的真实响应(删掉了大部分键)。
blogger-detail(run id e34c2ff1-0001-45fe-acc4-e78b5a29094c):
{"code": 0, "data": {"userId": "59ae4dfc5e87e72475fb3bf3", "name": "Perfect Diary完美日记",
"fansCount": 1835170, "likeCollectCountInfo": 7664542, "location": "广东"}}blogger-fans-history(run id 4c229f0e-f79f-49bc-bc7d-0385ec662fbe;list 共 60 个点,展示 2 个):
{"code": 0, "data": {"fansNumInc": -9214, "list": [
  {"dateKey": "2026-08-02", "num": 1842991},
  {"dateKey": "2026-09-30", "num": 1833777}
]}}
两者都在 outputs[0].data 里;字段名只是实测观察。两个蒲公英端点的参数都是 user_id(不是 blogger_id)。date_type 可选,参考允许 1–12,常用值是 1 ≈ 7 天、2 ≈ 30 天、3 ≈ 90 天。之前的测试里部分尝试返回过上游 400,建议加重试。
每个 KOL 评估的调用:blogger-detail + blogger-fans-history = 2 次。筛选 100 个候选人:1 次 page_size 100 的 blogger-list + 200 = 201 次。
跨平台场景
场景:新品上市监控
消费品牌发布新产品,agent 同时监控两个平台。调用量是示意估算,不是测量值:
| 平台 | 监控什么 | 端点 | 每天调用量(示意) |
|---|---|---|---|
| 微博 | 品牌热搜提及、帖子情感 | hot-search + realtime-search | ~100 次 |
| 小红书 | 产品相关笔记、竞品推荐 | xiaohongshu/app-v2/search-notes + xiaohongshu/app-v2/product-recommendations | ~50 次 |
| 合计 | 每天 ~150 次(每月 ~4,500 次) |
场景:KOL 投放效果追踪
KOL 活动上线后追踪表现:
| 指标 | 微博端点 | 小红书端点 |
|---|---|---|
| 帖子互动 | weibo/web-v2/post-comments | xiaohongshu/app-v2/image-note-detail / video-note-detail |
| 受众反应 | weibo/app/status-reposts | xiaohongshu/app-v2/note-comments |
| 创作者涨粉 | weibo/app/user-info | xiaohongshu/pgy/blogger-fans-history |
SandBase vs 平台官方 API
两个平台都没有面向任意数据的通用免鉴权公开数据 API,官方开发者平台面向的是经过授权、关联账号的场景。粗略对比:
| 需求 | SandBase 公开数据端点 | 平台官方 API / OAuth |
|---|---|---|
| 公开读取数据(热搜、公开帖子、公开笔记) | 支持 | 取决于具体项目和审批 |
| 发布、评论、私信、账号操作 | 不支持 | 可能支持,需账号授权;因平台而异* |
| 私密或仅所有者可见的分析数据 | 不支持 | 可能支持,限你自己已授权的账号;因平台而异* |
| 鉴权 | 一个 SandBase API key | 平台应用凭证;涉及账号数据时需用户授权(微博为 OAuth) |
| 适合 | 研究、监控、达人发现 | 管理你自己的账号 |
* 官方开放平台实际提供哪些能力,微博和小红书并不相同,还取决于获批的产品、授予的权限范围和账号类型。围绕某项具体能力做规划前,请先查看对应平台的开发者文档。
SandBase 加了什么
- 一个契约:本文的每次微博和小红书 Model API 调用方式都一样,
POST /v1/api/<model>,body 只放该端点的参数,结果从outputs[0].data读 - 一个 key:同一个 SandBase API key 覆盖两个平台和 LLM 那一步
- 跨平台组合:一个 workflow 里调微博热搜 → 小红书搜索 → LLM 分析,不需要换 API 或鉴权方式
局限
- 微博:端点全部只读,不能发帖、不能私信。写操作需要微博官方 OAuth API。
- 小红书:端点覆盖公开分析和内容发现,不包含账号管理。蒲公英标签的端点通过 SandBase 公开数据目录返回达人研究数据,不是任何品牌自己蒲公英账号里的视图。
- 两者:通过第三方基础设施访问公开数据,非官方平台授权。数据新鲜度因端点而异:热搜近实时,历史分析可能滞后。
FAQ
微博数据定价和抖音比怎么样?
每个组织每天的 100 次免费数据 API 调用用完后,本文用到的微博端点和非蒲公英的小红书端点按次计费。小红书蒲公英端点不在每日免费调用范围内,从第一次调用起就按目录价计费(sandbase_inspect 会显示端点的 free_quota,sandbase_account 会显示当天剩余的免费次数)。动手前请在端点的目录页或用 sandbase inspect 确认当前单价。
小红书蒲公英标签的数据能看到什么?
在上面的实测里:博主粉丝数(fansCount)、获赞与收藏合计(likeCollectCountInfo)、地区,以及按天的粉丝序列(list[].dateKey / num)和净变化(fansNumInc)。这些是实测观察到的字段名,不是文档保证。
能追踪一条小红书笔记的表现变化吗?
能。用 note_id(或 share_text)定期调 xiaohongshu/app-v2/image-note-detail(视频笔记用 video-note-detail)。2026-10-01 我用完美日记的一条笔记调用,{"note_id": "6abcdadd0000000002012523"}(run id ac60ce27-9c88-4c42-a5e1-ee30aae1300e),计数在 data[0].note_list[0] 下(实测观察):
{"id": "6abcdadd0000000002012523", "liked_count": 19, "comments_count": 2, "collected_count": 2, "shared_count": 1}每天追踪 50 条笔记就是每天 50 次调用。
微博和抖音的数据有重叠吗?
基本没有。它们覆盖不同平台、不同用户行为。微博是文字+观点优先(热门话题、评论、转发)。抖音是视频优先(创作者、互动指标、电商)。大部分监控 agent 两个都用。
下一步
- 获取 SandBase API key(鉴权文档)
- 浏览微博 API · 浏览小红书 API
- 打开本文用到的参考:
weibo/web-v2/hot-search、weibo/web-v2/realtime-search、xiaohongshu/pgy/blogger-detail
完整的社媒数据方案选型看 社媒数据 API 选型指南。抖音专项覆盖看 抖音公开数据 API。