社媒数据 API vs 爬虫:Agent 怎么选
从架构视角对比结构化社媒数据 API 与爬虫:可靠性、合规风险、成本、延迟、数据覆盖五个维度,附一次 2026-10-01 实测的抖音 API 调用示例。
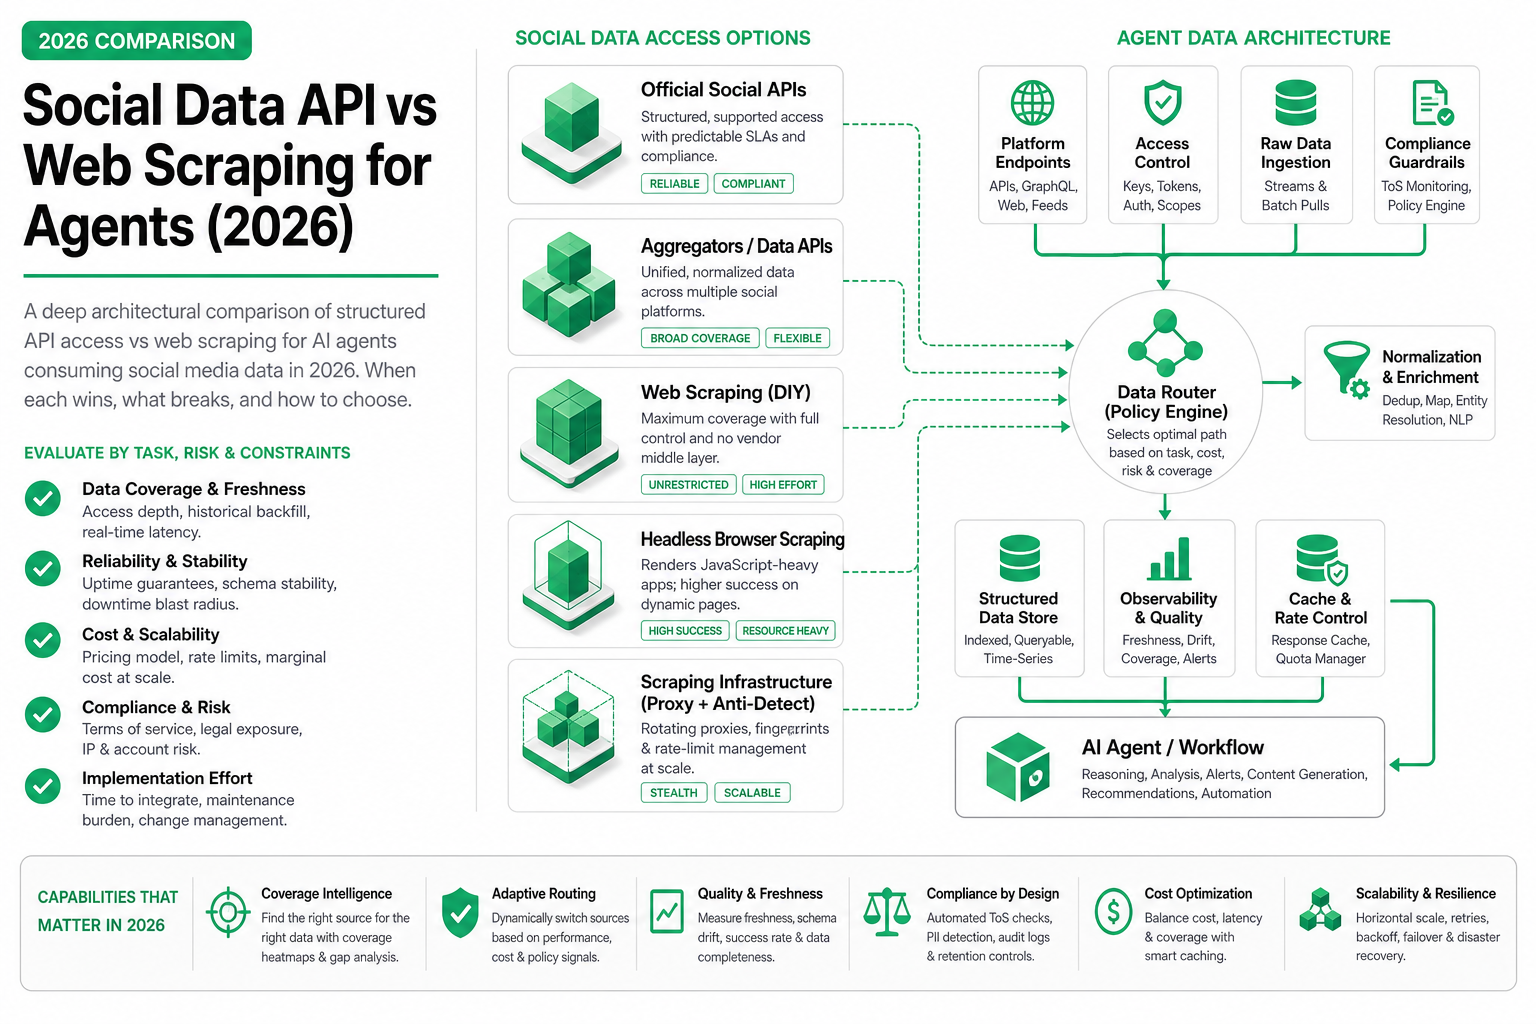
先说结论 — Agent 获取社媒数据有两条架构路线:结构化 API(可预测、快速、有速率治理)和网页爬虫(灵活、脆弱,法律问题由你自己承担)。它决定了你的 Agent 可靠性上限、成本下限和法律风险。本文从五个维度对比两条路线,附一次实测 API 调用,示例数字都做了明确标注。
你的 Agent 需要社媒数据。问题不是”要不要获取”,而是”怎么获取”。社媒数据 API vs 爬虫是核心选择,这两条路线的可靠性和成本曲线差异大到:选错路线可以让一个不错的 Agent 在生产环境里不可用。
这不是产品对比,而是架构决策。类似于选择托管数据库还是平面文件:两者都能存数据,但运维特性的分化会影响下游的一切。
两条路线的精确定义
路线 A:结构化数据 API。 第三方服务通过文档化的 REST 端点提供平台数据。你发请求、带参数、收 JSON。服务方处理上游访问、限流和 schema 维护。(平台自己的官方 API 是第三种选择,适用于授权给你的账号,见文末决策表。)
路线 B:网页爬虫。 你的 Agent(或爬虫服务)用无头浏览器渲染平台页面,从 DOM 提取数据或截获网络请求,再解析成可用格式。反爬对抗、会话管理和 schema 变更全部由你承担。
两条路线的终点都是:Agent 决策循环拿到 JSON。区别在于从”需要数据”到”拿到数据”之间的所有环节。
维度一:可靠性与可用性
这是对 Agent 架构影响最大的维度。
| 指标 | 结构化 API | 爬虫 |
|---|---|---|
| 可用性 | 以服务商公布的为准,向其索要书面 SLA | 取决于你自己的维护 |
| 响应一致性 | 信封有文档,字段实际稳定 | 页面结构一改就坏 |
| 失败模式 | HTTP 错误码,可重试 | 常常是静默的:数据错了或缺了 |
| 恢复时间 | 服务商修上游 | 你自己修选择器 |
| 失败对 Agent 的影响 | 可优雅降级 | 级联解析错误 |
对 Agent 来说关键区别是:API 的失败是显式的。 你拿到 429 或 503,重试逻辑处理,Agent 等一下继续。爬虫的失败常常是静默的:页面结构变了,解析器返回错误数据,Agent 在不知情的情况下基于错误输入做决策。
举个假设的例子:Agent 每天做 1,000 次决策,如果爬虫有 5% 的时候静默返回错误数据,每天大约 50 次决策基于错误输入,而且没有任何信号告诉它是哪 50 次。同样的失败率放在 API 上,就是 Agent 能看到并重试的 50 次错误响应。
示例场景:抖音竞品监控
Agent 监控 50 个竞品账号,每天需要新的互动数据。用结构化 API 是 50 次调用,每次返回同样的信封;2026-10-01 顺序调用 6 次 douyin/app-v3/user-profile,每次约 1.9–3.2 秒,而且可以并行。用爬虫是 50 个浏览器会话,每个都要渲染页面、可能遇到登录墙、解析 DOM,平台 UI 一改可能 50 个同时失效。
维度二:法律与合规风险
两条路线都不是自动合法的。区别在于你依赖谁、能审查什么。
结构化 API:
- 你同意的是 API 服务商的条款;请认真阅读,包括关于数据来源和允许用途的部分
- 使用某个 API 本身并不能说明服务商拿到了平台授权。以 SandBase 为例,它以公开、只读数据为主,不是所覆盖平台的官方合作方
- 你存储或处理的个人信息(GDPR、个保法等)相关义务仍然在你自己身上
- 你能从一个供应商拿到用量记录和发票,便于内部审查
爬虫:
- 法律地位因司法辖区、平台条款和采集内容而异;请针对你的具体用途咨询专业意见
- 和平台没有合同关系,与服务条款冲突很常见
- 个人数据处理义务完全由你承担
- 除了自己的日志没有审计线索
在企业环境里,法务审查常常直接决定选择。两条路线法务都会审:用 API 时审服务商的条款和数据实践;用爬虫时审平台条款和你自己的采集方式。
中国特有的考量
如果你的 Agent 处理来自中国平台的个人信息,《个人信息保护法》适用于这类处理,平台条款通常也限制自动化采集。只采集你需要的数据,避开私密账号数据,无论走哪条路线,都请和法律顾问一起评估你的义务。
维度三:成本结构
成本对比比”API 要花钱,爬虫免费”复杂得多。本节所有金额都是示意假设,不是实测成本。
结构化 API 成本模型
每个数据点成本 = API 调用价格
示例:douyin/app-v3/user-profile 按次计费
     (单价以 SandBase 模型卡片为准,
     每个组织每天前 100 次数据调用免费)
每天 1,000 个画像 = 每天 1,000 次调用 ≈ 每月 30,000 次
每天 10,000 个画像 = 每天 10,000 次调用 ≈ 每月 300,000 次
可预测、线性、不需要自建基础设施。
这个端点的按次单价以它的模型卡片为准。下面的截图摄于 2026-10-02,当时页面还显示促销期的 Free。
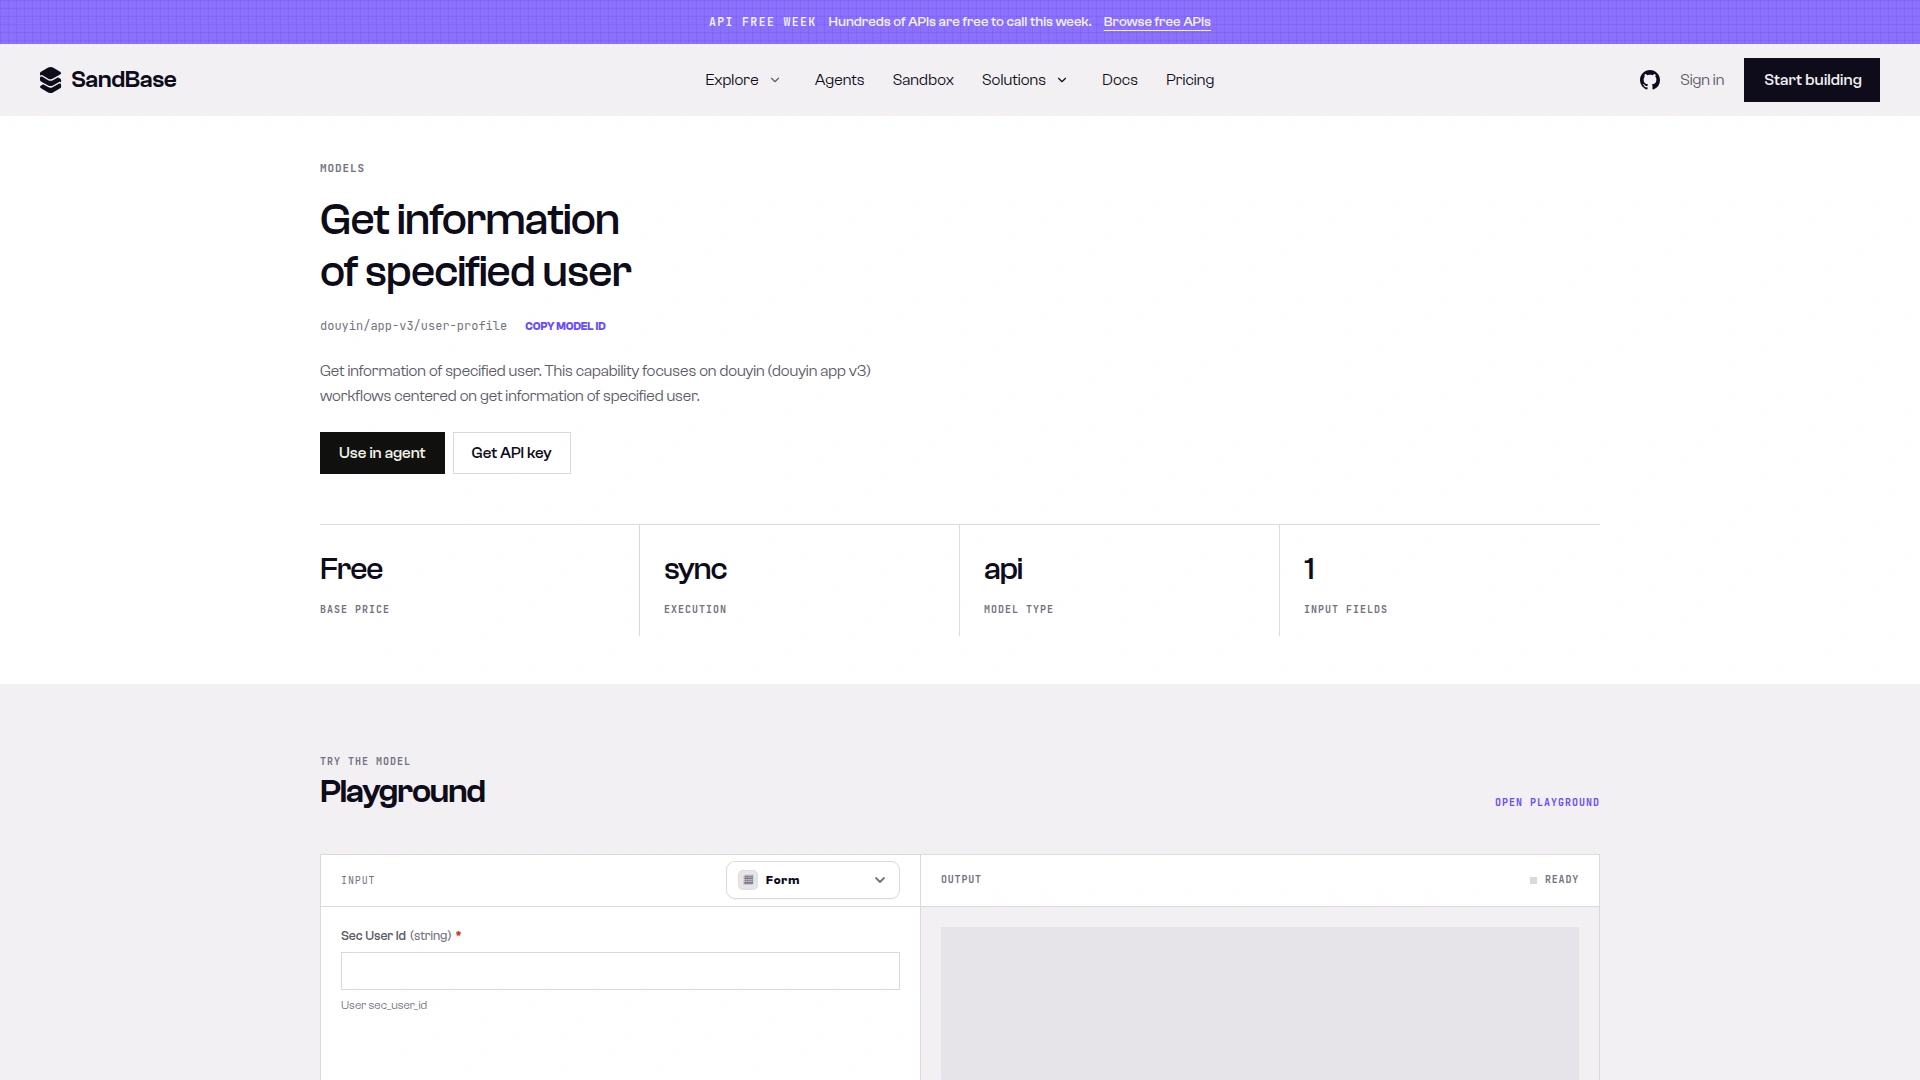
截图:douyin/app-v3/user-profile 模型卡片显示基础价格「Free」、执行方式「sync」(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
爬虫成本模型(示意)
基础设施(假设):
  - 代理池:$200–500/月
  - 浏览器集群:$100–300/月
  - IP 轮换服务:$50–150/月
  - 监控告警:$50/月
  小计:$400–1,000/月

工程(假设 $150/小时):
  - 初始开发:40–80 小时(一次性:$6,000–12,000)
  - 持续修选择器:8–16 小时/月
  - 反爬适配:4–8 小时/月
  持续投入:12–24 小时/月 = $1,800–3,600/月

每天 10,000 个画像的持续总成本:约 $2,200–4,600/月
在这类假设下,算上工程时间,爬虫往往比 API 更贵。请代入你自己的费率。
盈亏平衡示例
| 日调用量 | API 月成本(假设 $0.001/次) | 爬虫月成本(假设) | 更便宜 |
|---|---|---|---|
| 100 次 | $3 | $800+ | API |
| 1,000 次 | $30 | $1,200+ | API |
| 10,000 次 | $300 | $3,500+ | API |
| 100,000 次 | $3,000 | $5,000+ | API |
| 1,000,000 次 | $30,000 | $12,000+ | 爬虫* |
*前提是你已有专职工程团队在编,且平台没有主动对抗你的爬虫。
API 一栏用的是虚构的付费单价,只为说明交叉点可能在哪,不是 SandBase 的价格。把你所用端点在 SandBase 目录里的按次单价代进去,就能算出自己的交叉点,再看调用量限制、延迟和可靠性。
维度四:速度与延迟
Agent 架构对延迟敏感,决策循环里的 Agent 不该等 30 秒拿数据。
| 指标 | 结构化 API | 爬虫 |
|---|---|---|
| 单次请求工作量 | 一次 HTTP 调用 | 页面加载 + 渲染 + 解析 |
| 实测示例 | user-profile 每次 1.9–3.2 秒(6 次,2026-10-01) | 本文未实测 |
| 并行度 | 受限流约束 | 受代理池和浏览器数量约束 |
| 突发容量 | 限流响应会告诉你 | 靠试错 |
| 超时策略 | 标准 HTTP 超时 | 复杂(加载 + 渲染 + 解析) |
对需要在几分钟内响应热点的 Agent,这个差别很重要:并行的 API 调用一起返回,而爬虫每个页面都需要浏览器会话、代理轮换和页面渲染。决定前请在你自己的工作负载上实测两者。
同步 vs 异步
采用 sync-only 设计的结构化 API 直接嵌入 Agent 工具调用流程。Agent 调函数、拿 JSON、继续推理。无轮询、无回调、无状态管理。
爬虫需要异步模式:启动浏览器、等页面、提取数据、关浏览器。Agent 要么阻塞(慢),要么管理并发状态(复杂)。
维度五:数据覆盖与灵活性
这是爬虫理论上有真正优势的维度。
结构化 API 的优势:
- 精选端点,请求和信封有文档
- 响应结构长期一致
- 原始计数可由你聚合成互动率和趋势
- 跨平台标准化(见异构接口怎么归一成 Agent 契约)
爬虫的优势:
- 页面上任何可见数据都能拿
- UI 级细节(布局、视觉上下文)
- 任何 API 都没暴露的数据
- 不依赖第三方的端点路线图
- 针对小众数据的定制提取逻辑
实践中,爬虫的灵活性优势比看起来小。大多数 Agent 用例需要的是对同类数据的结构化、重复访问,这正是 API 擅长的。
什么时候爬虫胜出
确实存在爬虫是正确选择的场景:
-
没有 API。 如果没有任何 API 提供你需要的公开数据点,爬虫可能是唯一路径。
-
一次性研究。 如果只需要拿一次数据集,爬虫的持续维护成本就不存在。
-
视觉/布局数据。 如果 Agent 需要理解内容如何展示(广告位、UI 模式),API 给不了。
-
超大量级的简单数据。 每天数百万次简单公开数据请求时,如果你有工程团队,爬虫可能更便宜。
什么时候 API 胜出
对大多数 Agent 架构,结构化 API 是更好的路径:
-
生产级 Agent。 显式错误和稳定信封胜过爬虫的静默失效。向服务商索要公布的 SLA。
-
实时决策循环。 延迟预算紧时,一次 HTTP 调用胜过一次浏览器渲染。
-
中国平台。 反爬要求高,和按次计费的 API 相比,维护爬虫很少划算。法务审查两条路线都要做。
-
没有爬虫经验的团队。 构建和维护爬虫基础设施是专门技能。
-
审查要求高的部署。 一个供应商的条款和用量记录,比自建爬虫更便于企业和受监管团队审查。
对 Agent 开发者的架构影响
API 与爬虫的选择会传导到整个 Agent 架构。
用结构化 API
示例调用 douyin/app-v3/user-profile(端点参考),需要一个 SandBase API Key:
# Agent 工具定义:简单、同步的请求/响应
import os
import httpx

client = httpx.AsyncClient(
    base_url="https://api.sandbase.ai",
    headers={"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"},
    timeout=30,
)


async def get_douyin_user_metrics(sec_user_id: str) -> dict:
    response = await client.post(
        "/v1/api/douyin/app-v3/user-profile", json={"sec_user_id": sec_user_id}
    )
    response.raise_for_status()
    body = response.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(
            f"SandBase call did not complete: {body.get('status')} {body.get('error')}"
        )
    return (outputs[0].get("data") or {}).get("user") or {}
这是 SandBase 的 Model API 路由(POST /v1/api/douyin/app-v3/user-profile,Bearer 鉴权,JSON body 只放 sec_user_id)。参考文档记录的完成态负载在 outputs[0].data;调用未完成时函数会直接抛错。
端点参考页确认了这条路由,以及函数发送的唯一必填 body 字段。
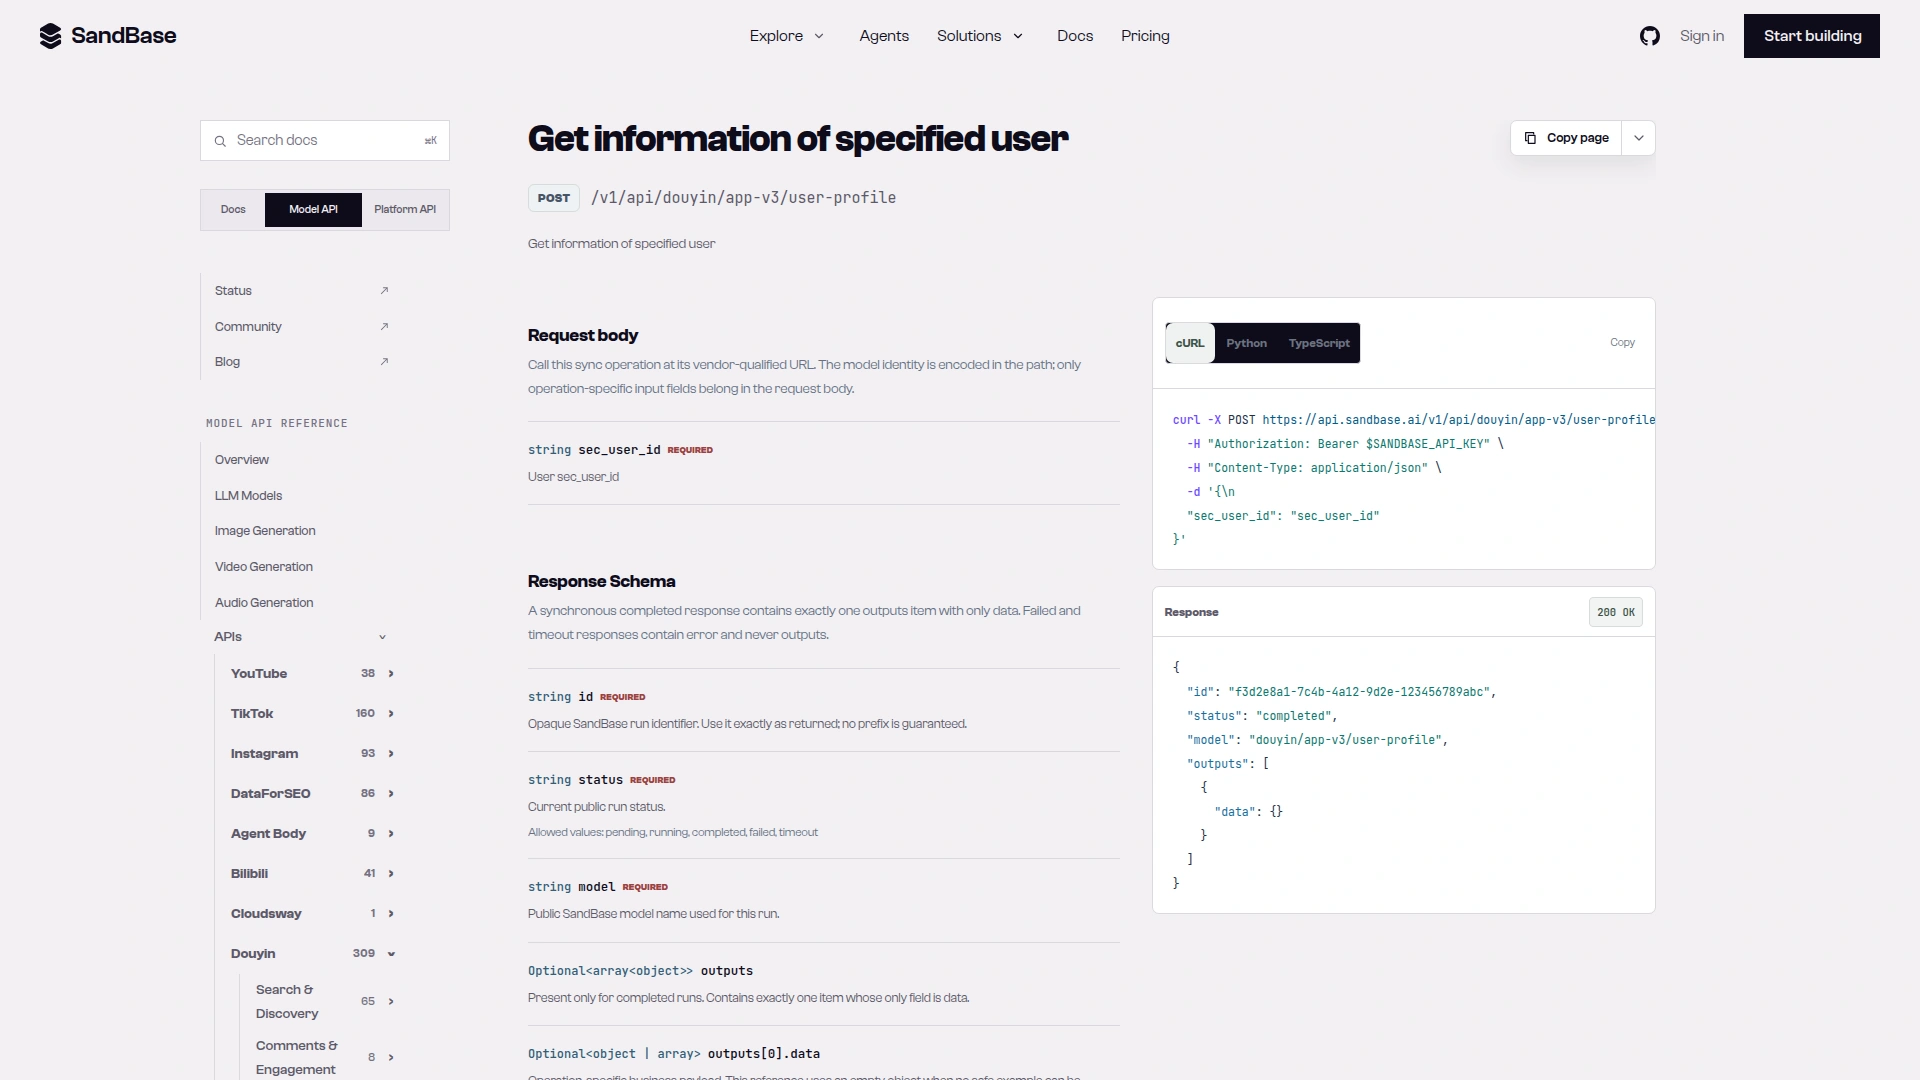
截图:douyin/app-v3/user-profile 参考页显示 POST /v1/api/douyin/app-v3/user-profile、一个必填的 sec_user_id 字符串字段,以及文档化的响应信封(2026-10-02 截取)。
Tested on 2026-10-01(UTC),测试对象是人民日报的公开官方账号,请求 body 为 {"sec_user_id": "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4"}。截短后的返回:
{
  "id": "b85d53b6-2d8c-45f0-a017-4cf9fd0480fb",
  "status": "completed",
  "model": "douyin/app-v3/user-profile",
  "outputs": [{
    "data": {
      "status_code": 0,
      "user": {
        "nickname": "人民日报",
        "unique_id": "rmrbxmt",
        "follower_count": 203211105,
        "aweme_count": 12276
      }
    }
  }]
}
user.nickname 和 user.follower_count 来自这次调用,属于实测观察,不是文档保证,读取时用 .get()。
用爬虫
# Agent 工具定义:复杂、脆弱(示意,不能直接运行)
async def get_douyin_user_metrics(user_id: str) -> dict:
    browser = await launch_browser(proxy=get_rotating_proxy())
    try:
        page = await browser.new_page()
        await page.goto(f"https://www.douyin.com/user/{user_id}")
        await page.wait_for_selector(".user-stats", timeout=10000)
        # 解析 DOM:抖音前端一改就坏
        followers = await page.query_selector(".follower-count")
        likes = await page.query_selector(".like-count")
        # ... 还有 20 行脆弱的 DOM 解析
    except TimeoutError:
        # 触发反爬?代理被封?页面改版?
        return None  # Agent 现在得处理缺失数据
    finally:
        await browser.close()
API 路线给你一个简单函数,干净地嵌入任何 Agent 框架的工具调用模式。爬虫路线给你一个脆弱、慢、复杂、每一步都要错误处理的函数。
编排层
SandBase 这类平台提供跨众多异构 API 的统一契约,让 API 路线更有吸引力。不用逐个集成每个数据供应方,你得到的是一种认证方式、一种响应信封。截至 2026-10-01,SandBase 目录显示 抖音 262、TikTok 145、微博 52、小红书 34 个端点(合计 493)。本文覆盖的是文中用到的、有文档的公开只读端点,例如 douyin/app-v3/user-profile。并不是每个目录条目都符合这个描述:有些依赖平台 cookie 或登录会话(见下文)。
抖音的数量来自抖音目录页。
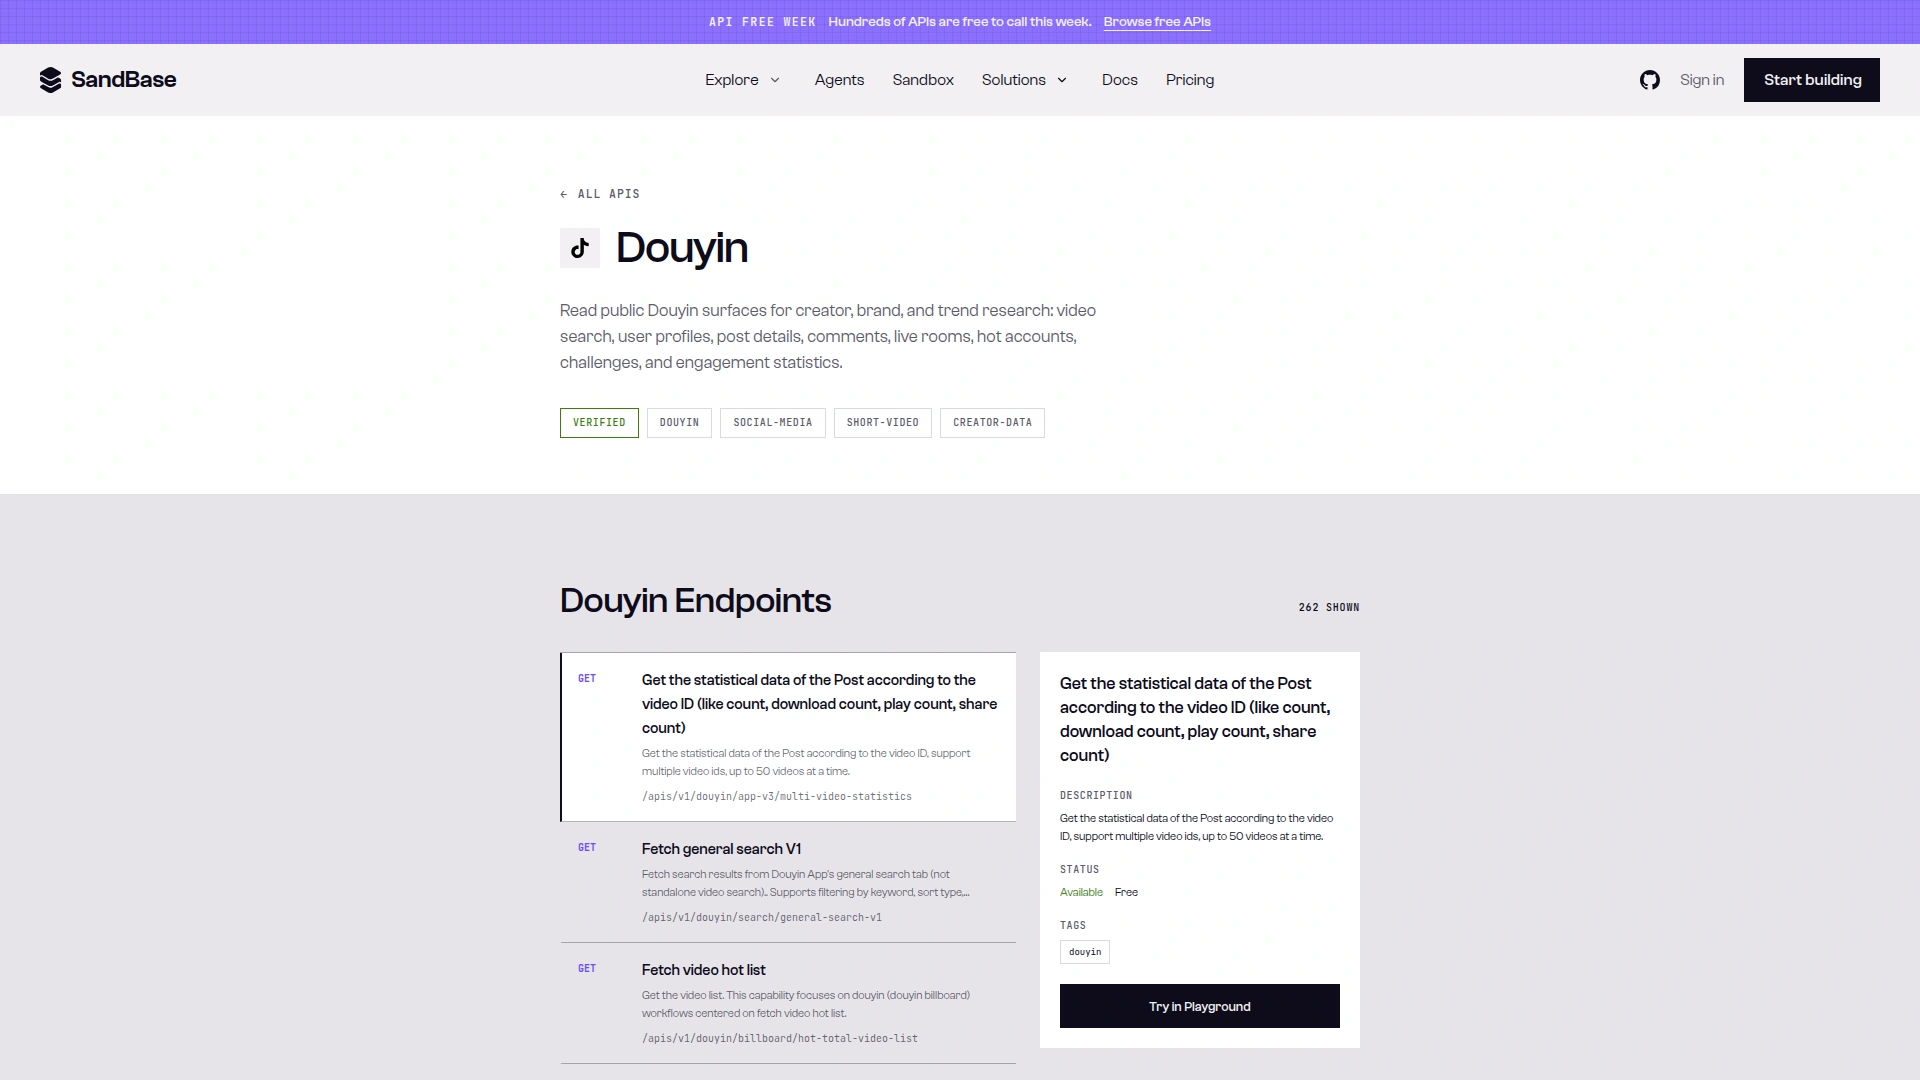
截图:抖音目录页显示「262 SHOWN」,与上文的抖音数量一致(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
依赖鉴权的能力
少数目录条目不属于本文描述的「公开数据 + 仅需 API Key」工作流。截至 2026-10-01 的两个抖音例子:douyin/index/get-user-sub-word 返回抖音指数当前登录用户订阅的关键词列表,douyin/web/generate-ttwid 生成 ttwid 设备 cookie。这类端点应视为依赖会话或 cookie,使用前先看端点参考,任何 cookie 值都按凭证处理。
这对 Agent 开发者的意义在于:无论 Agent 用多少数据源,工具定义都保持简单。
决策框架
按以下顺序做架构决策:
- 你的数据需求有结构化 API 吗? 没有 → 爬虫(如果你代表已授权账号操作,也可以用平台官方 API)。
- 用例是生产级/持续性的吗? 是 → API(爬虫维护成本会不断累积)。
- 延迟预算紧吗? 是 → API。
- 读取中国平台吗? 是 → 鉴于反爬强度,API 通常更简单;法务审查两条路线都要做。
- 日调用量 > 100 万且有专职工程团队? 是 → 爬虫可能更便宜(用你自己的数字算一遍)。
- 需要视觉/布局数据? 是 → 爬虫(API 不捕获展示层)。
| 平台官方 API | 公开数据 API(SandBase) | 爬虫 | |
|---|---|---|---|
| 数据范围 | 授权给你应用的账号 | 有文档的公开只读端点 | 你能加载的任何页面 |
| 鉴权 | 各平台的开发者授权,通常是授权账号的 OAuth | 一个 SandBase API Key | 你自己的会话/代理 |
| 账号操作、仅所有者可见的分析 | 对已授权账号支持 | 不支持 | 不支持(除非自动化登录,而这不该做) |
| 维护 | 平台维护 | 服务商维护 | 你自己 |
| 适合 | 管理自己或客户的账号 | 研究、监控、Agent 工具 | 一次性或布局数据 |
对大多数基于公开社媒数据构建生产系统的 Agent 开发者,结构化 API 是更好的默认选择。可靠性、速度和简洁性的优势随时间复利,而爬虫的灵活性很少能抵消它的运维负担。
想动手试试:创建 SandBase API Key、浏览抖音目录,或打开 user-profile 端点参考。
结论
对大多数生产级 Agent 架构,这不是势均力敌的选择。结构化 API 在显式失败、稳定信封、集成简单以及(算上工程时间后)通常的成本上胜出。爬虫在灵活性上胜出,在极大规模且已有团队时,单位经济也可能更好。两条路线都不能免除你自己的法律义务。
SandBase 的观点是:Agent 更适合 API 优先的数据访问,因为 Agent 需要可预测、快速、结构化的输入。爬虫适合人类会审查并纠正提取数据的时代。Agent 做不到这一点,它需要以自己的运行速度拿到可信的数据。