Gemini 4 Argon、Claude Opus 5.5 和 GPT-6 Astra 对比:什么活该用哪个
Gemini 4 Argon 和 Claude Opus 5.5、GPT-6 Astra 对比:Google 官方表格里 Argon 赢在哪、输在哪,Artificial Analysis 独立榜单怎么看,价格多少,再加我们 24 次同题实测的逐次成本。
同样四道题,我们在 SandBase 上分别发给 Gemini 4 Argon、Claude Opus 5.5 和 GPT-6 Astra,每题跑两次。逻辑题、代码输出题、采购单算账,三个模型全都做对了。24 次调用里只有两次判错,而且跟智力无关:我们用 response_format 传了 JSON Schema,Opus 回了一句“No schema actually came through with your message”,然后给出一段说明文字加一个代码块,不是纯 JSON。
所以 Gemini 4 Argon 和 Claude Opus 5.5 对比,放在 2026 年 10 月,真正的答案不在“谁更聪明”。小而可核对的任务上,三家旗舰几乎分不出高下。拉开差距的是:你让它干什么活、每个任务(不是每个 token)花多少钱、输出格式守不守约定、跑分里各自的短板在哪。本文写给要在三者里挑一个干具体活的开发者。Argon 的完整独立排名见 Gemini 4 Argon 跑分排名。
先说结论
- Google 模型卡的对比表里,Argon 在知识工作类 Agent(Vals Index 68.9、Harvey Legal Agent 19.6)和超长上下文(GraphWalks 256k–1M 84.2)上领先 Opus 5.5 和 GPT-6 Astra;在 FrontierSWE v2、Terminal-bench 4.0、PostTrainBench、Terminal-Bench Science、OSWorld-2.0 上落后。全部是 Google 自报。
- Artificial Analysis(Intelligence Index v4.3,数据截至 2026-10-12):Gemini 4 Argon (High) 52.6,和 GPT-6 Astra (Max) 的 52.7 基本持平,低于 Claude Opus 5.5 (Max) 的 57.6。AA 还没有 Argon 的编码、Agent 和速度数据。
- SandBase 标价(每百万 token):Argon $4 / $20,Opus 5.5 $4 / $20,GPT-6 Astra $10 / $50。Google 直连的 Argon 介绍价是 $2 / $10,到 2026 年 11 月 30 日为止。
- 我们 24 次实测(2026-10-14 UTC):Argon 8/8,实扣 $0.148;Astra 8/8,$0.170;Opus 6/8,$0.203。Opus 错的两次都是
response_format,把 Schema 直接写进提示词后两次全对。- Astra 每 token 贵 2.5 倍,但逻辑题只写了别人三分之一的 token,这道题实扣反而三家里最少(靠的是当天 9 折;按原价算 Opus 5.5 略便宜)。
三个模型先摆一起看
价格来自 2026-10-14(UTC)的 GET /v1/models/<id>,模型 id 分别是 google/gemini-4-argon、anthropic/claude-opus-5.5、openai/gpt-6-astra。上下文和最大输出取自同一天的 SandBase 模型页。
| Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|
| SandBase 标价(输入 / 输出,每百万) | $4 / $20 | $4 / $20 | $10 / $50(提示词低于 272K 时) |
| 当天页面折扣 | 无 | 95 折 | 9 折 |
| 缓存读取倍率 | 0.05 | 0.05 | 0.1 |
| SandBase 上下文 / 最大输出 | 1M / 65.5K | 1M / 128K | 1.1M / 128K |
| AA 智能指数 v4.3 | 52.6(High) | 57.6(Max)、53.6(High) | 52.7(Max)、49.6(Medium) |
| AA 编码 / Agent 指数 | 未测 | 未测 | 76.9 / 51.0(Max) |
| Google 表格里领先的方向 | 知识工作 Agent、超长上下文、长视频 | Terminal-bench 4.0、PostTrainBench | FrontierSWE v2、Terminal-Bench Science、OSWorld-2.0 |
| 我们的实测(各 8 次) | 8/8,$0.148 | 6/8,$0.203 | 8/8,$0.170 |
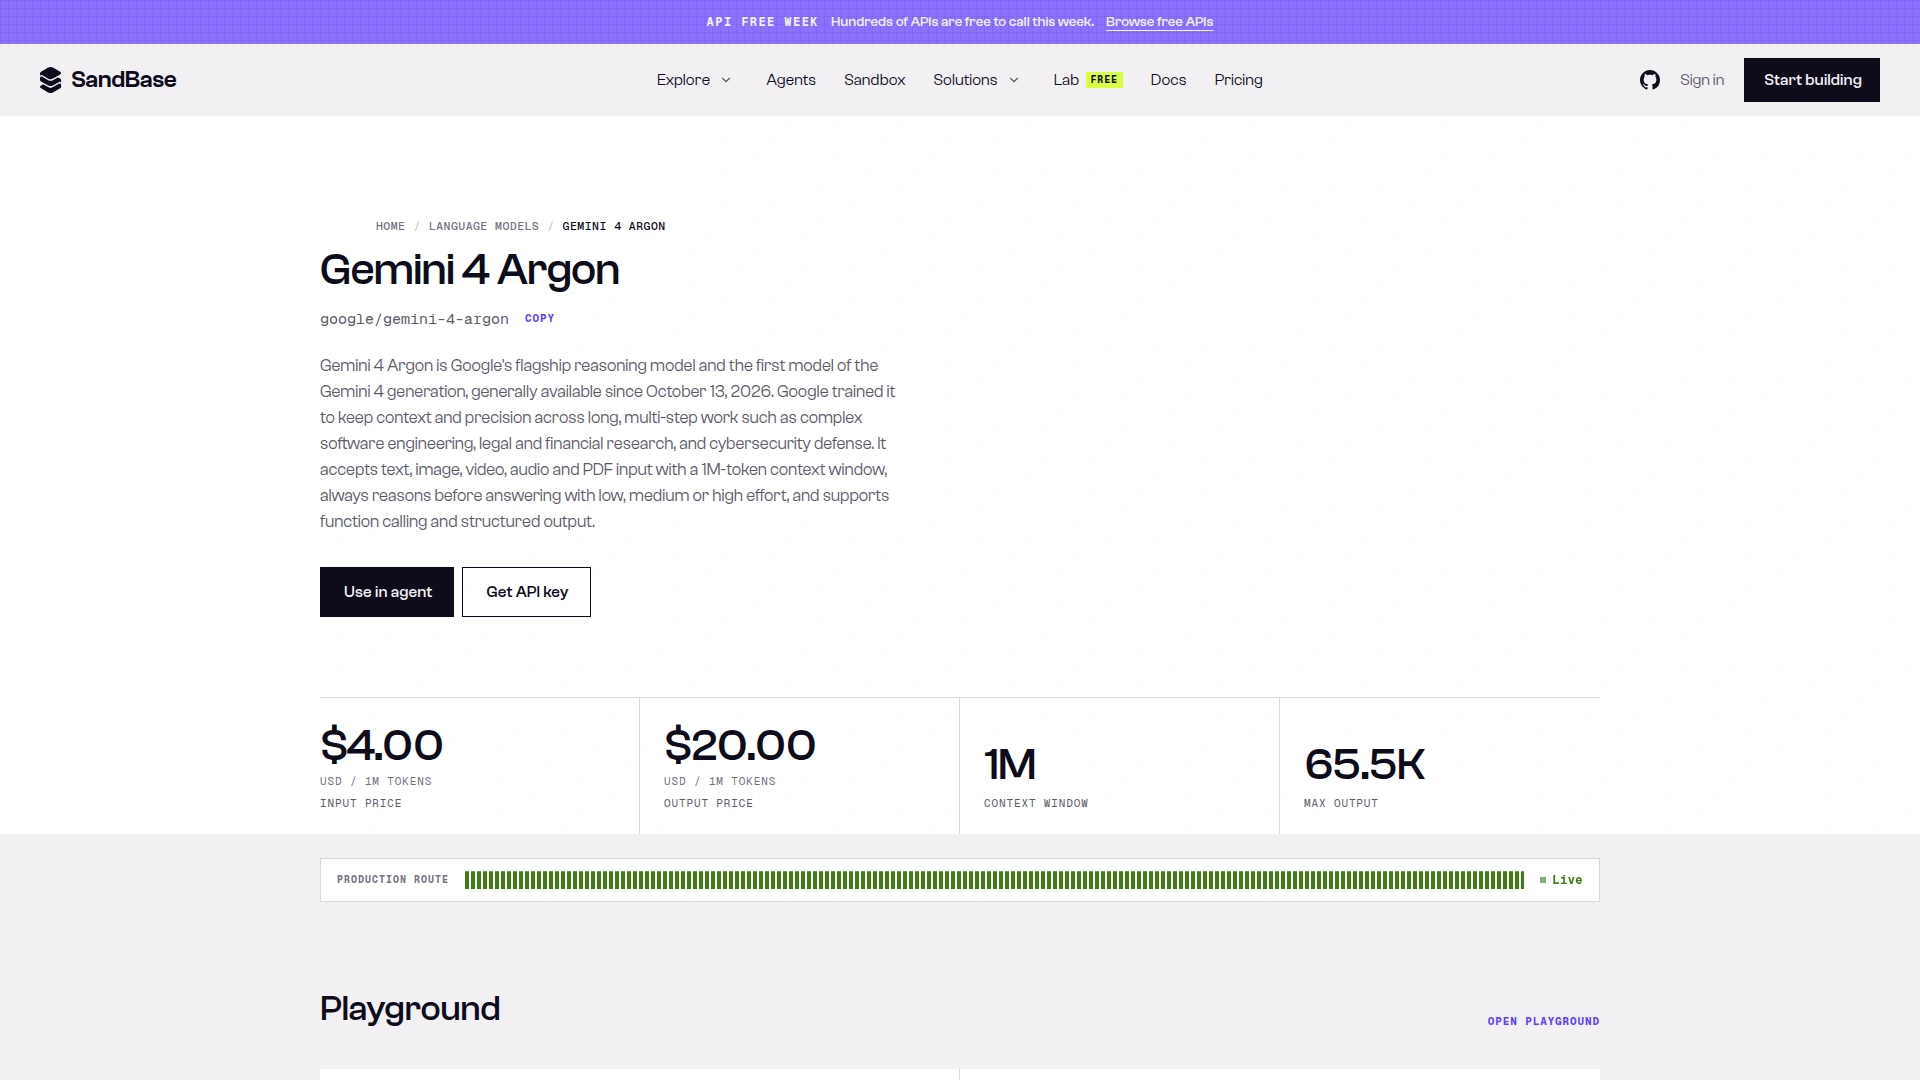
图注:SandBase 的 Gemini 4 Argon 页面标价 $4 / $20、最大输出 65.5K,本文所有 Argon 成本都按这个价算(2026-10-14 UTC 截图)。
有一点得说清楚:$4 / $20 是 Google 介绍期结束后的标准价。11 月 30 日之前 Google 直连只收 $2 / $10,也就是说,眼下在 SandBase 上用 Argon,单价是 Google 直连的两倍。12 月 1 日之后怎么算,见 Gemini 4 Argon 价格。
Google 自己的表格:Argon 赢在哪,输在哪
Google 的模型卡(2026 年 10 月 13 日发布)把 Argon 和 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 放在一张表里。下面只留跟这三家有关的行,Fable 那一列去掉了。数字全部是 Google 自报,我们没有复现。
| 基准(测什么) | Argon | GPT-6 Astra | Opus 5.5 | 领先 |
|---|---|---|---|---|
| Vals Index(专业任务) | 68.9 | 63.1 | 67.0 | Argon |
| AutomationBench(流程自动化) | 51.3 | 41.4 | 42.5 | Argon |
| Vals Finance Agent v2 | 65.4 | 53.5 | 58.6 | Argon |
| Harvey Legal Agent | 19.6 | 5.4 | 3.8 | Argon |
| GraphWalks 256k–1M(超长上下文) | 84.2 | 71.8 | 66.8 | Argon |
| LVBench(长视频) | 91.7 | 87.5 | 83.7 | Argon |
| DeepSWE v1.1(长程软件工程) | 77.9 | 74.1 | 74.2 | Argon |
| FrontierSWE v2(高难编码) | 55.0 | 65.5 | 62.3 | Astra |
| Terminal-Bench Science 0.1 | 57.6 | 68.1 | 63.3 | Astra |
| OSWorld-2.0 offline(操作电脑) | 69.2 | 72.6 | — | Astra |
| Terminal-bench 4.0(终端 Agent) | 57.4 | 58.2 | 66.4 | Opus |
| PostTrainBench(ML 工程) | 45.3 | 44.3 | 49.3 | Opus |
把行排开看,规律比标题清楚得多:Argon 赢的是文档多、步骤多的知识工作和超长输入;输的是真动手的工程活——开终端、啃难仓库、操作桌面。Harvey Legal Agent 上 19.6 对 5.4 和 3.8,是整张表里相对差距最大的一项。说实话,真要把法律流程押在它身上,我会先等别人独立复现。法律和金融场景单独写在 Gemini 4 Argon 法律、金融场景。
独立榜单补上了什么
厂商表格的基准是自己挑的。Artificial Analysis 用同一套评测跑所有模型,我们用的是它的免费层数据。Intelligence Index v4.3(数据截至 2026-10-12,共 687 行有分数,每行是“模型 × 推理强度”的组合,不是独立模型),Gemini 4 Argon (High) 排第 8。和本文相关的几行:
| AA 配置 | 智能指数 | AA 跑指数的每任务成本 |
|---|---|---|
| Claude Opus 5.5 (Max, Default Fallback) | 57.6 | $5.98 |
| Claude Opus 5.5 (High, Default Fallback) | 53.6 | $1.82 |
| GPT-6 Astra (Max) | 52.7 | $3.26 |
| Gemini 4 Argon (High) | 52.6 | $1.99(按 $2 / $10) |
| GPT-6 Astra (Medium) | 49.6 | $1.54 |
看这张表要记住两件事。第一,AA 按 Google 的 $2 / $10 介绍价给 Argon 算成本;换成 SandBase 的 $4 / $20,同样的 token 大约翻倍,每任务约 $4,比 Opus 5.5 High 还贵。第二,AA 还没测 Argon 的编码和 Agent 指数,偏偏这两块正是 Google 自己表格里 Argon 落后的方向。Argon 的 AA 法律指数 60.0,高于 Opus 5.5 High(59.0)和 Astra Max(58.5),低于 Opus 5.5 Max(63.3)。指数构成见 AA 方法论。
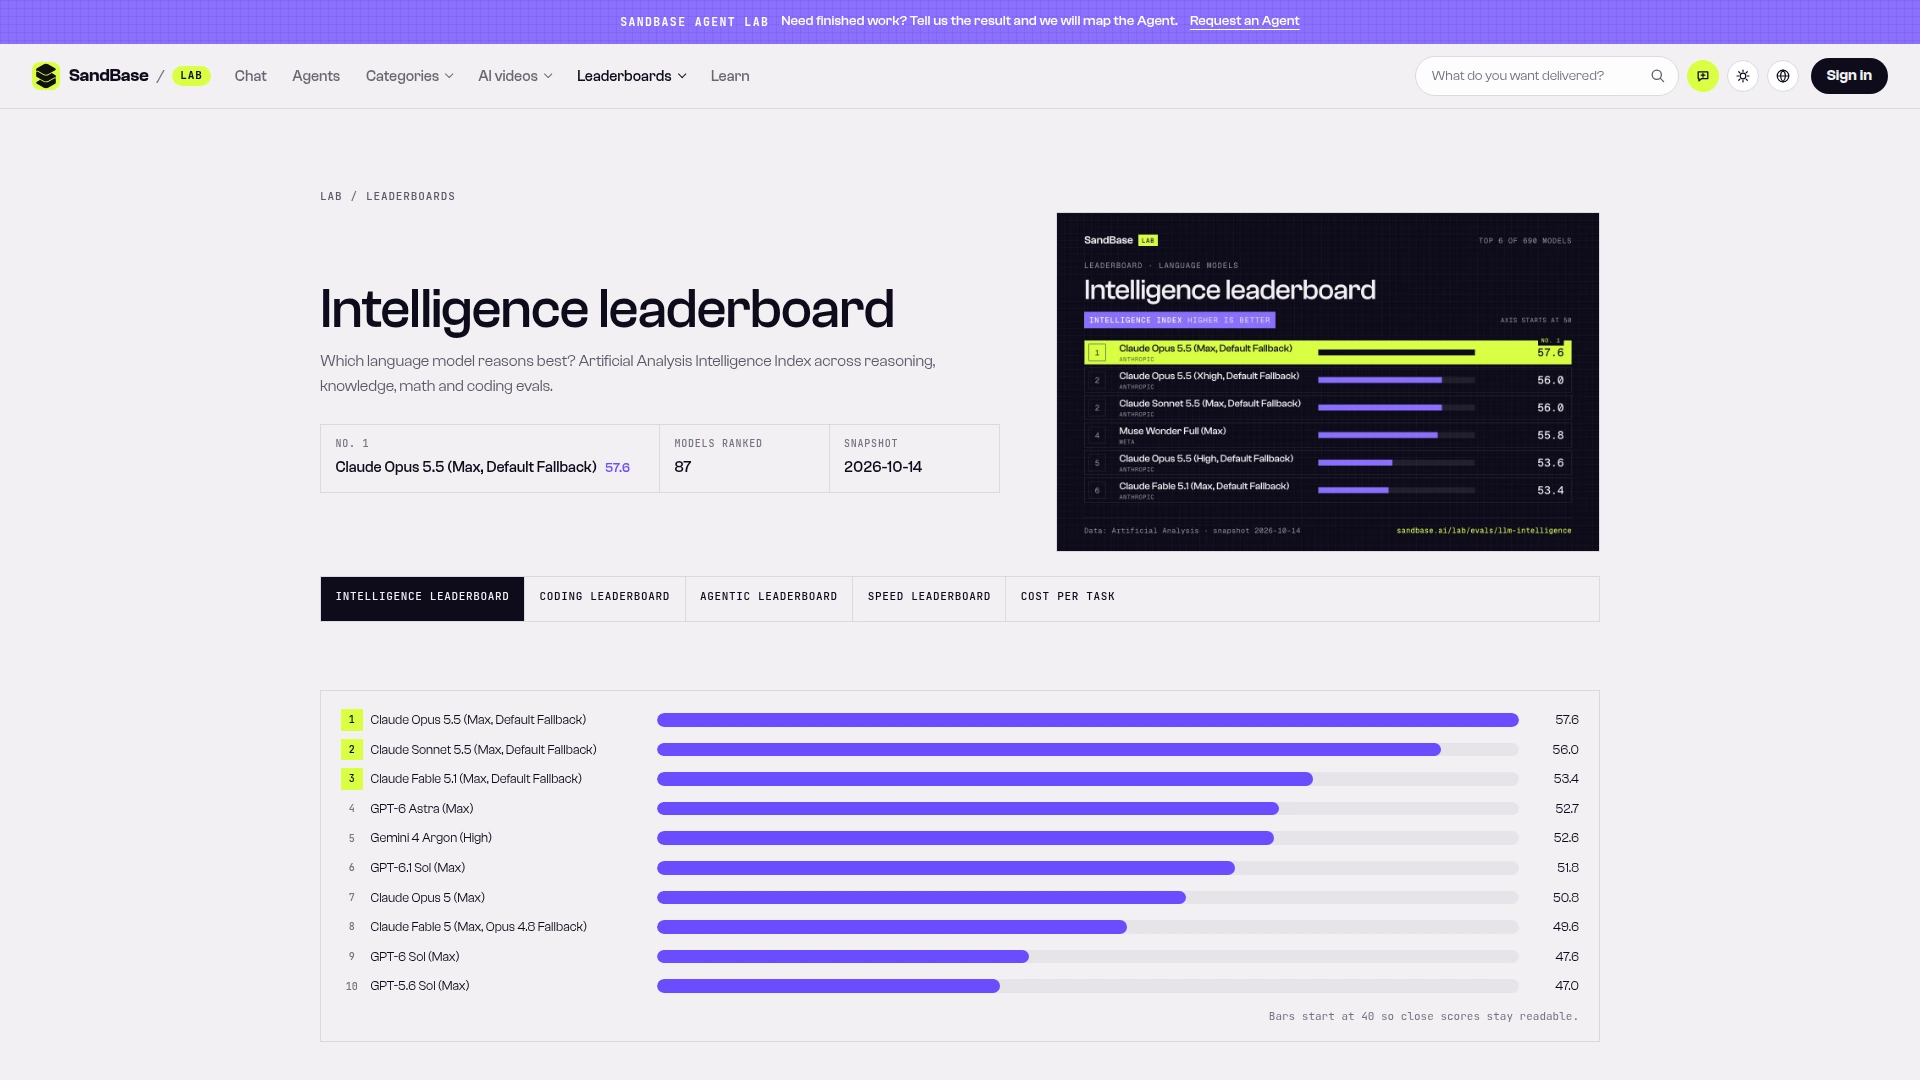
图注:SandBase Lab 智能排行榜基于 Artificial Analysis 数据,只排 SandBase 目录里的模型:Gemini 4 Argon (High) 在 87 个里排第 5,比 GPT-6 Astra (Max) 低 0.1。这个名次是 SandBase 目录内的,不是 AA 全部行(2026-10-14 UTC 截图,Lab 快照日期 2026-10-14)。
Lab 评测页还有编码、Agent、速度、成本几个标签页,AA 没测过的那几项里找不到 Argon。
我们的同题实测
跑分讲的是平均值。我更想知道一个普通开发者发一次请求,在三家身上分别是什么样:多少 token、几秒、几分钱、回复能不能直接用。测试范围先说清楚:四道短题,每题两次,一共 24 次调用。够看出行为差异,不够给智力排座次。
所有请求都发到 SandBase 的 OpenAI 兼容 Chat Completions 接口 POST https://api.sandbase.ai/v1/chat/completions,时间是 2026-10-14 18:30 到 18:37(UTC),只设了 max_tokens: 16000。推理强度全用默认:Astra 在 SandBase 的参数表里 reasoning_effort 默认 medium;Argon 和 Opus 的参数表没有强度参数,我们也就没传。成本取 GET /v1/tasks/<completion id>/cost 返回的实扣 cost。
| 任务 | 考什么 | 标准答案 |
|---|---|---|
logic | 9 条约束的快递员排班题,再算 S = Σ 包裹号 × 出发时间;用穷举确认唯一解 | Ada 1@9、Ben 5@11、Cy 3@13、Dee 4@12、Eli 2@10,S = 171 |
extract | 采购邮件转 JSON,走严格的 response_format: json_schema:按打计数、按百件计价、取消一行、追加数量、单行 85 折、8.25% 税只算货款 | 4 个 SKU,货款 254.05,税 20.96,总计 293.01 |
extract_inline | 同一封邮件,Schema 写进提示词,不传 response_format(第 1 轮后补的) | 同上 |
code | 预测一行 Python 输出:可变默认参数、惰性生成器、整除、银行家舍入 | 100 [101, 104, 109] 109 -4 6 [1, 2] |
逻辑题要求最后一行固定输出 ANSWER: {...},评分脚本解析这一行逐项比对。抽取题把回复当 JSON 解析,SKU、数量、行金额、货款、税、运费、总计精确到分。
结果:答案一样,账单不一样
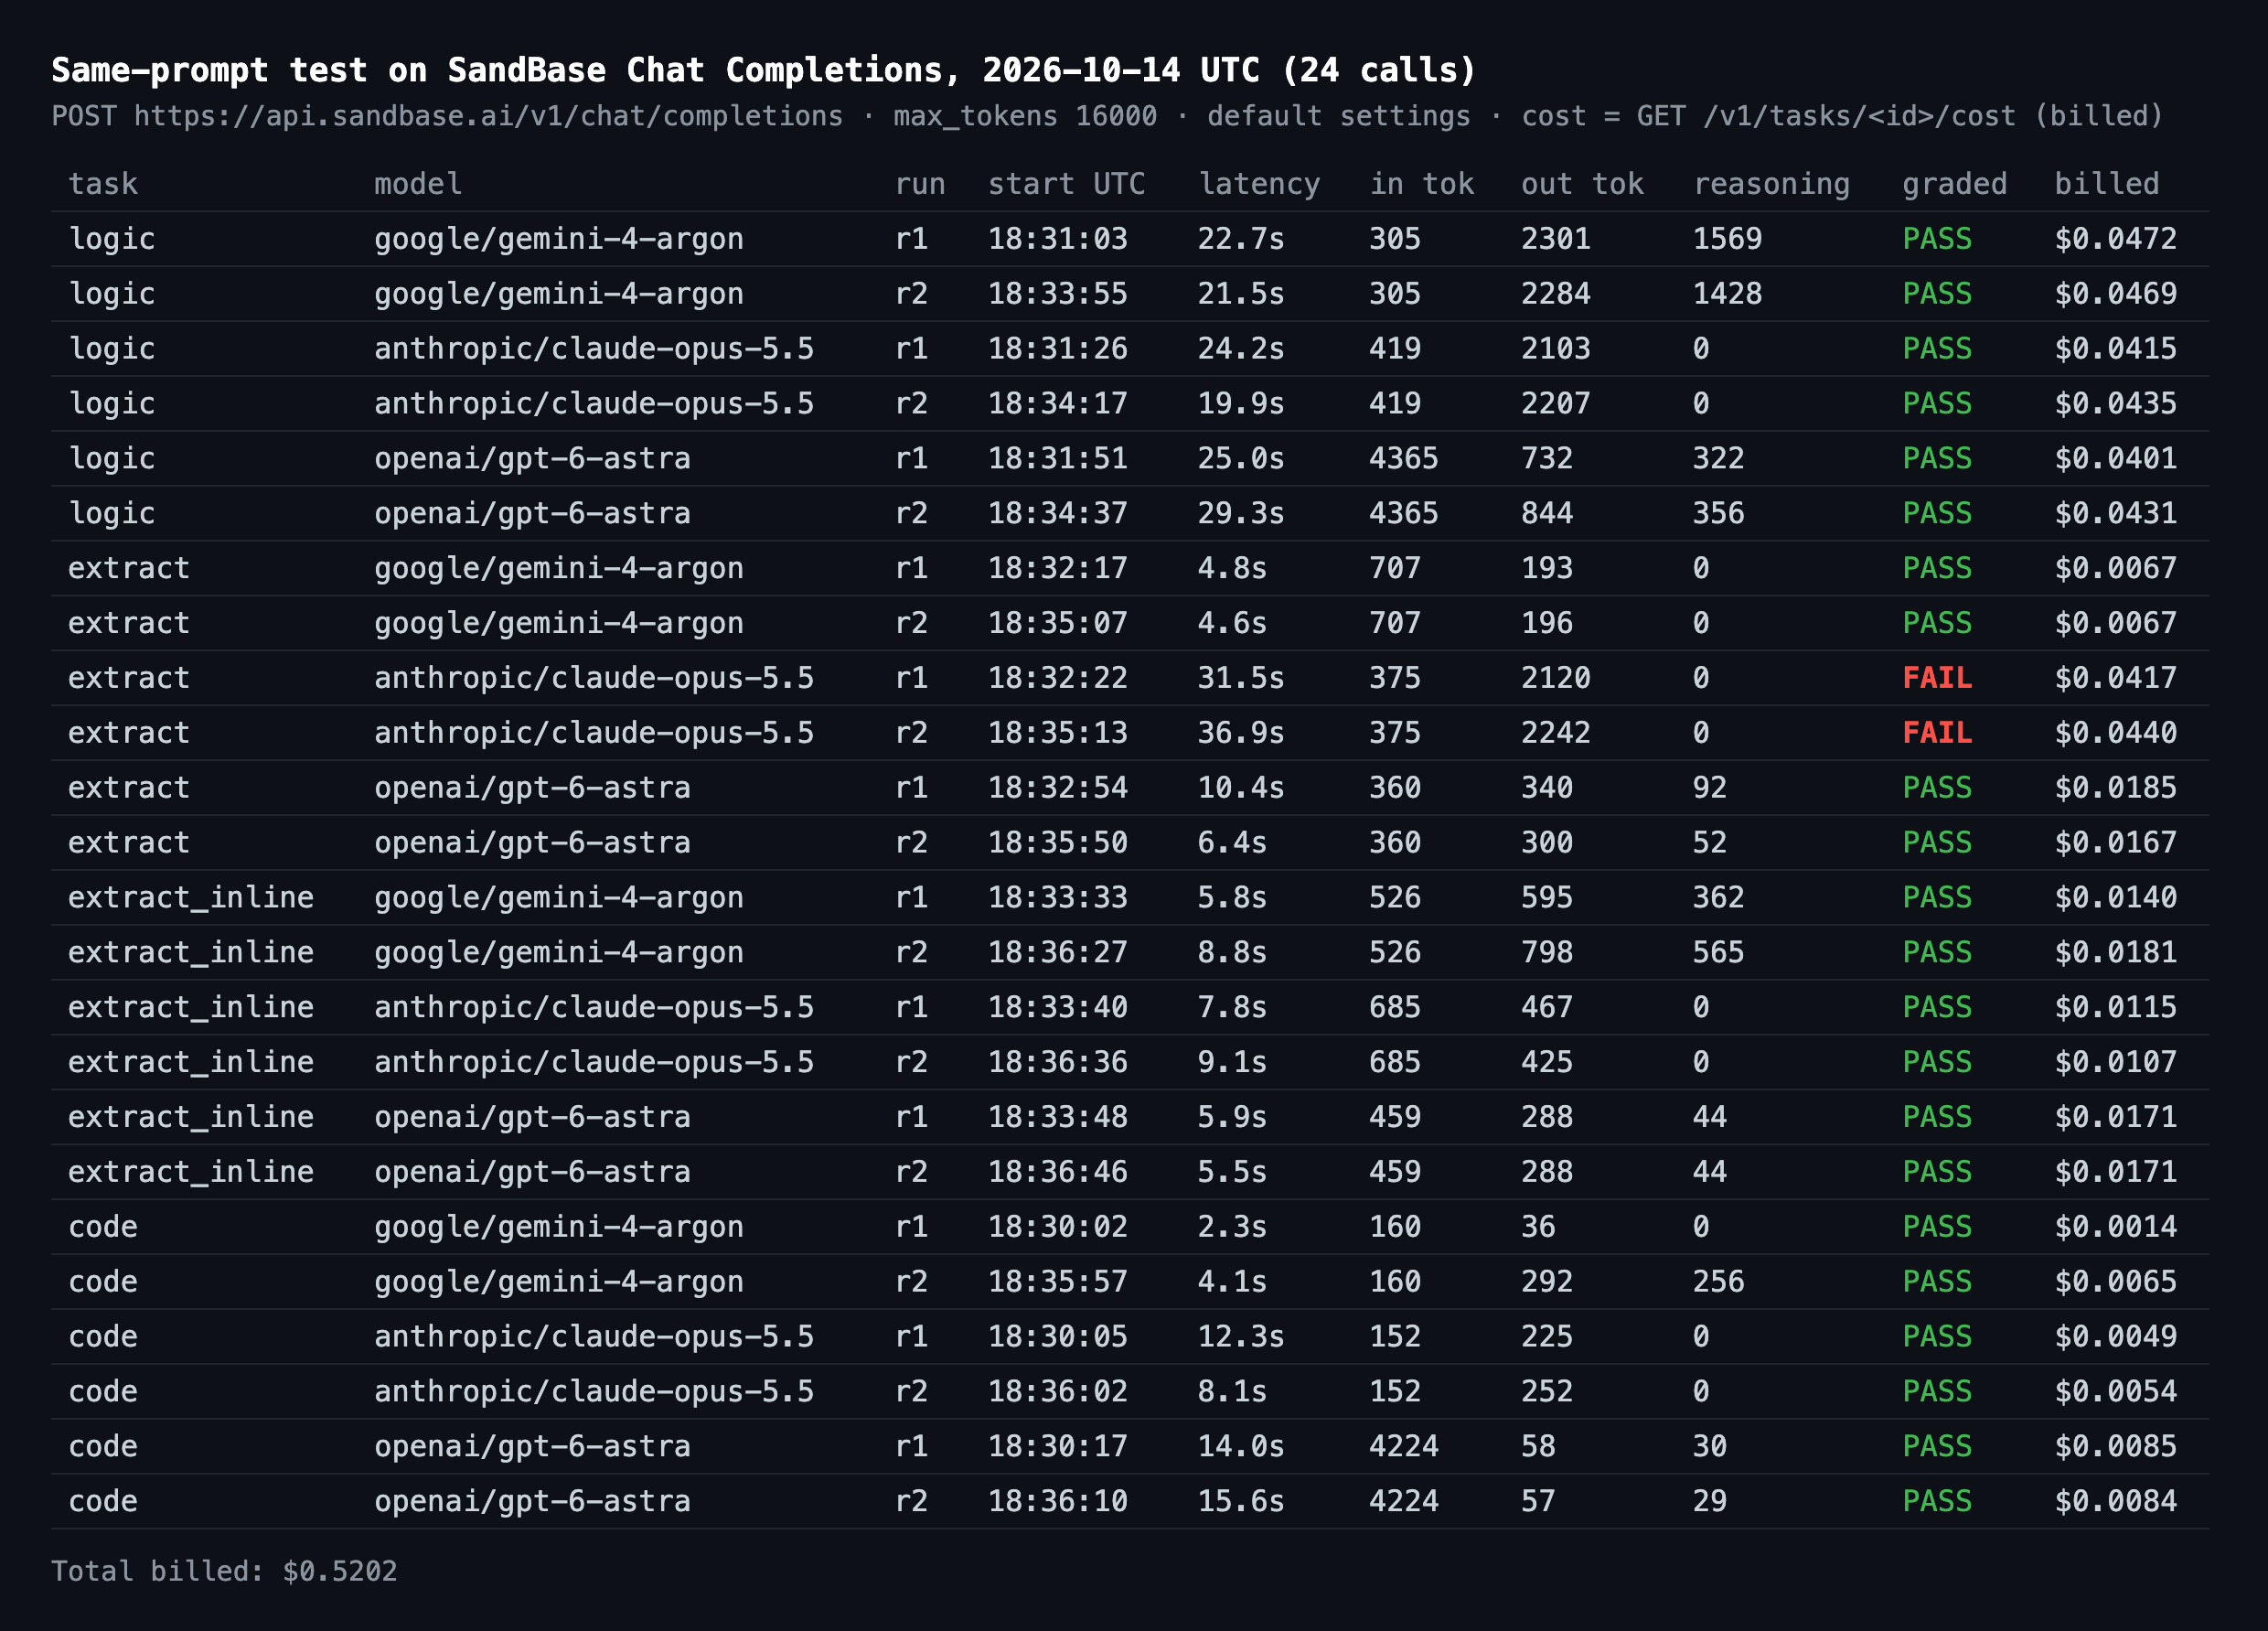
图注:根据我们保存的运行记录渲染的全部 24 次调用:除了 Claude Opus 5.5 的两次 response_format,其余全部通过;整轮测试经 /v1/tasks/<id>/cost 实扣 $0.52(2026-10-14 UTC 运行)。
两次的平均值(通过数、输出 token、耗时、实扣成本):
| 任务 | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| logic | 2/2,2,293,22.1 秒,$0.047 | 2/2,2,155,22.0 秒,$0.043 | 2/2,788,27.2 秒,$0.042 |
| extract | 2/2,195,4.7 秒,$0.0067 | 0/2,2,181,34.2 秒,$0.043 | 2/2,320,8.4 秒,$0.018 |
| extract_inline | 2/2,697,7.3 秒,$0.016 | 2/2,446,8.4 秒,$0.011 | 2/2,288,5.7 秒,$0.017 |
| code | 2/2,164,3.2 秒,$0.0039 | 2/2,239,10.2 秒,$0.0051 | 2/2,58,14.8 秒,$0.0085 |
Opus 5.5 在这条线路上没收到、或者没执行 response_format。 两次 extract 开头都说没看到 Schema,然后自己起字段名(order_number、customer、lines),JSON 包在代码块里,后面还跟着几条说明。账倒是算对了,一直算到 $293.01,只是把供应商写成了 customer。把 Schema 写进提示词后,Opus 两次都回了干净、字段对得上的 JSON,而且是三家里这题最便宜的。它在 SandBase 的参数表里明明列了 response_format,所以我倾向于把这当成线路行为去排查,而不是模型能力问题。Anthropic 官方 API 直连我们没测。
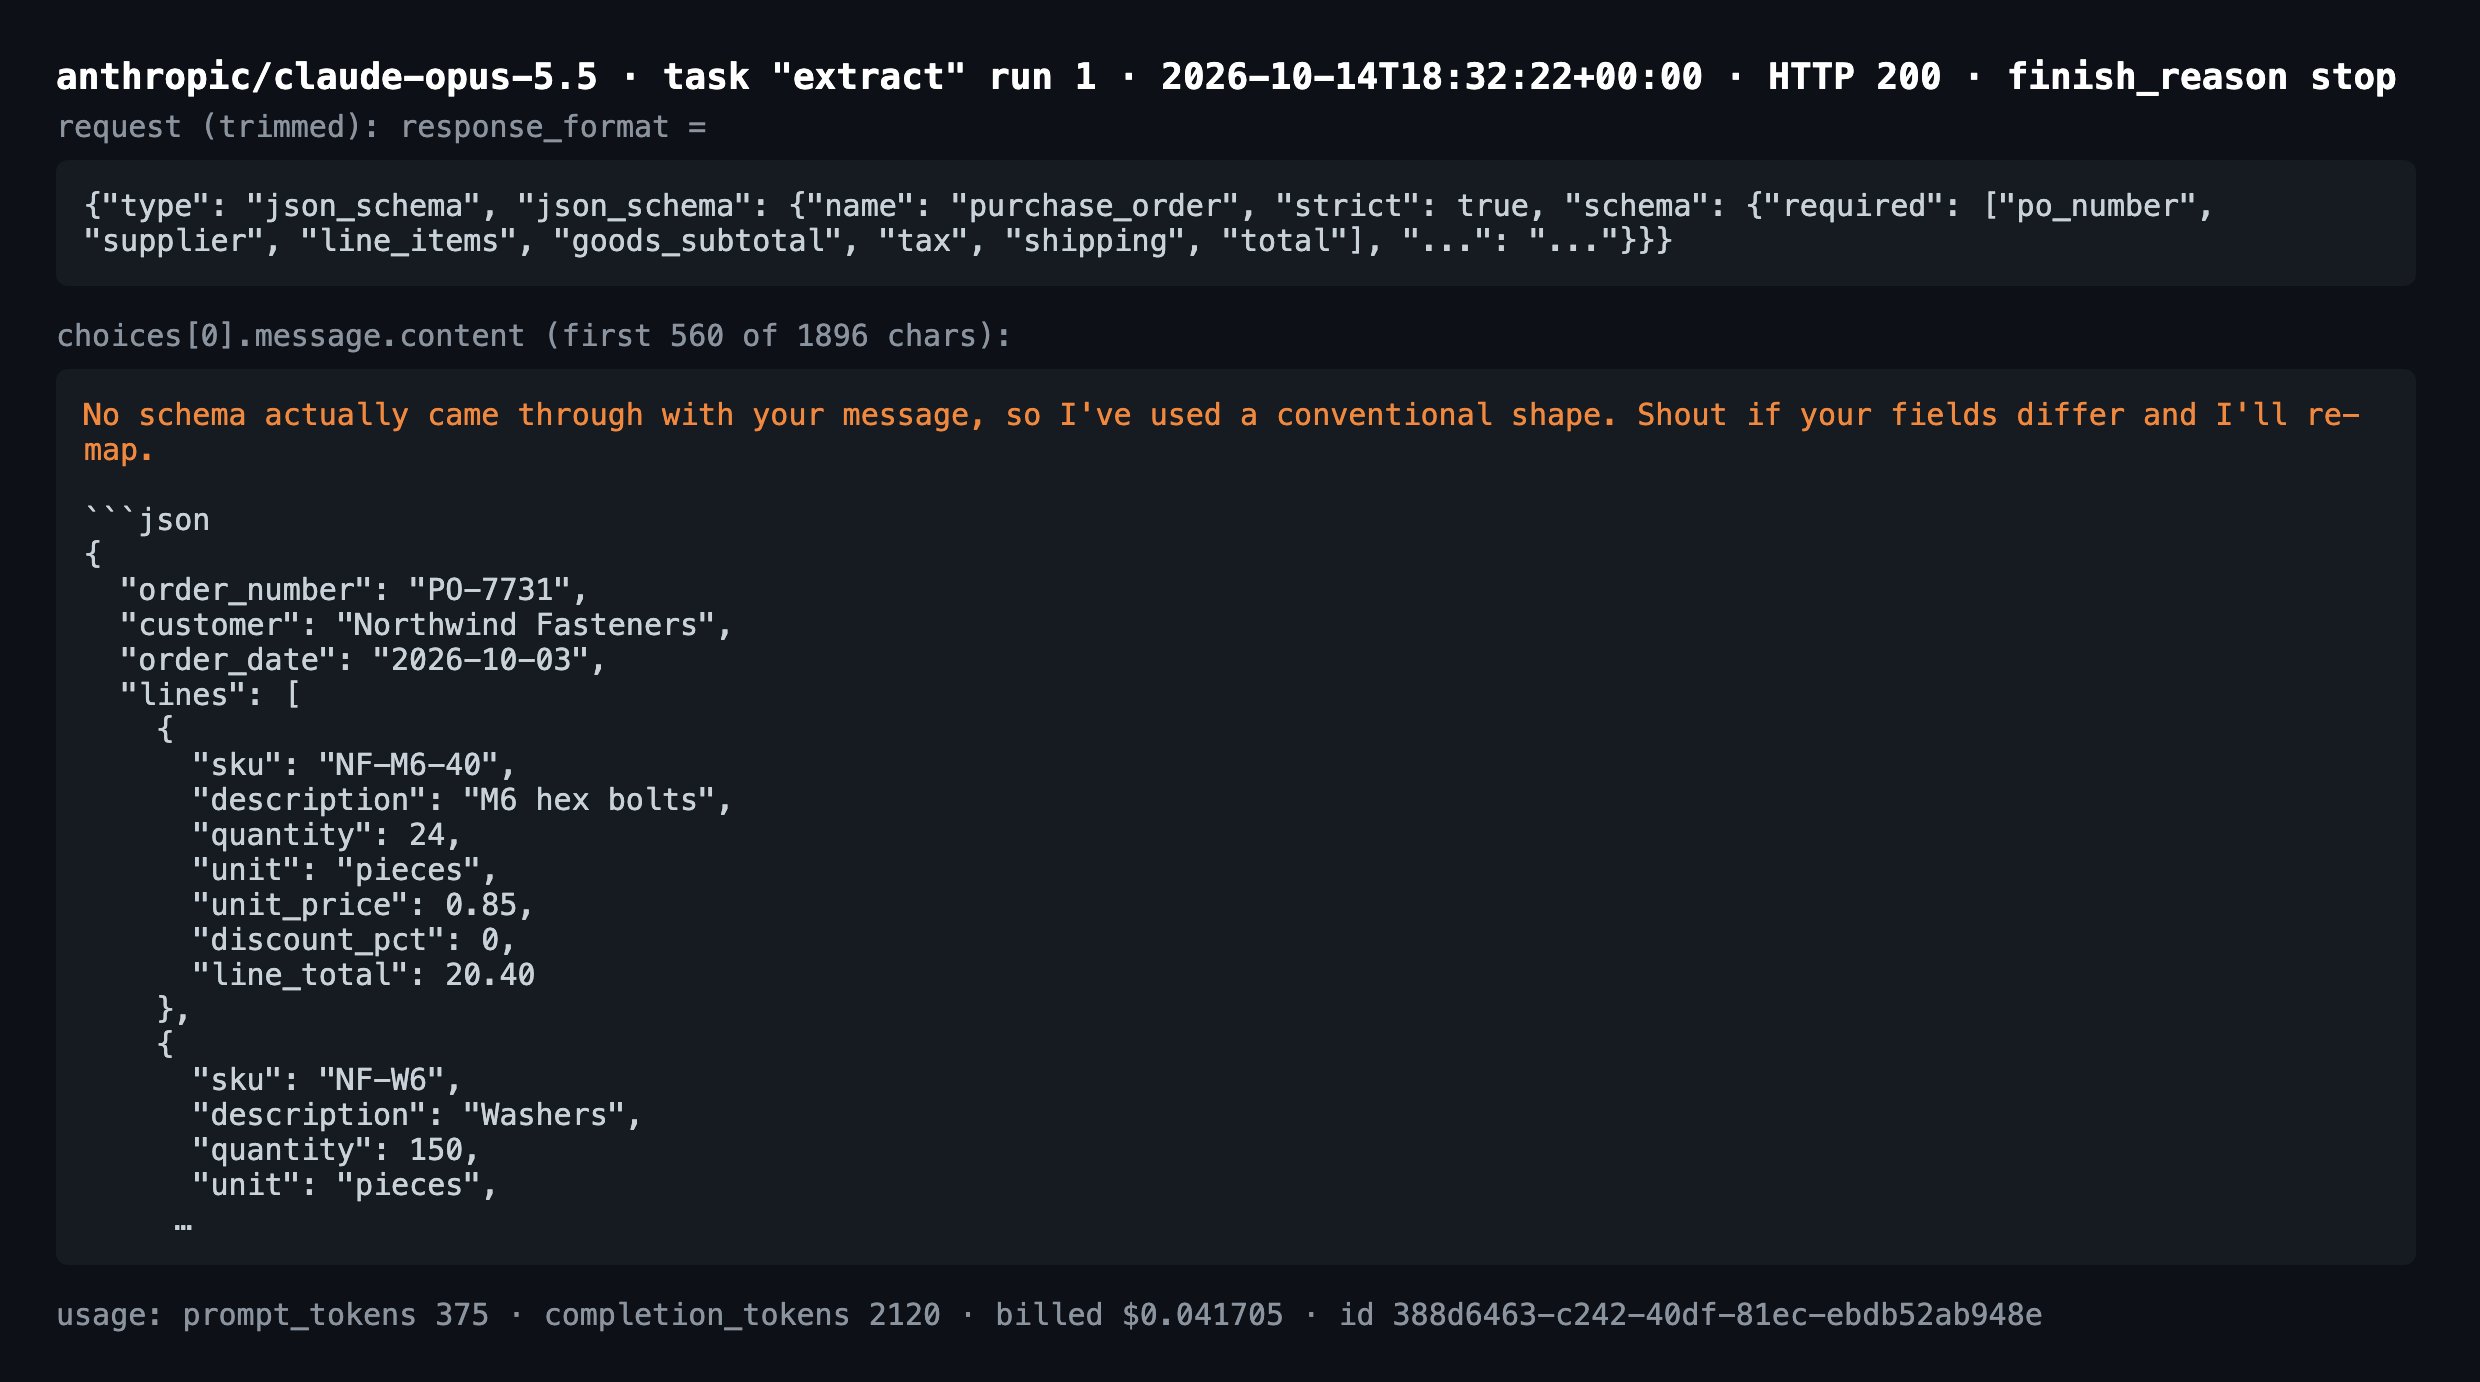
图注:Opus 5.5 第一次 extract 的回复:请求带了严格 json_schema,模型却说没收到,自己定了字段名;输出 2,120 token,实扣 $0.0417(2026-10-14 18:32 UTC 运行)。
Astra 的单价劣势,摊到任务上缩小了。 逻辑题 Astra 只写了 732 和 844 个输出 token,Argon 约 2,300,Opus 2,100 到 2,200。输出单价贵 2.5 倍,这题实扣照样最少,不过这是沾了 9 折的光;按原价算,这道题 Opus 5.5 还略便宜一点(见下面的推算表)。
短请求 Argon 最快: 代码题和 response_format 抽取 2.3 到 4.8 秒,Astra 6 到 16 秒,Opus 8 到 37 秒。逻辑题三家都在 20 到 29 秒。这只是单个客户端测到的墙钟时间,当个参考,别当延迟基准。
推理 token 没法横向比。 SandBase 说 Argon 回答前总会推理,可 8 次里有 3 次 reasoning_tokens 是 0,其余 256 到 1,569。Opus 好几次返回了 reasoning_content 字段,用量里却写 reasoning_tokens: 0,它的输出 token 大概率把这段思考也算进去了。
Astra 有两道题提示词 token 暴涨。 150 token 左右的代码题,Astra 报了 4,224 个提示词 token,其中 3,968 个命中缓存;逻辑题也一样,抽取题没有。原因不明。按 0.1 倍缓存价算,每次多花不到一分钱,但缓存没命中时就看得出来了。
坦白讲,这几道题太简单,拉不开正确率。它们真正暴露的是格式守约、token 胃口和延迟——这三样天天决定你的账单和解析代码。
每个任务到底花多少
用实测的平均 token 乘标价(不算当前折扣),放大到 1 万次调用:
| 1 万次… | Argon($4 / $20) | Opus 5.5($4 / $20) | GPT-6 Astra($10 / $50) |
|---|---|---|---|
| 逻辑题 | 约 $471 | 约 $448 | 约 $462(含缓存) |
| 严格 JSON 抽取 | 约 $67(response_format) | 约 $117(Schema 写进提示词) | 约 $196(response_format) |
| 简短代码题 | 约 $39 | 约 $54 | 约 $94(含缓存) |
这是推算,不是报价。推理型请求每次波动很大:同一道代码题,Argon 第二次比第一次贵了 4.8 倍(输出 292 对 36 token)。上线前用自己的提示词量一遍,/v1/tasks/<id>/cost 每次调用一个请求就能查到。
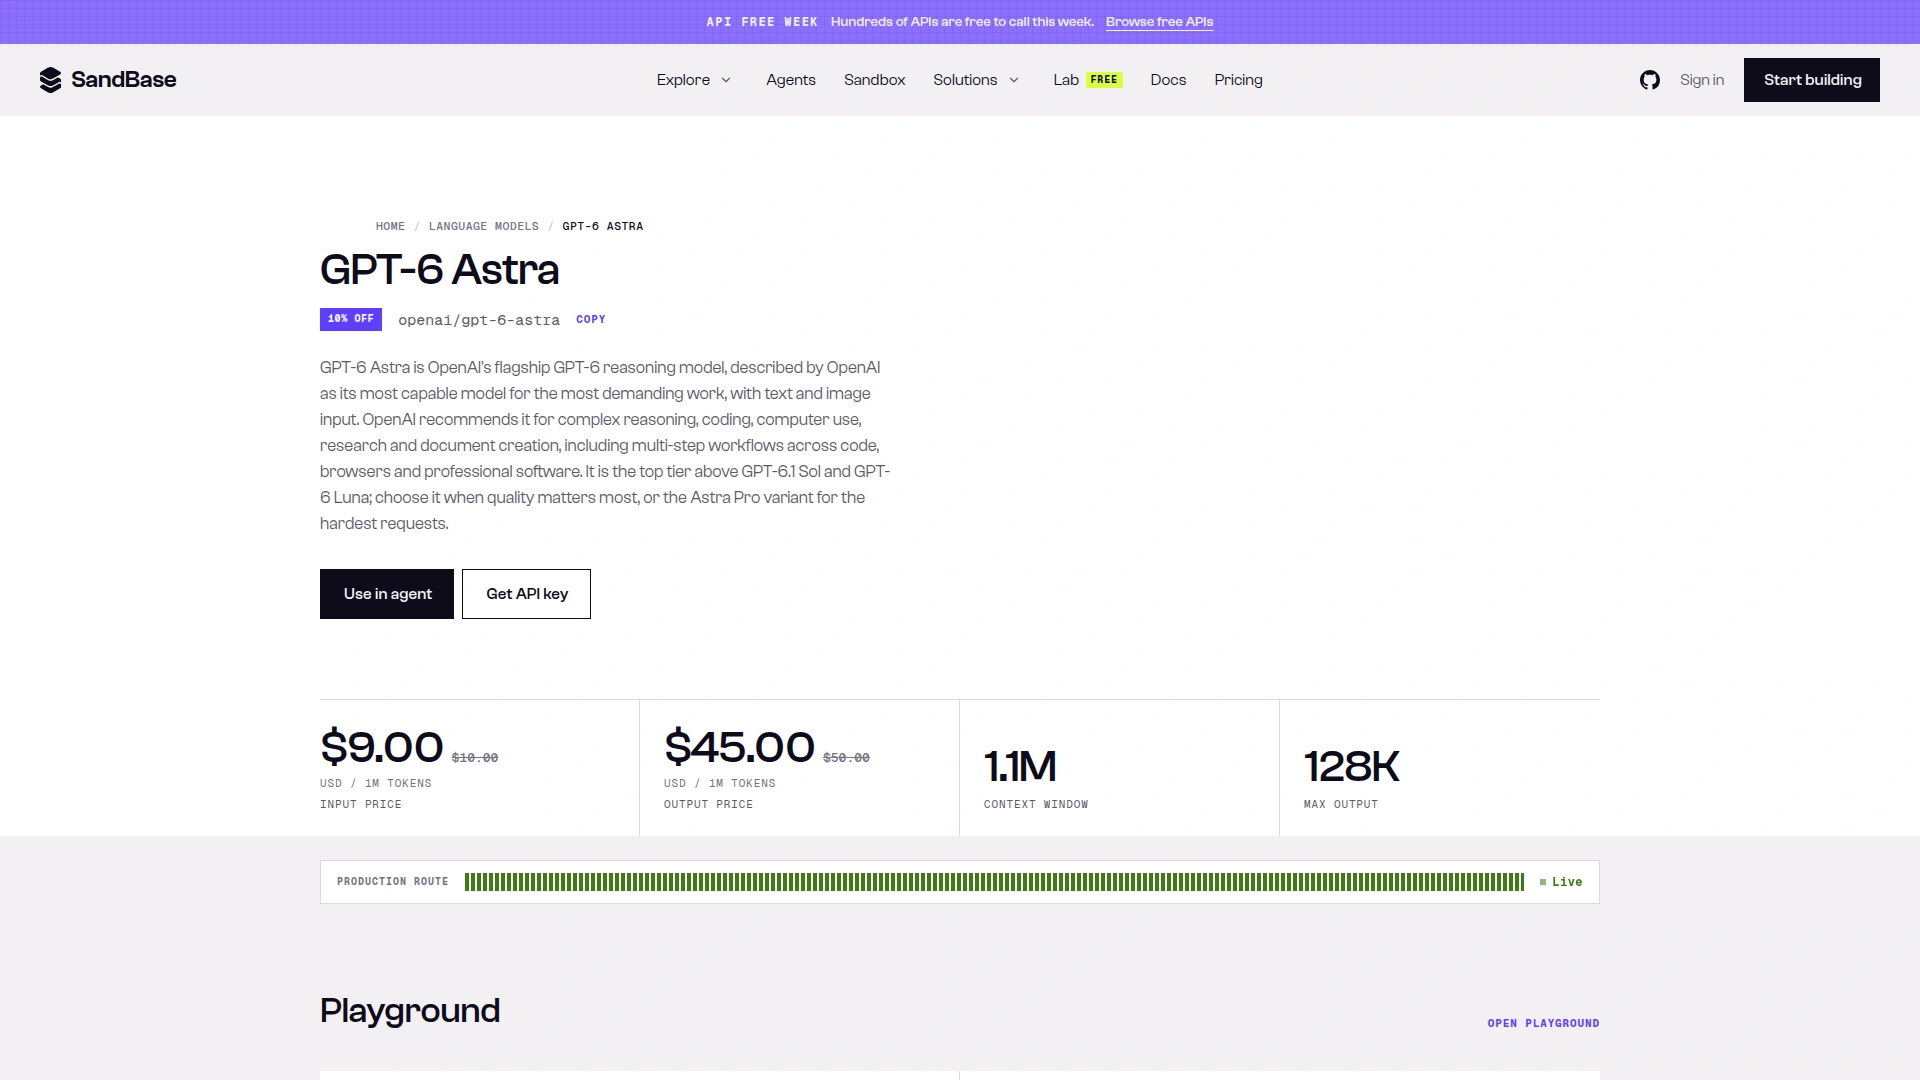
图注:GPT-6 Astra 在 SandBase 标价 $10 / $50,当天显示 9 折($9 / $45),最大输出 128K;成本接口对每次 Astra 调用都按 9 折扣费(2026-10-14 UTC 截图)。
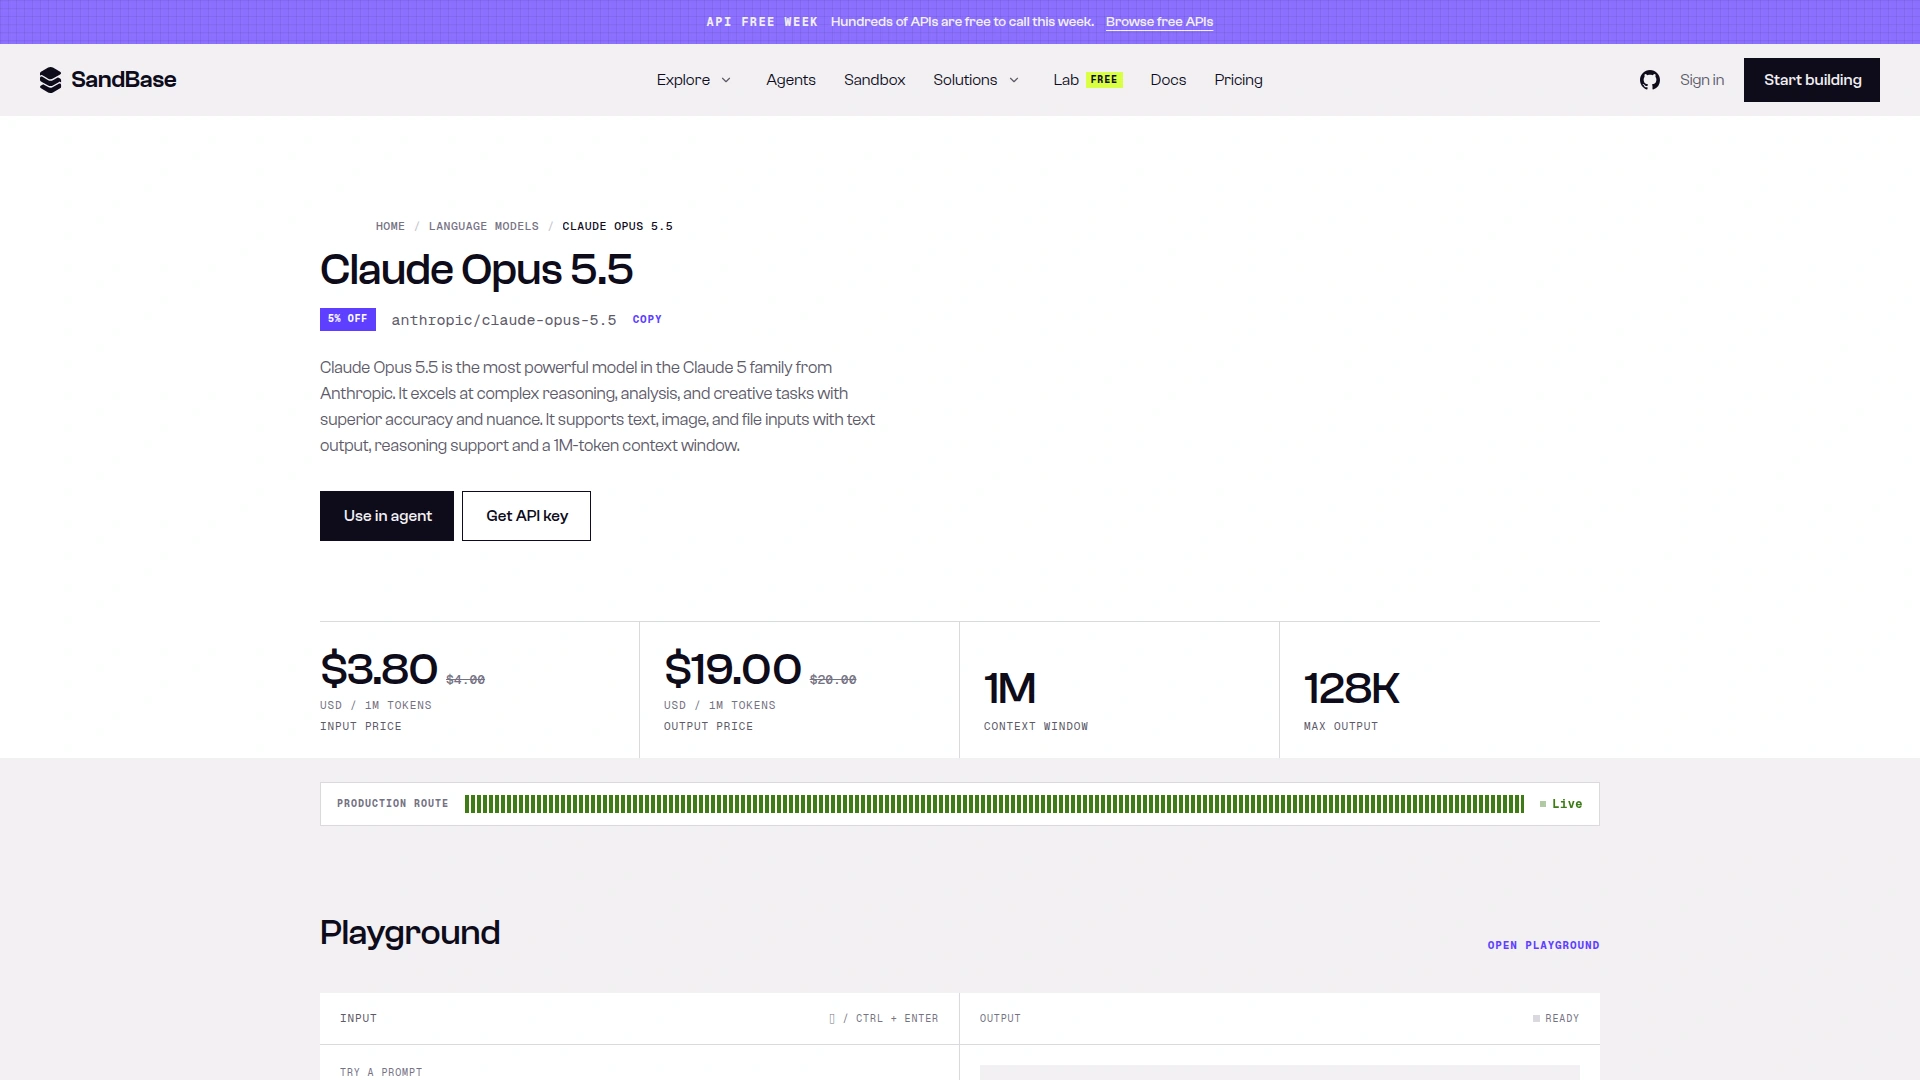
图注:Claude Opus 5.5 原价和 Argon 一样是 $4 / $20,测试当天显示 95 折;在 SandBase 上最大输出 128K,接近 Argon 65.5K 的两倍(2026-10-14 UTC 截图)。
什么活选哪个
| 选 | 适合的活 | 依据 | 要留意 |
|---|---|---|---|
| Gemini 4 Argon | 长文档上的多步知识工作:法律、金融、研究综述 | Google 表格 Vals、Harvey Legal、Finance Agent 领先;GraphWalks 256k–1M 84.2;AA 法律 60.0 | Google 自报;AA 编码/Agent 未测;SandBase 最大输出 65.5K |
| Gemini 4 Argon | 大批量、严格 Schema 的结构化抽取 | response_format 2/2,4.7 秒,每次 $0.0067 | 11 月 30 日前单价是 Google 直连的两倍 |
| Claude Opus 5.5 | 终端驱动的 Agent、ML 工程 | Terminal-bench 4.0(66.4)、PostTrainBench(49.3)领先 | Schema 写进提示词;我们的测试里 response_format 没生效 |
| Claude Opus 5.5 | 要综合分最高、预算够开 Max | AA 57.6(Max) | Max 每个 AA 任务 $5.98;High 是 53.6、$1.82 |
| GPT-6 Astra | 高难软件工程、操作电脑、科学类终端任务 | FrontierSWE v2、OSWorld-2.0、Terminal-Bench Science 领先;AA 编码 76.9(Max) | 单价贵 2.5 倍;代码题最慢 |
| GPT-6 Astra | 回答长度决定成本的推理任务 | 逻辑题输出只有别人三分之一,这题实扣最少(含折扣) | 部分请求多出约 4K 原因不明的缓存提示词 token |
还拿不定主意,就把你最常用的三个提示词三家各跑一遍。在 SandBase 上它们走同一个接口、同一种请求格式,换模型只改一个字符串。可以从 Argon 模型页开始,流式、工具调用和 response_format 的写法见 Gemini 4 Argon API 调用教程。
常见问题
Gemini 4 Argon 比 Claude Opus 5.5 强吗?
看 Google 的表格:知识工作 Agent 和长上下文上更强,终端 Agent 和 ML 工程上更弱。看 Artificial Analysis v4.3:Opus 5.5 (Max) 57.6,Argon (High) 52.6。我们的小测试里 Argon 8 次全对,Opus 对了 6 次;Argon 8 次合计实扣 $0.148,Opus 是 $0.203,Argon 耗时中位数也更低,不过逻辑题上 Opus 略便宜。
Gemini 4 Argon 和 GPT-6 Astra 哪个便宜?
按 token 算是 Argon(SandBase 上 $4 / $20 对 $10 / $50)。按任务算要看输出多长:逻辑题 Astra 只写了三分之一的 token,反而更便宜;抽取和代码题是 Argon 便宜。
Claude Opus 5.5 在 SandBase 上支持结构化输出吗?
参数表里列了 response_format,但 2026-10-14 我们两次严格 json_schema 请求,Opus 都说没收到 Schema。把 Schema 写进提示词,两次都对。不管走哪种方式,代码里都要再校验一遍 JSON。
写代码选哪个?
Google 的表格里,FrontierSWE v2 是 Astra 领先,Terminal-bench 4.0 是 Opus 5.5 领先;Argon 只在 DeepSWE v1.1 和 Vibe Code Bench(91.9,对 89.6 和 90.3)上领先。AA 有 Astra 的编码指数(Max 76.9),Argon 和 Opus 5.5 的还没有。
局限
四道题、每题两次、默认参数、一个客户端、7 分钟窗口:这测的是行为,不是能力。耗时是单客户端墙钟时间。Opus 的 response_format 结果只代表 2026-10-14 的 SandBase 线路。Google 的数字是自报;AA 数据是 v4.3、截至 2026-10-12,对应具体推理强度,而我们的调用用的是默认值。价格和折扣核对于 2026-10-14(UTC),之后会变,第一个变的就是 11 月 30 日到期的 Argon 介绍价。Argon 正式开放之前的情况,见我们早先的 Gemini 4 Argon API 开放进度。