Gemini 4 Argon 能做法律和金融工作吗:跑分对照与一次实测
Gemini 4 Argon 用在法律、金融场景靠不靠谱?对照 Google 的 Vals、Harvey 自报成绩和 Artificial Analysis 领域指数,再看我们用文本、页面图片和 PDF 跑的贷款合同条款核查实测。
想把 Gemini 4 Argon 用到法律、金融业务里,最先看到的数字多半是 19.6。这是 Google 自报的 Harvey Legal Agent 成绩,GPT-6 Astra 只有 5.4,Claude Opus 5.5 是 3.8,看上去领先了五倍。可换到第三方数据,故事就平淡多了:Artificial Analysis 的法律指数里,Argon 排第 5,Claude Opus 5.5 (Max) 在它前面。
这篇写给正在挑模型做合同审阅、贷款条款核查、财报分析这类“基于文档干活”的团队。先把 Google 的知识工作成绩和独立的领域指数放在一起对照,看哪里一致、哪里打架;再讲我们自己的测试:一份自己编的贷款协议,埋了三个坑和一个故意缺失的数字,用纯文本、页面图片、PDF 三种方式喂给 Argon,一共跑了 12 次。
先说结论
- Google 模型卡里,Argon 在 Vals Index(68.9)、Vals Finance Agent v2(65.4)、Harvey Legal Agent(19.6)上都压过 GPT-6 Astra 和 Claude Opus 5.5。这些都是 Google 自己报的,我们没有复现。
- Artificial Analysis(综合智能指数 v4.3,数据截至 2026-10-12)在法律上和 Google 一致,在金融上不一致:Gemini 4 Argon (High) 法律指数 60.0,208 行里第 5;金融与会计 53.8,并列第 13,低于 GPT-6 Astra (Max) 的 55.2 和 Opus 5.5 (High) 的 55.9。
- 我们在 SandBase 上做的贷款条款核查(2026-10-15 UTC),文本、两张页面图片、PDF 三种输入各跑 3 次,9 次全部 17 项检查通过,包括把两个文档里没有的数字如实返回 null。单次费用 $0.013 到 $0.026。
- 把 schema 里的 null 选项去掉之后,3 次里 Argon 都把缺失的 RCF 总额度填成了
0,只在备注文字里交代了原因。“查不到”能不能保住,取决于你的 schema 怎么写。- Google 宣传的是 1M 输入输出合计上限。SandBase 页面上显示 1M 上下文、单次最多输出 65.5K,价格每百万 token $4 / $20。
从知识工作的角度看 Gemini 4 Argon
Argon 是 Google DeepMind 的第一个 Gemini 4 模型,2026 年 10 月 13 日正式开放。按模型卡的说法,它是稀疏 MoE 架构,输入支持文本、图片、音频、视频,输出文本,输入加输出合计最长 1M token,知识截止 2026 年 3 月。Google 的发布文章开头就打了 Vals Index 第一这张牌。
跟文档类工作相关的几项:
| 项目 | 数值 | 来源 |
|---|---|---|
| SandBase 模型 ID | google/gemini-4-argon | SandBase 模型 API,2026-10-15 |
| 输入 | 文本、图片、音频、视频(SandBase 页面另列 PDF) | 模型卡;SandBase 模型页 |
| 上下文 | Gemini API 下输入输出合计 1M | Google 发布文章 |
| SandBase 单次最大输出 | 65.5K token | SandBase 模型页 |
| 知识截止 | 2026 年 3 月 | 模型卡 |
| SandBase 价格 | 每百万 token 输入 $4 / 输出 $20,缓存读取 0.05 倍 | SandBase 模型 API |
| Google 直连价格 | 11 月 30 日前 $2 / $10,之后 $4 / $20 | Google 发布文章脚注 |
| 已知局限 | 幻觉;偶尔变慢或超时 | 模型卡 |
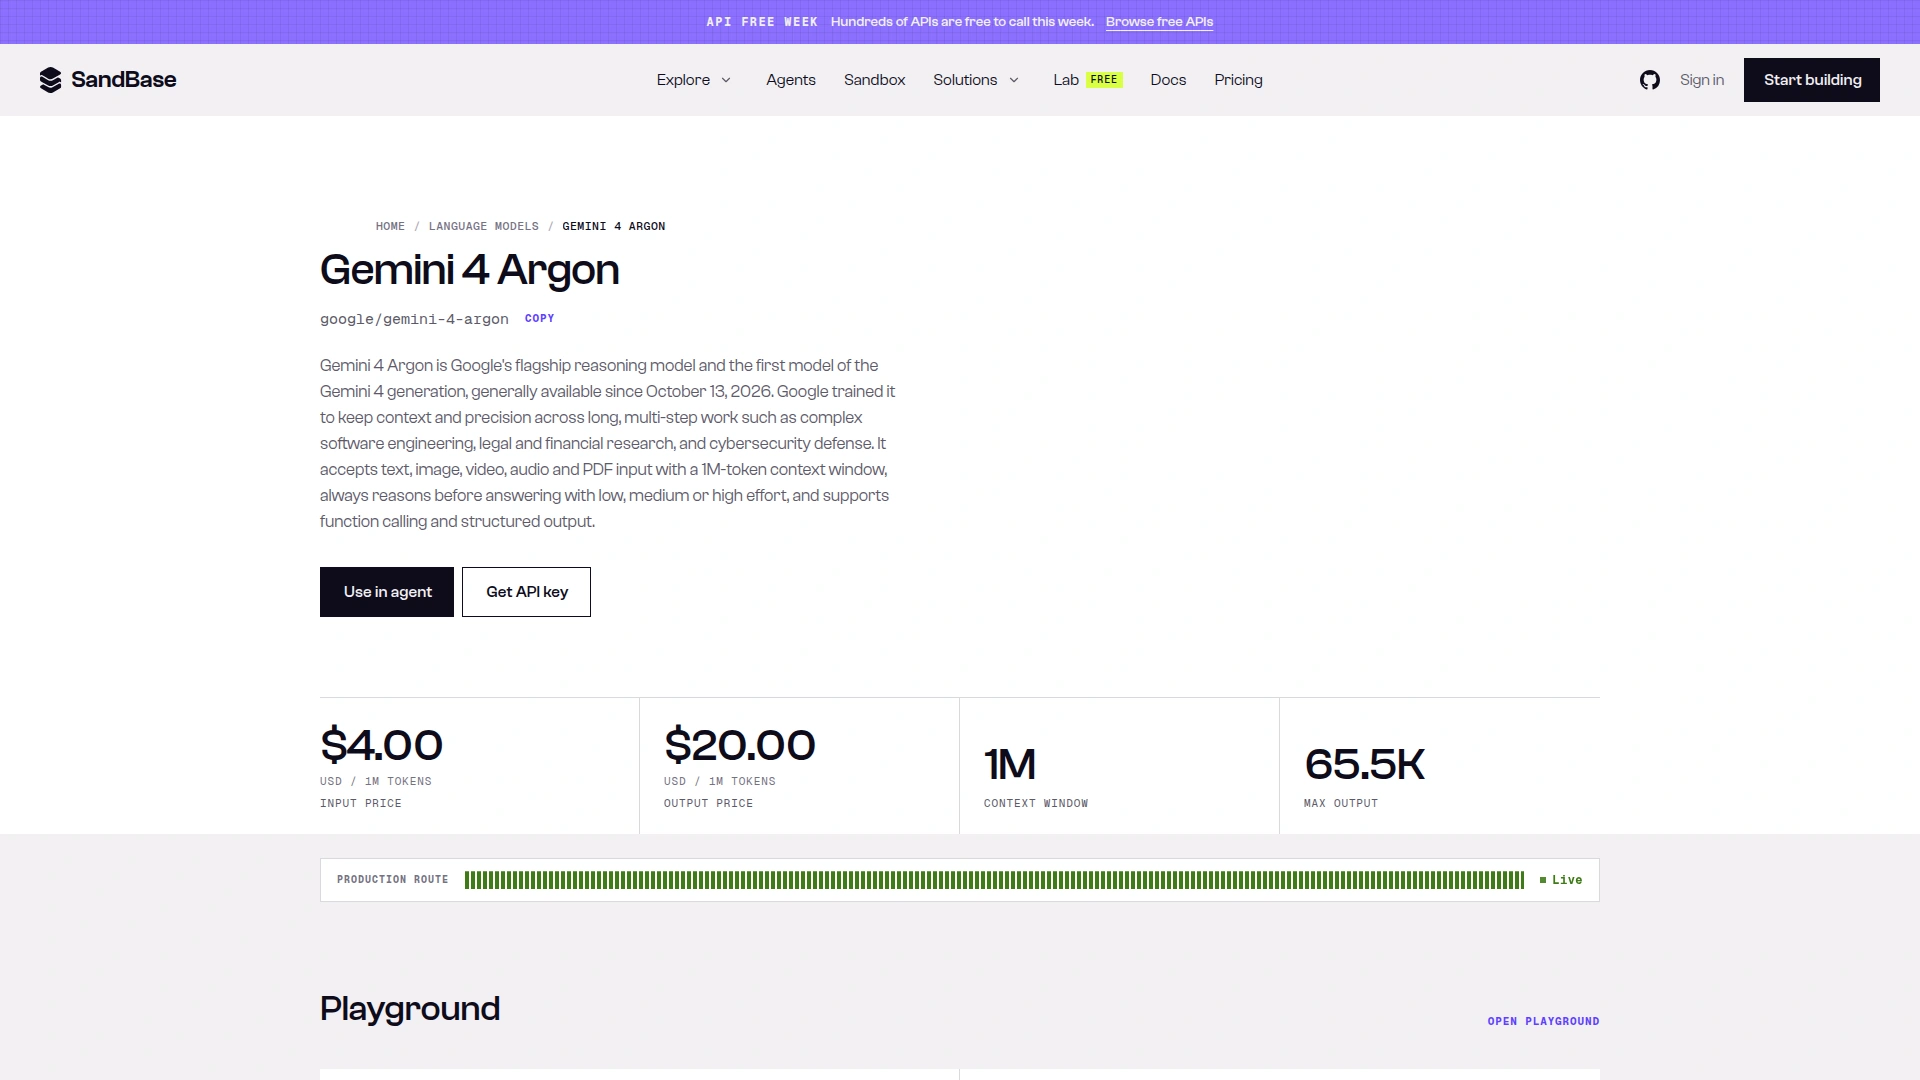
图注:SandBase 的 Argon 页面写明支持 PDF 输入、1M 上下文、单次最多输出 65.5K,下面所有测试都受这些限制约束(2026-10-15 UTC 截图)。
价格这点直说:SandBase 的 $4 / $20 是 Google 直连介绍价的两倍,这个差价持续到 11 月 30 日。文档量大的任务具体怎么算,看我们的 Gemini 4 Argon 价格指南。
Google 自报的知识工作成绩
Google 表格里有四行跟写代码无关,测的是专业工作。数字全部来自 Google,题目也是 Google 选的。
| 基准(Google 自报) | Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68.9 | 63.1 | 65.8 | 67.0 |
| Vals Finance Agent v2 | 65.4 | 53.5 | 58.9 | 58.6 |
| Harvey Legal Agent | 19.6 | 5.4 | 6.7 | 3.8 |
| AutomationBench | 51.3 | 41.4 | 31.4 | 42.5 |
细看差距:Vals Index 比 Opus 5.5 只高 1.9 分;Finance Agent 比第二名 Fable 5.1 高 6.5 分;流程自动化的 AutomationBench 比 Opus 5.5 高 8.8 分,我们手上没有对应的第三方数据。
Harvey Legal Agent 是个特例。所有模型分数都很低,最高也不到 20,说明这套题非常难,13 分的差距可能就是多做对了几道题。我更愿意把它理解成“Argon 在一套很难的法律 Agent 任务里完成得更多”,而不是“Argon 懂法律是别人的五倍”。另外,我们没有去 Vals 和 Harvey 自己的榜单上核对这些数字。
第三方数据怎么说
Artificial Analysis(下称 AA)除了综合分,还发布分领域指数,其中两个正好对上这篇的问题。我们用的是免费层快照,综合智能指数 v4.3,数据截至 2026-10-12。排名按“有分数的行”算,一行是一个模型加一个推理档位,所以同一个模型可能占好几个名次。AA 测的是 Gemini 4 Argon (High)。
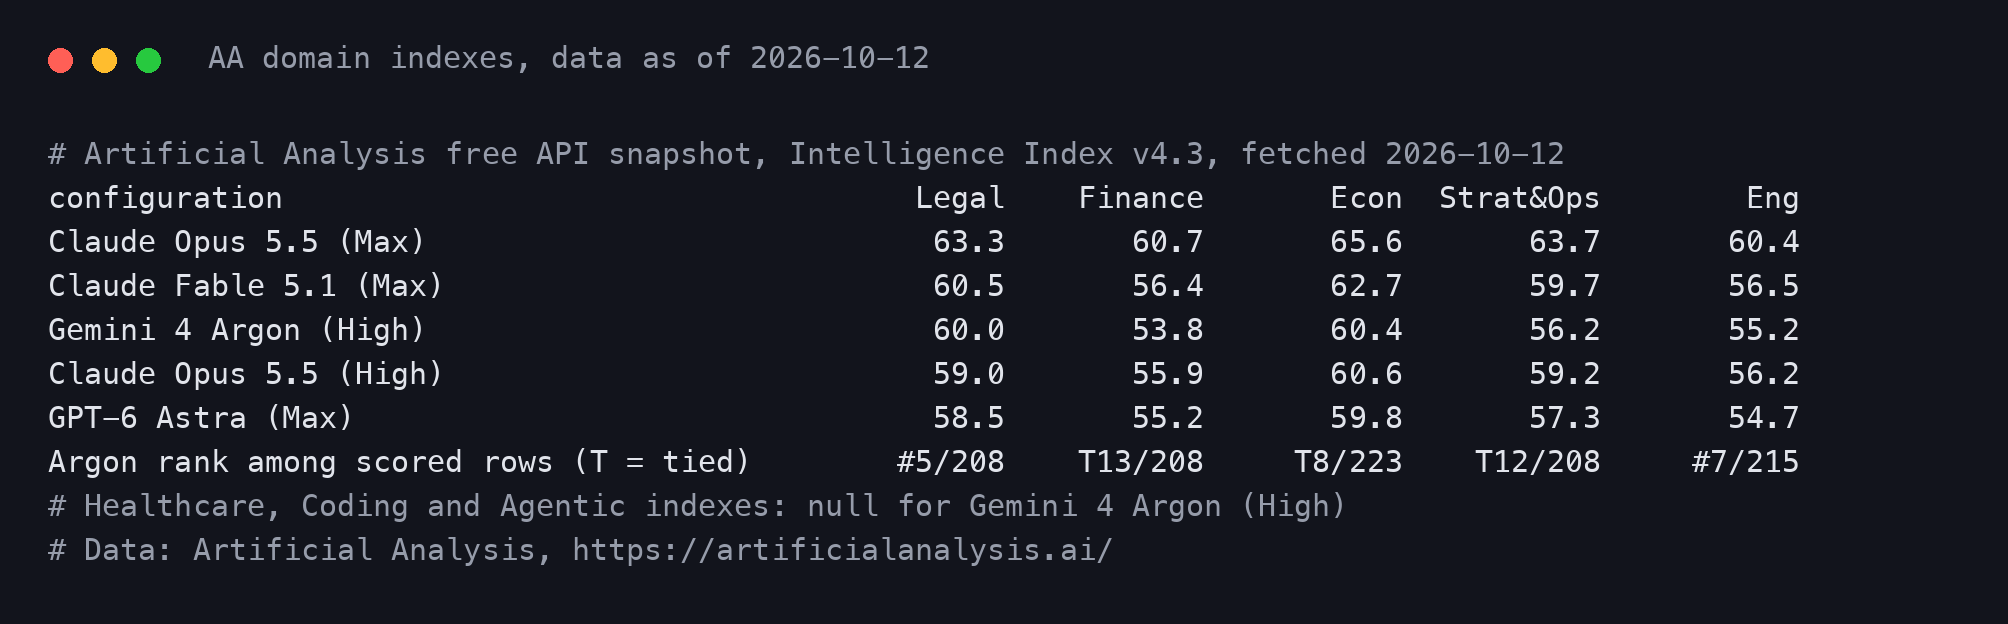
图注:直接从 AA 快照文件渲染。法律和经济上 Argon 接近头部,金融与会计却落后于 Opus 5.5 (High) 和 GPT-6 Astra (Max)。数据来源:Artificial Analysis,截至 2026-10-12。
| AA 领域指数 | Argon (High) | 在有分数的行中排名 | 最高分 |
|---|---|---|---|
| 法律 | 60.0 | 208 行中第 5 | Claude Opus 5.5 (Max),63.3 |
| 经济 | 60.4 | 223 行中并列第 8 | Claude Opus 5.5 (Max),65.6 |
| 工程 | 55.2 | 215 行中第 7 | Claude Opus 5.5 (Max),60.4 |
| 战略与运营 | 56.2 | 208 行中并列第 12 | Claude Opus 5.5 (Max),63.7 |
| 金融与会计 | 53.8 | 208 行中并列第 13 | Claude Opus 5.5 (Max),60.7 |
| 医疗 | 未测 | — | — |
综合分怎么算,见 AA 的方法说明。完整的总榜排名在我们的 Gemini 4 Argon 跑分排名里。
两边哪里一致,哪里打架
法律:方向一致,差距小得多。 两边都认为 Argon 强过同档位的 GPT-6 Astra 和 Opus 5.5。AA 上 Argon 60.0,Opus 5.5 (High) 59.0,Astra (Max) 58.5。但 Opus 5.5 开到 Max 是 63.3,Opus 5.5 (Xhigh) 和两个 Fable 5.1 档位也比它高 0.5 到 0.8。第三方数据支持“Argon 是法律第一梯队”,不支持“领先五倍”,也没把它排第一。
金融:两边说法相反。 Google 说 Argon 在 Vals Finance Agent v2 上领先 Astra 12 分;AA 的金融与会计指数里,Astra (Max) 反而高 1.4 分,Opus 5.5 (High) 高 2.1 分。两者测的东西不一样:Finance Agent 是带工具、多步调研的 Agent 任务,AA 的指数是题库组合。一个模型完全可能擅长跑金融调研流程,却在直接答会计题上弱一点。如果你的活更像后者,AA 的数字更有参考价值。
战略和经济:有竞争力,但不领先。 经济并列第 8,战略与运营并列第 12。
医疗:没有第三方数字。 AA 还没出 Argon 的医疗指数。
我们的测试:一份文档里的条款核查
跑分是在你管不着的题目上取平均。我想知道的更具体:给一份像模像样的法律金融文档,Argon 能不能严格按定义算、能不能注意到修订函、找不到的数字会不会老实说“没有”。
我写了一份虚构的贷款协议摘录(公司、银行、数字全是编的):定义条款、两个财务约束条款、利率调档条款、控制权变更条款、一封修订函,再加十二个月的合规数据。里面埋了三个坑:
- 非经常性项目是 4,500,但 EBITDA 定义规定加回额不超过加回前 EBITDA 的 10%,所以只能加 3,580。
- 银行存款 26,200,其中 3,700 在托管账户里,按“非限制现金”的定义要剔除。
- 原杠杆上限是 3.50 倍,修订函把 2026 年 12 月 31 日前的测试日放宽到 3.75 倍。算出来是 3.61,漏看修订函就会判成“违约”。
另外,提示词还要两个文档里根本没有的值:适用法律,以及循环贷款(RCF)总额度(文档只给了已提款金额)。
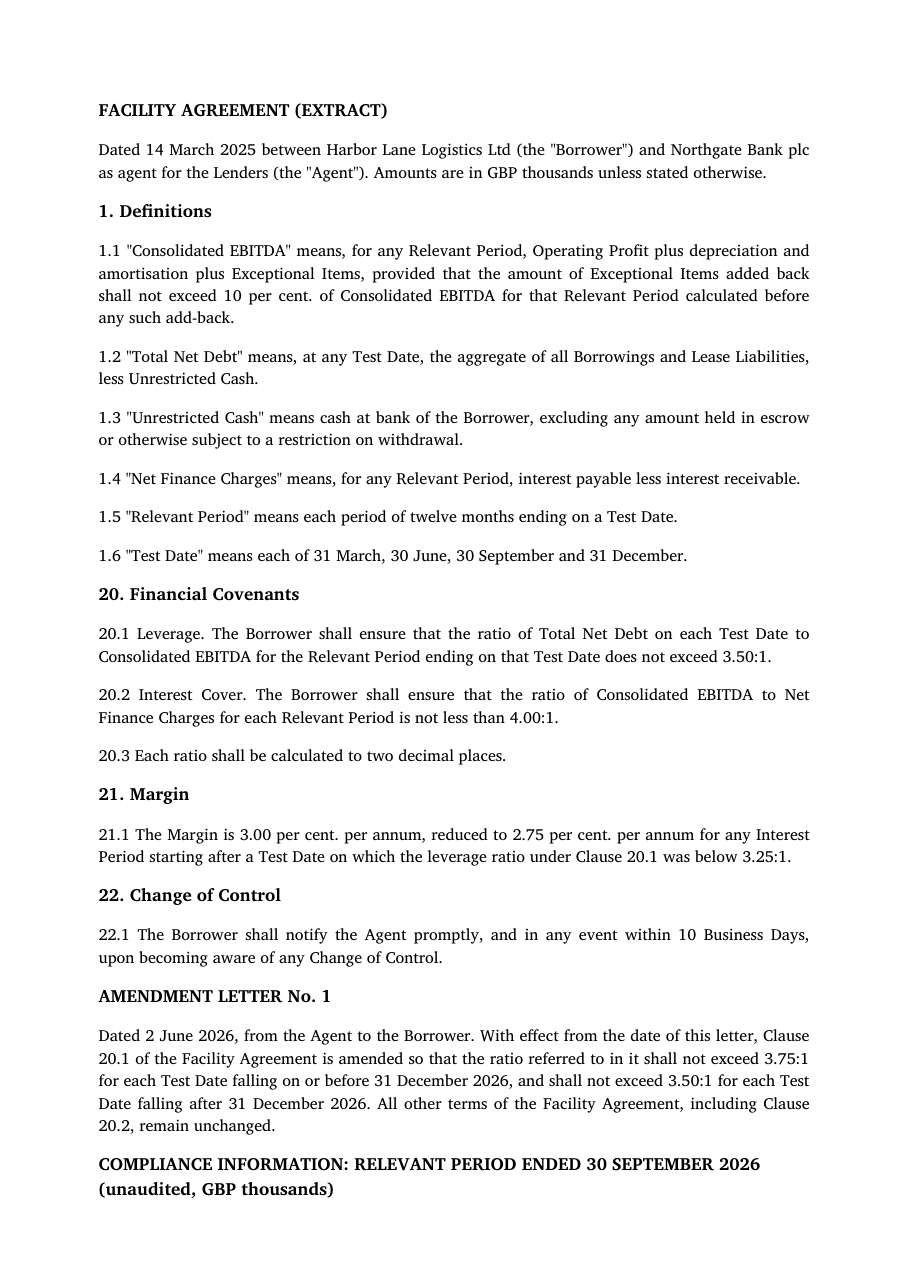
图注:我们为测试编写的虚构文档第 1 页,图片模式下就是把这样的页面发给模型;EBITDA 上限、托管资金剔除和修订函就是三个坑(2026-10-15 渲染)。
标准答案由脚本算出:合并 EBITDA 39,380;非限制现金 22,500;净债务 142,300;杠杆 3.61,上限 3.75,合规;利息覆盖 5.71,合规;下一计息期利率维持 3.00%;控制权变更通知期限 10 个工作日;适用法律和 RCF 总额度为 null 并列入 not_found。评分脚本共查 17 个字段。
调用方式:SandBase 的 OpenAI 兼容 Chat Completions 接口,模型 google/gemini-4-argon,max_tokens: 16000,用严格的 response_format JSON Schema,两个查不到的字段允许 null。没有传推理档位参数:SandBase 的描述说 Argon 总会先推理,但 reasoning_tokens 经常报 0,我没法确认档位参数真的起作用。三种输入方式各跑 3 次:
text:文档原文直接贴进提示词。image:两页 PNG 渲染图,作为image_url发送,不附文字版。pdf:PDF 以 OpenAI 风格的file内容块发送(base64 data URL)。
费用取自 GET /v1/tasks/<completion id>/cost 返回的 cost 字段。
结果:三种输入,9 次全对
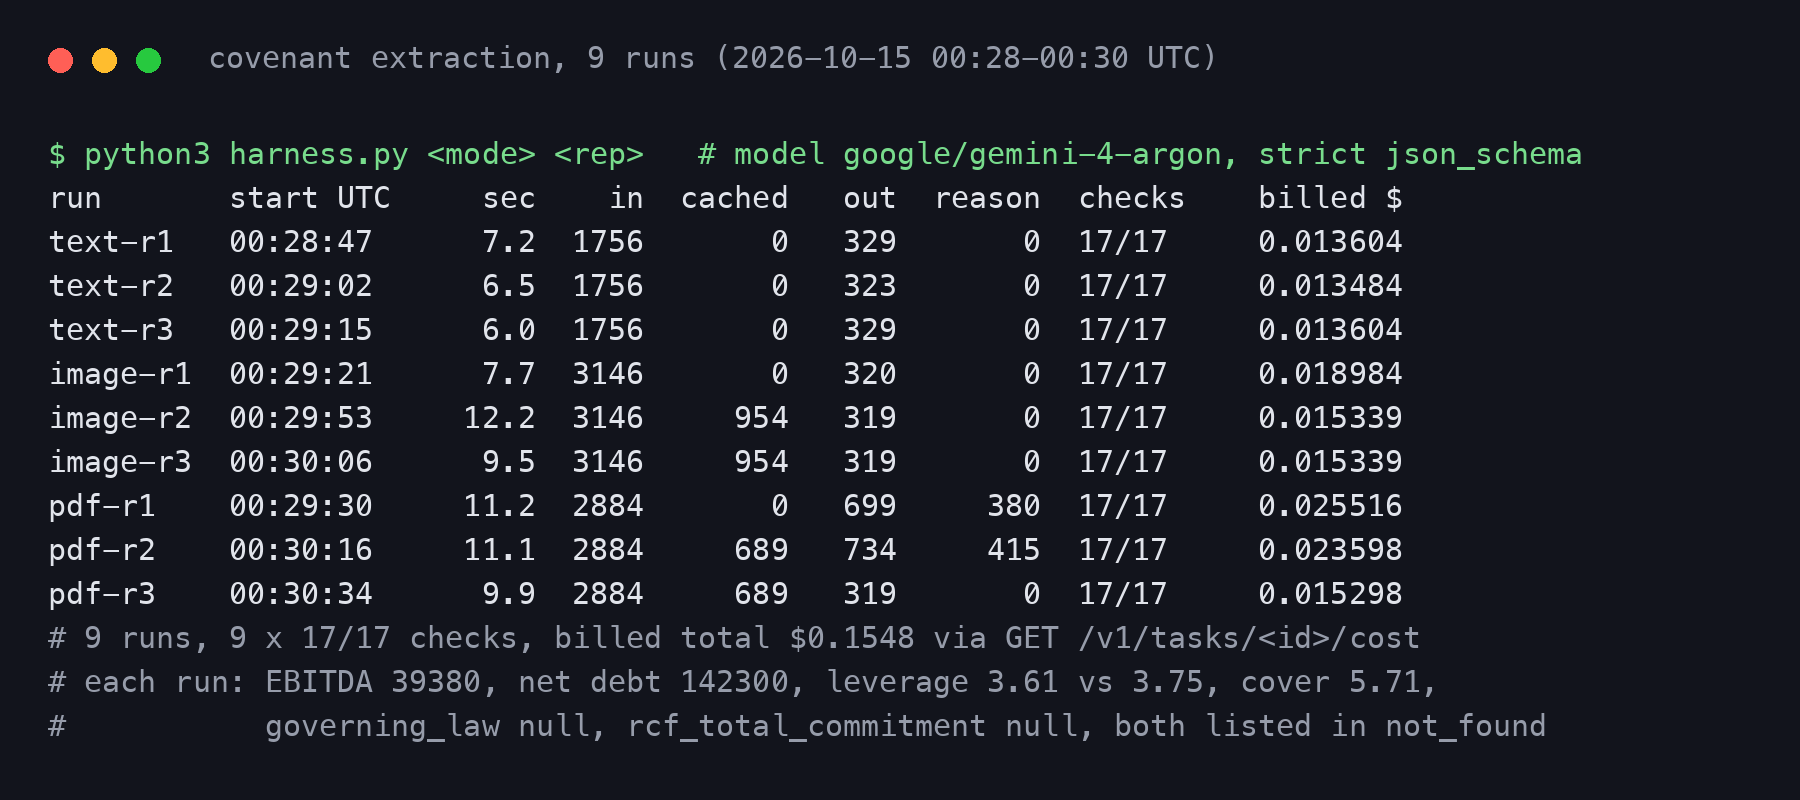
图注:根据保存的调用记录渲染的全部 9 次结果:每次 17 项全部通过,PDF 线路可用,9 次合计按 /v1/tasks/<id>/cost 计费 $0.155(2026-10-15 UTC 运行)。
| 输入方式 | 正确 | 输入 token | 输出 token | 耗时 | 单次费用 |
|---|---|---|---|---|---|
| 文本 | 3/3 | 1,756 | 323–329 | 6.0–7.2 秒 | $0.0135–$0.0136 |
| 图片(2 页) | 3/3 | 3,146(第 2、3 次缓存 954) | 319–320 | 7.7–12.2 秒 | $0.0153–$0.0190 |
| 3/3 | 2,884(第 2、3 次缓存 689) | 319–734 | 9.9–11.2 秒 | $0.0153–$0.0255 |
几点观察:
- 每次都正确处理了加回上限、剔除了托管资金、用了修订后的 3.75。两个缺失值每次都返回
null并写进not_found。source_clauses引用的条款也对,包括“Amendment Letter No. 1”和“Note 4”。 - PDF 通过
file内容块在这条线路上能用。 - 同样的内容,页面图片的输入 token 大约是纯文本的 1.8 倍(3,146 对 1,756)。手上已经有干净文本的话,直接发文本。
- 图片和 PDF 重复调用时,自动出现了缓存 token,按 0.05 倍计费;文本那三次没有缓存。触发门槛是多少,我不清楚。
- 只有两次 PDF 调用报了推理 token(380 和 415),也正是最贵的两次,其余都是 0。
测试范围说在前面:这只是一份两页的短文档。300 页的授信协议、跨文档对账、扫描质量差的 PDF,这次都没测到。
真正踩坑的地方:schema 没给“查不到”留位置
前 9 次全过之后,我改了一个很多真实流水线都会写错的地方。文档、问题都不变,只是 schema 里每个字段都不许为空:rcf_total_commitment 必须是数字,governing_law 必须是字符串,去掉 not_found 列表,提示词里“查不到就返回 null”那条规则也删了,另加一个自由文本的 notes 字段。
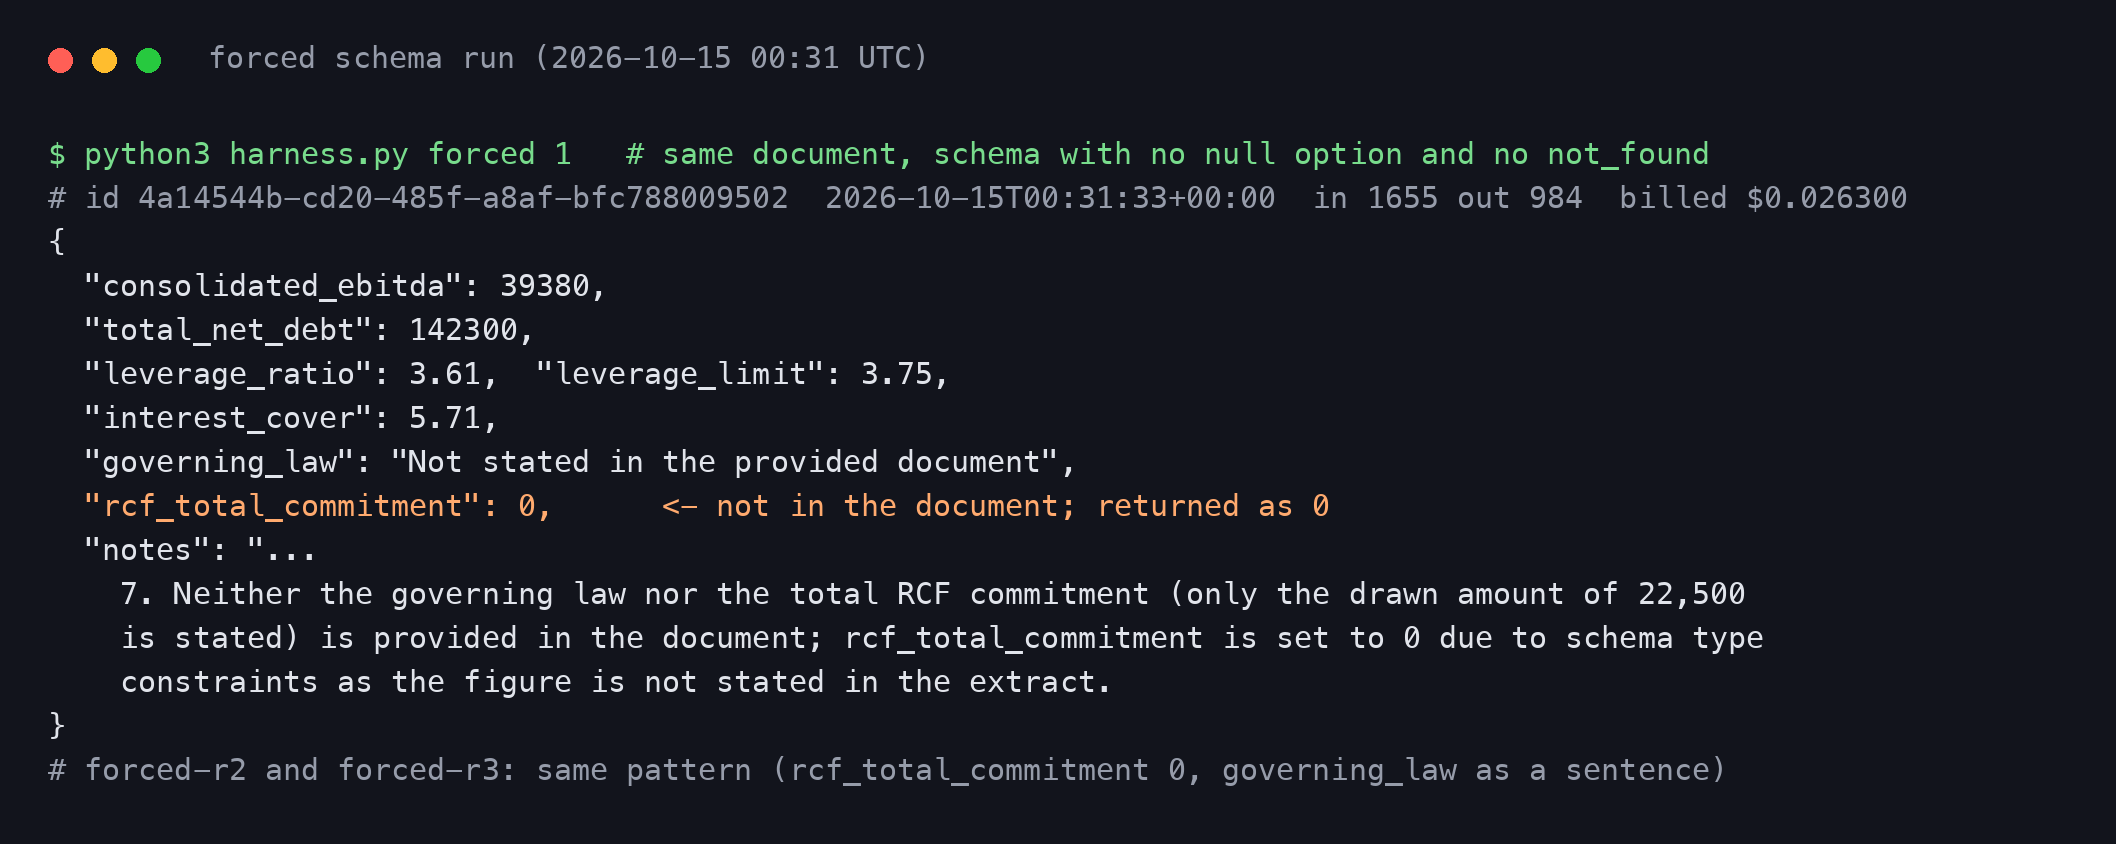
图注:没有 null 可选时,Argon 计算的数字依旧全对,但把文档里不存在的 RCF 总额度填成了 0,原因只写在 notes 里;3 次都是这样,单次 $0.023 到 $0.026(2026-10-15 UTC 运行)。
3 次里,15 个计算字段全部正确;但 rcf_total_commitment 每次都是 0,governing_law 变成一句话(两次是“Not stated in the provided document”,一次是“Not stated in document”)。模型在 notes 里交代得很清楚,可下游系统只读数字字段的话,就会记下一笔“额度为 0 英镑的循环贷款”。说白了,模型已经告诉你了,是你写的 schema 逼它填了占位值。
对法律、金融流水线的建议:每个要抽取的字段都留 null,再加一个 not_found 列表,并在代码里校验该空的字段确实为空。有这个出口时,Argon 用得很到位。
长篇多模态文档:哪些验证过,哪些没有
Google 说的 1M 上限是输入加输出合计。SandBase 页面显示 1M 上下文,单次最多输出 65.5K。我用一句话的提示词配 max_tokens: 100000 发了一次,返回 200、没有报错;但只输出了 5 个 token,看不出上限是被强制执行还是被静默截断。规划时按单次 65.5K 输出算。
如果是 1M token 的数据室,账单主要在输入:按 SandBase 的价格,满上下文一次约 $4,同一批文档反复提问时缓存读取 0.05 倍能省不少。Google 自报 GraphWalks 256k–1M 得 84.2,高于 Astra(71.8)和 Opus 5.5(66.8),不过它测的是图遍历,不是条款检索。这篇没有测任何长文档。图片和文件输入的 Python 写法见 Argon API Python 调用教程。
法律、金融工作该不该用 Argon
| 你的任务 | 适配程度 | 依据 |
|---|---|---|
| 合同审阅、条款抽取、财务约束核查 | 值得优先试 | AA 法律第 5;Google 的 Harvey 领先;我们测试 9/9 |
| 带工具的金融调研 Agent | 可以试,需验证 | Google 的 Finance Agent 领先,暂无第三方佐证 |
| 直接问答式的会计、金融问题 | 先对比 | AA 金融并列第 13,落后 Opus 5.5 (High) 和 Astra (Max) |
| 不计成本要最高法律分 | 看 Opus 5.5 (Max) | AA 法律 63.3 对 60.0 |
| 医疗、临床文档 | 未知 | AA 没有 Argon 的医疗指数 |
| 长输出(完整修订稿、长备忘录) | 注意上限 | SandBase 单次最多输出 65.5K |
想看它和 Opus 5.5、Astra 在成本和格式遵循上的正面对比,见 Gemini 4 Argon、Claude Opus 5.5 和 GPT-6 Astra 对比。想拿自己的文档试,从 Argon 模型页开始;第三方分数也能在 SandBase Lab 评测页查到。
常见问题
Gemini 4 Argon 适合做法律工作吗?
第一梯队,但不是第一。AA 法律指数 60.0,208 行中第 5(2026-10-12),落后 Claude Opus 5.5 (Max) 的 63.3。Google 自报的 Harvey Legal Agent 领先幅度要大得多。
Gemini 4 Argon 适合金融和会计吗?
说法不一。Google 说它在 Vals Finance Agent v2 上第一(65.4);AA 的金融与会计指数里它是 53.8,208 行中并列第 13,低于 GPT-6 Astra (Max) 和 Opus 5.5 (High)。最好用自己的任务类型测一下。
在 SandBase 上 Gemini 4 Argon 能读 PDF 吗?
2026-10-15 我们实测可以:两页 PDF 以 file 内容块发送,3 次都返回了正确的结构化结果。页面图片也能用,只是输入 token 约为纯文本的 1.8 倍。
Gemini 4 Argon 处理文档会有幻觉吗?
Google 模型卡把幻觉列为已知局限。我们的测试里,只要 schema 允许,它都把缺失值如实返回 null;schema 不允许时,它填了 0。输出要在代码里校验,重要的结论要有人复核。
局限
一份两页的虚构文档,12 次评分调用加 1 次探测,单一客户端,2026-10-15 UTC 00:28 到 00:32 的四分钟窗口。本文 Argon 总花费约 $0.23。Google 的跑分是 Google 自报;AA 数据是 v4.3、截至 2026-10-12、High 档位,我们的调用用的是默认设置。本文不构成法律或财务建议,任何模型输出都不能替代专业人士的审核。Argon 正式开放之前的情况,可以看我们更早的接入记录。