Gemini 4 Argon 跑分排名:第三方榜单上到底排第几
Gemini 4 Argon 跑分排名怎么看:Artificial Analysis v4.3 综合智能指数 687 行里排第 8,法律、工程等领域指数排名,编码和速度还没测,以及跑一遍指数的成本和 Google 自报数据的差别。
这周搜 Gemini 4 Argon 跑分排名,会看到三个说法:Google 官方说它在 Vals Index 上排第一;Artificial Analysis 上 Gemini 4 Argon (High) 排第 8;SandBase Lab 的排行榜上它又是第 5。三个都没错,只是数的东西不一样。真要拿它干活,搞清楚这层差别比记住哪个名次更有用。
这篇只回答一个问题:把 Google 自己的表格放一边,Argon 在第三方榜单上到底什么水平。数据用的是 Artificial Analysis(下称 AA)免费 API 的快照,综合智能指数 v4.3,数据截至 2026-10-12。适合已经看过发布会数字、准备花时间评测之前想先找个独立参照的开发者和采购方。
先说结论
- AA 综合智能指数 v4.3(数据截至 2026-10-12)里,Gemini 4 Argon (High) 得 52.6 分,在 687 个有分数的行里排第 8。这里一行是“模型 × 推理档位”,按模型去重的话,它前面只有四家:Claude Opus 5.5、Claude Sonnet 5.5、Claude Fable 5.1 和 GPT-6 Astra。
- 领域指数里最强的是法律:60.0 分,208 行里排第 5;工程 215 行里第 7。最弱的是金融与会计,53.8 分,和另外两行并列第 13。
- AA 还没给 Argon 出编码、Agent、医疗指数,也没有输出速度和首 token 时间,快照里这些字段都是空的。现在谁说“第三方编码跑分”,来源都不是 AA。
- 按 Google 的介绍价 $2 / $10 算,跑完整个指数每题 $1.99。11 月 30 日之后改按 $4 / $20(SandBase 现在就是这个价),同样的 token 大约每题 $3.98。
- Google 模型卡 19 行里 Argon 有 14 行第一,但那是 Google 自己选题、自己跑的。AA 的综合分认可它是第一梯队,不认可它是第一名。
Gemini 4 Argon 在 Artificial Analysis 上的排名
下面是快照里综合智能指数前 12 行,原样取自 AA 免费 API 在 2026-10-12(meta.fetched_at 07:34 UTC)返回的数据。“每题成本”是 AA 按各模型当时的标价跑完整个指数后折算的。数据来源:Artificial Analysis。
| 名次 | AA 测的配置 | 厂商 | 综合智能指数 v4.3 | 每题成本 |
|---|---|---|---|---|
| 1 | Claude Opus 5.5 (Max, Default Fallback) | Anthropic | 57.6 | $5.98 |
| 2 | Claude Opus 5.5 (Xhigh, Default Fallback) | Anthropic | 56.0 | $3.46 |
| 3 | Claude Sonnet 5.5 (Max, Default Fallback) | Anthropic | 56.0 | $5.46 |
| 4 | Claude Opus 5.5 (High, Default Fallback) | Anthropic | 53.6 | $1.82 |
| 5 | Claude Fable 5.1 (Max, Default Fallback) | Anthropic | 53.4 | $7.63 |
| 6 | Claude Fable 5.1 (Xhigh, Default Fallback) | Anthropic | 53.2 | $5.98 |
| 7 | GPT-6 Astra (Max) | OpenAI | 52.7 | $3.26 |
| 8 | Gemini 4 Argon (High) | 52.6 | $1.99 | |
| 9 | GPT-6 Astra (Xhigh) | OpenAI | 52.4 | $2.31 |
| 10 | Claude Sonnet 5.5 (Xhigh, Default Fallback) | Anthropic | 51.9 | $2.01 |
| 11 | GPT-6.1 Sol (Max) | OpenAI | 51.8 | $0.72 |
| 12 | Claude Fable 5.1 (High, Default Fallback) | Anthropic | 51.2 | $3.91 |
第 2、3 名同为 56.0,先后顺序按快照原样;第 12 名也和 Claude Opus 5.5 (Medium) 并列 51.2。
看这张表,有两点值得说。
第一,第 5 到第 10 名只差 1.5 分。Argon 比 GPT-6 Astra (Max) 低 0.1,比 Astra (Xhigh) 高 0.2。免费数据里没有置信区间,所以我会把 Argon 和 Astra 在这个指数上当成打平,不当成先后。
第二,排在 Argon 前面的 7 行里,只有一行每题比它便宜:Claude Opus 5.5 的 High 档,53.6 分、每题 $1.82,Argon 是 52.6 分、$1.99。按 AA 的价格算,Argon 在第一梯队里不算性价比之选,它和 Opus 5.5 (High)、Sonnet 5.5 (Xhigh) 在同一个价位,分数夹在两者中间。
放到 Google 自家产品线里看,快照里 Google 第二高的是 Gemini 3.8 Flash (High),40.9 分,比 Argon 低 11.7 分。没拿到第一,但对 Google 来说这一步迈得不小。
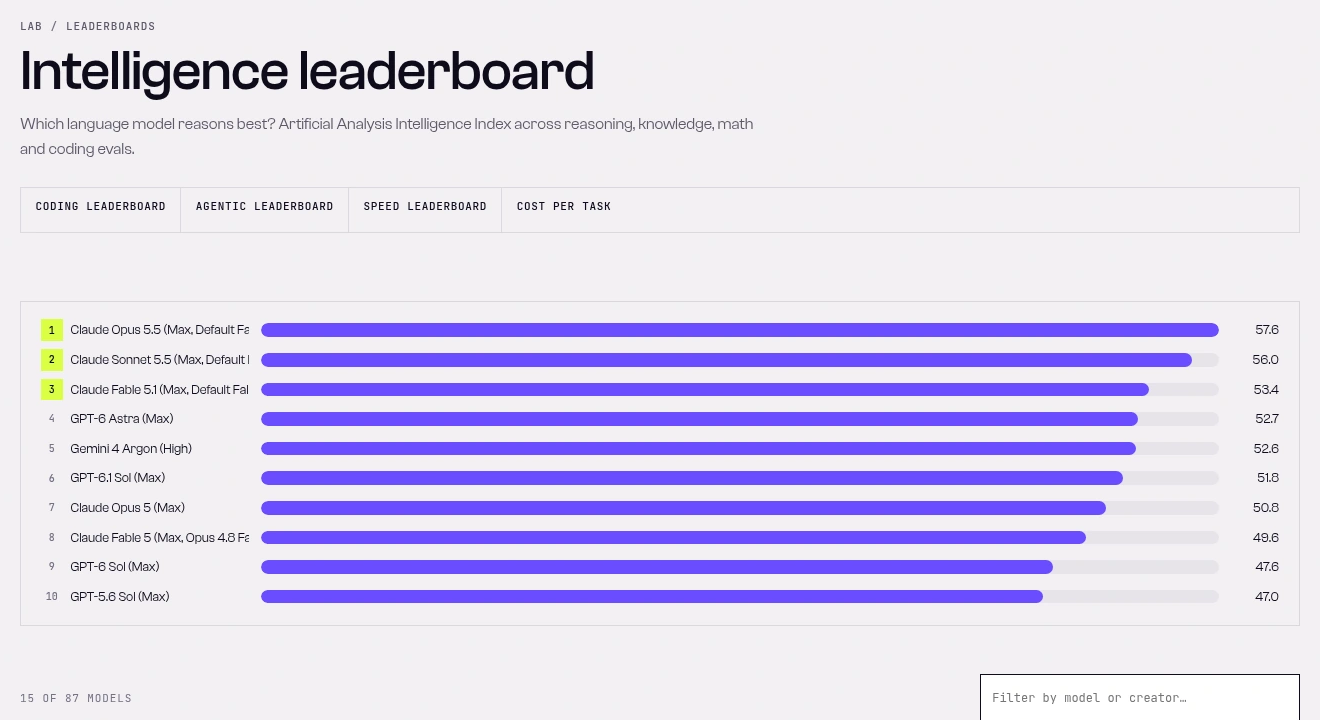
SandBase Lab 的排行榜用的是同一个 AA 分数(52.6),但 Argon 排第 5:它每个模型只留一行,范围是 AA 有数据的 87 个 SandBase 上架模型(2026-10-15 截图)。
同一个模型,为什么一会儿第 8、一会儿第 5
名次不同,是因为参与排名的集合不同。引用之前先对一下口径:
| 在哪看到的 | 排的是什么 | Argon 的位置 |
|---|---|---|
| AA 快照全部行 | 687 个有综合分的行,每行是一个模型的一个推理档位 | 第 8 |
| 按模型去重(每个模型取最高一行) | 同一份数据,每个模型一行 | 第 5,前面是 Opus 5.5、Sonnet 5.5、Fable 5.1、GPT-6 Astra |
| SandBase Lab 综合智能榜 | 每个模型一行,只含 AA 有数据的 87 个 SandBase 模型 | 第 5 |
| Google 发布博客 | Vals Index,另一个基准,由 Google 自己跑、自己报 | 第 1(Google 自报) |
AA 自己的模型页还写着“#8 / 216”,那是 AA 按模型类别划的比较范围,免费数据里复现不出来,这里不用。
还有一点容易忽略:AA 测的是“Gemini 4 Argon (High)”,快照里 Argon 只有这一行,没有 Low、Medium 档。Opus 5.5 的 Medium(51.2 分、每题 $1.34)和 High(53.6 分、$1.82)成本差得很远,Argon 这条曲线现在画不出来。打算用低档位跑 Argon 的话,这个分数说明不了你的配置。
领域指数:法律最突出
AA 免费数据里还有六个领域指数,Argon 有五个有分。下表的名次只在“该指数有分数的行”里算,并列就写并列,不按列表顺序硬拆。数据来源:Artificial Analysis,v4.3,截至 2026-10-12。
| 领域指数 | Argon (High) | 名次 | 有分数的行数 | 该指数第一名 |
|---|---|---|---|---|
| 法律 Legal | 60.0 | 第 5 | 208 | Claude Opus 5.5 (Max),63.3 |
| 工程 Engineering | 55.2 | 第 7 | 215 | Claude Opus 5.5 (Max),60.4 |
| 经济 Economics | 60.4 | 并列第 8(与 Claude Fable 5 Max) | 223 | Claude Opus 5.5 (Max),65.6 |
| 战略与运营 Strategy & ops | 56.2 | 并列第 12(与 Claude Sonnet 5.5 Xhigh) | 208 | Claude Opus 5.5 (Max),63.7 |
| 金融与会计 Finance & accounting | 53.8 | 并列第 13(与 Claude Fable 5 Max、Fable 5.1 High) | 208 | Claude Opus 5.5 (Max),60.7 |
| 医疗 Healthcare & medical | 未测 | — | 81 | Claude Opus 5.5 (Max),60.5 |
分领域看,形状和总榜不一样。法律上,Argon 只比 Claude Fable 5.1 (Max) 低 0.5,比 Fable 5.1 (Xhigh) 和 Opus 5.5 (Xhigh) 低 0.8,每题成本却比这几行都低($1.99 对 $3.46 到 $7.63)。到了金融与会计,它掉到并列第 13,排在 GPT-6 Astra (Max) 的 55.2 和 GPT-6.1 Sol (Max) 的 54.0 后面。
第三方数据和 Google 的说法,恰好在金融这里对不上。Google 模型卡里 Vals Finance Agent v2,Argon 65.4%,GPT-6 Astra 53.5%,领先 12 个点;AA 的金融指数却是 Astra (Max) 领先 1.4 分。两者测的不是一回事:一个是 Agent 式的金融任务集,一个是 AA 为综合指数自建的领域分。但如果你做金融场景,别拿那 12 个点当预期。这个对比我们在法律与金融那篇里展开讲。
Artificial Analysis 还没测什么
发布周的报道大多跳过了这一块。2026-10-12 的快照里,Argon 下面这些字段是 null:
artificial_analysis_coding_index(编码指数)artificial_analysis_agentic_index(Agent 指数)artificial_analysis_healthcare_and_medical_index(医疗指数)median_output_tokens_per_second、median_time_to_first_token_seconds等速度字段
也就是说,截至这个日期,AA 没有 Argon 的编码分、Agent 分和速度数据。这倒不算坏消息:同样 9 月下旬发布的 Claude Opus 5.5 和 Sonnet 5.5,在快照里也没有编码和 Agent 指数。目前 AA 编码指数前三全是 Claude Fable 5.1(81.6、80.7、79.1),GPT-6 Astra (Max) 是 76.9。Argon 大概率只是还没跑到这几套题。
落到实处就是:有人说 Argon“编码吊打 Opus”,来源要么是 Google 的表,要么是他自己测的,反正不是 AA。而 Google 自己的表里,四个 Agent 编码项 Argon 还输了两个。
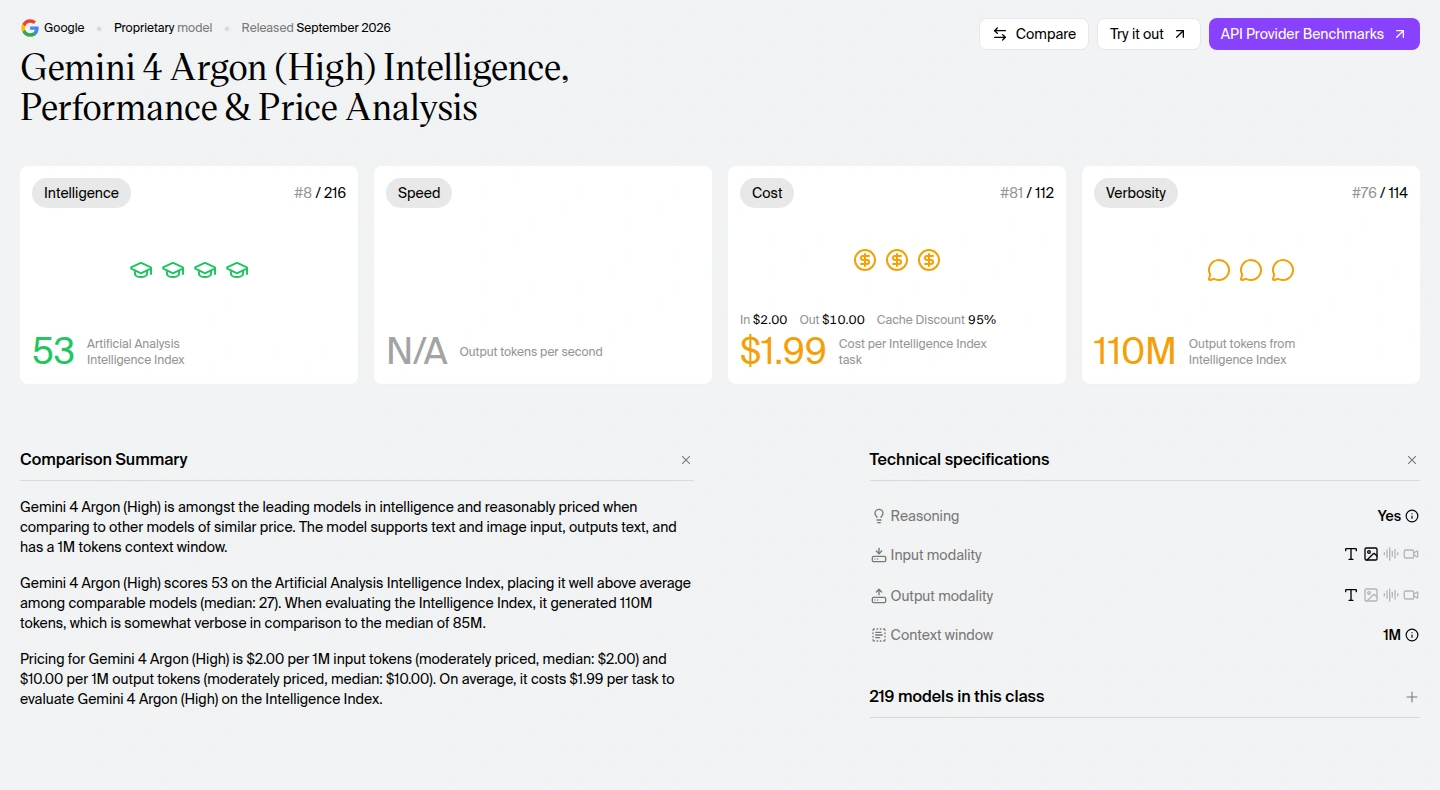
AA 官网的 Gemini 4 Argon (High) 页面:综合分四舍五入显示为 53,按 $2 / $10 介绍价每题 $1.99,速度显示 N/A,和快照里速度字段为空一致(2026-10-15 截图)。
速度再多说一句。等 AA 的速度数据出来,那也是 AA 测的各家 API 服务商的中位数,不是 SandBase 的路由延迟。Google 模型卡自己也把“偶尔变慢或超时”列为已知限制。延迟请在你实际要用的线路上测。
跑一遍指数的成本:现在 $1.99,之后约 $3.98
AA 跑指数时按各模型的标价计费。Argon 用的是 Google 介绍价:每百万输入 token $2、输出 $10,缓存命中 $0.10。结果是整个指数 $2,407.24,折合每题 $1.99。
介绍价 2026 年 11 月 30 日到期,Google 博客和 Google Cloud 都写了之后按 $4 / $20。各项单价都翻倍,同样的 token 用量大约每题 $3.98,整个指数约 $4,814。这是我拿 AA 的数字算的,不是 AA 公布的。
| 配置 | 综合分 | AA 每题成本 | 备注 |
|---|---|---|---|
| Gemini 4 Argon (High),介绍价 | 52.6 | $1.99 | $2 / $10 |
| Gemini 4 Argon (High),按 $4 / $20 | 52.6 | 约 $3.98(估算) | token 不变,按标准价 |
| Claude Opus 5.5 (High) | 53.6 | $1.82 | $4 / $20 |
| Claude Sonnet 5.5 (Xhigh) | 51.9 | $2.01 | $2 / $10 |
| GPT-6 Astra (Xhigh) | 52.4 | $2.31 | $10 / $50 |
| GPT-6 Astra (Max) | 52.7 | $3.26 | $10 / $50 |
| GPT-6.1 Sol (Max) | 51.8 | $0.72 | $2 / $10 |
介绍价下,Argon 在中间。换成 $4 / $20,它就和分数差不多的 GPT-6 Astra (Max) 一个价位,还比高一分的 Opus 5.5 (High) 贵。GPT-6.1 Sol (Max) 差 0.8 分,成本只有介绍价下 Argon 的三分之一左右。12 月 1 日调价对实际业务的影响,见 Argon 价格那篇。
SandBase 上 Argon 现在的标价是输入 $4、输出 $20(每百万 token),缓存读取 $0.20。这是 Google 11 月 30 日之后的标准价,在那之前是 Google 直连介绍价的两倍。如果这个月要跑大规模评测、只看价格,Google 直连更便宜;SandBase 的价值在于一个 key、一套 API,就能把 Argon 和它的对手放在一起测。
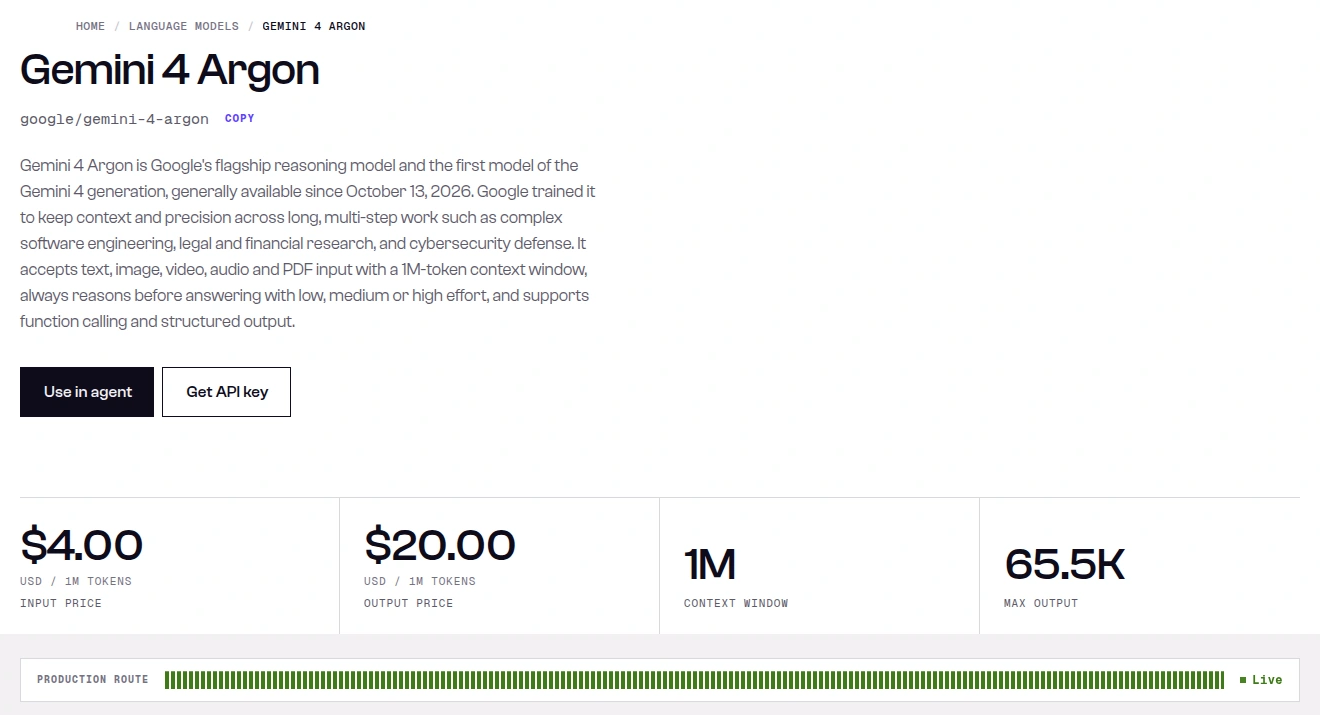
SandBase 的 google/gemini-4-argon 模型页:每百万 token $4 / $20、1M 上下文、最大输出 65.5K,上面“约 $3.98”的估算就是按这个价格算的(2026-10-15 截图)。
Google 自报和第三方数据:哪里一致
DeepMind 模型卡拿 Argon 和 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 比了 19 行。Argon 14 行最高,其中 CWE-bench v1 和 Astra 并列。输的那几行,输得也很明显:
| 基准(Google 自报) | Argon | 其他最高 | 第一 |
|---|---|---|---|
| Vals Index | 68.9 | 67.0 | Argon |
| Harvey Legal Agent | 19.6 | 6.7 | Argon |
| DeepSWE v1.1 | 77.9 | 74.2 | Argon |
| FrontierSWE v2 | 55.0 | 65.5 | GPT-6 Astra |
| Terminal-bench 4.0 | 57.4 | 66.4 | Claude Opus 5.5 |
| PostTrainBench | 45.3 | 49.3 | Claude Opus 5.5 |
| Terminal-Bench Science 0.1 | 57.6 | 68.1 | GPT-6 Astra |
| OSWorld-2.0(离线子集) | 69.2 | 72.6 | GPT-6 Astra |
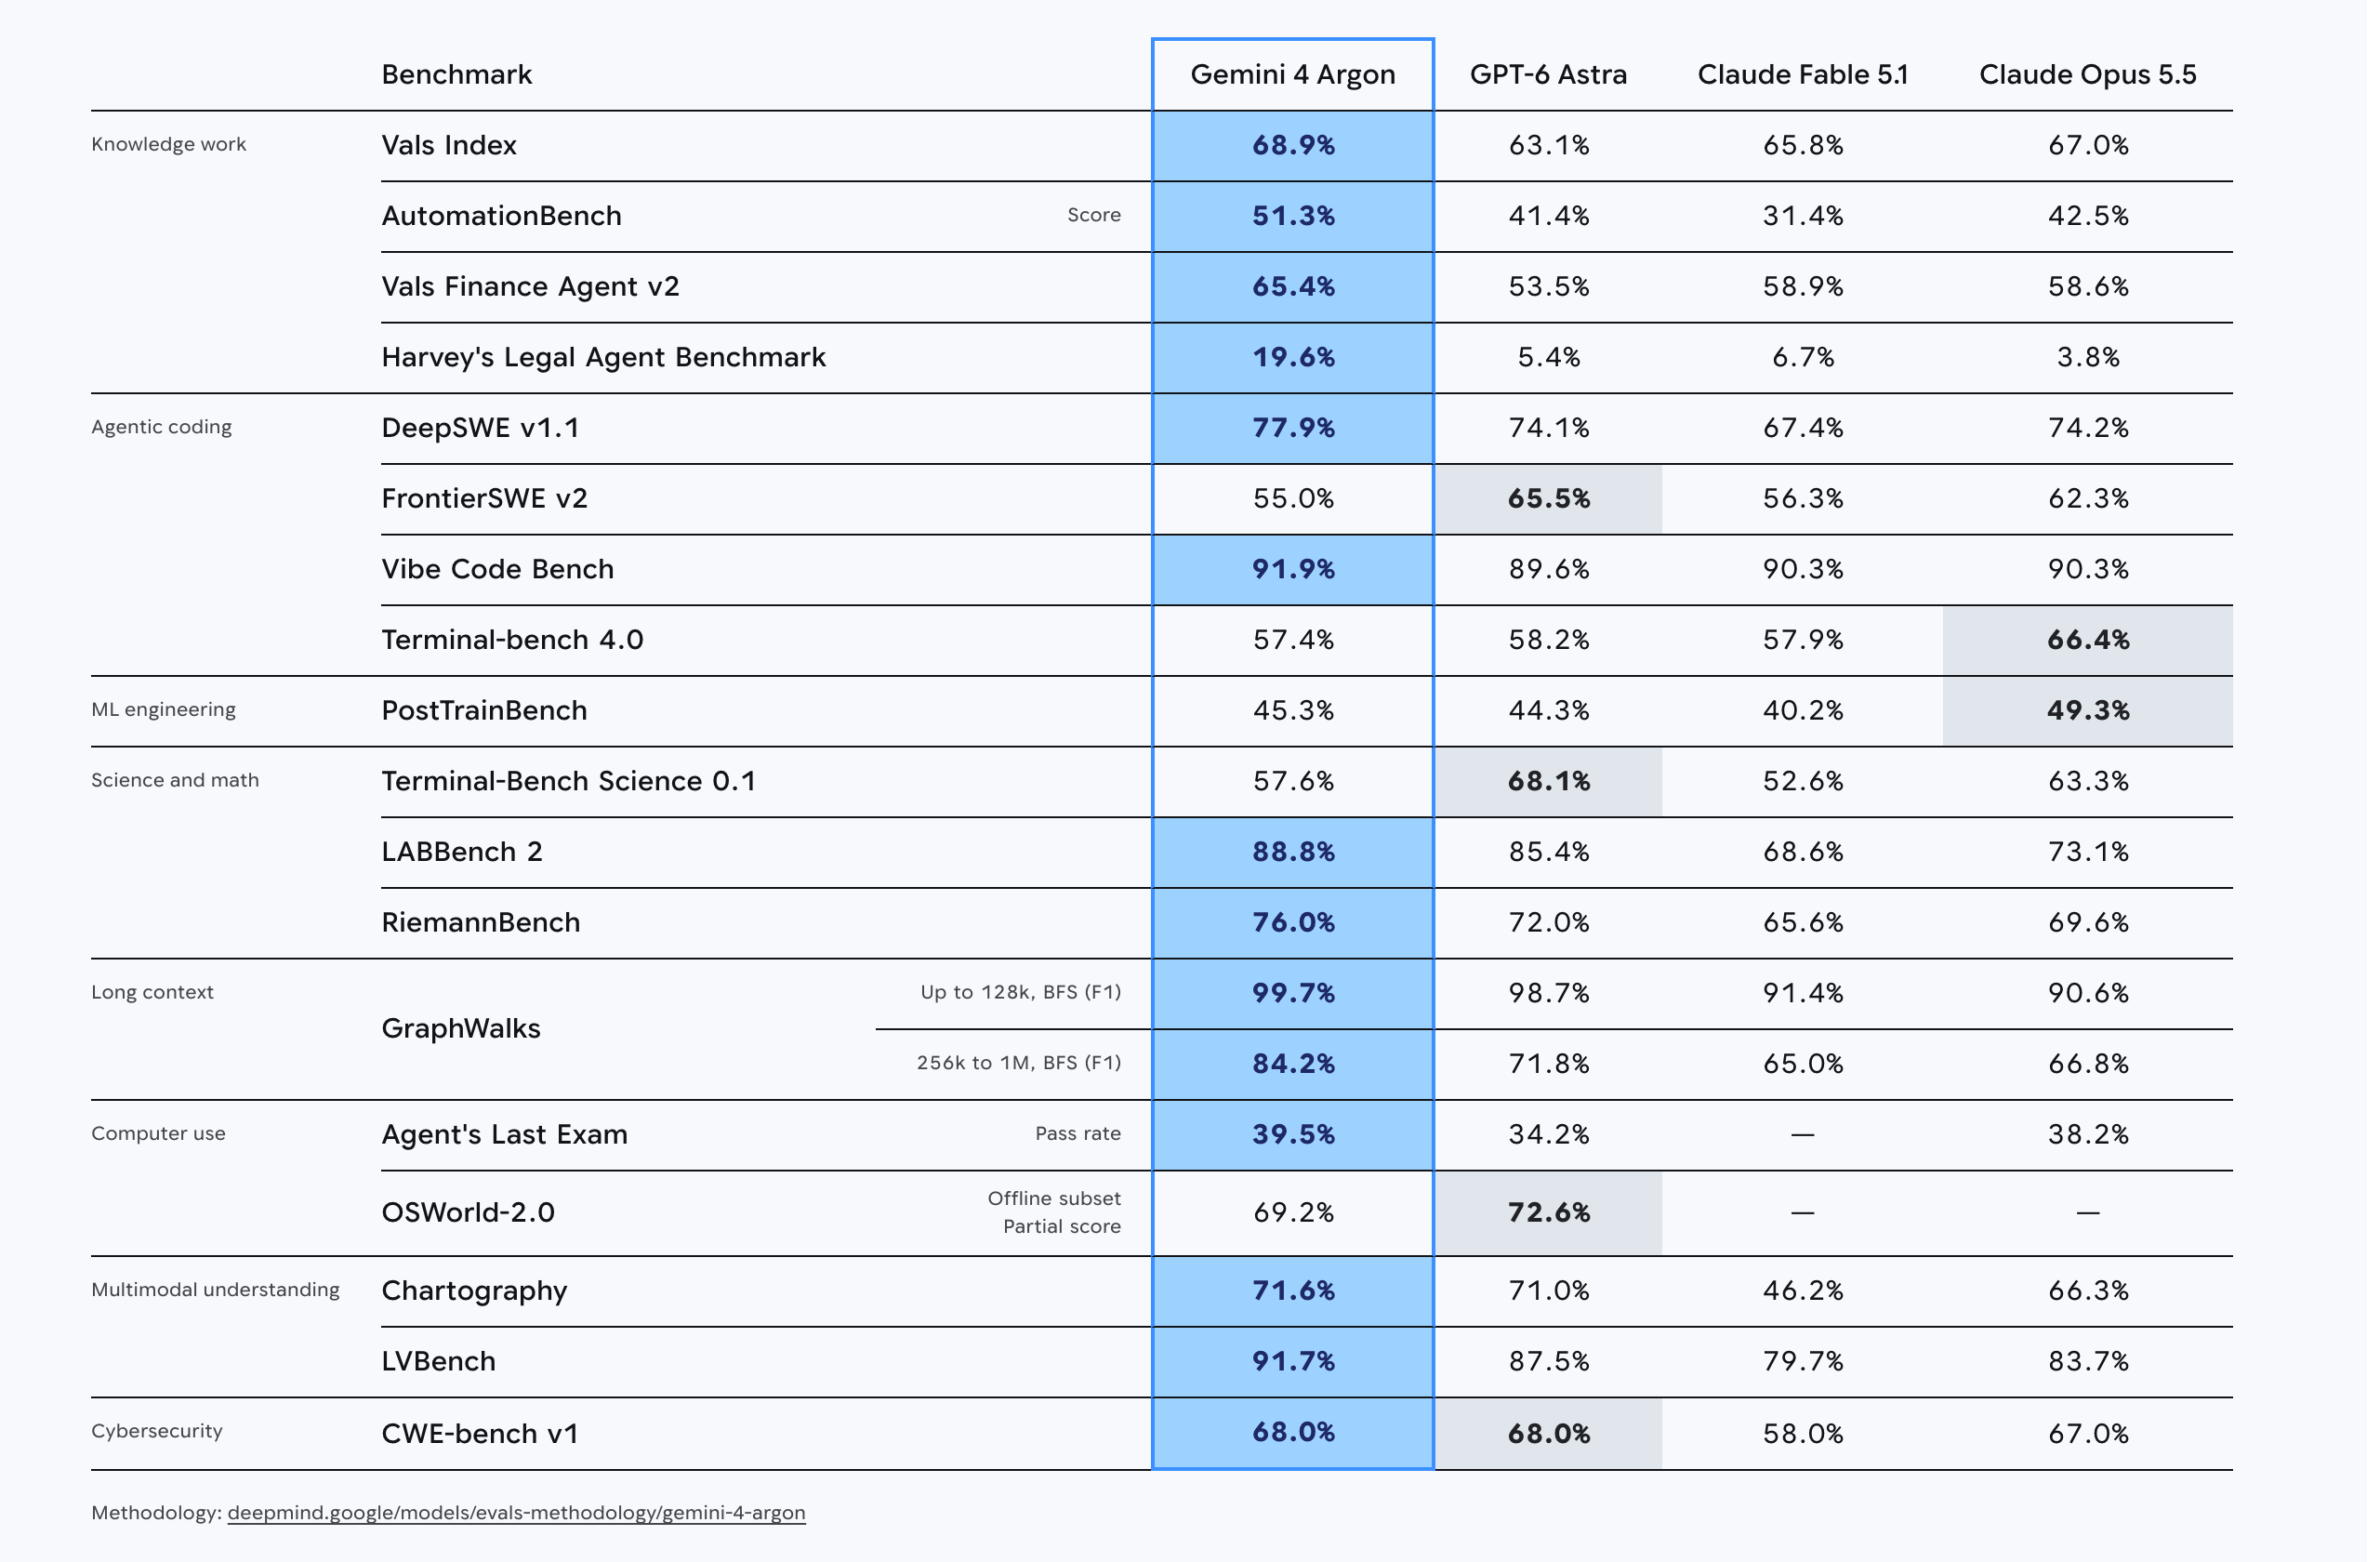
Google 模型卡评测表(2026 年 10 月 13 日发布):大多数行 Argon 高亮第一,但 FrontierSWE v2、Terminal-bench 4.0、PostTrainBench、Terminal-Bench Science 和 OSWorld-2.0 落后;表中所有数字均为 Google 自报(2026-10-15 截图)。
我不觉得两边矛盾。Google 挑的基准贴近它为 Argon 设计的长程知识工作,在这些题上 Argon 领先;AA 的综合指数覆盖面更广,Argon 落在 Anthropic 最强几档后面。另外,模型卡表头只写模型名,没写推理档位,Google 的测试设置在它的方法说明页,这篇没有细看。Google 的数字我们一个都没复现。
两边一致的地方:Argon 是第一梯队,法律和长文档强,终端类 Agent 编码不是它的强项。不一致的地方:它是不是总体最强。按截至 2026-10-12 的第三方数据,不是。
这些数字怎么用
做法律审阅、长文档分析,AA 的法律指数和 Google 的 Harvey 结果指向同一个方向:Argon 应该进候选名单,而且 12 月 1 日前测最便宜。
选编码 Agent,AA 目前没有 Argon 的数据,Google 自己的表也是有输有赢,只能拿自己的仓库任务去跑。Argon、Claude Opus 5.5、GPT-6 Astra 三方对比里有我们在 SandBase 上做的同题小测。
如果看的是“每分多少钱”,按 AA 的数字,GPT-6.1 Sol (Max) 和 Claude Opus 5.5 (High) 都比 Argon 划算,11 月 30 日之后差距更大。
想用一个 key 把 Argon 和表里这些模型放一起测,可以从 Gemini 4 Argon 模型页或 Python 调用教程开始。GA 之前的背景,见我们早先那篇 Argon 开放进度与 Gemini 实测。
常见问题
Gemini 4 Argon 在 Artificial Analysis 上排第几?
Gemini 4 Argon (High) 在 AA 综合智能指数 v4.3 上得 52.6 分,687 个有分数的行里排第 8,数据截至 2026-10-12。按模型去重是第 5,前面是 Claude Opus 5.5、Claude Sonnet 5.5、Claude Fable 5.1 和 GPT-6 Astra。
Gemini 4 Argon 比 Claude Opus 5.5 强吗?
看 AA 综合分,不强:Opus 5.5 (Max) 57.6,连 High 档都有 53.6。Google 模型卡里 Argon 多数项领先 Opus 5.5,但 Terminal-bench 4.0 和 PostTrainBench 落后。哪个更重要,取决于你的任务。
AA 有 Gemini 4 Argon 的编码跑分吗?
截至 2026-10-12 没有。快照里 Argon 的编码、Agent、医疗指数和所有速度字段都是空的。Opus 5.5 和 Sonnet 5.5 也还没有编码和 Agent 指数。
在 Argon 上跑一遍综合指数要多少钱?
按 Google 介绍价 $2 / $10,每题 $1.99,总计 $2,407。11 月 30 日之后按 $4 / $20,同样 token 我们估算约每题 $3.98。
这份分析的边界
这是一个综合指数的一份快照,数据截至 2026-10-12,只覆盖 Argon 的一个配置(High)。AA 的方法见其智能指数方法说明。我们用的免费 API 没有单项基准分,也没有误差范围,零点几分的差距不要当成先后。AA 重跑后分数可能变化,编码、Agent 和速度字段之后的快照里可能补上。这篇没有调用 Argon,$3.98 是基于 AA token 成本的估算,不是实测。数据来源:Artificial Analysis(Argon 模型页)。Google 的数字来自发布博客、Google Cloud 公告和 DeepMind 模型卡,均于 2026-10-15 获取。