Gemini 4 Argon API 怎么用?价格、开放进度与 Gemini 实测
Gemini 4 Argon API 怎么用、什么时候能用、价格多少:Google 9 月 30 日官宣,介绍价 $2 / $10,开发者开放没有日期。附现在就能调用的 5 个 Gemini 模型在 Agent 工具调用和 Claude Code 编码上的实测。
Google 在 2026 年 9 月 30 日发布了 Gemini 4 Argon,价格给了(每百万输入 token $2、输出 $10),开发者什么时候能用却没给日期。2026-10-04 00:13(UTC),我们在 SandBase 上请求 GET /v1/models/google/gemini-4-argon,返回的还是 HTTP 404,“model not found”。
所以现在搜 Gemini 4 Argon API 怎么用,老实的答案是:大多数开发者暂时还用不上。这篇不猜 Argon 有多强,只做三件事:把 Google 官方原文说了什么理清楚;把介绍价换算成每个任务的钱;再用我们 12 个模型的工具调用实测 和 Claude Code 换模型实测 的同一套测试程序,看看现在就能调用的 5 个 Gemini 模型表现如何。适合正在纠结“等 Argon,还是先用 Gemini 3.x 开工”的开发者。
先说结论
- Argon 只是官宣,还没全面开放。Google 先给 Fairwind Program 里的可信网络安全防御方,之后才面向开发者,“从付费 API 客户和 Google AI Ultra 订阅用户开始”,没有日期。SandBase 目前也没有这个模型。
- 介绍价 $2 / $10,缓存输入比输入价便宜 95%,每 token 单价和 SandBase 上的 GPT-6.1 Sol 一样。每个任务实际花多少,取决于 Argon 用多少 token,这一点外部现在没人知道。
- 17 道 Agent 工具调用题、每题 3 次:Gemini 3.1 Pro preview 47/51,四个 Flash 在 42 到 46 之间;GPT-6.1 Sol、Claude Opus 5.5、GPT-6 Luna 都是 51/51。
- 四个 Flash 都在同一道“20 个数求平均”上 3 次全错。3.1 Pro preview 这题全对,但有一道长列表题 3 次都被输出上限截断。
- Claude Code 编码实测:Gemini 3.8 Flash 和 3.1 Pro preview 都是 12/12,每任务中位成本 $0.29 和 $0.45。Gemini 3.5 Flash-Lite 只有 3/12,而且 12 次全部以流式连接中断收尾。
Google 官方到底说了什么
下表全部来自 Google 官方博客,2026-10-04 重新核对。跑分都是 Google 自己报的,我们没有复现。
| 项目 | Google 原文要点 |
|---|---|
| 发布日期 | 2026 年 9 月 30 日 |
| 现在谁能用 | 通过 Fairwind Program 开放给一批可信的网络安全防御方 |
| 下一批 | 开发者、企业和普通用户,从付费 API 客户和 Google AI Ultra 订阅用户开始;没有日期 |
| 价格 | 介绍价(introductory price):输入 $2 / 百万 token,输出 $10 / 百万 token |
| 缓存输入 | 按输入价打 95% 折扣 |
| 输出上限 | 100 万 token,此前是 64K |
| DeepSWE v1.1(长程软件工程) | 77.9%(Google 自报) |
| AutomationBench(Zapier) | 51.3%(Google 自报) |
| LVBench(长视频理解) | 91.7%(Google 自报) |
| CWE-bench v1(漏洞修复) | 68%,并列第一(Google 自报) |
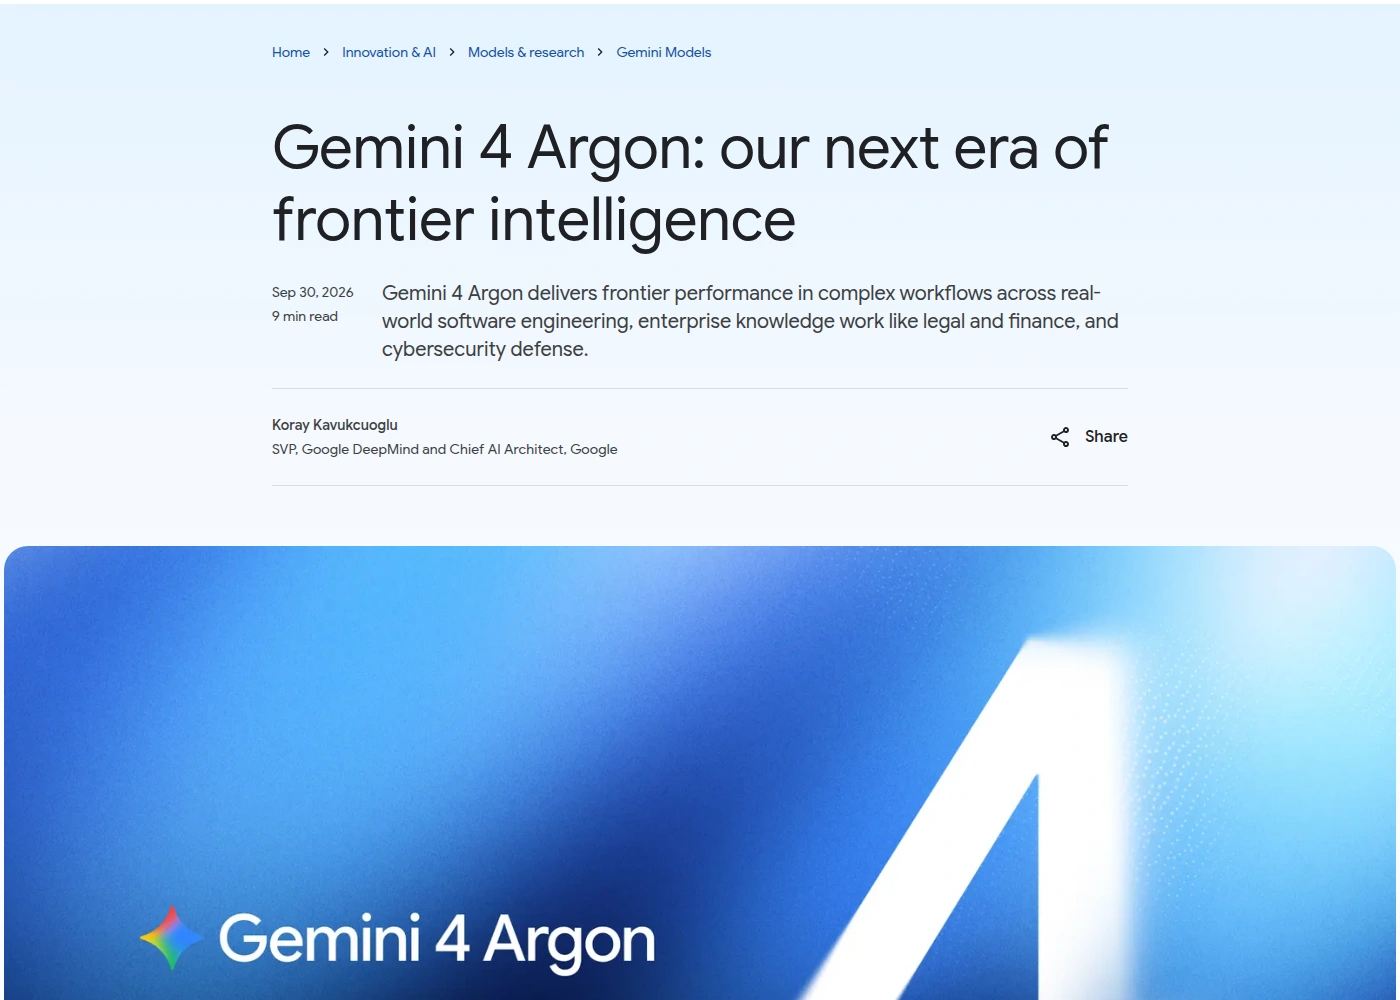
截图:Google 于 2026 年 9 月 30 日发布 Gemini 4 Argon 的官方博文,上表的事实全部取自这一篇(2026-10-04 截取)。
做预算时注意两点。第一,官方说的是“介绍价”,没说持续多久,也没说之后涨到多少,别按这个价算长期账。第二,官方明确是分阶段放量,安全防护要在“全面开放前”继续加固。日期我们不猜。
现在能调用 Gemini 4 Argon API 吗
除非你在 Google 的早期名单里,否则不能。2026-10-04 00:13(UTC),我们在 SandBase 上试了三个可能的 id:google/gemini-4-argon、google/gemini-4-argon-preview、google/gemini-4,全部 404。同一时间模型列表里有 16 个 Gemini id,下面实测的 5 个都在其中。Argon 上线 SandBase 后,我们会用同样两套程序再跑一遍,但不承诺时间。
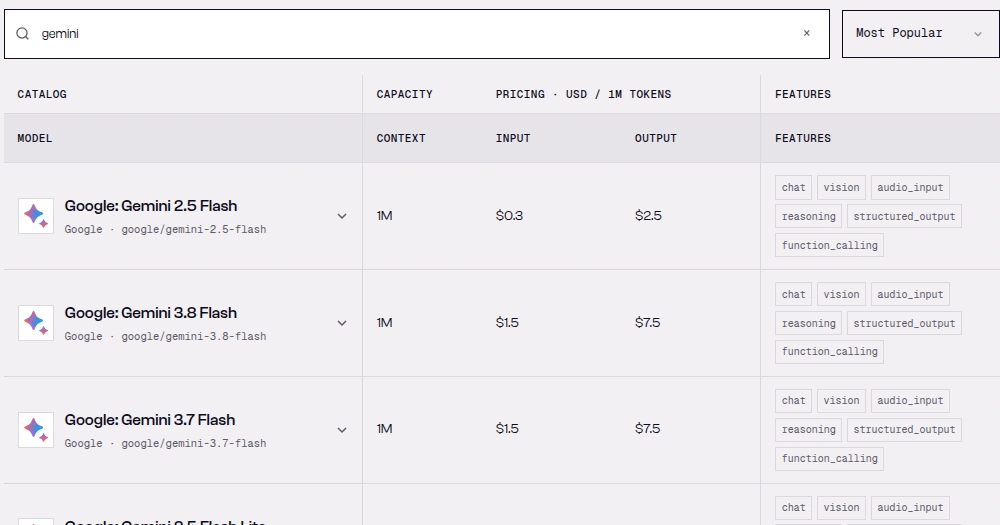
截图:在 SandBase 模型目录搜索“gemini”,能看到现在可调用的 Gemini 模型和价格,比如 Gemini 3.8 Flash、3.7 Flash 都是 $1.50 / $7.50,没有 Argon(2026-10-04 截取)。
Gemini 4 Argon 价格:$2 / $10 落到每个任务是多少
按每 token 算,Argon 介绍价和 SandBase 上 GPT-6.1 Sol 的 $2 / $10 完全一样,输出比 Gemini 3.1 Pro preview 的 $12 便宜。但一个任务花多少钱,还得乘上 token 数,而同样单价的模型,token 用量能差好几倍。
下表是推算,不是实测:拿我们实测到的每任务 token 数,套上 Argon 公布的单价。
| 按谁的 token 用量(实测) | 输入 / 输出 token 中位数 | 按原价的每任务中位成本 | 同样 token 按 Argon $2 / $10 |
|---|---|---|---|
| GPT-6.1 Sol | 2,887 / 110 | $0.0069 | $0.0069 |
| Gemini 3.8 Flash | 2,679 / 235 | $0.0058 | $0.0077 |
| Gemini 3.1 Pro preview | 2,679 / 717 | $0.0129 | $0.0117 |
| Claude Opus 5.5 | 5,041 / 436 | $0.0285 | $0.0143 |
如果 Argon 用 token 像 Sol,那它的花费就和 Sol 一样。如果它像 3.1 Pro preview 那样能写(输出中位数是 Sol 的 6.5 倍),同样单价下每个任务要贵 1.7 倍左右。缓存输入打 95% 折扣,对 Claude Code 这种每轮都重发长系统提示的 Agent 最有用;不过 Google 没公布缓存写入怎么计价。
现在能用的 Gemini,实测结果
Agent 工具调用:17 道题,每题 3 次
测试程序和 Pro vs Flash 分档实测 完全相同:6 个工具封装抖音、微博、小红书的公开数据接口,工具返回结果先缓存再回放,保证每个模型看到的数据一模一样;17 道计分题(T1–T10 查询类,H1–H8 统计类,H7 剔除);每轮最多输出 1,500 token,最多 10 轮,默认参数。Gemini 3.8 Flash 和对照模型在 2026-10-03 07:36 到 10:42(UTC)之间跑完;另外 4 个 Gemini 模型从 2026-10-03 23:55 跑到 10-04 00:06 左右。价格是 GET /v1/models/<id> 读到的 SandBase 标价,这个接口要带同一个 Authorization: Bearer key;没 key 的话,公开的模型页上也能看到同样的价格。
| 模型 | 单价(输入 / 输出,$/百万) | T(30) | H(21) | 总分(51) | 每任务中位成本 | 中位耗时 |
|---|---|---|---|---|---|---|
| Gemini 3.1 Pro preview | $2 / $12 | 30 | 17 | 47 | $0.0129 | 12.6 秒 |
| Gemini 3.8 Flash | $1.50 / $7.50 | 27 | 19 | 46 | $0.0058 | 6.3 秒 |
| Gemini 3.7 Flash | $1.50 / $7.50 | 27 | 16 | 43 | $0.0064 | 7.4 秒 |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | 27 | 16 | 43 | $0.0013 | 5.4 秒 |
| Gemini 3.5 Flash | $1.50 / $9 | 27 | 15 | 42 | $0.0071 | 6.5 秒 |
| GPT-6.1 Sol | $2 / $10 | 30 | 21 | 51 | $0.0069 | 9.5 秒 |
| Claude Opus 5.5 | $4 / $20 | 30 | 21 | 51 | $0.0285 | 10.1 秒 |
| GPT-6 Luna | $0.10 / $0.50 | 30 | 21 | 51 | $0.00035 | 7.6 秒 |
| Claude Sonnet 5.5 | $2 / $10 | 27 | 17 | 44 | $0.0130 | 13.6 秒 |
所有 Gemini 模型都没有出现格式错误的工具调用。错题几乎都栽在两处:手算和长列表。
- T5,20 条视频点赞数求平均(正确答案 422,764)。 四个 Flash 都是 3 次全错。Gemini 3.8 Flash 三次都答 422,739,差 25。3.1 Pro preview 三次全对。
- H2,按条件筛出 4 个视频 ID。 Flash 系列要么多列、要么漏列,每个模型错 2 到 3 次。3.1 Pro preview 在这题上是另一种翻车:3 次都写满了 1,500 token 的上限,没输出
FINAL行。它的第 4 个错是 H3 的一次运行,正常结束但同样没有FINAL行。 - H4、H3,10 到 20 个数求和。 3.5 Flash 和 3.7 Flash 的 H4 都是 3 次全错;Flash-Lite 的 H3 错了 2 次,两次都正好多出 20,000。
3.7 Flash 的背景可以看我们的 Gemini 3.7 Flash 发布解读;那篇写的 $0.75 / $3.75 是发布时的价格,2026-10-04 SandBase 标价是 $1.50 / $7.50。另外,3.5 Flash 有 11 次工具请求不在缓存里(其中一次是把账号 ID 抄错了),Flash-Lite 有 1 次,这些请求走了实时接口。没有哪道题的标准答案依赖它们。
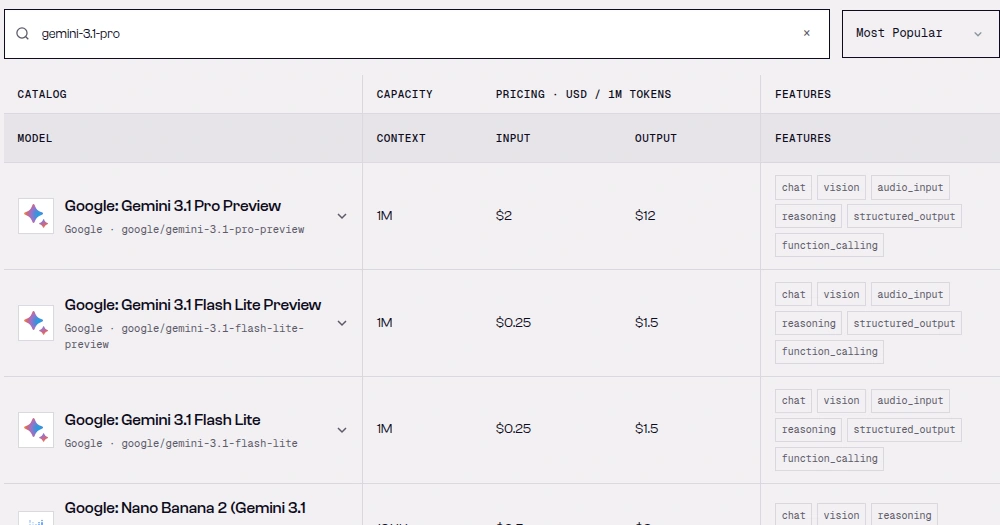
截图:Gemini 3.1 Pro preview 标价输入 $2、输出 $12(每百万 token),它每个工具任务 $0.0129 的中位成本就是按这个价算的(2026-10-04 截取)。
编码 Agent:Claude Code,6 道题,每题 2 次
题目和 Claude Code 换模型实测 相同:6 个小型 Python 仓库,Agent 跑完后再放入隐藏测试判分。Claude Code 2.1.246 通过 SandBase 兼容 Anthropic 协议的 POST /v1/messages 调 Gemini;每个 Gemini id 的 12 次运行都在 stderr 打出 [claude-code:unrecognized_model],但不影响运行。Gemini 在 2026-10-03 23:57 到 10-04 00:09(UTC)之间跑完,对照模型是 10-03 13:40 到 14:15 左右跑的。
| 模型 | 通过(12) | 中位轮数 | 中位耗时 | 每任务中位成本 | Claude Code 自报(12 次合计) |
|---|---|---|---|---|---|
| Gemini 3.8 Flash | 12 | 10.5 | 68 秒 | $0.293 | $14.21 |
| Gemini 3.1 Pro preview | 12 | 10.5 | 98 秒 | $0.446 | $14.99 |
| Gemini 3.5 Flash-Lite | 3 | 9 | 46 秒 | $0.037 | $8.05 |
| GPT-6.1 Sol | 12 | 23.5 | 114 秒 | $0.117 | $4.55 |
| Claude Sonnet 5.5 | 12 | 9 | 109 秒 | $0.124 | $1.56 |
| Claude Opus 5.5 | 12 | 5 | 44 秒 | $0.540 | $7.64 |
| GPT-6 Luna | 11 | 22 | 100 秒 | $0.0071 | $4.33 |
成本是我们自己估的:Claude Code 输出里的累计 usage × SandBase 标价,缓存读取按模型卡上的 cache_read_multiplier(Gemini 是 0.1);Gemini 的模型卡没写缓存写入倍率,所以缓存写入按普通输入价算。Claude Code 自己的 total_cost_usd 不认识这些模型,数字偏差很大。/v1/messages 的 id 在 GET /v1/tasks/<id>/cost 里查不到,所以没法逐次和账单对账。
有两个结果要多说一句。一是 Gemini 3.8 Flash 单价比 GPT-6.1 Sol 低,每任务却贵 2.5 倍:它只有 11% 的 token 是缓存读取,Sol 是 93%,大部分输入都按全价计费。二是 Flash-Lite 的 3/12 不能当成编码能力的结论。它 12 次运行全部在第 3 到 14 轮以 “API Error: stream closed before completion” 结束,其中 3 次碰巧留下了能通过测试的代码。我们没有重跑。
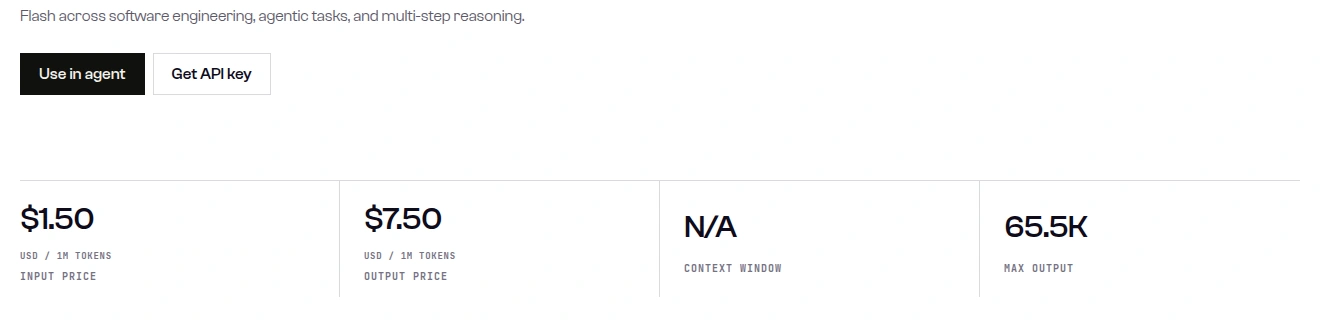
截图:SandBase 上 Gemini 3.8 Flash 的模型页显示 $1.50 / $7.50 和 65.5K 最大输出,对比 Google 给 Argon 宣布的 100 万 token 输出上限(2026-10-04 截取)。
这些数据对 Argon 意味着什么
对它的水平,什么都说明不了。模型不同,Google 给 Argon 报的也是另一批榜单。数据能告诉你的,是 Argon 开放后先测什么:基于工具结果的手算(Flash 全军覆没的地方)、有 token 上限时的长答案(3.1 Pro preview 被截断的地方)、编码 Agent 里的缓存命中(决定 Gemini 每任务成本的地方)。在那之前,求和、求平均放进代码里做,长答案给够 max_tokens,成本按任务算,别只看单价。
现在就把 Agent 切到 Gemini
SandBase 通过兼容 OpenAI 的 Chat Completions 接口 提供上面这些 Gemini 模型,和其他模型用同一个 key,换模型只改一个字符串。下面的程序给 Gemini 3.8 Flash 一个工具:封装抖音的公开接口,平均数在 Python 里算好再交给模型,正好绕开 Flash 在 T5 上翻车的那一步。aweme_list 和 statistics.digg_count 是我们在实际返回里看到的字段名,不是文档保证的,所以代码用 .get() 读取。
import os
import re
import json
import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
# Swap the model by changing one string. $/M input, output: SandBase list price, 2026-10-04.
MODEL = os.environ.get("AGENT_MODEL", "google/gemini-3.8-flash")
PRICE = {"google/gemini-3.8-flash": (1.5, 7.5), "google/gemini-3.1-pro-preview": (2, 12),
         "openai/gpt-6.1-sol": (2, 10), "openai/gpt-6-luna": (0.1, 0.5)}
SYSTEM = "Use the tools to answer; never guess numbers. Finish with one line: FINAL: {json}."


def call_data_api(model: str, params: dict) -> dict:
    """Call a SandBase data endpoint and return outputs[0].data, failing loudly otherwise."""
    resp = requests.post(f"{BASE}/api/{model}", headers=HEADERS, json=params, timeout=120)
    resp.raise_for_status()
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def douyin_video_stats(sec_user_id: str) -> dict:
    """First page of an account's videos, with the arithmetic done here, not by the model."""
    data = call_data_api("douyin/app-v3/user-post-videos",
                         {"sec_user_id": sec_user_id, "max_cursor": 0, "count": 20})
    likes = [(item.get("statistics") or {}).get("digg_count") or 0  # observed field names
             for item in data.get("aweme_list") or []]
    if not likes:
        return {"videos": 0, "found": False}
    return {"videos": len(likes), "likes_sum": sum(likes), "likes_mean_floor": sum(likes) // len(likes)}


TOOLS = [{"type": "function", "function": {
    "name": "douyin_video_stats",
    "description": "Like statistics for the first page (up to 20) of a Douyin account's videos.",
    "parameters": {"type": "object", "properties": {"sec_user_id": {"type": "string"}},
                   "required": ["sec_user_id"]}}}]


def run(task: str, model: str = MODEL, max_tokens: int = 1500) -> dict:
    """One agent run over Chat Completions. Returns the parsed FINAL json plus usage and list-price cost."""
    messages = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": task}]
    usage, ids = [0, 0], []
    for _ in range(6):
        resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS, timeout=240,
                             json={"model": model, "max_tokens": max_tokens,
                                   "tools": TOOLS, "messages": messages})
        resp.raise_for_status()
        body = resp.json()
        ids.append(body.get("id"))
        usage[0] += body["usage"]["prompt_tokens"]
        usage[1] += body["usage"]["completion_tokens"]
        choice = body["choices"][0]
        msg = choice["message"]
        messages.append({k: v for k, v in msg.items() if k in ("role", "content", "tool_calls")})
        if choice.get("finish_reason") == "length":
            raise RuntimeError(f"output cut at max_tokens={max_tokens}")
        calls = msg.get("tool_calls") or []
        if not calls:
            found = re.search(r"FINAL:\s*(\{.*\})", msg.get("content") or "", re.S)
            if not found:
                raise RuntimeError("no FINAL line")
            price_in, price_out = PRICE[model]
            cost = usage[0] / 1e6 * price_in + usage[1] / 1e6 * price_out
            return {"model": model, "answer": json.loads(found.group(1)), "turns": len(ids),
                    "tokens": usage, "cost_usd": round(cost, 6), "completion_ids": ids}
        for call in calls:
            args = json.loads(call["function"].get("arguments") or "{}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": json.dumps(douyin_video_stats(**args))})
    raise RuntimeError("turn limit reached")


if __name__ == "__main__":
    task = ("For the Douyin account with sec_user_id "
            "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4, what is the average like count "
            "on the first page, rounded down? Keys: videos, average_likes.")
    print(json.dumps(run(task), ensure_ascii=False))
实测于 2026-10-04(UTC)。 00:14 原样运行上面的程序。输入是 T5 用过的人民日报公开抖音账号。数据请求:POST https://api.sandbase.ai/v1/api/douyin/app-v3/user-post-videos,请求体 {"sec_user_id": "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4", "max_cursor": 0, "count": 20}。返回节选:
{"id": "f013c20f-8f09-449b-a7a4-8a17462a2ea3", "status": "completed",
 "model": "douyin/app-v3/user-post-videos",
 "outputs": [{"data": {"aweme_list": [
   {"aweme_id": "7692418769125199138", "statistics": {"digg_count": 42839}},
   {"aweme_id": "7692417622113111323", "statistics": {"digg_count": 10500}}],
  "has_more": 1}}]}
aweme_list 只保留了 20 条里的前 2 条,每条只留 aweme_id 和 statistics.digg_count,其余字段(包括 data 和外层信封的其他键)都已省略。外层的 id、status、model、outputs[0].data 是文档写明的;aweme_list、aweme_id、statistics.digg_count、has_more 是这次返回里观察到的字段,不是文档承诺。
Gemini 3.8 Flash 调了一次工具,第二轮给出答案,程序输出:
{"model": "google/gemini-3.8-flash", "answer": {"videos": 20, "average_likes": 442266}, "turns": 2, "tokens": [365, 192], "cost_usd": 0.001988, "completion_ids": ["280ed183-bcf5-4f31-ba4e-335f79181841", "a3b50716-e388-450a-a82f-dc73475e0bcc"]}我们用这次返回的 20 个 digg_count 重新算了一遍,向下取整的平均数一致。192 个输出 token 里有 112 个是推理 token(在 completion_tokens_details 里观察到)。GET /v1/tasks/<id>/cost(同样要带 Bearer key)显示两次补全分别计费 $0.001485 和 $0.000503,合计正好是程序算出的 $0.001988,数据接口计费 $0。和题库里的 422,764 不一样,是因为账号在缓存之后又发了新视频,上面两条就不在缓存里。
接口的完整参数见 抖音 user-post-videos 接口文档。想对比别的模型,设置 AGENT_MODEL 即可。获取 SandBase API key 就能自己跑。
数据边界:这些都是公开、只读的查询,需要 SandBase API key。SandBase 不是抖音、微博、小红书的官方合作方,也不涉及私密账号、私信、账号后台数据或任何账号操作。题目、判分规则和汇总结果都在本文和链接的两篇实测里;缓存的工具返回和逐次日志含第三方内容,只在内部保存。
常见问题
Gemini 4 Argon API 现在能用吗?
截至 2026-10-04 还不能公开使用。Google 先开放给可信网络安全防御方,之后面向开发者,从付费 API 客户和 Google AI Ultra 订阅用户开始,没给日期。当天 SandBase 查询结果是“model not found”。
Gemini 4 Argon 价格是多少?
官方介绍价:输入 $2 / 百万 token,输出 $10 / 百万 token,缓存输入便宜 95%。官方没说介绍价持续多久。
Gemini 4 Argon 和 GPT-6.1 Sol 哪个便宜?
按 token 单价一样,Sol 在 SandBase 上也是 $2 / $10。按任务算要看 Argon 用多少 token:套用 Sol 在工具任务上的用量,两者都是 $0.0069;套用 3.1 Pro preview 那种长输出,Argon 要 $0.0117。质量对比只能等 Argon 能调用再说。
现在做 Agent 用哪个 Gemini?
按我们的数据:工具任务要准确,用 Gemini 3.1 Pro preview(47/51);Claude Code 写代码,或者要快又便宜一些的工具调用,用 Gemini 3.8 Flash(12/12,每任务 $0.29;工具题 46/51)。不管用哪个,算术都放进代码里。
Claude Code 能接 Gemini 吗?
能,走 SandBase 兼容 Anthropic 协议的 /v1/messages。Gemini 3.8 Flash 和 3.1 Pro preview 这次都是 12/12。Gemini 3.5 Flash-Lite 的运行全部以流式中断结束,正式用之前先把链路测通。
局限
本文没有测到 Argon 本身,关于 Argon 的事实都来自 Google 的一篇官方博文。实测每套程序只有一类任务,工具题每题 3 次、编码题每题 2 次,默认参数,1,500 token 的输出上限对最能写的模型不利。Gemini 和对照模型相隔数小时运行,耗时对比只能参考。成本是用量 × 标价,没有和账单逐次核对。Flash-Lite 的编码结果受流式错误影响,原因我们没有查清。Argon 开放后,建议用你自己的任务重跑一遍,我们也会。