Gemini 4 Argon 价格怎么算:12 月 1 日前后的真实成本
Gemini 4 Argon 价格详解:11 月 30 日前 $2/$10,之后 $4/$20,缓存输入只收 5%,1M 统一上限的影响,附实测账单和 Python 成本计算器。
先说个坑。我们拿一份 11,059 token 的政策文档连问了三个问题,三次返回的都是 cached_tokens: 0,每次在 SandBase 上扣约 $0.046。接着把其中一个问题原样再发一遍,这次显示 9,005 个缓存 token,只扣了 $0.0113,差不多是原价的四分之一。对大多数 Argon 业务来说,这个差距对账单的影响,比限时优惠价本身还大。
这篇是给要做预算的开发者写的 Gemini 4 Argon 价格 指南:12 月 1 日涨价后怎么算、缓存输入便宜 95% 实际能省多少、1M 统一 token 上限对长输出任务意味着什么。文中每一笔单次成本都来自 GET /v1/tasks/<id>/cost 的真实扣费,不是估算。所有测试在 2026-10-14 18:29–18:35 UTC 跑在 SandBase 上。
先说结论
- Google 官方价:2026 年 11 月 30 日前每百万输入 token $2、输出 $10;12 月 1 日起变成 $4 / $20。缓存输入只按输入价的 5% 计费(便宜 95%);Google 是在限时价里写的这条,标准价阶段没有重申。
- SandBase 上
google/gemini-4-argon现在就是 $4 / $20,缓存读取每百万 $0.20。这等于 Google 12 月起的标准价,是 Google 直连限时价的 2 倍。- SandBase 实测:一轮简短对话 $0.0018;11K token 的 RAG 提问未命中缓存 $0.0455,命中 9,005 个缓存 token 后 $0.0113;生成 9,789 个输出 token 的代码任务 $0.196。
- 12 次调用里,只有原样重发的请求命中了缓存(5/5),同一份文档换个新问题全部未命中(4/4)。预算要按自己测出来的命中率算。
- Artificial Analysis 按 $2 / $10 跑 Argon,每个 Intelligence Index 任务花 $1.99;换成 $4 / $20,同样的 token 约 $3.98,比 Claude Opus 5.5(Xhigh)的 $3.46 还贵。
Gemini 4 Argon 价格:你会看到的三个价
两个 Google 价、一个 SandBase 价,差别只存在于 11 月 30 日之前。Google Cloud 发布文(2026 年 10 月 13 日)一段话写清了两个阶段;Google 官方公告 给出限时价和缓存折扣,$4 / $20 的后续价写在区域版脚注里。
| 价格 | 输入 / 百万 | 缓存输入 / 百万 | 输出 / 百万 | 适用时间 |
|---|---|---|---|---|
| Google 直连限时价 | $2.00 | $0.10 | $10.00 | 2026-10-13 至 11-30 |
| Google 直连标准价 | $4.00 | $0.20(推定) | $20.00 | 2026-12-01 起 |
SandBase 标价(google/gemini-4-argon) | $4.00 | $0.20 | $20.00 | 现在,无限时优惠 |
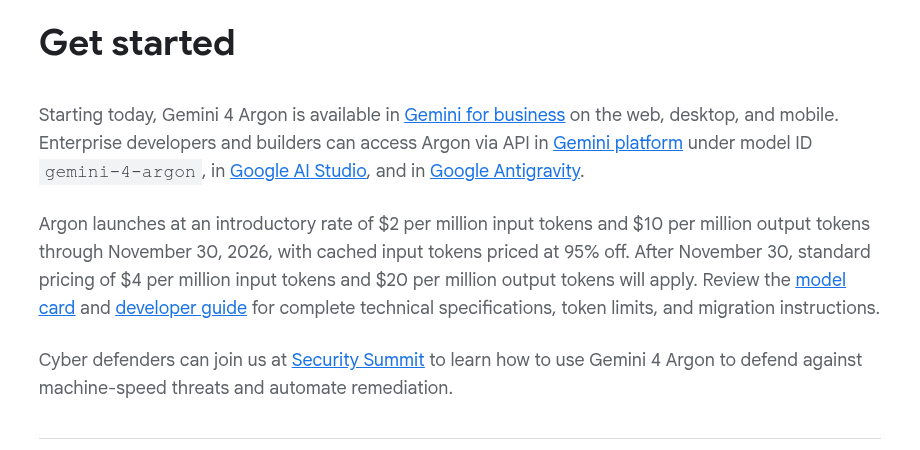
Google Cloud 发布文在同一段里写明了两个价格阶段和缓存输入便宜 95% 的规则,模型 ID 为 gemini-4-argon(2026-10-14 UTC 截图)。
直说:11 月 30 日前,通过 SandBase 调 Argon 的单价是 Google 直连的两倍;12 月 1 日起两边一样。SandBase 的价值在于一个 key、一个 OpenAI 兼容接口同时调 Argon、Claude、GPT,而不是 Argon 更便宜。如果你只用 Argon、12 月前预算又紧,直连 Google 更省。
Google 那段话把 95% 缓存折扣和限时价写在一起,标准价阶段没有重申;我们按沿用处理($0.20),也正是 SandBase 现在的缓存价。Google 的文章也没给缓存写入价或存储费。SandBase 的模型卡只有 cache_read_multiplier 0.05,没有写入倍率;我们所有调用的 cache_write_tokens 也都是 0。
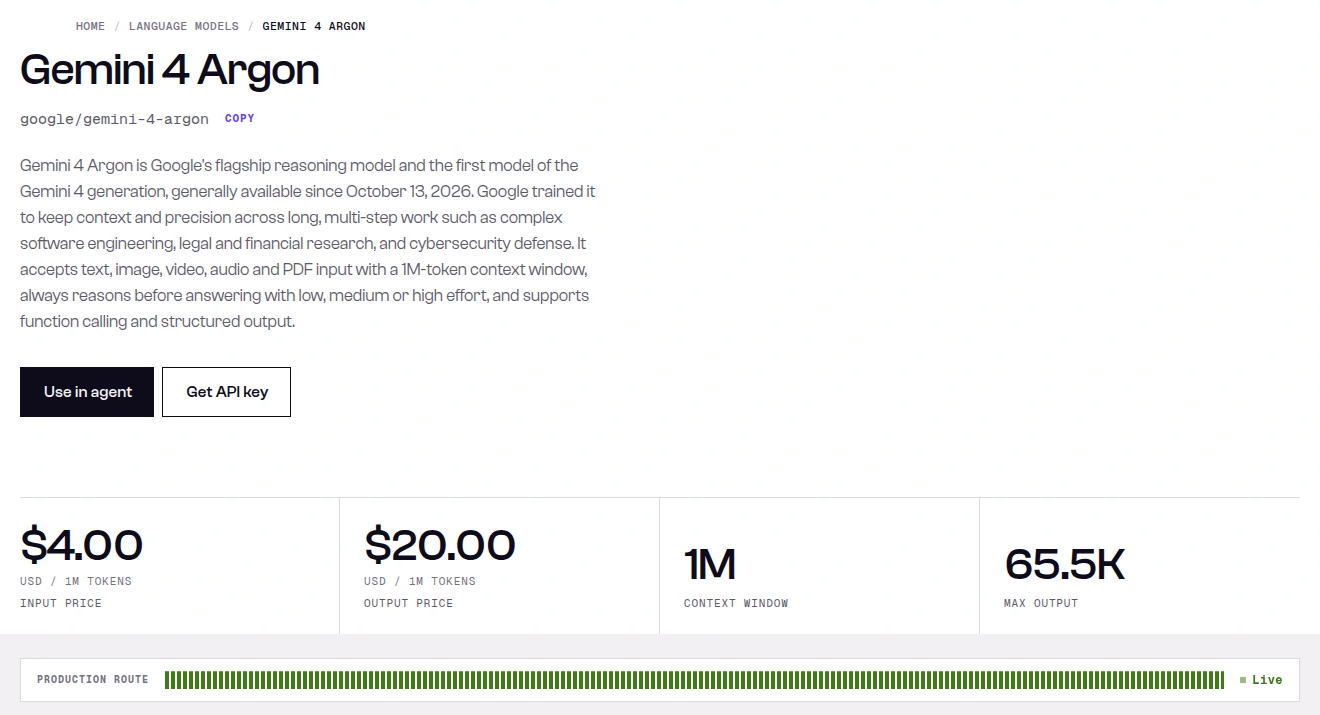
SandBase 模型页标价 $4.00 / $20.00 每百万 token,最大输出 65.5K,这个上限决定了长输出任务的预算天花板(2026-10-14 UTC 截图)。
和其他模型比,Argon 的标价在什么位置
按单价看,Argon 属于中档旗舰。下表是 2026-10-14 从 GET /v1/models/<id> 取的 SandBase 标价,缓存输入价 = 输入价 × 各模型卡的 cache_read_multiplier。
| 模型 | 输入 / 百万 | 缓存输入 / 百万 | 输出 / 百万 |
|---|---|---|---|
| Gemini 4 Argon | $4.00 | $0.20 | $20.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| Claude Sonnet 5.5 | $2.00 | $0.20 | $10.00 |
| Claude Fable 5.1 | $10.00 | $0.25 | $50.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
| Gemini 3.1 Pro preview | $2.00 | $0.20 | $12.00 |
| Gemini 3.8 Flash | $1.50 | $0.15 | $7.50 |
OpenAI 三款和 Gemini 3.1 Pro preview 在提示超过 272K / 200K token 后会切到更高的长上下文价,Argon 只有一档。Argon 和 Opus 5.5 单价完全相同,两者谁贵,就看谁更费 token。
每个任务花多少钱:独立评测的账
衡量”费不费 token”,目前最好的公开参照是 Artificial Analysis 跑 Intelligence Index 时每个任务的花费。数据来源:Artificial Analysis,Intelligence Index v4.3,数据截至 2026-10-12(免费层快照);每一行是”模型 × 推理强度”的组合,Argon 的测量配置是 “Gemini 4 Argon (High)“。完整排名见我们的 Argon 跑分排名文章。
| 配置(AA) | Intelligence Index | AA 计价 输入 / 输出 | 每个任务成本 |
|---|---|---|---|
| Claude Opus 5.5 (Max) | 57.6 | $4 / $20 | $5.98 |
| Claude Opus 5.5 (Xhigh) | 56.0 | $4 / $20 | $3.46 |
| Claude Opus 5.5 (High) | 53.6 | $4 / $20 | $1.82 |
| GPT-6 Astra (Max) | 52.7 | $10 / $50 | $3.26 |
| Gemini 4 Argon (High) | 52.6 | $2 / $10 | $1.99 |
| GPT-6 Astra (Xhigh) | 52.4 | $10 / $50 | $2.31 |
| Claude Sonnet 5.5 (Xhigh) | 51.9 | $2 / $10 | $2.01 |
| GPT-6.1 Sol (Max) | 51.8 | $2 / $10 | $0.72 |
关键在第三列:AA 用的是 Argon 的限时价。12 月 1 日后快照里 Argon 的所有价格都翻倍,同样的 token 每个任务约 $3.98。结论随之反转——按 $1.99 算,在 AA 得分 52 以上的 9 个配置里 Argon 是第二便宜的;按 $3.98 算,它比得分 56.0 的 Opus 5.5(Xhigh)还贵,是同单价、得分 53.6 的 Opus 5.5(High)的两倍多。
另一个信号:Argon 很能”吃” token。GPT-6.1 Sol(Max)单价同为 $2 / $10,得分只低 0.8,每个任务却只要 $0.72,折算下来 Argon(High)用的 token 大约是它的 2.8 倍。评测任务不等于你的业务(方法说明),但别看到 $2 / $10 就默认它便宜。
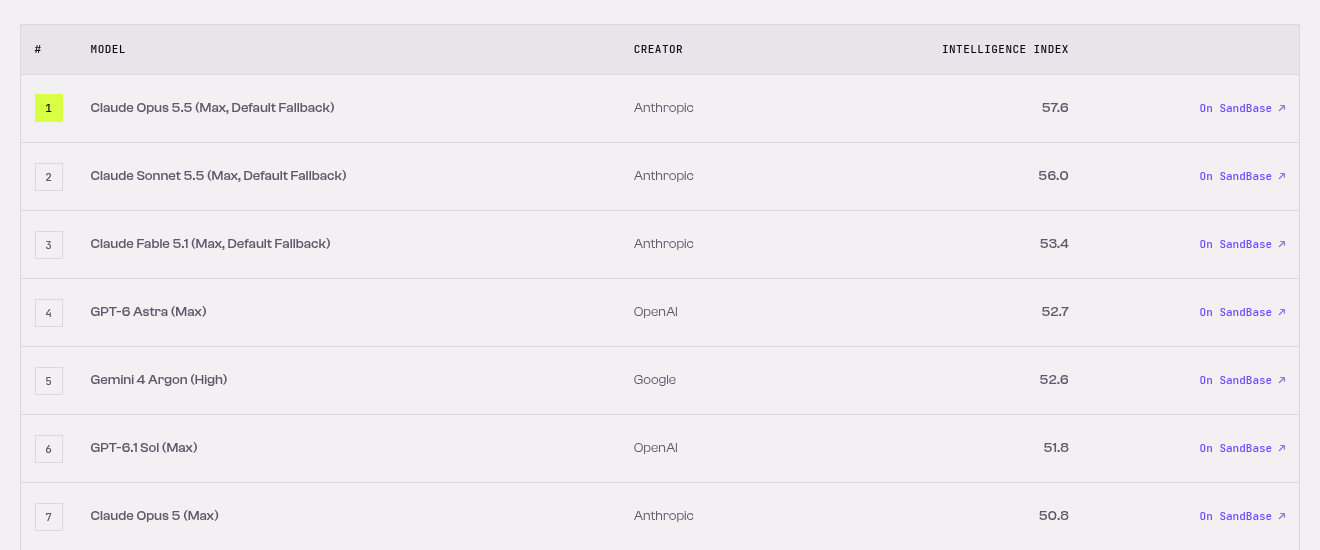
基于 Artificial Analysis 数据的 SandBase Lab 智能榜,在 87 个 SandBase 上架模型中把 Gemini 4 Argon (High) 以 52.6 排在第五;Lab 用的是 2026-10-14 快照(2026-10-14 UTC 截图)。
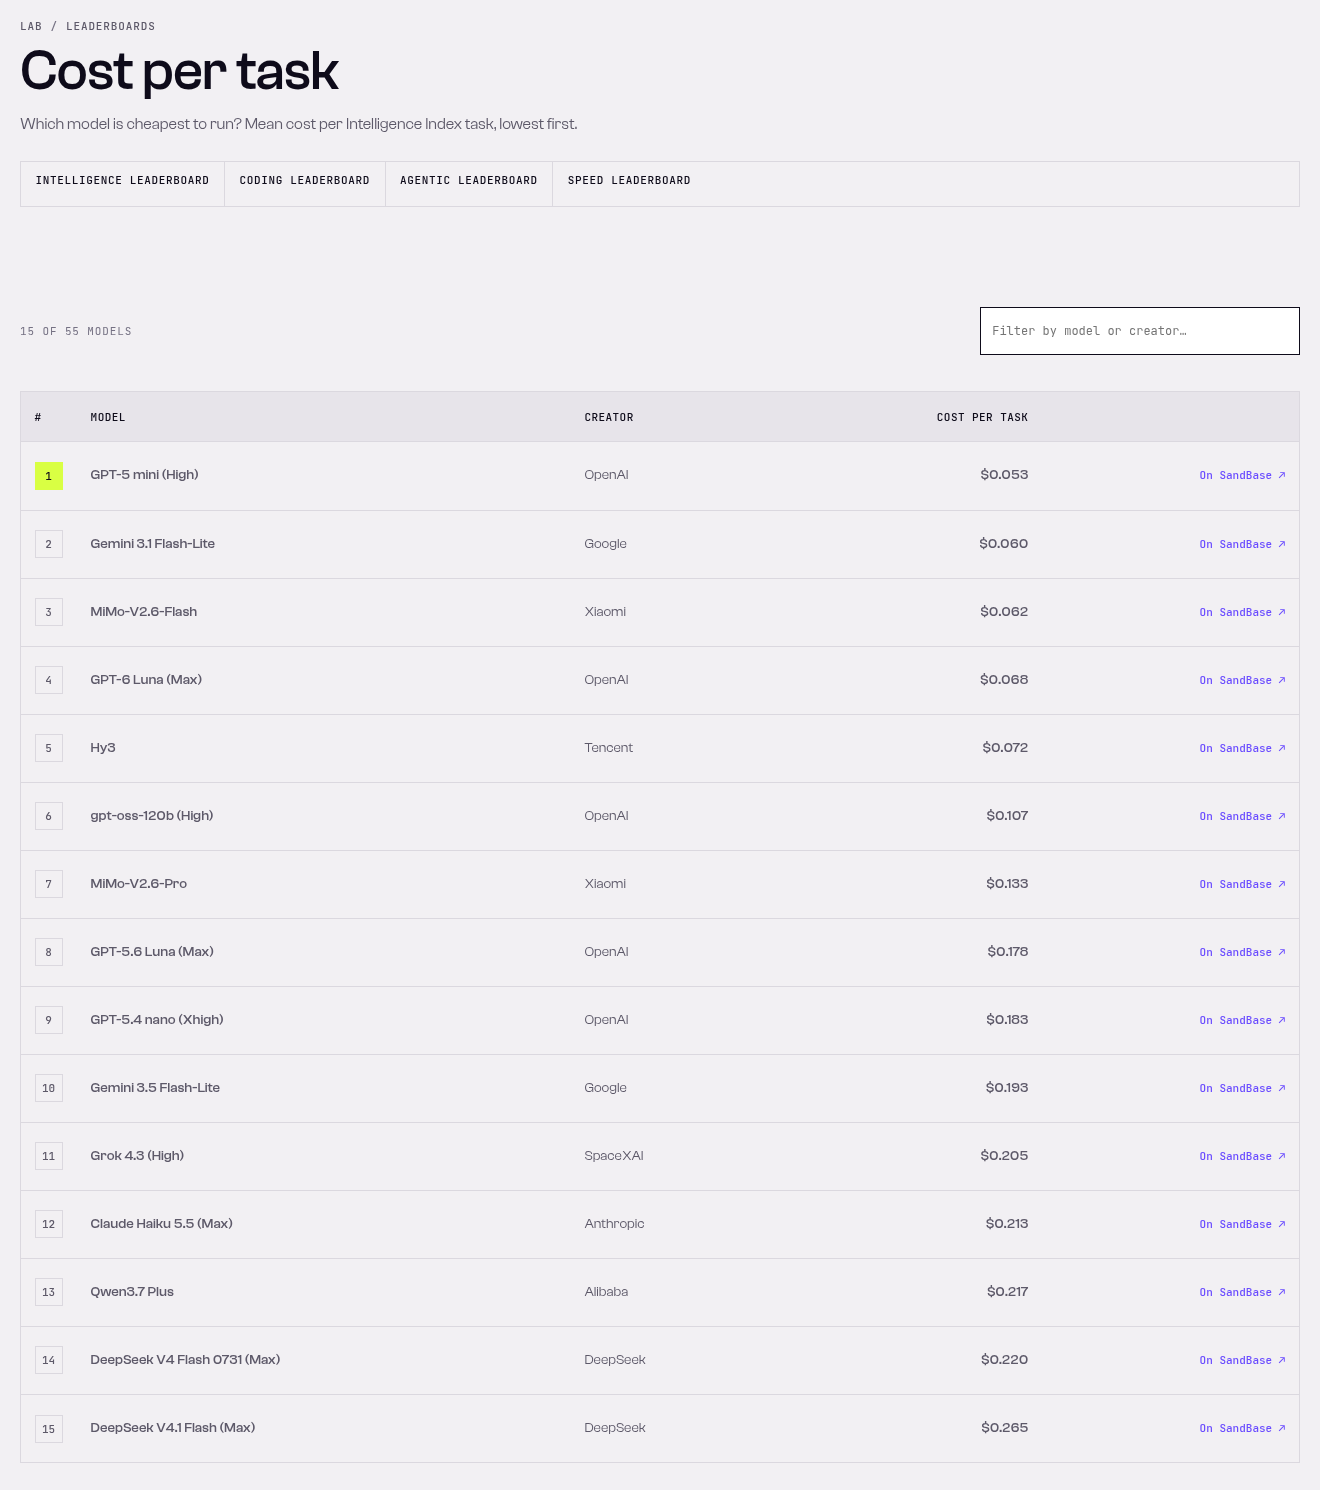
Lab 每任务成本榜从便宜往贵排,第 15 名是每任务 $0.265;Argon 即使按限时价算的 $1.99,也远在”低价档”之外(2026-10-14 UTC 截图)。
实算三种场景:对话、RAG、长输出
下面每一行都是一次真实的 SandBase 调用。token 数取自响应里的 usage,SandBase 一列就是 /v1/tasks/<id>/cost 实际扣的钱;限时价一列是把同样的 token 按 $2 / $10 算。
| 任务(2026-10-14 UTC 实测) | 输入 token(其中缓存) | 输出 token | Google 限时价 | 12 月起 Google / SandBase |
|---|---|---|---|---|
| 一轮对话,两句话回答 | 66(0) | 78 | $0.000912 | $0.001824 |
| RAG 提问,11K 前缀,未命中 | 11,059(0) | 65 | $0.022768 | $0.045536 |
| RAG 提问,同一请求重发 | 11,059(9,005) | 63 | $0.005639 | $0.011277 |
| 长输出:Python 模块 + 测试 | 86(0) | 9,789 | $0.098062 | $0.196124 |
拆开算一下命中缓存的那次(按 $4 / $20):新鲜输入 (11,059 − 9,005) × $4/M = $0.008216,缓存输入 9,005 × $0.20/M = $0.001801,输出 63 × $20/M = $0.001260,合计 $0.011277,和 /cost 扣的一分不差。
换算成月度(推算,不是实测):
| 月用量(推算) | Google 限时价 | 12 月起 / SandBase |
|---|---|---|
| 个人项目:3,000 轮对话(同第 1 行) | $2.74 | $5.47 |
| 创业团队:5 万次 RAG 提问,缓存命中 0% | $1,138 | $2,277 |
| 创业团队:5 万次 RAG 提问,命中 50% | $710 | $1,420 |
| 团队:2,000 次长输出任务(同第 4 行) | $196 | $392 |
最容易算错的是 RAG。命中率 50% 能省 38%,全部命中能省 75%。但从我们的结果看,这两个数都不能想当然。
缓存到底命中了多少
12 次调用里有 9 次用的是同一份 11,059 token 的系统提示(240 条编号政策条款)。结果是这样的:
- 四个不同问题的首次发送(三个在 20 秒内,一个约两分钟后):
cached_tokens全是 0。 - 五次重发已经问过的问题(距首次 20 秒到 3 分钟不等):每次都命中 9,005 或 9,006 个缓存 token,约占提示的 81%。
- 其中两次重发把系统提示包成了 Anthropic 风格的
cache_control块,命中情况和普通重发一样,看不出这个标记有作用。
同一个 11K 前缀、换个新问题为什么不命中?这块没有确切答案:缓存的 key 怎么算、请求怎么路由、新前缀多久才能被缓存,都有可能。这只是一天的观察,不是规律。建议给每次调用记下 prompt_tokens_details.cached_tokens,跑一周,用真实命中率做预算,别直接按”所有输入都便宜 95%“来算。
1M 统一上限,对长输出任务意味着什么
Google 说 Argon 通过 Gemini API 提供 1M 的”统一输入输出 token 上限”,模型卡 也写明输入加输出合计最多 1M token。落到成本上有两点。
第一,输入和输出共用一个额度:塞进 700K token 的文档,回答最多只剩 300K。第二,输出单价是输入的 5 倍,钱主要花在长回答上。直连 Google 一次输入 200K、输出 800K,限时价 $8.40,12 月起 $16.80,其中 $16 是输出。Google 还提到一个”continuation protocol”,它的文档我们没访问到,这里不做定价。
SandBase 目前不一样:模型页写最大输出 65.5K,schema 里 max_tokens 上限 65,536,所以单次响应的输出费最多约 $1.31(按限时价折算约 $0.66)。我们发了一次 max_tokens: 100000、内容是 “Say OK.” 的请求,返回 HTTP 200、6 个 token——说明请求不会被拒,但看不出长回答会不会在 65,536 处被截断。按单次最多 65.5K 输出来规划比较稳妥。
长输出那次,我们让 Argon 写一个自包含的 Python 键值存储:带 TTL、LRU 淘汰、JSON 快照,外加至少 40 个单元测试。它用 70.7 秒返回 9,789 个输出 token,finish_reason: stop,花 $0.196;本地跑了一下,42 个测试全部通过。只是一次运行,但可以当个参考单位:在 SandBase 上每 1 万输出 token 约 $0.20,按 Google 限时价约 $0.10。
还有一个没解开的问题:SandBase 的介绍说 Argon 回答前总会推理,可 12 次调用的 reasoning_tokens 全是 0。从外部看不出推理是并进了 completion_tokens,还是这些提示根本没触发。不过在我们的 Python 调用教程里,一道更难的数学题确实报出了推理 token,而且算在 completion_tokens 里按输出价计费。反正计费看的是 completion_tokens,用你自己的提示测一下就知道。
Python 成本计算器,对过真实账单
按 API 返回的 usage 计算单次成本。注意 prompt_tokens 已经包含缓存 token,SandBase 计费也是这个口径。
"""Gemini 4 Argon cost calculator (prices as of 2026-10-15, USD per 1M tokens)."""
CACHE_READ_FACTOR = 0.05  # cached input is 95% off the input rate
RATES = {
    "google-intro": (2.00, 10.00),     # Google direct, through Nov 30, 2026
    "google-standard": (4.00, 20.00),  # Google direct, from Dec 1, 2026
    "sandbase": (4.00, 20.00),         # SandBase list price for google/gemini-4-argon
}


def argon_cost(prompt_tokens: int, completion_tokens: int, cached_tokens: int = 0,
               rate: str = "sandbase") -> float:
    """Cost of one call. prompt_tokens includes cached_tokens, as in the API's usage block."""
    if not 0 <= cached_tokens <= prompt_tokens:
        raise ValueError("cached_tokens must be between 0 and prompt_tokens")
    price_in, price_out = RATES[rate]
    fresh = prompt_tokens - cached_tokens
    return (fresh * price_in
            + cached_tokens * price_in * CACHE_READ_FACTOR
            + completion_tokens * price_out) / 1_000_000


if __name__ == "__main__":
    # usage blocks copied from real SandBase responses on 2026-10-14 (UTC)
    runs = {
        "chat turn": (66, 78, 0),
        "RAG, cache miss": (11059, 65, 0),
        "RAG, cache hit": (11059, 63, 9005),
        "long output": (86, 9789, 0),
    }
    for name, (p, c, k) in runs.items():
        row = {r: round(argon_cost(p, c, k, r), 6) for r in RATES}
        print(f"{name:16} {row}")
对账方法:把 POST https://api.sandbase.ai/v1/chat/completions 响应里的 id 传给 GET /v1/tasks/<id>/cost,用同一个 Bearer key(见 Chat Completions 指南)。命中缓存的那次 RAG 调用(6a4939b2-b988-4dc1-87b4-3449767e7d93)返回如下(已删减):
{"status": "completed", "settled": true, "currency": "USD", "cost": "0.011277",
 "usage": {"prompt_tokens": 11059, "completion_tokens": 63, "cached_tokens": 9005,
           "cache_creation_tokens": 0, "reasoning_tokens": 0}}
12 次调用,计算器的 sandbase 结果和实际扣费全部一致,包括 5 次命中缓存的。本文测试总花费 $0.4366。
怎么把 Argon 账单压下来
- 可缓存的前缀保持逐字节一致:文档和指令放前面,用户问题放最后,然后去看
cached_tokens。 max_tokens按任务需要设。一次失控的 65K 回答在 SandBase 上就是 $1.31。- 便宜的轮次交给别的模型:GPT-6.1 Sol 在 SandBase 标价 $2 / $10,GPT-6 Luna 只要 Argon 的四十分之一。
- 如果直连 Google,评测和补数类任务尽量在 11 月 30 日前跑完,同样的 token 半价。
- 按 $2 / $10 做的预算表,现在就加一列 $4 / $20。
怎么调用 Argon(流式、response_format、finish_reason 处理),看 Argon API 调用教程;值不值得比 Opus 5.5、GPT-6 Astra 多花钱,看 三款旗舰对比。正式开放前的背景信息在我们更早的 Argon 文章里。
常见问题
Gemini 4 Argon 多少钱?
直连 Google:2026 年 11 月 30 日前每百万输入 token $2、输出 $10,12 月 1 日起 $4 / $20,缓存输入只按输入价的 5% 计费(随限时价一起公布)。SandBase 现在是 $4 / $20,缓存读取每百万 $0.20。
在 SandBase 上调 Argon 比直连 Google 便宜吗?
不便宜。11 月 30 日前,SandBase 的 $4 / $20 是 Google 限时价的两倍;12 月 1 日起两边一致。
在 SandBase 上能拿到 1M 输出 token 吗?
不能。SandBase 标注单次最大输出 65.5K。Google 说的 1M 是 Gemini API 上输入加输出的统一上限。
缓存输入便宜 95%,是自动生效的吗?
原样重发请求时自动生效了,不需要额外参数:11,059 个输入 token 里有 9,005 个按缓存价计费。但在我们的测试里,同一前缀换新问题没有命中。
局限
这是同一账号、同一天的 12 次调用,提示都很短,文档是合成的;缓存行为以后也可能变。AA 的每任务成本反映的是它自己的评测任务、按限时价计算,翻倍的前提是 token 用量不变。我们没测 Google 直连、continuation protocol,也没测超过 9,789 个输出 token 的单次响应。价格截至 2026-10-14 UTC,定预算前请再看一眼 Argon 模型页。