Gemini 4 Argon API 调用教程:Python 实测流式、工具调用和 JSON 输出
Gemini 4 Argon API 调用教程:用 Python(requests 或 openai SDK)调用 google/gemini-4-argon,覆盖流式输出、函数调用、JSON Schema 结构化输出、图片输入、max_tokens 截断和错误重试,每段代码都实跑过。
先说我踩的第一个坑:调 Gemini 4 Argon,HTTP 200,内容却是空字符串。
当时 max_tokens 设的是 300,问的是一道计数题。返回里 finish_reason 是 "length",content 是 ""。翻 usage 才看明白:300 个 completion token 里有 297 个是推理 token,我一个字也看不到,但 300 个全按输出价计费。下面这篇 Gemini 4 Argon API 调用教程,很多写法都是被这一次返回逼出来的。
本文面向想直接拿代码干活的 Python 开发者:通过 SandBase 的 OpenAI 兼容 Chat Completions 接口调用 google/gemini-4-argon,requests 和 openai SDK 两种写法都给。所有代码都在 2026-10-14 18:27 至 18:36(UTC)对线上模型实跑过,文中每一笔费用都来自 GET /v1/tasks/<id>/cost 的返回,不是我按单价估算的。
先说结论
openaiSDK 把base_url设成https://api.sandbase.ai/v1,模型 id 写google/gemini-4-argon就能用。流式、并行工具调用、response_formatJSON Schema、base64 图片输入,第一次就都跑通了。- 隐藏的推理 token 和可见回答共用
max_tokens。设 300 时三次实测都返回空内容,并按 300 个输出 token 计费;设 16000 时用 1,381 个 token 答对。reasoning_effort能传,但不校验:"low"、"high",连"banana"都返回 200。一道难题上各跑 3 次,推理 token 中位数分别是 888(low)、1,144(不传)、1,409(high),只能算迹象,不能算证明。- 请求漏了
messages,SandBase 返回的是 503 而不是 400。“遇到 5xx 就重试”的通用逻辑会把一个 bug 重试好几遍,所以发请求前先在本地校验。- 首轮 35 次计费调用一共花了 $0.30,按 SandBase 标价 $4 / $20 每百万 token 计。
准备工作
需要 Python 3.10 以上、环境变量 SANDBASE_API_KEY,再装两个包。我用的版本是 openai==2.8.1 和 requests==2.32.5。
python3 -m venv .venv && source .venv/bin/activate
pip install "openai==2.8.1" "requests==2.32.5"
export SANDBASE_API_KEY="your-key"
动手前有两件事要心里有数。
一是价格。SandBase 上 Argon 标价是输入 $4、输出 $20 每百万 token,缓存读取按 0.05 倍计。这是 Google 在 2026 年 11 月 30 日优惠期结束后的标准价;优惠期内 Google 官方直连是 $2 / $10,所以眼下 SandBase 的单价是官方直连的两倍。这一点不绕弯子,细账见 Gemini 4 Argon 价格。
二是上限。模型页写的是 1M 上下文、65.5K 最大输出。Google 宣传的 1M 输入输出合计上限是它自家 Gemini API 的数字;通过 SandBase,目前单次回复按 65K 左右的输出来规划。
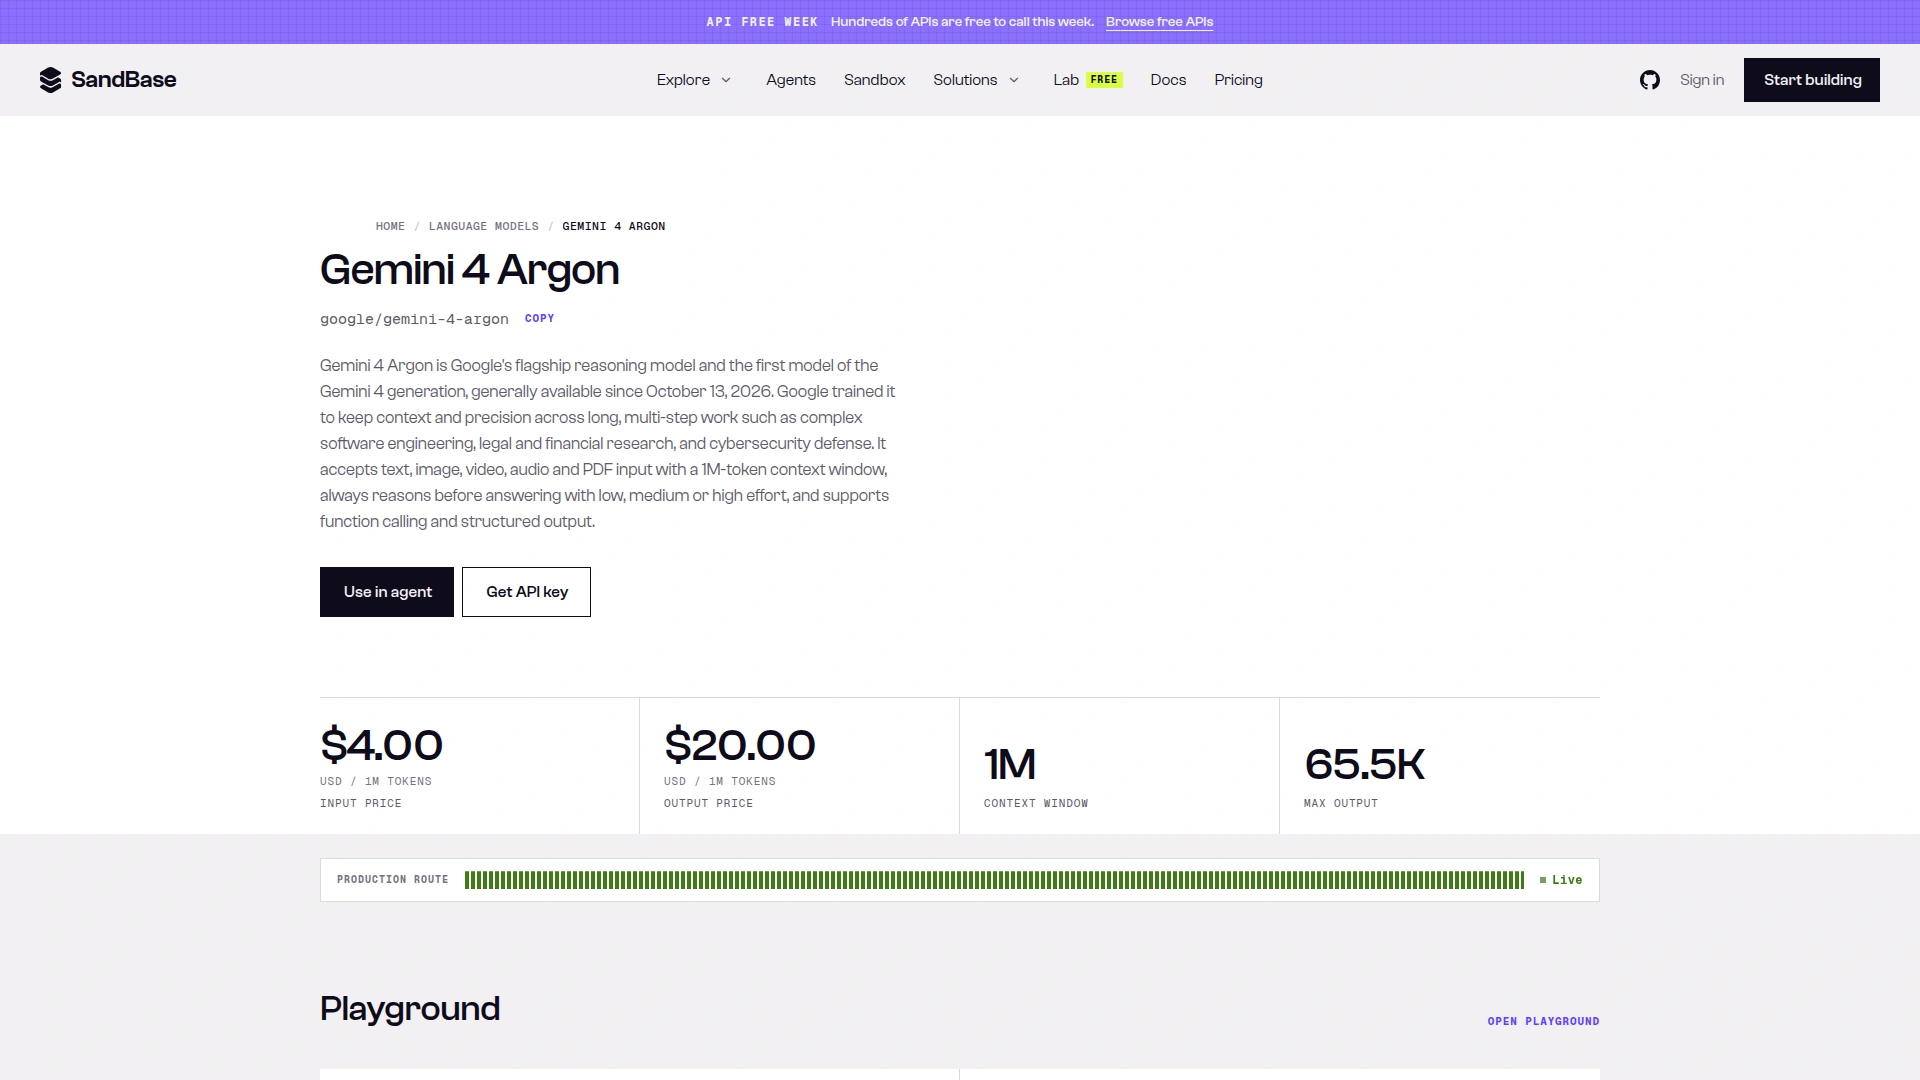 SandBase 模型页:本文所有代码用的模型 id、下文费用对应的 $4 / $20 标价,以及决定
max_tokens 上限的 65.5K 最大输出都在这里(2026-10-14 截图)。
第 1 步:用 requests 发一次请求
不用任何 SDK,后面所有步骤都是在这个结构上加东西。
import os
import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}

resp = requests.post(
    f"{BASE}/chat/completions",
    headers=HEADERS,
    json={
        "model": "google/gemini-4-argon",
        "messages": [
            {"role": "system", "content": "Answer in one sentence."},
            {"role": "user", "content": "What does HTTP status 429 mean for an API client?"},
        ],
        "max_tokens": 1024,  # covers hidden reasoning tokens AND the visible answer
    },
    timeout=120,
)
resp.raise_for_status()
body = resp.json()
choice = body["choices"][0]
print("id:", body["id"])
print("finish_reason:", choice["finish_reason"])
print("answer:", choice["message"]["content"])
print("usage:", body["usage"])

# What SandBase actually billed for this completion
cost = requests.get(f"{BASE}/tasks/{body['id']}/cost", headers=HEADERS, timeout=30).json()
print("billed:", cost["cost"], cost["currency"], "| settled:", cost["settled"])
18:28:30(UTC)的输出,只保留关键字段:
id: 1f83291f-8136-4572-8e06-706fbfdc1a5d
finish_reason: stop
answer: An HTTP status 429 ("Too Many Requests") means the API client has exceeded the server's allowed rate limit ...
usage: {'completion_tokens': 45, 'completion_tokens_details': {'reasoning_tokens': 0}, 'prompt_tokens': 55, ...}
billed: 0.001120 USD | settled: True
账对得上:55 × $4/M + 45 × $20/M = $0.00112。返回里的 id 记得存下来,之后对账全靠它。
第 2 步:openai SDK 改 base_url
SandBase Chat Completions 文档说,现有 OpenAI SDK 代码只要换 key 和 base URL。实测确实如此。SandBase 没有自己的 SDK,用的就是官方 openai 包。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.sandbase.ai/v1",
    api_key=os.environ["SANDBASE_API_KEY"],
    timeout=120,
    max_retries=2,  # SDK default; retries 408/409/429/5xx and connection errors
)

completion = client.chat.completions.create(
    model="google/gemini-4-argon",
    messages=[{"role": "user", "content": "Name the three HTTP methods most REST APIs use for writes."}],
    max_tokens=1024,
)
choice = completion.choices[0]
print("id:", completion.id)
print("finish_reason:", choice.finish_reason)
print("answer:", choice.message.content)
u = completion.usage
print("prompt:", u.prompt_tokens, "| completion:", u.completion_tokens,
      "| reasoning:", u.completion_tokens_details.reasoning_tokens)
18:28:34 返回了 POST、PUT、PATCH,44 个输入 token、143 个输出 token,推理 token 为 0,计费 $0.003036。注意:我没要求格式,它也默认回了 Markdown 列表。如果你要渲染成纯文本,得在 system prompt 里说清楚。
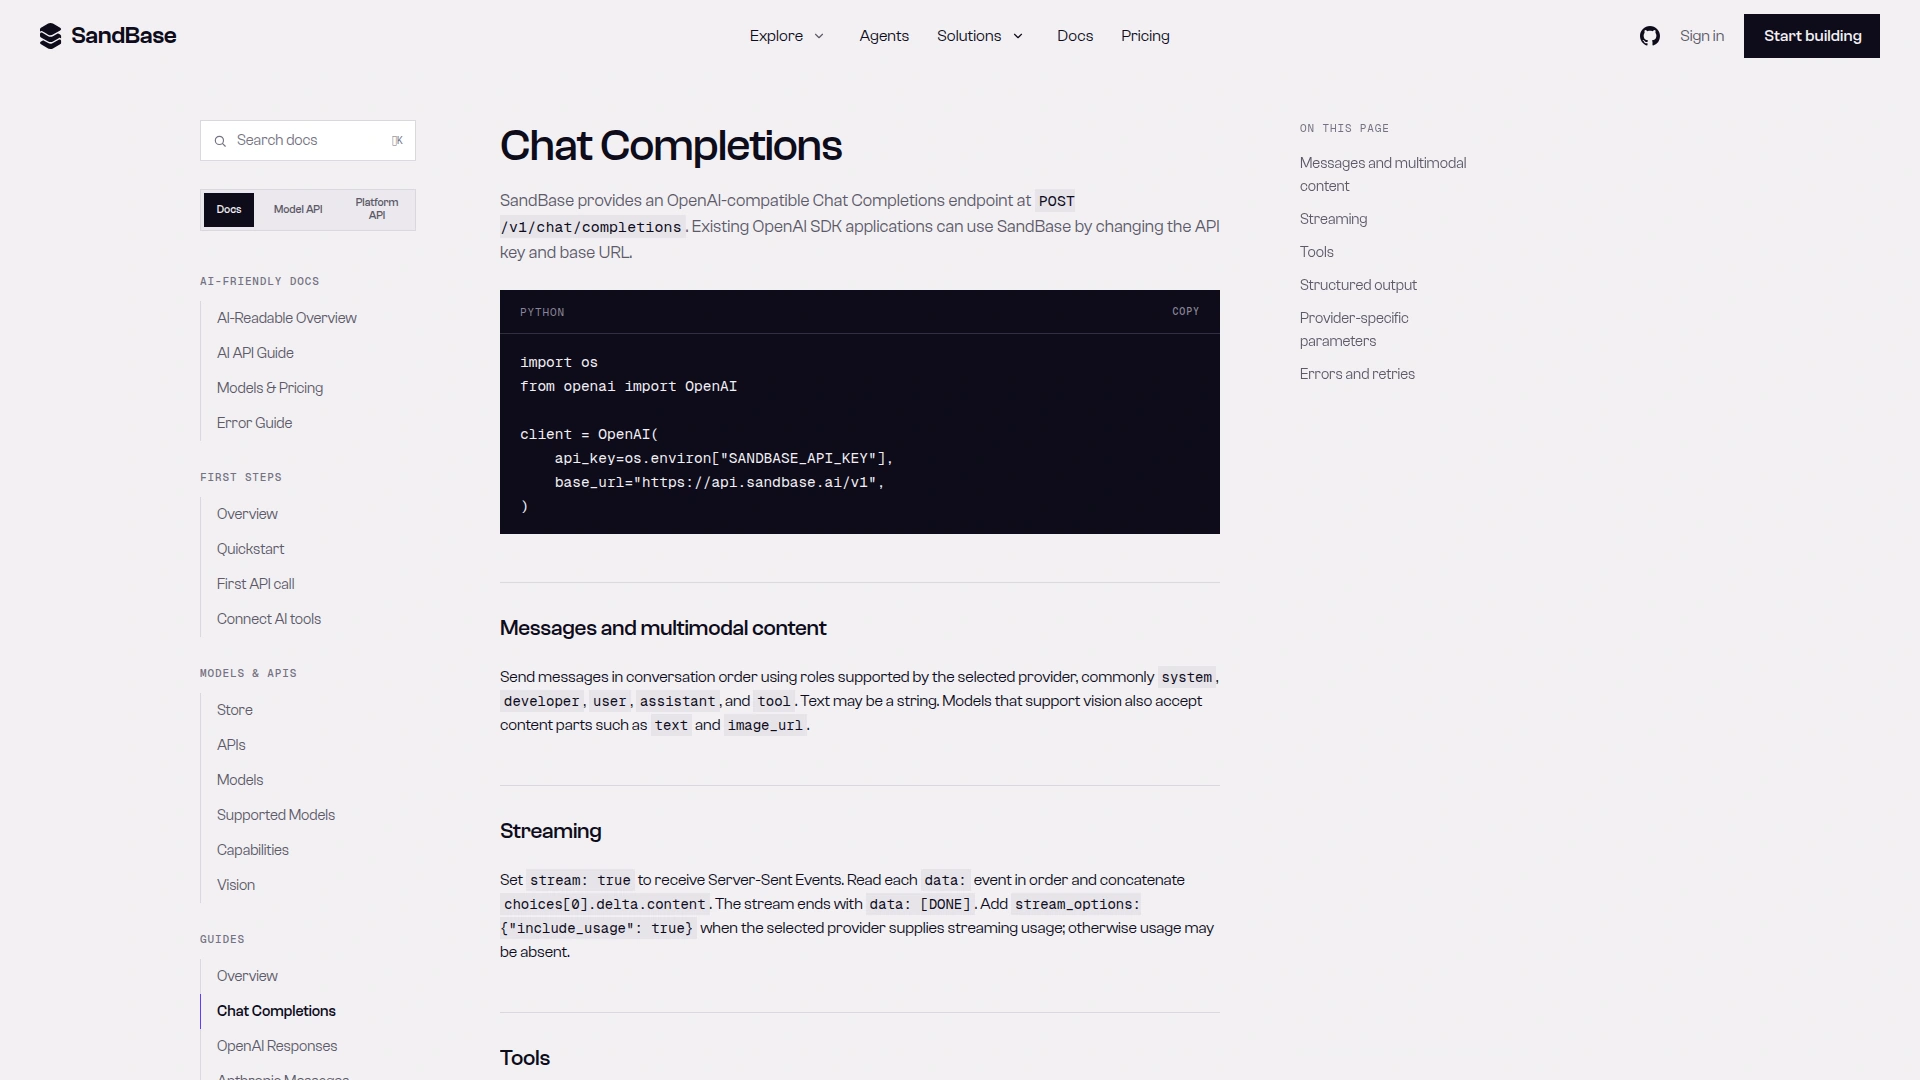 SandBase Chat Completions 文档:第 2、3、6 步用到的 base URL、
image_url 内容块和 stream_options.include_usage 都出自这一页(2026-10-14 截图)。
第 3 步:流式输出,最后拿 usage
import os
import time
from openai import OpenAI

client = OpenAI(base_url="https://api.sandbase.ai/v1", api_key=os.environ["SANDBASE_API_KEY"])

start = time.monotonic()
first_token_at = None
parts, usage, finish, completion_id = [], None, None, None

stream = client.chat.completions.create(
    model="google/gemini-4-argon",
    messages=[{"role": "user", "content": "Write a 4-line poem about rate limits."}],
    max_tokens=2048,
    stream=True,
    stream_options={"include_usage": True},  # ask for a final chunk carrying usage
)
for chunk in stream:
    completion_id = completion_id or chunk.id
    if chunk.usage:  # final chunk: usage, usually with empty choices
        usage = chunk.usage
    for choice in chunk.choices:
        if choice.delta and choice.delta.content:
            if first_token_at is None:
                first_token_at = time.monotonic() - start
            parts.append(choice.delta.content)
            print(choice.delta.content, end="", flush=True)
        if choice.finish_reason:
            finish = choice.finish_reason

print()
print("id:", completion_id)
print("finish_reason:", finish)
print(f"first visible token after {first_token_at:.1f}s, total {time.monotonic() - start:.1f}s")
print("usage:", usage)
18:28:39 这次,首个可见 token 在 2.7 秒到达,3.0 秒结束,usage 是 42 进 46 出。这只是我这边网络的一次结果,不是延迟测评。
做账本之前要知道一个细节:流式 chunk 的 id 长这样 chatcmpl-14e87e61-e706-...,非流式返回的是不带前缀的 UUID。拿带前缀的 id 去查 /v1/tasks/<id>/cost,返回 404 “task not found”;去掉前缀再查,正常拿到费用($0.001088)。所以写成 task_id = completion_id.removeprefix("chatcmpl-")。
第 4 步:函数调用,完整走一轮
套路是标准的:传 tools,模型要什么就执行什么,每个调用追加一条带对应 tool_call_id 的 tool 消息,然后再问一次。这里的工具是本地字典,结果可以核对。
import json
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.sandbase.ai/v1", api_key=os.environ["SANDBASE_API_KEY"])
MODEL = "google/gemini-4-argon"

# A local, deterministic "tool" so the result is checkable.
ORDERS = {"A-1001": {"status": "shipped", "carrier": "DHL", "eta": "2026-10-17"},
          "A-1002": {"status": "processing", "carrier": None, "eta": None}}

def get_order_status(order_id: str) -> dict:
    return ORDERS.get(order_id, {"error": f"unknown order {order_id}"})

TOOLS = [{
    "type": "function",
    "function": {
        "name": "get_order_status",
        "description": "Look up shipping status for one order id.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string", "description": "Order id like A-1001"}},
            "required": ["order_id"],
        },
    },
}]

messages = [{"role": "user", "content": "Where are orders A-1001 and A-1002? One line each."}]
ids, total_in, total_out = [], 0, 0

for turn in range(5):  # hard cap so a confused model can't loop forever
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=TOOLS, max_tokens=2048)
    ids.append(resp.id)
    total_in += resp.usage.prompt_tokens
    total_out += resp.usage.completion_tokens
    msg = resp.choices[0].message
    print(f"turn {turn}: finish_reason={resp.choices[0].finish_reason} tool_calls={len(msg.tool_calls or [])}")

    if not msg.tool_calls:
        print("answer:", msg.content)
        break

    # Echo the assistant turn back exactly, including tool_calls, before adding tool results.
    messages.append(msg.model_dump(exclude_none=True))
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments or "{}")
        result = get_order_status(**args)
        print(f"  -> {call.function.name}({args}) = {result}")
        messages.append({"role": "tool", "tool_call_id": call.id, "content": json.dumps(result)})
else:
    raise RuntimeError("tool loop did not finish in 5 turns")

print("completion ids:", ids)
print("tokens in/out:", total_in, total_out)
Argon 在第 0 轮就一次性发了两个并行 tool_calls,把两个订单都查了;第 1 轮直接作答,对没有承运商的那个订单也没瞎编。
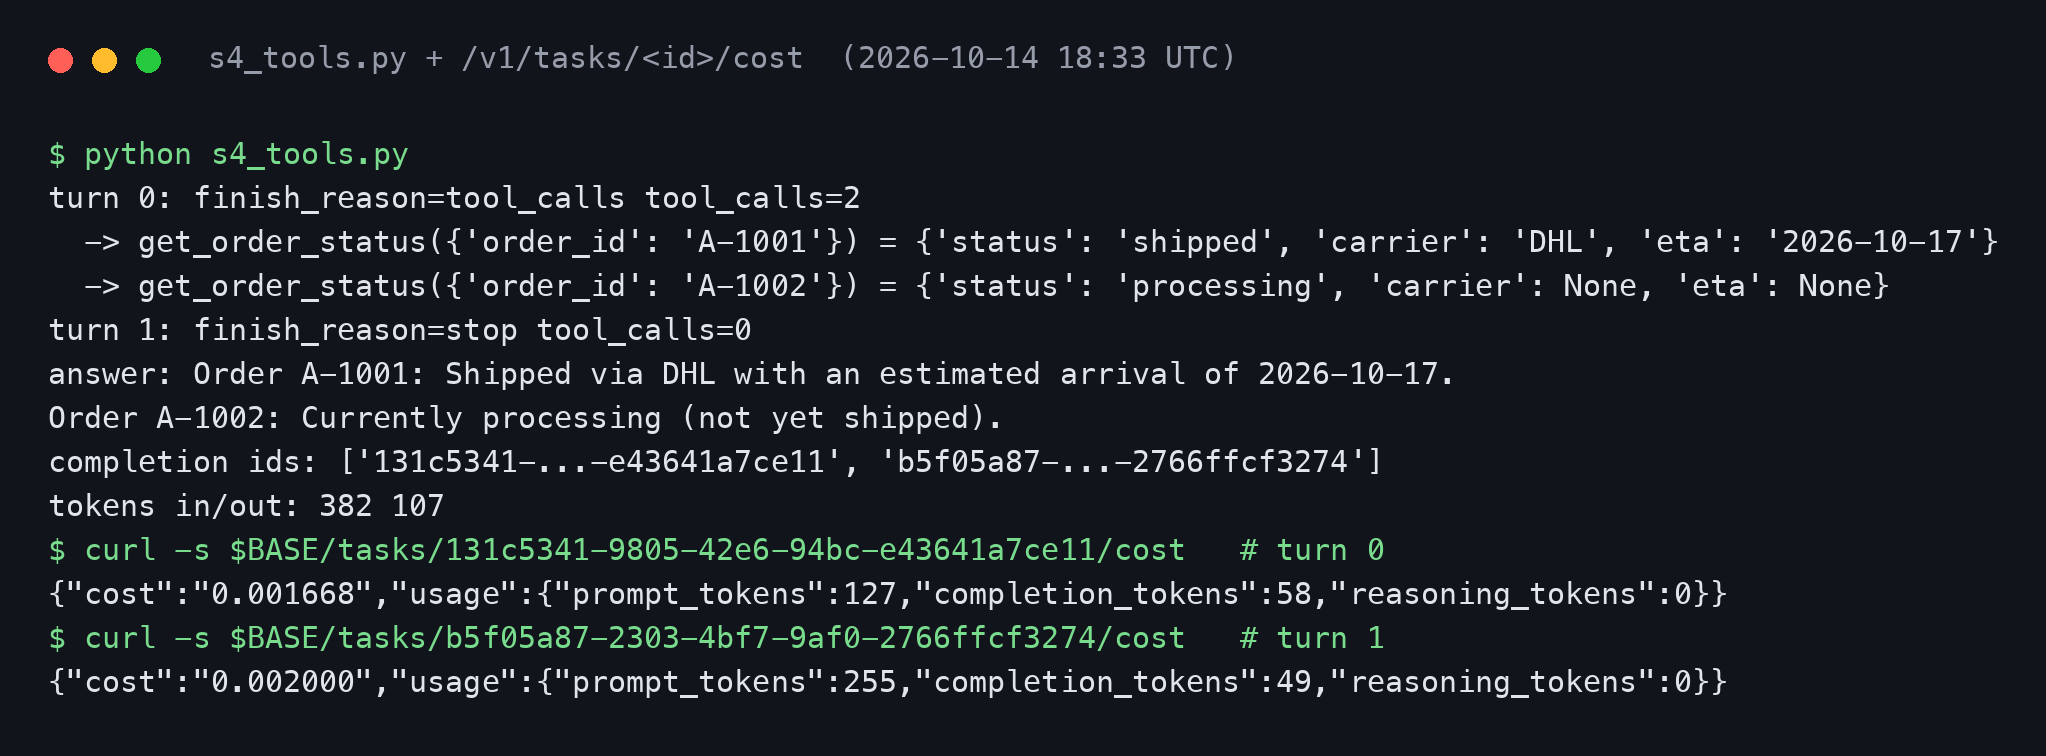 第 4 步在 18:33(UTC)的真实输出,渲染成图片:第 0 轮两个并行工具调用,第 1 轮基于工具结果作答,以及
/v1/tasks/<id>/cost 给出的每轮费用(JSON 只保留 cost 和 usage)。
两轮分别是 $0.001668 和 $0.002000。第 1 轮的输入(255 token)是第 0 轮(127)的两倍,因为整段对话连同工具结果每轮都要重新发一遍。做十轮的 agent,账单主要就涨在这里。
第 5 步:response_format 结构化输出
import json
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.sandbase.ai/v1", api_key=os.environ["SANDBASE_API_KEY"])

SCHEMA = {
    "type": "object",
    "properties": {
        "vendor": {"type": "string"},
        "invoice_number": {"type": "string"},
        "total_usd": {"type": "number"},
        "line_items": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {"description": {"type": "string"}, "amount_usd": {"type": "number"}},
                "required": ["description", "amount_usd"],
                "additionalProperties": False,
            },
        },
    },
    "required": ["vendor", "invoice_number", "total_usd", "line_items"],
    "additionalProperties": False,
}

TEXT = ("Invoice INV-2291 from Northwind Hosting. Dedicated server October: $1,200.00. "
        "Backup storage 2 TB: $80.00. Support plan: $150.00. Amount due: $1,430.00.")

resp = client.chat.completions.create(
    model="google/gemini-4-argon",
    messages=[{"role": "user", "content": f"Extract the invoice fields.\n\n{TEXT}"}],
    response_format={"type": "json_schema",
                     "json_schema": {"name": "invoice", "strict": True, "schema": SCHEMA}},
    max_tokens=2048,
)
choice = resp.choices[0]
if choice.finish_reason != "stop":
    raise RuntimeError(f"incomplete JSON risk: finish_reason={choice.finish_reason}")

data = json.loads(choice.message.content)  # raises if the model returned non-JSON
missing = [k for k in SCHEMA["required"] if k not in data]
if missing:
    raise ValueError(f"missing keys: {missing}")
items_sum = round(sum(i["amount_usd"] for i in data["line_items"]), 2)
print("id:", resp.id)
print(json.dumps(data, indent=2))
print("line items sum:", items_sum, "| matches total:", items_sum == data["total_usd"])
18:33:14 返回的是纯 JSON,三条明细齐全,total_usd: 1430.0,加总校验通过;397 进 102 出,$0.003628。
我还故意想把它弄坏:同样的写法,换一个两字段的 schema,prompt 却要求”用一段友好的散文回答”。结果返回 {"city": "Tokyo", "country": "Japan"},一个多余的字都没有。只测了一次,算是好消息,不算保证。SandBase 文档自己也说 schema 强约束的支持程度因模型而异,所以代码里照样 parse、照样查 finish_reason 和必填字段。
第 6 步:图片输入
视觉输入用 OpenAI 风格的 content parts,本地文件转成 base64 data URL 传进去。我自己画了一张四根柱子的图,数值已知(Mon 42、Tue 77、Wed 31、Thu 64),方便判对错。
import base64
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.sandbase.ai/v1", api_key=os.environ["SANDBASE_API_KEY"])

with open("chart.png", "rb") as f:
    data_url = "data:image/png;base64," + base64.b64encode(f.read()).decode()

resp = client.chat.completions.create(
    model="google/gemini-4-argon",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "Read every bar label and value in this chart, then say which day is highest. "
                                     "Format: Day=value, ... ; highest=Day"},
            {"type": "image_url", "image_url": {"url": data_url}},
        ],
    }],
    max_tokens=2048,
)
print("id:", resp.id)
print("finish_reason:", resp.choices[0].finish_reason)
print("answer:", resp.choices[0].message.content)
print("usage: in", resp.usage.prompt_tokens, "out", resp.usage.completion_tokens)
18:34:04 的回答是 Mon=42, Tue=77, Wed=31, Thu=64 ; highest=Tue,全对。一张 640×400 的 PNG 加指令吃掉 1,153 个输入 token,$0.005152 的账单大头就是这张图。图片要按输入 token 算预算,别当成免费附件。
第 7 步:max_tokens 和 finish_reason
回到开头那个空回答。Argon 会先推理再作答,SandBase 把推理 token 算进 completion_tokens,按 $20/M 的输出价计费,而 max_tokens 管的是两者之和。一个看起来对一句话回答绰绰有余的上限,可能全被”想”用光了。
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.sandbase.ai/v1", api_key=os.environ["SANDBASE_API_KEY"])
MODEL = "google/gemini-4-argon"
PROMPT = "How many 7-digit positive integers have a digit sum of exactly 30? Reply with the number only."


def ask(prompt: str, max_tokens: int, retry_budget: int = 16000):
    resp = client.chat.completions.create(model=MODEL, max_tokens=max_tokens,
                                          messages=[{"role": "user", "content": prompt}])
    c, u = resp.choices[0], resp.usage
    print(f"max_tokens={max_tokens}: finish_reason={c.finish_reason} content={c.message.content!r} "
          f"completion={u.completion_tokens} reasoning={u.completion_tokens_details.reasoning_tokens} id={resp.id}")
    if c.finish_reason == "length":
        if max_tokens >= retry_budget:
            raise RuntimeError("still truncated at the retry budget; shorten the task instead")
        # Hidden reasoning shares this budget, so a short visible answer can still be cut off.
        return ask(prompt, retry_budget, retry_budget)
    return c.message.content


print("final:", ask(PROMPT, max_tokens=300))
正确答案是 453,438,我在本地暴力枚举过。
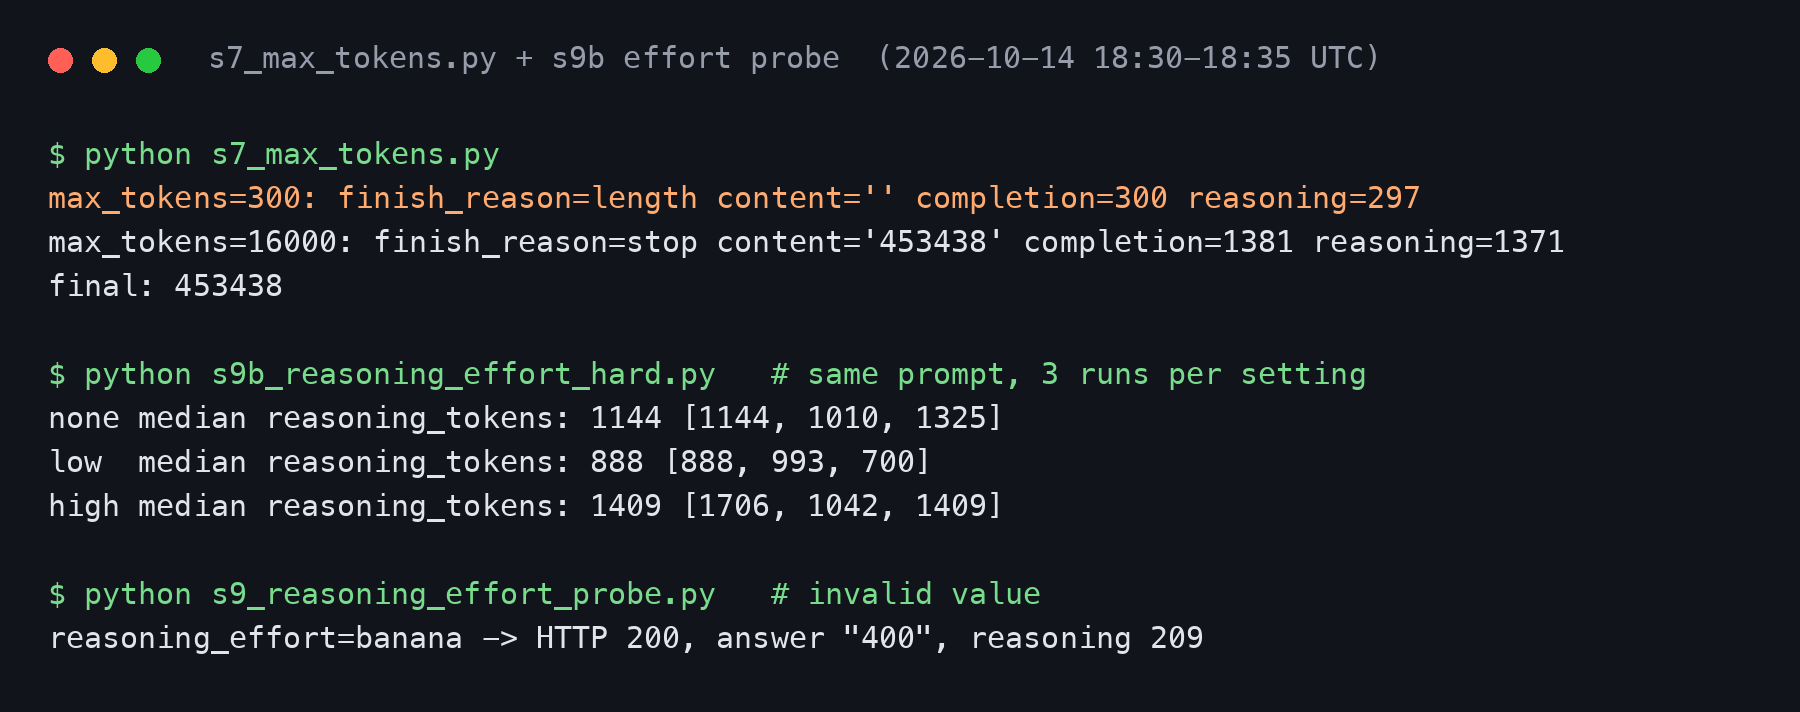 第 7 步和推理强度测试的真实输出(UTC 18:30 至 18:35):300 token 上限下回答为空、推理占了 297 个;三档 effort 的推理 token 区间互有重叠。
这不是偶然:同一个脚本跑了三次,300 token 那次每次都停在 297 个推理 token、内容为空。被截断的那次照样计费 $0.006220(55 进 300 出);重试那次 $0.027840,1,381 个输出 token 里只有 10 个是可见答案。
由此得出三条规矩:每次都看 finish_reason,不能只看 content;“内容为空 + length”的意思是预算给少了,不是模型拒答;推理模型别靠压低 max_tokens 省钱,上限要给够,成本靠 prompt 控制。
另一头,max_tokens=65536 能用,70,000 也返回 200,尽管模型 schema 写的上限是 65,536。这两次都只回了一个 “OK”,所以我说不清 70,000 是被截到上限还是原样透传。输出别指望超过 65K 左右。
推理强度:我测了什么,结果如何
SandBase 的模型介绍写着 Argon “回答前总会以 low、medium 或 high 强度推理”,但请求 schema 里并没有 effort 字段。所以动笔之前,我先把两种写法都实测了一遍。
简单题(一道整除计数,答案 400)上,reasoning_effort 设成 "low"、"high"、"banana",再加上 OpenRouter 风格的 reasoning: {"effort": ...} 对象,全都返回 200、全都答对,推理 token 在 0 到 209 之间乱跳,跟设置看不出关系。换成上面那道数位和难题,每档跑 3 次:
reasoning_effort | 每次推理 token | 中位数 | 答对 |
|---|---|---|---|
| 不传 | 1,144 / 1,010 / 1,325 | 1,144 | 3/3 |
"low" | 888 / 993 / 700 | 888 | 3/3 |
"high" | 1,706 / 1,042 / 1,409 | 1,409 | 3/3 |
方向符合预期,low 的每一次都比不传的每一次少。但 high 和不传有重叠,样本只有 3 次,非法值还被悄悄放行了。我的判断是:SandBase 要么透传这个字段,要么直接忽略,从外面分不出来。要用的话,只传 "low"、"medium"、"high",在自己的 prompt 上量 reasoning_tokens,别把一个 200 当成”设置已生效”。这 9 次难题调用一共 $0.208,是全文最大的一笔。
第 8 步:错误处理和重试
我用裸 requests 把常见错误都发了一遍,看真实状态码:
| 错误 | HTTP | 返回体(已裁剪) |
|---|---|---|
| API key 错误 | 401 | {"error":"invalid API key"} |
google/gemini-4-argon-preview | 404 | type: not_found_error,“model not found” |
gemini-4-argon(缺厂商前缀) | 404 | 同上 |
缺 messages 字段 | 503 | type: server_error,“Input required: specify “prompt” or “messages"" |
有两处出乎意料。401 的 error 是个字符串,其余都是 OpenAI 风格的对象,解析错误时要兼容两种。缺 messages 这种明明是客户端的错,却回 503,大多数通用重试策略(包括 openai SDK 自带的)都会把它当成临时故障。以上响应都没带 Retry-After 头。Google 模型卡也把”偶发的缓慢或超时”列为已知限制,所以超时给宽一点、重试设上限,都值得做。
import os
import random
import time
import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
RETRYABLE = {429, 500, 502, 503, 504}


class ArgonError(RuntimeError):
    pass


def chat(payload: dict, max_attempts: int = 3, timeout: float = 180) -> dict:
    if not payload.get("messages"):
        raise ArgonError("messages is empty; SandBase answers this with a 503, so catch it locally")
    for attempt in range(1, max_attempts + 1):
        try:
            r = requests.post(f"{BASE}/chat/completions", headers=HEADERS, json=payload, timeout=timeout)
        except (requests.Timeout, requests.ConnectionError) as exc:
            status, detail, retry_after = None, repr(exc), None
        else:
            if r.status_code == 200:
                return r.json()
            status, detail, retry_after = r.status_code, r.text[:200], r.headers.get("retry-after")
            if status not in RETRYABLE:
                raise ArgonError(f"HTTP {status}, not retrying: {detail}")
        if attempt == max_attempts:
            raise ArgonError(f"gave up after {attempt} attempts, last: HTTP {status} {detail}")
        delay = float(retry_after) if retry_after else min(30, 2 ** attempt) + random.random()
        print(f"  attempt {attempt}: HTTP {status}, sleeping {delay:.1f}s")
        time.sleep(delay)


msgs = [{"role": "user", "content": "Reply with OK."}]
for label, payload in [
    ("good request", {"model": "google/gemini-4-argon", "messages": msgs, "max_tokens": 256}),
    ("typo in model id", {"model": "google/gemini-4-argn", "messages": msgs, "max_tokens": 256}),
    ("messages missing", {"model": "google/gemini-4-argon", "max_tokens": 256}),
]:
    try:
        body = chat(payload)
        print(label, "-> ok:", body["id"], body["choices"][0]["message"]["content"])
    except ArgonError as exc:
        print(label, "-> error:", exc)
18:35:59 跑的第一版没有 messages 校验:正常请求回了 “OK”,拼错模型 id 的请求在 404 上立刻失败,空请求则在 503 上白白重试两次、耗了约 7 秒才放弃。chat() 开头那行校验就是修法,加上之后第三种情况在本地就报错,不发网络请求。
用 SDK 的话,openai.NotFoundError 和 openai.AuthenticationError 捕获后不要重试;我确认过 404 会抛成 NotFoundError,body 和上表一致。还有一条 SandBase 文档里的规则跟第 4 步直接相关:工具副作用可能已经发生的那一轮,不要自动重试。
整篇教程花了多少钱
| 步骤 | 计费调用 | 费用 |
|---|---|---|
| 第 1 至 6 步,加 schema”散文”测试 | 8 | $0.019 |
| 第 7 步(截断 + 重试) | 2 | $0.034 |
| 第 8 步和错误测试(仅成功调用) | 4 | $0.001 |
| 推理强度测试 | 20 | $0.241 |
| 最早的冒烟测试 | 1 | $0.004 |
| 首轮合计 | 35 | $0.299 |
失败请求(401、404、503)没有返回 completion id,也就没有可计费的任务。表里每一行都是 /v1/tasks/<id>/cost 返回值相加。
改完稿后,我把文中 8 段 Python 代码原样抽出来,在 UTC 18:42 至 18:44 又跑了一遍。8 段全部正常退出,行为一致:两个并行工具调用、符合 schema 的发票 JSON、读对的柱状图,以及再次出现的 300 token 截断。这一轮对账费用 $0.053,另有一次第 7 步重跑因为当时还没打印 id,约 $0.025 是按 usage 估算的。
常见问题
Gemini 4 Argon 能用 openai Python SDK 调用吗?
能。base_url 设为 https://api.sandbase.ai/v1,传 SandBase 的 key,model 写 google/gemini-4-argon。对话、流式、工具、JSON Schema 输出和图片输入在 openai==2.8.1 下都跑通了。
为什么 Gemini 4 Argon 返回的内容是空的?
先看 finish_reason。如果是 length,说明可见回答还没开始,推理就把 max_tokens 用完了。调大 max_tokens 即可;推理 token 无论如何都按输出计费。
SandBase 支持 Gemini 4 Argon 的 reasoning_effort 吗?
字段能传,任何值(包括非法值)都不报错。在一道难题上各跑 3 次,low 的推理 token 更少、high 更多,但区间有重叠。请在自己的任务上实测。
怎么查单次调用的费用?
用同一把 Bearer key 请求 GET https://api.sandbase.ai/v1/tasks/<completion id>/cost。流式调用要先去掉 chunk id 的 chatcmpl- 前缀。
通过 SandBase 最多能输出多少 token?
模型页标的是 65.5K,schema 里 max_tokens 上限是 65,536。Google 说的 1M 合计上限是它自家 Gemini API 的口径。
测试范围和下一步
测试范围说在前面:每段代码只跑了一次(推理强度每档 3 次),一个网络环境,一天之内。延迟数字只是个例。音频、视频、PDF 输入,prompt 缓存,以及 Google 在发布文章里提到的 continuation protocol,这些我都没测。跑分是另一回事,请看 Gemini 4 Argon 跑分排名和 Gemini 4 Argon 与 Claude Opus 5.5、GPT-6 Astra 对比;GA 之前的背景在我们更早的接入说明里。
想自己跑一遍,去 Gemini 4 Argon 模型页拿 key 和模型 id。建议先抄第 7 步的 ask() 和第 8 步的 chat(),这两段是我在任何生产客户端里都会保留的。