TikTok 达人刷量审核 Agent:投放前先筛一遍
TikTok 达人刷量审核 Agent 实战:输入达人账号,拉最近作品,逐条调用假播放量检测接口,在 Python 里汇总,再让 GPT-6 Luna 写一页审核备忘。用 Duolingo、NBA、Ryanair 三个品牌官方账号实测,附耗时、成本和踩坑。
第一次拿 NBA 的 TikTok 账号试跑,结果是「需复核」:作品「播放 / 粉丝比」的中位数,低于检测接口给的同档最低值。打开那 15 条作品一看,全是两天内刚发的,播放还在涨。加上发布时间过滤后再跑,备忘录里冒出一个「同档最低值 0.01」,可这是小一档账号的基准,NBA 有 2,700 多万粉丝。原因是那批作品的第一条是合拍,作者是另一个 310 万粉丝的账号,代码恰好从它身上取了粉丝档位。没有任何人刷量,是审核量错了对象。
这篇教程做一个 TikTok 达人刷量审核 Agent,适合品牌方、代理商在谈付费合作之前先筛一遍,也适合要把这一步做进系统的开发者。输入一个达人账号,它拉取最近的作品,剔除会把结果带偏的那几类,对每条调用 SandBase 的 tiktok/analytics/detect-fake-views,所有统计在 Python 里算完,最后让 openai/gpt-6-luna 只根据算好的数字写一页审核备忘。产出是一份逐条作品的 CSV,加一份带筛查结论的备忘。演示只用品牌官方账号:Duolingo、NBA 和 Ryanair。
先说结论
- 2026-10-04 对三个认证品牌账号共 45 条作品实测,检测接口把 0 条标为可疑,置信度全部是「Minimal」,三个账号的 fake_score 中位数分别是 16.26、19.65、19.74。
estimated_fake_views看起来是查表算的,不是数出来的:它等于播放量乘以 5%、10% 或 20%,档位由 fake_score 决定。实测 9.98 分及以下是 5%,12.21~19.99 分是 10%,20.09 分以上是 20%。- 在我试过的所有改动里,审哪些作品对结果影响最大。剔除置顶、发布不满 3 天、别人发起的合拍之后,每个账号在打分前被拿掉 6 到 65 条。
- LLM 写一份备忘只花 $0.00022~$0.00034。数字核对没发现编造的数字,但逐句读还是找到两处问题:只出现在 15 条里 9 条的标记被写成了「账号层面」,还有一份备忘写了「proceed with the deal」,说得比筛查结论更满。
这个 Agent 做什么
| 步骤 | 端点 | 代码保留什么 |
|---|---|---|
| 拉近期作品 | tiktok/app-v3/user-post-videos | 作品 id、发布日期、播放、点赞、评论、分享;跳过置顶、太新、合拍 |
| 逐条打分 | tiktok/analytics/detect-fake-views | fake_score、假播放比例和估算量、is_suspicious、置信度、风险标记、粉丝档位和对应基准 |
| 汇总 | Python | 中位数、计数、与档位基准的对比、反复出现的标记、筛查结论 |
| 写备忘 | openai/gpt-6-luna,走 /v1/chat/completions | 4~6 条要点加下一步建议,然后做数字核对 |
检测接口的单条报告很长,单条视频刷量检测教程逐块讲了每个字段怎么看。这个 Agent 只用跨作品汇总后还有意义的那部分。达人主页和作品列表接口本身,见 TikTok 达人数据 API 指南。
这个结果是什么,不是什么
detect-fake-views 是第三方的启发式算法,参考文档自己写的是基于「TikTok 流量池理论」做流量分析。它不是 TikTok 官方数据,分数高也不能证明有人买了播放。我手上没有标注过的刷量视频集,所以这篇只测检测器的行为,测不了准确率。也正因为这样,演示只用品牌官方账号。不要拿这份输出去公开说某个达人「刷量」。
数据是公开、只读的,需要一把 SandBase API key。SandBase 不是 TikTok 官方合作方,碰不到私密账号、私信、达人自己的后台数据,也不做任何账号操作。
| 你要的 | 用什么 |
|---|---|
| 联系达人之前,先对任意公开账号做一轮快速筛查 | 这个 Agent(公开数据,第三方启发式) |
| 达人真实的受众、触达和流量来源 | 让达人提供 TikTok Studio 后台截图,或通过 TikTok 官方达人合作工具共享的投放数据 |
| 你自己账号或广告的数据 | TikTok 面向账号所有者的官方工具 |
实测记录:2026-10-04(UTC)
输入:公开账号 duolingo、nba、ryanair,以及这些账号自己发布的视频 id。每个数据调用都是 POST https://api.sandbase.ai/v1/api/<vendor>/<path>,带 Authorization: Bearer $SANDBASE_API_KEY,JSON body 里只放该端点的字段。这是端点参考页给的 Model API POST 路由,不是目录页上的 GET 路由;参考页自动生成的 curl 示例会在 body 里多带一个 model 字段,其实路径已经指明了模型。代码只读文档里的 outputs[0].data,运行没完成就直接报错。下面的字段名来自这几次调用的实际返回,不是文档保证。
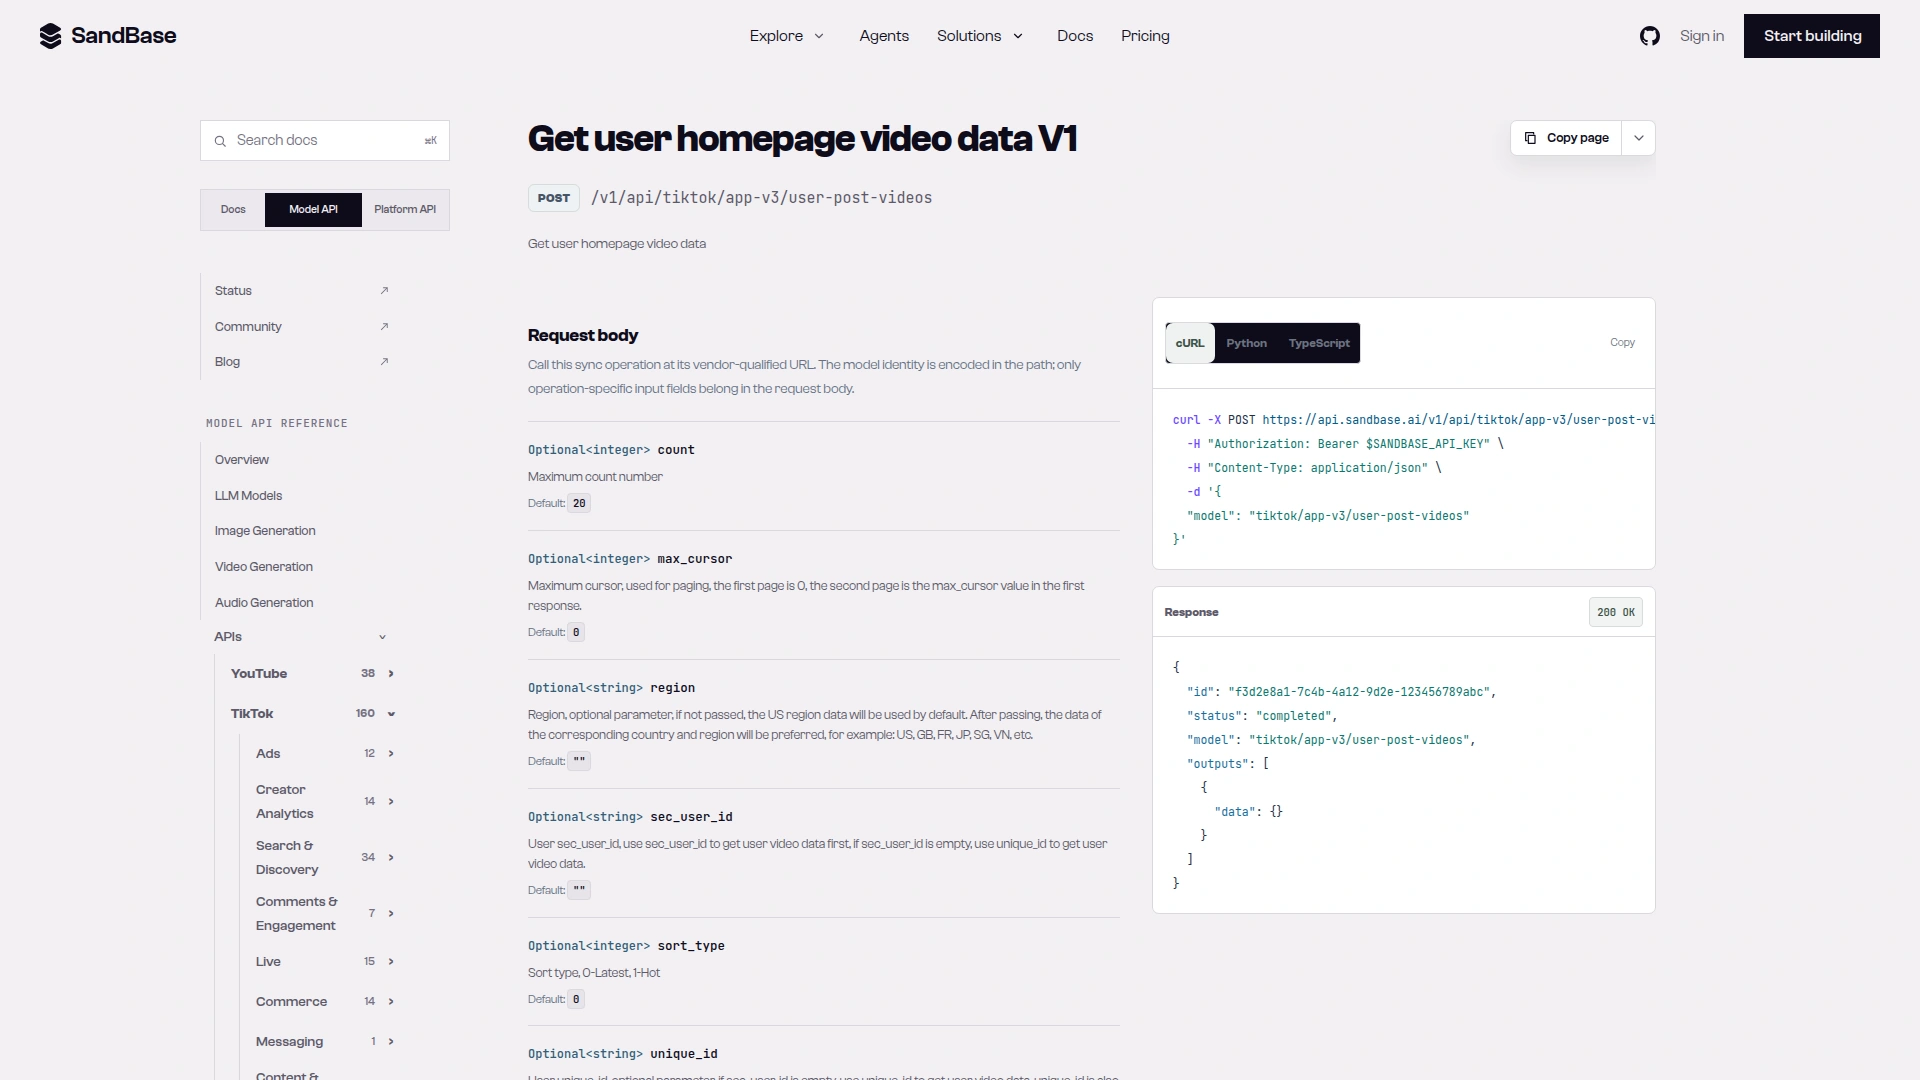
截图:user-post-videos 参考页列出了 count(默认 20)、用于翻页的 max_cursor 和 unique_id,正是 Agent 发送的三个字段(2026-10-04 截取)。
curl -s https://api.sandbase.ai/v1/api/tiktok/app-v3/user-post-videos \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"unique_id": "duolingo", "count": 20}'
运行 dfacf0c8-3704-48a8-a8bd-57869a9c2441 只返回了 10 条,不是 20 条,另外有 has_more: 1 和下一页用的 max_cursor。第二条作品如下,其余字段全部省略:
{"aweme_id": "7692128874154429709", "create_time": 1790963327, "is_top": 0,
 "author": {"unique_id": "duolingo"},
 "statistics": {"play_count": 354521, "digg_count": 44803, "comment_count": 1396,
                "share_count": 12012, "collect_count": 8457}}
列表第一条是 is_top: 1,一条 2025 年 6 月的置顶视频。合拍要靠 author.unique_id 识别:出现在达人列表里的合拍,作者字段是对方的账号。
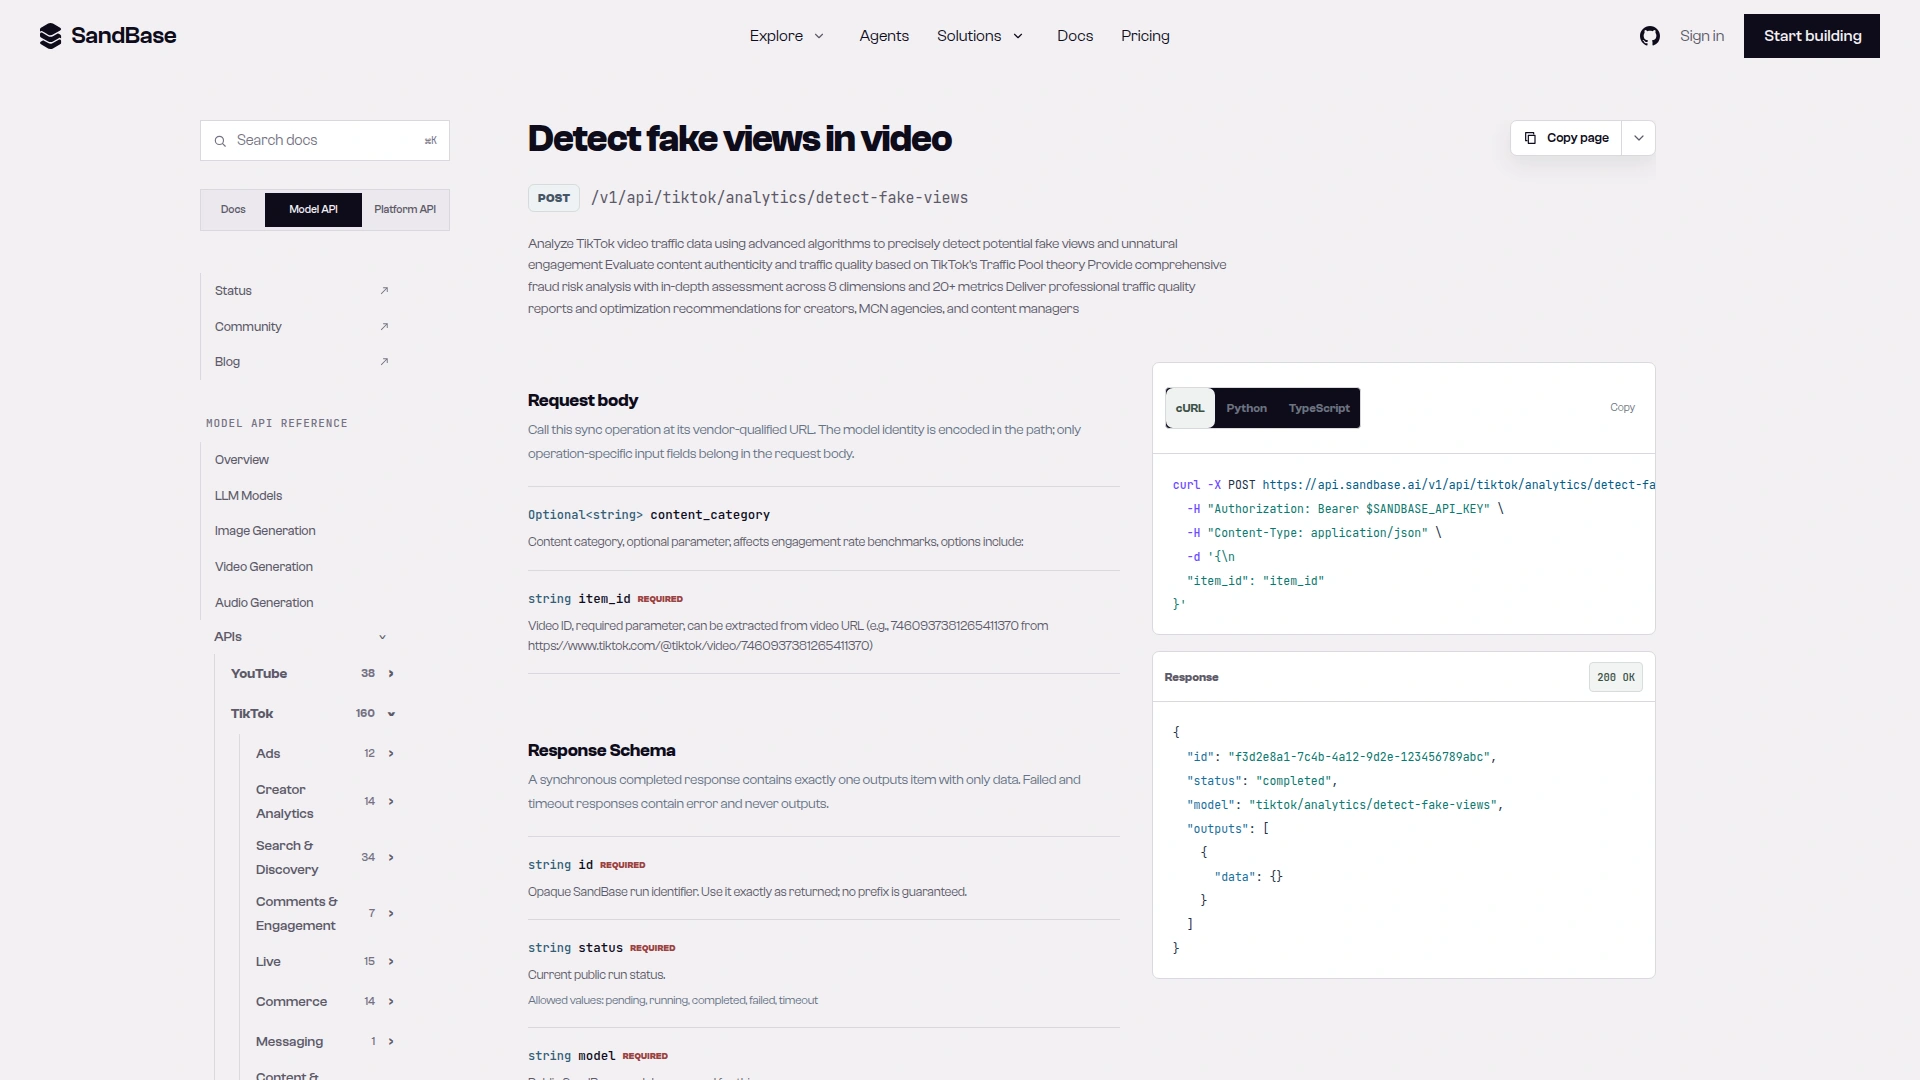
截图:detect-fake-views 参考页显示 item_id 是唯一必填字段,content_category 可选,并说明方法基于 TikTok 流量池理论(2026-10-04 截取)。
对 Duolingo 一条 2026-09-25 发布的视频调用 {"item_id": "7689488735649402126"}(运行 28568b7b-0fb3-4970-955a-cd68594413e7),返回的 fake_view_analysis 完整如下。这是批量运行之外单独调的一次,所以数字和后文略有出入:
{"component_scores": {"consistency_score": 77.78, "content_authenticity_score": 34.0,
  "creator_credibility_score": 0, "distribution_score": 65.0, "engagement_score": 0.0,
  "fan_growth_score": 45, "follower_correlation_score": 20, "racing_mechanism_score": 0},
 "confidence_level": "Minimal", "estimated_fake_views": 666010, "fake_score": 25.64,
 "fake_view_percentage": 20.0, "is_suspicious": false,
 "main_detection_reason": "Statistical View Anomalies"}
detailed_analysis.follower_correlation 里的档位信息(其余字段省略):
{"follower_tier": "xxlarge",
 "tier_benchmarks": {"like_follower_ratio": {"avg": 0.002, "good": 0.01, "min": 0.0005},
                     "view_ratio": {"avg": 0.02, "good": 0.1, "min": 0.005}}}
一致性模块给 77.78 分的理由是 9 天里有 7 处问题,比如「Day 3: 474265 views but 0 comments」。这条视频总共有 9,676 条评论,却有 5 天评论数为 0,更像是逐日数据缺了,而不是观众行为异常。看到分数先别急着下结论,先读它给的理由。
完整程序
一个文件,200 行,标准库加 requests。运行 python3 creator_audit.py duolingo 即可。可选参数:--posts(默认 15)、--min-age-days(默认 3)、--category、--model。下面就是我跑出后文结果的那个文件,一字未改。
#!/usr/bin/env python3
"""TikTok creator audit agent: recent posts -> detect-fake-views per post -> stats in code -> LLM memo.

Usage: python3 creator_audit.py duolingo [--posts 15] [--category default] [--model openai/gpt-6-luna]
Writes audit_<handle>.csv (one row per post) and memo_<handle>.md (stats, memo, numbers check).
The result is a screening signal from a third-party heuristic, not evidence of fraud.
"""
import argparse
import csv
import json
import os
import re
import statistics as st
import time
from collections import Counter
from concurrent.futures import ThreadPoolExecutor

import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
PRICE = {"openai/gpt-6-luna": (0.1, 0.5)}  # USD per 1M input / output tokens on SandBase, 2026-10-04


def call(model: str, params: dict, retries: int = 2) -> dict:
    """POST /v1/api/<model> and return outputs[0].data; raise if the run did not complete."""
    for attempt in range(retries + 1):
        try:
            resp = requests.post(f"{BASE}/api/{model}", headers=HEADERS, json=params, timeout=120)
        except requests.RequestException:  # dropped connections happen; retry them like a 5xx
            if attempt == retries:
                raise
            time.sleep(3 * (attempt + 1))
            continue
        body = resp.json() if resp.headers.get("content-type", "").startswith("application/json") else {}
        outputs = body.get("outputs") or []
        if resp.status_code == 200 and body.get("status") == "completed" and outputs:
            return outputs[0].get("data") or {}
        if resp.status_code < 500 or attempt == retries:
            raise RuntimeError(f"{model}: HTTP {resp.status_code} {body.get('status')} {body.get('error')}")
        time.sleep(3 * (attempt + 1))


def recent_posts(handle: str, n: int, min_age_days: float, max_pages: int = 8) -> tuple[list[dict], dict]:
    """Newest posts by this creator, at least min_age_days old (fresh posts are still collecting views)."""
    posts, cursor, cutoff, skipped = [], 0, time.time() - min_age_days * 86400, Counter()
    for page in range(1, max_pages + 1):
        data = call("tiktok/app-v3/user-post-videos", {"unique_id": handle, "count": 20, "max_cursor": cursor})
        for a in data.get("aweme_list") or []:
            s = a.get("statistics") or {}
            author = ((a.get("author") or {}).get("unique_id") or "").lower()
            reason = ("pinned" if a.get("is_top") else "collab by another author" if author != handle.lower()
                      else "too new" if a.get("create_time", 0) > cutoff else "" if s.get("play_count") else "no views")
            if reason:
                skipped[reason] += 1
                continue
            posts.append({"video": a["aweme_id"], "posted": time.strftime("%Y-%m-%d", time.gmtime(a.get("create_time", 0))),
                          "list_views": s["play_count"], "likes": s.get("digg_count", 0),
                          "comments": s.get("comment_count", 0), "shares": s.get("share_count", 0)})
        if len(posts) >= n or not data.get("has_more"):
            break
        cursor = data.get("max_cursor") or 0
    return posts[:n], {"list_pages": page, **skipped}


def detect(post: dict, category: str | None) -> dict:
    params = {"item_id": post["video"], **({"content_category": category} if category else {})}
    d = call("tiktok/analytics/detect-fake-views", params)
    fv, da = d.get("fake_view_analysis") or {}, d.get("detailed_analysis") or {}
    thin = [name for name, block in da.items() if isinstance(block, dict)
            and any("Insufficient" in i for i in block.get("issues") or [])]
    return {**post, "fake_score": fv.get("fake_score"), "fake_pct": fv.get("fake_view_percentage"),
            "est_fake_views": fv.get("estimated_fake_views"), "suspicious": fv.get("is_suspicious"),
            "confidence": fv.get("confidence_level"), "reason": fv.get("main_detection_reason"),
            "views": (d.get("video_metrics") or {}).get("total_views") or post["list_views"],
            "insufficient": " ".join(thin),
            "_flags": d.get("suspicious_features") or [], "_creator": d.get("creator_metrics") or {},
            "_tier": (da.get("follower_correlation") or {}), "_bench": (da.get("engagement") or {}).get("benchmark_category")}


def med(xs: list) -> float:
    xs = [x for x in xs if x is not None]
    return round(st.median(xs), 4) if xs else None


def vs_tier(x: float, b: dict | None) -> str:
    """Place a ratio against the endpoint's own tier benchmarks (min / avg / good) in code, not in the LLM."""
    if not b or x is None:
        return "no benchmark"
    return ("below tier min" if x < b["min"] else "min to avg" if x < b["avg"]
            else "avg to good" if x < b["good"] else "above good")


def aggregate(handle: str, rows: list[dict]) -> dict:
    followers = max(r["_creator"].get("follower_count") or 0 for r in rows)
    tier = rows[0]["_tier"]
    bench = tier.get("tier_benchmarks") or {}
    scores = [r["fake_score"] for r in rows if r["fake_score"] is not None]
    views = [r["views"] for r in rows]
    flags = Counter(f for r in rows for f in set(r["_flags"]))
    return {
        "handle": handle, "posts": len(rows), "followers": followers, "verified": rows[0]["_creator"].get("verified"),
        "follower_tier": tier.get("follower_tier"), "benchmark_category": rows[0]["_bench"],
        "fake_score": {"median": med(scores), "min": min(scores), "max": max(scores)},
        "suspicious_posts": sum(bool(r["suspicious"]) for r in rows),
        "confidence_levels": dict(Counter(r["confidence"] for r in rows)),
        "fake_pct_median": med([r["fake_pct"] for r in rows]),
        "fake_pct_levels": {str(k): v for k, v in sorted(Counter(r["fake_pct"] for r in rows).items())},
        "est_fake_views_total": sum(r["est_fake_views"] or 0 for r in rows), "views_total": sum(views),
        "views_median": med(views), "views_max_to_median": round(max(views) / st.median(views), 2),
        "view_follower_median": med([v / followers for v in views]),
        "like_follower_median": med([r["likes"] / followers for r in rows]),
        "tier_view_ratio": bench.get("view_ratio"), "tier_like_follower_ratio": bench.get("like_follower_ratio"),
        "reach_vs_tier": vs_tier(med([v / followers for v in views]), bench.get("view_ratio")),
        "likes_vs_tier": vs_tier(med([r["likes"] / followers for r in rows]), bench.get("like_follower_ratio")),
        "like_view_median": med([r["likes"] / r["list_views"] for r in rows]),
        "comment_like_median": med([r["comments"] / max(r["likes"], 1) for r in rows]),
        "share_view_median": med([r["shares"] / r["list_views"] for r in rows]),
        "insufficient_data_by_component": dict(Counter(c for r in rows for c in r["insufficient"].split())),
        "recurring_flags": [{"flag": f, "posts": c} for f, c in flags.most_common(4)],
    }


def band(s: dict) -> str:
    """Screening band from fixed starting thresholds (ours, not the vendor's; no ground truth behind them)."""
    if s["suspicious_posts"] / s["posts"] >= 0.3:
        return "escalate"
    if s["suspicious_posts"] or s["reach_vs_tier"] == "below tier min":
        return "review"
    return "no screening concerns"


MEMO_PROMPT = """You write a short vetting memo for a brand team about a TikTok creator before a paid deal.
Use ONLY the JSON stats you are given. Copy numbers exactly as written; do not compute new numbers.
Write plain English, not JSON key names. Ratios are per view or per follower (0.0275 = 2.75%).
Compare with the follower tier only through the reach_vs_tier and likes_vs_tier labels.
The detector is a third-party heuristic, not TikTok data and not proof of fraud: say "risk signals" or
"the endpoint estimated", never "fake account". Flags that repeat on every post are account-level.
Format: 4-6 bullet points, under 160 words, then one line "Next step:" that matches the screening band."""


def memo(stats: dict, model: str) -> tuple[str, dict]:
    resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS, timeout=120,
                         json={"model": model, "max_tokens": 1500,
                               "messages": [{"role": "system", "content": MEMO_PROMPT},
                                            {"role": "user", "content": json.dumps(stats)}]})
    resp.raise_for_status()
    body = resp.json()
    return body["choices"][0]["message"]["content"].strip(), {"id": body.get("id"), **(body.get("usage") or {})}


def numbers_check(text: str, stats: dict) -> list[str]:
    """Every number in the memo must match a stats value (as-is, rounded, or as a percentage)."""
    allowed = set()
    for v in re.findall(r"-?\d+(?:\.\d+)?", json.dumps(stats)):
        x = float(v)
        for y in (x, x * 100):
            allowed |= {f"{y:g}", f"{y:.0f}", f"{y:.1f}", f"{y:.2f}", f"{y:,.0f}"}
    found = re.findall(r"\d[\d,]*(?:\.\d+)?", text)
    return [n for n in found if n not in allowed and n.replace(",", "") not in allowed]


if __name__ == "__main__":
    ap = argparse.ArgumentParser()
    ap.add_argument("handle")
    ap.add_argument("--posts", type=int, default=15)
    ap.add_argument("--min-age-days", type=float, default=3)
    ap.add_argument("--category", default=None, help="default|entertainment|education|product|verified_large")
    ap.add_argument("--model", default="openai/gpt-6-luna")
    a = ap.parse_args()
    t0 = time.time()
    posts, skipped = recent_posts(a.handle, a.posts, a.min_age_days)
    if not posts:
        raise SystemExit(f"no eligible posts for @{a.handle}: {skipped}")
    with ThreadPoolExecutor(max_workers=4) as pool:
        rows = list(pool.map(lambda p: detect(p, a.category), posts))
    t1 = time.time()
    stats = aggregate(a.handle, rows)
    stats["min_post_age_days"], stats["skipped_posts"] = a.min_age_days, skipped
    stats["screening_band"] = band(stats)
    facts = {k: v for k, v in stats.items() if not k.startswith("tier_")}  # raw benchmarks invite mix-ups
    text, usage = memo(facts, a.model)
    unmatched = numbers_check(text, facts)
    pin, pout = PRICE.get(a.model, (0, 0))
    usd = (usage.get("prompt_tokens", 0) * pin + usage.get("completion_tokens", 0) * pout) / 1e6
    cols = ["video", "posted", "views", "list_views", "likes", "comments", "shares", "fake_score", "fake_pct",
            "est_fake_views", "suspicious", "confidence", "reason", "insufficient"]
    with open(f"audit_{a.handle}.csv", "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=cols, extrasaction="ignore")
        w.writeheader()
        w.writerows(rows)
    with open(f"memo_{a.handle}.md", "w", encoding="utf-8") as f:
        f.write(f"# Creator audit: @{a.handle} ({time.strftime('%Y-%m-%d %H:%M UTC', time.gmtime())})\n\n"
                f"Screening band: **{stats['screening_band']}**\n\n{text}\n\n"
                f"Numbers check: {'all numbers match the stats' if not unmatched else 'UNMATCHED ' + ', '.join(unmatched)}\n\n"
                f"```json\n{json.dumps(stats, indent=1)}\n```\n")
    print(json.dumps(stats, indent=1))
    print(f"\n{text}\n\nunmatched numbers: {unmatched}")
    print(f"{len(rows)} posts, data {t1 - t0:.1f}s, total {time.time() - t0:.1f}s, "
          f"LLM {usage.get('prompt_tokens')} in / {usage.get('completion_tokens')} out, ${usd:.5f}, id {usage.get('id')}")
这四处设计都是之前跑歪了才改出来的:
- 审哪些作品。 置顶作品是旧的,而且是达人自己挑的。发布不满三天的作品播放还在涨,第一次跑 NBA 就是被它们拉低了触达。合拍带的是对方的粉丝数,而 Agent 从第一条作品取档位,一条合拍就能把基准整个换掉。这三类都跳过,数量记在
skipped_posts里。 - 档位对比在代码里做。 判断一个比例落在 min、avg、good 哪一段是算术题,所以由
vs_tier写成标签,LLM 根本看不到基准表。上面那个合拍 bug,是因为备忘里引用了原始基准才露出来的;现在标签旁边仍然会打出档位名,人工扫一眼就能发现不对。 - LLM 只负责措辞。 所有数字都来自
aggregate,这条规矩来自我们的 GPT-6.1 Sol Agent 实测。默认用 GPT-6 Luna,是因为一份 600 token 左右的备忘花不到 $0.001;我们的模型档位测评里它在工具任务上 51 题全对。 - 筛查结论的阈值是我定的,不是厂商的。 可疑作品占 30% 以上为「escalate」,有任何可疑作品或触达低于同档最低值为「review」。早一版还把 fake_score 中位数 20 以上也算进 review,结果 Ryanair 以 21.53 分、0 条可疑被划进去,我就删了这条。在三个品牌账号上调阈值,本质上还是没有标注数据的调参,只能当起点用。
三个品牌账号的结果
最终一轮在 2026-10-04 02:00 UTC 开始,三个账号依次跑,全部默认参数。
| Duolingo | NBA | Ryanair | |
|---|---|---|---|
| 粉丝数(检测接口返回) | 18,187,032 | 27,234,175 | 2,924,849 |
| 粉丝档位 | xxlarge | xxlarge | xlarge |
| 打分作品数,发布日期 | 15 条,9 月 10 日~30 日 | 15 条,全在 9 月 30 日 | 15 条,9 月 14 日~30 日 |
| 列表翻页数 | 3 | 7 | 3 |
| 跳过:置顶 / 太新 / 合拍 | 1 / 4 / 1 | 3 / 52 / 10 | 3 / 3 / 0 |
| fake_score 中位数(最小~最大) | 16.26(5.36~22.88) | 19.65(16.4~24.6) | 19.74(9.72~26.83) |
| is_suspicious | 15 条中 0 条 | 15 条中 0 条 | 15 条中 0 条 |
| 假播放比例 5 / 10 / 20 | 5 / 7 / 3 条 | 0 / 10 / 5 | 2 / 6 / 7 |
| 估算假播放 / 总播放 | 1,337,145 / 13,623,666 | 340,026 / 1,975,011 | 793,296 / 6,102,527 |
| 播放 / 粉丝中位数 | 0.0317(avg 到 good) | 0.0028(低于同档最低) | 0.0431(min 到 avg) |
| 点赞 / 播放中位数 | 0.1218 | 0.0867 | 0.0416 |
| 每条都出现的标记 | 2 个涨粉标记 | 1 个涨粉标记 | 无 |
| 筛查结论 | no screening concerns | review | no screening concerns |
NBA 有两条的比例是 9.99,我按 10 计。45 条作品的置信度全是「Minimal」,竞速机制(racing mechanism)模块也全部提示数据不足。
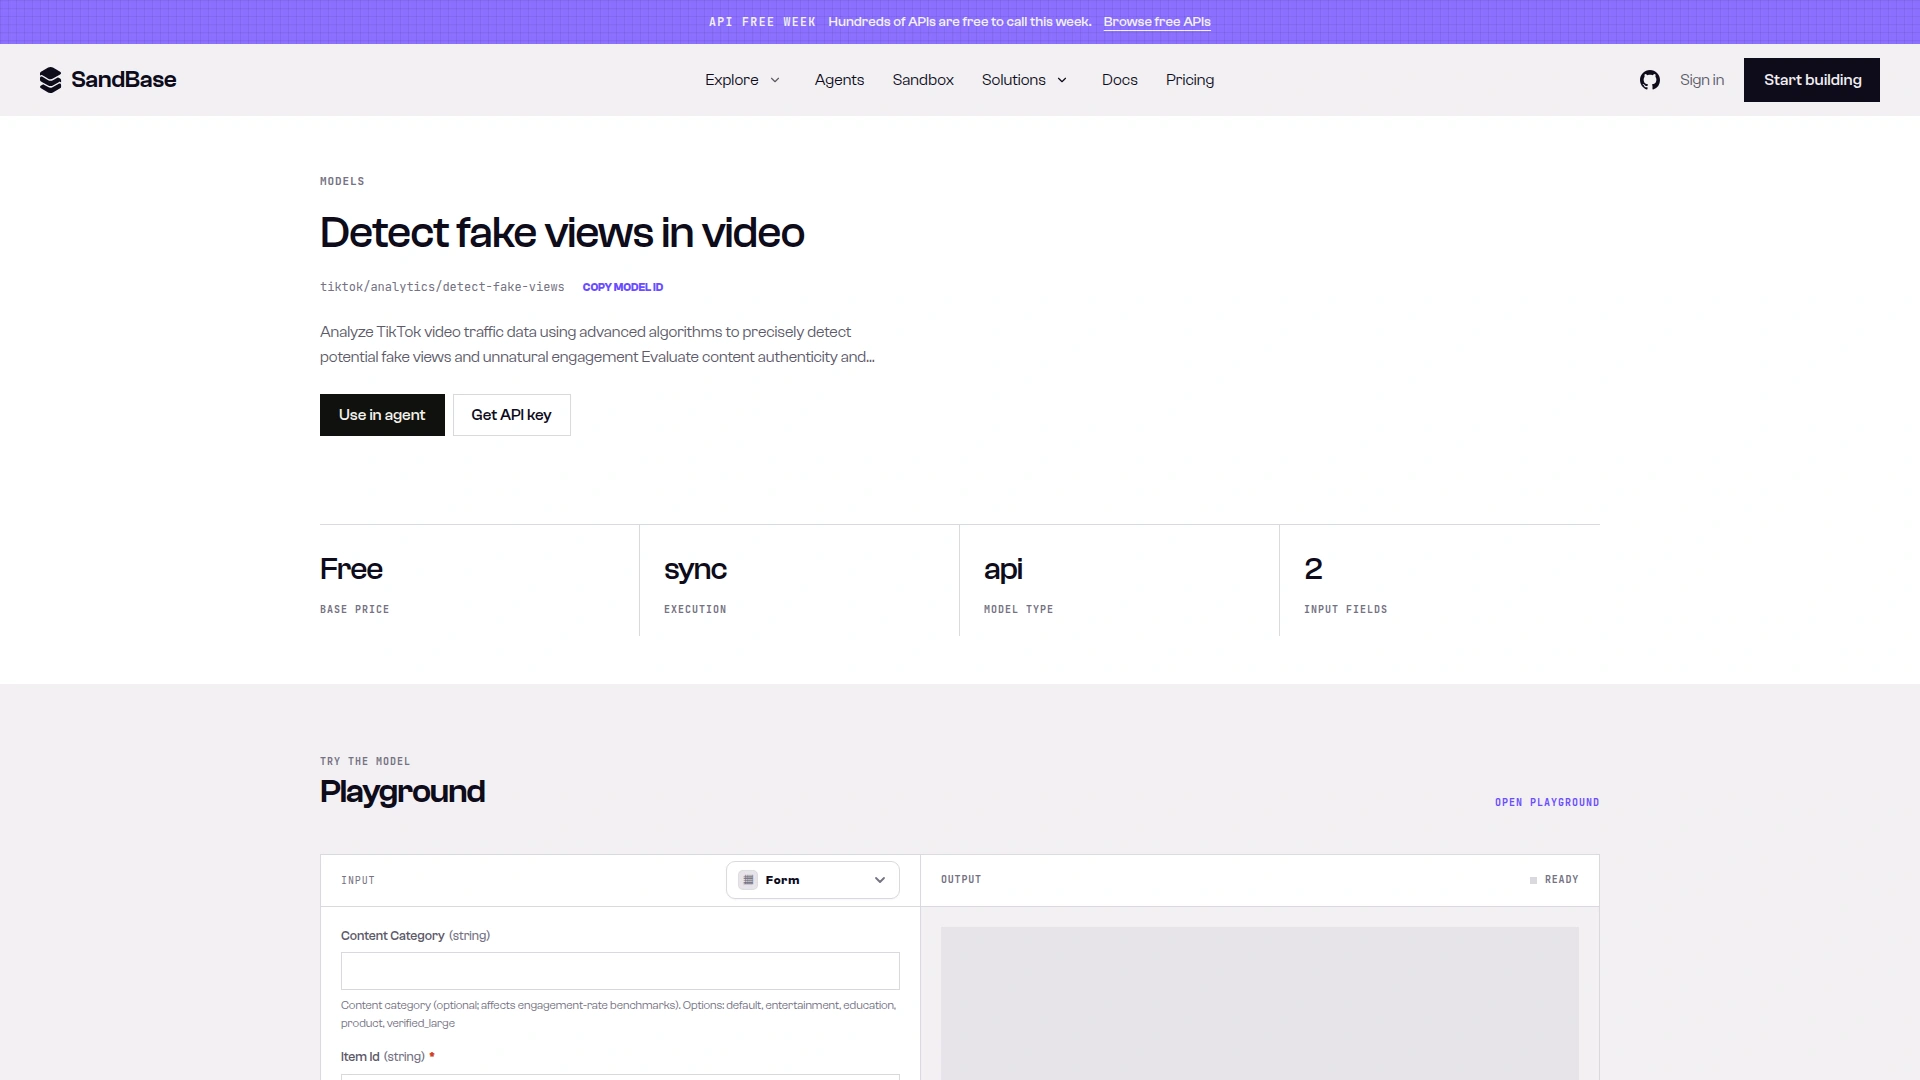
截图:2026-10-04 的 detect-fake-views 模型页显示基础价格 Free、同步执行、2 个输入字段,顶部挂着「API Free Week」活动横幅,价格请以当天为准(2026-10-04 截取)。
这些数字说明了什么,没说明什么
假播放估算是阶梯函数。 45 条作品里,estimated_fake_views 都等于播放量乘以 5%、10% 或 20% 再向下取整;NBA 那两条显示 9.99 的,实际也是按 10% 算的。fake_score 在 5.36~9.98 时比例是 5,12.21~19.99 是 10,20.09~26.83 是 20。中间的空档里没有样本,所以确切分界线只能靠猜。分数稍微一动,估算量就可能翻倍。Duolingo 有一条视频在 01:38 到 01:46 UTC 的三次运行里都是 25.64 分,01:50 和 02:00 变成 16.26 分。01:46 到 01:50 之间播放只涨了 570,估算假播放却从 666,129 直接减半到 333,121。这两轮共有 43 条重合作品,3 条变动 6.7~10.06 分,其余变动不超过 0.01。最后两轮相隔 10 分钟,45 条的差都在 0.01 以内。所以,要把「估算假播放」写进合同之前,先想清楚能不能接受一个两次调用之间就减半的数字。
账号层面的标记会出现在每一条上。 Duolingo 的 15 条都带着「Followers grew 5.0x in only 18 days」和「Reached 1000000 followers from 500000 in only 20 days」,NBA 带的是 168 天版本的后一条。它们来自账号的涨粉历史,不是视频本身。品牌号刚入驻 TikTok 的头几周涨粉快,也说得通,而这个标记并不告诉你涨粉发生在什么时候。TikTok 官方账号在单条视频教程里也被打了类似标记。这类标记按账号算一次就够了。
触达低不等于刷量。 NBA 被划进 review,唯一原因是播放 / 粉丝中位数 0.0028,低于同档最低值 0.005。NBA 发得太勤了:不满三天的作品有 52 条,15 条合格作品只覆盖了一天。作品越多,同一批粉丝大概就被摊得越薄,不过这点我没测。这值得问一句预期触达是多少,跟刷量无关。
content_category 在这里没起作用。 我用 education 和 entertainment 各重跑了一次 Duolingo,15 条的分数和不传类别时完全一样,benchmark_category 始终是 verified_large。看起来至少对这个认证账号,检测器会自己选基准。未认证的达人我没测,类别也许有影响。
两个接口的播放量对得上。 作品列表里的播放量和检测接口 video_metrics 里的播放量,每条相差最多约 0.01%。
备忘录有没有照着数字写?
最终三份备忘的数字核对全部通过:里面出现的每个数字都能在统计结果里找到。但逐句读,还是发现两个它查不出的问题。Ryanair 的备忘说统计异常标记「recur across posts」,要按账号层面看待;实际只出现在 15 条里的 9 条,而提示词规定只有每条都出现的标记才算账号层面。Duolingo 的备忘结尾写「Proceed with the deal」,可「no screening concerns」只表示没筛出问题,下面的表格建议的是照常审核。更早的几轮里,备忘还有两次把「估算假播放总数」写成了「estimated views」。数字核对只能证明数字存在,证明不了它挂对了标签。备忘和它附带的统计块要放在一起读。
拿到结果之后怎么办
| 结果 | 含义 | 下一步 |
|---|---|---|
| no screening concerns | 没有可疑作品,触达不低于同档最低值 | 照常审核:受众匹配、品牌安全、过往合作效果 |
| review:触达低于同档最低值 | 按粉丝档位看,单条播放偏低 | 先看发帖频率,再请达人提供 TikTok Studio 的触达和粉丝活跃截图 |
| review:有可疑作品 | 检测器标记了个别视频 | 读这几条的 main_detection_reason 和问题明细,请达人提供这几条的流量来源 |
| escalate:30% 以上可疑 | 跨作品的模式,不是个别异常 | 达人提供一手后台数据前先暂停合作;不要仅凭这个结果指责任何人 |
| 任意结论,且有每条都出现的标记 | 来自账号历史,不是作品本身 | 问问涨粉节点,比如某条爆款或付费推广;近期作品单独评估 |
无论哪一行,接口给的都是筛查信号,真正的证据是达人自己的后台数据。
批量耗时和成本
每轮对 15 条作品打分,检测接口 4 路并发。数据阶段 Duolingo 28.8 秒、NBA 72.6 秒、Ryanair 27.2 秒;NBA 要翻 7 页才凑够 15 条合格作品。加上写备忘,三轮全程分别是 35.5、80.3、34.2 秒。
数据调用当天按标价不收费:两个端点在 GET /v1/models/<model> 里都返回 base_price: "0"。这个接口要用同一把 Bearer key,不想用 key 的话,公开模型页上也能看到价格。上面的模型页挂着「API Free Week」横幅,大批量跑之前再确认一次。GPT-6 Luna 标价每百万 token 输入 $0.10、输出 $0.50。三份备忘用了 600~609 个输入 token、318~556 个输出 token,GET /v1/tasks/<id>/cost(同样要带 Bearer key)查到的实际扣费是 $0.000220、$0.000330、$0.000338,和程序里的估算一致。数据调用这边,一个 user-post-videos 运行查到 $0,一个检测运行返回「task not found」。
检测接口中途还挂过一次。大约 01:18 到 01:28 UTC,每次调用都返回 HTTP 503 和上游错误,连参考页自带的示例视频也不行,而 tiktok/analytics/video-metrics 一切正常,01:32 恢复。程序对 5xx 会重试两次,之后带着错误退出。批量审核多个达人时,建议捕获这个错误、稍后重跑这个达人,别写出一份残缺的报告。
局限
测试范围:三个认证品牌账号,每个 15 条作品,2026-10-04 一个上午(UTC),外加前面几轮塑造代码的试跑。没有测未认证或小达人,没有测其他地区,没有标注好的刷量数据,所以这里的一切都说明不了准确率。阶梯映射和类别无效这两点,是这 45 条作品上的观察,不是文档行为。原始返回只在内部保存;方法、提示词、阈值和汇总结果都已写在本文里。
下一步
- 完整读一份报告。 单条视频刷量检测教程逐块解释每个字段,以及哪些可信。
- 看检测器有多稳定。 刷量识别实测在更多视频和重复调用上看分数分布。
- 补上主页信息。 TikTok 达人数据 API 指南讲了主页、粉丝数和作品列表。
想自己跑,先看 detect-fake-views 参考文档和模型页,再去申请 SandBase API key。
常见问题
怎么判断一个 TikTok 达人有没有刷量?
别只看一条视频,要给近期多条作品打分,看整体:多少条被标为可疑,播放 / 粉丝比是否符合同档水平,哪些标记反复出现。然后请达人提供一手后台数据。三个品牌账号的 45 条作品里,被标为可疑的是 0 条。
fake_score 是什么?
检测器的综合风险分,由 8 个分项分数合成。参考文档没写它的取值范围,也没写 is_suspicious 的触发线。这 45 条作品的分数在 5.36~26.83 之间,is_suspicious 全是 false。
估算假播放量靠得住吗?
把它当成一个档位看。在这 45 条作品上,它总是播放量乘以 5%、10% 或 20%,档位由 fake_score 决定。有一条视频的估算值在相隔几分钟的两次调用之间直接减半。
为什么要跳过合拍和新作品?
新作品播放还没涨完,第一次跑 NBA 就是被它们划进了 review。合拍带的是对方的粉丝数,后面一轮里就是一条合拍把 NBA 的档位基准换掉了。
审一个达人要花多少钱?
2026-10-04 这两个 TikTok 端点标价免费,一份 GPT-6 Luna 备忘 $0.00022~$0.00034。15 条作品全程 34~80 秒。