TikTok 创作者研究 API 教程 | SandBase
按关键词搜 TikTok 创作者,读主页资料,翻页拉取作品,再按播放和点赞排序:四个 SandBase 端点串成一条链路。同时提供已知公开用户名的单次资料请求示例。
在 TikTok 账号搜索里输入 “national geographic”,出来的不只是国家地理官方号,还有它的地区号、栏目号,以及一长串山寨号。我测的这批结果里,有的山寨号粉丝也有几十万。做创作者研究,第一关就是把这些筛掉,然后才轮得到真正想问的:哪个是官方号?体量多大?最近的作品里,哪几条真的跑出去了?
这篇 TikTok 创作者研究 API 教程用四个 SandBase 端点把这条路走一遍:按关键词搜账号、读主页资料、翻页拉作品、按播放和点赞排序。完整的端点地图见 TikTok 公开数据 API 总览。如果要从搜索需求出发,可改读 Creator Search Insights 内容缺口工作流。
这里读的都是公开、只读数据。不需要 TikTok 账号,不需要申请 TikTok 开发者应用,也不需要 SDK,只要一个 SandBase API Key。每个组织每天(UTC)有 100 次免费数据 API 调用,由符合条件的 API 共享(sandbase_inspect 会显示端点的 free_quota);超出后这四个端点按次计费,单价以 SandBase 目录页为准。
参数和文档化响应信封以当前端点参考为准。截至 2026-11-05,App V3 资料端点 README 也已列出公开资料字段并给出非空示例,但这不保证字段路径永远稳定,也不是完整、已核准的成功响应契约。下文出现的业务字段名都来自我自己跑的调用(测试于 2026-10-01,UTC),属于实测观察,不是文档保证。
先说结论
tiktok/app-v3/user-search-result把关键词变成候选账号,每条带uid、sec_uid、unique_id、粉丝数和认证标签。- 我测的品牌号,认证标签在
enterprise_verify_reason里,custom_verify是空的。两个字段都要读,不然会排错账号。tiktok/app-v3/user-profile返回主页资料卡;tiktok/app-v3/user-post-videos用max_cursor和has_more翻页,每条作品的play_count都有真实数值。tiktok/app-v3/multi-video一次回读最多 10 条作品,id 列表要放进一个就叫body的字段。
已知用户名:用 Python 直接查询 TikTok 公开主页
已经知道公开账号的用户名,就不必先搜索。例如查询 @natgeo,只发送 unique_id: "natgeo";不知道哪个账号才是目标时,继续使用下文保留的搜索研究流程。
App V3 README 要求三个字符串标识符只选一个:用户名用 unique_id,已有安全标识符用 sec_user_id,数字用户 ID 用字符串 user_id;另外两个不传。先查看 TikTok App V3 资料 API 请求参考,确认当前参数写法。
下面是单次 Model API POST 请求,不是目录的 GET 路由,也没有自动重试。运行前安装 requests,在服务器环境设置 SANDBASE_API_KEY。本示例在 2026-11-05 通过离线 mock 测试,未运行真实 API;运行它会发起一次资料查询。
import os

import requests

response = requests.post(
    "https://api.sandbase.ai/v1/api/tiktok/app-v3/user-profile",
    headers={
        "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={"unique_id": "natgeo"},
    timeout=(10, 60),
)
response.raise_for_status()
try:
    raw_response = response.json()
except requests.exceptions.JSONDecodeError as exc:
    raise RuntimeError("SandBase returned a non-JSON response") from exc

# Keep raw_response opaque: do not infer business success or profile paths.
raise_for_status() 检查 HTTP 错误,JSON 解码成功不等于业务查询成功。raw_response 原样保留,不提取资料或粉丝数,也不接入下文历史 read_profile()。当前 README 已列出公开资料字段及非空示例,但不是完整、已核准的成功响应契约;本次没有新增业务解析器。超时设置是示例客户端配置,不是延迟或 SLA 承诺。
独立的 Web 资料参考使用 uniqueId 或 secUid,响应形状也不同,不能把参数名直接搬进 App V3。README 中的 user.follower_count 是账号计数,不是粉丝名单、受众画像或历史增长序列;缺失、null 或空值保留为未知,不填零。这个单账号资料请求没有分页参数,也不承诺邮箱、私有资料、完整历史或实时一致性。
一个字段名,让我挑错了账号
第一版代码,我按 custom_verify 过滤搜索结果,因为这个名字看着最像“认证”。结果 29 个账号里只有 1 个带认证,而且是一位个人纪录片摄影师,不是品牌号。国家地理官方号其实就在列表里,只是它的 custom_verify 是空字符串,verified account 这个标签放在 enterprise_verify_reason 里。两个兄弟号的 institution account、Business account 也在这个字段。改成两个字段都读之后,29 个账号里有 8 个带标签,按粉丝排序,官方号排在第一。
所以这篇把认证标签当成头号过滤条件。同一次搜索里的山寨号,名字写成 “NATlONAL GEOGRAPHIC”(把大写 I 换成小写 l),而且一个标签都没有。只按粉丝数排,它们很可能混进你的候选名单。
| 你的需求 | 用什么 |
|---|---|
| 做研究用的公开账号资料和作品互动数据 | SandBase TikTok 公开数据 API |
| 登录、发布内容,或读取已授权账号的数据 | TikTok for Developers |
| 私密账号、私信、仅登录可见的数据 | 两条路都不适用 |
流程一览
- 用
tiktok/app-v3/user-search-result(keyword、offset、count)按关键词搜账号。 - 只留带标签的账号:
enterprise_verify_reason或custom_verify非空,再按粉丝排序。 - 用
tiktok/app-v3/user-profile(sec_user_id)读主页资料。 - 用
tiktok/app-v3/user-post-videos(sec_user_id、max_cursor、count)翻页拉作品。 - 按播放、点赞或点赞率排序,再用
tiktok/app-v3/multi-video回读头部作品。
四个调用都在 app-v3 这一组里,搜索拿到的 sec_uid 可以直接喂给后面两步,不用做 id 转换。
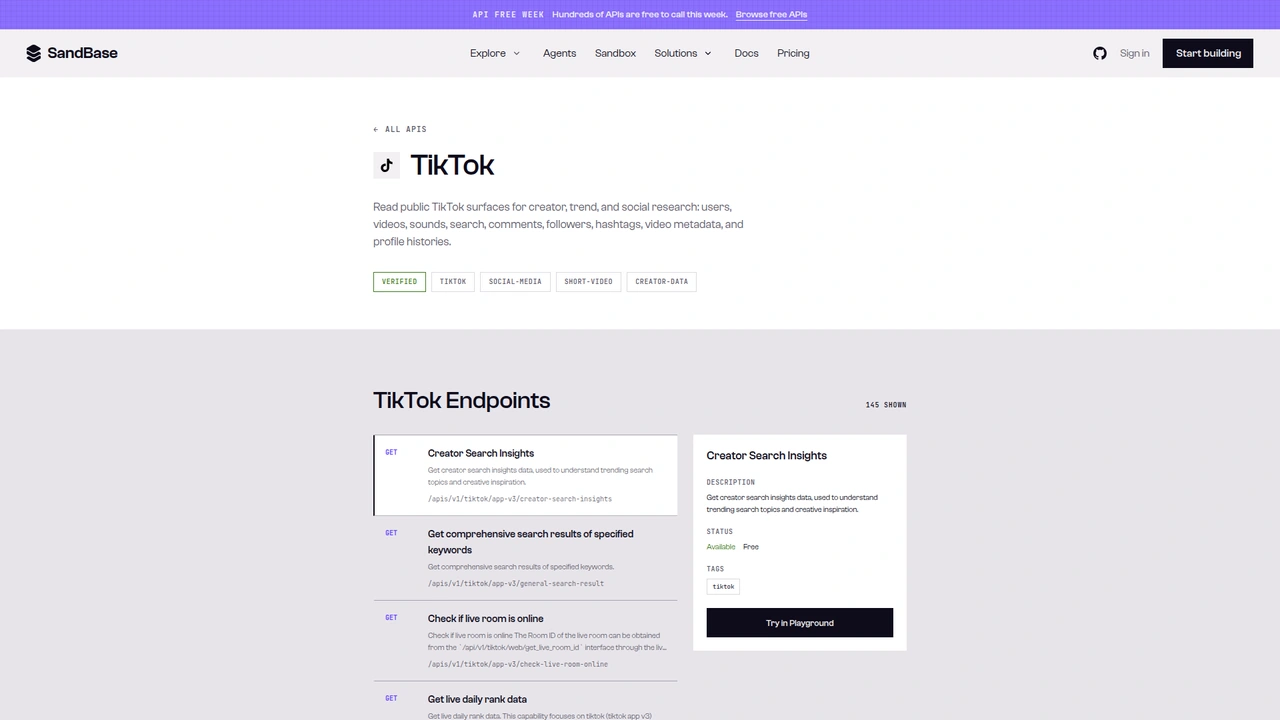 SandBase 上的 TikTok 目录页:145 个端点以
GET /apis/v1/tiktok/... 形式列出,右侧面板显示选中端点为 Available、Free。本教程调用的是 Model API 的 POST /v1/api/tiktok/... 路由。截图摄于 API Free Week 期间,Free 是当时的标价;活动已结束,数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按目录价按次计费。
写代码前先说清楚接口面。目录页展示的是 GET /apis/v1/tiktok/<path>;本文用的是端点参考里的 Model API,即 POST /v1/api/tiktok/<path>,JSON 请求体里只放该端点自己的参数。有一个参考页自动生成的 cURL 示例在请求体里带了 model 字段,我没加,因为模型名已经在路径里了,调用都正常。如果你用的端点参考另有说明,以参考为准。
第 0 步:一个通用调用函数
import os
import time
import statistics
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}


def call(path: str, payload: dict, retries: int = 2):
    for attempt in range(retries + 1):
        try:
            resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=90)
            resp.raise_for_status()
            break
        except requests.RequestException:
            if attempt == retries:
                raise
            time.sleep(2 * (attempt + 1))
    try:
        body = resp.json()
    except requests.exceptions.JSONDecodeError as exc:
        raise RuntimeError("SandBase returned a non-JSON response") from exc
    if not isinstance(body, dict):
        raise RuntimeError("SandBase response must be a JSON object")
    print("  run", body.get("id"), path)
    if body.get("status") != "completed":
        error = body.get("error")
        message = error.get("message") if isinstance(error, dict) else None
        raise RuntimeError(message if isinstance(message, str) and message.strip() else f"{path} did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict) or "data" not in outputs[0] or outputs[0]["data"] is None:
        raise RuntimeError(f"{path}: missing documented outputs[0].data")
    return outputs[0]["data"]
参考记录的完成态信封是 outputs[0].data,2026-10-01 的 TikTok 测试都返回了这一结构。修订后的函数只读取这个文档化信封,缺失时明确报错。那次历史测试中,搜索、主页和作品列表返回对象,multi-video 返回作品列表。本次信封修订于 2026-11-05 通过离线测试;旧业务解析器及完整工作流没有用当前 API 重新实测。
第 1 步:搜账号,只留带标签的
def search_creators(keyword: str, pages: int = 2) -> list[dict]:
    offset, seen, creators = 0, set(), []
    for _ in range(pages):
        page = call("tiktok/app-v3/user-search-result",
                    {"keyword": keyword, "offset": offset, "count": 10})
        for item in page.get("user_list") or []:
            u = item.get("user_info") or {}
            if u.get("uid") in seen:  # 实测翻页会有重叠
                continue
            seen.add(u.get("uid"))
            creators.append({
                "uid": u.get("uid"),
                "sec_user_id": u.get("sec_uid"),
                "handle": u.get("unique_id"),
                "name": u.get("nickname"),
                "badge": u.get("enterprise_verify_reason") or u.get("custom_verify"),
                "followers": u.get("follower_count"),
            })
        if not page.get("has_more"):
            break
        offset = page.get("cursor")
    return creators
第一页(run fa68d6fa-922d-4d5f-936a-77bcb0446fc5)返回 10 个账号,has_more: 1,cursor: 10。每条结果把账号信息包在 user_info 里,旁边还有空着的 items、musics。只保留我用到的字段,国家地理那一条大致是这样:
{
  "cursor": 10,
  "has_more": 1,
  "user_list": [
    {
      "user_info": {
        "uid": "6780344874811442181",
        "sec_uid": "MS4wLjABAAAAEf96k3JW8-3eOhgzgQswlFF6ZDnn1dzqWWorJjwDsiNZymqTtvOcFhp_RiYYST6s",
        "unique_id": "natgeo",
        "nickname": "National Geographic",
        "follower_count": 9631551,
        "total_favorited": 54581367,
        "aweme_count": 1448,
        "custom_verify": "",
        "enterprise_verify_reason": "verified account",
        "verification_type": 1
      }
    }
  ]
}
翻页没有 cursor 看上去那么规整。我把返回的 cursor(10)当作下一页的 offset 发出去,第二页(run 11cca131-6901-4d39-8224-17bb7ae59b0c)却给了 20 个账号,cursor: 20,其中好几个第一页已经出现过。所以代码里有个 seen 去重。还有两点:verification_type 在每条结果里都是 1,有没有标签都一样,拿来过滤没意义;隔几分钟再搜,结果的顺序和内容也会变。用过哪份候选名单就存下来,别指望搜索能复现。
参考里还列了 user_search_follower_count、user_search_profile_type、user_search_other_pref 三个排序参数,默认都是空字符串,但没写可选值,我就没传。拿到列表自己过滤、排序,结果更可控。
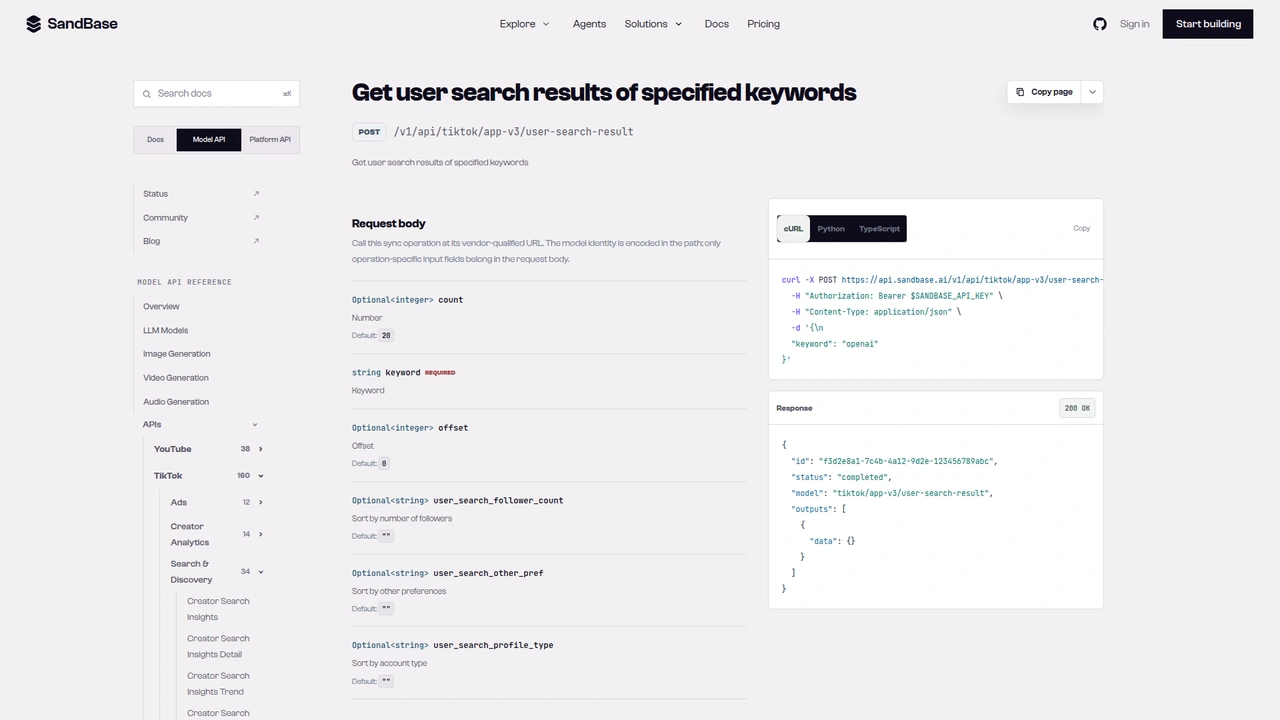
tiktok/app-v3/user-search-result 参考页:POST /v1/api/tiktok/app-v3/user-search-result,必填 keyword,可选 count(默认 20)、offset(默认 0),以及三个默认为空的排序字符串。文档里的响应示例 outputs[0].data 是空的。
第 2 步:读主页资料卡
def read_profile(sec_user_id: str) -> dict:
    user = call("tiktok/app-v3/user-profile", {"sec_user_id": sec_user_id}).get("user") or {}
    return {
        "handle": user.get("unique_id"),
        "name": user.get("nickname"),
        "bio": user.get("signature"),
        "badge": user.get("enterprise_verify_reason") or user.get("custom_verify"),
        "followers": user.get("follower_count"),
        "total_likes": user.get("total_favorited"),
        "videos": user.get("aweme_count"),
    }
App V3 README 要求只发送一个字符串标识符:sec_user_id、代表用户名的 unique_id,或纯数字字符串 user_id;另外两个不传。我试了用户名(unique_id: "natgeo",run ffcfb81a-34c8-4a6d-a286-bddd866b6f06)和 sec_user_id 两种,拿到的是同一个账号。在完整脚本那次运行里(run d2ee560c-dace-4092-8d09-677f3fc3277b),主页显示粉丝 9,630,810,总获赞 54,798,303,作品 1,518 条。
和几分钟前的搜索结果对一下:搜索里作品数是 1,448,获赞约 5,458 万。粉丝数只差几十,作品数却差了 70。认证标签的大小写也变了,搜索里是 verified account,主页里是 Verified account。在 2026-10-01 的这条工作流里,搜索用于挑账号,主页和作品调用提供分析数字,标签比较时忽略大小写。这次历史差异不能证明当前计数更准确、更新更及时,或不同端点之间始终一致。
第 3 步:翻页拉作品
def slim(a: dict) -> dict:
    s = a.get("statistics") or {}
    commerce = a.get("commerce_info") or {}
    return {
        "aweme_id": str(a.get("aweme_id")),
        "created": a.get("create_time"),
        "pinned": bool(a.get("is_top")),
        "branded": commerce.get("branded_content_type") == 1,
        "desc": (a.get("desc") or "")[:50],
        "plays": s.get("play_count"),
        "likes": s.get("digg_count"),
        "comments": s.get("comment_count"),
        "shares": s.get("share_count"),
        "saves": s.get("collect_count"),
    }


def list_posts(sec_user_id: str, max_pages: int = 3) -> list[dict]:
    max_cursor, posts, seen = 0, [], set()
    for _ in range(max_pages):
        page = call("tiktok/app-v3/user-post-videos",
                    {"sec_user_id": sec_user_id, "max_cursor": max_cursor, "count": 20})
        for a in page.get("aweme_list") or []:
            p = slim(a)
            if p["aweme_id"] not in seen:
                seen.add(p["aweme_id"])
                posts.append(p)
        if not page.get("has_more"):
            break
        max_cursor = page.get("max_cursor")
    return posts
参考的翻页规则是:第一页 max_cursor 传 0,下一页传上一次响应里的 max_cursor。实测一致,每页都带 has_more: 1 和一个像毫秒时间戳的 max_cursor。不过我传 count: 20,每页都只回 10 条,调用次数要按两倍预估。下面是某次第一页的节选(run 271f8aef-8b5c-4f88-a0b4-e719422a5446):
{
  "has_more": 1,
  "max_cursor": 1790190767062,
  "aweme_list": [
    {
      "aweme_id": "7683891628230315295",
      "desc": "Presented by @ROLEX. Welcome to Africa ...",
      "create_time": 1789045447,
      "is_top": 1,
      "commerce_info": { "branded_content_type": 0 },
      "statistics": {
        "play_count": 137129,
        "digg_count": 19138,
        "comment_count": 303,
        "share_count": 591,
        "collect_count": 1123
      }
    },
    {
      "aweme_id": "7689094110573120782",
      "desc": "Paid content for @De Beers. Nat Geo phot...",
      "is_top": 0,
      "commerce_info": { "branded_content_type": 1, "bc_label_test_text": "Paid partnership" },
      "statistics": { "play_count": 29360, "digg_count": 2018, "comment_count": 25 }
    }
  ]
}和一些同类短视频平台不同,这里的作品列表直接带真实播放数,可以拿来排序,不用额外补一次调用。有三个细节影响了排序代码。第一条是三周前的置顶作品(is_top: 1),排在所有新作品前面,算近期统计时要剔掉。标着 “Paid partnership”、“Commission paid” 的作品,commerce_info.branded_content_type 是 1,可以用来区分商单和自然内容;但置顶那条 “Presented by @ROLEX” 偏偏是 0,说明这个标记会漏。如果这个区分对你重要,再看一眼 desc。
参考写着 sort_type 为 0 是最新、1 是最热。我试了 sort_type: 1(run 45a21806-1713-493e-8ee4-9007b0110d42),顺序还是按时间倒序,置顶在最前,没有任何变化。所以排序一律在本地做。
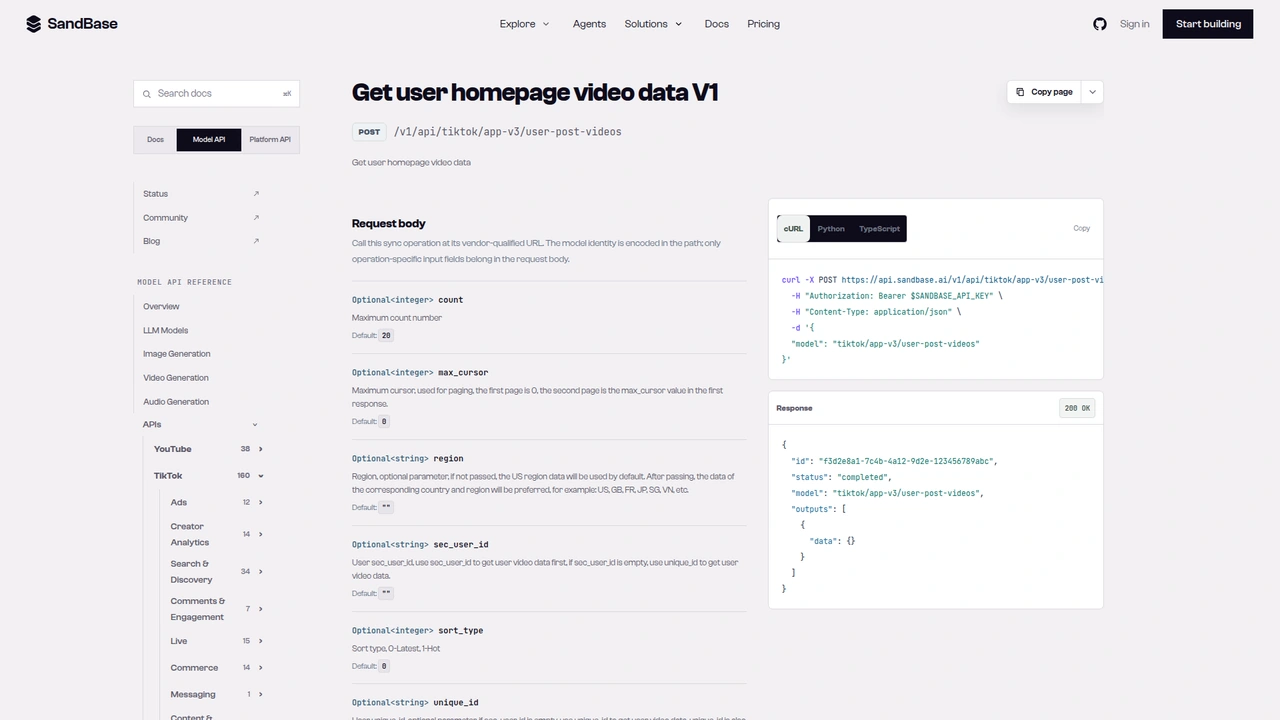
tiktok/app-v3/user-post-videos 参考页:可选 count(默认 20)、max_cursor(首页 0,之后用上次响应的值)、region、sec_user_id、sort_type(0 最新,1 最热)和 unique_id。自动生成的 cURL 示例在请求体里带了 model 字段。
第 4 步:排序,再回读头部作品
def refresh(aweme_ids: list[str]) -> dict:
    # multi-video 的 id 列表就放在名为 `body` 的字段里
    items = call("tiktok/app-v3/multi-video", {"body": aweme_ids})
    return {str(a.get("aweme_id")): slim(a) for a in (items or []) if isinstance(a, dict)}


def rank(posts: list[dict], key: str = "plays", top: int = 5) -> list[dict]:
    return sorted(posts, key=lambda p: p.get(key) or 0, reverse=True)[:top]
这个批量端点只有一个参数,是名叫 body 的数组,参考说一次最多 10 条。我一开始按抖音对应接口的习惯传了 aweme_ids,不对。实测返回的是一个完整作品对象的列表,顺序和传入的 id 一致,statistics 结构和作品列表一样,所以 slim() 两边都能用。只查一条的话还有 tiktok/app-v3/one-video(参数 aweme_id),它把作品包在 aweme_detail 里返回。
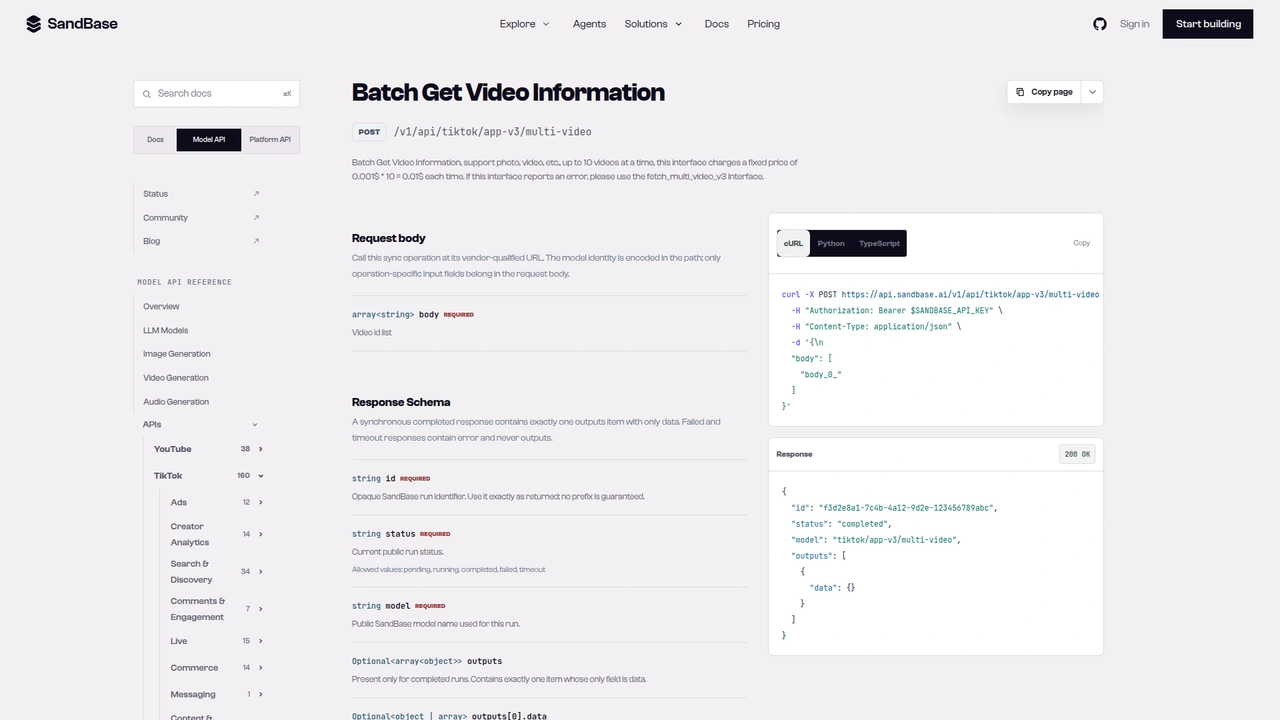
tiktok/app-v3/multi-video 参考页:必填的 body 数组放视频 id,说明里写一次最多 10 条,报错时可改用 v3 接口。说明里还有一行单次价格;这个端点在 SandBase 上按次计费,正式使用前请以目录页的单价为准。
串起来跑一遍
def matches(c: dict, keyword: str) -> bool:
    text = f"{c['handle']} {c['name']}".lower()
    return all(word in text for word in keyword.lower().split())


keyword = "national geographic"
shortlist = search_creators(keyword)
verified = sorted((c for c in shortlist if c["badge"] and matches(c, keyword)),
                  key=lambda c: c["followers"] or 0, reverse=True)
target = verified[0]
profile = read_profile(target["sec_user_id"])
posts = list_posts(target["sec_user_id"], max_pages=3)
organic = [p for p in posts if not p["pinned"]]
print("median plays", int(statistics.median(p["plays"] or 0 for p in organic)))
top = rank(organic, "plays")
for p in top:
    rate = (p["likes"] or 0) / p["plays"] if p["plays"] else 0
    print(f"{p['plays']:>10,} plays {p['likes']:>8,} likes {rate:5.1%} {p['desc'][:32]}")
fresh = refresh([p["aweme_id"] for p in top])
2026-10-01 的原版本完整脚本我原样跑过一遍,只在末尾加了几行打印:两次搜索(f9c69239-31e3-493b-a3fc-9a585b92f68c、cc1d00e6-de0a-4f8c-98df-092575d1de8e),一次主页(d2ee560c-dace-4092-8d09-677f3fc3277b),三页作品(d11bbc13-36ff-43b0-977c-776712a560f4、2e1b6a17-4117-44c7-9468-55760e54e9f4、8c5a905e-369b-4c9f-a8fd-0c1fc3ad5c34),一次批量回读(cb2d40b8-279f-42c2-a386-7ec6a23ee69a)。名称过滤后剩下 6 个带标签的国家地理账号,@natgeo 排第一。它的 30 条作品覆盖 2026 年 9 月 6 日到 30 日,其中 4 条被标为商单。去掉置顶后,播放中位数是 19,002。
真正有信息量的是排行头部。前两名是一条野猫视频和一条潘塔纳尔湿地的游猎片段,播放约 219 万和 177 万,都是中位数的 90 倍以上,点赞率分别是 9.8% 和 16.0%。第三名是一条节目宣传片,播放约 69.4 万,点赞率只有 0.8%。播放高、反应低,可能说明这条拿到了自然兴趣之外的分发,但这份数据说明不了原因,我会标出来交给人看,不下结论。表现最好的赞助内容是一条 “Presented by @ROLEX” 的视频,排第五,播放约 4.9 万。
批量回读时,播放数最多只差个位数(比如 2,194,819 变成 2,194,825)。发布几天的作品本来就是这样,回读真正有用的场景,是每天跟踪一条新发作品。
要研究多个创作者,就遍历 verified,按 uid 每人存一条记录。翻三页的话,每个创作者 5 次调用:主页 1 次、作品 3 页、批量回读 1 次。把记录交给模型,可以让它比较各账号的播放中位数、总结每个号的爆款题材,或者把“播放高但点赞率异常低”的作品挑出来。
文档保证 vs 实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/tiktok/app-v3/user-search-result,参数 keyword、offset、count | 参考有记录 |
POST /v1/api/tiktok/app-v3/user-profile,sec_user_id、unique_id、user_id 三选一 | 参考有记录 |
POST /v1/api/tiktok/app-v3/user-post-videos,参数 sec_user_id、max_cursor、count、sort_type | 参考有记录 |
POST /v1/api/tiktok/app-v3/multi-video,参数 body(最多 10 个 id) | 参考有记录 |
信封 id / status / model / outputs[0].data | 参考有记录 |
搜索 user_list[].user_info 里的 uid、sec_uid、unique_id、follower_count、enterprise_verify_reason;cursor、has_more | 仅实测观察 |
主页 user.follower_count、total_favorited、aweme_count、signature | 字段路径来自 2026-10-01 历史观察;当前 App V3 README 另列字段和截短示例,不保证路径稳定或每次都有全部值 |
作品 aweme_list[].statistics.play_count(非零)、is_top、commerce_info.branded_content_type;max_cursor、has_more | 仅实测观察 |
multi-video 返回作品对象列表 | 仅实测观察 |
sort_type: 1 改变排序 | 我的调用里没观察到 |
常见用法
找官方号
做外联或竞品跟踪之前,先确认哪个用户名才是真品牌。输入:品牌关键词。输出:带标签、按粉丝排好序的账号,山寨号剔除。端点:user-search-result。
品牌号、媒体号的内容复盘
拉最近几周的作品,看哪些题材爆了、哪些扑了。输入:一个 sec_uid。输出:按播放和点赞率排序的作品。端点:user-profile、user-post-videos。
商单和自然内容对比
按 branded_content_type 分组(再结合 desc 检查),比较两组的播放中位数。输入:作品列表。输出:两个中位数和差距。端点:user-post-videos。
子账号横向对比
品牌往往有地区号和栏目号,上面的搜索结果就是例子。比较各账号的单条播放中位数,而不是比粉丝总数。输入:带标签的候选名单。输出:每个账号一行。端点:四个都用。
实用提示
- 认证标签两个字段都读。 品牌号的标签在
enterprise_verify_reason,custom_verify是空的;verification_type别用。 - 搜索结果按
uid去重。 翻页有重叠,返回条数也会超过count。 - 每页按 10 条预估。 传
count: 20每次都只回 10 条。 - 置顶作品排最前。 算近期统计和中位数时剔掉
is_top的作品。 - 商单标记不全。 有一条赞助内容没被标出来,配合
desc一起判断。 - 排序在本地做。
sort_type: 1在我的调用里没改变顺序。 - 批量 id 放在
body里。 参考说一次最多 10 条。 - 业务字段只是实测观察。 依赖之前先用真实响应核对。
- 只研究公开的品牌号和媒体号。 存账号级、作品级指标,不存观众或评论者的个人数据。
常见问题
需要 TikTok 账号或开发者应用吗?
不需要。用 SANDBASE_API_KEY 向 SandBase 鉴权即可,这些只读端点不需要你这边做 TikTok 登录或 OAuth。
收费吗?
每个组织每天的 100 次免费数据 API 调用用完后,这四个端点按次计费,单价以 SandBase 目录页或 sandbase inspect <model> 的结果为准,批量跑之前先确认。
sec_user_id 从哪来?
从搜索结果来,每条的 user_info.sec_uid 就是。如果你已经知道用户名,user-profile 也接受 unique_id。
怎么区分官方号和山寨号?
保留 enterprise_verify_reason 或 custom_verify 非空的结果,再按粉丝排序。我这次测试里,山寨号两个字段都是空的。
为什么要 20 条只回 10 条?
我请求的每一页都是这样。用返回的 max_cursor 继续翻,直到 has_more 为假。
小结
一个关键词就能开始研究 TikTok 创作者,前提是认证标签读对字段。搜索给你候选账号和 sec_uid,主页给你资料卡,作品列表给你播放、点赞和商单标记,批量接口负责回读关键作品。排序放在本地做,就能看清一个账号的数据是靠哪几条作品撑起来的,哪些作品只是沾了账号的光。其余 TikTok 端点见 TikTok 公开数据 API 总览。准备好了就可以开始:
2026 年 SandBase TikTok 枢纽的标价,见 2026 年最佳 TikTok API:价格对比。
觉得有用?分享给更多人