TikTok 视频刷量检测:用 API 查假播放量(2026 实测)
TikTok 视频刷量怎么查?从分享链接拿到视频 ID,调一次免费的假播放量检测接口,逐块读懂 fake_score、estimated_fake_views 和各项预警。附 8 个品牌官方账号实测和 57 行 Python 脚本。
我拿 TikTok 官方账号自己的一条视频去跑假播放量检测。这条视频有 1.62 亿播放,结果很干净:fake_score 4.34,is_suspicious 为 false。可同一份报告里又写着 estimated_fake_views: 8102335,还给 TikTok 官方号挂了一条“涨粉过快”的警告。
810 万“假播放”听着像铁证,其实只是 5% 的基线乘以总播放量。投放前想做 TikTok 视频刷量检测,最容易踩的坑就在这里:把一个估算数字当成了查出来的数字。本文用 SandBase 的 tiktok/analytics/detect-fake-views 接口,演示从任意链接拿到视频 ID、调一次接口、把报告每一块读明白。读者是给达人投放前要做核查的品牌和代理商,以及要把这一步写进工具里的开发者。2026-10-04 我用 8 个认证品牌和媒体账号的公开视频做了实测。
先说结论
- 一条公开链接,两次调用出结果:
tiktok/web/aweme-id把链接(包括/t/短链)转成视频 ID,detect-fake-views返回报告。两个接口 2026-10-04 在目录里都标 Free,实际扣费 $0。estimated_fake_views就是total_views乘以fake_view_percentage,而这个百分比在我的测试里只出现过三档:5、约 20、约 30。它是分档估算,不是逐条查出的假播放数。- 8 条认证品牌视频,
is_suspicious全是 false,confidence_level全是 “Minimal”,fake_score在 4.34 到 31.12 之间。其中 4 个账号被挂了涨粉类警告(出现在fan_growth或creator_credibility里),TikTok 官方号也在内。content_category对粉丝超过 1800 万的两个账号完全没影响;对一个 6.28 万粉的账号,分数在 24.51 到 31.71 之间变动,选entertainment时估算档位从 20% 跳到 30%。- 这是第三方的启发式判断,不是 TikTok 官方数据,也不能当刷量证据。它的用处是帮你决定该找哪些达人要后台数据。
这个接口能做什么,不能做什么
接口拿公开视频的计数(播放、点赞、评论、分享、收藏)和达人的涨粉历史,从 8 个维度打分。它的说明里写的是基于 “TikTok’s Traffic Pool theory”(流量池理论),这是供应方对 TikTok 分发机制的理解,不是 TikTok 公开的规则。SandBase 只是把请求转给第三方服务,自己不跑检测模型。
它能给出风险信号,但判断不了某一次播放是不是假的:它看到的是公开计数器,看不到 TikTok 的播放日志。我手上也没有“已知刷量”的标注样本,所以下文测的是接口的行为,不是准确率。
数据边界
只读公开数据,需要 SandBase API Key。SandBase 不是 TikTok 官方合作方,碰不到私密账号、私信、达人自己的后台数据,也不做任何账号操作。实测只用了认证品牌、媒体和 TikTok 官方账号,本文不会说任何账号刷量。
| 需求 | 用什么 |
|---|---|
| 投放前对任意公开视频做快速风险筛查 | detect-fake-views(本文) |
| 达人真实的受众、完播和流量来源 | 让达人提供 TikTok Studio 后台截图或导出 |
| 自己账号的数据 | TikTok Studio |
第一步:从链接拿到视频 ID
检测接口要的是 item_id,也就是 https://www.tiktok.com/@tiktok/video/7460937381265411370 里那串长数字。完整链接可以自己解析;https://www.tiktok.com/t/... 这种分享短链里没有 ID,就交给 tiktok/web/aweme-id。名字更直观的 tiktok/app-v3/one-video-by-share-url 在 2026-10-04 是下线状态,别用。其他短链域名我没测。
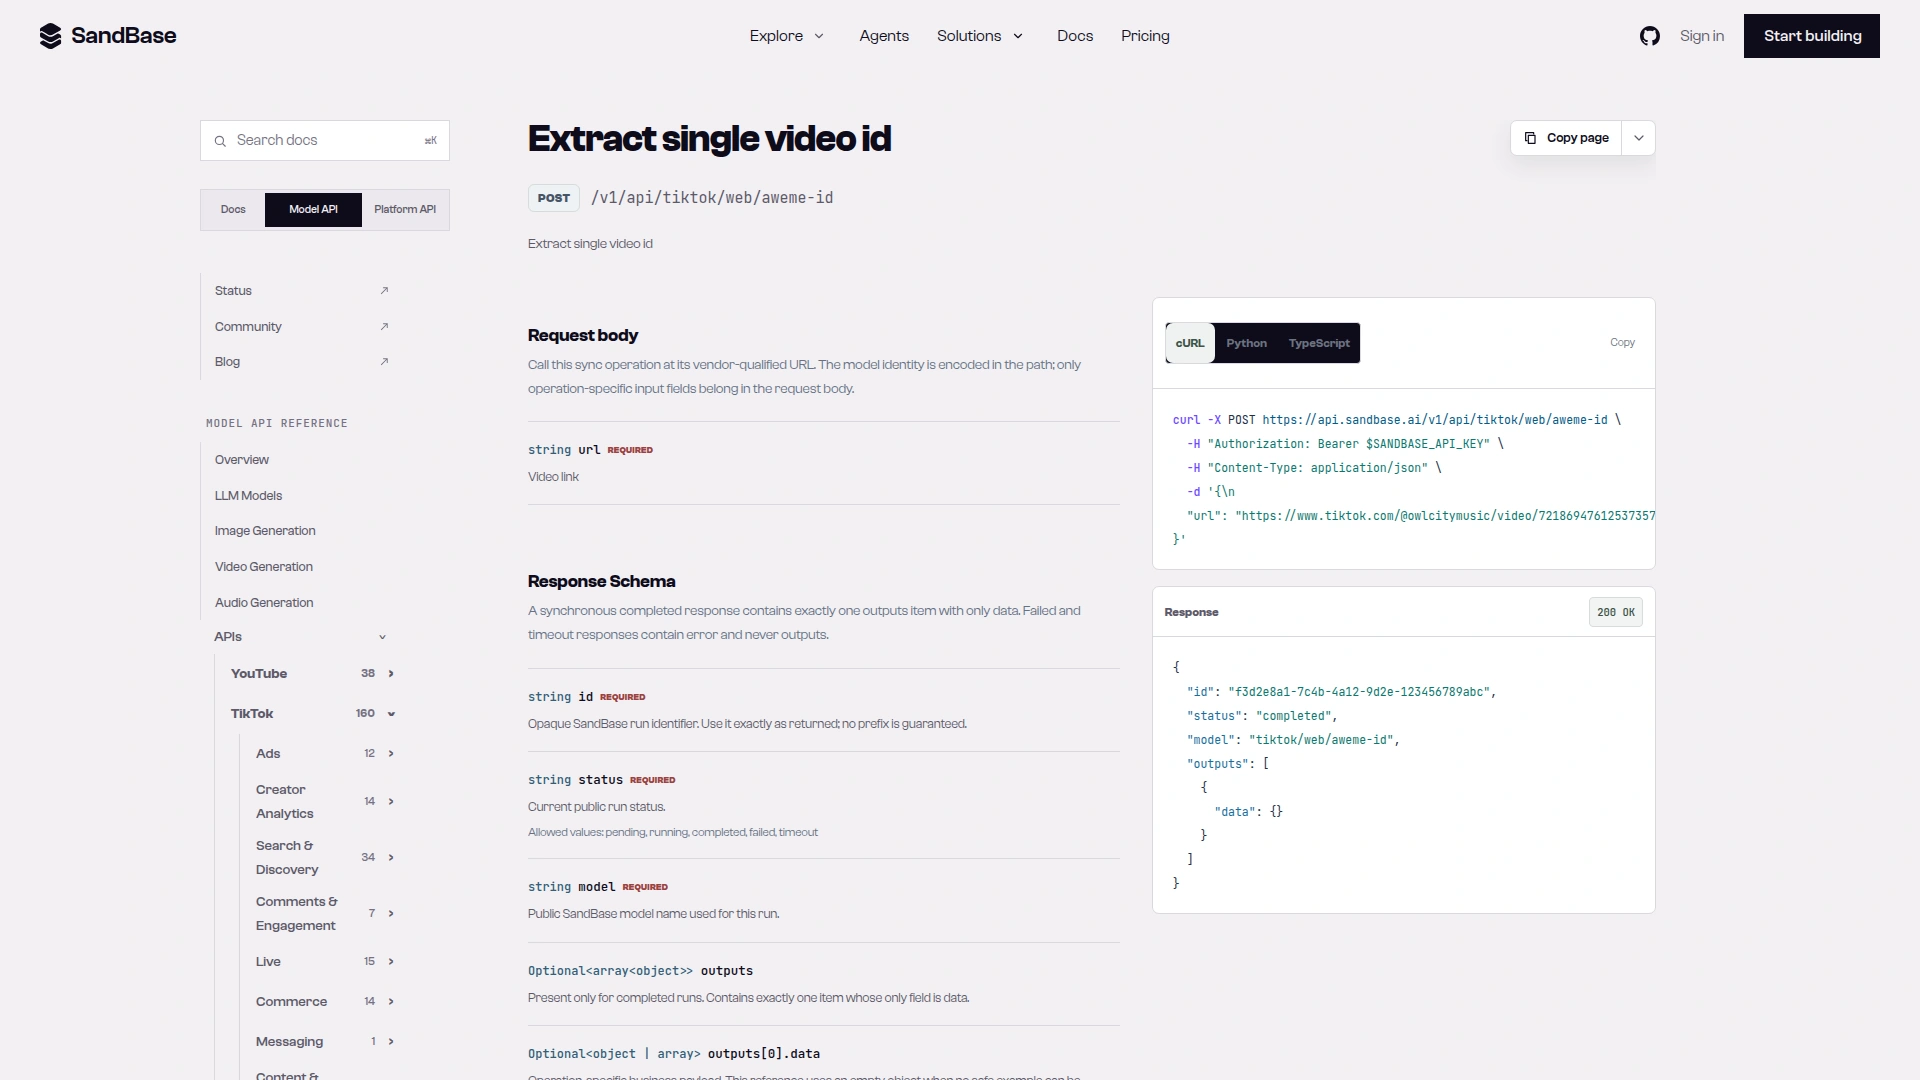
截图:aweme-id 参考页只有一个必填字段 url,路由就是脚本调用的 POST /v1/api;示例返回是空对象,实测返回的是一个 ID 字符串(2026-10-04 截取)。
curl -s https://api.sandbase.ai/v1/api/tiktok/web/aweme-id \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://www.tiktok.com/t/ZP9DAsd5x3xtR-37cuu/"}'
这条短链是我用 tiktok/app-v3/share-short-link 给 TikTok 那条视频生成的。返回的 outputs[0].data 直接是字符串 "7460937381265411370",耗时 1.8 秒(run fade1bb3-3d8e-4c0e-bd8a-39686c18aab7)。完整链接带不带 ?is_from_webapp=1&sender_device=pc,都在 1 秒内解析出同一个 ID。主页链接会失败:HTTP 503,提示 “upstream error 400”,不扣费。
第二步:调一次检测接口
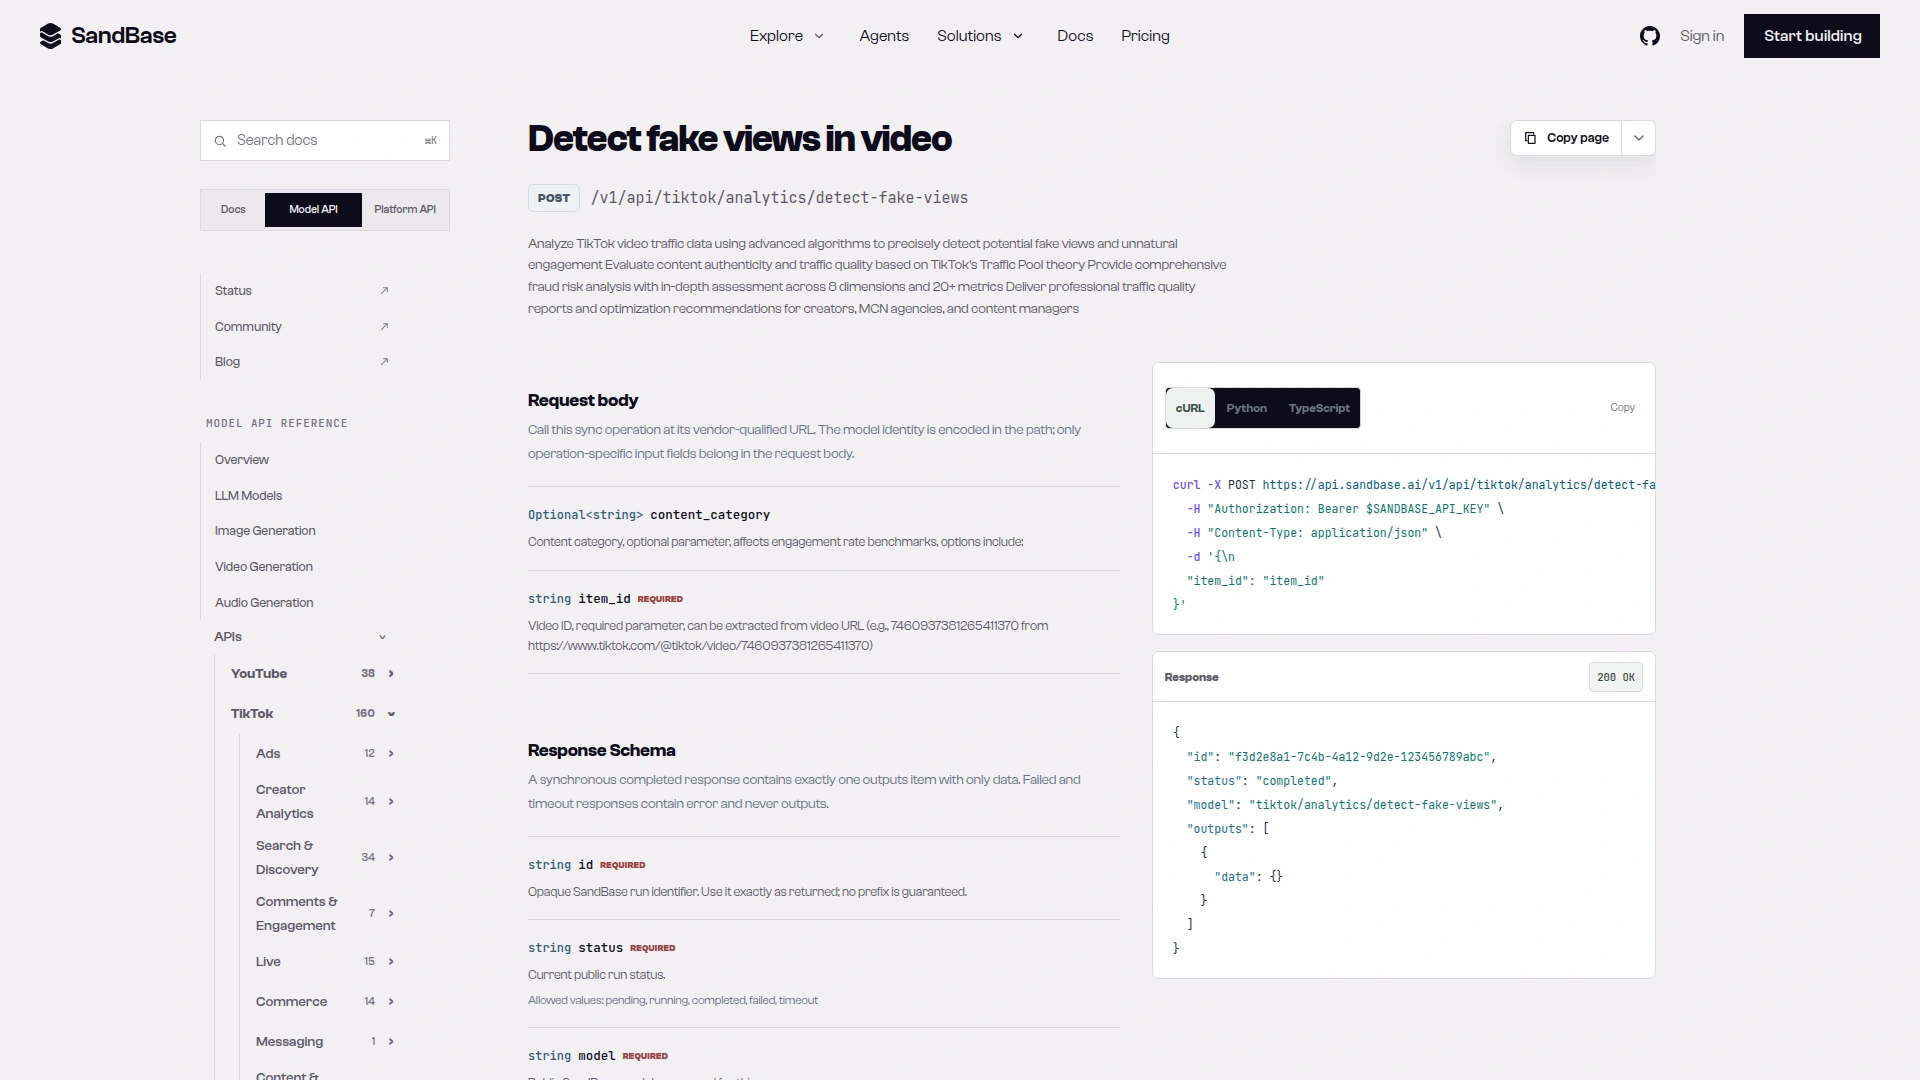
截图:detect-fake-views 参考页给出 POST 路由、必填的 item_id 和可选的 content_category,返回只写了信封结构、data 是空对象,所以下文的报告字段都来自实测(2026-10-04 截取)。
curl -s https://api.sandbase.ai/v1/api/tiktok/analytics/detect-fake-views \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"item_id": "7460937381265411370"}'
用的是参考页上的 Model API 路由,不是目录页的 GET 路由,body 里只放这个接口自己的参数。同步返回,报告就在同一个响应的 outputs[0].data 里,不用轮询。
2026-10-04(UTC)实测
样本:TikTok、Duolingo、National Geographic、Chipotle、NASA、MIT、Figma、Cloudflare 各一条公开视频,8 个账号在数据里都是认证状态。除 TikTok 外,每个品牌用 tiktok/app-v3/user-post-videos 取最近一条非置顶、发布满 3 天的视频;TikTok 用接口示例里那条。ESPN 和 NBA 原本也在名单里,但返回的作品不是置顶就是发布不满 3 天,所以没进样本。一共记录了 23 次成功的检测调用,首次就成功的调用耗时 2.0 到 3.8 秒。
TikTok 那条视频的 fake_view_analysis 完整返回如下(run 397720a1-dee5-4b33-985f-ebc1cd3d8b12):
{"component_scores": {"consistency_score": 0, "content_authenticity_score": 34.0,
  "creator_credibility_score": 0, "distribution_score": 0, "engagement_score": 0.0,
  "fan_growth_score": 45, "follower_correlation_score": 35.0, "racing_mechanism_score": 0},
 "confidence_level": "Minimal", "estimated_fake_views": 8102335, "fake_score": 4.34,
 "fake_view_percentage": 5.0, "is_suspicious": false,
 "main_detection_reason": "Multiple Anomalous Indicators"}
同一个响应里 video_metrics.total_views 是 162046716,乘以 5% 正好是 8102335.8。其余顶层字段还有 detailed_analysis、creator_metrics、mcn_report、traffic_pool、suspicious_features 等,这里省略。所有字段名都是实测观察到的,不是文档保证。
稳定性也要提一句:UTC 01:20 前后约 10 分钟内,23 次检测调用有 20 次重试 3 次后仍返回 HTTP 503(“upstream error 400”,不扣费)。紧接着重跑,20 次全部一次成功。所以下面的脚本对 5xx 做了重试。
第三步:读懂报告
| 字段 | 含义 | 可信度 |
|---|---|---|
fake_score | 8 个维度加权的风险分,实测 4.34 到 31.71 | 适合横向比较,没有公开的刻度和阈值 |
is_suspicious | 接口给的是否可疑 | 8 条全是 false,唯一像“结论”的字段 |
confidence_level | 置信度 | 我的每次调用都是 “Minimal” |
fake_view_percentage | 判定为假的播放占比 | 只出现过 5、约 20、约 30 三档 |
estimated_fake_views | total_views × 上面的百分比 | 档位乘法,别当成实数引用 |
component_scores | 8 个分项 | 要配合 detailed_analysis 看,好几项因为缺数据是 0 |
detailed_analysis.engagement | 点赞、评论、分享、收藏率和基准对比 | 最透明的一块,每条预警都写明了用的阈值 |
detailed_analysis.follower_correlation | 粉丝档位和该档基准 | 自己核查时很好用 |
fan_growth、creator_credibility | 涨粉里程碑 | 8 个认证品牌里 4 个被挂了警告 |
traffic_pool | 供应方定义的“流量池”层级 | estimated_organic_views 等于播放 ×(1 − fake_score/100),和 estimated_fake_views 对不上 |
mcn_report.business_impact.revenue_impact | 金额影响 | estimated_fake_views 按固定 $1 CPM 换算,不是实际损失 |
suspicious_features | 所有预警汇总 | 要逐条读,别数条数 |
有几个维度名字很唬人,信息量却不大。racing_mechanism 在 8 条视频上都是 “Insufficient data”;consistency_score 和 creator_credibility_score 8 条全是 0;distribution 在数据够用的 7 条上全报了 “Statistical anomalies detected in view distribution”,分数都是 65。一条在每个认证品牌视频上都会触发的预警,等于没区分度。
TikTok 那条分数最低,原因也很平淡:它的 distribution_score 是 0,因为 “Insufficient view data for distribution analysis”,其他 7 条在这一项都是 65。数据越少,分数反而越低。
8 条品牌视频结果
| 账号 | 接口判定档位 | 粉丝 | 播放 | 点赞/播放 | fake_score | fake_view_percentage | is_suspicious |
|---|---|---|---|---|---|---|---|
| TikTok | xxlarge | 9604 万 | 1.62 亿 | 9.83% | 4.34 | 5.0 | false |
| Duolingo | xxlarge | 1819 万 | 187,921 | 2.69% | 20.09 | 20.0 | false |
| National Geographic | xlarge | 964 万 | 11,679 | 4.67% | 20.60 | 19.99 | false |
| Chipotle | xlarge | 293 万 | 30,473 | 1.70% | 21.93 | 20.0 | false |
| NASA | xlarge | 196 万 | 125,049 | 5.43% | 27.30 | 20.0 | false |
| Figma | medium | 6.28 万 | 2,150 | 4.93% | 26.83 | 20.0 | false |
| MIT | medium | 13.3 万 | 55,221 | 6.31% | 31.12 | 30.0 | false |
| Cloudflare | small | 2.15 万 | 631 | 6.50% | 24.61 | 19.97 | false |
均为默认分类、每条一次调用。8 条的 confidence_level 都是 “Minimal”,recommendations.action 都是 “no_action”。播放最少的两条因为分享数是 0 和 1,被打上 “Critical: Share Ratio is extremely low”;几百播放的视频,多一个分享就能改变结论,我更倾向于把它看作样本太小。同一条视频反复调用,分数不变:TikTok 和 Duolingo 各记录 6 次,约 20 分钟内。
content_category 到底改了什么
content_category 可选 default、entertainment、education、product、verified_large,schema 说它“影响互动率基准”。我对 3 条视频把 5 个值都跑了一遍。
| 视频 | default | entertainment | education | product | verified_large |
|---|---|---|---|---|---|
| TikTok(9604 万粉) | 4.34 | 4.34 | 4.34 | 4.34 | 4.34 |
| Duolingo(1819 万粉) | 20.09 | 20.09 | 20.09 | 20.09 | 20.09 |
| Figma(6.28 万粉) | 26.83 | 31.71 | 29.11 | 25.56 | 24.51 |
两个大号不管传什么,benchmark_category 都固定是 verified_large。不传分类时,百万粉以上的 5 个认证账号都被归到 verified_large,更小的归到 default。Figma 这条分类生效了,预警文案能看出原因:entertainment 下点赞率对比的平均值是 0.05,收藏率平均值 0.005,分享率最低值 0.001;default 下收藏率平均值是 0.003,分享率最低值 0.0005。换成 entertainment 后百分比进了 30 档,同样 2,150 播放,estimated_fake_views 从 430 变成 645。
结论:按视频实际内容选分类,比较多个达人时保持同一个分类。选了更严的基准,达人就会“看起来更可疑”。
不靠接口也能自查的信号
点赞/播放、评论/点赞、分享/播放,用公开计数自己就能算。接口返回的 tier_benchmarks 可以拿来当参照,view_ratio 指播放除以粉丝:
| 档位(我样本里的粉丝数) | 播放/粉丝:最低、平均、良好 | 点赞/粉丝:最低、平均、良好 |
|---|---|---|
| small(2.15 万) | 0.08、0.25、0.6 | 0.008、0.025、0.06 |
| medium(6.28 万、13.3 万) | 0.05、0.15、0.4 | 0.005、0.015、0.04 |
| xlarge(196 万到 964 万) | 0.01、0.05、0.2 | 0.001、0.005、0.02 |
| xxlarge(1819 万、9604 万) | 0.005、0.02、0.1 | 0.0005、0.002、0.01 |
我会按这个顺序看:
- 播放远超同档、点赞远低于同档。 如果买的是不带点赞的播放,点赞/播放会掉下去,播放/粉丝会冲上来。单看播放/粉丝高没意义:TikTok 那条是 1.69,远超“良好”。
- 和达人自己的其他视频对不上。 拿最近 10 到 20 条比点赞/播放,一条离群值比任何分数都更值得拿去问达人。
- 评论和点赞不成比例。 大视频评论/点赞接近 0,或者小视频评论多得离谱。
- 涨粉突增。 8 个认证品牌里有 4 个被挂了涨粉警告,单凭这一条说明不了问题。
这些都不是证据。付费推广就可能让播放和点赞拉开差距,这是正常原因之一,而公开数据看不出视频有没有投流。
完整脚本
一个文件,57 行,Python 加 requests。用法:python3 check_views.py <链接> [分类]。下面就是我实际运行的文件。
#!/usr/bin/env python3
"""Screen a public TikTok video for fake-view risk signals. Usage: python3 check_views.py <video or share URL> [category]"""
import os
import sys
import time

import requests

BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}


def call(model: str, params: dict, tries: int = 3):
    for attempt in range(tries):  # upstream 5xx came in bursts during testing; retry with a pause
        resp = requests.post(f"{BASE}/{model}", headers=HEADERS, json=params, timeout=120)
        body = resp.json()
        if resp.status_code < 500 or attempt == tries - 1:
            break
        time.sleep(10)
    outputs = body.get("outputs") or []
    if resp.status_code != 200 or body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"{model}: HTTP {resp.status_code} {body.get('status')} {body.get('error')}")
    return outputs[0].get("data")


def main(url: str, category: str | None = None):
    item_id = call("tiktok/web/aweme-id", {"url": url})  # observed: a bare id string
    params = {"item_id": str(item_id)}
    if category:
        params["content_category"] = category
    r = call("tiktok/analytics/detect-fake-views", params)
    fv, da = r.get("fake_view_analysis", {}), r.get("detailed_analysis", {})
    vm, cm = r.get("video_metrics", {}), r.get("creator_metrics", {})
    eng = da.get("engagement", {})
    views = vm.get("total_views") or 0
    print(f"video {item_id}: {views:,} views, {cm.get('follower_count', 0):,} followers "
          f"(tier {da.get('follower_correlation', {}).get('follower_tier')}, "
          f"benchmarks {eng.get('benchmark_category')}, verified {cm.get('verified')})")
    for k, v in (eng.get("engagement_metrics") or {}).items():
        print(f"  {k:15} {v:.4f}")
    print(f"fake_score {fv.get('fake_score')}, suspicious {fv.get('is_suspicious')}, "
          f"confidence {fv.get('confidence_level')}")
    print(f"estimated_fake_views {fv.get('estimated_fake_views'):,} = views x {fv.get('fake_view_percentage')}% "
          f"(a bucketed estimate, not a count)")
    no_data = [k for k, v in da.items() if isinstance(v, dict)
               and any("nsufficient" in i for i in v.get("issues") or [])]
    print("components without enough data:", ", ".join(no_data) or "none")
    for flag in r.get("suspicious_features") or []:
        print("  flag:", flag)
    action = (r.get("recommendations") or {}).get("action")
    verdict = "review manually" if fv.get("is_suspicious") else "no strong signal"
    print(f"screening verdict: {verdict} (endpoint action: {action}; heuristic, "
          "ask the creator for TikTok analytics before deciding)")


if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2] if len(sys.argv) > 2 else None)
结论行故意写得很克制:只复述接口自己的 is_suspicious,不给 fake_score 拍一个阈值,因为没有标注数据,定不出来。“components without enough data” 那一行和分数一样重要:建立在缺失数据上的低分,不等于没问题。
用短链跑的输出(2026-10-04 01:43 UTC,全程 3.6 秒):
video 7460937381265411370: 162,046,731 views, 96,045,042 followers (tier xxlarge, benchmarks verified_large, verified True)
  comment_ratio   0.0022
  favorite_ratio  0.0068
  like_ratio      0.0983
  share_ratio     0.0081
fake_score 4.34, suspicious False, confidence Minimal
estimated_fake_views 8,102,336 = views x 5.0% (a bucketed estimate, not a count)
components without enough data: consistency, distribution, racing_mechanism
  flag: Suspicious: Reached 100000 followers from 10000 in only 31 days
  flag: Suspicious: Account gaining 22674 followers per day on average
screening verdict: no strong signal (endpoint action: no_action; heuristic, ask the creator for TikTok analytics before deciding)
换成 Figma 那条加 entertainment,输出 fake_score 31.71 和 estimated_fake_views 645 = views x 29.99%。传主页链接,脚本直接抛 RuntimeError: tiktok/web/aweme-id: HTTP 503 停下,不会悄悄给你一份空报告。
费用
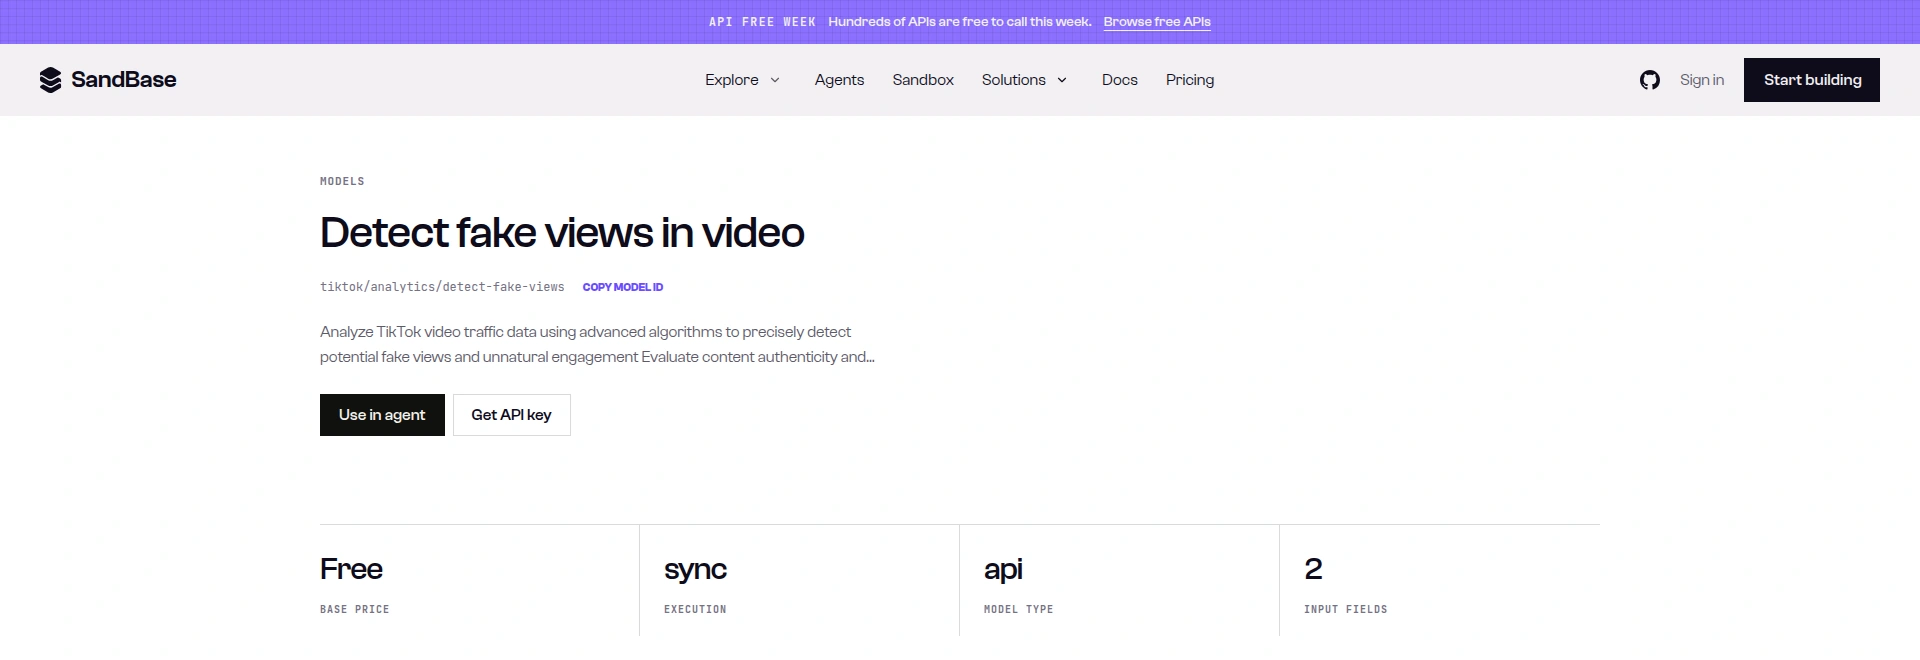
截图:2026-10-04 的 detect-fake-views 模型页显示基础价格 Free、同步执行、2 个输入字段,顶部挂着 “API Free Week” 横幅,价格请以当天为准(2026-10-04 截取)。
2026-10-04 用 GET /v1/models/<model> 查,detect-fake-views、aweme-id、video-metrics、user-post-videos 的 base_price 都是 "0"。这个接口需要同一把 Bearer Key,公开的模型页不登录也能看价格。我用 GET /v1/tasks/<id>/cost(同样要 Key)抽查了 3 次调用,"cost" 都是 "0.000000"。页面有免费周横幅,价格可能会变,大批量跑之前先看一眼模型页。
延伸阅读
想知道这个检测接口在大量视频上表现如何,可以看 TikTok 刷量识别实测:68 个公开视频跑下来,分数主要受哪些因素影响。签约前想一次性筛查达人最近的作品,可以看 TikTok 达人刷量审核 Agent。
局限
范围:8 条认证品牌和媒体账号的公开视频、3 组分类对比、一天。没有个人达人、没有已知刷量样本、没有标注真值,所以本文说明的是接口怎么表现,不是它准不准。三个百分比档位、estimated_fake_views 和 estimated_organic_views 的算法、粉丝档位划分,都是我从返回里观察到的,参考文档没有写。测试脚本和原始返回留在内部;样本规则、输入、run id 和汇总数据都在正文里。
下一步
- 别只看一条视频,把达人最近 20 条都筛一遍。主页和作品列表的拉法见 TikTok 达人研究教程。
- TikTok 其他接口能做什么,看 TikTok 数据 API 总览。
- 小红书上做同样的达人筛查,可以参考 KOL 筛选 Agent 教程。
想自己跑,先看 detect-fake-views 接口参考,或者在模型页直接试,然后申请 SandBase API Key。
常见问题
TikTok 上能看到假播放吗?
直接看不到。公开计数不会标哪些播放是假的。你能做的是自己算比例、用这类启发式工具看风险信号,播放日志只有 TikTok 自己能看。
怎么判断一条 TikTok 视频有没有刷量?
看播放相对粉丝档位是否偏高、点赞评论分享是否偏低,再和达人自己的其他视频对比,最后找达人要后台数据。我的实测里,8 条认证品牌视频没有一条被接口判为可疑,分数在 4.34 到 31.12 之间。
有免费的 TikTok 假播放量检测工具吗?
这个检测接口和链接转 ID 的接口,2026-10-04 在 “API Free Week” 横幅下都标 Free,实际扣费 $0,需要一个 SandBase API Key。价格可能变化,以模型页为准。
TikTok 会删除刷出来的播放吗?
TikTok 的 Countering deceptive behavior 页面(2026-10-04 查阅)写明:不允许用机器人、脚本等手段人为抬高播放、点赞、评论、分享等互动数据,违规的内容或账号会被删除;每年拦截数百亿次虚假互动尝试,并在社区准则执行报告里按季度披露。页面没有说具体某条视频的播放数会怎么调整。
estimated_fake_views 是什么意思?
它等于 total_views 乘以 fake_view_percentage。TikTok 那条视频是 1.62 亿乘 5%,同时分数只有 4.34、也没被判可疑。看分数和判定,别看这个乘出来的数。