Claude Sonnet 5.5 和 GPT-6.1 Sol 对比:哪个更适合 Agent?
Claude Sonnet 5.5 和 GPT-6.1 Sol 标价都是 $2/$10,做工具调用 Agent 该选哪个?10 个任务各跑 3 次,对比准确率、单任务成本、延迟和 token 开销。
同一页 20 条抖音视频,让两个模型算平均点赞数。GPT-6.1 Sol 三次都答 422,764,和代码算出来的一致。Claude Sonnet 5.5 第一次答对,第二次 416,992,第三次 434,643。
这是本次 Claude Sonnet 5.5 和 GPT-6.1 Sol 对比里最明显的差别。两家标价一模一样,都是每百万输入 token $2、输出 $10,光看价目表定不了默认模型。所以我们在 2026-10-03(UTC)通过 SandBase 跑了一组工具调用 Agent 实测:10 个任务、6 个数据工具,每个模型每个任务跑 3 次,答案逐字段精确比对。
先说结论
- GPT-6.1 Sol 30 次全对;Claude Sonnet 5.5 对了 27 次。错的 3 次都是对工具返回结果做算术或计数:两次平均值、一次日期计数。
- 两个模型在每个任务上选的工具、调用次数完全一样。选工具这一步,看不出差距。
- GPT-6.1 Sol 单任务成本约为一半(中位数 $0.0066 对 $0.0123),也更快(中位数 6.7 秒对 11.1 秒)。差距主要来自 token:Sonnet 5.5 输入约 1.7 倍、输出约 3 倍。
- 测试范围:10 个任务各 3 次,中文社媒数据工具,默认参数,单一时间窗口。它能说明短小、结构化的 Agent 任务,不是通用排名。
为什么现在比这两个模型
72 小时里连着三家发布。Anthropic 9 月 28 日发布 Claude Sonnet 5.5,定位是 Claude Opus 5.5 的更快、更便宜的搭档,最擅长边界清晰的日常任务;价格沿用 Sonnet 5,输入 $2、输出 $10。
OpenAI 9 月 29 日在 DevDay 上推出 GPT-6.1 Sol(官方回顾,TechCrunch 报道)。OpenAI 的模型页说它以更低成本接近 Astra 水平,价格页上 gpt-6.1-sol 是输入 $2、输出 $10,正好是 GPT-6 Astra($10/$50)的五分之一。
9 月 30 日 Google 也公布了 Gemini 4 Argon,首发价同样是 $2/$10,但目前只通过 Fairwind 计划向少量用户开放,SandBase 上也没有,所以这次不测。
两个都能直接用的模型,标价完全相同。对做 Agent 的人来说,问题不是“谁更聪明”,而是:一个短小的工具调用任务,谁更稳地答对,每答对一次花多少钱。
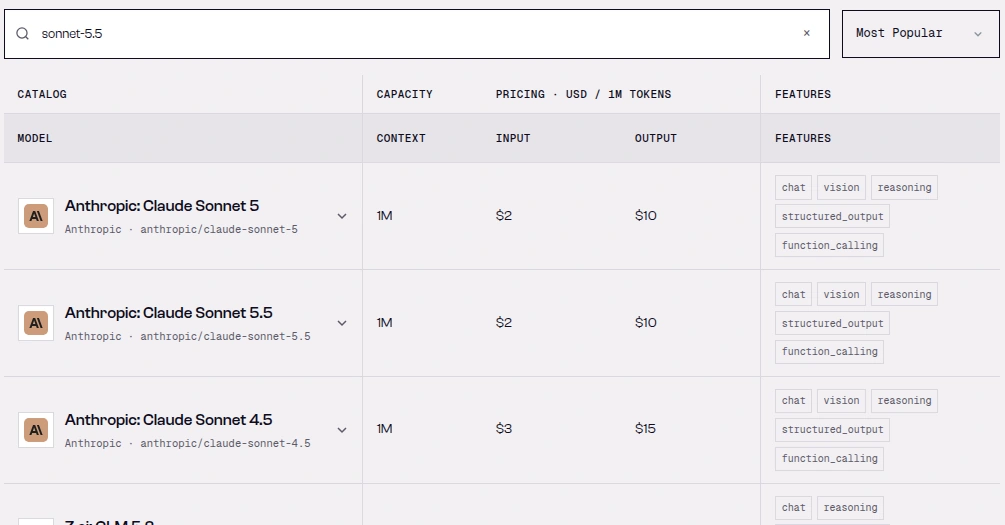
截图:SandBase 模型目录中 anthropic/claude-sonnet-5.5 的价格为每百万 token 输入 $2、输出 $10,本文成本按这个费率计算(2026-10-03 截取)。
这一行和 GET /v1/models/anthropic/claude-sonnet-5.5 返回的 model_card 一致,我们在 10 月 2 日和 3 日各查了一次。想直接试,可以打开 SandBase 上的 Claude Sonnet 5.5 模型页和 GPT-6.1 Sol 模型页。
测试怎么做的
两个模型拿到的系统提示词、6 个工具定义、任务原文完全相同。Sonnet 5.5 走 SandBase POST /v1/messages(Anthropic Messages 协议,工具写成 input_schema);GPT-6.1 Sol 走 SandBase POST /v1/chat/completions(OpenAI function tools)。每轮最多输出 1,500 token,每个任务最多 10 轮,temperature 和推理强度都用默认值。
6 个工具分别封装了 SandBase 的公开数据接口:
| 工具 | SandBase 接口 |
|---|---|
douyin_user_search | douyin/search/user-search-v2 |
douyin_user_profile | douyin/app-v3/user-profile |
douyin_user_videos | douyin/app-v3/user-post-videos |
weibo_hot_search | weibo/web-v2/hot-search |
weibo_search | weibo/web-v2/realtime-search |
xhs_search_notes | xiaohongshu/app-v2/search-notes |
社媒数据每分钟都在变,直接实时调用就没法公平比较。我们的做法是:2026-10-03 02:50 到 02:58(UTC)之间把每个接口调一次,按“工具名 + 参数”缓存精简后的返回,之后两个模型看到的都是同一份缓存。标准答案也从这份缓存用 Python 算出来:过滤、取最大值、sum(...) // len(...)、字符串匹配。模型的输出不参与出答案。
| 任务 | 要做什么 | 考什么 |
|---|---|---|
| T1 | 找到名字正好是“瑞幸咖啡”的抖音账号,从主页读粉丝数 | 在一堆相似账号里挑对,再串到主页接口 |
| T2 | 人民日报第一页里,点赞最多的非置顶视频 | 过滤 + 取最大 |
| T3 | 微博热搜前 30 里有几条含“王楚钦” | 计数 |
| T4 | 比较“瑞幸咖啡”和“CottiCoffee 库迪咖啡”谁粉丝多、差多少 | 两次搜索、两次主页、减法 |
| T5 | 第一页全部 20 条视频的平均点赞,向下取整 | 20 个数的算术 |
| T6 | 小红书搜“防晒霜”,点赞最多的笔记 | 列表取最大 |
| T7 | 第一页有几条视频发布于 2026-10-01 当天或之后 | 日期过滤 |
| T8 | 取热搜第一,拿这个词搜微博,报第一页帖子数 | 链式调用 |
| T9 | 查一个不存在的账号,要求答 found=false | 查不到就说查不到,不能编 |
| T10 | 关键词“露营”:小红书点赞最多的笔记点赞数 + 抖音粉丝最多的账号粉丝数 | 两个工具、两个最大值 |
每个回答最后必须有一行 FINAL:,后面是只含指定字段的 JSON。评分很严:每个字段都要和代码算的值一致。数字里的逗号、"true" 和 true 这类写法会统一处理,但差 1 就算错。
两个模型用的是同一段系统提示词,原文如下:
You are a research agent with tools for public Douyin, Weibo and Xiaohongshu data. Use the tools to answer; never guess numbers. If something can't be found, say so. Finish with ONE line that starts with FINAL: followed by a compact JSON object with exactly the keys requested.判分程序把 FINAL: 后面的 JSON 对象解析出来,再逐个字段比对:整数去掉逗号后比,布尔值统一小写后比,ID 和名称按字符串精确比对。缺字段(包括外面多套了一层导致字段找不到)或者 JSON 解析不了,都算错;多出来的字段不扣分。缓存的原始返回我们不公开,因为里面是第三方平台上真实账号的内容。有了上面的任务表、这段提示词和判分规则,就能用你自己的新快照重建这套测试;其实也建议这么做,因为你的数据和我们的不会一样。
T2 要说明一下:这次抓到的 20 条视频里没有置顶视频,“非置顶”这个过滤条件实际上没考到,T2 只考了取最大值。
结果:准确率、成本、延迟
| 指标(每个模型 30 次) | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| 答对次数 | 27 / 30 | 30 / 30 |
| 工具调用 / 参数无效 | 48 / 0 | 48 / 0 |
| 单任务成本中位数 | $0.0123 | $0.0066 |
| 单任务成本均值 | $0.0128 | $0.0063 |
| 30 次合计 | $0.385 | $0.189 |
| 单任务输入 token 中位数 | 4,930 | 2,838 |
| 单任务输出 token 中位数 | 242 | 77 |
| 耗时中位数 | 11.1 秒 | 6.7 秒 |
| 最慢一次 | 27.0 秒 | 19.1 秒 |
两边都正好调用了 48 次工具,参数全部合法,而且每个任务的调用顺序一模一样:T1 两次、T4 四次、T5 一次……T9 那个不存在的账号,6 次运行全都老实回答“没有”。
| 任务 | Sonnet 答对 | GPT 答对 | Sonnet 耗时中位数 | GPT 耗时中位数 | Sonnet 成本中位数 | GPT 成本中位数 |
|---|---|---|---|---|---|---|
| T1 | 3/3 | 3/3 | 17.2 秒 | 9.4 秒 | $0.0157 | $0.0069 |
| T2 | 3/3 | 3/3 | 10.9 秒 | 6.5 秒 | $0.0123 | $0.0066 |
| T3 | 3/3 | 3/3 | 10.3 秒 | 5.3 秒 | $0.0086 | $0.0035 |
| T4 | 3/3 | 3/3 | 17.3 秒 | 11.7 秒 | $0.0239 | $0.0117 |
| T5 | 1/3 | 3/3 | 11.7 秒 | 9.6 秒 | $0.0129 | $0.0081 |
| T6 | 3/3 | 3/3 | 9.2 秒 | 5.5 秒 | $0.0083 | $0.0037 |
| T7 | 2/3 | 3/3 | 11.2 秒 | 6.7 秒 | $0.0125 | $0.0065 |
| T8 | 3/3 | 3/3 | 14.5 秒 | 8.5 秒 | $0.0144 | $0.0070 |
| T9 | 3/3 | 3/3 | 9.8 秒 | 5.6 秒 | $0.0082 | $0.0034 |
| T10 | 3/3 | 3/3 | 9.4 秒 | 6.1 秒 | $0.0109 | $0.0054 |
10 个任务里,GPT-6.1 Sol 每一个都更便宜、更快。耗时包含 SandBase 网关;工具那一步读的是本地缓存,只要几毫秒,所以这里比的基本是模型加路由的时间,不含数据接口本身。
Sonnet 5.5 错在哪
三次失误全出在“对 20 条记录记账”的两个任务上。
T5 平均值。 缓存里 20 个点赞数加起来是 8,455,283,平均值向下取整为 422,764。Sonnet 5.5 第一次答对;第二次答 416,992,相当于总和少算了约 11.5 万;第三次答 434,643,相当于多算了约 23.8 万。这 20 个数从 4,676 到 2,780,636,量级差得很大,心算时漏一条、重一条都不容易察觉。GPT-6.1 Sol 三次都是 422,764。
T7 日期计数。 20 条里有 19 条发布于 10 月 1 日或 2 日,列表最后一条是 9 月 30 日。Sonnet 5.5 两次答 19,一次答 18。
说白了,这类错误有个对所有模型都管用的解法:能用代码算的,就别让 LLM 去加 20 个数。需要平均值或计数,就让工具直接返回(比如带 count、sum、mean 的 like_stats 字段),或者给 Agent 一个计算器工具。我们没有带着这个改动重跑,所以拿不出改进后的数字,但它恰好绕开了出错的那一步。
正式跑之前还有一轮试跑,情况类似:Sonnet 5.5 的 T5 错了一次(409,542),还有两次特别慢,分别 225 秒和 259 秒。GPT-6.1 Sol 在 T10 上翻车,因为当时题目写的是“top note”,它报了 7 个赞,而点赞最多的那条有 1,006 个。正式跑之前,我们把 T10 统一改成“点赞最多的笔记”,两个模型用同一版题目。试跑每题只跑一次、题目措辞也是旧版,上面所有表格都不包含试跑数据。
成本和延迟:两倍差距从哪来
费率相同,成本差距就是 token 差距,主要有两块。
第一块是每次请求的固定开销。只放系统提示词、6 个工具定义和一句“Reply with OK.”,Sonnet 5.5 走 /v1/messages 计 1,036 个输入 token,GPT-6.1 Sol 走 /v1/chat/completions 只计 336 个(2026-10-03 复测)。Agent 每一轮都要把完整上下文重发一遍,这笔开销每轮都交。像 T1 这种三轮的任务,光固定开销 Sonnet 就多出约 2,100 个输入 token,占 T1 输入差距(2,992)的七成左右。剩下的来自工具结果和对话历史,由两家各自的 tokenizer 计数,这部分我们没有单独拆开。
第二块是输出。Sonnet 5.5 每个任务输出中位数 242 token,GPT-6.1 Sol 只有 77,而两边给出的答案、调用的工具都一样。按 $10/百万输出 token 算,积少成多。GPT-6.1 Sol 的输出数已经包含推理 token(usage 里单独列出),仍然更少。
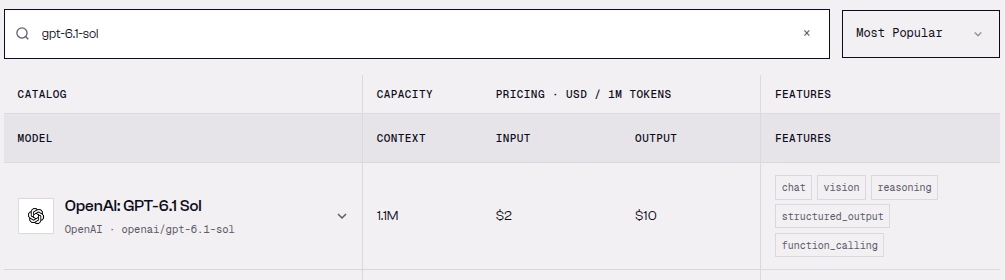
截图:同一目录中 openai/gpt-6.1-sol 也是每百万 token 输入 $2、输出 $10,所以本次的成本差异来自 token 用量,而不是单价(2026-10-03 截取)。
换成具体数字:按这组任务的中位数,每天跑 1,000 个任务,Sonnet 5.5 约 $12.3/天,GPT-6.1 Sol 约 $6.6/天,30 天大约 $370 对 $200。这是用每个模型 30 次短任务外推的,而且没开 prompt caching。两家都对缓存输入打折,而又长又固定的系统提示词加工具列表正是缓存最省钱的地方,做预算前最好开着缓存再测一遍。
整个实验(试跑 + 正式)一共花了 $0.77 的 LLM token(正式 $0.57,试跑 $0.19)。10 月 2 日查看时,用到的数据接口在 SandBase 目录里标为 Free。
怎么选
| 选 GPT-6.1 Sol,如果 | 选 Claude Sonnet 5.5,如果 |
|---|---|
| Agent 做的是短小、结构化的工具调用:查、筛、比、报 | 主要做文档、幻灯片、表格或修 bug,这是 Anthropic 官方强调的方向(本次没测) |
| 跑量大、在意单任务成本,这次大约省一半 | 现有系统已经建在 Anthropic Messages API 上,不想维护两套协议 |
| 延迟直接影响用户,这次耗时中位数低约 40% | 需要 Anthropic 强调的长链路任务或图像理解能力(厂商说法,本次没测) |
| 暂时没法把统计计算挪进代码 | 已经把算术交给工具,本次看到的失误类型就基本被绕开了 |
我们的建议:短小、结构化的工具调用任务,默认先上 GPT-6.1 Sol;Sonnet 5.5 留作文档和代码类任务的候选,那部分这次没覆盖。不管选哪个,统计计算都放进代码里做。改动很小,正好防住这次唯一出现的错误类型。
如果你在设计工具本身,可以看看为什么数据 API 默认应该是 sync-only,讲的是一次阻塞调用如何让 Agent 每一轮更短;从零搭一个抖音竞品监控 Agent 则用同一批抖音接口搭了完整的 Agent。
在 SandBase 上跑一个单工具示例
一个 SandBase API Key 就能同时调两个模型和数据工具。同一批接口,SandBase 有不止一种调用入口:目录页列的是 GET /apis/v1/<vendor>/...,本文用的是各接口 API 参考里的 Model API 路由,两者别混用。工具执行器调用数据接口 POST https://api.sandbase.ai/v1/api/<model>,只读文档里的 outputs[0].data。下面用到的 aweme_list、statistics.digg_count、is_top、create_time 等字段,来自我们 2026-10-03 的实际返回,属于观测到的字段,不是文档保证,所以都用 .get() 防御式读取。下面的代码只是测试里的一个工具(T2、T5、T7 背后的 douyin_user_videos),不是完整的六工具测试。
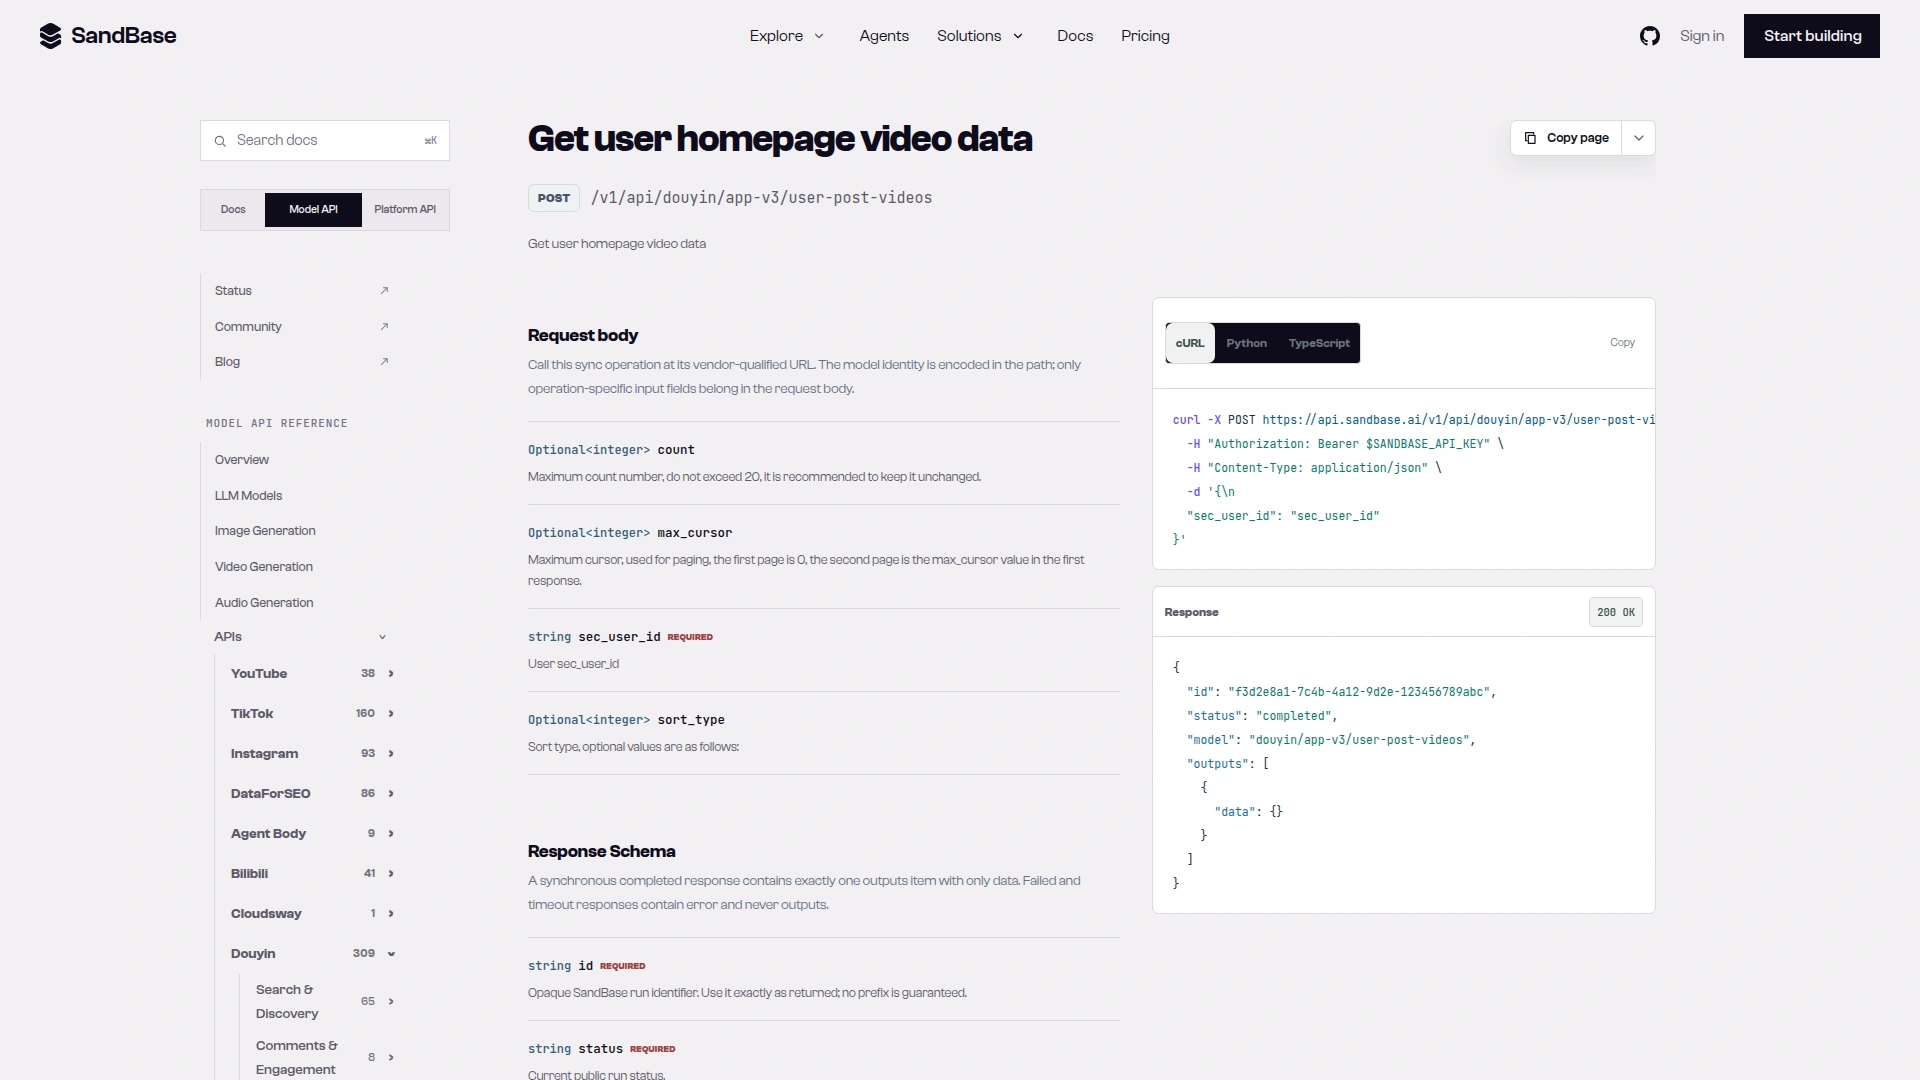
截图:user-post-videos 接口文档写明 POST /v1/api/douyin/app-v3/user-post-videos、count 不超过 20、首页 max_cursor 为 0,正是 T2、T5、T7 背后那个工具发出的请求(2026-10-03 截取)。
import os
import json
import datetime
import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}


def call_data_api(model: str, params: dict) -> dict:
    """调用 SandBase 数据接口,只返回 outputs[0].data;没完成就直接报错。"""
    resp = requests.post(f"{BASE}/api/{model}", headers=HEADERS, json=params, timeout=120)
    resp.raise_for_status()
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def douyin_user_videos(sec_user_id: str) -> dict:
    data = call_data_api("douyin/app-v3/user-post-videos",
                         {"sec_user_id": sec_user_id, "max_cursor": 0, "count": 20})
    videos = []
    for item in data.get("aweme_list") or []:  # 观测到的字段名,防御式读取
        stats = item.get("statistics") or {}
        created = datetime.datetime.fromtimestamp(item.get("create_time") or 0, datetime.timezone.utc)
        videos.append({"aweme_id": item.get("aweme_id"), "create_time": created.strftime("%Y-%m-%d"),
                       "pinned": bool(item.get("is_top")), "likes": stats.get("digg_count")})
    likes = [v["likes"] or 0 for v in videos]
    # 统计在代码里算好,模型不用自己加
    like_stats = {"count": len(likes), "sum": sum(likes), "mean_floor": sum(likes) // len(likes) if likes else None}
    return {"videos": videos, "like_stats": like_stats}


SCHEMA = {"type": "object", "properties": {"sec_user_id": {"type": "string"}}, "required": ["sec_user_id"]}
DESC = "Get the first page (up to 20) of a Douyin account's videos by sec_user_id, plus like_stats."
SYSTEM = "Use the tools to answer; never guess numbers. Finish with one line: FINAL: {json}."


def run_sonnet(task: str) -> str:
    tools = [{"name": "douyin_user_videos", "description": DESC, "input_schema": SCHEMA}]
    messages = [{"role": "user", "content": task}]
    for _ in range(10):
        resp = requests.post(f"{BASE}/messages", headers={**HEADERS, "anthropic-version": "2023-06-01"},
                             json={"model": "anthropic/claude-sonnet-5.5", "max_tokens": 1500,
                                   "system": SYSTEM, "tools": tools, "messages": messages}, timeout=240)
        resp.raise_for_status()
        content = resp.json().get("content") or []
        messages.append({"role": "assistant", "content": content})
        uses = [c for c in content if c.get("type") == "tool_use"]
        if not uses:
            return "".join(c.get("text", "") for c in content if c.get("type") == "text")
        messages.append({"role": "user", "content": [
            {"type": "tool_result", "tool_use_id": u["id"],
             "content": json.dumps(douyin_user_videos(**u["input"]), ensure_ascii=False)} for u in uses]})
    raise RuntimeError("turn limit reached")


def run_gpt(task: str) -> str:
    tools = [{"type": "function", "function": {"name": "douyin_user_videos", "description": DESC, "parameters": SCHEMA}}]
    messages = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": task}]
    for _ in range(10):
        resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS,
                             json={"model": "openai/gpt-6.1-sol", "max_tokens": 1500,
                                   "tools": tools, "messages": messages}, timeout=240)
        resp.raise_for_status()
        msg = resp.json()["choices"][0]["message"]
        messages.append({k: v for k, v in msg.items() if k in ("role", "content", "tool_calls")})
        calls = msg.get("tool_calls") or []
        if not calls:
            return msg.get("content") or ""
        for call in calls:
            args = json.loads(call["function"].get("arguments") or "{}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": json.dumps(douyin_user_videos(**args), ensure_ascii=False)})
    raise RuntimeError("turn limit reached")
实测于 2026-10-03(UTC)。 14:07(UTC)我们原样加载上面的代码,用 T5 类型的问题 “For the Douyin account with sec_user_id MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4, what is the average like count on the first page, rounded down? Keys: videos, average_likes.” 分别调用 run_sonnet 和 run_gpt 各一次。输入:T2、T5、T7 用到的公开账号 人民日报 抖音号。每次工具调用都发送 POST https://api.sandbase.ai/v1/api/douyin/app-v3/user-post-videos,参数 {"sec_user_id": "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4", "max_cursor": 0, "count": 20}。Sonnet 那次调用的返回节选:
{"id": "2372254c-8d24-4f1c-a7f3-4c777d5df7a3", "status": "completed",
 "model": "douyin/app-v3/user-post-videos",
 "outputs": [{"data": {"aweme_list": [
   {"aweme_id": "7692418769125199138", "statistics": {"digg_count": 10344}},
   {"aweme_id": "7692417622113111323", "statistics": {"digg_count": 4090}}],
  "has_more": 1}}]}
只展示 aweme_list 20 条中的前 2 条;每条只保留 aweme_id 和 statistics.digg_count,其余键(包括 create_time、is_top)都已省略。外层结构有文档说明;data 里的字段是观察到的,不是文档字段。
Sonnet 5.5 回答 FINAL: {"videos": 20, "average_likes": 404603},GPT-6.1 Sol 回答 FINAL: {"videos":20,"average_likes":404670}。两者都等于各自那次工具调用的 like_stats.mean_floor;数字不同,是因为两次实时调用相隔几秒,点赞数还在涨。GET /v1/tasks/<id>/cost 显示 Sonnet 两轮合计 $0.006404,GPT-6.1 Sol 两轮合计 $0.003716,每次数据调用 $0.000000。POST /v1/messages 返回体里的 msg_... id 在这个接口查不到(404),但响应头 x-task-id 可以查到。查成本和 GET /v1/models/<id> 都需要同一个 Authorization: Bearer Key;不带 Key 也能在公开模型页上看到价格。
请求字段见 抖音 user-post-videos API 文档。获取 SandBase API Key,用你自己的任务把两个循环都跑一遍。
后续的 12 个模型工具调用实测 用同样的十个任务重跑了一遍,写明了测试方法、任务表、判分规则和每个模型的汇总数据;原始缓存返回和完整测试脚本那篇同样没有公开。
数据范围:这些都是公开、只读的查询,需要 SandBase API Key。SandBase 不是抖音、微博、小红书的官方合作方,也不涉及私密账号、私信、账号后台数据或任何账号操作。
两点协议上的提醒。第一,工具的 JSON Schema 两边通用,只是外层包装不同:Messages 用 input_schema,Chat Completions 用 function.parameters。第二,如果你绕过 SandBase 直连 OpenAI,OpenAI 模型页写的是 GPT-6.1 Sol 的工具调用要走 Responses API,Chat Completions 只支持不带工具的调用。我们 2026-10-03 通过 SandBase /v1/chat/completions 跑的 30 次里工具调用都正常,但上线前请再核对当时的文档。想看更完整的 Agent 循环,可以参考用 OpenAI SDK 搭社媒监控 Agent。
常见问题
做 Agent,GPT-6.1 Sol 比 Claude Sonnet 5.5 强吗?
在我们这 10 个短小的工具调用任务上,是的:30 次全对对 27 次,单任务成本约一半。但这只是一组任务、每题 3 次,适合当作“查询 + 汇报”类 Agent 的参考,不能代表所有 Agent 场景。
两个模型价格一样吗?
标价一样:厂商官网和 SandBase 上都是每百万输入 token $2、输出 $10。单任务成本不一样:Sonnet 5.5 每个任务中位数用 4,930 输入、242 输出 token,GPT-6.1 Sol 是 2,838 和 77。单任务成本中位数是先按每次运行自己的 usage × 标价算出成本,再取这 30 个值的中位数,结果是 $0.0123 对 $0.0066(成本的中位数不等于用 token 中位数算出来的成本)。
Sonnet 5.5 为什么输入 token 更多?
主要是固定开销。同一套系统提示词和 6 个工具定义,走 /v1/messages 计 1,036 token,走 /v1/chat/completions 计 336 token,而 Agent 每一轮都要重发一次。开 prompt caching 能让两边都降下来,这次测试没开。
哪个模型选工具更准?
这次分不出高下。两边都调用了 48 次工具、参数零错误,每个任务选的工具和顺序也完全相同。差别出现在工具返回之后,需要模型自己加总或计数的时候。
两个模型能随时切换吗?
工具逻辑和 JSON Schema 可以直接复用;请求和返回的外层格式在 Messages 和 Chat Completions 之间不一样,上面的代码就是例子。把协议层写薄一点,按模型替换即可。
测试边界
样本很小:10 个任务、每个 3 次,一套基于中文社媒平台的工具,一份 2026-10-03(UTC)的数据快照,temperature 和推理强度都是默认值,没开 prompt caching,也没开 extended thinking。延迟是从一台机器经 SandBase 网关测的,换地区、换负载都会不同。30 次里错 3 次,样本太少,没法精确估计 Sonnet 5.5 的错误率。两个模型都才发布几天,任何一方更新都可能改变结果。真正上线前,挑和你业务最像的几个任务再跑一遍。