TikTok 刷量识别实测:68 条视频跑一遍假播放检测接口
TikTok 刷量识别实测:用 SandBase 的 detect-fake-views 接口检测 68 条公开视频,拆开 fake_score 看它到底对什么敏感、重复调用稳不稳、content_category 有什么用,以及为什么“干净”视频也有 5% 假播放估算。
先说一个让人皱眉的结果:TikTok 官方账号自己的一条视频,1.62 亿播放,丢进假播放检测接口,返回 fake_score 4.34(满分 100),“不可疑”,置信度 Minimal。同一份报告里又写着:估算假播放 8,102,335 次,并且这个账号“可疑地”在 31 天内从 1 万粉涨到了 10 万粉。
一份 JSON,两种说法。拿这类报告去和达人谈价格之前,最好先弄清楚它到底在对什么起反应。2026-10-04(UTC),我们用 SandBase 上的 tiktok/analytics/detect-fake-views 检测了 68 条公开 TikTok 视频,其中 10 条又重复调用了最多 3 次,13 条在 5 个 content_category 下各跑一遍,实测共拿到 163 份完成的报告,另有几次示例运行。
先说结论
- 68 条视频没有一条被判为可疑(
is_suspicious全部为 false)。fake_score 从 5.92 到 47.53,中位数 19.66;66 条置信度是 Minimal。fake_view_percentage是 fake_score 的阶梯函数:低于 10 分记 5%,往上按 10 分一档记 10/20/30/40%。estimated_fake_views就是播放量乘这个档位,“收入影响”再按每千次播放 1 美元折算。所以再干净的视频,也至少挂着 5% 的“假播放”。- 我们测到的最强单一变量是视频发布时长(与 fake_score 的 Spearman 相关 0.69)。发布超过 2 天的视频中位分 29.53,不到 2 天的只有 10.66,主要由播放分布检查带动;而且它一小时内就可能翻转:重复测试的 10 条里有 5 条在 01:50 到 02:15 UTC 之间涨了 10.5~12.4 分。
- 对我们测的认证品牌号,
content_category完全不起作用(始终按verified_large基准);对未认证达人的视频,换类别能让分数差 2.3 到 9.7 分。- 我们没有“已知刷量”的标注数据,所以本文测的是接口行为,不是准确率。把结果当初筛信号和待核查清单,别当刷量证据。
测什么,不测什么
问题很窄:这个检测器对什么敏感,同一条视频问两次答案是否一致。要回答“TikTok 刷量能不能被识别”这种大问题,得有真值,也就是确切知道哪些视频买了多少播放。我们没有,任何只给一个分数却不给真值的工具也没有。
还要说清楚身份:这是第三方启发式算法,上游供应商是 TikHub,参考页写的是基于“TikTok 流量池理论”。它不是 TikTok 官方数据,分数高也不能证明谁刷了量。
样本(2026-10-04 01:18 UTC 拉取,共 68 条):
| 分组 | 取样方式 | 数量 | 文中是否点名 |
|---|---|---|---|
| 品牌 / 媒体号 | 用 tiktok/app-v3/user-post-videos 取 12 个官方账号各自最新 3 条普通视频:TikTok、Nike、NBA、Netflix、ESPN、Red Bull、Sephora、Duolingo、NFL、Chipotle、华盛顿邮报、Ryanair | 36 | 是,只写品牌名 |
| 搜索结果 | 用 tiktok/app-v3/video-search-result 搜 4 个美区通用关键词(美食、美妆、健身、学习),近 30 天,取前 8 条未认证创作者视频 | 32 | 否,只给汇总,代号“视频 A”等 |
搜索组里都是普通创作者,随手贴个“可疑”标签就可能伤到人,所以不公开任何 ID、账号名或文案。36 条品牌视频来自 210 万到 9,600 万粉丝的账号(检测器的 xlarge、xxlarge 档);搜索组从 micro 到 xlarge 都有。
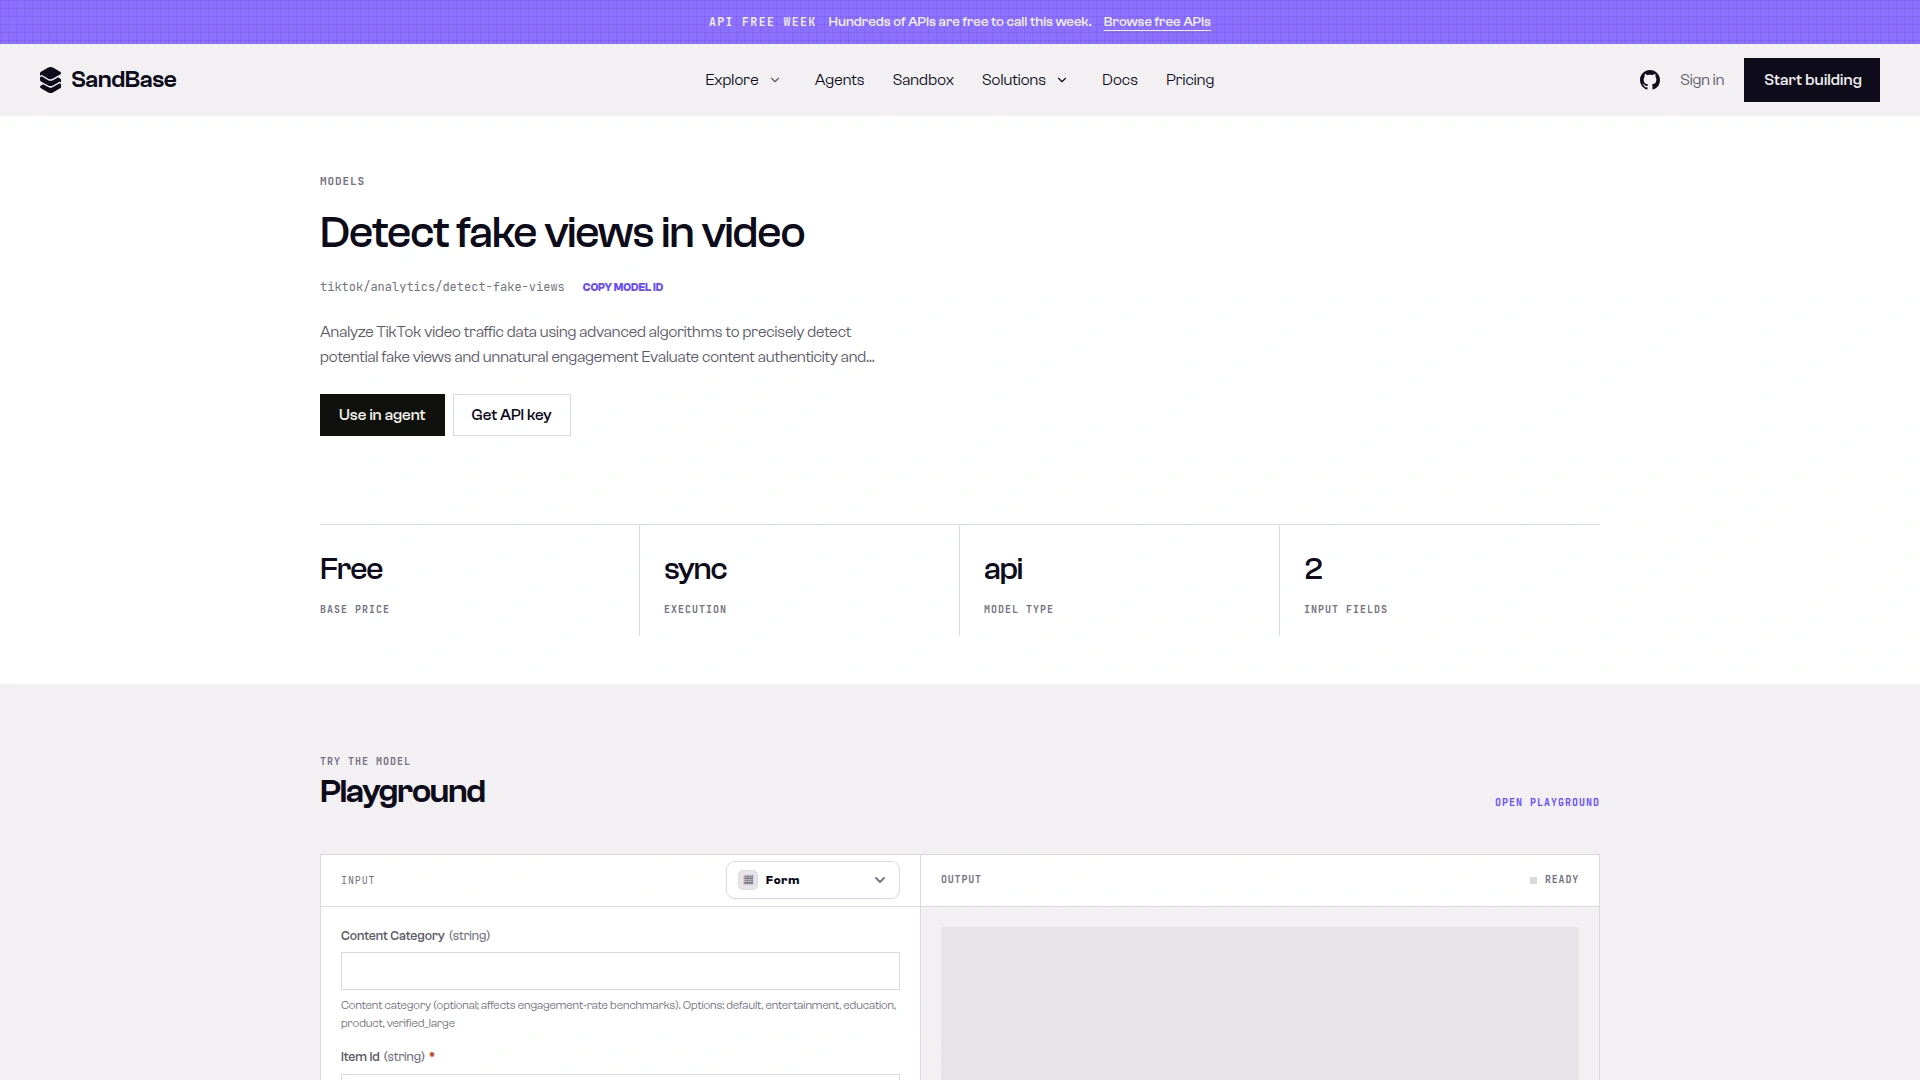
截图:tiktok/analytics/detect-fake-views 的模型页显示基础价格 Free、同步执行、两个输入参数,页面顶部挂着“API Free Week”横幅(2026-10-04 截取)。
费用:01:16 UTC 调 GET https://api.sandbase.ai/v1/models/tiktok/analytics/detect-fake-views,返回 base_price "0",两个取样接口也是 0;GET /v1/tasks/621146a2-cf67-4dcf-a9e8-a15a63830cea/cost 显示一次检测计费 $0.000000。这两个查询要带和调用时同一个 Authorization: Bearer key,没有 key 可以直接看公开模型页。因为当时挂着免费周横幅,Free 是否长期有效我们说不准。整个实测连截图大约花了 $0.015。
分数从没喊过“可疑”
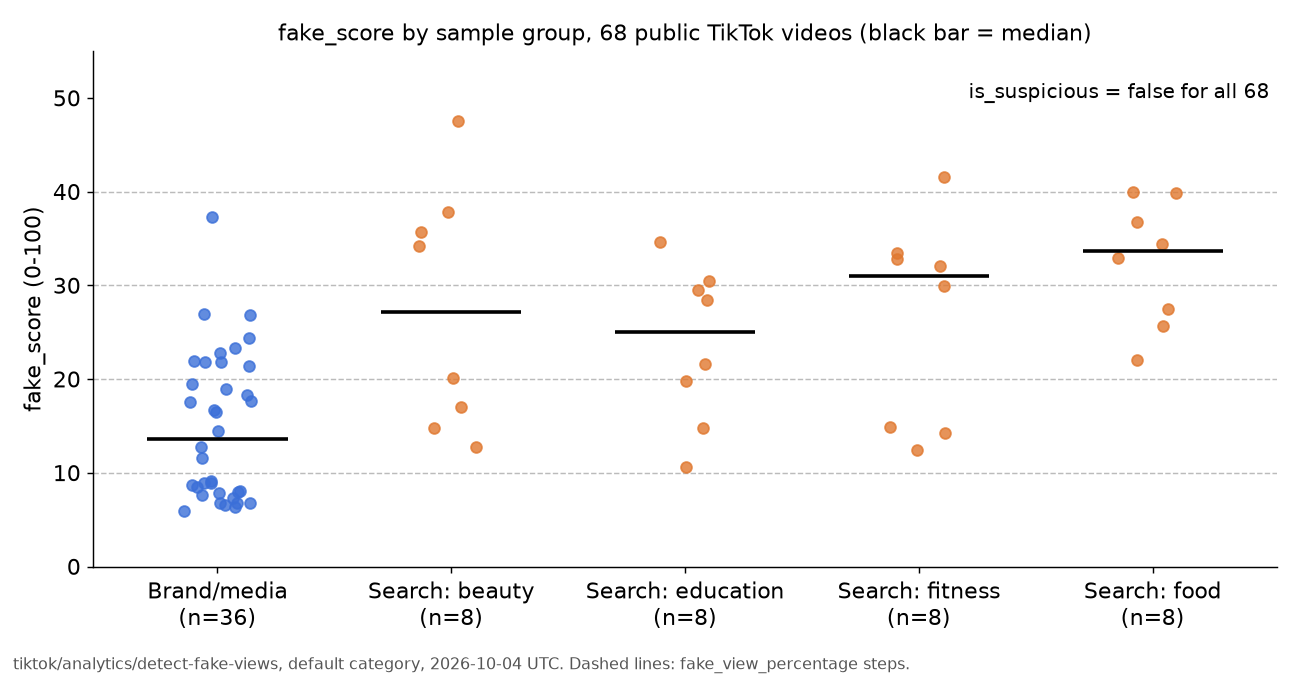
截图:默认类别下 68 条视频的 fake_score,品牌视频中位数 13.6,匿名搜索视频 29.74,没有一条被判可疑(根据 2026-10-04 实测数据绘制)。
| 品牌 / 媒体(36) | 搜索结果(32) | |
|---|---|---|
| fake_score 中位数(四分位) | 13.6(7.93~21.5) | 29.74(19.1~34.48) |
| 范围 | 5.92~37.36 | 10.66~47.53 |
is_suspicious: true | 0 | 0 |
| 置信度 Low(其余为 Minimal) | 0 | 2 |
suspicious_features 里出现 “Critical:” 的视频 | 7 | 19 |
最容易踩的坑是:报警和结论是两回事。68 份报告里有 55 份至少列了一条 “Suspicious:” 或 “Critical:”,其中 26 份有 “Critical:”,但结论全部是 is_suspicious: false。比如 Nike 的一条视频写着 “Critical: Like Ratio is extremely low (0.00473 vs minimum 0.00500)”,fake_score 37.36。这些行是单项检查对固定阈值的报警,结论另有一条分界线,我们的样本一条都没碰到。最高分 47.53,所以分界线在哪里我们也看不到。
涨粉报警最典型。36 条品牌视频里有 18 条带着它:TikTok(“31 天从 1 万涨到 10 万粉”)、Duolingo(“20 天从 50 万涨到 100 万粉”)、NFL(“2 天内粉丝涨 10 倍”)。看起来说的是这些账号多年前刚起步的时候。而且它几乎不影响总分,下一节细说。
真正推动 fake_score 的是什么
每份报告有 8 个 component_scores。拿这 8 个分量对 fake_score 做最简单的线性拟合,68 次默认调用的 R² 是 0.956,权重大致为:engagement 0.26、creator credibility 0.23、distribution 0.22、follower correlation 0.15、consistency 0.10,fan growth 和 content authenticity 接近 0。这是我们反推的结果,不是官方公式。
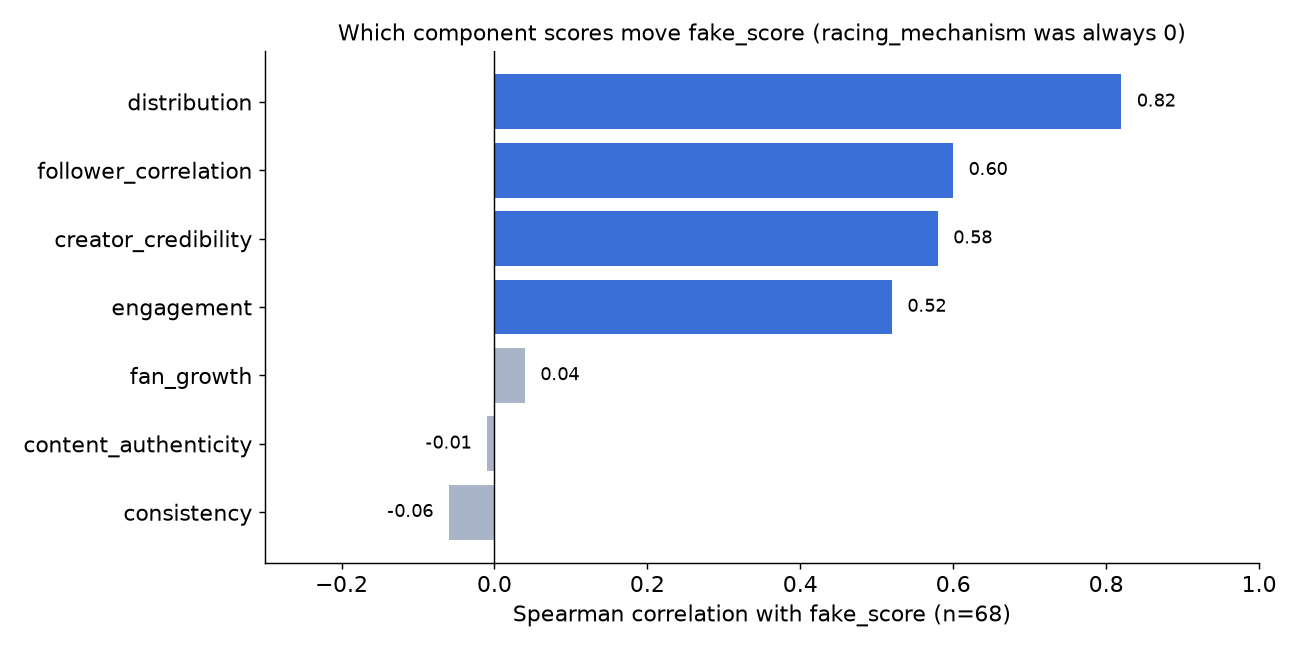
截图:distribution、follower correlation、creator credibility、engagement 四项跟着 fake_score 走;fan growth、content authenticity、consistency 基本不相关,racing mechanism 每次都是 0(根据 2026-10-04 实测数据绘制)。
几个分量在样本里的表现:
- **distribution(播放分布)**只出现过 0、10、60、65、80 五个值。“natural”给 10,“low entropy”“statistical anomaly”“growth anomaly”给 60~80。单这一跳就能让总分多出 11~15 分。
- creator credibility 在 36 条认证品牌视频上全部是 0,未认证创作者多数是 3~55。认证等于直接去掉这一项。
- follower correlation 品牌视频 36 条里 35 条是 20,搜索视频是 30 或 70。
- engagement 拿点赞、评论、分享、收藏率去比基准表,最敏感的是评论率:我们算的“评论 / 播放”和 engagement 分的 Spearman 相关是 −0.82。
- fan growth 固定落在 10、45、55,跟其他项无关。所以 TikTok 官方号可以同时拿到“31 天”报警和 4.34 的总分。
- racing mechanism 68 份报告全部返回 “Insufficient data: No racing mechanism metrics available”。
发布时长比点赞率更要紧
我们用取样接口给的计数算了几个简单比率,再和 fake_score 做相关。互动比率都偏弱:点赞 / 播放 −0.27,评论 / 播放 −0.41,分享 / 播放 0.16。最强的两个变量反而和互动质量无关:播放 / 粉丝 0.55,发布时长 0.69。
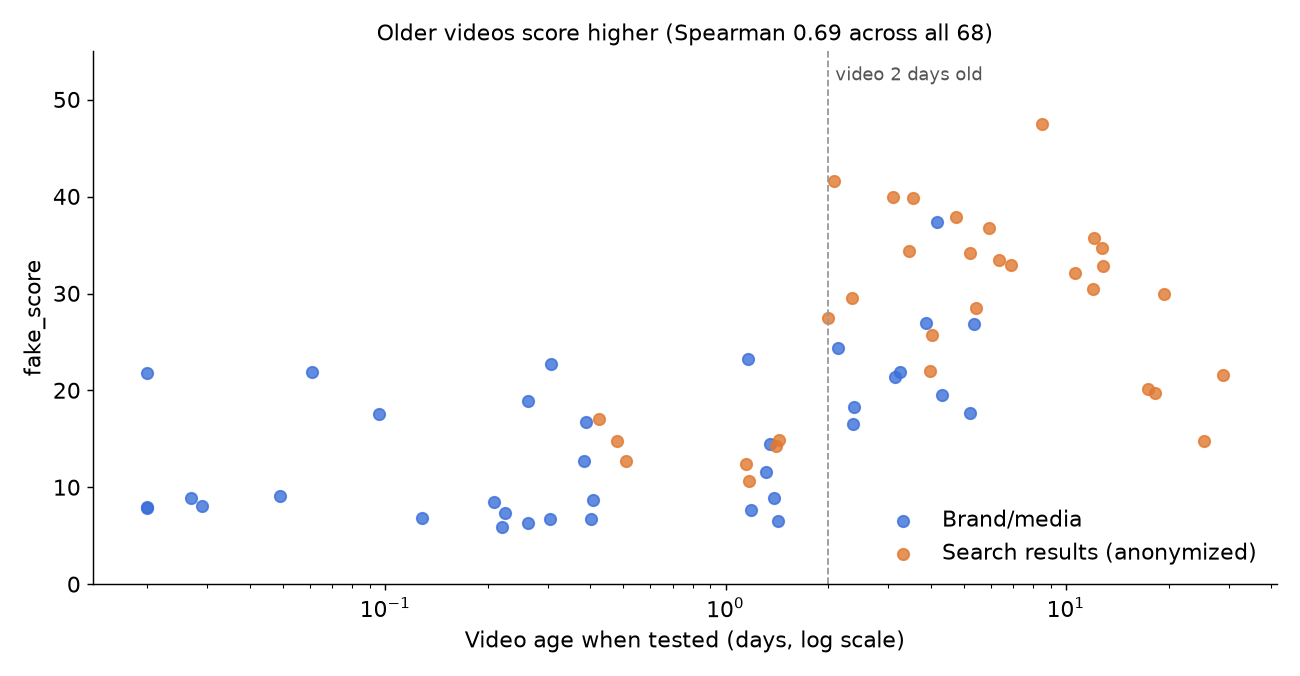
截图:发布不到 2 天的视频大多低于 20 分,超过 2 天的大多在 20~48 分,品牌和搜索样本都一样(根据 2026-10-04 实测数据绘制)。
原因在播放分布检查。它依据一段很短的播放历史,长度(stats.count)在我们的报告里从 2 到 36 个点不等:一天半内涨到 30 个左右,第二天前后掉到 3~5 个(看起来是从按小时记换成按天记),三周时到 15 个。新视频通常判 natural,老一些的通常被贴上异常标签。33 条不到 2 天的视频里,distribution ≥ 60 的占 18%;35 条更老的视频里占 86%。
这也是我们样本自己的混杂因素,品牌和搜索的差距得重新理解:品牌视频取的是各账号最新几条(中位 0.4 天),搜索视频最长 30 天(中位 5.0 天)。按发布时长分开看,差距缩小但没消失:
| 测试时的发布时长 | 品牌中位数(n) | 搜索中位数(n) |
|---|---|---|
| 不到 2 天 | 8.8(26) | 14.26(7) |
| 2 天及以上 | 21.66(10) | 32.86(25) |
剩下的差距和上面认证账号的两项对得上(creator credibility 为 0、基准不同)。发了 10 天的视频和发了 10 小时的视频,在这里不是同一把尺子。比较达人时,请拿发布时长相近的视频比。
老视频也不是一律被标。开头那条 TikTok 视频发布于 2025 年,测试时已 624 天,distribution 返回 “Insufficient view data”,总分 4.34。我们的推测是检测器只对近期在追踪的视频有播放历史,但这只是从输出倒推。
content_category:只对未认证达人有用
接口有个可选参数 content_category(default、entertainment、education、product、verified_large),参考页说它会切换互动率基准。我们挑 13 条视频,5 个值各跑一遍。
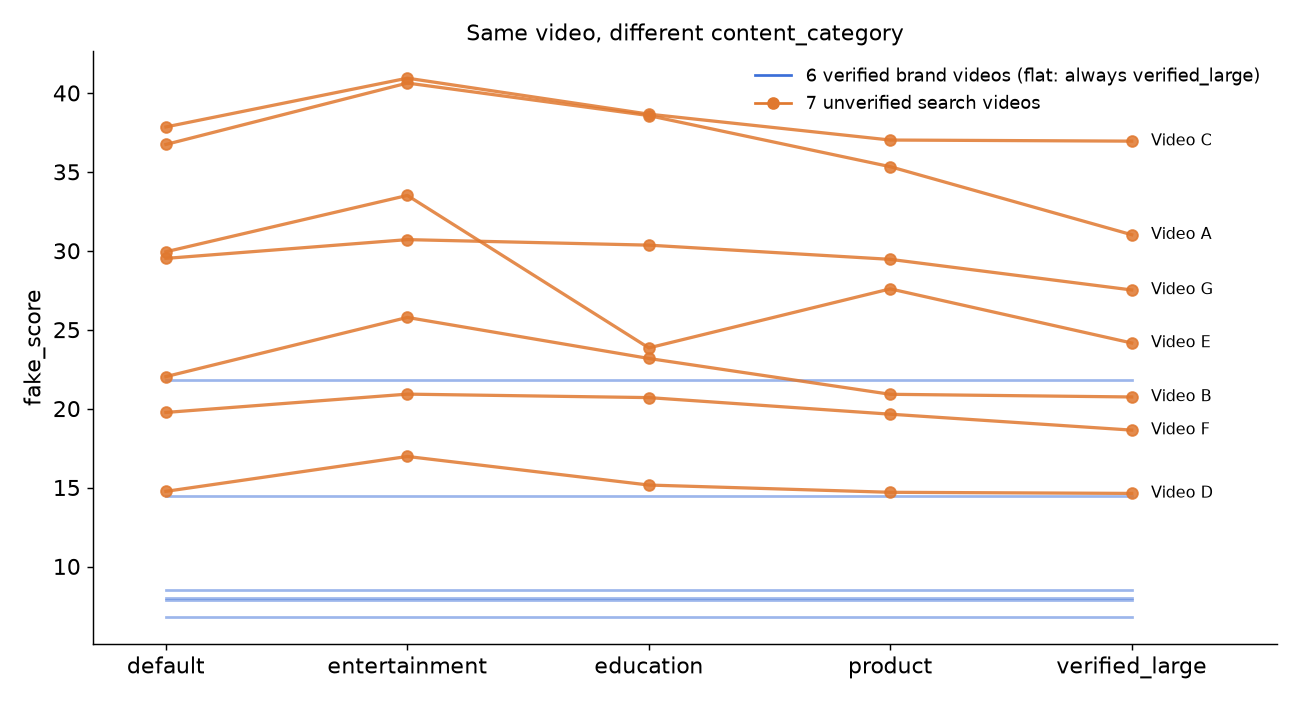
截图:认证品牌视频在任何 content_category 下分数都不变;未认证视频在 entertainment 下最高、verified_large 下最低(根据 2026-10-04 实测数据绘制)。
6 条认证品牌视频(TikTok、NBA、ESPN、Sephora、NFL、华盛顿邮报)不管传什么,返回的 benchmark_category 都是 verified_large,5 个值下分数完全一样。7 条未认证视频的基准跟着参数变,分数差 2.28~9.66 分。entertainment 每次都最高,verified_large 在 7 条里有 6 条最低。7 条里有 5 条在 default 和 entertainment 之间跨过了 10 分一档,比如视频 A 从 36.75(估算 30% 假播放)变成 40.64(40%)。
所以先定类别再看分数,而且所有要比较的达人用同一个类别。不传时,未认证视频按 default 算。
稳不稳
主测之后,我们挑 10 条视频(5 条品牌、5 条匿名搜索)在约 01:20、01:50、02:15 UTC 又各测了一次。看到两件事。
第一是可用性。01:20 的第一批重复调用是成功的,随后 01:20:45 到 01:23:43 UTC 日志里有 10 次调用返回 HTTP 503,错误是 “upstream error 400: Request failed. Please retry”,并注明失败请求不计费。之后几分钟几次没记日志的手动探测也一样失败;01:32 的一次调用成功,此后全部正常。遇到这种情况隔一会儿再试,别紧密循环重试。
第二,播放历史不变时分数很稳,一变就跳。
| 视频(01:18 时的发布时长) | 01:18 | 01:20 | 01:50 | 02:15 | 02:15 时的播放分布 |
|---|---|---|---|---|---|
| @nba(1 小时) | 9.14 | 9.15 | 9.12 | 21.39 | natural → statistical_anomaly |
| @espn(不到 1 小时) | 8.92 | 8.95 | 9.83 | 22.27 | natural → statistical_anomaly |
| @tiktok 最新一条(32 小时) | 14.47 | 14.47 | 14.96 | 25.48 | natural → statistical_anomaly |
| @duolingo(31 小时) | 11.6 | 失败 | 11.61 | 22.76 | natural → statistical_anomaly |
| 视频 O,美妆(10 小时) | 17.08 | 17.08 | 17.08 | 29.48 | natural → statistical_anomaly |
| 原本已被标记的 5 条 | 不变,最大波动 0.07 分 |
原本 natural 的 5 条,在 01:50 到 02:15 之间全部变成 statistical anomaly,分数比 01:50 那次涨了 10.5~12.4 分;TikTok 最新那条的播放历史在这期间从 34 个点变成 35 个点。原本已被标记的 5 条波动不超过 0.07 分,但其中一条美食视频正好卡在 40 分线上:39.95、40.01、40.01、39.94,于是 fake_view_percentage 变成 30、40、40、30。
还有一个解释不了的例子。一条 Red Bull 视频 01:18 是 8.95,01:35 是 20.01,01:50 回到 8.73,02:16 是 8.72,每次的分布模式都是 natural。20.01 来自示例程序的第一次运行(与最终版只差数字格式),那次完整响应我们没保存,所以说不清是哪一项变了。
实际用法:新视频的一份报告只是移动目标的一张快照。记下测试时间,隔几个小时再跑一次,并且只拿发布时长相近的视频比较。
5% 保底和那个美元数字
报告里有三个字段其实是算术,不是独立测量:
| 字段 | 68 份报告里观察到的规律 | 怎么读 |
|---|---|---|
fake_view_percentage | 10 分以下为 5,往上按 10 分一档记 10/20/30/40,除一条 371 播放的视频为 4.85 外,其余与档位相差都不超过 0.03 | 是分档,不是测量值 |
estimated_fake_views | 播放量 × 百分比,误差在 1 次以内 | 继承保底,最低约为播放量的 5% |
mcn_report.business_impact.revenue_impact | 估算假播放 ÷ 1000 × 1 美元,原文写 “average CPM of $1.00” | 固定费率的示意,不是你的合同金额 |
68 条视频加起来 27,859,525 次播放,“估算假播放” 4,201,597 次,占 15%,而可疑判定一条都没有。TikTok 那条 4.34 分的视频照样打印出 810 万假播放和 8,102 美元“收入影响”。分档还让估算很跳:一条搜索视频两次调用之间从 39.95 分变成 40.01 分,估算假播放一下子多了三分之一。
自己跑一遍
下面的程序接收一组视频 ID,打印我们觉得值得看的字段,外加两个从同一份响应算出的比率,以及“发布不到 2 天”的提示。它只读 outputs[0].data,其他情况直接抛错。fake_view_analysis、detailed_analysis、video_metrics、view_pattern_type 这些业务字段名来自我们 2026-10-04 的实际返回,不是文档保证,所以都用 .get() 读。调用走参考页给出的 Model API 路由 POST /v1/api/<model>。
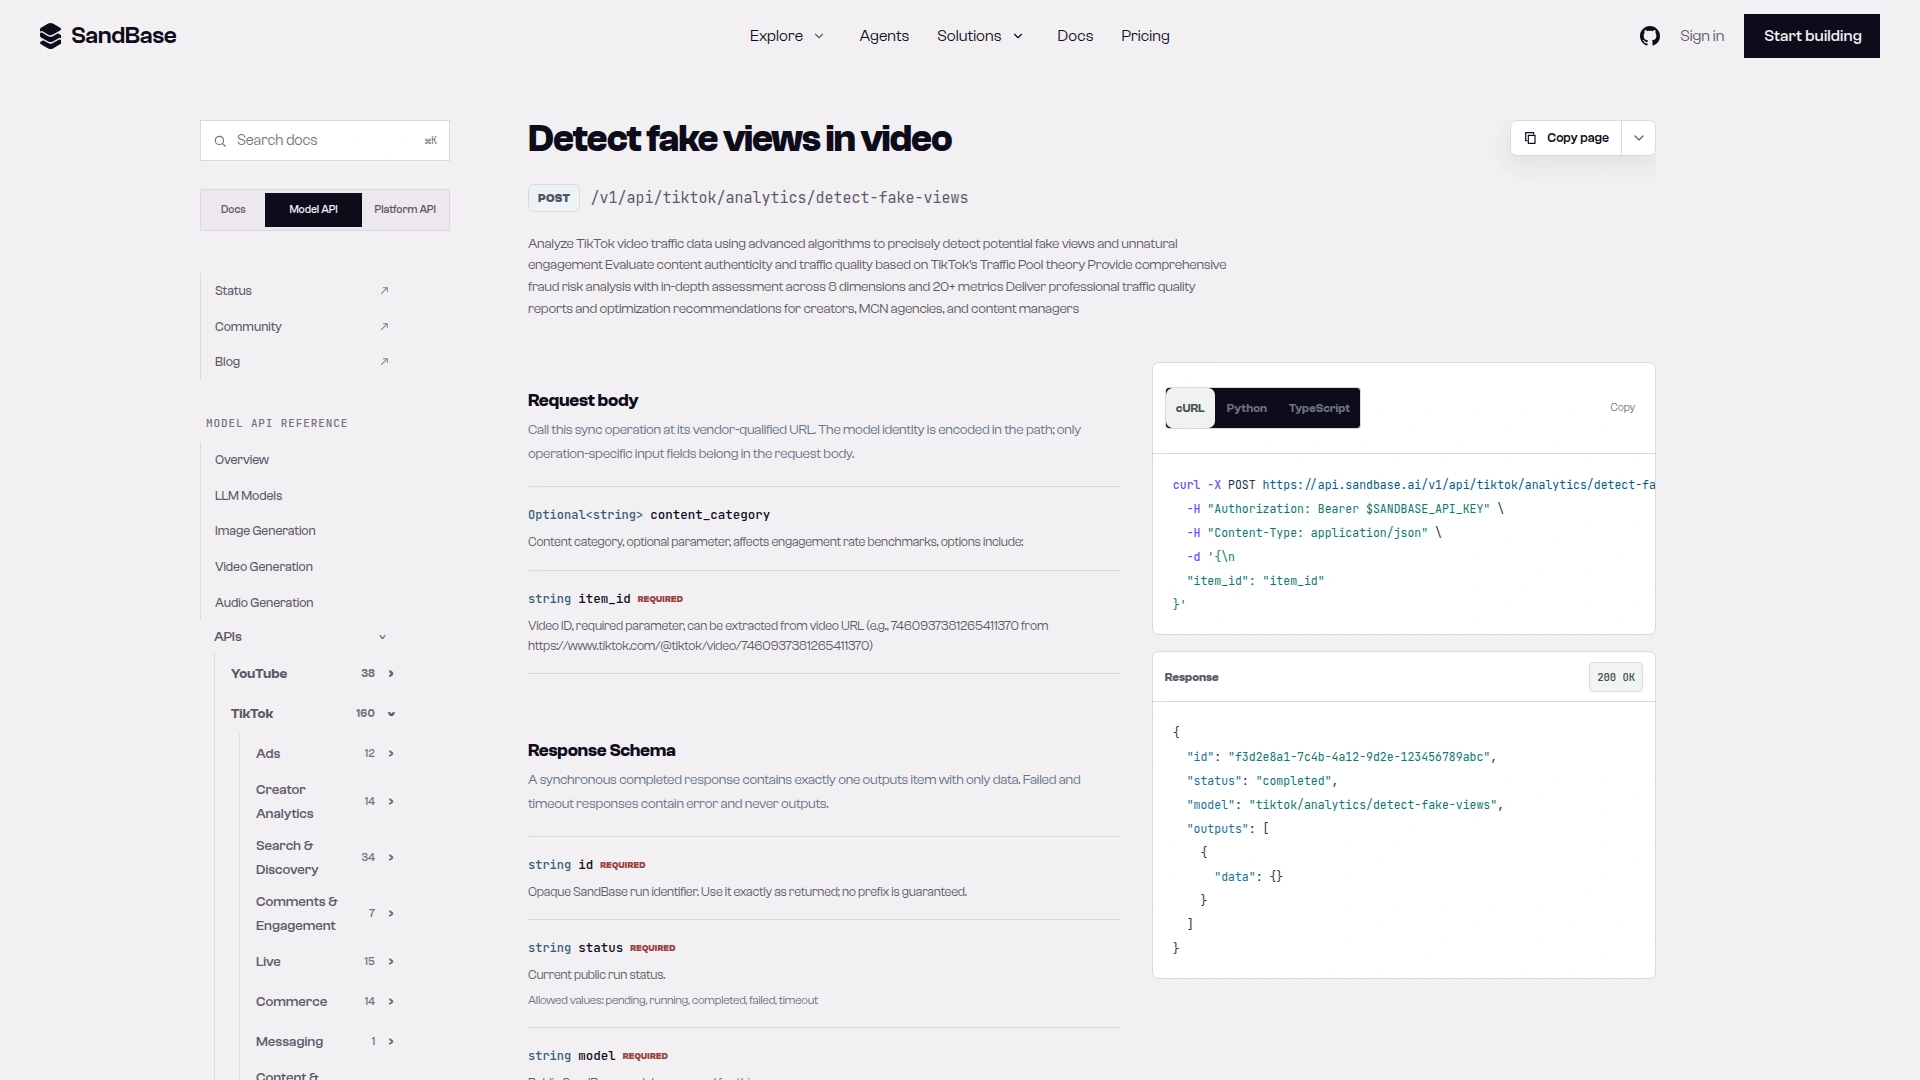
截图:接口参考页写明了 POST 路由、必填 item_id 和可选 content_category;示例响应里 outputs[0].data 是空对象,所以业务字段都属于实测观察(2026-10-04 截取)。
import os
import sys
import time
import requests

BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}


def call(model: str, params: dict) -> dict:
    """POST a SandBase data endpoint and return outputs[0].data, failing loudly otherwise."""
    resp = requests.post(f"{BASE}/{model}", headers=HEADERS, json=params, timeout=120)
    body = resp.json()
    outputs = body.get("outputs") or []
    if resp.status_code != 200 or body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"{model} failed: HTTP {resp.status_code} {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def screen(video_id: str) -> dict:
    """Run the detector once and keep the fields our study found worth reading."""
    d = call("tiktok/analytics/detect-fake-views", {"item_id": video_id})
    fa = d.get("fake_view_analysis") or {}
    da = d.get("detailed_analysis") or {}
    vm = d.get("video_metrics") or {}
    views = vm.get("total_views") or 0
    age_days = (time.time() - (d.get("content_metrics") or {}).get("creation_time", time.time())) / 86400
    thin = [name for name, block in da.items()
            if isinstance(block, dict) and any("nsufficient" in str(i) for i in block.get("issues") or [])]
    return {
        "video": video_id,
        "views": views,
        "age_d": round(age_days, 1),
        "score": fa.get("fake_score"),
        "pct": fa.get("fake_view_percentage"),
        "suspicious": fa.get("is_suspicious"),
        "confidence": fa.get("confidence_level"),
        "benchmark": (da.get("engagement") or {}).get("benchmark_category"),
        "pattern": d.get("view_pattern_type"),
        # our own ratios from the same response, so you can check them against your benchmarks
        "like/view": f"{(vm.get('total_likes') or 0) / views:.4f}" if views else None,
        "comment/view": f"{(vm.get('total_comments') or 0) / views:.5f}" if views else None,
        "thin_data": ",".join(thin) or "-",
    }


if __name__ == "__main__":
    cols = ["video", "views", "age_d", "score", "pct", "suspicious", "confidence",
            "benchmark", "pattern", "like/view", "comment/view", "thin_data"]
    print("\t".join(cols))
    for vid in sys.argv[1:]:
        try:
            row = screen(vid)
        except (RuntimeError, ValueError, requests.RequestException) as err:
            print(f"{vid}\terror: {err}")  # upstream 503s happen; retry later rather than in a tight loop
            continue
        print("\t".join(str(row[c]) for c in cols))
        if row["age_d"] < 2:
            print(f"{vid}\tnote: under 2 days old; distribution checks have little history yet")
**实测于 2026-10-04(UTC)。**输入:TikTok 官方账号的公开视频 7460937381265411370,也就是接口 schema 示例里的那个 ID。01:32 UTC 发出的请求:
curl -X POST https://api.sandbase.ai/v1/api/tiktok/analytics/detect-fake-views \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"item_id": "7460937381265411370"}'
这次调用的截短返回:
{
 "id": "621146a2-cf67-4dcf-a9e8-a15a63830cea",
 "status": "completed",
 "model": "tiktok/analytics/detect-fake-views",
 "outputs": [
  {
   "data": {
    "fake_view_analysis": {
     "component_scores": {
      "consistency_score": 0,
      "content_authenticity_score": 34.0,
      "creator_credibility_score": 0,
      "distribution_score": 0,
      "engagement_score": 0.0,
      "fan_growth_score": 45,
      "follower_correlation_score": 35.0,
      "racing_mechanism_score": 0
     },
     "confidence_level": "Minimal",
     "estimated_fake_views": 8102335,
     "fake_score": 4.34,
     "fake_view_percentage": 5.0,
     "is_suspicious": false,
     "main_detection_reason": "Multiple Anomalous Indicators"
    },
    "video_metrics": {
     "total_views": 162046716,
     "total_likes": 15925353,
     "total_comments": 359944,
     "total_shares": 1318334
    }
   }
  }
 ]
}
outputs[0].data 里只保留了完整的 fake_view_analysis 和 video_metrics 的 4 个键;detailed_analysis、creator_metrics、content_metrics、mcn_report、traffic_pool 等其余块都省略了。信封字段(id、status、model、outputs[0].data)有文档;data 里面的内容全部是实测观察,不是文档保证。约 20 分钟前对同一视频的另一次调用也是 4.34。
随后在 02:16 UTC,把 SANDBASE_API_KEY 设在环境变量里,原样运行上面的程序,输入这条视频、一条 Nike 视频和一条 Red Bull 视频(都是品牌号)。输出如下:
video	views	age_d	score	pct	suspicious	confidence	benchmark	pattern	like/view	comment/view	thin_data
7460937381265411370	162046776	624.4	4.34	5.0	False	Minimal	verified_large	insufficient_data	0.0983	0.00222	consistency,distribution,racing_mechanism
7691063003759922445	179037	4.2	37.47	30.0	False	Minimal	verified_large	low_entropy	0.0046	0.00008	racing_mechanism
7692048484546907414	7497651	1.4	8.72	5.0	False	Minimal	verified_large	natural	0.0667	0.00035	racing_mechanism
7692048484546907414	note: under 2 days old; distribution checks have little history yet
Red Bull 那条就是“稳不稳”一节提到的视频:这里是 8.72,距离 01:35 看到的 20.01 过去了 41 分钟。
想改成自己的版本,请求字段见 detect-fake-views API 参考,取样用的搜索接口见视频搜索参考。申请一个 SandBase API key,就能拿你正在评估的视频跑。
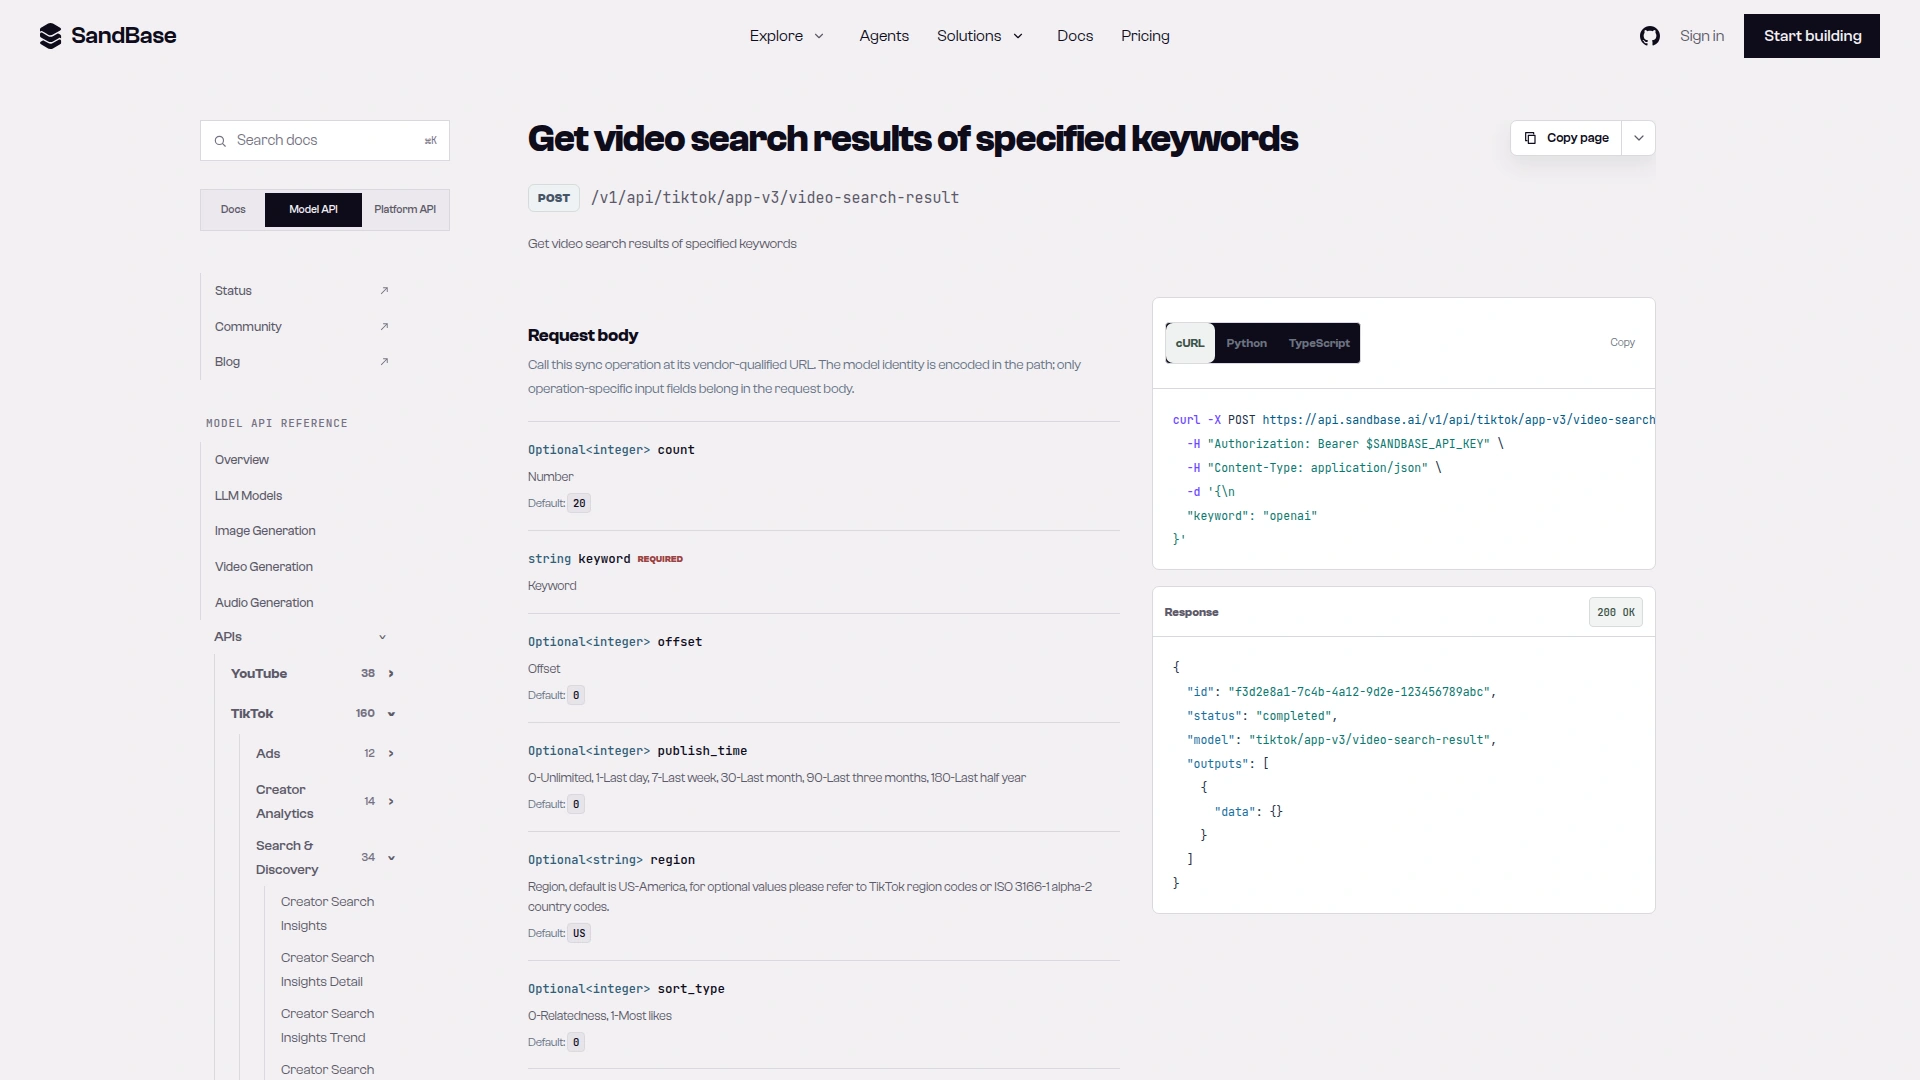
截图:我们用来搭匿名样本的视频搜索接口参考页,含 keyword、publish_time、region 等参数(2026-10-04 截取)。
数据边界:以上都是公开、只读的查询,需要 SandBase API key。SandBase 不是 TikTok 官方合作方,不涉及私密账号、私信、创作者后台数据或任何账号操作。达人的 TikTok Studio 数据、TikTok Creator Marketplace 报告才是一方数据,这个检测器不是。
报告怎么用
| 看到什么 | 大概意味着 | 怎么做 |
|---|---|---|
is_suspicious: false,分数低于 10 | 没有检查项强烈触发 | 初筛通过;别把 5% 估算当事实引用 |
| 发布超过 2 天、分数 20~40 | 多半是播放分布检查,老视频大多会被标 | 和其他达人发布时长相近的视频比 |
| “Critical: Comment Ratio is extremely low” | 低于该类别基准表 | 自己翻评论区;评论少的原因很多 |
| 大号上的涨粉报警 | 多半是早年历史 | 单独出现可以忽略,它几乎不动总分 |
| 准备拿去谈判的任何数字 | 只是启发式估算 | 请达人提供后台数据截图 |
想先拉达人近期作品和主页数据,可以看 TikTok 达人调研 API 教程,其他接口见 TikTok 数据 API 总览。用平台一方数据做同类审核,可以参考抖音星图达人评估。
延伸阅读
只想查一个视频,按 TikTok 视频刷量检测教程 一步步来就行。想对一个达人最近的作品批量跑检测、出一份审核备忘,可以看 TikTok 达人刷量审核 Agent。
常见问题
工具能识别 TikTok 刷量吗?
能根据公开数字估算风险信号:互动率对比基准、播放增长形态、账号历史。但它看不到谁在看。我们这次一条可疑都没测出来,也没有真值去核对。
假播放有哪些迹象?
检测器会拿点赞、评论、分享、收藏率对比基准表,再看播放增长曲线。我们的数据里,分数跟得最紧的互动指标是很低的评论 / 播放。但每个信号都有正常解释,比如视频主要靠私信转发传播。
TikTok 正常互动率是多少?
这个接口自带的 tier_benchmarks 里,like_follower_ratio 最大档平均 0.002,micro 档平均 0.03。我们品牌样本的点赞 / 播放中位数是 0.064,搜索样本是 0.071。这只是一家供应商的表加一个小样本,不是平台标准。
为什么干净的视频也有估算假播放?
因为 68 份报告里 fake_view_percentage 最低也在 5 左右(最低 4.85,出现在一条 371 播放的视频上),而 estimated_fake_views 就是播放量乘这个比例。TikTok 那条 1.62 亿播放的视频,4.34 分照样算出 810 万。
content_category 会改变结果吗?
对我们测的认证账号不会,基准始终是 verified_large。对未认证达人,最多差 9.7 分,entertainment 下最高。
局限
68 条视频、一天、美区搜索结果、一个检测器。没有刷量标注数据,不谈准确率。品牌组和搜索组同时在发布时长、认证、体量上不同,我们只粗略控制了发布时长。重复测试只覆盖 10 条视频、约一小时。上面的权重来自我们的线性拟合,不是供应商公布的。我们没见过一次可疑判定,所以不知道阈值在哪、行为如何。原始响应留在内部,因为搜索组含第三方创作者数据;方法、汇总和品牌视频示例都已写在文中。