Instagram ID 查用户名:一次 API 调用把数字 ID 转成用户名(2026 实测)
Instagram ID 查用户名怎么做?把数字用户 ID 发给 SandBase 的 v3 接口,一次调用拿到当前用户名;再用 98 行 Python 脚本批量转换整张 CSV。附 18 个品牌账号实测、错误 ID 的返回和停用接口清单。
手里有一个 Instagram 数字 ID,想知道它是哪个账号?Instagram ID 查用户名只要一次调用:把 ID 发给 SandBase 的 instagram/v3/user-id-to-username,从返回里读 username。我发 787132,2.7 秒后拿到 natgeo:
curl -s https://api.sandbase.ai/v1/api/instagram/v3/user-id-to-username \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"user_id": "787132"}'
单个账号,到这里就够了。下面写给两类人:一类手上有一整批 ID,另一类的 ID 发过去报错了。内容包括:六个能收 user_id 的接口该用哪个、哪些已经停用、错误 ID 会返回什么,以及一个把 CSV 里的 ID 批量转成用户名的 98 行脚本。所有调用都在 2026-10-04(UTC)实测,对象是 18 个公开的品牌和媒体账号。
先说结论
- 用
instagram/v3/user-id-to-username。三轮批量测试里 18 个品牌 ID 每轮都全部查到(54 次调用 54 次成功),单次 2.5 到 4.9 秒;2026-10-04 目录价格为 Free。instagram/v1/user-id-to-username和instagram/v2/user-id-to-username在 2026-10-04 返回 HTTP 404endpoint_not_found,查历史用户名的instagram/v3/user-former-usernames也一样。- ID 要按字符串传。传 JSON 数字会被参数校验挡下(HTTP 400);带空格、非数字、空串或不存在的 ID 一律返回 HTTP 503,看不出是 ID 本身的问题。
- Meta 官方 Graph API 里那种 17 位 ID 是另一套编号。Meta 文档示例里的 ID 查不到;同一个品牌用 SandBase 拿到的 ID 能查到。
- 只适用于公开账号,只读。存表时以 ID 为主键,用户名才是会变的那个。
哪个接口能把 Instagram 用户 ID 转成用户名
SandBase 的 Instagram 目录里有好几个接口收 user_id。我先在 registry 里查了每个接口是否启用,再用 natgeo、nasa、instagram 三个账号的 ID 各调两轮。
| 接口 | 2026-10-04 状态 | 单次耗时(N=6) | outputs[0].data 字段数 | 不存在的 ID |
|---|---|---|---|---|
instagram/v3/user-id-to-username | 已启用,Free | 2.7 到 3.7 秒 | 18 | HTTP 503 |
instagram/v1/user-info-by-id-v2 | 已启用,Free | 1.9 到 4.2 秒 | 62 | HTTP 200,带 errorMessage |
instagram/v1/user-info-by-id | 已启用,Free | 4.2 到 9.5 秒 | 64 到 69 | 未测 |
instagram/v2/user-info | 已启用,Free | 3 个品牌 ID 全部 HTTP 503 | 无 | 未测 |
instagram/v1/user-id-to-username | 已停用 | HTTP 404 | 无 | 无 |
instagram/v2/user-id-to-username | 已停用 | HTTP 404 | 无 | 无 |
v3 胜在刚好对题:返回小,username 就在顶层。v1 的 V2 版资料接口适合当兜底,因为它遇到不存在的 ID 会给一句能看懂的话,而不是 503。老的 v1 资料接口能用,但最慢,返回的东西也大多用不上。
如果你是从 v1 user-id-to-username 的模型页过来的:这个页面 2026-10-04 还能打开,可我对这个接口发的每次调用都返回 HTTP 404 和 {"error": "endpoint_not_found"},请改用 v3 路径。之前那篇用户名查 ID 的教程在 2026-10-01 碰到过 v3 间歇性 503;到 2026-10-04,我用 SandBase 自己的用户名查询拿到的 ID 一共 62 次调用,全部成功。
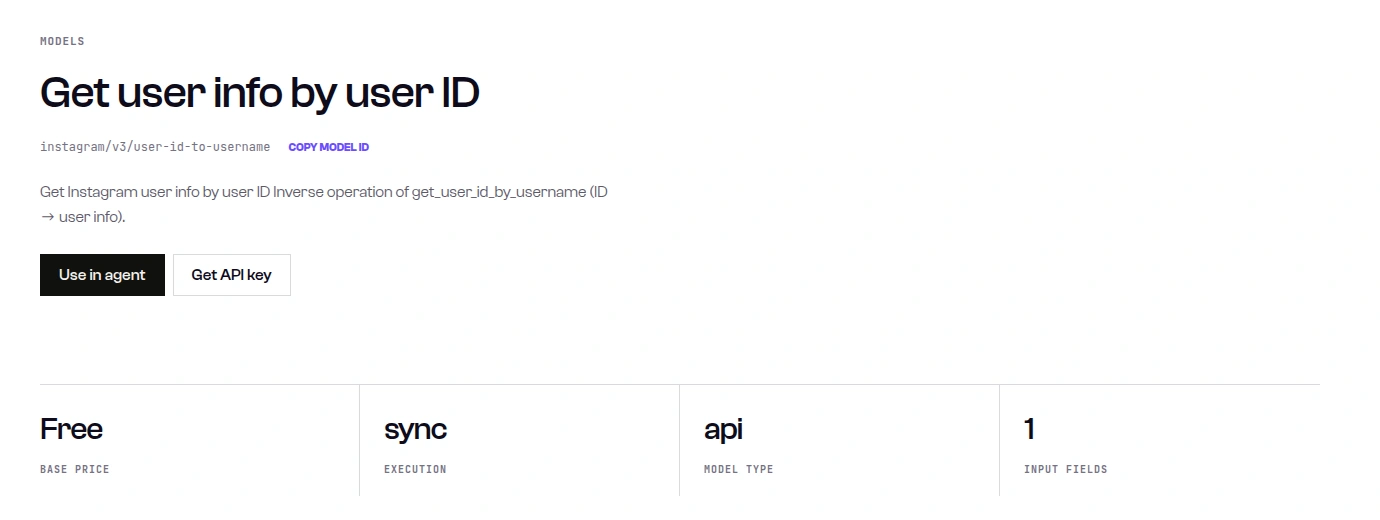
截图:v3 user-id-to-username 模型页显示基础价格 Free、同步执行、只有一个输入字段,和目录 API 返回的价格一致(2026-10-04 截取)。
数据边界
这些接口凭 SandBase API Key 读取公开的账号资料。SandBase 不是 Meta 或 Instagram 的官方合作方,拿不到私密账号、私信、账号后台数据,也不能代替账号做任何操作。请只用在你有权研究的账号上,比如品牌、媒体、你自己或客户的账号。不要拿它去给一个不愿公开身份的个人“对上号”。本文用到的账号全部是品牌和媒体账号,其中 18 个测试账号都是认证账号。
第一步:调一次,读出用户名
请求体只有一个字段 user_id,必须是字符串。
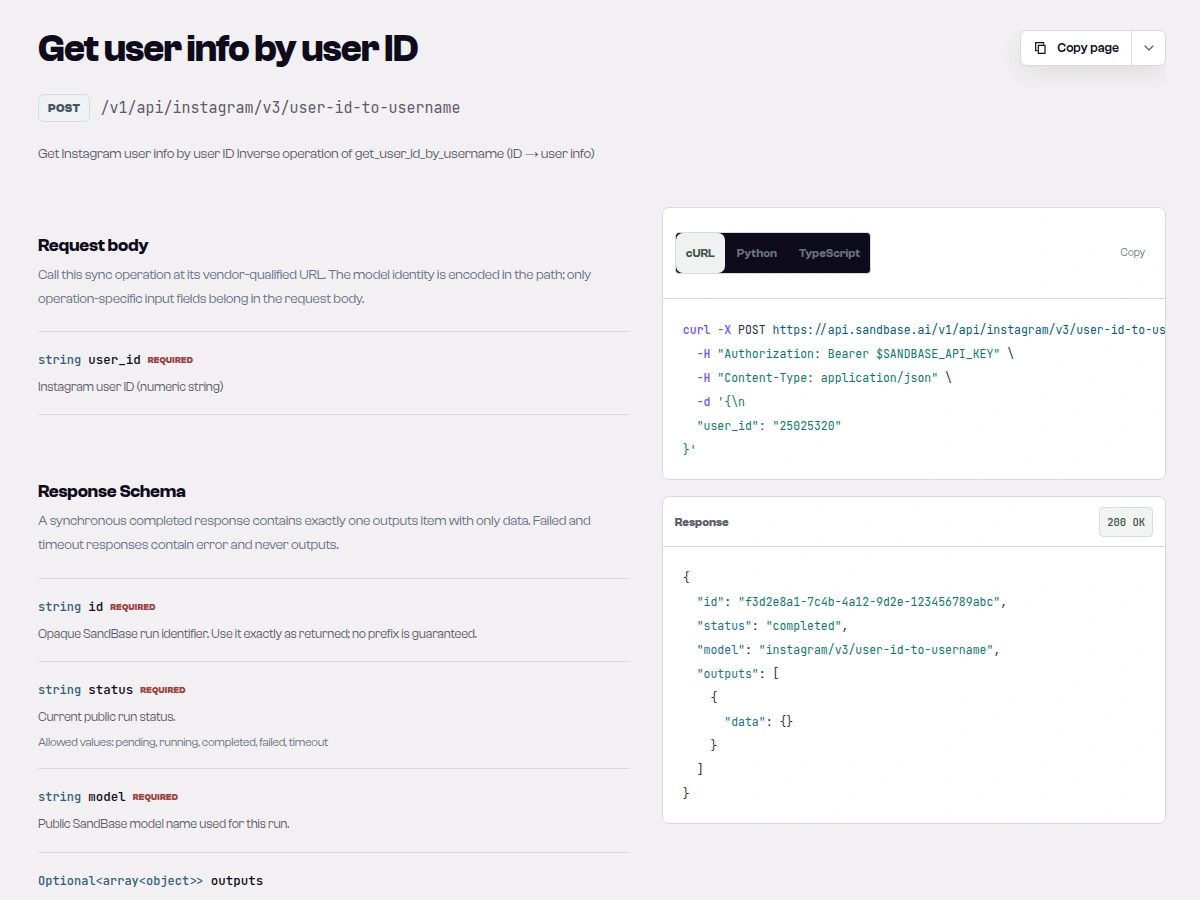
截图:v3 user-id-to-username 的接口文档写明了 POST 路径和唯一必填的字符串字段 user_id(说明为数字字符串),示例里的 data 是空对象,所以下文字段都来自实测(2026-10-04 截取)。
这里用的是接口文档里的 Model API 路径,不是目录页上展示的 GET 路径。调用是同步的,资料就在同一个响应的 outputs[0].data 里。
实测记录:2026-10-04(UTC)
输入:18 个认证品牌和媒体账号的 ID,分别是 instagram、natgeo、nasa、nike、adidas、nba、bbcnews、cnn、spotify、netflix、starbucks、google、nytimes、redbull、lego、airbnb、patagonia、duolingo。每个 ID 都先用 instagram/v3/user-id-by-username 查出来,所以每个 ID 都有确定的正确答案。上面那条 curl 的 run 是 e947a63e-1aa4-4734-ba3d-4eb3e65d4b85,返回如下。我删掉了三个字段(profile_pic_url、profile_pic_url_hd 和内部字段 _rid),其余原样保留:
{
  "id": "e947a63e-1aa4-4734-ba3d-4eb3e65d4b85",
  "status": "completed",
  "model": "instagram/v3/user-id-to-username",
  "outputs": [
    {
      "data": {
        "biography": "Step into wonder and find your inner explorer with National Geographic 🌎",
        "category": "",
        "edge_follow": {"count": 194},
        "edge_followed_by": {"count": 268459852},
        "edge_owner_to_timeline_media": {"count": 32041},
        "external_url": "http://visitstore.bio/natgeo",
        "follower_count": 268459852,
        "following_count": 194,
        "full_name": "National Geographic",
        "id": "787132",
        "is_private": false,
        "is_verified": true,
        "media_count": 32041,
        "pk": "787132",
        "username": "natgeo"
      }
    }
  ]
}这些字段名是我这次看到的,不是文档承诺。username 是当前用户名;id 和 pk 都原样回显了我发的 ID;粉丝数出现两次,一次是 follower_count,一次在 edge_followed_by 里。Python 里建议这样防御式读取:
data = outputs[0].get("data") or {}
username = data.get("username")  # None 表示没拿到答案,别猜
第二步:认清错误 ID 长什么样
我给 v3 接口发了六种错误输入,只有前两种的报错能看出问题在哪。
| 输入 | 结果 |
|---|---|
{"user_id": 787132}(JSON 数字) | HTTP 400,parameter validation failed: /user_id: expected string, but got number |
{} | HTTP 400,missing properties: 'user_id' |
" 787132 "(带空格) | HTTP 503 |
"natgeo"(传成用户名) | HTTP 503 |
"99999999999999999"(不存在) | HTTP 503 |
"" | HTTP 503 |
所有 503 的报错文字都一样:upstream error 400: Request failed. Please retry.,并注明这次不扣费。也就是说,503 既可能是上游一时抽风,也可能是 ID 本身不对,响应里分辨不出来。两个习惯能解决大部分情况:调用前去掉空格、确认 ID 全是数字;同一个 ID 反复 503 时,换一个接口确认。
这个“第二个接口”就是 instagram/v1/user-info-by-id-v2。对那个不存在的 ID,run 03423151-7be6-4c98-8ea7-7a73236924f3 返回 HTTP 200,完整 data 如下:
{"errorMessage": "This account does not exist.", "status": false}这是我见到的最清楚的“查无此号”信号。它同样要求字符串 ID,传数字也是 HTTP 400。
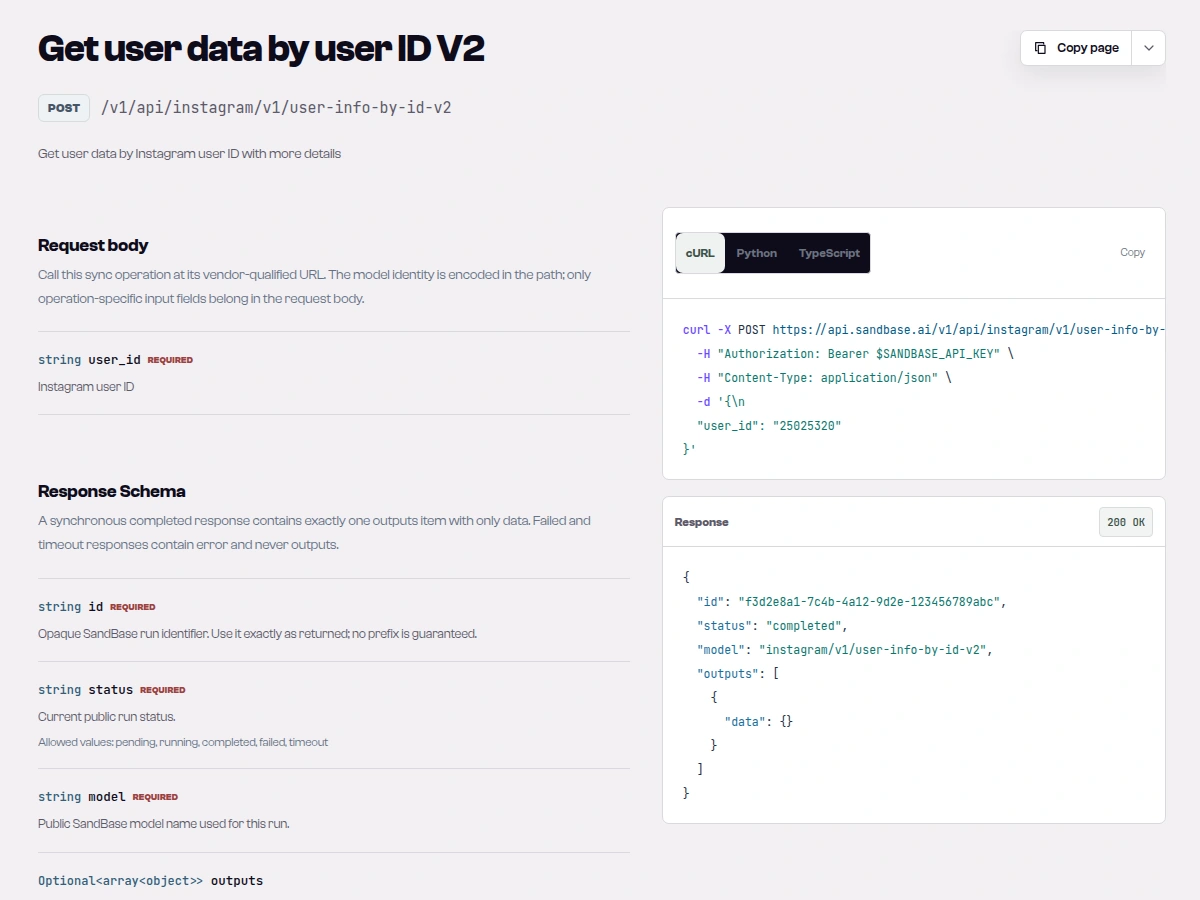
截图:user-info-by-id-v2 的接口文档显示它有自己的 POST 路径,请求同样只有一个 user_id 字段,所以批量脚本可以原样换过去兜底(2026-10-04 截取)。
Instagram 用户 ID 从哪里来
数字 ID 一般出现在数据里,而不是 Instagram 界面上:主页链接里放的是用户名,不是 ID。
- 账号资料返回:资料里的
id和pk就是用户 ID。 - 帖子的 media ID:
instagram/v3/user-posts返回的帖子id形如3983118388705688735_787132,前半段是帖子的pk,下划线后面是发帖账号的用户 ID。按_切开,就知道这条帖子是谁发的。 - 自己的日志和导出:如果某个工具或旧流程只存了 ID 没存用户名,就用这个办法把它们变回能读的名字。
- 分享链接:分享链接里的
igsh=参数,我没找到任何文档说明能把它还原成账号,所以没有把它当成用户 ID。
Graph API 的 ID 是另一套编号
Meta 的 Business Discovery 文档(2026-10-04 查阅)里,Blue Bottle Coffee 的 Instagram 用户 ID 写的是 17841401441775531,这是 Meta Graph API 用的 ID。我把它发给两个查询接口:v3 返回 HTTP 503,v1 的 V2 接口回答 “This account does not exist.”(run ee7bd5d6-7801-4e3b-a3b2-54d2571777c8)。而用 instagram/v3/user-id-by-username 查 bluebottle,得到的是 354032059(run cebb35e2-6c1d-4204-9703-65208e469415)。Meta 文档里的示例 ID 都以 1784 开头、一共 17 位。如果你的 ID 也长这样,它可能来自 Meta 官方 API,那就得回到 Meta 的 API 去解析。这类 ID 我只测了这一个。
| 你手上有 | 用什么 |
|---|---|
| 公开资料或帖子返回里的数字 ID | instagram/v3/user-id-to-username(本文) |
| 自己 Meta 应用拿到的 Graph API ID | Meta 的 Instagram Platform API,配你自己应用的 token |
| 用户名,想查 ID | instagram/v3/user-id-by-username,见用户名查 ID 教程 |
| 帖子链接或 shortcode | 先用 instagram/v1/shortcode-to-media-id,再按上面的方法切出账号 ID |
shortcode 和 media ID 可以互相转换,来回都对得上。National Geographic 的帖子 DdG4RIxIPyf 经 instagram/v1/shortcode-to-media-id 转成 media ID 3983118388705688735,用时 1.2 秒;instagram/v1/media-id-to-shortcode 再转回去,用时 0.9 秒。两次都返回 {"media_id": "3983118388705688735", "shortcode": "DdG4RIxIPyf", "status": true}。v3 的 shortcode 接口给出同样的一对值,只是没有 status。
第三步:把一整张 CSV 的 ID 批量转成用户名
下面是一个单文件的批量转换脚本,Python 加 requests。它读取带 user_id 列的 CSV,去掉空格,把不是纯数字的行单独放一边,去重,然后逐个查询,每次间隔 1 秒。每个 ID 先查 v3,遇到 5xx 或连接被重置就短暂退避后再试,最多重试两次;还不行就换 v1 的 V2 接口。输出 CSV 每行都带状态和备注。这就是第三轮实际运行的文件(前两轮逻辑相同,只是还没加非 JSON 响应的保护):
#!/usr/bin/env python3
"""Convert a CSV of Instagram user IDs to current usernames with SandBase.

Usage: python3 ig_ids_to_usernames.py ids.csv usernames.csv
The input CSV needs a user_id column. Public accounts you are allowed to research only.
"""
import csv
import os
import sys
import time

import requests

BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
PRIMARY = "instagram/v3/user-id-to-username"
FALLBACK = "instagram/v1/user-info-by-id-v2"
PAUSE = 1.0  # seconds between lookups


class LookupFailed(Exception):
    pass


def call(model: str, user_id: str, tries: int = 3) -> dict:
    """POST one lookup; retry 5xx and connection resets; return outputs[0].data."""
    for attempt in range(tries):
        try:
            resp = requests.post(f"{BASE}/{model}", headers=HEADERS, json={"user_id": user_id}, timeout=60)
        except requests.ConnectionError:
            time.sleep(3 * (attempt + 1))
            continue
        try:
            body = resp.json()
        except ValueError:  # non-JSON error page
            body = {"error": resp.text[:200]}
        if resp.status_code >= 500 and attempt < tries - 1:
            time.sleep(3 * (attempt + 1))
            continue
        outputs = body.get("outputs") or []
        if resp.status_code != 200 or body.get("status") != "completed" or not outputs:
            raise LookupFailed(f"HTTP {resp.status_code}: {body.get('error')}")
        return outputs[0].get("data") or {}
    raise LookupFailed("connection failed")


def lookup(user_id: str) -> dict:
    """Try the compact v3 endpoint first, then instagram/v1/user-info-by-id-v2."""
    errors = []
    for model in (PRIMARY, FALLBACK):
        try:
            data = call(model, user_id)
        except LookupFailed as e:
            errors.append(f"{model.split('/', 1)[1]}: {e}")
            continue
        if data.get("username"):
            return {"username": data["username"], "full_name": data.get("full_name", ""),
                    "is_verified": data.get("is_verified"), "is_private": data.get("is_private"),
                    "status": "ok", "source": model}
        errors.append(f"{model.split('/', 1)[1]}: {data.get('errorMessage') or 'no username in data'}")
    return {"status": "not_found", "note": " | ".join(errors)}


def read_ids(path: str) -> tuple[list[str], list[dict]]:
    """Normalize ids to digit strings, dedupe in order, and set aside invalid rows."""
    ids, rejected, seen = [], [], set()
    with open(path, newline="") as f:
        for row in csv.DictReader(f):
            raw = (row.get("user_id") or "").strip()
            if not raw.isdigit():
                rejected.append({"user_id": raw, "status": "invalid_id", "note": "not a numeric id"})
            elif raw not in seen:
                seen.add(raw)
                ids.append(raw)
    return ids, rejected


def main(src: str, dst: str) -> None:
    ids, rows = read_ids(src)
    print(f"{len(ids)} unique numeric ids, {len(rows)} rejected before any call")
    for i, uid in enumerate(ids, 1):
        start = time.time()
        result = {"user_id": uid, **lookup(uid)}
        result["seconds"] = round(time.time() - start, 2)
        rows.append(result)
        print(f"[{i}/{len(ids)}] {uid:>12} -> {result.get('username') or result['status']} ({result['seconds']}s)")
        time.sleep(PAUSE)
    fields = ["user_id", "username", "full_name", "is_verified", "is_private", "status", "source", "seconds", "note"]
    with open(dst, "w", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fields)
        writer.writeheader()
        writer.writerows(rows)
    ok = sum(r["status"] == "ok" for r in rows)
    print(f"wrote {dst}: {ok} resolved, {len(rows) - ok} not resolved")


if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
我的 ids.csv 有 22 行:18 个品牌 ID,再加一遍 787132,一个前后带空格的 NASA ID,字符串 natgeo,以及不存在的 99999999999999999。先导出 SANDBASE_API_KEY,再运行:
python3 ig_ids_to_usernames.py ids.csv usernames.csv第三轮在 2026-10-04 03:36 UTC 跑完,中间几行省略:
19 unique numeric ids, 1 rejected before any call
[1/19]     25025320 -> instagram (3.07s)
[2/19]       787132 -> natgeo (3.14s)
[3/19]    528817151 -> nasa (2.75s)
[17/19]    143939018 -> patagonia (2.66s)
[18/19]    231373492 -> duolingo (2.58s)
[19/19] 99999999999999999 -> not_found (21.03s)
wrote usernames.csv: 18 resolved, 2 not resolved
重复的 ID 和带空格的 NASA ID 都合并成一次查询;natgeo 没发请求就被挡下。三轮里,18 个品牌 ID 都是 v3 第一次就查到,兜底接口一次都没替真实账号出过场。不存在的 ID 每轮都花了 20 到 25 秒,因为要先把 v3 的重试用完,兜底接口才给出否定答案。它在 usernames.csv 里的备注是:
v3/user-id-to-username: HTTP 503: upstream error 400: Request failed. Please retry. ... | v1/user-info-by-id-v2: This account does not exist.这一行里重复的 503 文字我做了截断。名单很大时,我会改两处:如果很多 ID 可能已失效,把重试次数调低,因为每个失效 ID 要耗掉 20 秒左右;以及边查边写文件,免得中途崩了整批白跑。间隔我保持在 1 秒。当天大约 130 次 Instagram 调用没碰到限流,但我手上也没有可以引用的官方限额。
费用
2026-10-04,GET /v1/models/instagram/v3/user-id-to-username 返回 base_price: "0",兜底的 v1 V2 接口、user-id-by-username 和 shortcode 相关接口也都是 0。这个查询要带同一把 Bearer Key;不想用 Key 的话,公开模型页上也能看到价格。我用 GET /v1/tasks/<id>/cost(同样要带 Key)核对了一次 v3 查询、一次查无此号的 v1 V2 查询和一次 shortcode 调用,都是 "cost": "0.000000"。网站当时挂着 “API Free Week” 横幅,大批量跑之前请先看一眼模型页。
用户名为什么会变,表里该存什么
用户名是账号主人可以随时改的名字,数字 ID 才是不变的那个。表里以 ID 为主键,用户名当作需要定期刷新的缓存。定时重跑转换脚本、对比 username 列,就能发现改名。SandBase 的 registry 里也有查历史用户名的 instagram/v3/user-former-usernames,但它在 2026-10-04 返回 HTTP 404,所以我没法展示它的输出。
测试范围和局限
范围:18 个认证品牌和媒体账号、一个不存在的 ID、一个 Graph API ID,测试只在一天内完成。私密账号、已注销账号、刚改过名的账号我都没测,不知道它们会返回什么。耗时是从一台机器测得的端到端时间。字段名来自这几次返回,不是文档定义的结构。原始响应和探测脚本留在内部;输入、run ID、规则和结果都已写在本文里。
接下来
- 反方向(用户名查 ID):看 Instagram 用户 ID API 教程。
- 拿到用户名之后,想看主页资料和最近帖子:看 Instagram 账号研究 API 指南。
- 其他 Instagram 接口:看 Instagram 数据 API 总览。
想自己跑一遍,可以打开 user-id-to-username 接口文档,或者在模型页上直接试,然后申请一个 SandBase API Key。
常见问题
能通过用户 ID 查到 Instagram 用户名吗?
公开账号可以。把数字 ID 以字符串形式发给 instagram/v3/user-id-to-username,读 username 字段即可。2026-10-04 我试的 18 个品牌账号全部查到。
有免费的 Instagram ID 转用户名工具吗?
本文用到的 SandBase 接口在 2026-10-04 都标 Free,实际扣费 $0,当时网站挂着 “API Free Week” 横幅。需要一个 SandBase API Key。上面的脚本可以一次转换整张 CSV。
用户名为什么变了?
账号主人可以改用户名,数字 ID 不变。存 ID,定期重新查,就能跟上改名。查历史用户名的 instagram/v3/user-former-usernames 在 2026-10-04 返回 404。
为什么我的 Instagram ID 报错?
先查三件事:是不是按字符串传的(传数字会 HTTP 400);是不是纯数字、没有空格;是不是 Meta 官方 API 给的 17 位 Graph API ID。如果仍然 503,换 instagram/v1/user-info-by-id-v2 问一次,账号不存在时它会直接说 “This account does not exist.”。
私密账号能查吗?
我只测了公开的品牌账号。这些接口读取的是公开数据,拿不到私密账号的资料;本文也不是用来识别那些选择不公开账号的人的。