Agent 用便宜模型够不够?22 个模型分档实测
Agent 用便宜模型够不够实测:7 个厂商的 Flash、标准、Pro、Max 档共 22 个模型,17 道工具调用题各跑 3 次。GPT-6 Luna 51/51 全对,单任务成本约为 GPT-6.1 Sol 的 1/20。
同一家 OpenAI,GPT-6 Luna 每百万输入 token 标价 $0.10,GPT-6 Astra 标价 $10,差了 100 倍。在我们的 17 道 Agent 工具调用题上,每题跑 3 次,Luna 51 次全对,Astra 对了 50 次。Astra 错的那一次是 T2:把点赞数 2,780,636 抄成了 2,782,636。
这就是这篇 Agent 用便宜模型够不够实测要回答的问题。我们沿用 12 个模型的工具调用实测的测试程序,在 2026-10-03(UTC)又加跑了 10 个模型,这样大多数厂商都有 2 到 4 个档位跑在同一套题上:Flash、标准版、Pro、Prime、Max。问题很窄:任务是“调一个数据工具,读结果,按 JSON 交答案”时,多花钱上高档模型,到底能换来什么?
先说结论
- GPT-6 Luna 51/51,单任务成本中位数 $0.00035,约为 GPT-6.1 Sol($0.0069)的 1/20。Sol、Sol Pro、Luna 都是 51/51;全场最贵的 GPT-6 Astra 是 50/51。
- 6 个有多档的厂商里,只有 2 家是高档明显更好:Claude Opus 5.5 51/51,Sonnet 5.5 44/51;阿里从 Qwen3.7 Flash 的 38 分,到 Qwen3.8 Max 0902 的 49 分,再到 Max Prime 的 51 分。OpenAI、小米、智谱三家,最高档并不比便宜的档强。
- GPT-6.1 Sol Pro 和 Sol 标价相同($2 / $10),但每个任务的输入 token 中位数是 9,026,Sol 是 2,887,所以实际花费约是 Sol 的 3 倍。
- 全对的模型里最便宜的,不是全场最便宜的模型。Qwen3.7 Flash 的“每个正确答案成本”最低($0.00033),但 51 次错了 13 次,其中 10 次是输出被截断。
- 测试范围:一类任务(中文社媒数据查询 + 统计),每题 3 次,默认参数,成本按 token 用量 × 标价计算。不涉及长推理、写代码和长文档。
各家档位和价格
价格是 2026-10-03 SandBase 标价,约 11:16 UTC 从 GET https://api.sandbase.ai/v1/models/<id> 的 prompt_token_price、completion_token_price 和 price_formula 读取,这些字段是每 token 的美元价格,表中换算成美元 / 百万 token。22 个模型都是 enabled: true。
| 厂商 | 参测档位(输入 / 输出) |
|---|---|
| OpenAI | GPT-6 Luna $0.10 / $0.50 · GPT-6.1 Sol $2 / $10 · GPT-6.1 Sol Pro $2 / $10 · GPT-6 Astra $10 / $50 |
| Anthropic | Claude Sonnet 5.5 $2 / $10 · Claude Opus 5.5 $4 / $20 |
| 智谱 Z.ai | GLM-5.3 Flash $0.15 / $0.50 · FlashX $0.37 / $1.25 · GLM-5.3 $1.40 / $4.40 · Prime $2.80 / $8.80 |
| 小米 | MiMo v2.6 Flash $0.14 / $0.28 · MiMo v2.6 Pro $0.435 / $0.87 |
| DeepSeek | V4.1 Flash $0.30 / $1.20 · V4 Pro 0813 $1.32 / $3.96 |
| 阿里 | Qwen3.7 Flash $0.03 / $0.13 · Qwen3.8 Max 0902 $2 / $6 · Qwen3.8 Max Prime $4 / $12 |
| Gemini 3.8 Flash $1.50 / $7.50(没测更高档) | |
| 单档 | Grok 4.7 $2 / $6 · Kimi K3 $3 / $15 · MiniMax M3 $0.30 / $1.20 · Seed 2.1 Pro $0.89 / $4.45 |
OpenAI 的 4 个模型、Qwen3.7 Flash 和 Grok 4.7 在单次请求的 prompt 超过 272K、256K 或 200K token 后会切换到更高费率。本次全部运行里最大的一次,各轮输入加起来也只有 59,630 token,所以每个请求都按基础费率计。
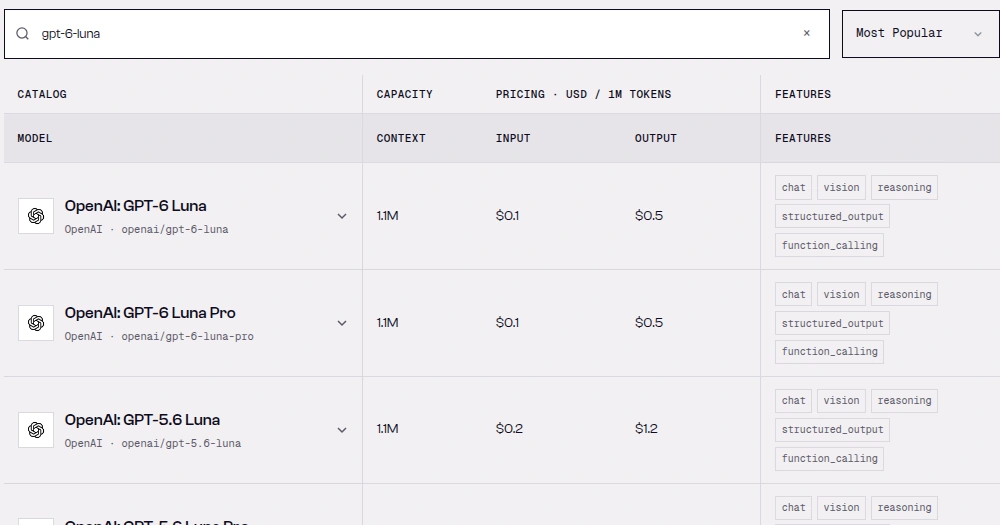
截图:SandBase 模型目录里 openai/gpt-6-luna 标价为输入 $0.10、输出 $0.50 每百万 token,单任务中位数 $0.00035 就是按这个价算的(2026-10-03 截取)。
“Flash”只是名字,不代表价位。Gemini 3.8 Flash 的标价是 GPT-6 Luna 的 15 倍;在这次测试里,它的单任务成本比 GLM-5.3 Flash、MiMo Flash、DeepSeek V4.1 Flash 三个加起来还高。
测试设置:同一套程序、同一批题、同一份缓存
除了模型名单,和 12 个模型那次相比什么都没改:
- 6 个工具,封装了 SandBase 上抖音、微博、小红书的公开数据接口。工具返回按“工具名 + 参数”缓存,对每个模型原样回放,所以 22 个模型看到的数据完全一样。标准答案由 Python 从同一份缓存算出。
- 17 道计分题:T1 到 T10(查数、求平均、数日期)和 H1 到 H6、H8(排序、10 到 20 个数求和、筛选列表、多步串联查询)。H7 题目本身有歧义,和上次一样不计分。完整题目见 12 个模型那篇。
- 每题 3 次,每轮最多输出 1,500 token,最多 10 轮,温度和推理参数用默认值,不开 prompt 缓存。
- Claude Opus 5.5 和 Sonnet 5.5 一样走 SandBase 的
POST /v1/messages;其余 20 个走POST /v1/chat/completions,用 OpenAI 格式的 function 工具。
22 个模型用的系统提示词原文如下:
You are a research agent with tools for public Douyin, Weibo and Xiaohongshu data. Use the tools to answer; never guess numbers. If something can't be found, say so. Finish with ONE line that starts with FINAL: followed by a compact JSON object with exactly the keys requested.判分规则:解析 FINAL: 后面的 JSON,逐个比对要求的键。整数去掉千分位逗号后比较,布尔值转小写后比较,ID 和名称按字符串精确比较,列表按顺序逐项比较。缺键、JSON 解析失败、没有 FINAL: 行都算错,多出来的键不管。缓存的工具返回不公开,因为那是关于真实账号的第三方平台内容;题目、提示词、判分规则和每次运行的汇总数据已经足够在你自己的数据快照上复现。
有一点不同需要说明。原来 12 个模型在 07:36 到约 08:16 UTC 跑完;新增的 10 个在 10:22 到 10:42 UTC 并行跑。数据一样,但延迟是在不同时段、不同负载下测的,两批之间差几秒可以当噪声看。另外,DeepSeek V4.1 Flash 和 Qwen3.7 Flash 发出了 11 次缓存里没有的主页请求(涉及 10 个账号),这些请求在运行时打到了线上接口;没有哪道题的标准答案依赖这些数据。
结果:22 个模型,按厂商分组
以下是我们在自己的题集上跑出的结果,不是厂商认证的性能数据。“单任务成本”取中位数。“每个正确答案成本”是该模型 51 次计分运行的总花费除以答对次数,答错的钱也算进去。
| 模型 | T(30) | H(21) | 合计(51) | 单任务成本中位数 | 每个正确答案成本 | 耗时中位数 | 截断 |
|---|---|---|---|---|---|---|---|
| OpenAI GPT-6 Luna | 30 | 21 | 51 | $0.00035 | $0.00038 | 7.6 秒 | 0 |
| GPT-6.1 Sol | 30 | 21 | 51 | $0.0069 | $0.0070 | 9.5 秒 | 0 |
| GPT-6.1 Sol Pro | 30 | 21 | 51 | $0.0213 | $0.0220 | 11.9 秒 | 0 |
| GPT-6 Astra | 29 | 21 | 50 | $0.0344 | $0.0352 | 13.6 秒 | 0 |
| Anthropic Claude Sonnet 5.5 | 27 | 17 | 44 | $0.0130 | $0.0168 | 13.6 秒 | 0 |
| Claude Opus 5.5 | 30 | 21 | 51 | $0.0285 | $0.0304 | 10.1 秒 | 0 |
| 智谱 GLM-5.3 Flash | 30 | 19 | 49 | $0.00068 | $0.00080 | 21.4 秒 | 2 |
| GLM-5.3 FlashX | 29 | 21 | 50 | $0.0018 | $0.0019 | 9.8 秒 | 0 |
| GLM-5.3 | 29 | 20 | 49 | $0.0066 | $0.0072 | 21.5 秒 | 1 |
| GLM-5.3 Prime | 30 | 19 | 49 | $0.0130 | $0.0157 | 9.8 秒 | 2 |
| 小米 MiMo v2.6 Flash | 29 | 21 | 50 | $0.00060 | $0.00063 | 5.8 秒 | 0 |
| MiMo v2.6 Pro | 30 | 20 | 50 | $0.0018 | $0.0020 | 12.7 秒 | 1 |
| DeepSeek V4.1 Flash | 29 | 19 | 48 | $0.0015 | $0.0018 | 6.3 秒 | 0 |
| V4 Pro 0813 | 28 | 21 | 49 | $0.0069 | $0.0073 | 10.2 秒 | 0 |
| 阿里 Qwen3.7 Flash | 26 | 12 | 38 | $0.00025 | $0.00033 | 9.7 秒 | 10 |
| Qwen3.8 Max 0902 | 30 | 19 | 49 | $0.0112 | $0.0125 | 12.3 秒 | 2 |
| Qwen3.8 Max Prime | 30 | 21 | 51 | $0.0213 | $0.0240 | 8.4 秒 | 0 |
| Google Gemini 3.8 Flash | 27 | 19 | 46 | $0.0058 | $0.0069 | 6.3 秒 | 0 |
| 单档 Grok 4.7 | 30 | 21 | 51 | $0.0139 | $0.0148 | 8.7 秒 | 0 |
| Kimi K3 | 30 | 21 | 51 | $0.0159 | $0.0167 | 8.5 秒 | 0 |
| MiniMax M3 | 28 | 20 | 48 | $0.0019 | $0.0021 | 10.2 秒 | 1 |
| Seed 2.1 Pro | 29 | 19 | 48 | $0.0058 | $0.0067 | 17.1 秒 | 3 |
1,122 次计分运行里,没有一次工具调用不符合 schema;T9 问的是一个不存在的账号,22 个模型 3 次都回答了“不存在”。总共 48 次失误,新增 10 个模型占 26 次,其中 13 次是 Qwen3.7 Flash。
每家的高档模型,多花的钱买到了什么
OpenAI:这套题上什么也没买到。 Luna、Sol、Sol Pro 都是 51/51,Astra 50。Luna 和 Sol 的输入中位数一样(2,887 token),输出也接近(139 对 110),所以成本差几乎就是价格差:Sol 的中位数是 Luna 的 19.6 倍。Astra 用的 token 和 Sol 一样,费率是 5 倍,花费也正好是 5 倍。
Sol Pro:单价一样,账单三倍。 Sol Pro 标价 $2 / $10,和 Sol 完全相同,但每个任务的输入中位数是 9,026 token,Sol 是 2,887。T1 三次都一样:同样 3 轮对话、2 次工具调用,Sol Pro 输入 10,374 token,Sol 只有 2,788。输出也更多(253 对 110)。最后它的单任务中位数是 $0.0213,是 Sol 的 3.1 倍,也更慢(11.9 秒对 9.5 秒)。多出来的输入 token 从哪来,我们没有拆开查;usage 字段里报了这么多,价格公式就按这么多计费。
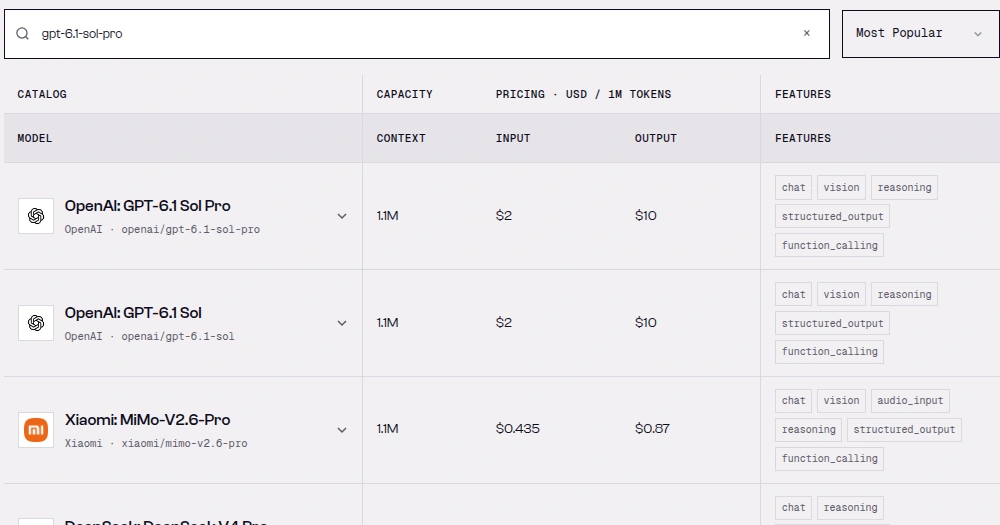
截图:SandBase 模型目录中 GPT-6.1 Sol Pro 与 GPT-6.1 Sol 标价都是 $2 / $10,所以 Sol Pro 单任务贵 3 倍来自 token 用量,而不是单价(2026-10-03 截取)。
Anthropic:唯一一家升档在准确率上明显回本。 Sonnet 5.5 错的 7 次全是对工具结果做算术:T5 求平均错 2 次,T7 数日期错 1 次,H2 筛选列表错 3 次(把低于平均值的视频也算了进去),H3 求和差了 10,000。这 4 道题 Opus 5.5 每次都对。它用的 token 和 Sonnet 差不多(输入 / 输出中位数 5,041 / 436,Sonnet 是 4,932 / 415),所以成本大致就是 2 倍的价差:$0.0285 对 $0.0130。Opus 最慢一次 24 秒,Sonnet 最慢一次 259 秒。如果你的 Agent 必须用 Claude,这类任务选 Opus 更稳;如果不限厂商,Luna 也是 51/51,单任务中位数约为 Opus 的 1/80。
阿里:底线确实存在。 Qwen3.7 Flash 是这里每 token 最便宜的模型,效果也对应。13 次失误里 10 次是截断:T5(3 次)、H2(3 次)、H8(2 次)、H3 和 H6 都撞上了 1,500 token 上限,单任务输出中位数 949 token,22 个模型里最高。其余是 H3 求和差了 20,000、H4 总数算错,以及 T10 本该取搜索结果里的粉丝数,它却用了主页接口里的数。Qwen3.8 Max 0902 49 分,Max Prime 51 分,单任务中位数分别是 Flash 的 45 倍和 86 倍。
智谱:FlashX 比 Prime 还好。 GLM-5.3 FlashX 50/51,唯一一次失误是 T6 输出 208 token 就停了,没有写 FINAL 行。GLM-5.3 Flash 49 分,两次失误都是 H2 截断;它也是新增模型里最慢的,中位数 21.4 秒,最慢一次 77 秒。GLM-5.3 和 GLM-5.3 Prime 都是 49 分。Prime 单任务成本是 FlashX 的 7 倍,还少了 1 分。
小米:Flash 追平 Pro。 MiMo v2.6 Flash 50/51,单任务 $0.00060,是 Pro($0.0018)的三分之一;耗时中位数 5.8 秒,22 个模型里最快。它错的一次是 T5 平均值答成 418,764,正确是 422,764,正好差 4,000。Pro 错的一次是 H2 截断。
DeepSeek:多 1 分,贵 4.5 倍。 V4.1 Flash 48 分,V4 Pro 0813 49 分。Flash 三次失误里有两次不是算错,而是数取错了地方:H6 它对 11 个账号调了主页接口,按主页粉丝数排名,而题目要求用搜索结果;T10 它报了主页里的粉丝数 1,401,200,而搜索结果是 1,399,062。第三次是 H2 列表只列了 4 个 ID 里的 3 个。
Gemini 3.8 Flash 46/51:T5 三次都答 422,739(正确是 422,764),另有两次 H2 列表多列了视频。速度快(中位数 6.3 秒),但单任务中位数是 Luna 的 16.5 倍,还多错了 5 次。
每个正确答案的成本,以及它为什么还不够
按中位数算,每天跑 1,000 个这类任务,GPT-6 Luna 约 $0.35,MiMo v2.6 Flash 约 $0.60,GPT-6.1 Sol 约 $6.90,Claude Opus 5.5 约 $28.50,GPT-6 Astra 约 $34.40。这是从每个模型 51 次短任务外推的,前提是你的任务和我们的相似。
“每个正确答案成本”把失败也算了进去,但仍可能误导。Qwen3.7 Flash 在表里这一项最低($0.00033),因为它太便宜了,错 13 次也拉不高多少。可在生产环境里,失败的运行要被发现、重试或升级处理,一个四次错一次的模型和一个从不出错的模型,不是同一种选择。
运行结束后,我们在 11:22 到 11:42 UTC 查看目录和账单时,有两个模型正在打折:Claude Opus 5.5 七五折($3 / $15),GPT-6 Astra 六五折($6.50 / $32.50)。GET /v1/models 返回的价格字段仍是标价。这段时间内我们发了一个一句话的 Astra 请求,按标价应为 $0.00033,实际计费 $0.000215,和 35% 的折扣一致。我们无法确认 10:22 到 10:42 跑测试时折扣是否已生效,所以本文所有表格都按标价算。按折扣价,Opus 中位数约 $0.0214,Astra 约 $0.0224,仍是 Luna 的 60 倍以上。
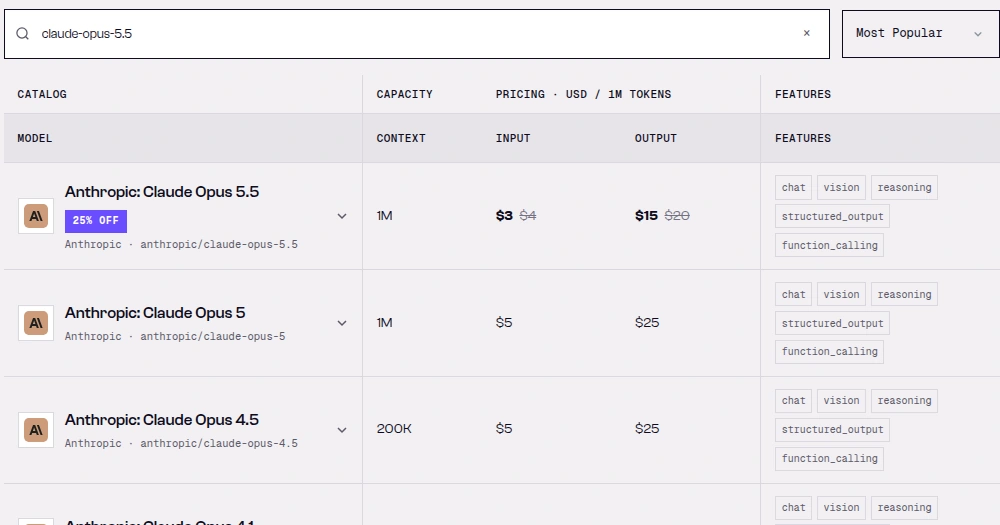
截图:2026-10-03 SandBase 模型目录显示 Claude Opus 5.5 七五折($3 / $15,标价 $4 / $20);本文成本数字都按标价计算(2026-10-03 截取)。
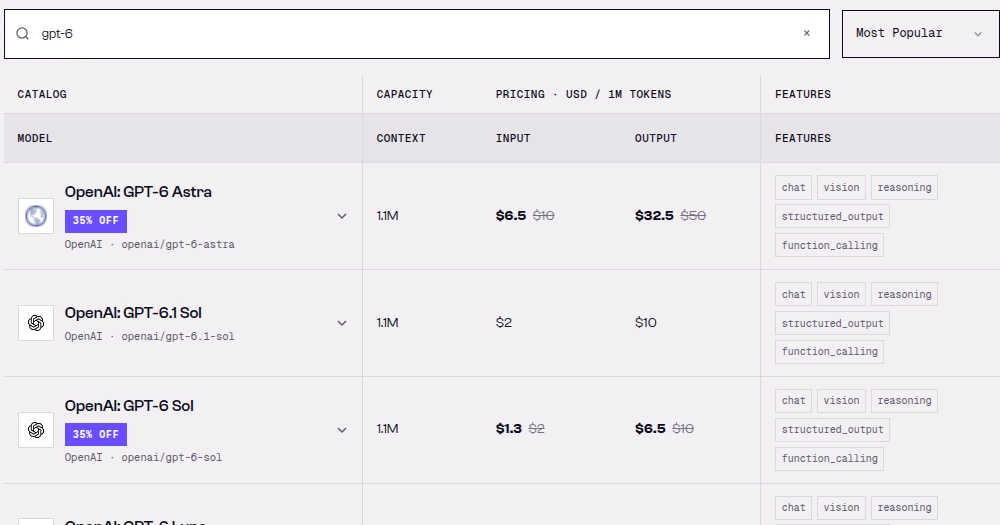
截图:同一目录中 GPT-6 Astra 在 $10 / $50 标价基础上打六五折,GPT-6.1 Sol 仍是 $2 / $10(2026-10-03 截取)。
新增 10 个模型共 510 次运行,按标价 token 花费合计 $5.03。数据接口在目录里是免费的(douyin/app-v3/user-post-videos 的 base_price 为 0,2026-10-03 查询)。
怎么给你的 Agent 选档位
数据指向的是一条路由规则,而不是一个赢家:用能通过你自己题集的最便宜档位做默认模型,再留一个更强的模型做兜底。
| 你的需求 | 默认 | 兜底 | 注意 |
|---|---|---|---|
| 成本最低,OpenAI 兼容 | GPT-6 Luna(51/51,$0.00035) | GPT-6.1 Sol(51/51,$0.0069) | 只测了一类任务,先用你的任务验证 |
| 成本最低,换一家厂商 | MiMo v2.6 Flash(50/51,$0.00060) | MiMo v2.6 Pro 或 GPT-6.1 Sol | T5 算错一次,求和放到代码里 |
| 用智谱模型 | GLM-5.3 FlashX(50/51,$0.0018) | GLM-5.3 Prime | GLM-5.3 Flash 这次很慢(中位数 21.4 秒) |
| 需要 Claude 特有能力 | Claude Opus 5.5(51/51,$0.0285) | 这套题上不需要 | Sonnet 5.5 心算错了 7 次 |
| 只看 token 单价 | 多步任务别用 Qwen3.7 Flash | Qwen3.8 Max Prime | 51 次里 10 次在 1,500 token 处截断 |
GPT-6 Astra 和 GLM-5.3 Prime 是各自家族里最贵的,分数却没有超过更便宜的兄弟型号。真正有用的升级,Opus 对 Sonnet、Qwen3.8 对 Qwen3.7 Flash,解决的是具体的失败类型:心算和截断。按 Claude Sonnet 5.5 和 GPT-6.1 Sol 对比实测的建议把算术挪到代码里,这部分差距就会缩小一截。编程 Agent 的取舍不一样:只有当测试能拒掉错误补丁时,重试才便宜,Gemini 3.8 Flash 重试成本分析专门算过这笔账。
便宜档优先、失败再兜底的 Agent
在 SandBase 上,一个 API Key 就能调用这 22 个模型,其中 20 个走同一套 OpenAI 兼容的 Chat Completions 接口,所以兜底顺序只是一个模型 id 列表。下面的程序先用 GPT-6 Luna,只有在运行彻底失败时才换 GPT-6.1 Sol:HTTP 报错、finish_reason: length、没有 FINAL 行、JSON 解析失败,或者达到轮数上限。它不判断答案对不对,那是你的题集该做的事。工具在 Python 里算好统计量,只把汇总结果交给模型。aweme_list 和 statistics.digg_count 是我们 2026-10-03 在返回里观察到的字段名,不是文档承诺,所以都用 .get() 读取。
import os
import re
import json
import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
# Cheapest tier first, stronger tier as fallback. $/M input, output (SandBase list price, 2026-10-03).
TIERS = [("openai/gpt-6-luna", 0.1, 0.5), ("openai/gpt-6.1-sol", 2, 10)]
SYSTEM = "Use the tools to answer; never guess numbers. Finish with one line: FINAL: {json}."


def call_data_api(model: str, params: dict) -> dict:
    """Call a SandBase data endpoint and return outputs[0].data, failing loudly otherwise."""
    resp = requests.post(f"{BASE}/api/{model}", headers=HEADERS, json=params, timeout=120)
    resp.raise_for_status()
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def douyin_video_stats(sec_user_id: str) -> dict:
    """First page of an account's videos, with the aggregates computed here, not by the model."""
    data = call_data_api("douyin/app-v3/user-post-videos",
                         {"sec_user_id": sec_user_id, "max_cursor": 0, "count": 20})
    likes = [(item.get("statistics") or {}).get("digg_count") or 0  # observed field names
             for item in data.get("aweme_list") or []]
    if not likes:
        return {"videos": 0, "found": False}
    return {"videos": len(likes), "likes_sum": sum(likes), "likes_mean_floor": sum(likes) // len(likes)}


TOOLS = [{"type": "function", "function": {
    "name": "douyin_video_stats",
    "description": "Like statistics for the first page (up to 20) of a Douyin account's videos.",
    "parameters": {"type": "object", "properties": {"sec_user_id": {"type": "string"}},
                   "required": ["sec_user_id"]}}}]


def run(model: str, task: str, max_tokens: int = 1500) -> tuple[dict, list[int]]:
    """One agent run. Returns (parsed FINAL json, [prompt_tokens, completion_tokens]); raises on failure."""
    messages = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": task}]
    usage = [0, 0]
    for _ in range(6):
        resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS, timeout=240,
                             json={"model": model, "max_tokens": max_tokens,
                                   "tools": TOOLS, "messages": messages})
        resp.raise_for_status()
        body = resp.json()
        usage[0] += body["usage"]["prompt_tokens"]
        usage[1] += body["usage"]["completion_tokens"]
        choice = body["choices"][0]
        msg = choice["message"]
        messages.append({k: v for k, v in msg.items() if k in ("role", "content", "tool_calls")})
        if choice.get("finish_reason") == "length":
            raise RuntimeError(f"output cut at max_tokens={max_tokens}")
        calls = msg.get("tool_calls") or []
        if not calls:
            found = re.search(r"FINAL:\s*(\{.*\})", msg.get("content") or "", re.S)
            if not found:
                raise RuntimeError("no FINAL line")
            return json.loads(found.group(1)), usage  # JSONDecodeError also triggers the fallback
        for call in calls:
            args = json.loads(call["function"].get("arguments") or "{}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": json.dumps(douyin_video_stats(**args))})
    raise RuntimeError("turn limit reached")


def run_with_fallback(task: str) -> dict:
    """Try each tier in order; move to the next one only when a run fails outright."""
    for model, price_in, price_out in TIERS:
        try:
            answer, (tok_in, tok_out) = run(model, task)
        except (RuntimeError, ValueError, requests.RequestException) as err:
            print(f"{model} failed: {err}; trying next tier")
            continue
        cost = tok_in / 1e6 * price_in + tok_out / 1e6 * price_out
        return {"model": model, "answer": answer, "tokens": [tok_in, tok_out], "cost_usd": round(cost, 6)}
    raise RuntimeError("all tiers failed")


if __name__ == "__main__":
    task = ("For the Douyin account with sec_user_id "
            "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4, what is the average like count "
            "on the first page, rounded down? Keys: videos, average_likes.")
    print(json.dumps(run_with_fallback(task), ensure_ascii=False))
实测记录(2026-10-03,UTC)。 我们在 13:29 UTC 原样运行了上面的程序。输入是 T2、T5、T7 用过的人民日报抖音公开账号。数据请求:POST https://api.sandbase.ai/v1/api/douyin/app-v3/user-post-videos,请求体 {"sec_user_id": "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4", "max_cursor": 0, "count": 20}。这次运行的返回节选:
{"id": "82db1811-8b65-4d7d-a5cb-3f0e323a7edf", "status": "completed",
 "model": "douyin/app-v3/user-post-videos",
 "outputs": [{"data": {"aweme_list": [
   {"aweme_id": "7692418769125199138", "statistics": {"digg_count": 6413}},
   {"aweme_id": "7692417622113111323", "statistics": {"digg_count": 2743}}],
  "has_more": 1}}]}
只展示 aweme_list 20 条中的前 2 条;每条只保留 aweme_id 和 statistics.digg_count,条目、data 和外层返回的其他键都已省略。外层结构(id、status、model、outputs[0].data)有文档说明;aweme_list、aweme_id、statistics.digg_count、has_more 是我们在这次返回里观察到的字段名,不是文档字段。
GPT-6 Luna 调了一次工具,第二轮给出 FINAL: {"videos":20,"average_likes":397485}。程序输出:
{"model": "openai/gpt-6-luna", "answer": {"videos": 20, "average_likes": 397485}, "tokens": [403, 102], "cost_usd": 9.1e-05}这次兜底没有触发,所以没有走到 Sol 分支。GET /v1/tasks/<id>/cost 显示两次 Luna 调用(task id 3224d47a-8ffc-4c28-8b34-ac450818d8b9 和 216bfcea-3c0f-4875-8ed7-2027f5dc4e73)分别计费 $0.000045 和 $0.000047,与 token 用量 × 标价一致;数据接口调用计费 $0.000000。这个接口和 GET /v1/models/<id> 都需要同一个 Authorization: Bearer Key;没有 Key 的话,可以在 sandbase.ai 的公开模型页面看到同样的价格。平均值和测试里的 422,764 不同,因为这是缓存录制几小时后的线上调用,账号期间又发了新视频:线上第一页最前面的视频不在缓存那一页里。
想改成自己的版本,这个接口的请求字段见 抖音 user-post-videos API 文档,同一个 Key 也能调用上面 22 个模型。获取 SandBase API Key,用你自己的题集跑一遍。
数据边界:这些都是公开、只读的查询,需要 SandBase API Key。SandBase 不是抖音、微博或小红书的官方合作方,本文不涉及私密账号、私信、账号后台数据或任何账号操作。
常见问题
Agent 用哪个便宜模型够用?
在这套题上是 GPT-6 Luna:51/51,单任务中位数 $0.00035。MiMo v2.6 Flash(50/51,$0.00060)和 GLM-5.3 FlashX(50/51,$0.0018)紧随其后。Qwen3.7 Flash 的 token 单价更低,但 51 次错了 13 次,多数是输出预算用完。
GPT-6 Luna 和 GPT-6.1 Sol,Agent 该用哪个?
两者都是 51/51,输入中位数相同(2,887 token)。Sol 单任务 $0.0069,Luna $0.00035;耗时中位数 Luna 略快(7.6 秒对 9.5 秒,两者在不同时段测得)。建议 Luna 做默认、Sol 做兜底,切生产流量之前先用你自己的任务重跑一遍。
GPT-6.1 Sol Pro 比 Sol 值吗?
在短工具任务上不值。两者都是 51/51,单价相同,但 Sol Pro 的输入 token 约是 3 倍(中位数 9,026 对 2,887),单任务贵 3.1 倍。它可能面向的长链路高难推理,我们没有测。
Flash 和 Pro 用在 Agent 上,Pro 档有用吗?
6 家里有 2 家有用。Claude Opus 5.5 把 Sonnet 5.5 的 7 次心算错误全部修正(51/51 对 44/51),Qwen3.8 Max Prime 避开了 Qwen3.7 Flash 的截断(51 对 38)。OpenAI、小米、智谱三家,更便宜的档位追平甚至超过了最高档。
Qwen3.7 Flash 为什么分这么低?
13 次失误里有 10 次是写演算过程写到 1,500 token 上限被截断。它的单任务输出中位数是 949 token,是 Luna(139)的 6 倍多。放大输出预算也许能救回一部分,但我们没有重跑。
局限
只测了一类任务(中文社媒数据查询 + 统计):17 道计分题,每题 3 次,默认参数,每轮 1,500 token 上限,不开 prompt 缓存。Pro 和 Max 档可能在长链路推理、写代码或长文档上物有所值,这些都没测。两批模型在不同时段跑同一份缓存,跨批次的延迟只能粗看。成本是 token 用量 × 标价,不是实际账单,而且有两个模型在我们查看时正在打折。1,122 次计分运行里只有 48 次失误,分数差一两分的模型谈不上排名高低。更适合把它当成一种方法:照你的真实流量写 20 道题,每个档位跑 3 次,选能通过的最便宜那一档。