Gemini 4 Argon 发布反响:264 个 X 视频的数据复盘
Gemini 4 Argon 发布反响到底如何?用 264 个 X 视频、209 位作者、24 小时 371 万播放的数据,拆解点赞长尾、内容类型、模型对比帖与单发帖的差异、发帖时间和样本偏差。
先说一个反直觉的数字:我们收录的 Gemini 4 Argon 发布视频里,一半的帖子点赞不超过 21 个,而点赞最多的 10 条帖子拿走了全部点赞的 54%。如果你对这次发布的印象来自时间线,那你看到的只是一条极陡曲线的顶端。
这篇文章复盘 Gemini 4 Argon 发布反响:10 月 13 日正式开放(GA)后的头 24 小时里,X 上 209 位作者发布的 264 个视频,总播放约 371 万,数据全部来自 SandBase Lab 的 Argon 视频合集。适合想弄清楚“发布周到底说明了什么”的开发者、DevRel 和产品同学:大家做了什么、什么帖子被看见、多少是模型对比擂台,以及这些对判断模型本身有多大参考价值。
先说结论
- 关注度高度集中:中位数帖子 21 个赞、1,753 次播放,前 10 条帖子占了 54.3% 的点赞和 59.5% 的播放。
- 3D 场景(105 条)和动效(75 条)合计占 68%,游戏 48 条排第三。
- 按我们的文本规则,264 条里有 90 条(34%)是同屏对比帖,其中 68 条对手是 Claude Opus 5.5。对比帖点赞中位数 35,单发帖 17.5;但对比帖每千次播放的点赞更低,而且差距大小取决于“对比”怎么定义。
- 分享提示词没有带来可测量的差别:有提示词中位数 25,没有的 20,置换检验 p = 0.46。
- 时间点的影响压过一切:前 8 小时发的帖子拿走了 85% 的点赞。
数据从哪来
SandBase Lab 从 X 上筛选展示 Gemini 4 Argon 作品的公开帖子,整理成画廊和一份 JSON 数据文件。本文用的是 2026-10-14 16:29:53 UTC 同步的那一版。每条记录包括帖子链接、作者、正文、发布时间、点赞、转发、播放、视频时长、策展方标注的分类,以及一个 prompt_shared 标记。
帖子时间从 2026-10-13 16:00:02 UTC 到 2026-10-14 16:27:53 UTC。也就是说,“13 日和 14 日两天”其实是从发布那个整点开始的一个 24.5 小时窗口。Google 官方博客写明,Argon 当天在 Gemini API、AI Studio、Antigravity 和 Gemini App 全面开放。
Lab 画廊就是这份数据集的公开入口:策展的 X 公开帖子,更新于 2026 年 10 月 14 日(截图于 2026-10-15)。画廊每位作者只展示一张卡片,但背后的数据文件收了全部 264 条,其中 39 位作者发了不止一条。
下面所有数字都来自同一个确定性的 Python 脚本(只用标准库),脚本和完整输出随本文的审稿记录一起保存。总量:36,870 个赞、3,705,816 次播放、2,167 次转发。语言上英文 218 条,中文 27 条,日文 11 条,土耳其语等其余 6 种语言共 8 条。
Gemini 4 Argon 发布反响:一条长尾
平均每条帖子 139.7 个赞,中位数却只有 21。差距本身就是结论。
| 每帖点赞 | 帖子数 | 占帖子比例 | 占全部点赞比例 |
|---|---|---|---|
| 0–9 | 78 | 29.5% | 1.1% |
| 10–49 | 106 | 40.2% | 7.1% |
| 50–99 | 22 | 8.3% | 4.2% |
| 100–499 | 43 | 16.3% | 26.2% |
| 500–999 | 8 | 3.0% | 12.8% |
| 1,000+ | 7 | 2.7% | 48.6% |
点赞过千的 7 条帖子拿了将近一半。第一名 @fofrAI 的傅里叶圆鹈鹕(4,600 赞、478,424 播放)一条就占 12.5%。前 10% 的帖子(26 条)占 71.9%,后一半帖子加起来只有 3.3%。
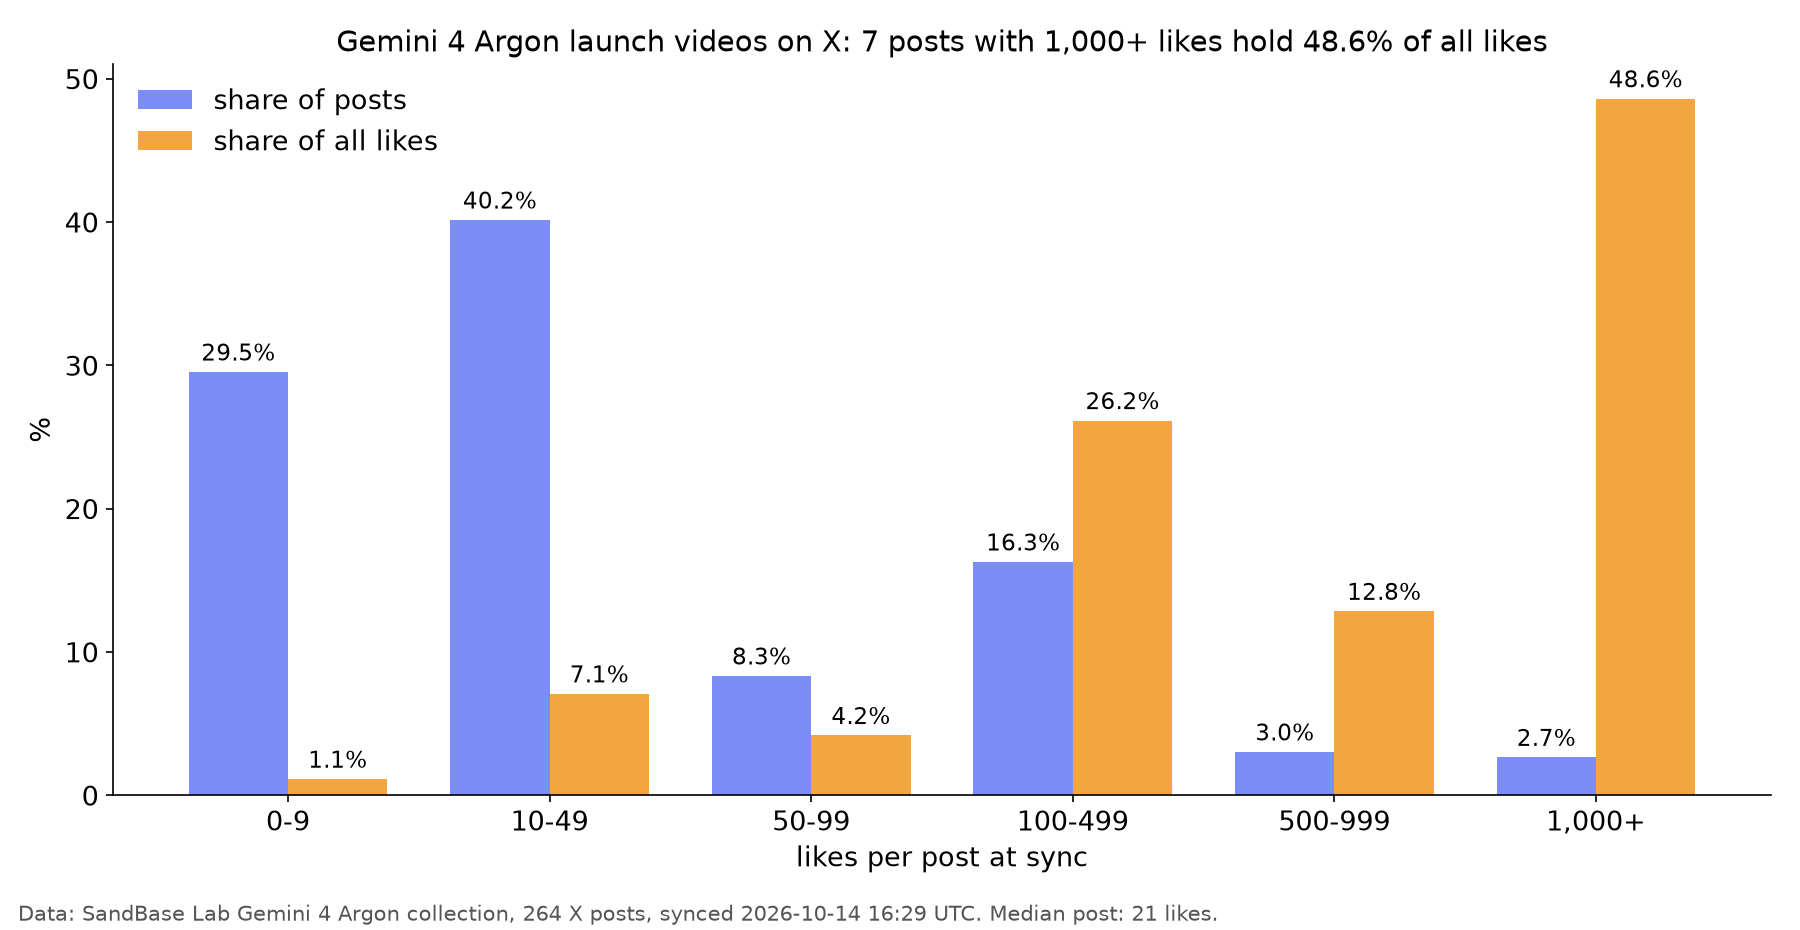
我们用 Lab 数据文件画的图:将近 70% 的帖子点赞不到 50,合计只拿到 8.2% 的点赞;点赞过 500 的 15 条帖子拿走 61.4%。数据为 2026-10-14 同步版,用 matplotlib 绘制。
播放量也是同样的形状:中位数 1,753,第 90 百分位 23,611,第 99 百分位 252,593。
说白了,发 Argon 作品的是几百个人,真正被大多数人刷到的只有十来条。如果你是从时间线判断这个模型,你判断的依据就是这十来条,它们整理在最受欢迎的 20 个作品里。
大家做了什么:内容类型
分类由策展方标注,每条一个。
| 分类 | 帖子数 | 占比 | 点赞中位数 | 播放中位数 | 每千次播放点赞 | 占全部点赞 |
|---|---|---|---|---|---|---|
| 3d-scene | 105 | 39.8% | 27 | 1,700 | 13.4 | 36.3% |
| motion-graphics | 75 | 28.4% | 17 | 1,955 | 11.6 | 29.6% |
| game | 48 | 18.2% | 20 | 1,571 | 13.5 | 13.7% |
| explainer | 13 | 4.9% | 21 | 1,128 | 21.6 | 8.3% |
| ui-demo | 11 | 4.2% | 21 | 1,737 | 19.3 | 3.3% |
| particles | 5 | 1.9% | 12 | 2,009 | 16.3 | 7.1% |
| data-viz | 4 | 1.5% | 11.5 | 1,325 | 12.8 | 0.2% |
| launch-film | 2 | 0.8% | 217 | 9,818 | 18.2 | 1.2% |
| kinetic-type | 1 | 0.4% | 100 | 6,152 | 16.3 | 0.3% |
第一,几乎全是“视觉代码”:Three.js 场景、SVG 和 canvas 动画、浏览器游戏。这和 Google 说的内部用法一致(复杂 3D 可视化、高保真游戏、原生代码写的交互动画),也恰好是最适合剪成 30 秒短视频的东西。知识类工作几乎没人发,表格在 X 上传播不起来,可那恰恰是 Artificial Analysis 给 Argon 排名最靠前的领域(Legal 指数在 208 个有分数的条目里排第 5,v4.3,数据截至 2026-10-12)。这部分看排行榜那篇。
第二,各分类的中位数其实差不多。3D 场景略高,为 27;particles 和 data-viz 只有 5 条和 4 条,中位数没什么意义。particles 占 7.1% 的点赞,几乎全靠一条:@kickingkeys 的代码绘画,2,335 个赞。样本这么小,一条爆款就能决定整个分类。
对比帖 vs 单发帖
发布周很大一部分内容是擂台:同一个提示词,一边 Argon,一边别的模型。要给这件事一个数字,就得先把规则写下来,不能凭感觉。
识别规则。 帖子正文同时满足两条就算“对比帖”:(1)点名至少一个 Argon 以外的模型(Opus、Claude、GPT-6、Astra、Sol、Muse Wonder、Kimi、Grok、旧版 Gemini 等);(2)出现正面对比的信号词:vs、versus、compare、same prompt/task/scene、exact same、side by side、head-to-head、next to、Left:/Right:、“N models”、“Argon and Opus”,以及土耳其语、波斯语、中文、日文里的对应说法(比如“对比”“同一个 Prompt”“比較”)。只点名对手、没有对比信号的算“提及对手”,其余算“单发”。
规则跑完后,我把所有被标记的帖子和边界情况逐条读了一遍,做了 12 处有记录的人工修正。比如 @NovaXCode 写了“it’s so over for opus and astra”(259 赞),点了两个对手,但视频里只有 Argon,所以不算;@jaimintf 没点任何对手的名字,但说 Argon 是“fastest of all (same prompt)”,Lab 封面帧里也是三个模型同框,所以算。这条规则只读文字,如果一个分屏视频的配文没提对手,它就看不见。
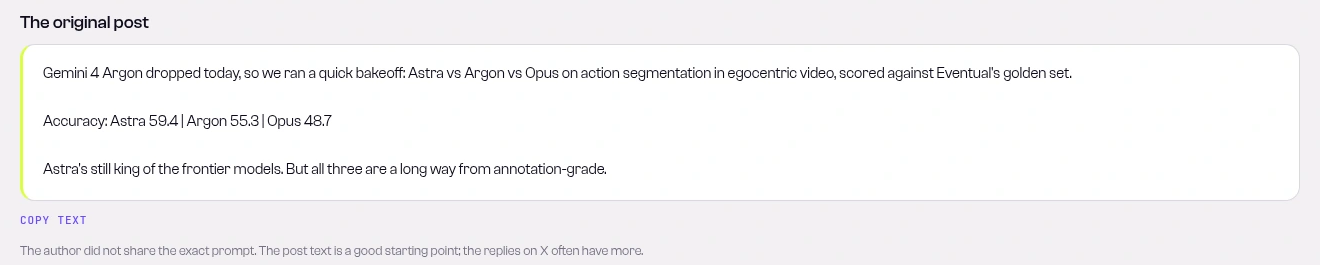
Lab 详情页保留了完整原帖正文,对比规则读的就是这段文字。这条来自 @Sammy_Sidhu,因为出现“vs”并点名 Astra 和 Opus 被识别为对比帖(截图于 2026-10-15)。它是少数有打分任务的对比,Argon 排第二。
| 帖子类型 | 帖子数 | 占比 | 点赞中位数 | 播放中位数 | 每千次播放点赞 | 占全部点赞 |
|---|---|---|---|---|---|---|
| 单发 | 146 | 55.3% | 17.5 | 1,532 | 15.5 | 48.8% |
| 对比 | 90 | 34.1% | 35 | 2,360 | 11.6 | 47.9% |
| 提及对手 | 28 | 10.6% | 20.5 | 1,624 | 11.7 | 3.3% |
大约三分之一的发布视频是擂台,拿走了差不多一半的点赞。点赞前 10 里有 7 条是对比帖,打头的是 @semichenkko 的小熊软糖物理测试,543,457 次播放,整个合集播放最高。90 条对比帖里 68 条(76%)点名 Opus 5.5,29 条点名 GPT-6 系列,13 条点名 Muse Wonder;有 20 条同时拉了两家以上的对手。
对比帖的点赞中位数更高(35 对 17.5,中位数置换检验 p = 0.017),播放也更多,但每千次播放的点赞更低(11.6 对 15.5)。我的理解是:带“vs”的标题会吸引来看热闹的人,看完不一定点赞。对比视频也更短(中位数 24.6 秒对 35.0 秒),报成本的比例是单发帖的三倍(32% 对 10%)。
引用这个 35 之前,有两点要先讲清楚。一是结果对定义很敏感。早一版更宽松的规则(把“better than”“beat”“against”和任何点名两个对手的帖子都算进去)标出了 104 条,中位数 27,差异不显著(p = 0.12)。二是和时间混在一起。同步时已发布超过 12 小时的帖子里,对比帖领先 49.5 对 25(p = 0.026);更新的帖子里只有 16.5 对 12(p = 0.42)。所以“对比帖更吸引关注”只能说大概率成立,还谈不上定论。
为什么这些对比不能当跑分看
每个视频都是一位作者给每个模型跑一次,用的是他手边的工具(Antigravity、Devin、聊天窗口),由发帖人自己判输赢。推理强度、重试次数、有没有剪辑,基本都不交代。结论也是两边都有:软糖那条作者判 Opus 赢;@EnvolDev 的太空列车里 Argon 更快更便宜,但作者承认画面质量输了。
软糖这条还说明了一次实验能多快变成好几条帖子。大约 15 小时内,@mayaislam_ai 和 @jurlycat 先后转述了结论和 $7.20 对 $22 的成本(jurlycat 注明出自 semichenkko);接着 @MiaAI_lab 自己重跑了提示词,说原视频是“FAKE”,她跑出的 Argon 效果好得多,只是 Opus 仍略胜。四条帖子,背后是一次实验和两个互相矛盾的说法,我们一个都没验证。把它们当成四个数据点就错了。
真要做选型,看三模型对比那篇:同一组提示词通过同一个 API 跑三个模型,并记录了每个任务的成本。
分享提示词、视频时长有没有用
52 条帖子(19.7%)标了 prompt_shared,即提示词在正文或回复里。
| 帖子数 | 点赞中位数 | 播放中位数 | 占全部点赞 | |
|---|---|---|---|---|
| 分享了提示词 | 52 | 25 | 2,073 | 7.5% |
| 没分享 | 212 | 20 | 1,716 | 92.5% |
这点差距就是噪声(p = 0.46),而且分天看方向还会反过来:发布当天 37 对 40.5,第二天 16 对 14.5。点赞前 20 里只有一条分享了提示词。公开提示词是好习惯,但它换不来流量。这 52 条提示词的拆解在提示词指南。
| 视频时长 | 帖子数 | 点赞中位数 | 播放中位数 | 占全部点赞 |
|---|---|---|---|---|
| 15 秒以内 | 44 | 13 | 1,532 | 21.2% |
| 15–29 秒 | 84 | 29 | 2,142 | 26.4% |
| 30–59 秒 | 82 | 21 | 1,739 | 24.5% |
| 60–119 秒 | 46 | 20.5 | 1,560 | 26.3% |
| 120 秒以上 | 8 | 6.5 | 440 | 1.6% |
视频时长中位数正好 30 秒。15–29 秒这档中位数最高,特别短的偏低,但各档重叠很多,120 秒以上只有 8 条,每档的点赞占比又都被一两条爆款撑着。拿这个去调视频长度不靠谱。
什么时候发的(按 UTC 小时)
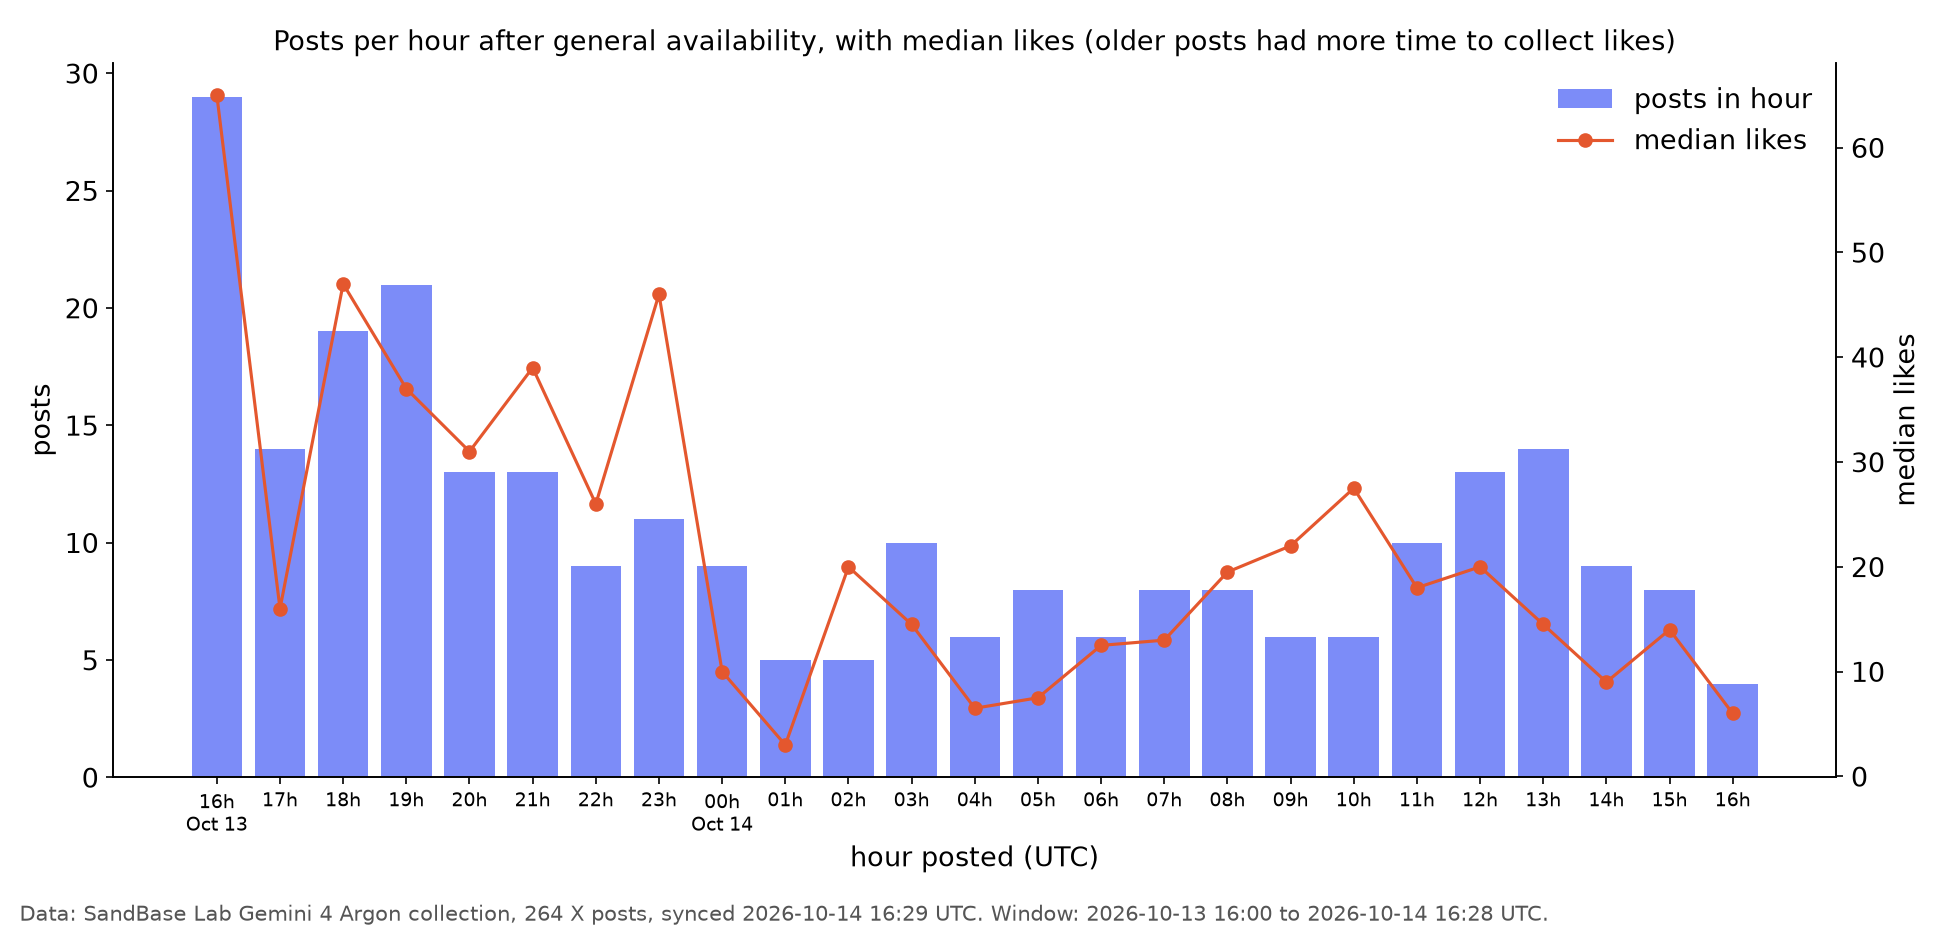
每个 UTC 小时的发帖数(柱)和点赞中位数(线),同一次同步的数据。GA 后第一个小时有 29 条,中位数 65 赞;到美洲深夜时段,每小时只剩 5 条,中位数降到个位数。
| 时段(UTC) | 帖子数 | 点赞中位数 |
|---|---|---|
| 10 月 13 日 16–19 点 | 83 | 41 |
| 10 月 13 日 20–23 点 | 46 | 35.5 |
| 10 月 14 日 0–3 点 | 29 | 12 |
| 10 月 14 日 4–7 点 | 28 | 8.5 |
| 10 月 14 日 8–11 点 | 30 | 19.5 |
| 10 月 14 日 12–15 点 | 44 | 16 |
| 10 月 14 日 16 点(至 16:28) | 4 | 6 |
16 点就是发布的那个小时。一小时冒出 29 条,说明很多作者手里早有现成作品,这和 Google 说的“9 月 30 日起先向 Fairwind 计划开放”对得上。前 4 个小时就发了 83 条,将近整个合集的三分之一。之后美国深夜发帖量下滑,欧洲和亚洲白天(UTC 8–13 点)回升,窗口在 UTC 16:28 收尾,也就是美东的中午。
别把这些中位数读成“最佳发帖时间”。点赞是在同一时刻冻结的:发布那个小时的帖子有 24 小时攒赞,15 点发的只有 90 分钟。同步时已发布超过 18 小时的帖子中位数 39 赞,不到 6 小时的只有 15。前 8 小时的 129 条帖子占了 85% 的点赞,这里面既有先发优势,也有曝光时间更长的因素,这份数据分不开两者。
方法和样本偏差
- 是策展,不是普查。 帖子由 SandBase 从 X 上挑选。没被搜到的帖子、私密账号、没有视频的作品都不在里面;而“用 Argon 做的作品”这个筛选标准,本身就偏向看起来惊艳的视频。
- 只有一个快照。 点赞和播放冻结在 2026-10-14 16:29 UTC,之后已经变了,越晚发的帖子低估得越多。
- 分类是策展方标的。 每条只有一个标签,一个 3D 游戏既可能标 3d-scene,也可能标 game。
- 作者说法未经验证。 “Argon 做的”、耗时、额度和花费都是作者自述。我们没有复现任何一个,软糖那场争议说明这些说法本身就可能互相冲突。
- 对比都是单次运行。 它只告诉你某个人在某个工具里看到过一次什么结果。
- 小样本。 好几个中位数背后不到 15 条帖子。p 值来自 10,000 次重排的中位数置换检验,没有做多重比较校正。
awesome-gemini4-argon 仓库同步的是同一个合集,徽章上的 264 个视频、52 个提示词和本文用的数据一致(截图于 2026-10-15)。视频和提示词版权归原作者。
发布周能说明什么
发布周说明了三件事:大家拿到 Argon 首先用它写视觉代码;三分之一的人马上把它和 Opus 5.5 或 GPT-6 Astra 放在一起比;少数几条早期帖子决定了公众印象。它没有说明 Argon 到底比这些模型强还是弱。要回答这个问题得做受控测试,这也是系列里其他几篇各自动手跑的原因:单文件 Three.js 场景、带输入测试的一句话浏览器游戏,还有前面提到的三模型对比。
想自己复现其中某个作品,可以看 SandBase 上的 Gemini 4 Argon 模型页:输入 $4、输出 $20 每百万 token,1M 上下文,单次响应最多输出 65.5K。这是 Google 11 月 30 日之后的标准价,是 Google 直连首发优惠价 $2 / $10 的两倍,具体差别见价格指南。每个 Lab 详情页都有“Try this prompt”面板,直接跑在 google/gemini-4-argon 上。GA 之前的背景信息见我们早先的 Argon API 接入笔记。
常见问题
Gemini 4 Argon 发布后 X 上反响怎么样?
在 SandBase Lab 的合集里,GA 后 24 小时内有 209 位作者发了 264 个视频,以 3D 场景、动效和游戏为主。大约三分之一是同屏对比,对手多是 Claude Opus 5.5,输赢两边都有。
这些发布视频一共有多少播放?
截至 2026-10-14 同步,总播放约 371 万,点赞 36,870。中位数帖子 1,753 次播放、21 个赞;前 10 条帖子拿走了 59.5% 的播放。
对比视频能证明 Argon 比 Opus 5.5 强或弱吗?
不能。每个都是每个模型跑一次、设置不明、发帖人自己判断,有些还是转述别人的结果。把它们当成自己做测试的线索就好。
分享提示词能多拿赞吗?
看不出来。分享提示词的帖子中位数 25 赞,没分享的 20 赞,这个差距完全可能是偶然(p = 0.46)。