模型介绍
Gemini 4 Carbon:网络安全、编程能力、价格与开放时间
Gemini 4 Carbon 是 Google 面向长周期编程与网络防御的新旗舰模型。本文拆解基准、价格、开放状态,以及开发者现在是否值得等待。
阅读Gemini 4 Carbon 是 Google 面向长周期编程与网络防御的新旗舰模型。本文拆解基准、价格、开放状态,以及开发者现在是否值得等待。
阅读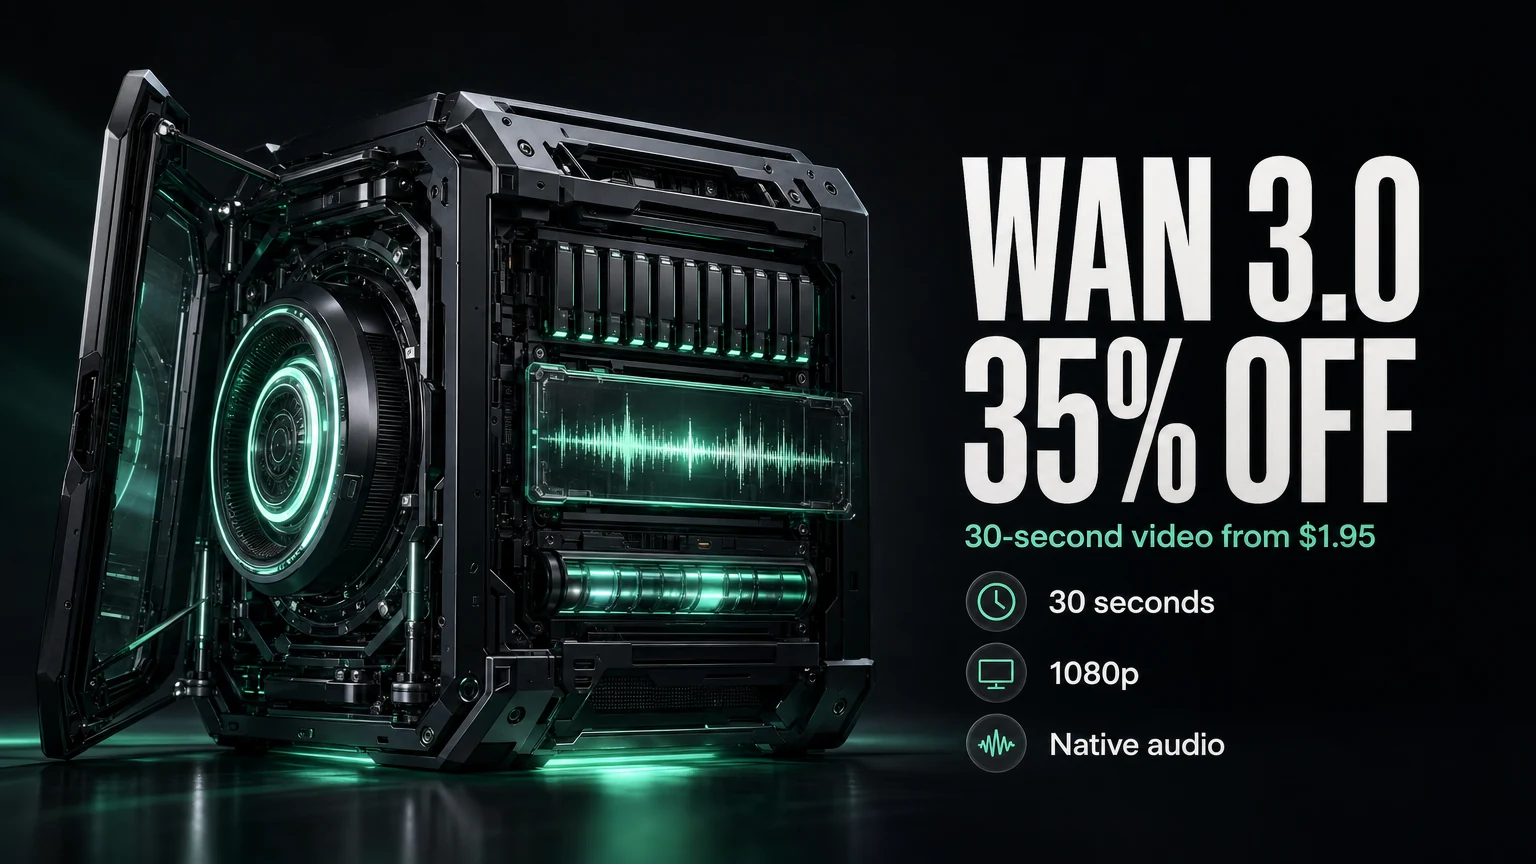
SandBase 上 Wan 3.0 正在打六五折。本文算清 5 秒与 30 秒真实价格,拆解模型能力、API 用法、实测表现和限制。
阅读
Claude Opus 5.5 API 详解:SandBase 当前 5 折后 $2/$10,1M 上下文、128K 输出、跑分、迁移坑与调用代码。
阅读
Claude Haiku 5.5 的阶梯价格、1M 上下文、自适应思考、官方跑分、API 调用与不该替代 Sonnet 的场景。
阅读
Jev 1.14 的类型化决策、$0.042/M 输入价格、概率输出、多语言更新、实验性图片能力与 SandBase decisions API。
阅读
Kimi K3.1 Pro 于 2026 年 10 月 23 日发布,API 每百万 token 输入 2 美元、输出 10 美元,权重承诺 11 月 4 日前开放。哪些已确认、网络安全数据过滤意味着什么,以及 reasoning_effort 实测花了多少钱。
阅读
可灵 Kling 4.0 API 使用指南:SandBase 上的文生视频、图生视频、参考生视频和视频编辑四个接口,按秒计费规则、实测账单与等待时间,以及目前 API 还没开放的功能。
阅读
MiniMax M3.1 Flash 详解:$0.15/$0.60 定价、1M 上下文、思考无法关闭、五档 effort 实测的 token 差异,以及官方跑分里它强在哪、弱在哪。
阅读
2026 年 10 月 17 日,DeepSeek-V4.1-Flash-1017 直接升级进 deepseek-flash:价格不变、跑分更高、输出更短。改了什么、哪里领先、哪里仍不如 Opus 5。
阅读
Gemini 4 Argon 用在法律、金融场景靠不靠谱?对照 Google 的 Vals、Harvey 自报成绩和 Artificial Analysis 领域指数,再看我们用文本、页面图片和 PDF 跑的贷款合同条款核查实测。
阅读
Nano Banana 2.1 已出现在 Google Flow 的报道和截图中,但 Google 尚未公布 API 模型 ID、价格或功能说明。本文区分已确认信息、传闻与现在能用的模型。
阅读
SandBase 解析 ChatGPT Images 2.5 图片编辑、Sketch 与 OpenAI API 价格,区分官方演示和后台版本未确认的两轮 ChatGPT 网页改价测试。
阅读
SandBase 记录 ChatGPT Images 2.5 网页版五轮水瓶编辑,附原始 PNG、纹理裁切和颜色取样;具体 API 后台型号未暴露。
阅读
DeepSeek V4.1 Flash 内测消息中的型号是什么,Harness 如何添加,费用、20 并发与多模态哪些尚未确认,以及当前可用的 V4 模型入口。
阅读
MazeBench 14% 的纪录,与 Fusion 360 建模、频谱识别、分子演示和 48 关游戏放在一起看:GPT-6 Astra 已能做什么,哪些结论还不能下。
阅读
旧模型帮助训练 GPT-6 Astra,是否等于递归自我改进?区分已披露事实与研究者判断,用训练数据过滤的示例说明还需要哪些实验记录,才能证明下一代模型确实变好。
阅读
SandBase 解读 Claude Fable 5.1 的编程表现、API 型号与缓存价格,用具体算例解释费用变化,并链接有真实账单的 Astra 同题实测。
阅读
基于腾讯混元 Hy4 preview 官方盲测数据,设计一套可复现的开源模型比较方法。
阅读
从代码仓库、长文档和跨文件任务出发,解释腾讯混元 Hy4 preview 的 1M 上下文应该如何评估。
阅读
拆解腾讯混元 Hy4 preview 发布稿中的分子动力学、量子输运和几何研究案例,以及如何独立复核。
阅读
用腾讯混元 Hy4 preview 的官方财务稽核案例,拆解跨文件检索、规则生效判断与企业交付的验收方法。
阅读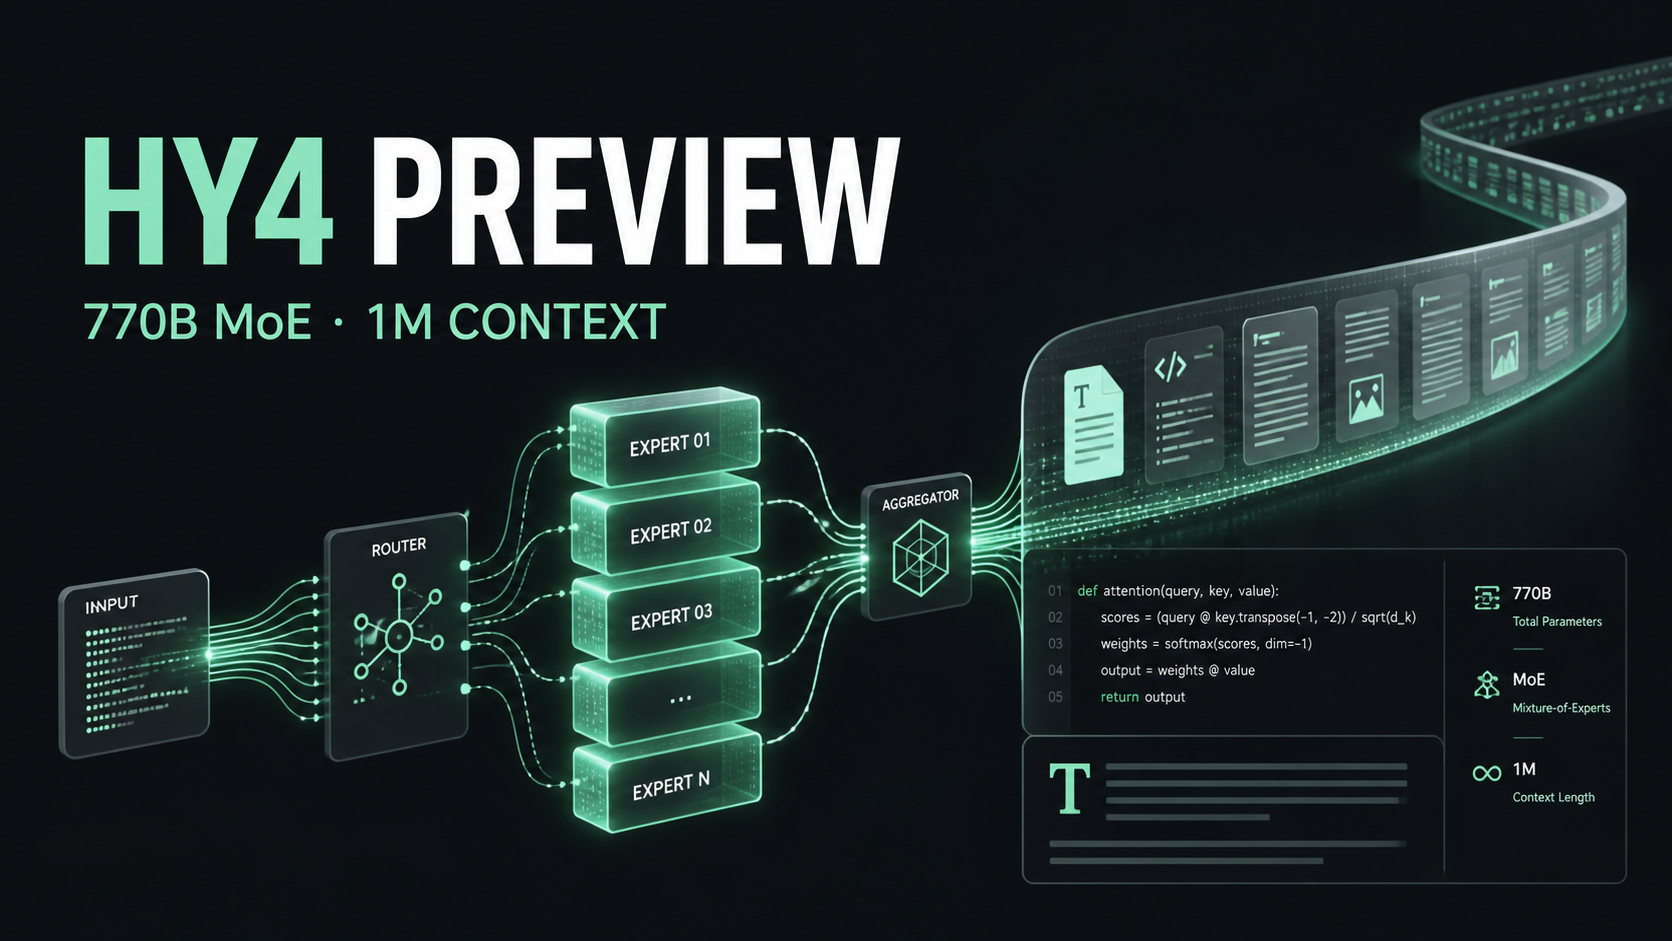
从长程编程、办公分析、游戏开发到科学研究,拆解腾讯混元 Hy4 preview 的官方发布信息与实际评测边界。
阅读
解释腾讯混元 Hy4 preview 发布稿中的递归自我改进、推理优化和 Codex 实验闭环。
阅读
When GLM-5.3-Flash multimodal and long context help agents. 中文指南。
阅读
How to interpret GLM-5.3-Flash coding-agent benchmark results. 中文指南。
阅读
Deploy GLM-5.3-Flash with Hugging Face, vLLM, and SGLang. 中文指南。
阅读
GLM-5.3-Flash token pricing and successful-workflow cost guide. 中文指南。
阅读
Compare GLM-5.3-Flash and DeepSeek for reliable agent economics. 中文指南。
阅读
用 SandBase 连接 X 发现、官方来源核验和 LLM 证据包,搭建一套不会把社交媒体帖子当成发布事实的模型追踪流程。
阅读从许可证、推理服务、评测、可观测性到回退路由,给出开放权重模型进入生产前的完整检查清单。
阅读
Gemini 3.7 Flash 以 $0.75/$3.75 每百万 token 发布,比 3.6 Flash 便宜一半。100万上下文、多模态、可调思维、强工具调用。
阅读
Meta Muse Glimmer 是 30B 密集多模态本地 Agent 模型。Apache-2.0,单张消费级 GPU 即可运行,本地调用工具、写代码。
阅读
GLM-5.3 发布时间与 API 价格评测:汇总官方编程和安全 benchmark、API 可用性、开源权重状态及 GLM-5.2 变化。
阅读
DeepSeek V4 Pro 0813 正式版上线,1.6万亿参数 MoE,490亿激活,100万上下文,定价仅为 Claude Fable 5 的2%。
阅读
Meta 发布 Muse Glimmer 30B 开放权重模型家族,专为笔记本电脑和消费级设备设计,将前沿 AI 能力带到端侧。
阅读
华为发布 openPangu-2.0-Pro——505B 参数 MoE 开源大模型,全程使用昇腾 910B NPU 训练。架构解析、算力主权意义、以及对性能声明的客观评估。
阅读
DeepSeek V4 Flash 0731 正式发布:Terminal-Bench 82.7、DeepSWE 54.4,9 项 Agent 基准全面超越 V4-Pro-Preview。284B/13B MoE 架构,1M 上下文,MIT 开源,$0.14/$0.28 每百万 token。
阅读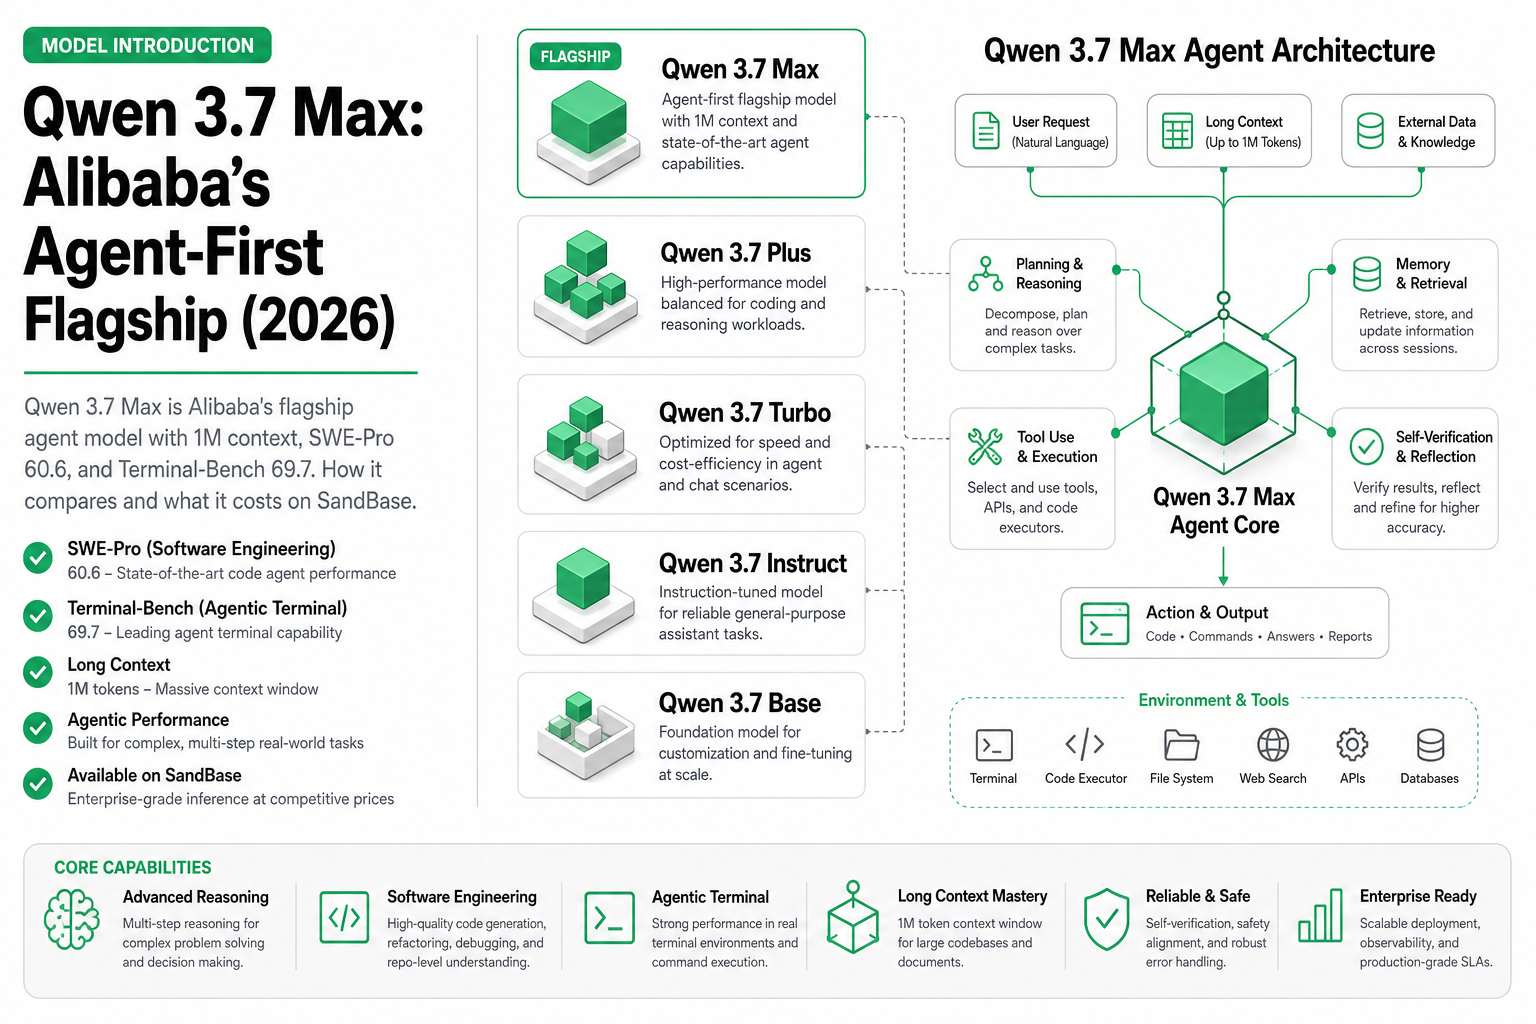
Qwen 3.7 Max 是阿里的 Agent 旗舰模型:1M 上下文、SWE-Pro 60.6、Terminal-Bench 69.7。性能追平西方前沿,价格只有 Claude Opus 的 1/20。本文详解 benchmark、定价与实战用法。
阅读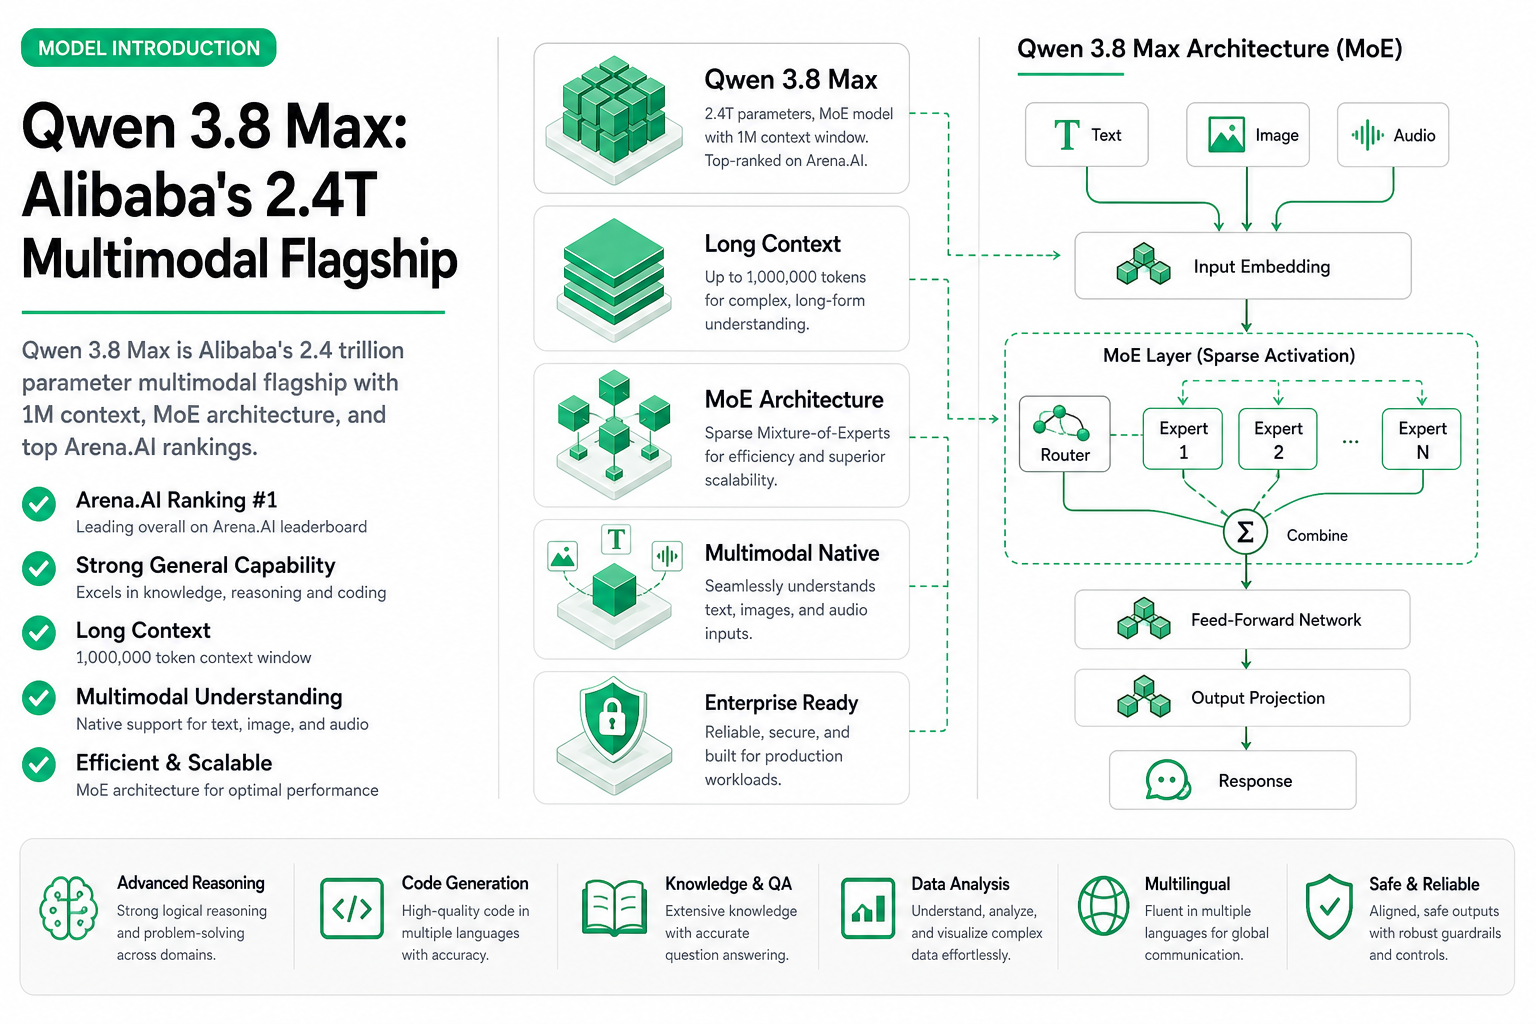
Qwen 3.8 Max 是阿里巴巴 2.4 万亿参数多模态旗舰模型,支持 1M 上下文、MoE 架构,Arena.AI 排名第二。本文详解规格、定价及 SandBase 接入方式。
阅读
Claude Opus 5 价格与评测:2026 年 1M 上下文、输入/输出每百万 Token 5/25 美元、API 限制、自适应思考与 Opus 对比 Sonnet。
阅读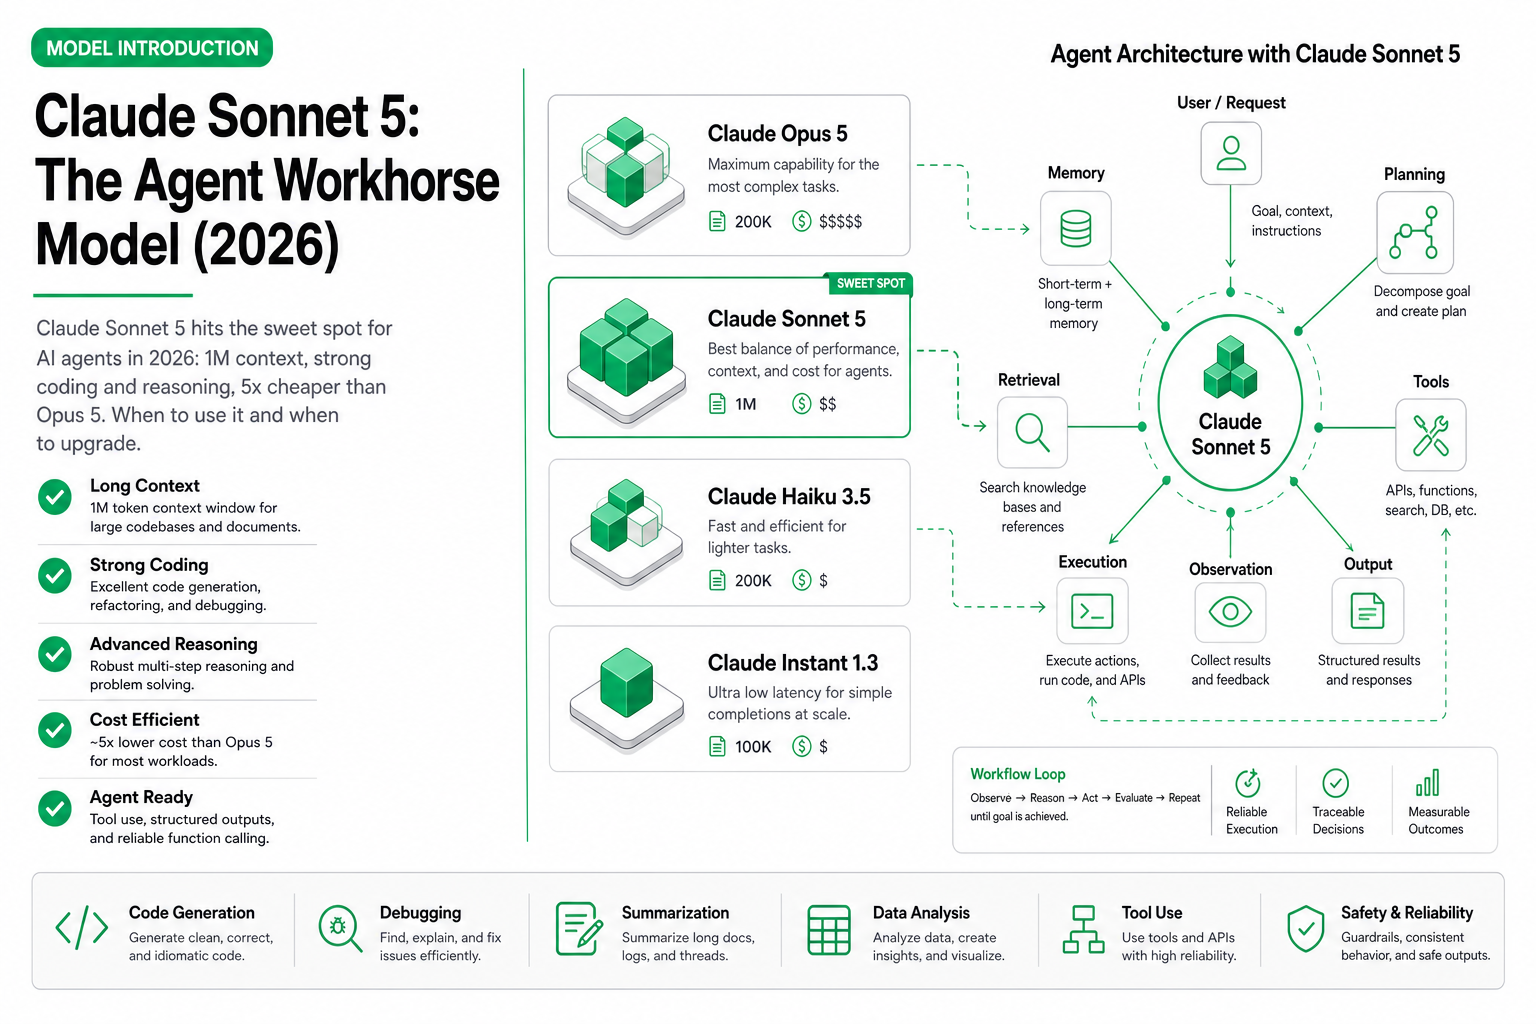
Claude Sonnet 5 是许多 2026 Agent 的实用起点:1M 上下文、强代码和推理能力,标价为每 MTok 输入/输出 2/10 美元。本文说明什么时候升级到 Opus 5。
阅读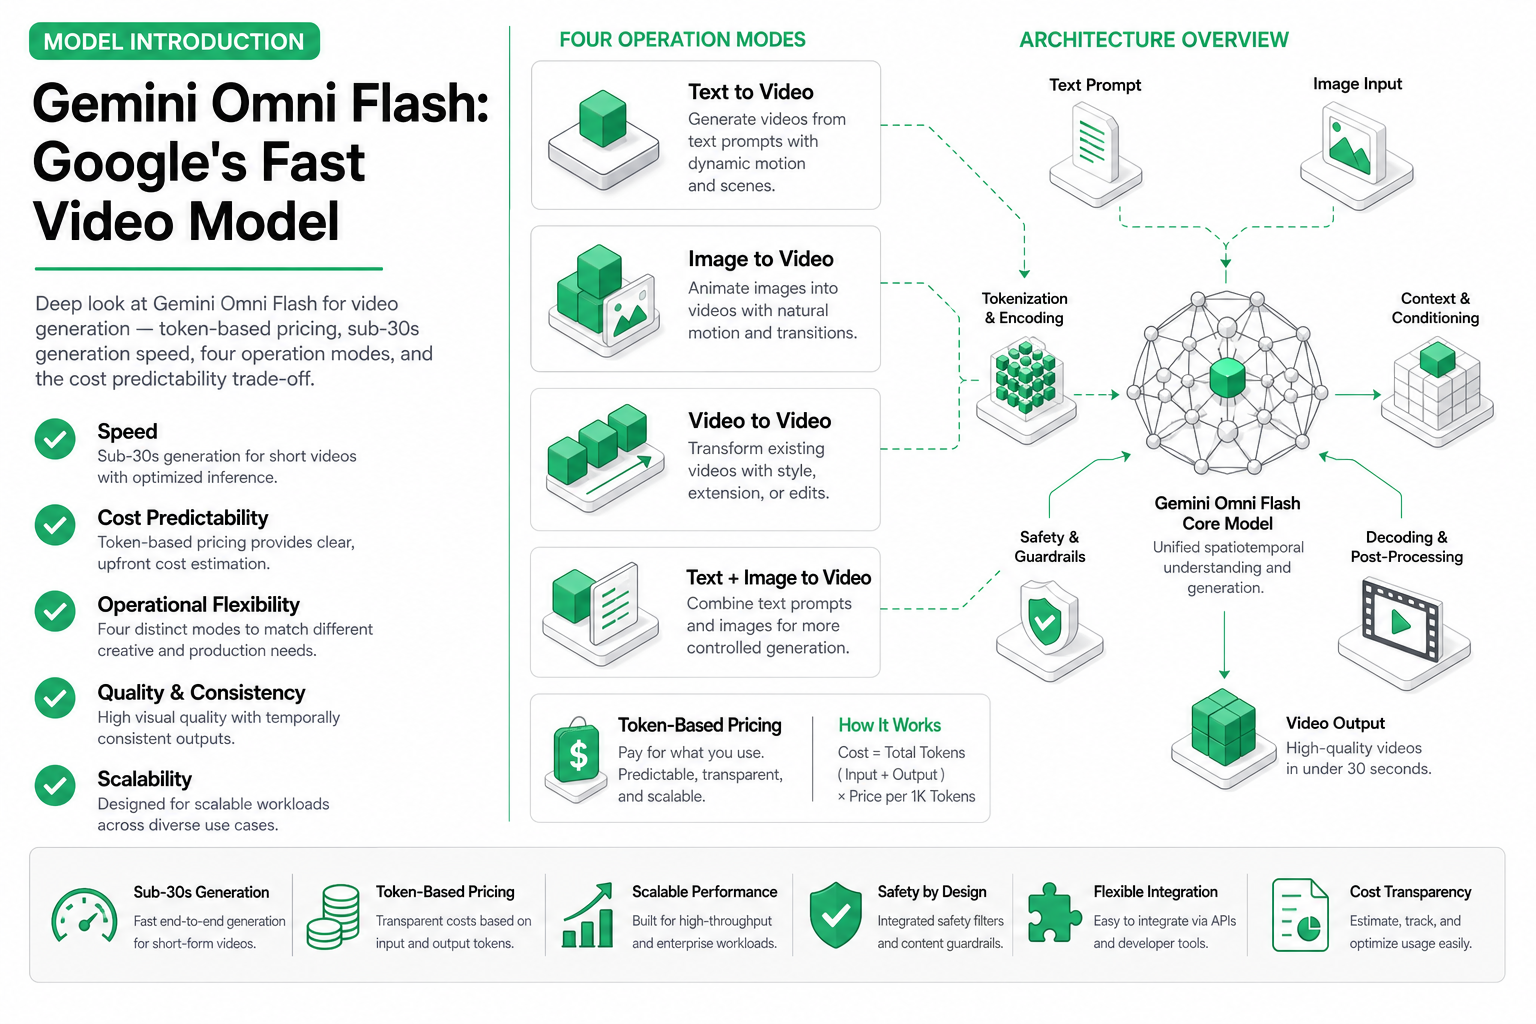
深度分析 Gemini Omni Flash 的视频生成能力——按 token 计费、30 秒内出片、四种操作模式,以及成本可预测性的取舍。
阅读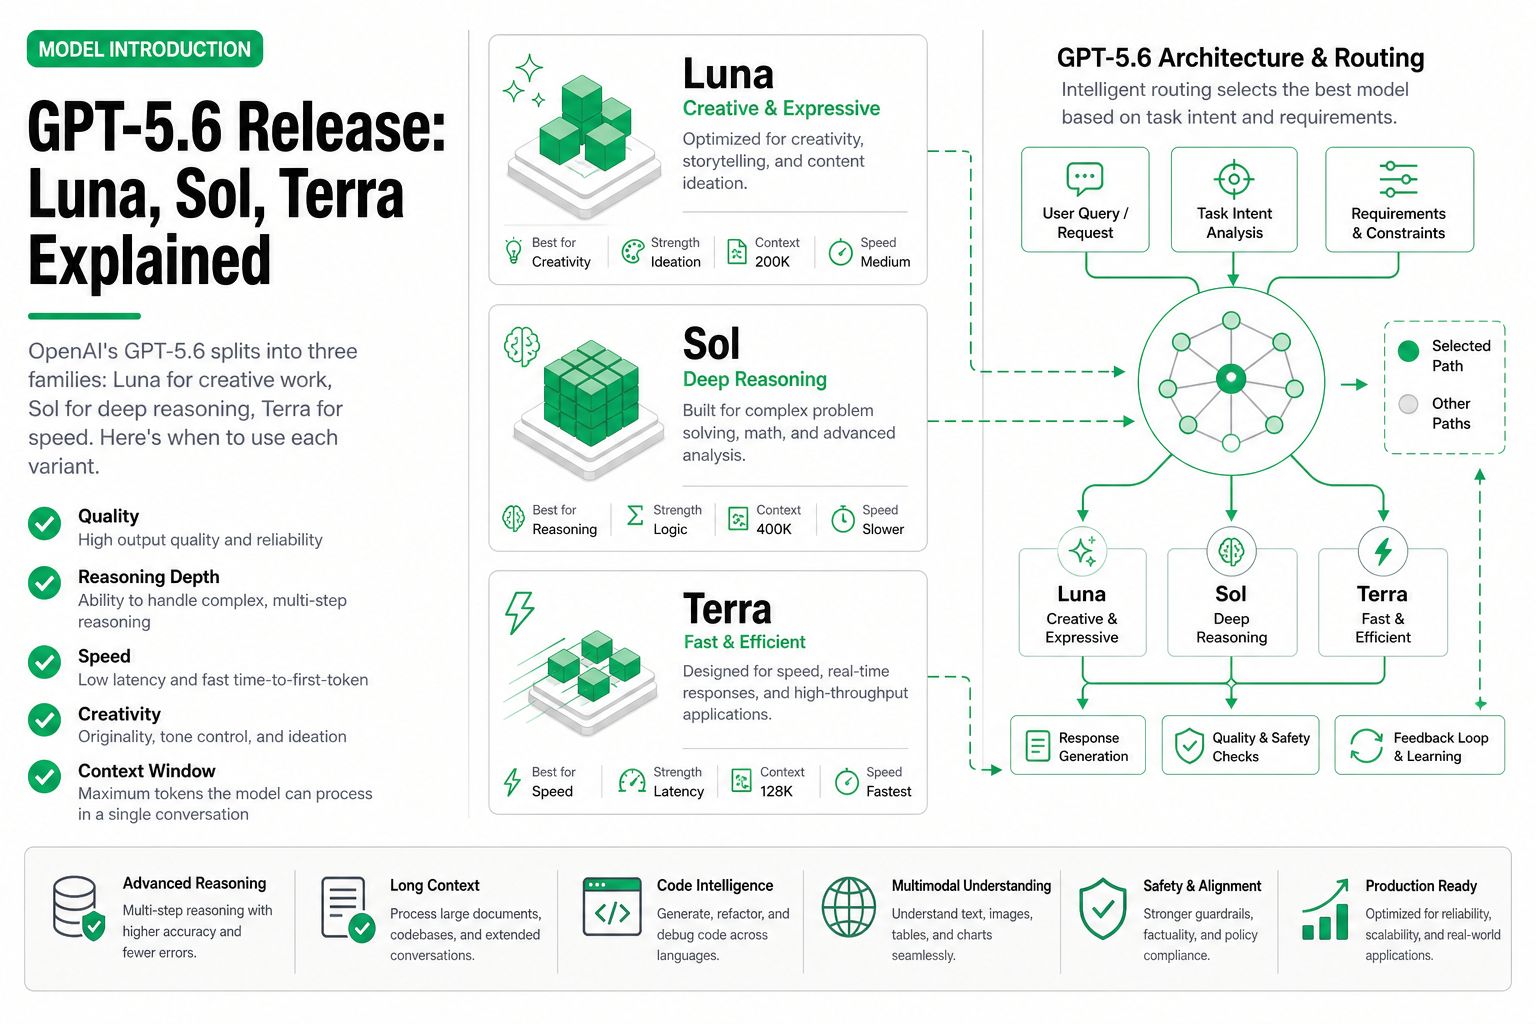
OpenAI 把 GPT-5.6 拆成三个家族:Luna 主创意、Sol 主推理(1.05M 上下文)、Terra 主速度。各变体适用场景全解。
阅读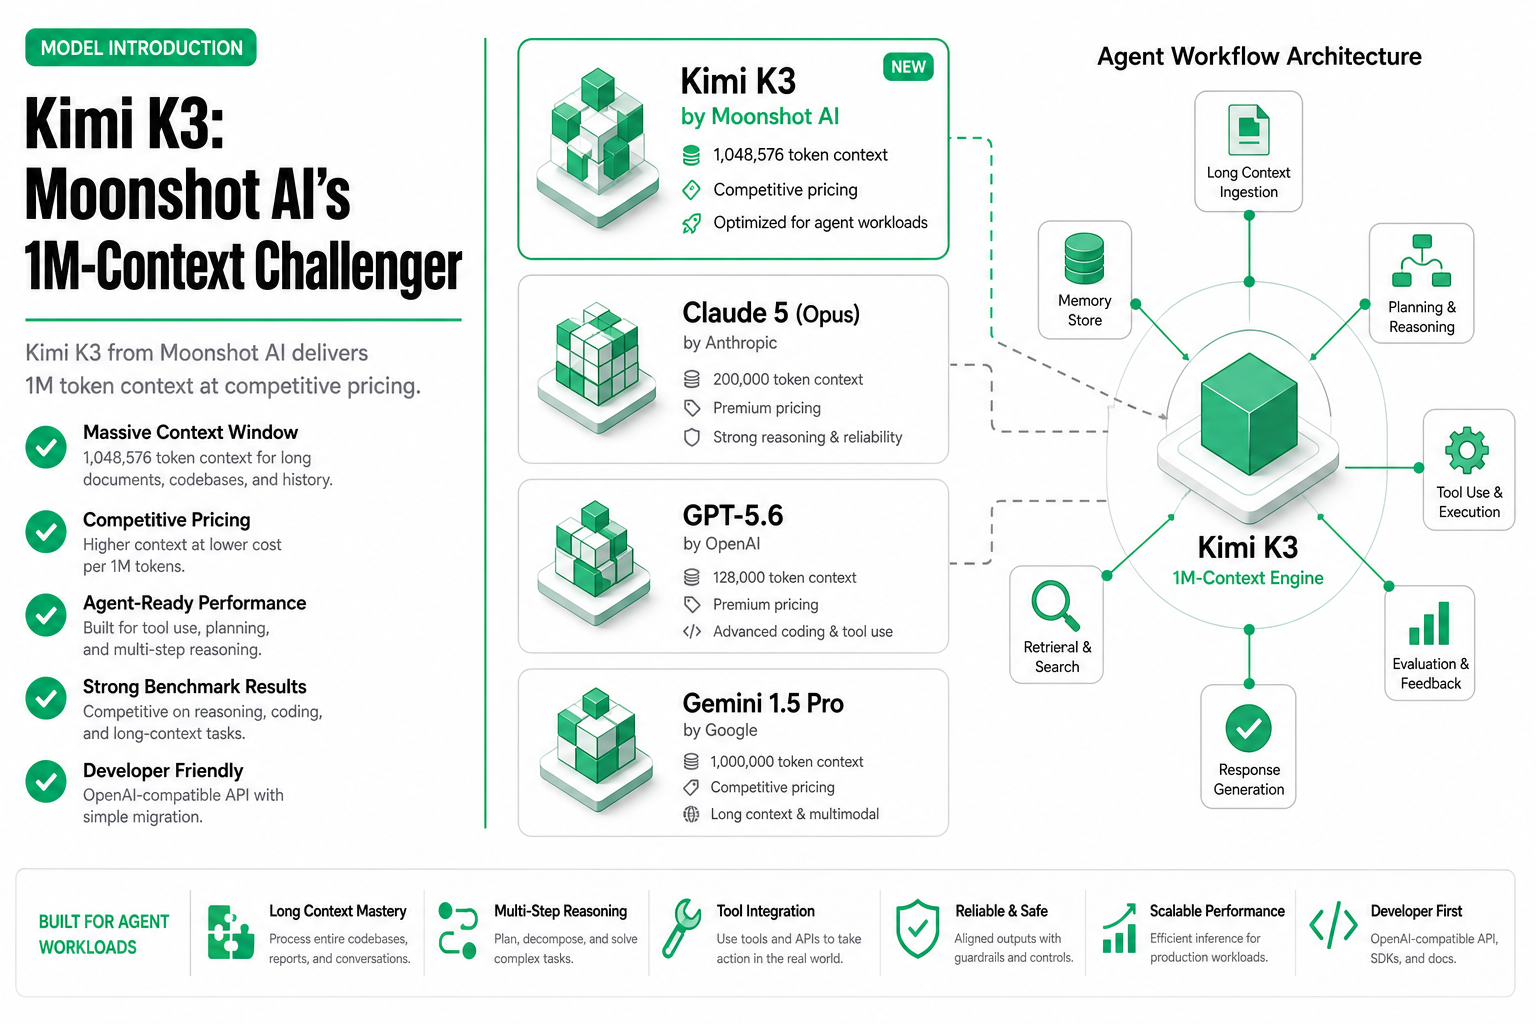
Kimi K3 来自月之暗面,1M token 上下文,定价远低于 Claude 5 和 GPT-5.6。Agent 工作负载的性价比之选。
阅读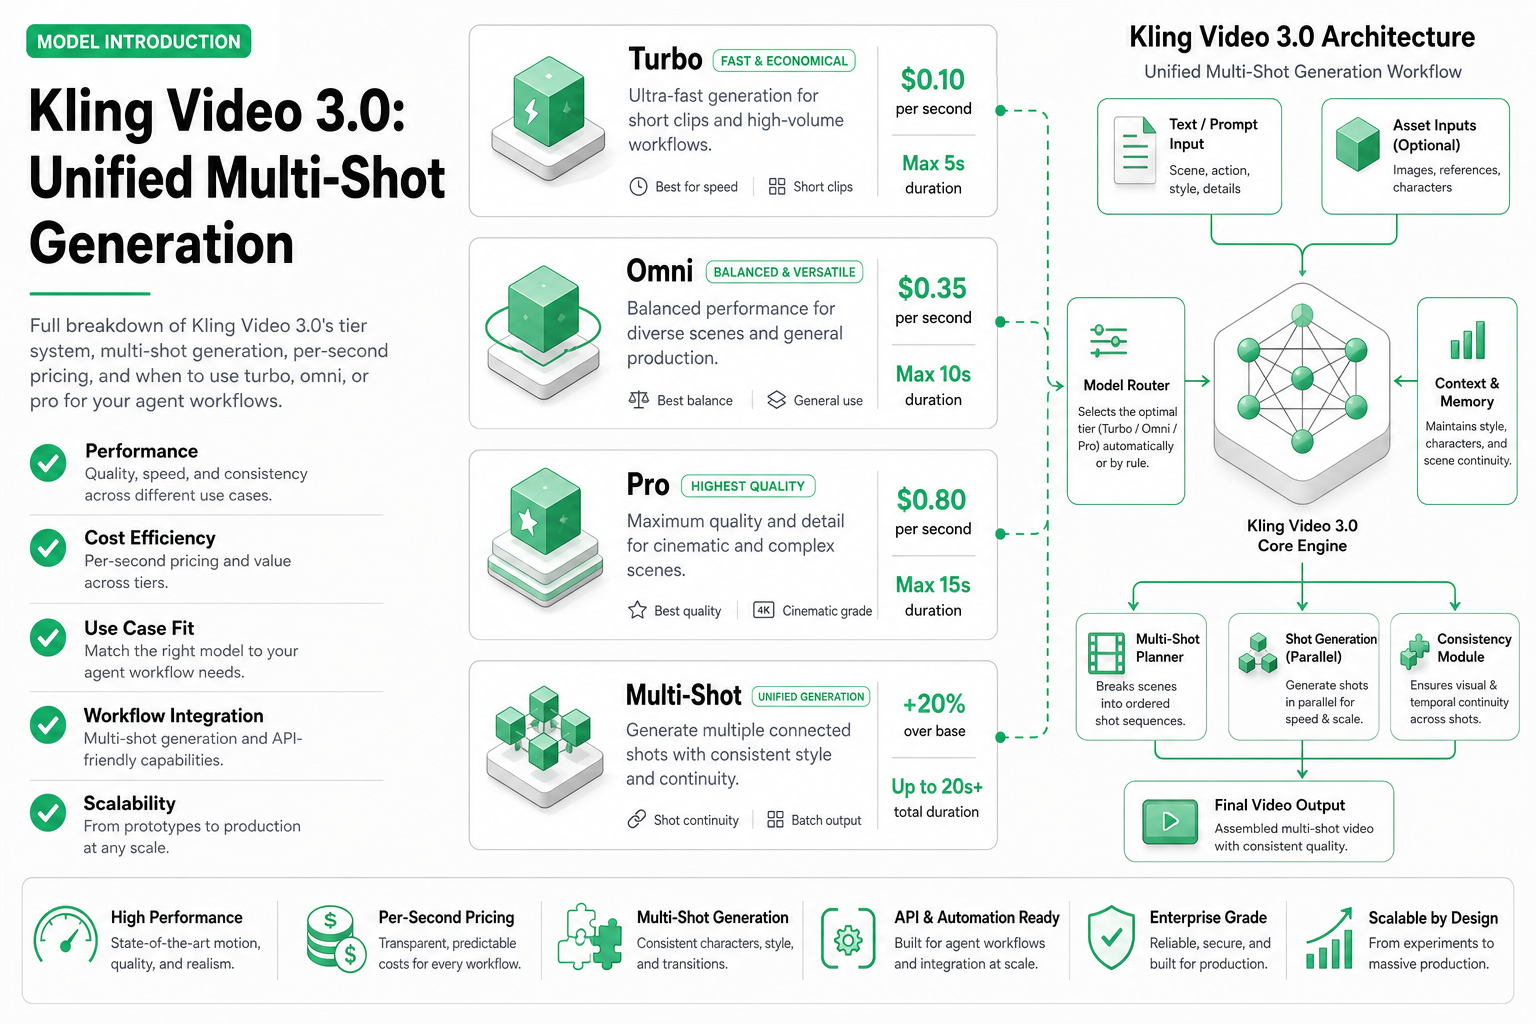
全面拆解 Kling Video 3.0 的档位系统、多镜头生成、按秒计费,以及 turbo/omni/pro 各档位的适用场景。
阅读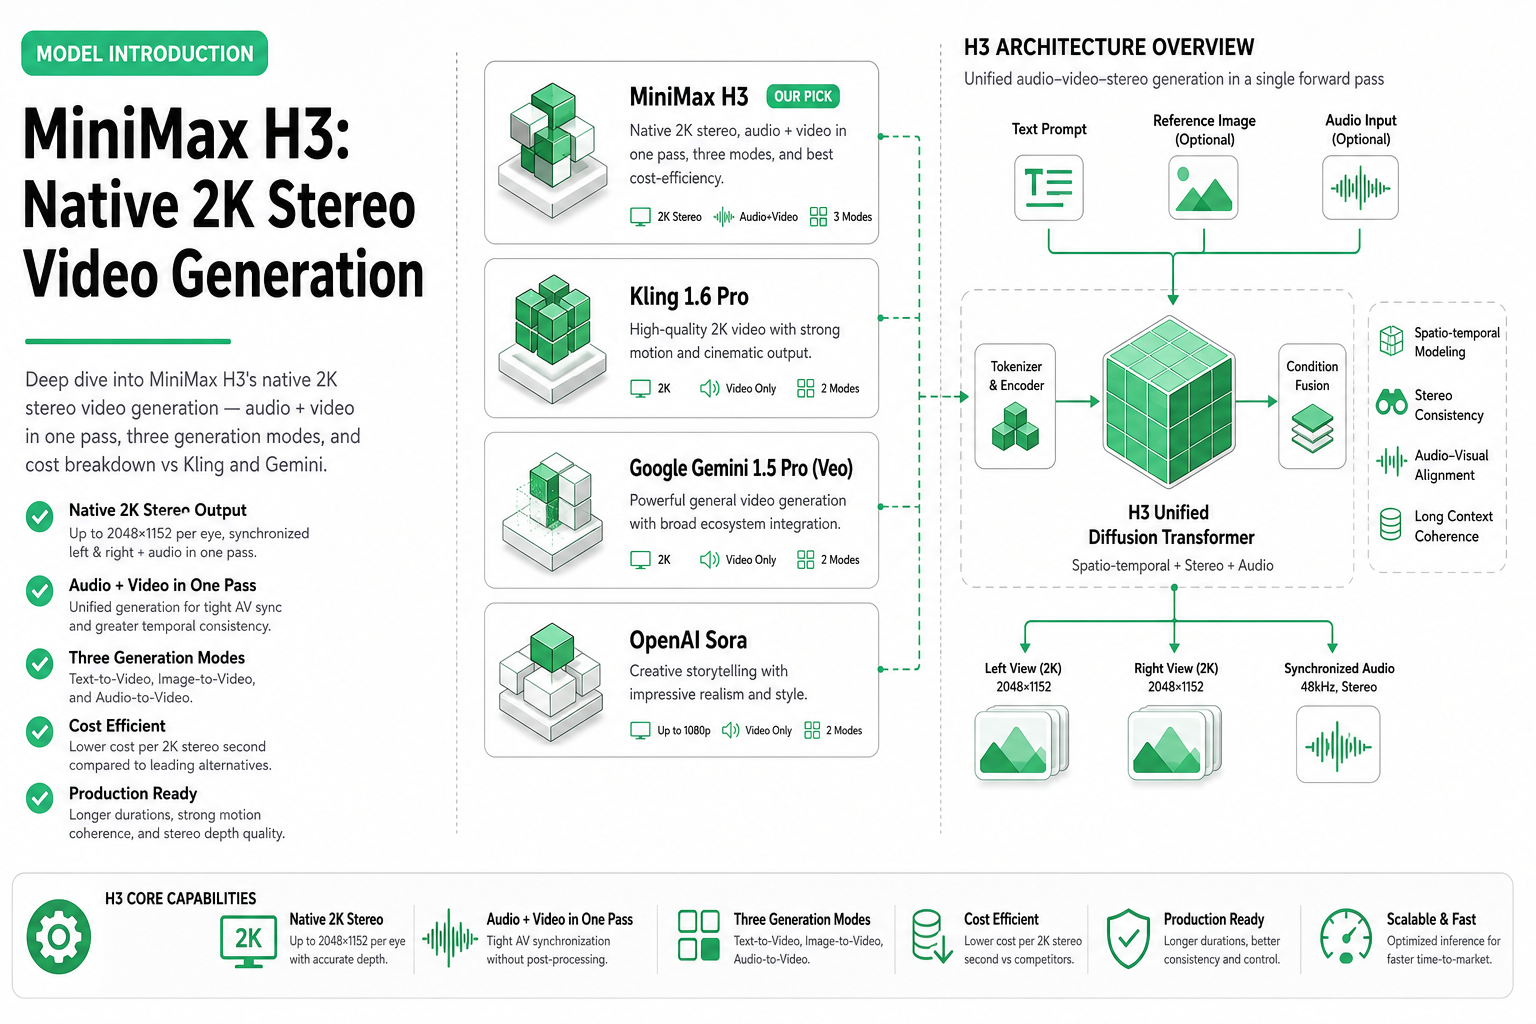
深入拆解 MiniMax H3 的原生 2K 立体声视频生成能力——音频+视频一次出,三种生成模式,以及与 Kling、Gemini 的成本对比。
阅读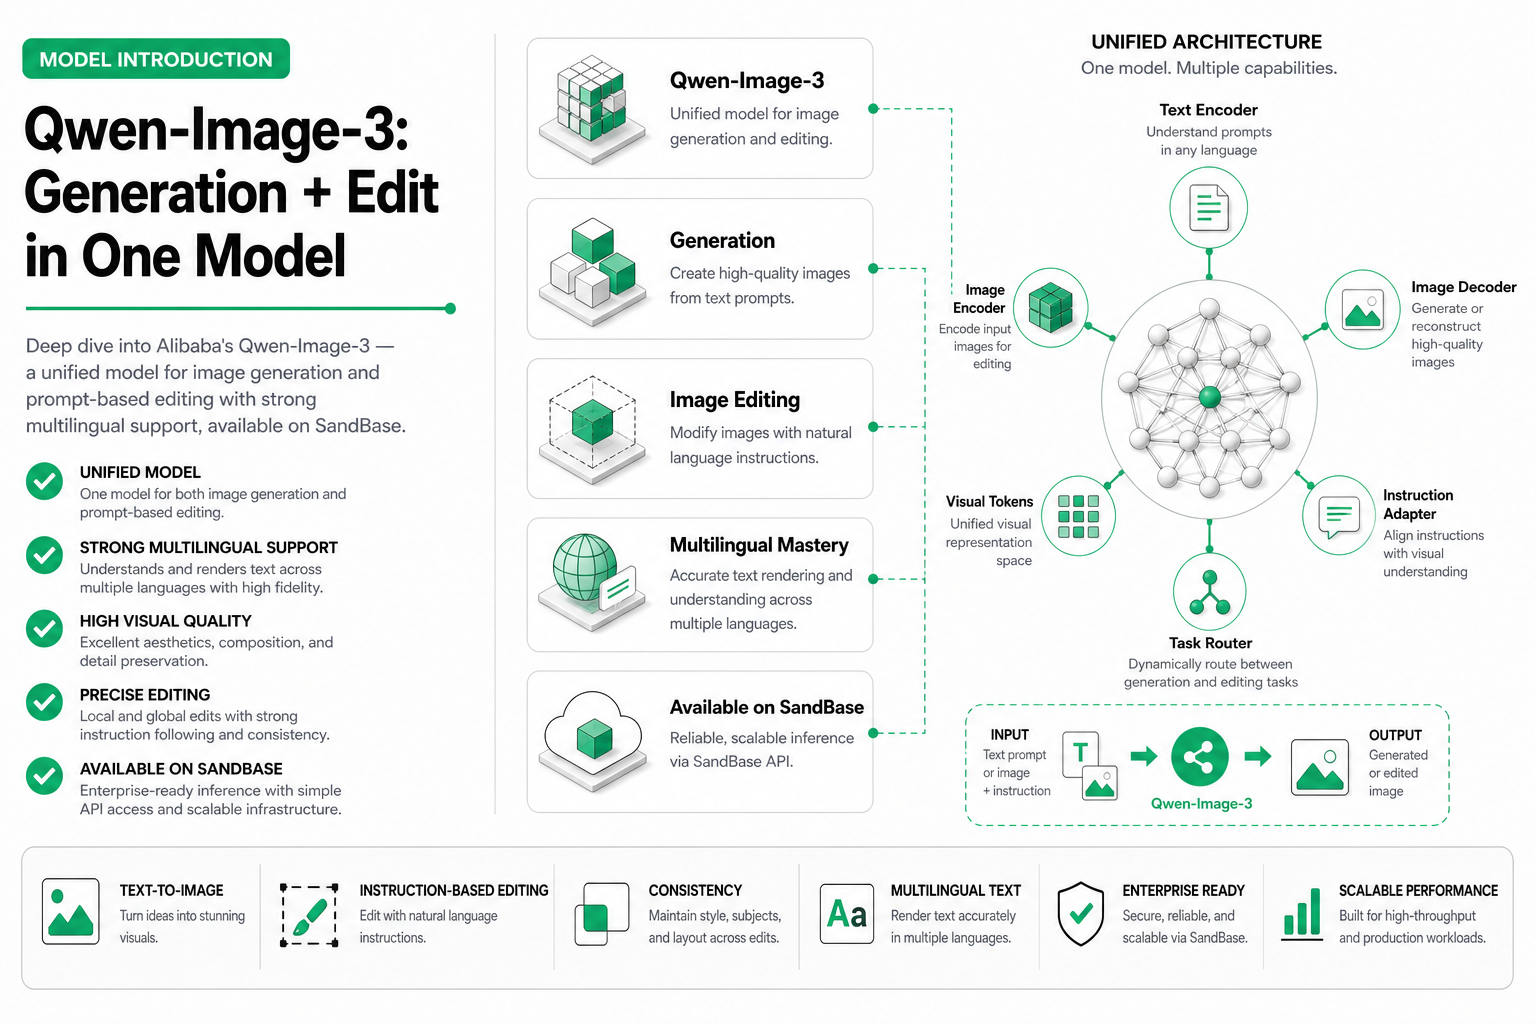
深入解析阿里 Qwen-Image-3——统一的图像生成与编辑模型,强多语言提示词支持,在 SandBase 上的实战用法。
阅读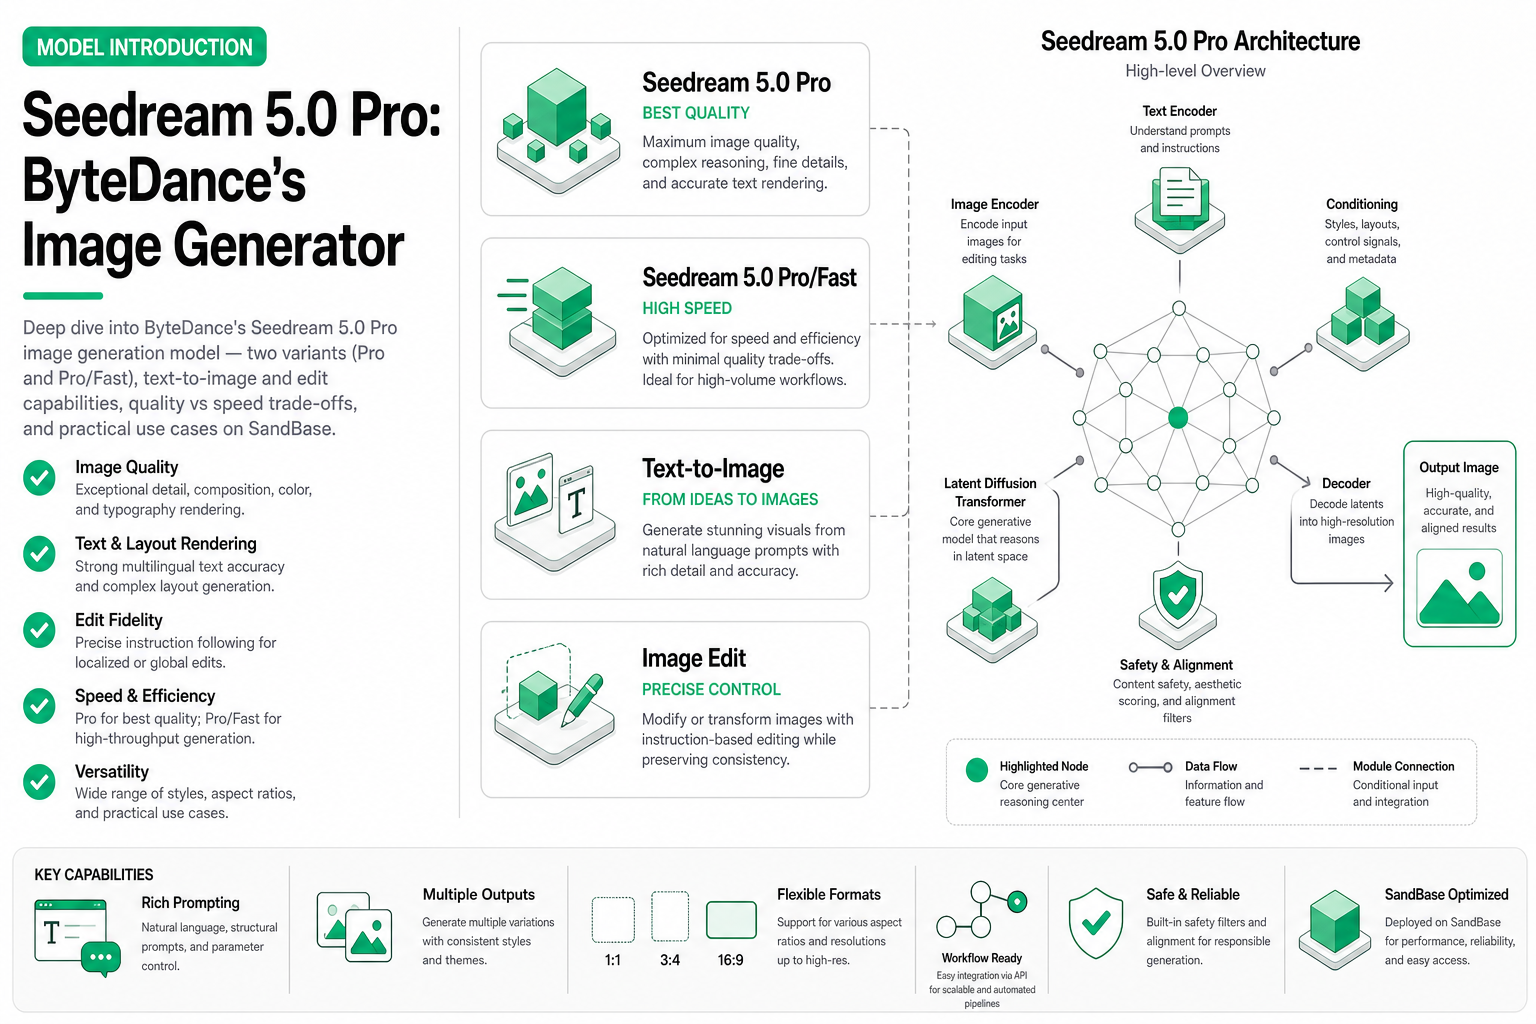
深入解析字节跳动 Seedream 5.0 Pro 图像生成模型——Pro 与 Pro/Fast 双版本、文生图与编辑能力、质量与速度权衡,以及在 SandBase 上的实战用法。
阅读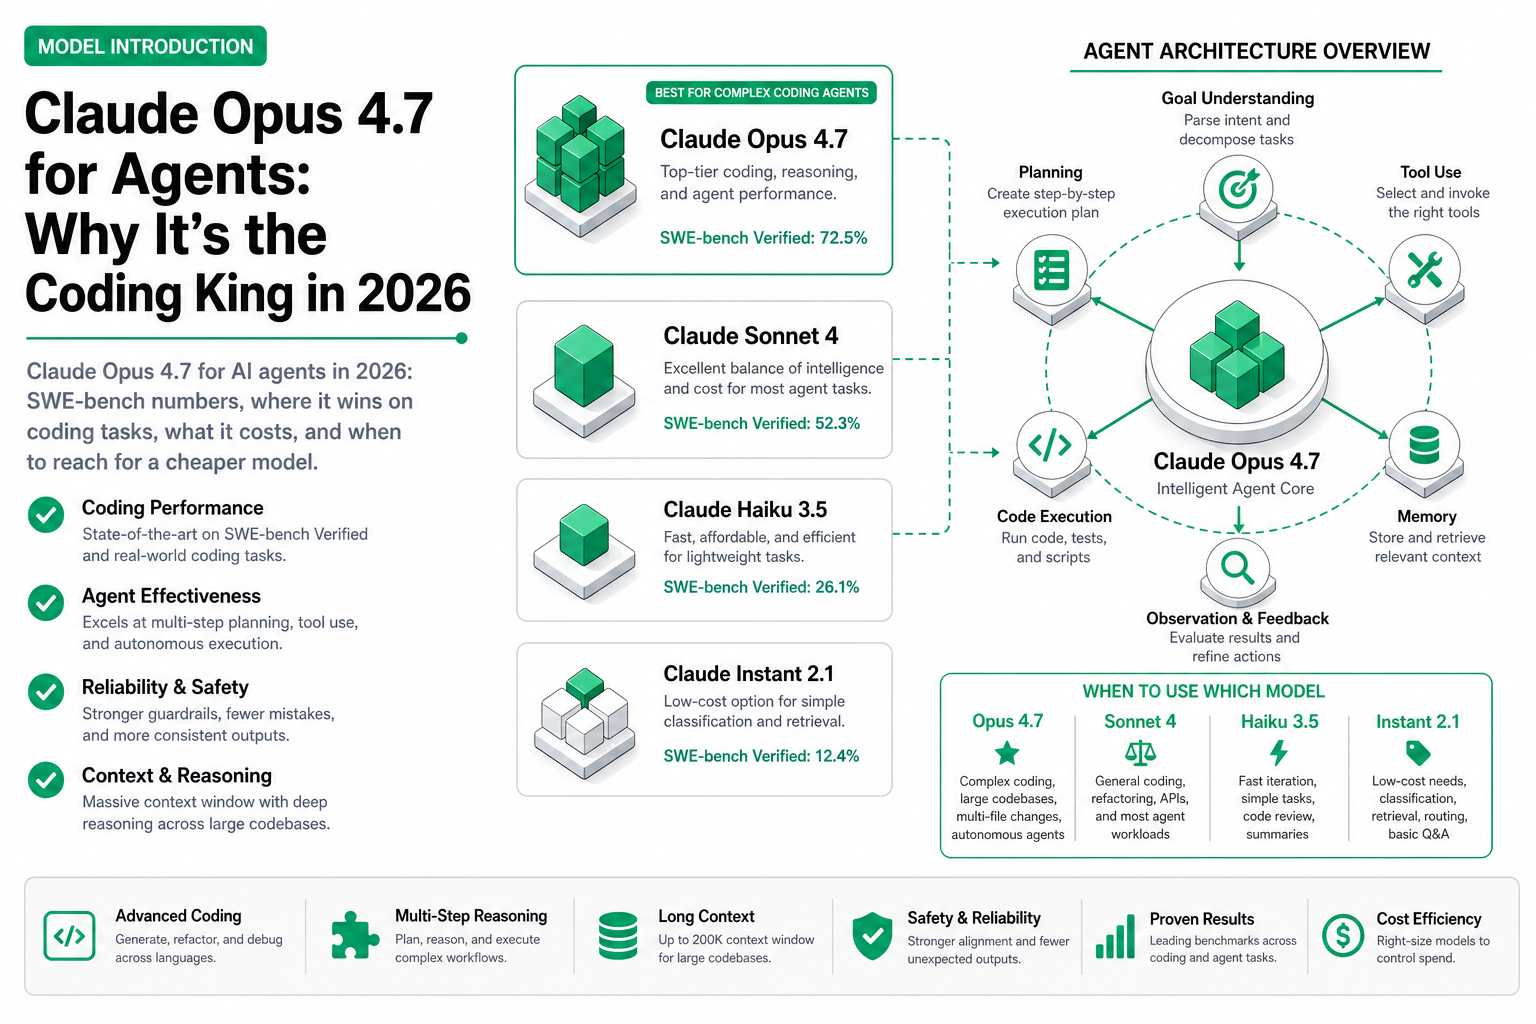
实测 Claude Opus 4.7 做 AI Agent:SWE-bench 成绩、它在编码任务上真正强在哪、成本多少、以及什么时候该换便宜模型。
阅读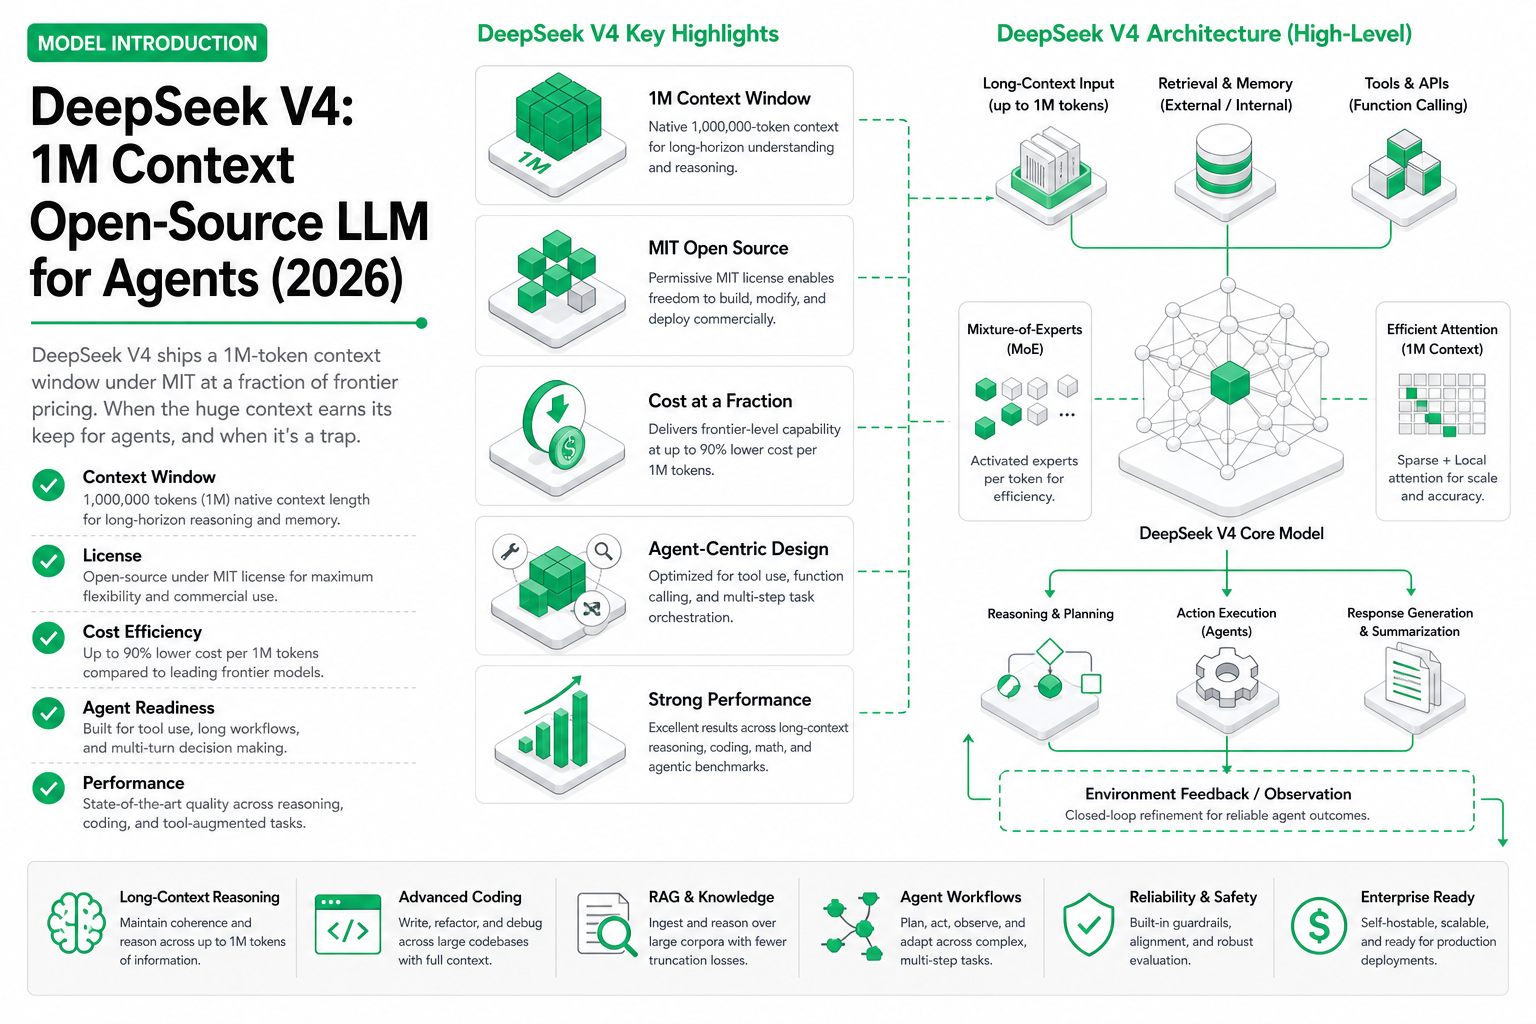
DeepSeek V4 以 MIT 许可、前沿模型零头的价格提供 1M token 上下文窗口。这个巨大窗口什么时候对 Agent 真有用,什么时候是陷阱。
阅读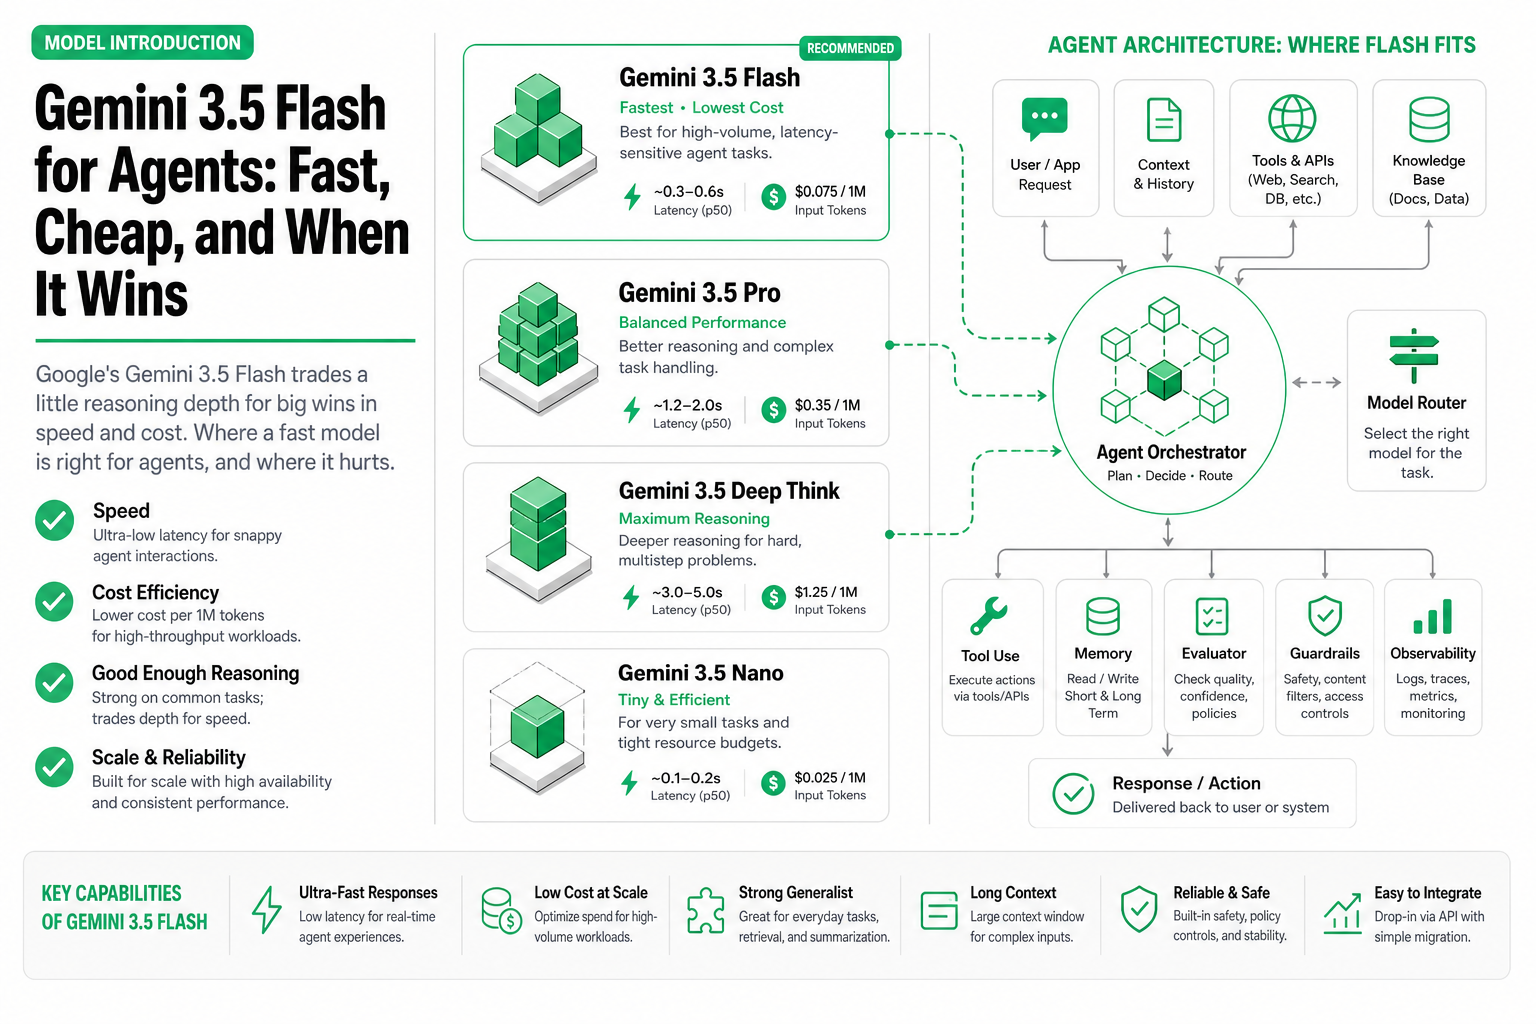
Google 的 Gemini 3.5 Flash 用一点推理深度换来速度和成本上的大赢。快模型什么时候是 Agent 的正确选择,什么时候会悄悄坑你。
阅读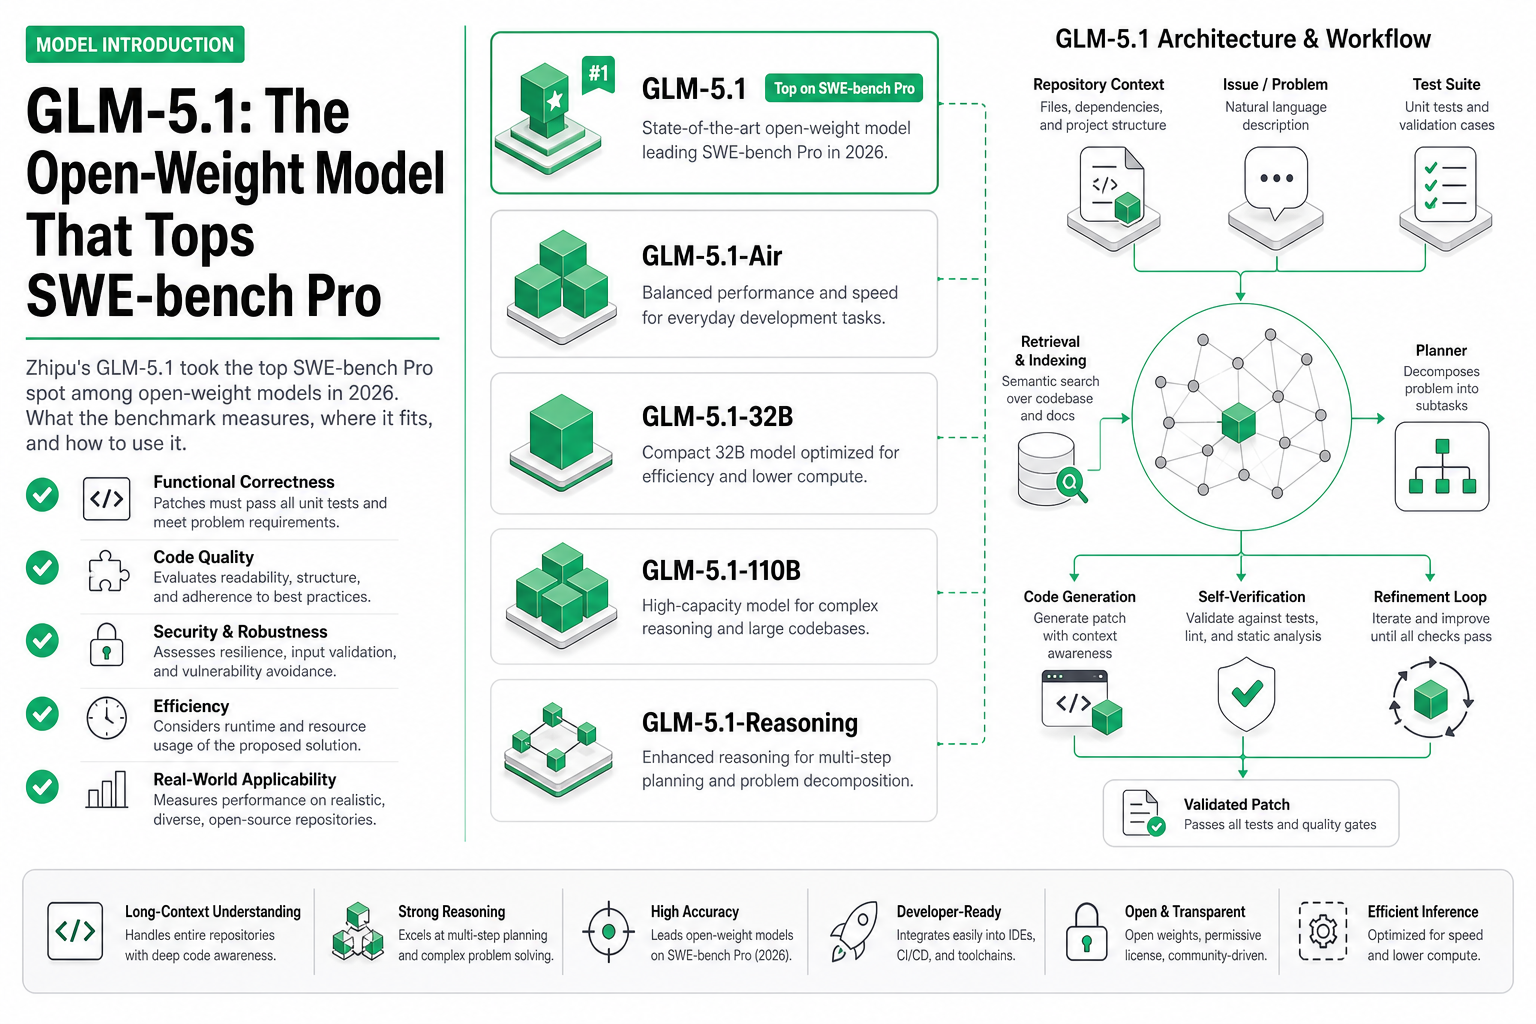
智谱的 GLM-5.1 在 2026 年拿下开源权重模型的 SWE-bench Pro 头名。这个 benchmark 到底测什么、GLM-5.1 的定位、以及怎么把它当编码 Agent 用。
阅读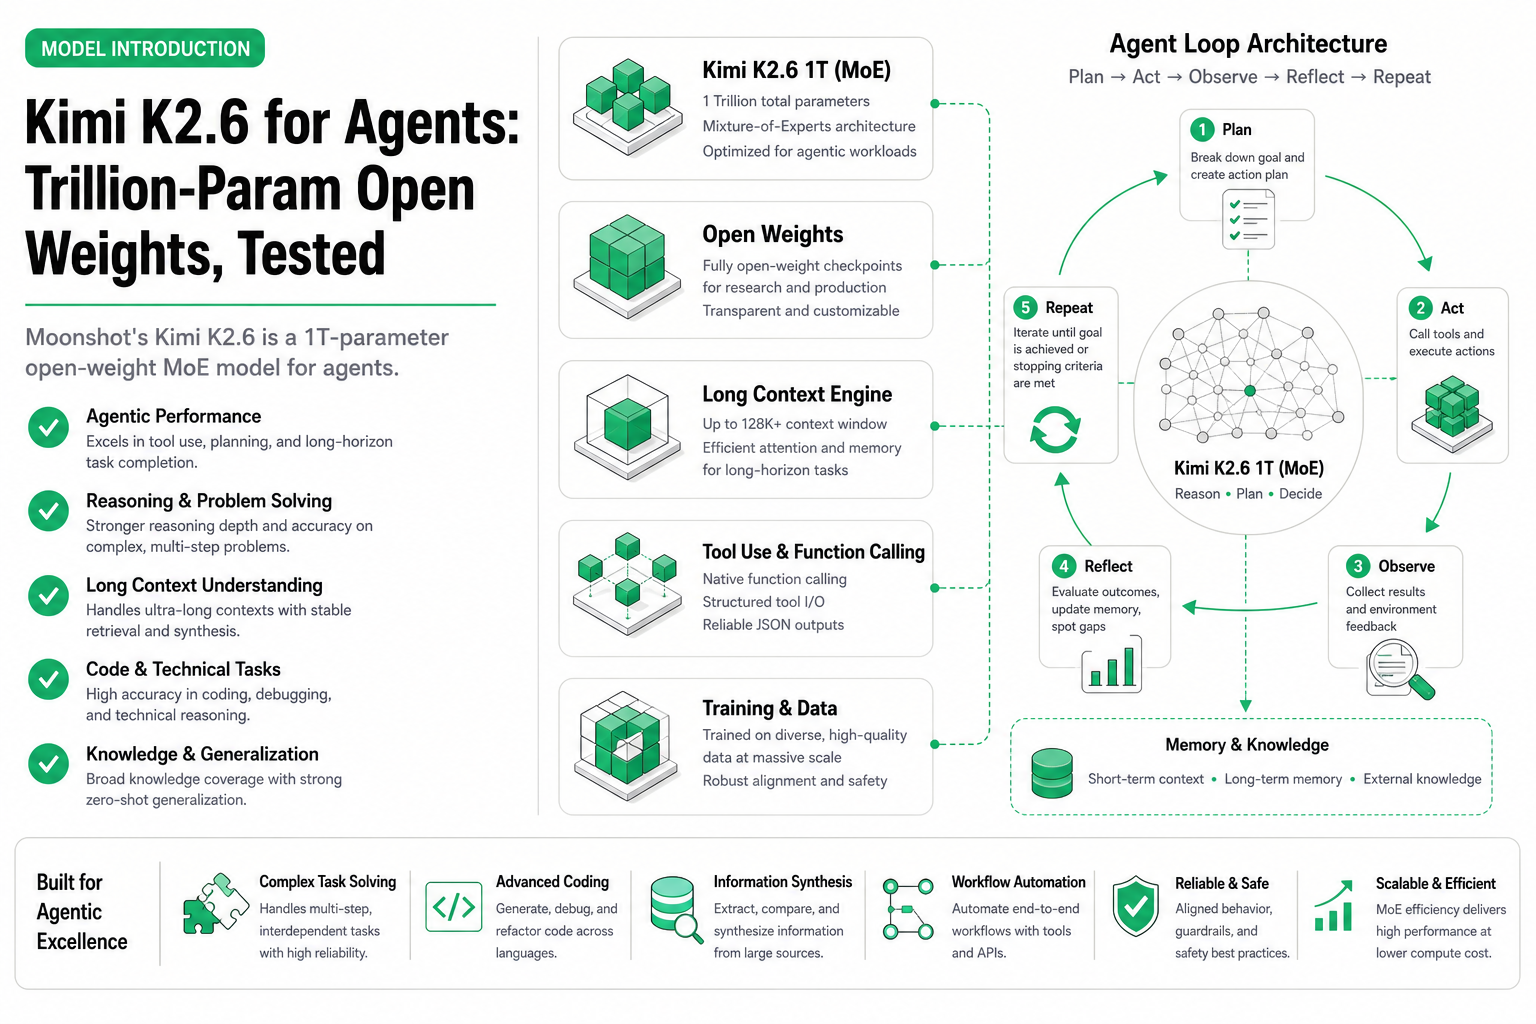
Moonshot 的 Kimi K2.6 是为 Agent 而生的 1T 参数开源 MoE 模型。它真正擅长什么、万亿参数在哪有用在哪没用、以及怎么接进 Agent loop。
阅读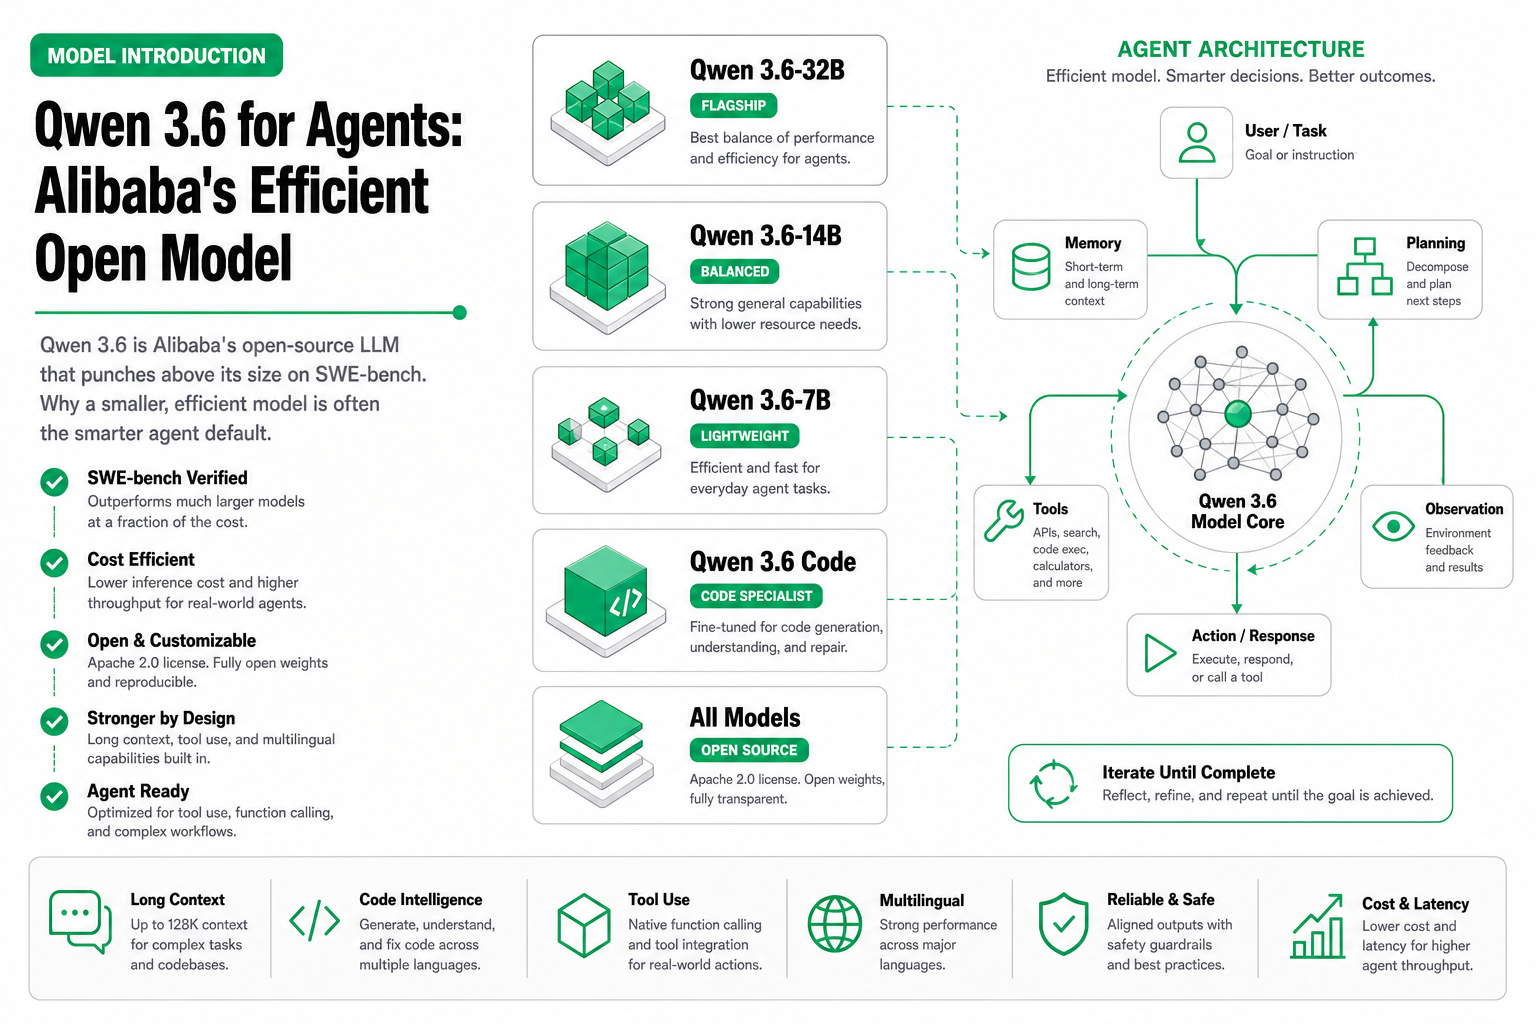
Qwen 3.6 是阿里的开源 LLM,体量不大却在 SWE-bench 上越级打怪。为什么对 Agent 来说,一个更小更高效的模型常常是比巨型模型更聪明的默认。
阅读