几百个异构社媒接口怎么归一成一个 Agent 契约
工程拆解:SandBase 如何把抖音、TikTok、微博、小红书上游 GET/POST、不同 body 形状的接口归一到 POST /v1/api 契约,含命名规则、body 包装和 fail-closed 校验。
先说结论 — 几百个社媒 API 操作,来自四个平台,上游的 HTTP 方法、参数位置、body 形状、命名规则各不相同。一个 adapter 层把它们映射到同一个公开契约:
POST https://api.sandbase.ai/v1/api/<vendor>/<path>,body 是 JSON 对象。本文讲四个最难的工程决策:命名归一、root body 包装、参数位置映射、fail-closed 校验。
截至 2026-10-01,SandBase 公开目录里本文涉及的四个平台共展示 493 个端点:抖音 262 个、TikTok 145 个、微博 52 个、小红书 34 个(数字取自当天各平台目录页的展示数;其他文档页面展示的汇总数可能不同)。在上游,有的是 GET + query 参数,有的是 POST + JSON 对象,少数是 POST + 顶层数组或顶层字符串。四个平台,四套命名规则。
各平台的端点数来自对应的目录页,下面是抖音目录页的复核截图。
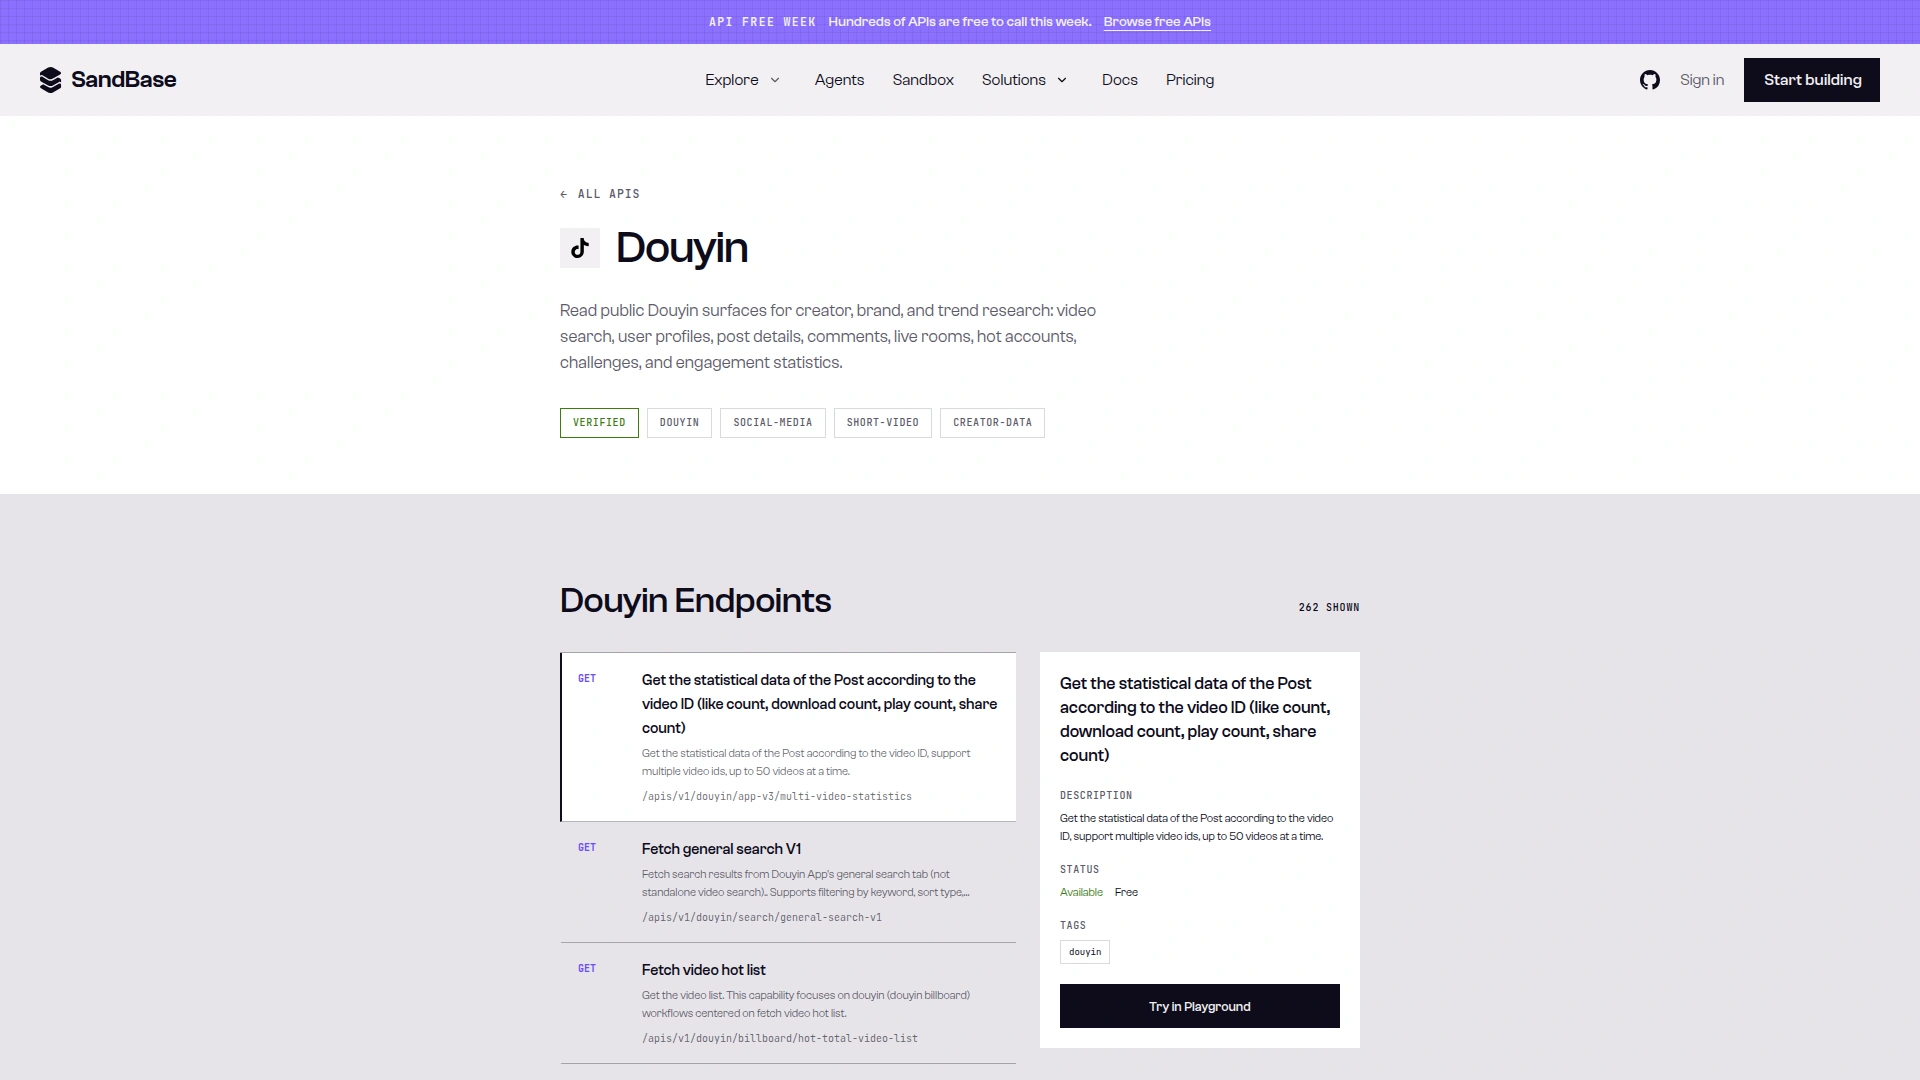
截图:抖音目录页显示「262 SHOWN」,与上文引用的数量一致(2026-10-02 截取)。
你的 agent 不该关心这些。
Agent 调 POST /v1/api/douyin/search/challenge-search-v1,发 {"keyword": "AI创作", "cursor": 0},拿回 JSON。上游是 GET ?keyword=AI创作 还是 POST {"keyword": "AI创作"},是 adapter 的事。
先说清范围:外部能验证的是请求/响应行为,文中所有公开调用都在 2026-10-01(UTC)通过 POST /v1/api/<model> 实际跑过。契约上游的一切(原始路径、元数据字段、导入规则、query/body/path 转换)都只是简化的假设性示意,用来说明这类 adapter 要解决的问题。这些例子都标了「示意」,它们不是 SandBase 实际的上游路由,也不是对其内部实现的公开说明,更不是调用 SandBase 的方式。
问题空间
这类 adapter 要吸收的差异类型(命名例子为示意):
| 维度 | Adapter 要处理的变体 |
|---|---|
| HTTP 方法 | GET、POST |
| 参数位置 | query string、path、JSON body、混合 |
| Body 形状 | JSON 对象、root 数组、root 可选字符串、无 body(GET) |
| 命名模式(示意) | fetch_video_search_result、get_unique_id、handler_hot_search、multi_video_v2 |
| 鉴权方式 | 每个上游的 header 约定不同 |
| 响应形状 | JSON(对象、数组或纯字符串) |
绝大多数操作是普通对象 body,root 数组和 root 字符串是少数。我们没有公开全量的方法和 body 形状统计,所以本文只讲类别,以及逐个实测过的操作。
目标:agent 看到一个扁平命名空间、发一个 JSON 对象 body、收一个 JSON 信封。其他全部隐藏。
决策 1:命名归一
问题
上游操作名可能长这样(示意):fetch_video_search_result、get_unique_id、handler_hot_search_list、fetch_multi_video_v2、kol_xingtu_index_v1。前缀不统一(fetch_、get_、handler_),路径里已经有 douyin/ 动作名里还带 douyin_,版本标记也混乱。
规则
公开模型名遵循这个形状:
canonical_name = {platform}/{normalized-channel-version}/{semantic-action}从一个假设的上游路径得到这种名字,一组示意步骤如下:
- 去掉外层路径前缀(例如
/api/v1/) - 归一频道+版本:
douyin/app/v3/→app-v3,weibo/web/v2/→web-v2 - 剥掉动作前缀:
fetch_、get_、handler_开头的去掉 - 剥掉冗余平台 token:动作里重复平台名的去掉
- 转 kebab-case:
multi_video_v2→multi-video-v2
前后对比
左列是为演示转换而虚构的上游路径形状,不是 SandBase 实际的上游路由;右列是放进 /v1/api/<model> 的真实公开模型名。
| 假设的上游路径形状(示意) | 公开模型名 |
|---|---|
/api/v1/douyin/search/fetch_video_search_v1 | douyin/search/video-search-v1 |
/api/v1/tiktok/web/get_unique_id | tiktok/web/unique-id |
/api/v1/weibo/web/v2/fetch_hot_search | weibo/web-v2/hot-search |
/api/v1/douyin/app/v3/fetch_multi_video_v2 | douyin/app-v3/multi-video-v2 |
/api/v1/xiaohongshu/web_v3/fetch_note_detail | xiaohongshu/web-v3/note-detail |
为什么不直接用原始名?
- Agent 可读性:
douyin/search/video-search-v1一眼看出平台/频道/动作,fetch_video_search_v1看不出平台和频道 - 防碰撞:好几个平台都有
hot_search,平台前缀保证唯一 - 身份稳定:在这种方案里,假设上游把
fetch_hot_search改名为get_hot_search,归一后仍是hot-search,因为映射基于路径结构,不基于 operationId
这类 importer 的一条通用设计原则:命名上 fail-closed。两个操作会归一成同一个名字时,应当作为错误交给人决定,而不是静默去重。
决策 2:Root body 包装
问题
公开契约要求 body 是 JSON 对象。但有的上游要求顶层直接是数组,比如 ["7687107502068026650", "7682040509572983400"]。契约要求对象时,没法直接发裸数组。
方案:body 字段包装
这类操作的公开 schema 只声明一个 body 字段(见下面的端点参考)。两个例子,都在 2026-10-01(UTC)实测:
# 抖音视频 ID 的 root 数组
# 参考:https://www.sandbase.ai/docs/model-api-reference/platform-apis/douyin/app-v3/multi-video-v2
curl -s -X POST https://api.sandbase.ai/v1/api/douyin/app-v3/multi-video-v2 \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"body": ["7687107502068026650", "7682040509572983400"]}'

# 主页链接的 root 数组(TikTok 官方账号)
# 参考:https://www.sandbase.ai/docs/model-api-reference/platform-apis/tiktok/web/all-sec-user-id
curl -s -X POST https://api.sandbase.ai/v1/api/tiktok/web/all-sec-user-id \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"body": ["https://www.tiktok.com/@tiktok"]}'
multi-video-v2 的参考页里只声明了一个 body 字段,第一个调用用的就是这个包装。
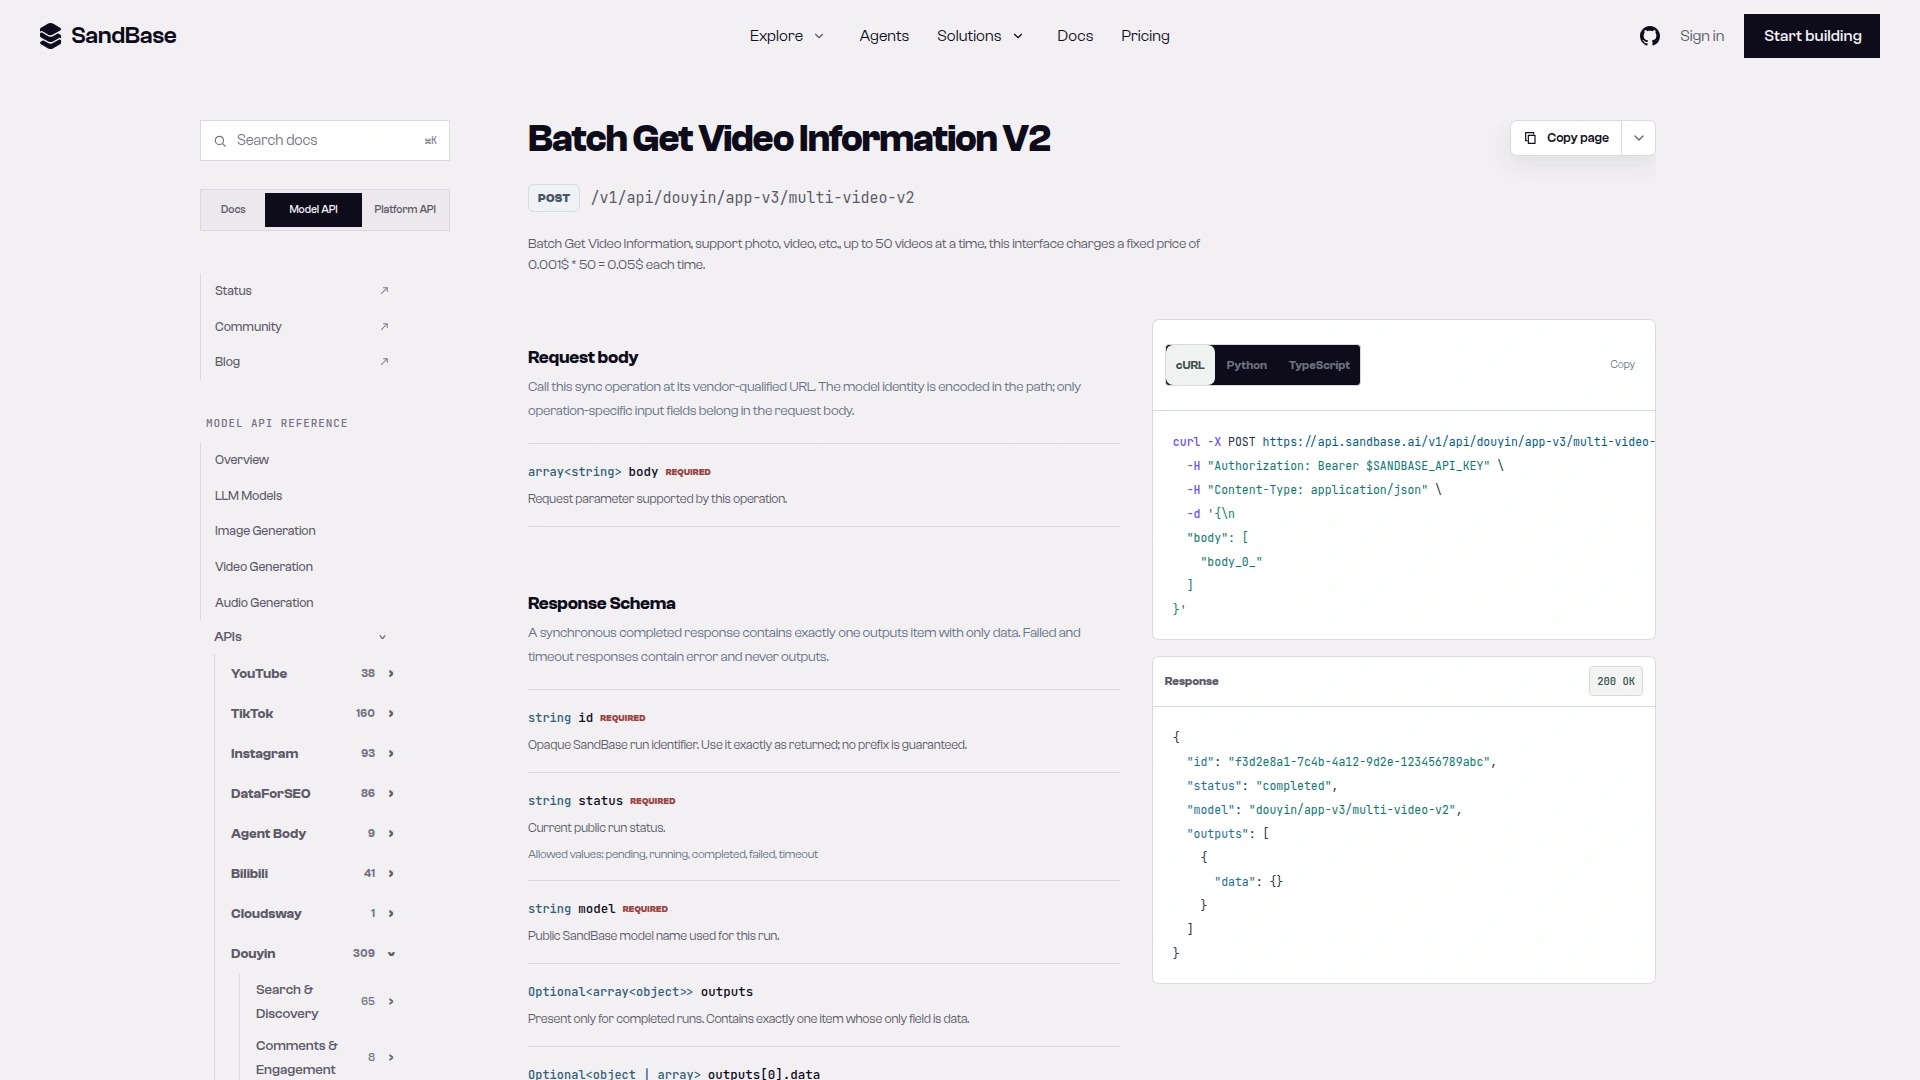
截图:douyin/app-v3/multi-video-v2 参考页列出 POST /v1/api/douyin/app-v3/multi-video-v2,只有一个必填的 array<string> body 字段(2026-10-02 截取)。
概念上,如果上游要求 root 数组,adapter 会把 body 拆包,转发裸数组(["7687107502068026650", "7682040509572983400"])。这个转发步骤只是示意;从外部只能看到 body 包装和返回结果。
第一个调用返回了包含两条视频的 aweme_details 列表(run id adaa01f7-cbd6-43c5-a4c4-6602fd10ad5e)。第二个返回的是裸数组,这也提醒你 outputs[0].data 不一定是对象。完整响应,未删改:
{
  "id": "6d90c30a-360d-48b8-b55d-fce62ee63c64",
  "status": "completed",
  "model": "tiktok/web/all-sec-user-id",
  "outputs": [{"data": ["MS4wLjABAAAAv7iSuuXDJGDvJkmH_vz1qkDZYo1apxgzaxdBSeIuPiM"]}]
}
body 的类型会被校验:给 multi-video-v2 传字符串,返回 HTTP 400 parameter validation failed: /body: expected array, but got string。
标记哪些操作需要包装(示意)
Adapter 需要某种逐操作的标记,说明 body 是否被包装。一个假设的元数据形状(不是 SandBase 实际的 registry 格式):
{
  "name": "douyin/app-v3/multi-video-v2",
  "root_body_type": "array",
  "body_required": true
}
这个示意里可能的取值:
null或缺省:标准对象 body,不包装"array":body字段必须是数组,发送前拆包"string":body字段必须是字符串(可选时可以不传)
依赖鉴权的能力
root 字符串这种情况确实存在,但抖音里能拿来演示的 douyin/web/query-user,它的 body 是用户的 ttwid cookie 值。这让它依赖会话,不属于公开数据调用,所以不在本文和下文公开只读承诺的范围内。需要的话看它的端点参考,并把 cookie 当成凭证对待。
决策 3:参数位置映射
问题
如果上游是 GET 操作,参数会在 query string 里。但 agent 永远发 JSON 对象 body。JSON 字段怎么映射到 query 参数?
# Agent 发(公开契约)
# 参考:https://www.sandbase.ai/docs/model-api-reference/platform-apis/tiktok/web/unique-id
curl -s -X POST https://api.sandbase.ai/v1/api/tiktok/web/unique-id \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://www.tiktok.com/@tiktok"}'

# 仅为示意,不是 SandBase 路由,也不是其实际上游:
# 一个形状类似这样的上游路径
# GET https://upstream.example/tiktok/unique_id?url=https%3A%2F%2Fwww.tiktok.com%2F%40tiktok
映射规则(示意)
Adapter 需要知道每个参数的位置(比如来自上游 OpenAPI spec)。一种映射方式:
| 位置 | Agent 发什么 | Adapter 会向上游产出什么 |
|---|---|---|
query | JSON 字段 | URL query 参数 |
path | JSON 字段 | 替换进 URL 路径 |
body(对象) | JSON 字段 | POST body 里的字段 |
body(root 数组/字符串) | body 字段 | 拆包后作为 POST body |
上面的 unique-id 调用在 2026-10-01 完成,outputs[0].data 是纯字符串 "tiktok"(run id d35785a0-76fe-4d8e-a66b-89475f4da0b2)。注意:接口参考目前把 outputs[0].data 的类型写为 object | array;字符串结果只是我们 2026-10-01 那次调用中观察到的,不是文档保证,客户端应同时兼容这几种形状。
Path 参数需要安全替换。下面的路径是假设的上游形状,不对应某个具体的 SandBase 操作:
// Agent 发到 POST /v1/api/<platform>/<channel>/user-posts:
{"unique_id": "example_user", "count": 20}

// 示意的上游形状:
// GET https://upstream.example/user/example_user/posts?count=20
//                              ^^^^^^^^^^^^^^^^^^^^^^^ path 替换
//                                                      ^^^^^^^^ 其余参数进 query
零值处理
false、0、空数组是合法的参数值。Adapter 不能把「字段存在但值是 falsy」和「字段不存在」搞混。
// Agent 发到 POST /v1/api/douyin/web/one-video:
{"aweme_id": "7687107502068026650", "need_anchor_info": false}

// 示意:如果上游是 GET 路由,adapter 应当产出
// GET ...?aweme_id=7687107502068026650&need_anchor_info=false
// 不是:GET ...?aweme_id=7687107502068026650(丢掉 false 会改变语义)
这个调用在 2026-10-01 返回了 aweme_detail 负载(run id 043512bf-a0e9-4da0-a88a-25fbc3550cef)。设计原则:只有真正缺失的字段才省略;null、false、0、""、[] 都是值,应当传递。上游转换本身从外部观察不到。
决策 4:Fail-closed 校验
哲学
有疑问就拒绝。不猜缺失的必填参数、不强转错误类型、不耍小聪明。
哪些会被拒绝(在调用上游之前)
前两行可以从外部观察到(见下面的例子),其余是这类 adapter 的通用设计原则,无法通过公开 schema 触发或验证。
| 条件 | 行为 | 理由 |
|---|---|---|
| 参数类型错误 | 拒绝 + 报错 | 该传整数却传了字符串是 bug,不是暗示 |
| 必填字段缺失 | 拒绝 + 报错 | 上游反正会失败,不如提前报清楚 |
Path 参数还有 {placeholder} | 拒绝 | 说明必填 path 参数没给 |
| Agent 以参数形式传 header 或 cookie | 不映射 | Agent 不能注入上游鉴权 header |
| 不支持的 body content type | 拒绝 | 只支持 JSON |
| 字段位置冲突 | 拒绝 | 同一字段既在 query 又在 body,有歧义 |
哪些会放行(设计如此)
| 条件 | 行为 | 理由 |
|---|---|---|
| 可选字段省略 | 放行(不注入默认值) | Agent 明确选择不传 |
| 布尔 false / 数字 0 | 原样传递 | 是合法值,不是缺失 |
报错示例
// POST /v1/api/tiktok/web/unique-id,body 为 {}
// 返回(HTTP 400,无 run id):
{"error": "parameter validation failed: (root): missing properties: 'url'"}
// POST /v1/api/douyin/search/challenge-search-v1,body 为 {"keyword": "AI", "cursor": "abc"}
// 返回(HTTP 400,无 run id):
{"error": "parameter validation failed: /cursor: expected integer, but got string"}两条都是我在 2026-10-01 实际调用得到的。错误信息点名字段和期望的类型,agent 可以自我纠正。同一轮测试里有一点要注意:schema 未定义的多余字段(在 challenge-search-v1 上传 "unknown_field": "test")没有被拒绝,调用正常完成(run id a7c6bf3c-4771-4a1e-a886-a8164f328ac5)。不要指望靠「未知字段拒绝」来发现可选参数名的拼写错误。
结果
从 agent 视角,每个操作的调用方式都一样:模型名放 URL,body 只放该端点的参数,结果从 outputs[0].data 读。本例端点参考:douyin/search/challenge-search-v1。
import os
import requests

def call_sandbase(model: str, params: dict):
    resp = requests.post(
        f"https://api.sandbase.ai/v1/api/{model}",
        headers={"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"},
        json=params,
        timeout=60,
    )
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data")  # 视端点不同,可能是对象、数组或字符串

data = call_sandbase("douyin/search/challenge-search-v1", {"keyword": "AI创作", "cursor": 0})
for item in data.get("challenge_list", [])[:3]:
    info = item.get("challenge_info", {})
    print(info.get("cha_name"), info.get("user_count"))
这个端点的参考页把 cursor 定义为整数,所以决策 4 里传 "cursor": "abc" 的调用会被拒绝。
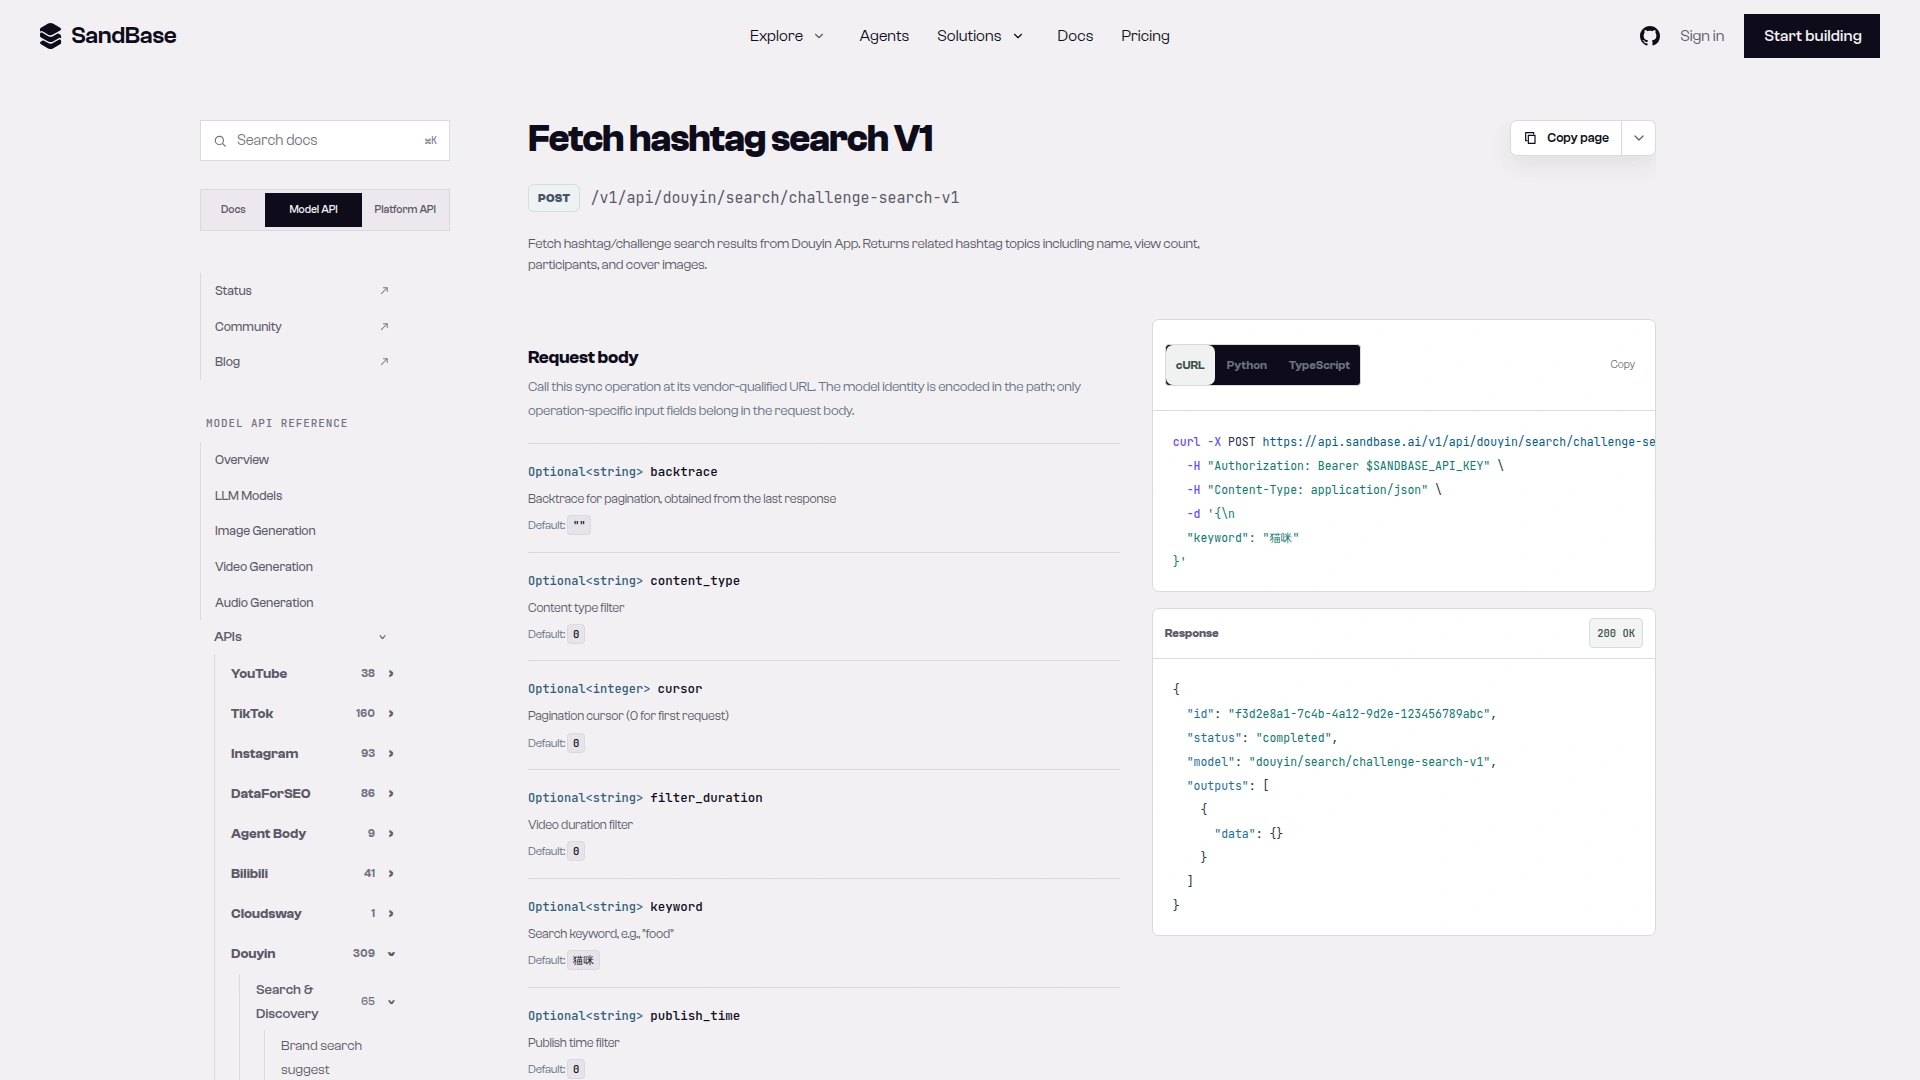
截图:douyin/search/challenge-search-v1 参考页显示 POST 路由和可选参数,其中 cursor 类型为 Optional<integer>(2026-10-02 截取)。
实测于 2026-10-01(UTC)。 公开资源:通用话题关键词 AI创作。请求:POST https://api.sandbase.ai/v1/api/douyin/search/challenge-search-v1,body 为 {"keyword": "AI创作", "cursor": 0}。截短后的真实响应(run id 38446d74-a295-4ff6-9df3-c0e6fb122511;删掉了大部分字段和 20 条结果中的 17 条):
{
  "status": "completed",
  "model": "douyin/search/challenge-search-v1",
  "outputs": [{
    "data": {
      "cursor": 20,
      "has_more": 1,
      "challenge_list": [
        {"challenge_info": {"cha_name": "ai创作", "cid": "1641397594586119", "user_count": 968792, "view_count": 10623376934}},
        {"challenge_info": {"cha_name": "抖音ai创作", "cid": "1776715988162624", "user_count": 438375154, "view_count": 272831217402}},
        {"challenge_info": {"cha_name": "ai创作浪潮", "cid": "7552088959354931251", "user_count": 58672, "view_count": 3915552067}}
      ]
    }
  }]
}信封(id、status、model、outputs)在端点参考里有文档。负载字段名(challenge_list、challenge_info、cha_name、user_count、cursor、has_more)只是实测观察,不是文档保证,读取时请用 .get() 防御。
不用想 HTTP 方法。不用想参数位置。不用想 body 形状。一个 SandBase API key,代替每个上游各自的鉴权。
范围:这个契约覆盖什么
这些是公开、只读的数据调用,每次调用都需要 SandBase API key。SandBase 不是抖音、TikTok、微博或小红书的官方合作方,契约不覆盖私密账号数据、私信、仅账号所有者可见的分析数据、发布或账号操作。
| 需求 | SandBase 平台数据 API | 平台官方 API |
|---|---|---|
| 公开数据研究(搜索、公开内容和主页、公开计数) | 覆盖:四个平台统一走 POST /v1/api/<model> 契约 | 不是通用的公开数据源;范围取决于你获批的开放计划和应用 |
| 私密或需鉴权的数据、账号操作(私信、所有者分析、发布) | 不覆盖 | 走平台开发者计划和用户授权 |
| 鉴权方式 | 一个 SandBase API key,放在 Authorization: Bearer | 在平台注册开发者并获取应用凭证;账号数据需要用户授权(例如微博 OAuth2.0 授权机制说明) |
官方开发者站点(均于 2026-10-01 UTC 访问可用):抖音开放平台、TikTok for Developers、微博开放平台、小红书开放平台。
接受的取舍
- 严格校验 = 开发初期报错多:主要是缺必填字段和类型错误,但每个错误都自带修正信息(点名字段和期望类型)。我们选可调试性而非宽容性。
- 命名归一丢失了原始标识符:你不能用上游的 operationId 直接调。但归一名更可读,上游改名时也更稳定。
- 本文涉及的端点不做流式:文中调用的每个端点,其参考页都声明
execution_mode: sync,实测也都在一次响应里返回完整结果。契约简单,但不支持「先拿前 10 条、其余稍后」。其他端点请以各自的参考页为准。 - Agent 不能控制 header 或 cookie:公开契约的 body 只包含端点声明的参数,没有传任意上游 header 或 cookie 的字段,安全优先于极少数场景的便利。(上面那个 cookie 值的 body 是 schema 声明的参数,这正是它被单独标为「依赖鉴权」的原因。)
FAQ
为什么不直接透传原始 API?
因为 agent 调 10 个不同操作就得理解 10 套规则:哪些是 GET、哪些是 POST、参数放哪、错误长什么样。这种认知负担违背 agent 平台的本意。一个契约 = 一条代码路径 = 一个错误处理器。
上游加了新操作怎么办?
新操作会以新的模型名出现在目录里,同样遵循 {platform}/{channel-version}/{action} 的形状。具体怎么导入属于内部实现;适用的是决策 1 里的设计原则:命名冲突应当作为错误由人解决,而不是静默去重。
能不能直接调原始 API?
不能通过 SandBase 调。数据 API 统一走 POST /v1/api/<model>。这是有意的:实测中,文中每个端点都使用同样的 Bearer key 鉴权,并按各自公开的 schema 做同样的请求校验,操作才能在 agent 工作流里组合。
上游破坏性变更怎么处理?
你能依赖的契约是端点参考页里公开的 schema。校验按这个 schema 执行,所以和它不再匹配的参数形状会被拒绝并返回清晰错误(就像上面的 HTTP 400 例子),不会静默降级。
下一步
平台层面的介绍看 抖音公开数据 API 和 微博 + 小红书数据接口上线 SandBase。为什么 agent 需要这种归一化,看 社媒 API 选型。