Instagram 用户ID查询API使用教程
Instagram 用户ID查询API教程:通过 SandBase 把用户名转换为数字ID、再把ID反查回用户名,附 curl、Python 代码和 2026-10-01 至 2026-10-04 的实测返回,适用于自动化和 AI Agent。
**更新(2026-10-04):**ID → 用户名这一步现在改用
instagram/v3/user-id-to-username。2026-10-01 时这个接口时好时坏(复测 4 次有 2 次返回 HTTP 503),所以本文旧版改用了instagram/v1/user-info-by-id。到 2026-10-04,Instagram ID 查用户名实测里它对 18 个品牌账号ID的 54 次调用全部成功,每次 2.5 到 4.9 秒;同一天我重跑本文代码(中英文两个版本)时,它对真实账号的 31 次调用也全部返回,耗时 2.5 到 5.0 秒。instagram/v1/user-id-to-username和instagram/v2/user-id-to-username在 SandBase 注册表里已停用,2026-10-04 调用均返回 HTTP 404endpoint_not_found。接口2、粉丝追踪器和批量处理的代码都在 2026-10-04(UTC)重新运行过;接口1的响应仍是 2026-10-01 的结果。批量转换 CSV 的脚本和各种无效ID的返回,见 Instagram ID 查用户名教程。
先说结论 — 用户名 → ID 用
instagram/v3/user-id-by-username(2026-10-01 实测natgeo→787132),ID → 用户名用instagram/v3/user-id-to-username,当前的username直接在返回数据顶层(2026-10-04 实测787132→natgeo)。两者都是用一个 SandBase API Key 调POST https://api.sandbase.ai/v1/api/<model>,2026-10-04 目录价均为 Free,数据从outputs[0].data读取。v3 解析不了的ID,可以交给instagram/v1/user-info-by-id-v2,它会直接回答“This account does not exist.”,而不是返回 503。
Instagram 用户ID查询API使用教程
如果你曾尝试构建 Instagram 自动化工具——无论是粉丝追踪器、数据分析面板,还是社交媒体监控 Agent——你一定遇到过同样的问题:很多 Instagram 数据工作流用数字用户ID而不是用户名来标识账号。这意味着在执行任何有用操作之前,你需要一种可靠的方式在用户名和ID之间进行转换。
本教程将展示如何用 SandBase Instagram 目录(截至 2026-10-01 列出 81 个端点)里的两个端点实现这一功能。我们将涵盖双向转换(用户名 → ID 和 ID → 用户名),提供完整的代码示例,并讨论 AI Agent 和自动化工作流的实际应用场景。
这个数字取自目录页:页面上写着“81 SHOWN”,第一张卡片就是本文用的 user-id-by-username,标着 Available · Free。
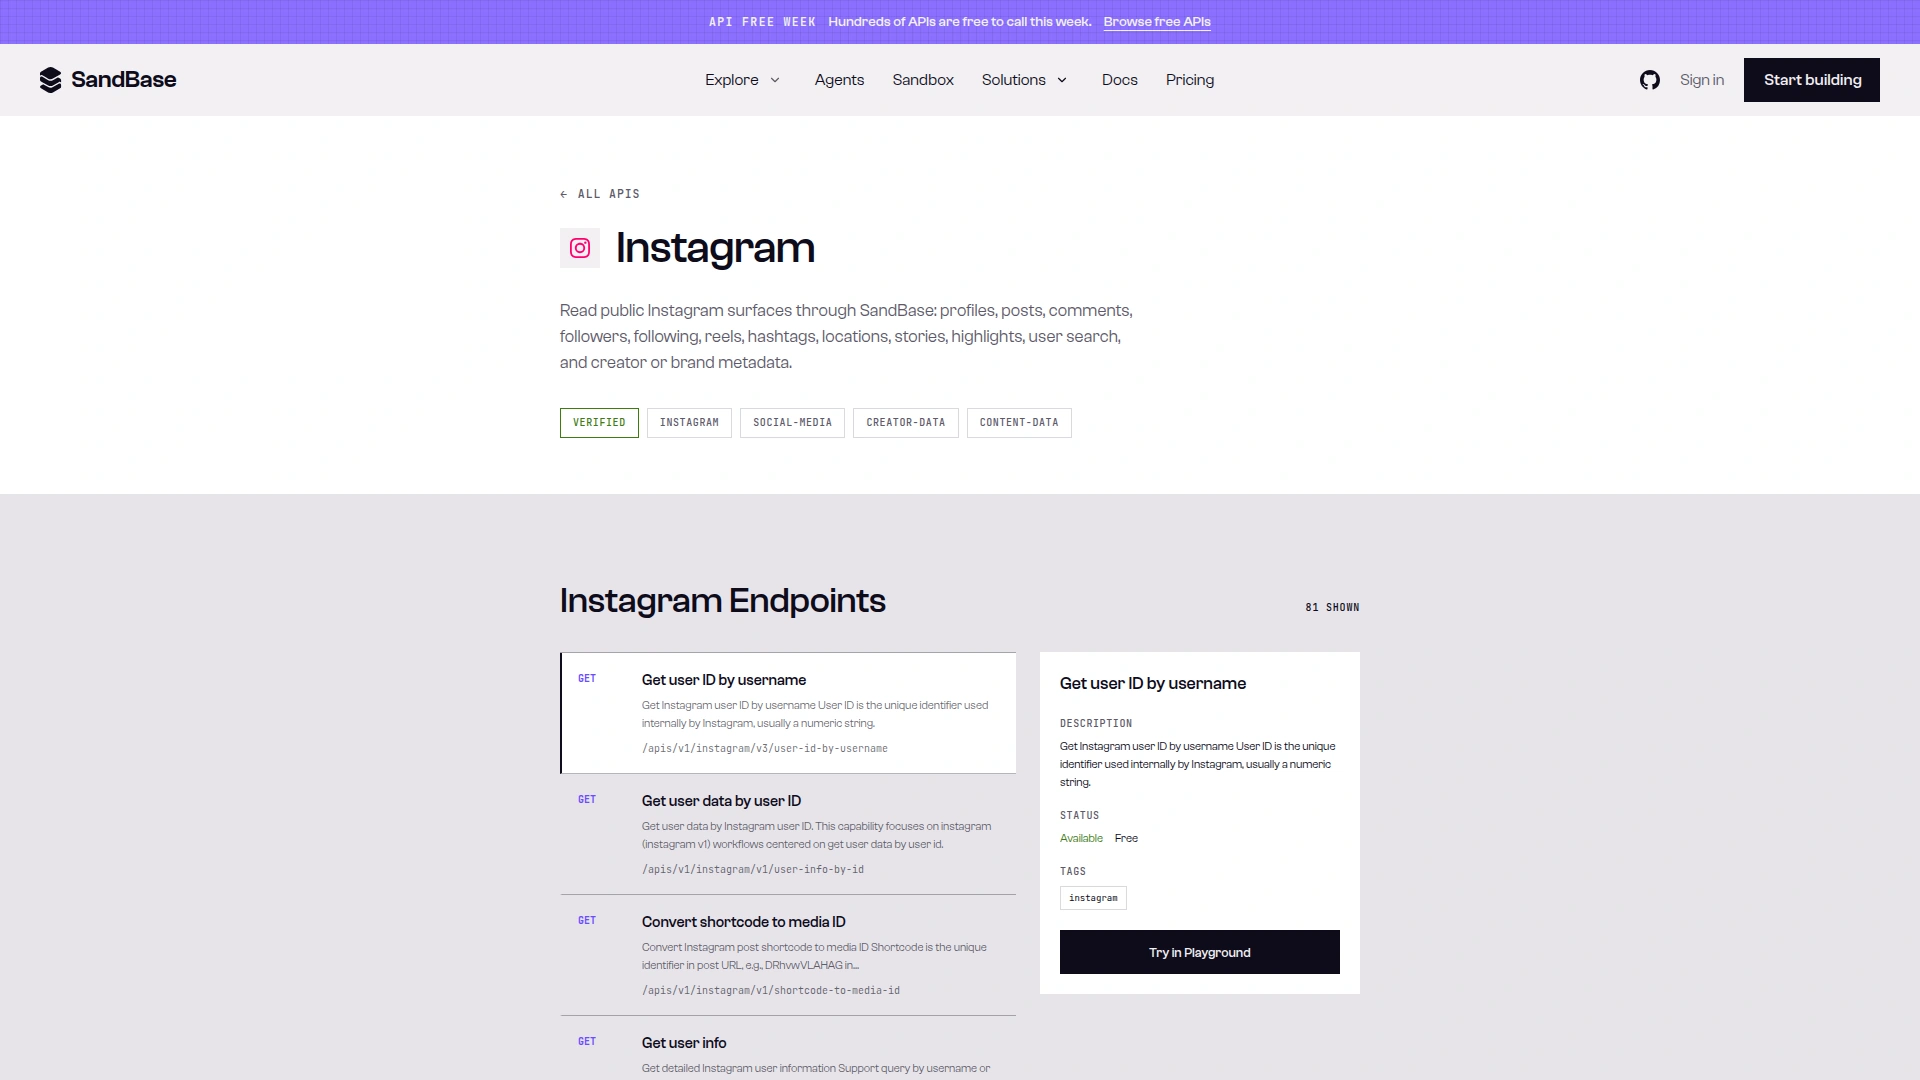
截图:SandBase Instagram 目录页列出 81 个端点,选中的 v3/user-id-by-username 卡片显示 Available 和 Free(2026-10-02 截取)。
为什么需要 Instagram 用户ID查询
大多数 Instagram 自动化任务需要数字用户ID,而不是人类可读的用户名。原因如下:
- 粉丝追踪:要监控粉丝数量的变化趋势,你需要目标账号的用户ID来持续查询粉丝列表。
- 内容排期:自动化工具在内部通过ID引用账号,即使用户输入的是用户名。
- 数据分析面板:跨账号聚合指标需要稳定的标识符——用户名可以修改,但ID不会变。
- 跨平台匹配:构建统一社交档案(Instagram + TikTok + YouTube)时,用户ID为每个平台提供稳定的锚点。
- AI Agent 工作流:监控竞争对手或追踪网红的 Agent 需要程序化的ID解析作为第一步。
Meta 的官方方式是 Business Discovery:拥有专业 Instagram 账号并持有访问令牌的已授权应用用户,可以查询 business_discovery.username(...),拿到另一个商业或创作者账号的ID。它不覆盖个人账号,并且需要先完成应用和授权配置。如果你只需要公开资料数据,SandBase 是更轻量的选择。
| SandBase(本文) | Meta Business Discovery | |
|---|---|---|
| 认证 | 一个 SandBase API Key | Meta 应用、专业 Instagram 账号、带权限的访问令牌 |
| 目标账号 | 端点能返回的公开账号 | 商业账号和创作者账号 |
| 数据 / 操作 | 只读的公开资料字段 | 在已授权应用内读取目标账号字段 |
| 局限 | 第三方端点,会出现上游错误(见下文) | Meta 应用审核、权限和速率限制 |
适用范围:公开、只读数据
这些端点只返回 Instagram 公开、只读的账号数据。调用需要 SandBase API Key,SandBase 不是 Meta 或 Instagram 的官方合作方。不提供私密账号、私信、账号所有者专属分析,也不支持发布或任何账号操作。
SandBase 提供什么
SandBase 提供统一的社交媒体数据API层,覆盖 Instagram、TikTok、抖音、YouTube 等平台。对于 Instagram 用户ID查询,本文使用两个接口:
| 方向 | 接口 | 说明 |
|---|---|---|
| 用户名 → ID | instagram/v3/user-id-by-username | 通过用户名获取数字用户ID |
| ID → 用户名 | instagram/v3/user-id-to-username | 通过数字用户ID获取当前 username(附带基础资料字段) |
两个接口调用方式相同,返回同样的 SandBase 信封(id、status、model、outputs[0].data)。下文还会提到两个相关接口:instagram/v1/user-info-by-id-v2 是 v3 解析不了某个ID时的备用接口;instagram/v1/user-info-by-id 返回的资料大得多,需要 v3 没有的字段时再用。
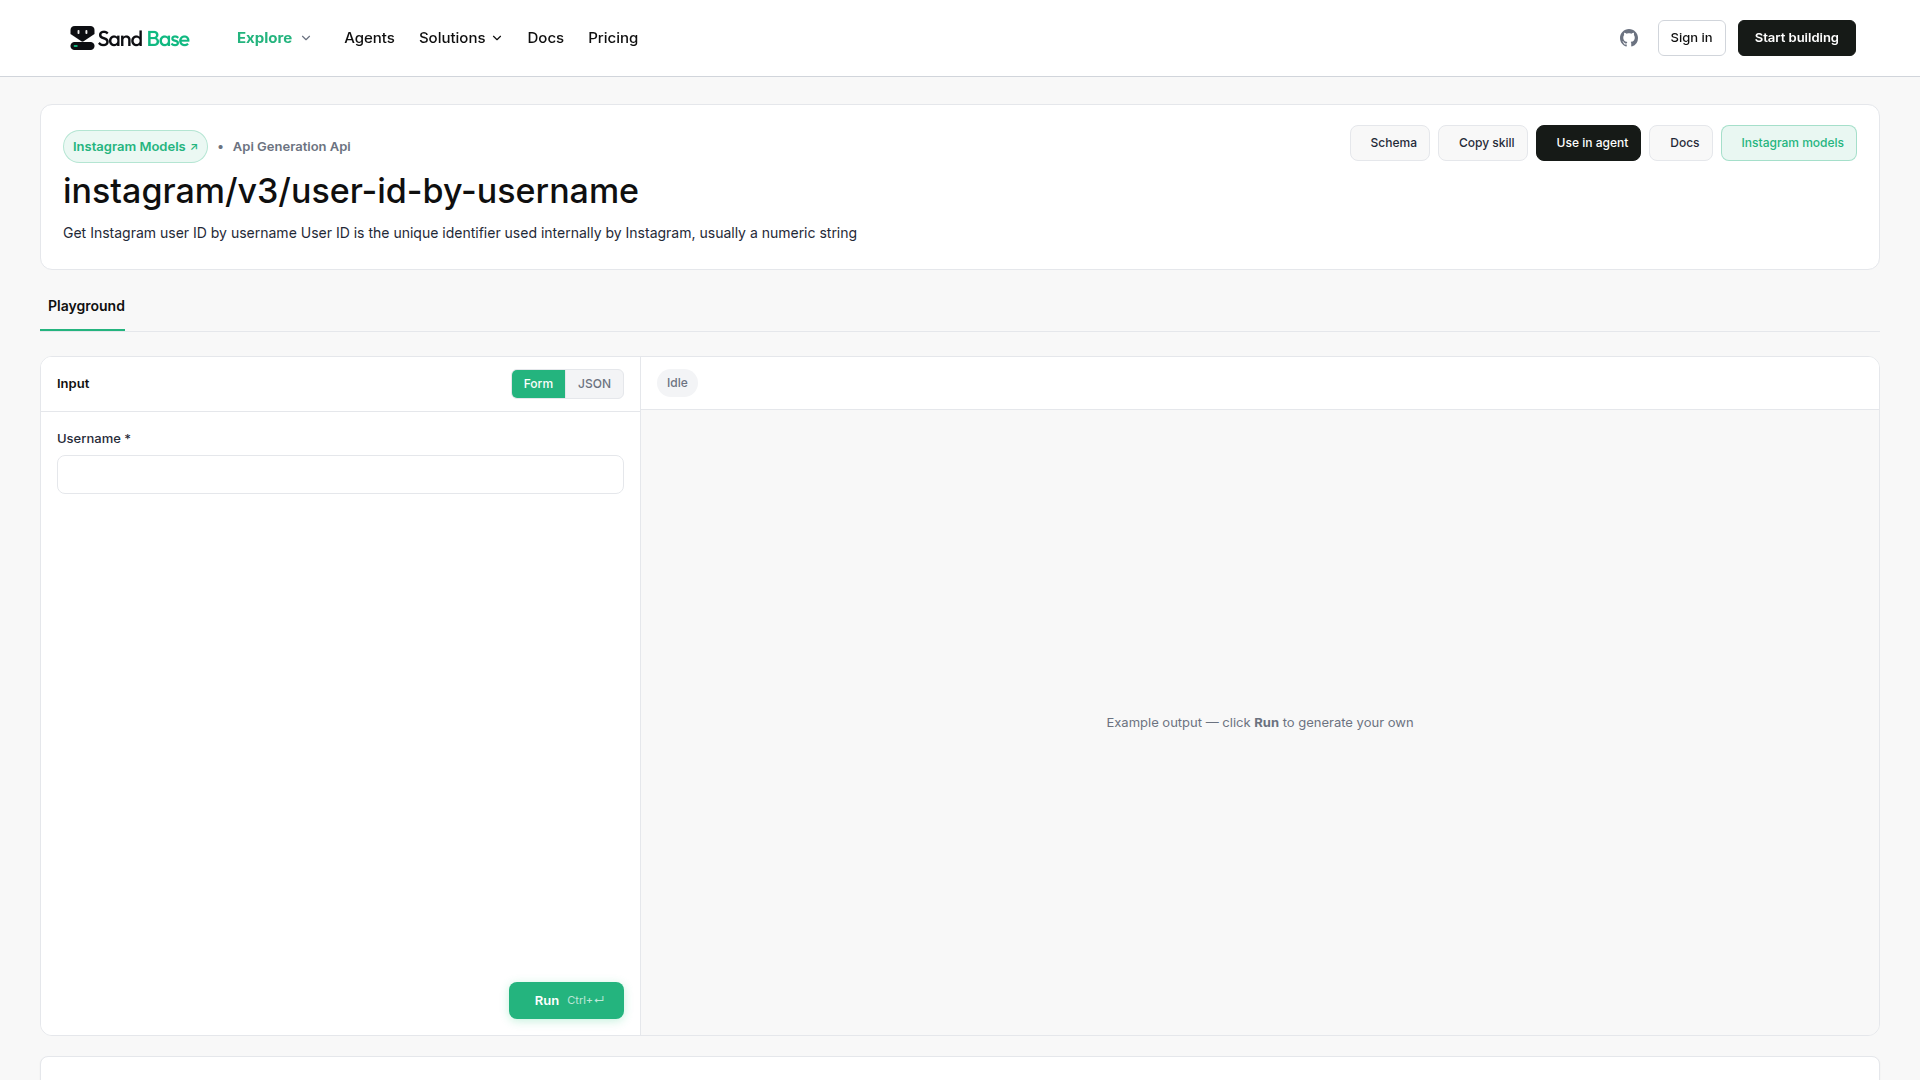
截图:较早截取的 instagram/v3/user-id-by-username 模型页,playground 只需填一个必填的 username;网站布局之后有调整,当前页面以下文 2026-10-02 截取的参考页为准。
开始使用
准备工作
- SandBase 账号(在 sandbase.ai 注册)
- 从控制面板获取 API Key,并导出为环境变量
SANDBASE_API_KEY - 安装 curl 或 Python(3.10+)
认证与调用方式
示例使用 Model API 路由:POST https://api.sandbase.ai/v1/api/<model>,Bearer Token 认证,参数放在 JSON 请求体中。这是端点参考页的调用面,不是目录页展示的 GET 路由;参考页生成的示例可能还带 model 字段,以参考页为准。
Authorization: Bearer $SANDBASE_API_KEY
Content-Type: application/json
参考文档把数据记录在 outputs[0].data;下面的 Python 辅助函数只读这个位置,调用未完成时抛出错误。请求 schema 见 user-id-by-username 参考和 user-id-to-username 参考。
user-id-by-username 参考页列出了下面 curl 示例用到的路由和唯一的必填字段 username。
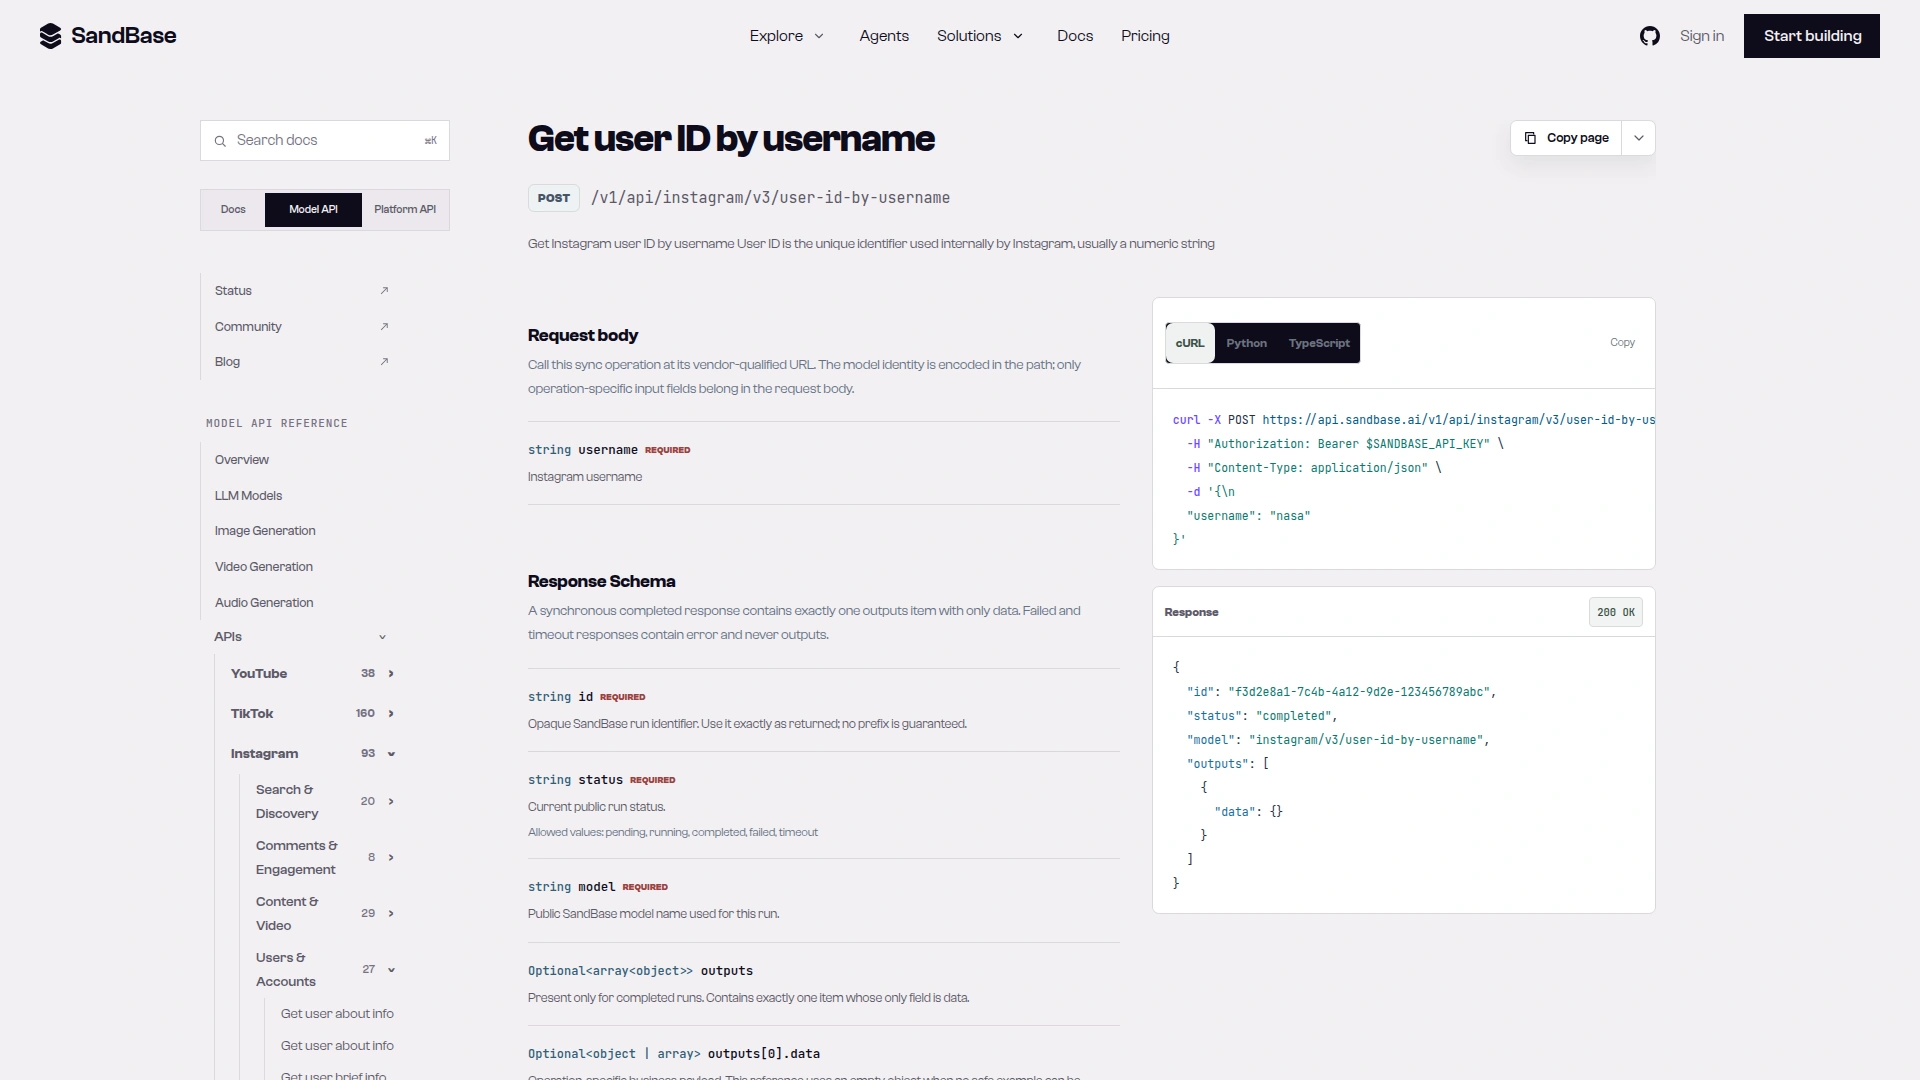
截图:instagram/v3/user-id-by-username 参考页记录了 POST /v1/api/instagram/v3/user-id-by-username、必填字符串 username,以及 id / status / model / outputs 响应结构(2026-10-02 截取)。
接口1:用户名查询用户ID
这是最常见的使用场景。你有一个 Instagram 用户名(如 natgeo 或 nike),需要获取对应的数字用户ID。
curl 示例
curl -X POST "https://api.sandbase.ai/v1/api/instagram/v3/user-id-by-username" \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"username": "natgeo"}'
响应示例
实测于 2026-10-01(UTC),使用国家地理的公开账号(natgeo)。上面的 curl 请求返回 HTTP 200,完整响应如下(run id 06c129cd-2779-4b5c-b409-b5137d2bd1d7):
{
  "id": "06c129cd-2779-4b5c-b409-b5137d2bd1d7",
  "status": "completed",
  "model": "instagram/v3/user-id-by-username",
  "outputs": [
    { "data": { "user_id": "787132" } }
  ]
}
user_id 字段名是我实测观察到的,不是文档保证。这个接口只返回ID;粉丝数等资料需要把ID传给接口2。
Python 示例
import os
import requests

API_KEY = os.environ["SANDBASE_API_KEY"]
BASE_URL = "https://api.sandbase.ai/v1/api"


def call_model(model: str, params: dict) -> dict:
    """POST 调用 SandBase 模型并返回 outputs[0].data。"""
    response = requests.post(
        f"{BASE_URL}/{model}",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json=params,
        timeout=120,
    )
    response.raise_for_status()
    body = response.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def get_user_id_by_username(username: str) -> str | None:
    """将 Instagram 用户名转换为数字用户ID。"""
    data = call_model("instagram/v3/user-id-by-username", {"username": username})
    return data.get("user_id")


# 使用示例
print(f"用户ID: {get_user_id_by_username('natgeo')}")
接口2:用户ID查询用户名
反向查询适用于你已存储用户ID(来自 webhook、数据库或其他API响应)并需要解析回可读用户名的场景。instagram/v3/user-id-to-username 只有一个必填参数 user_id,返回一份精简资料,当前的 username 就在 outputs[0].data 顶层。ID 要以字符串传入:2026-10-04 我发送 {"user_id": 787132}(JSON 数字),得到 HTTP 400,报错为 parameter validation failed: /user_id: expected string, but got number。
curl 示例
curl -X POST "https://api.sandbase.ai/v1/api/instagram/v3/user-id-to-username" \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"user_id": "787132"}'
响应示例
实测于 2026-10-04(UTC),使用接口1拿到的 natgeo 的ID 787132。上面的 curl 请求返回了已完成的响应,耗时 2.78 秒(run id 64abd76a-c4fe-4a0a-a3bf-7940cc058ba1)。data 里我省略了三个键(profile_pic_url、profile_pic_url_hd 和内部字段 _rid),其余内容与原始返回一致:
{
  "id": "64abd76a-c4fe-4a0a-a3bf-7940cc058ba1",
  "status": "completed",
  "model": "instagram/v3/user-id-to-username",
  "outputs": [
    {
      "data": {
        "biography": "Step into wonder and find your inner explorer with National Geographic 🌎",
        "category": "",
        "edge_follow": {"count": 194},
        "edge_followed_by": {"count": 268458203},
        "edge_owner_to_timeline_media": {"count": 32041},
        "external_url": "http://visitstore.bio/natgeo",
        "follower_count": 268458203,
        "following_count": 194,
        "full_name": "National Geographic",
        "id": "787132",
        "is_private": false,
        "is_verified": true,
        "media_count": 32041,
        "pk": "787132",
        "username": "natgeo"
      }
    }
  ]
}这些字段名是实测观察到的,不是文档契约。username 是当前用户名,id 和 pk 都是你传入的ID,粉丝数出现了两次:follower_count,以及 edge_followed_by 里的 count。
Python 示例
这里复用接口1的 call_model。get_profile_by_id 读取用户名和下文粉丝追踪器要用的字段;confirm_missing 用来在 v3 拒绝某个ID时做二次确认。
def get_profile_by_id(user_id: str) -> dict:
    """将数字用户ID解析为当前用户名和基础资料字段。"""
    data = call_model("instagram/v3/user-id-to-username", {"user_id": str(user_id).strip()})
    return {
        "user_id": data.get("id", user_id),
        "username": data.get("username"),
        "full_name": data.get("full_name"),
        "is_verified": data.get("is_verified"),
        "follower_count": data.get("follower_count"),
    }


def confirm_missing(user_id: str) -> str | None:
    """询问 instagram/v1/user-info-by-id-v2:账号不存在时它会直接说明,而不是返回 503。"""
    data = call_model("instagram/v1/user-info-by-id-v2", {"user_id": str(user_id).strip()})
    return data.get("errorMessage")


# 使用示例
profile = get_profile_by_id("787132")
print(f"用户名: {profile['username']}({profile['follower_count']:,} 粉丝)")

unknown = "99999999999999999"
try:
    get_profile_by_id(unknown)
except requests.HTTPError as e:
print(f"v3 返回 HTTP {e.response.status_code};备用接口回答: {confirm_missing(unknown)}")2026-10-04(UTC)与接口1的代码块一起运行,call_model 来自接口1,第一行也是它打印的。787132 的 v3 查询耗时 4.98 秒(run id 378e7f16-96e5-4c4d-b8db-924fcdcfcb82);不存在的ID在 2.32 秒后收到 v3 的 HTTP 503,没有 run id;备用接口用 4.04 秒给出回答(run id 28244cf2-6508-4e4c-9fee-25308291e2aa):
用户ID: 787132
用户名: natgeo(268,458,146 粉丝)
v3 返回 HTTP 503;备用接口回答: This account does not exist.
未知ID与备用接口
ID 不对的时候,instagram/v3/user-id-to-username 不会告诉你。在 2026-10-04 的 Instagram ID 查用户名实测里,不存在的ID、前后带空格的ID、非数字和空字符串,统统返回 HTTP 503,附带同一句笼统的上游报错,和上游临时故障时的状态码一模一样。所以调用前先去掉空白、确认ID全是数字;同一个ID反复 503,就用 instagram/v1/user-info-by-id-v2 确认一次。对上面 Python 示例里的那个不存在的ID,它返回 HTTP 200 和一个已完成的 run,数据里直接写明了原因。完整响应如下(run id 28244cf2-6508-4e4c-9fee-25308291e2aa):
{
  "id": "28244cf2-6508-4e4c-9fee-25308291e2aa",
  "status": "completed",
  "model": "instagram/v1/user-info-by-id-v2",
  "outputs": [
    {
      "data": {
        "errorMessage": "This account does not exist.",
        "status": false
      }
    }
  ]
}
instagram/v1/user-info-by-id 是本文旧版在这一步用的接口。它现在仍然可用,请求体同样只有一个字段,但返回的资料要大得多,只有在需要 v3 没有返回的资料字段时才值得用它。它的参考页里唯一的必填字段是 user_id:
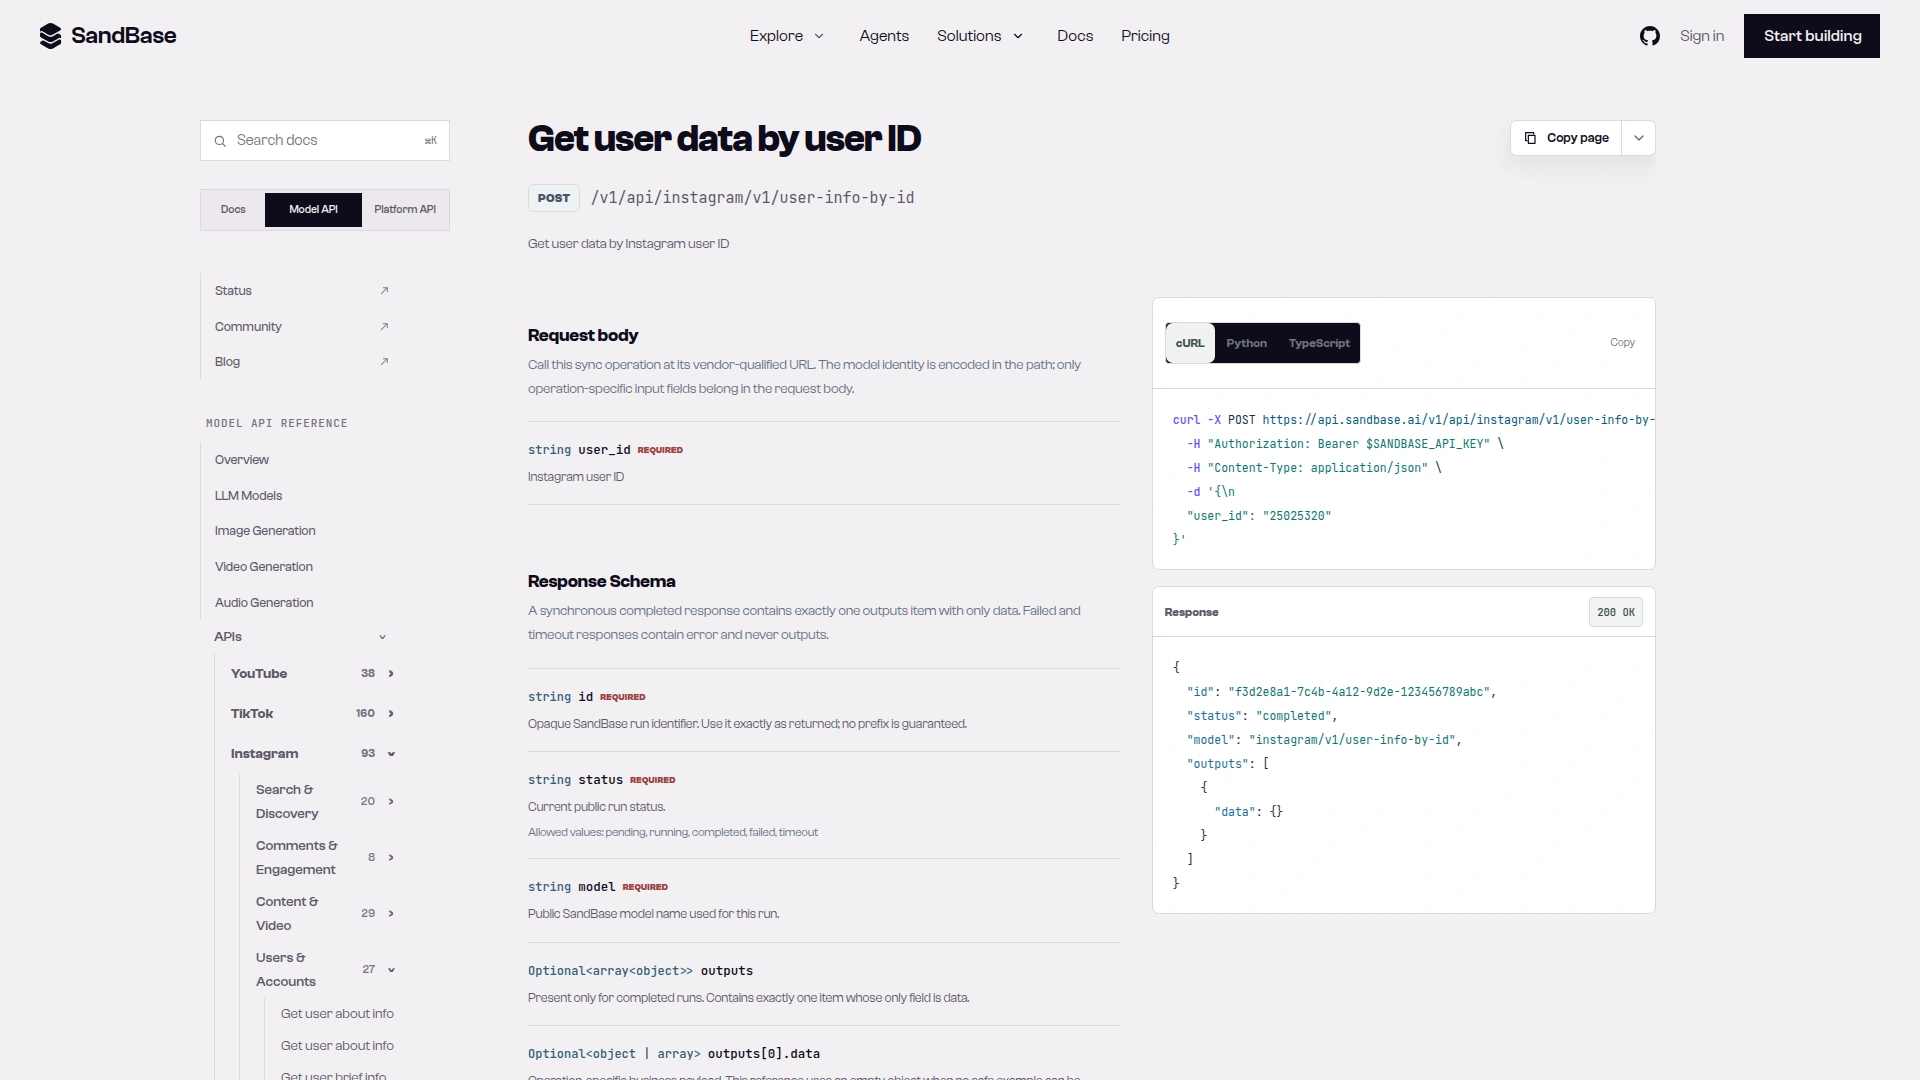
截图:instagram/v1/user-info-by-id 参考页记录了 POST /v1/api/instagram/v1/user-info-by-id 和必填字符串 user_id;自 2026-10-04 起,本文只把它当作比 v3/user-id-to-username 返回字段更多的替代接口(2026-10-02 截取)。
实战案例:构建粉丝追踪 Agent
让我们将以上内容整合到一个更实际的场景中。假设你正在构建一个 AI Agent,收集一组竞争对手账号的粉丝数量。每个账号需要两次调用:先用 instagram/v3/user-id-by-username 把用户名转成ID,再用 instagram/v3/user-id-to-username 把ID转成资料,后者在当前用户名旁边直接给出 follower_count。detect_changes 会把本次结果和你自己保存的上一次快照做比较;加载快照和发送告警由你的应用实现。
import os
import json
from datetime import datetime, timezone

import requests

API_KEY = os.environ["SANDBASE_API_KEY"]
BASE_URL = "https://api.sandbase.ai/v1/api"

TRACKED_ACCOUNTS = ["nike", "adidas", "puma", "newbalance"]


def call_model(model: str, params: dict) -> dict:
    """POST 调用 SandBase 模型并返回 outputs[0].data。"""
    response = requests.post(
        f"{BASE_URL}/{model}",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json=params,
        timeout=120,
    )
    response.raise_for_status()
    body = response.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def get_user_id_by_username(username: str) -> str | None:
    data = call_model("instagram/v3/user-id-by-username", {"username": username})
    return data.get("user_id")


def get_profile_by_id(user_id: str) -> dict:
    data = call_model("instagram/v3/user-id-to-username", {"user_id": str(user_id).strip()})
    return {
        "user_id": data.get("id", user_id),
        "username": data.get("username"),
        "full_name": data.get("full_name"),
        "is_verified": data.get("is_verified"),
        "follower_count": data.get("follower_count"),
    }


def collect_follower_data(usernames: list) -> list:
    """收集一组用户名的粉丝数据。"""
    results = []
    for username in usernames:
        try:
            user_id = get_user_id_by_username(username)
            if not user_id:
                print(f"{username} 没有返回用户ID")
                continue
            profile = get_profile_by_id(user_id)
            results.append({
                "username": profile["username"] or username,
                "user_id": user_id,
                "follower_count": profile["follower_count"],
                "timestamp": datetime.now(timezone.utc).isoformat(),
            })
        except (requests.RequestException, RuntimeError) as e:
            print(f"获取 {username} 数据时出错: {e}")
    return results


def detect_changes(current: list, previous: list, threshold: float = 0.01) -> list:
    """检测粉丝数的显著变化(默认阈值:1%)。"""
    alerts = []
    prev_map = {item["username"]: item["follower_count"] for item in previous}

    for item in current:
        username = item["username"]
        old_count = prev_map.get(username)
        new_count = item["follower_count"]
        if not old_count or new_count is None:
            continue
        change_pct = (new_count - old_count) / old_count
        if abs(change_pct) >= threshold:
            alerts.append({
                "username": username,
                "old_count": old_count,
                "new_count": new_count,
                "change_pct": round(change_pct * 100, 2),
            })
    return alerts


# 运行追踪器
if __name__ == "__main__":
    current_data = collect_follower_data(TRACKED_ACCOUNTS)

    # 生产环境中,从数据库加载历史数据
    # previous_data = load_from_db()
    # alerts = detect_changes(current_data, previous_data)

    print(json.dumps(current_data, indent=2, ensure_ascii=False))
2026-10-04(UTC)运行时,追踪器共调用 8 次,总耗时 15.1 秒,其中每次 v3 ID → 资料调用耗时 2.5 到 3.2 秒。完整输出如下:
[
  {
    "username": "nike",
    "user_id": "13460080",
    "follower_count": 291055106,
    "timestamp": "2026-10-04T06:26:57.663460+00:00"
  },
  {
    "username": "adidas",
    "user_id": "20269764",
    "follower_count": 29735718,
    "timestamp": "2026-10-04T06:27:01.172656+00:00"
  },
  {
    "username": "puma",
    "user_id": "10145706",
    "follower_count": 12939660,
    "timestamp": "2026-10-04T06:27:04.949282+00:00"
  },
  {
    "username": "newbalance",
    "user_id": "204654945",
    "follower_count": 9343850,
    "timestamp": "2026-10-04T06:27:08.939316+00:00"
  }
]这种模式适合作为定时任务,或作为更大型的使用 OpenAI SDK 构建的社交监控 Agent 的一部分。
批量处理:多用户名解析
当需要同时解析多个用户名时,添加基本的限流和错误处理。这里复用上文的 get_user_id_by_username 和 get_profile_by_id:
import time

def batch_resolve_usernames(usernames: list, delay: float = 0.5) -> dict:
    """批量解析用户名到用户ID,含限流处理。"""
    results = {}
    for username in usernames:
        try:
            user_id = get_user_id_by_username(username)
            if not user_id:
                results[username] = {"error": "no user_id returned"}
                continue
            profile = get_profile_by_id(user_id)
            results[username] = {
                "user_id": user_id,
                "full_name": profile["full_name"],
                "follower_count": profile["follower_count"],
            }
        except (requests.RequestException, RuntimeError) as e:
            results[username] = {"error": str(e)}
        time.sleep(delay)  # 遵守速率限制
    return results


# 解析10个账号
accounts = ["nike", "adidas", "puma", "newbalance", "underarmour",
            "reebok", "asics", "fila", "converse", "vans"]
resolved = batch_resolve_usernames(accounts)

for username, info in resolved.items():
    if "error" not in info:
        count = info["follower_count"]
        shown = f"{count:,}" if isinstance(count, int) else "n/a"
        print(f"@{username} → ID: {info['user_id']} ({shown} 粉丝)")
我在 2026-10-04(UTC)接在接口1、接口2的代码块后面运行了这段代码,前两段会先打印自己的几行。下面是批量循环打印的内容:
@nike → ID: 13460080 (291,055,093 粉丝)
@adidas → ID: 20269764 (29,735,717 粉丝)
@puma → ID: 10145706 (12,939,660 粉丝)
@newbalance → ID: 204654945 (9,343,851 粉丝)
@underarmour → ID: 5858873 (8,138,098 粉丝)
@reebok → ID: 186499819 (4,367,343 粉丝)
@asics → ID: 242236354 (1,508,211 粉丝)
@converse → ID: 6716197 (10,245,903 粉丝)
@vans → ID: 18919774 (15,655,816 粉丝)
10 个账号解析成功 9 个,每次 v3 ID → 资料调用耗时 2.5 到 2.9 秒。fila 没有出现,是因为 instagram/v3/user-id-by-username 返回了一个已完成的 run,但ID为空({"user_id": ""},run id 667dff6c-d73a-4678-afca-e1f6c6f37eec),于是 if not user_id 分支把它记成了错误;原因我没有深究。英文版的同一轮测试里第一次运行因为本地网络的连接重置而中断,except (requests.HTTPError, RuntimeError) 接不住这种异常,所以本文两个循环现在都捕获 requests.RequestException,它同时覆盖 HTTP 错误和连接错误。
结合其他社交平台API
SandBase 的优势之一是其统一的社交媒体数据处理方式。你可以将 Instagram 用户ID查询与其他平台的API结合使用,构建跨平台用户档案。
例如,如果你正在构建一个多平台网红数据库,可以:
- 通过
instagram/v3/user-id-by-username解析 Instagram 用户名 → 用户ID - 查询抖音用户搜索API,找到同一创作者在国内平台的账号
- 拉取 TikTok 个人资料数据,获取全球短视频平台信息
- 将所有数据合并为统一档案,每个平台使用各自的稳定ID
这种跨平台方法对处理社交媒体数据的 AI Agent 特别有用,Agent 需要在多个数据源之间建立一致的身份层。抖音这一侧可以看抖音用户搜索 API 教程。
错误处理最佳实践
下面的处理逻辑是通用的应用层做法,不是该端点的错误契约。代码之后列出了我实际观察到的状态码。
import time

def safe_lookup(username: str, retried: bool = False) -> str | None:
    """带基本 HTTP 错误处理的用户名查询。"""
    try:
        return get_user_id_by_username(username)
    except requests.HTTPError as e:
        status = e.response.status_code
        if status == 401:
            print("API Key 无效——请检查你的凭证")
        elif status == 429 and not retried:
            print("触发速率限制——等待后重试一次")
            time.sleep(60)
            return safe_lookup(username, retried=True)
        elif status in (500, 502, 503) and not retried:
            print(f"上游/服务端错误 {status}——重试一次")
            time.sleep(5)
            return safe_lookup(username, retried=True)
        elif status == 503:
            print(f"@{username} 再次返回上游错误——账号可能不存在,或上游暂时故障")
        else:
            print(f"未知错误: {e}")
    except RuntimeError as e:
        print(e)
    return None
我在 2026-10-01(UTC)调用 instagram/v3/user-id-by-username 时观察到:
- 401:无效的 API Key 返回 HTTP 401,内容为
{"error": "invalid API key"}。 - 503:上游失败以 HTTP 503 返回,带
error信息、没有 run id。真实账号偶发这种情况(14 个账号的一轮里出现几次),重试通常能成功。不存在的用户名同样返回 HTTP 503,而不是 404,所以同一个用户名反复 503 可能意味着账号不存在。 - 429:我没有触发速率限制;退避分支是通用做法。
2026-10-04(UTC)的 instagram/v3/user-id-to-username 也是同样的表现:对不存在的ID 99999999999999999 的调用全部返回 HTTP 503,没有 run id,报错为 upstream error 400: Request failed. Please retry.,并注明这次请求不收费。如何用 instagram/v1/user-info-by-id-v2 确认账号是否存在,见接口2。这次刷新调用了 70 次以上 Instagram 接口,同样没有触发速率限制。
生产环境使用建议
- 积极缓存:用户ID不会改变。一旦解析了用户名 → ID的映射,就存储到本地。
- 处理用户名变更:用户名可以修改,但ID是永久的。使用ID作为主键。
- 非高峰时段批量处理:如果需要解析数百个账号,在低流量时段运行批量任务。
- 监控使用量:在 SandBase 控制面板查看额度使用情况。
- 自己安排调度:这里的两个端点只是普通的读取调用。定时任务、webhook 和告警是你在自己的应用里围绕它们搭建的模式。
总结
在 Instagram 用户名和用户ID之间进行转换是几乎所有 Instagram 自动化工作流的基础步骤。SandBase 用两个接口完成这一步:
instagram/v3/user-id-by-username— 解析用户名到数字IDinstagram/v3/user-id-to-username— 解析ID回当前用户名 + 基础资料信息
如果 v3 对某个ID反复返回 503,可以用 instagram/v1/user-info-by-id-v2 确认账号是否存在。批量转换已存储的ID、以及完整的边界情况,见 Instagram ID 查用户名教程。
无论你是在构建粉丝追踪 Agent、社交媒体数据面板,还是跨平台网红数据库,这些接口都能提供你所需的稳定标识符来构建可靠的自动化系统。
准备开始了吗?注册 SandBase API Key,打开 user-id-by-username 和 user-id-to-username API 参考,然后尝试上面的示例。如需更高级的工作流,请查看我们关于使用 OpenAI SDK 构建社交监控 Agent 的指南。