为什么数据 API 默认应该是 sync-only
工程观点文章:为什么同步请求-响应是 AI Agent 调用数据 API 的正确默认。含实测示例、取舍分析、架构影响和 async 真正必要的场景。
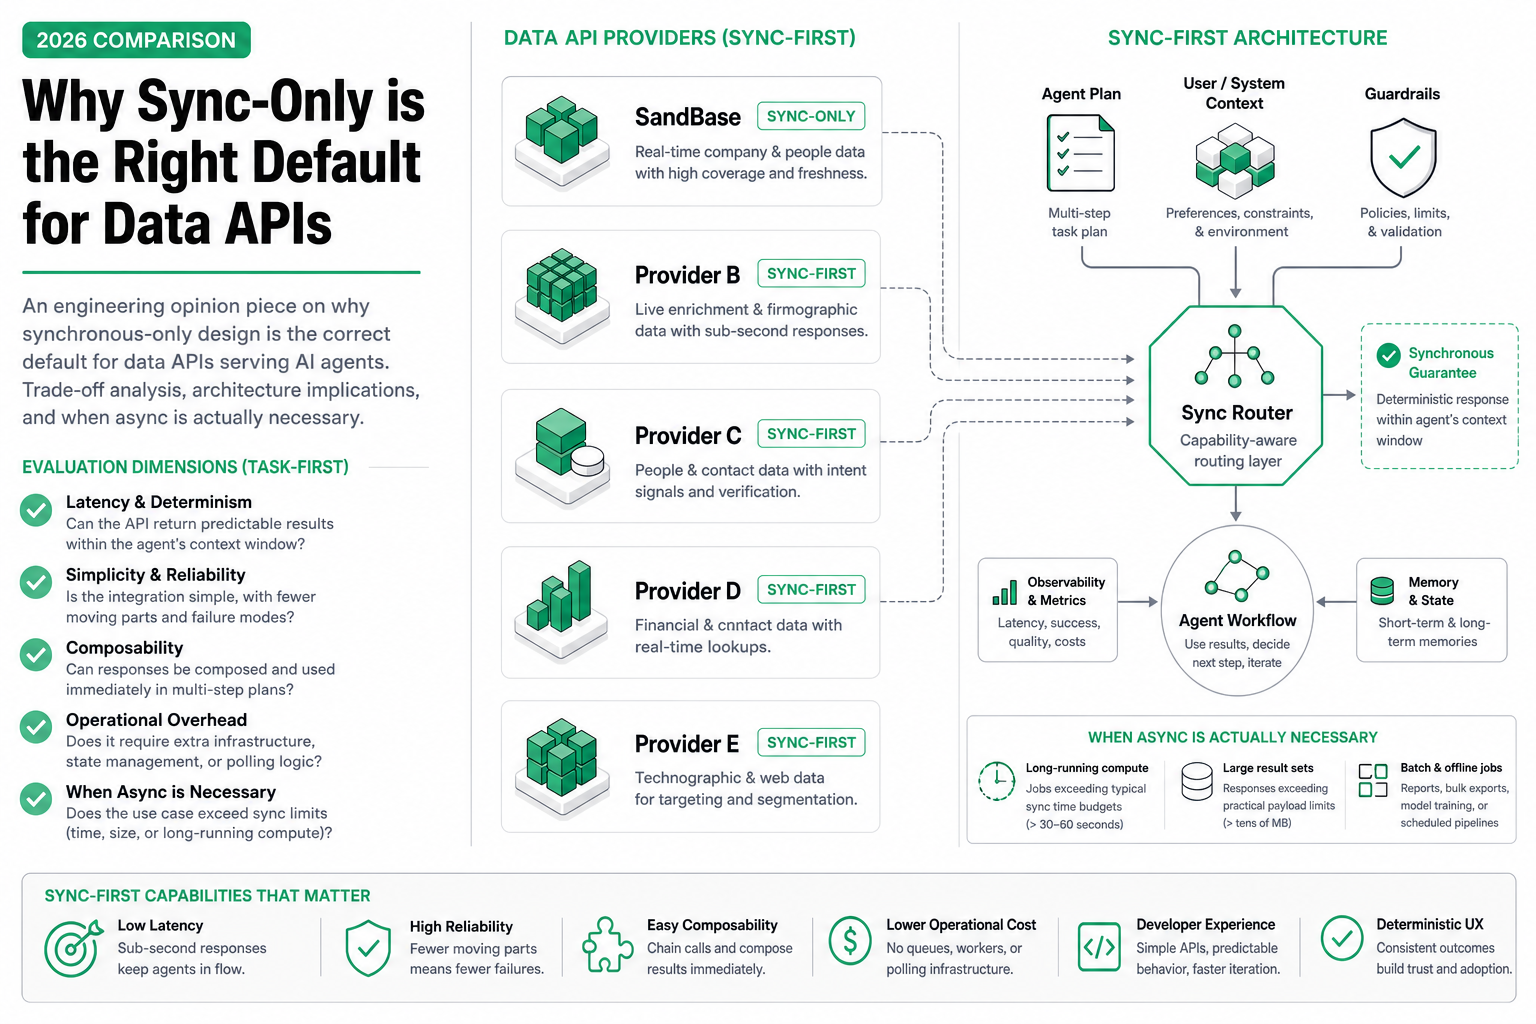
先说结论 — 本文实测的 SandBase 数据端点
douyin/app-v3/user-profile在参考页里声明execution_mode: sync,标注日期的样本也都在一次请求内完成。我们认为数据检索默认应该是 sync:简化 Agent 集成、去掉状态管理、匹配阻塞式 LLM 工具调用循环的工作方式。生成类任务可能是异步的,请查看所选模型的execution_mode和端点参考。本文是观点文章,文中唯一的测量数据是一个小样本,出现处会写明日期和条件。
观点,明确表达
对被 AI Agent 消费的数据 API,同步请求-响应是正确默认。 不是因为 async 不好,而是 sync 去掉了 Agent 不需要的一整类集成复杂度,这些复杂度在可靠性、可调试性和开发速度上有真实成本。
这是我们在 SandBase 上构建和运营社媒数据端点、观察 Agent 开发者如何集成时形成的工程观点。我们的印象是 sync 端点更容易接入、也更容易调试。这一点没有做过对照研究,请把它当经验,而不是数据。
先说清调用面,因为它决定了下文证据的含义。本文所有示例和测量都用数据 API 路由 POST https://api.sandbase.ai/v1/api/<vendor>/<path>,具体是 douyin/app-v3/user-profile。后文提到的生成任务(图片、视频、音频)走的是另一个 Model API 调用面 /v1/run,文档单独描述。这里测到的东西都不适用于 /v1/run。
LLM 工具调用的实际工作方式
讨论 API 设计前,先理解消费者的执行模型。
在常见的阻塞式工具循环里(大多数 LLM API 提供的 function calling),流程是:
1. LLM 生成工具调用:{"name": "get_user", "args": {"id": "123"}}
2. 运行时执行函数
3. 运行时将结果返回 LLM
4. LLM 带着结果继续推理
从 LLM 视角看,这是同步的。模型生成调用、暂停、收到结果、继续。这个循环本身没有内置这些步骤:
- 「给你一个 task ID,稍后轮询」
- 「准备好了会调你的 webhook」
- 「30 秒后再来看」
你可以在工具调用之上用客户端管理的后台编排实现这些模式。但每加一层 async,都变成 Agent 开发者必须管理的复杂度:
# Sync 在 Agent 工具中的样子(SandBase 数据 API 路由)
import os
import requests

SANDBASE_API_KEY = os.environ["SANDBASE_API_KEY"]

def get_douyin_user(sec_user_id: str) -> dict:
    resp = requests.post(
        "https://api.sandbase.ai/v1/api/douyin/app-v3/user-profile",
        headers={"Authorization": f"Bearer {SANDBASE_API_KEY}"},
        json={"sec_user_id": sec_user_id},
        timeout=30,
    )
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}
# 完事。LLM 立刻拿到结果。# 假想的 async 设计长这样(仅作对比,不是 SandBase 路由)
def get_douyin_user(sec_user_id: str) -> dict:
task = api.post("/hypothetical-async/user-profile", json={"sec_user_id": sec_user_id})
task_id = task.json()["task_id"]
# 现在怎么办?LLM 在等着。
# 方案 A:循环轮询(阻塞、浪费)
for _ in range(30):
result = api.get(f"/tasks/{task_id}")
if result.json()["status"] == "complete":
return result.json()["data"]
time.sleep(1)
raise TimeoutError("任务 30 秒未完成")
# 方案 B:把 task_id 返回给 LLM(令人困惑)
# LLM:「我拿到了一个 task_id,但我需要实际数据……」
# 现在需要另一次工具调用来检查状态Async 版本代码更多,引入了新的故障模式(超时、丢失任务、部分结果),也不匹配阻塞式工具循环。
实测于 2026-10-01(UTC)
公开资源:人民日报抖音官方账号,sec_user_id 为 MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4。前提:SANDBASE_API_KEY 里有 SandBase API key。请求:
curl -s -X POST https://api.sandbase.ai/v1/api/douyin/app-v3/user-profile \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"sec_user_id": "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4"}'
截短后的真实响应(run id 1265e649-243c-49be-93d3-9f0c3f486eb2;删掉了信封的 id 字段、user 的大部分字段和 extra / log_pb 对象):
{
  "status": "completed",
  "model": "douyin/app-v3/user-profile",
  "outputs": [{
    "data": {
      "status_code": 0,
      "user": {
        "nickname": "人民日报",
        "unique_id": "rmrbxmt",
        "enterprise_verify_reason": "人民日报官方账号",
        "follower_count": 203210829,
        "aweme_count": 12276
      }
    }
  }]
}信封(id、status、model、outputs)是端点参考文档记录的结构。负载字段(user、nickname、follower_count 等)只是实测观察,不是文档保证。这是公开、只读的主页数据;SandBase 不是抖音的官方合作方。
就这个公开主页场景而言:
SandBase douyin/app-v3/user-profile | 抖音开放平台 | |
|---|---|---|
| 数据范围 | 公开账号的公开、只读主页数据 | 已授权你应用的账号的数据 |
| 鉴权 | 一个 SandBase API Key(Bearer) | 开发者注册并创建应用,账号数据还需用户授权 |
| 操作 | 无,只读 | 针对已授权账号的账号关联操作,以平台文档为准 |
| 关系 | SandBase 不是抖音的官方合作方 | 抖音自己的开发者平台 |
| 适用场景 | 读取公开主页,即上面的实测 | 处理自有账号或已授权你应用的账号 |
Sync 合约
本文实测的端点形状很简单:
请求                 → 服务端获取数据 → 响应
POST /v1/api/<model>                 → JSON 信封或错误
douyin/app-v3/user-profile 声明的和实测观察到的:
- 声明为 sync: 端点参考写明
execution_mode: sync - 样本里只等一次: 下文标注日期的样本中,每次调用都在一次请求内返回
completed和完整结果;超时由客户端设定 - 客户端无需追踪任务: 那批样本里没有需要轮询的情况;响应里的
id是 run id,不是需要回头查询的句柄 - 可重试: 失败时,用相同参数重试相同请求
- 可观测: 延迟 = 请求到响应的时间,客户端这边没有隐藏队列
同一端点的公开模型页上也能直接看到 sync 声明。
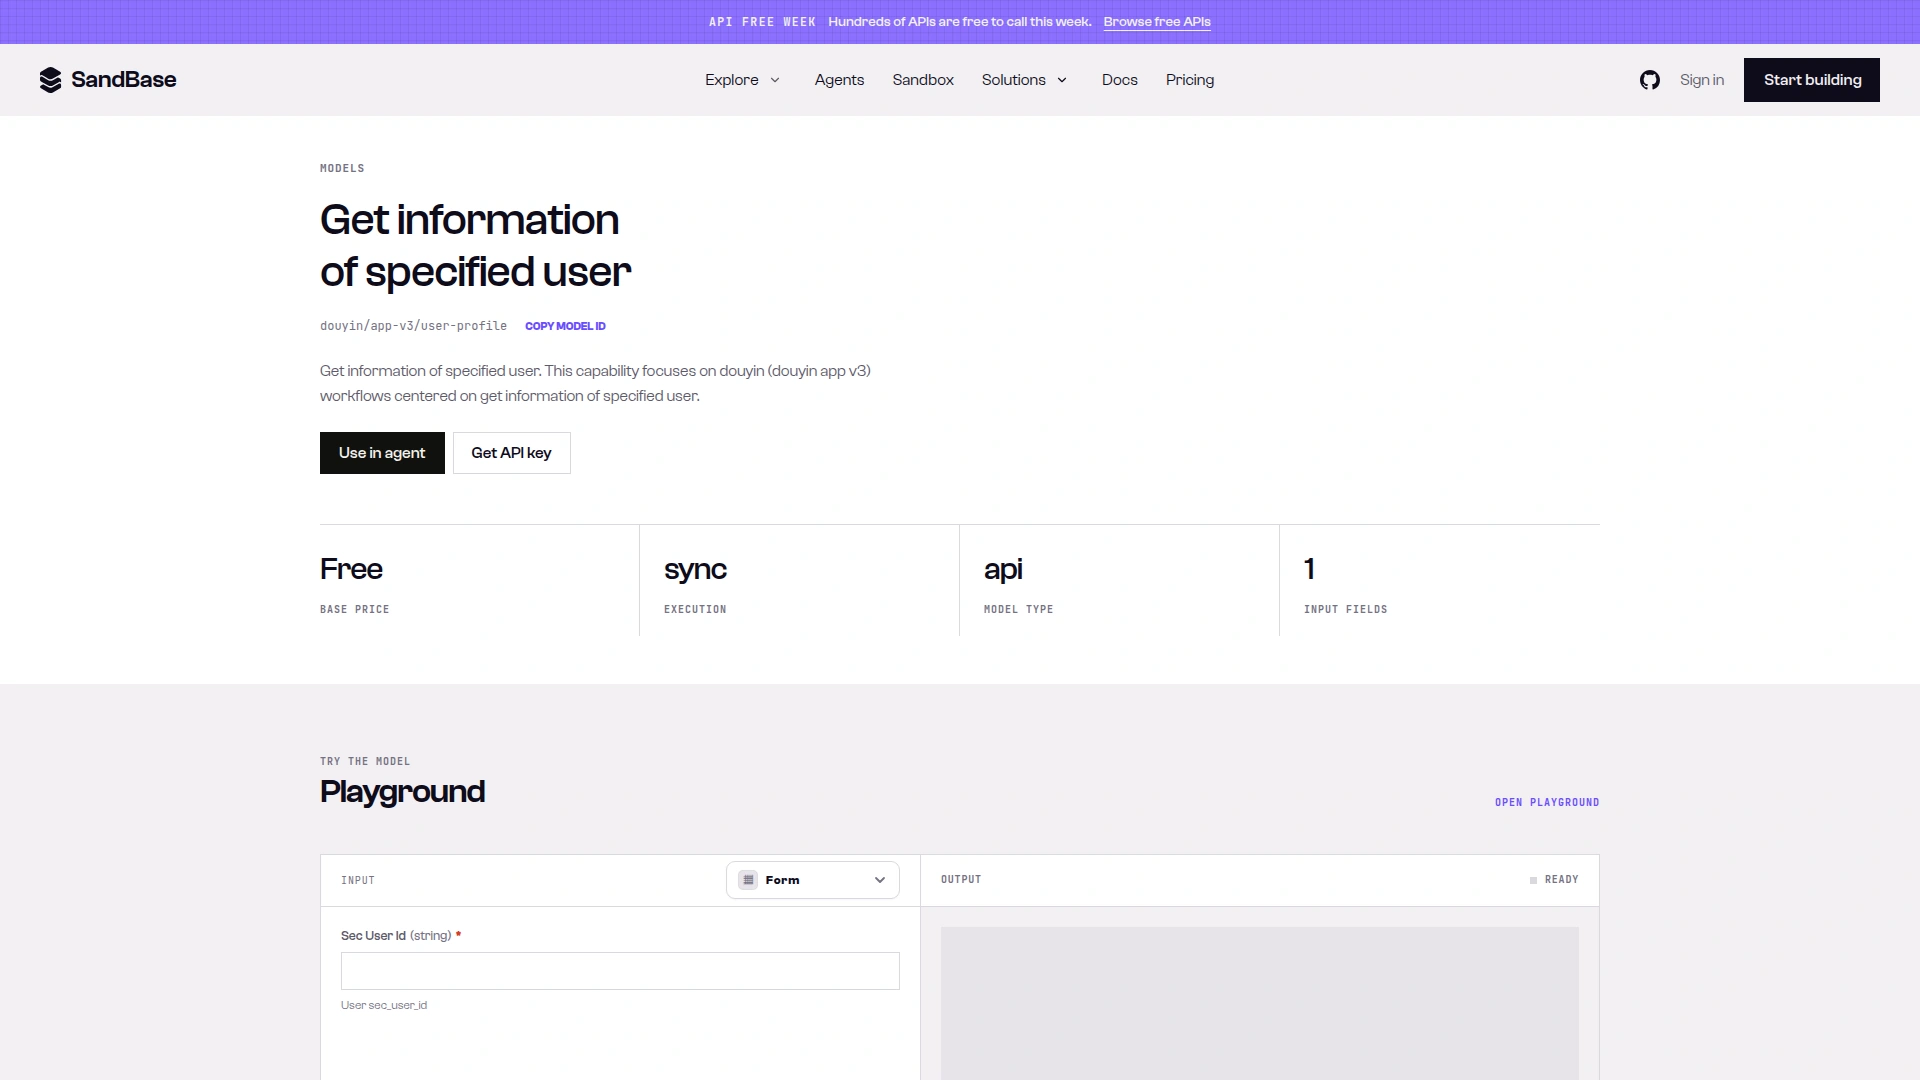
截图:douyin/app-v3/user-profile 模型页显示执行方式「sync」、基础价格「Free」和一个输入字段(2026-10-02 截取)。Free 是 API Free Week 期间的标价,活动已结束;数据 API 现在每个组织每天在符合条件的 API 上有 100 次免费调用,超出后按次计费。
同一个参考页也列出了通用的运行状态 pending、running、completed、failed、timeout,并给出了 pending 和 running 的示例。所以不要把「sync」当成「不会出现非终态」的承诺。本文的代码已经做了防御:只要状态不是 completed(或 outputs 为空)就抛错,没跑完的任务会以错误的形式暴露出来,而不会被当成数据。
这组状态值就写在端点参考页的响应 schema 里。
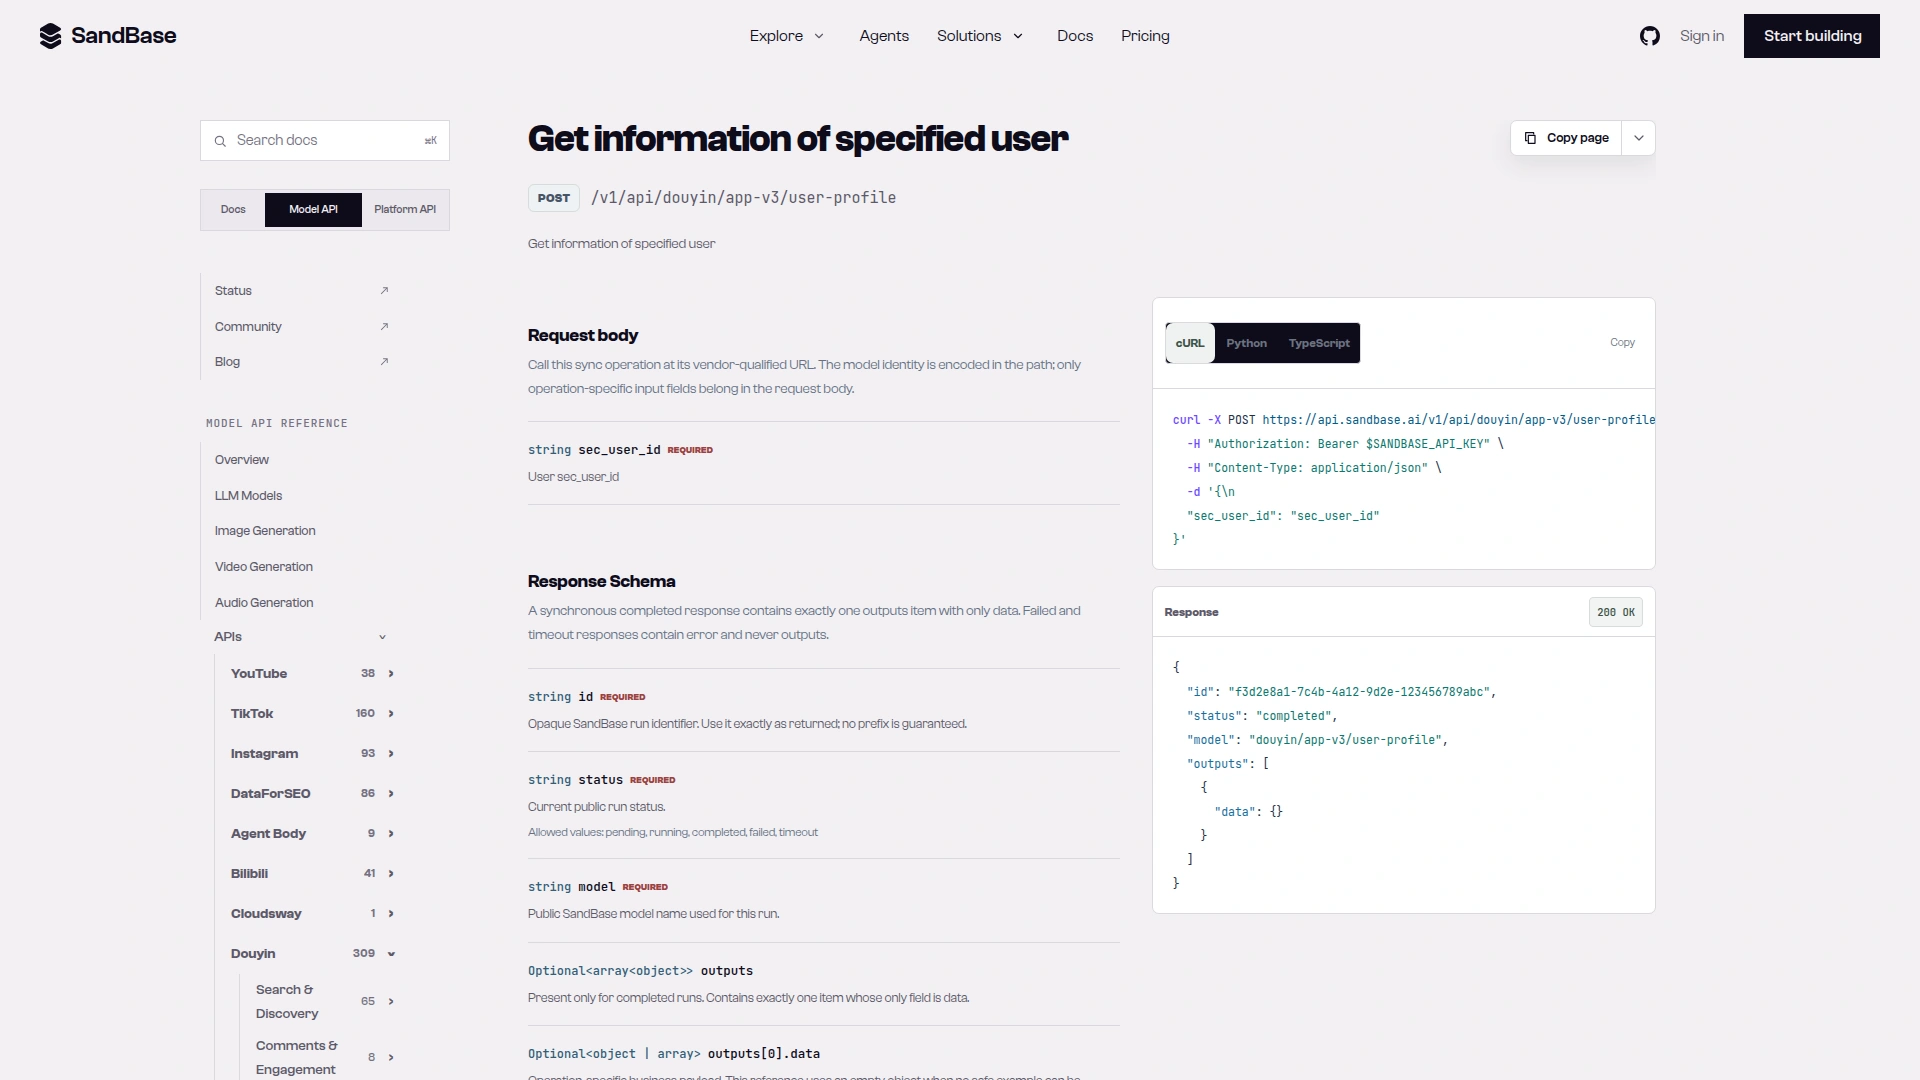
截图:douyin/app-v3/user-profile 参考页显示 POST /v1/api/douyin/app-v3/user-profile、一个必填的 sec_user_id 字段,以及 status 的可取值 pending、running、completed、failed、timeout(2026-10-02 截取)。
等多久取决于端点和上游。我们没有为数据端点公布延迟保证,所以请量一下你自己的调用组合(下面的样本说明了原因)。
为什么这简化了 Agent 架构
1. 无需状态管理
Async API 需要追踪未完成任务:
# Async:你需要一个任务管理器(假想)
class TaskManager:
    def __init__(self):
        self.pending = {}  # task_id -> 元数据
        self.results = {}  # task_id -> 结果

    async def submit(self, operation, params):
        task = await api.post(operation, params)
        self.pending[task.id] = {"submitted": time.time(), "params": params}
        return task.id

    async def check(self, task_id):
        if task_id in self.results:
            return self.results[task_id]
        result = await api.get(f"/tasks/{task_id}")
        if result.status == "complete":
            del self.pending[task_id]
            self.results[task_id] = result.data
            return result.data
        return None

    async def cleanup_stale(self):
        # 永远没完成的任务……
        for tid, meta in self.pending.items():
            if time.time() - meta["submitted"] > 300:
                # 重试?放弃?记日志?三者都做?
                pass
Sync API 不需要任何这些:
# Sync:调一下,拿结果
# api = httpx.AsyncClient(base_url="https://api.sandbase.ai",
#                         headers={"Authorization": f"Bearer {SANDBASE_API_KEY}"},
#                         timeout=30)
result = await api.post("/v1/api/douyin/app-v3/user-profile", json={"sec_user_id": sec_uid})
# 完事。无状态。无清理。无过期任务。
单个 API 调用差异看似微小。但对一个每个决策周期跨多个平台做几十次调用的 Agent,async 状态管理会成为真实的 bug 来源。
2. 错误处理直接了当
Sync 错误是即时和可操作的:
try:
    result = await api.post("/v1/api/douyin/app-v3/user-profile", json={"sec_user_id": sec_uid})
    result.raise_for_status()
except httpx.HTTPStatusError as e:
    if e.response.status_code == 429:
        await asyncio.sleep(1)
        result = await api.post("/v1/api/douyin/app-v3/user-profile", json={"sec_user_id": sec_uid})  # 重试
        result.raise_for_status()
    else:
        raise  # 意外错误,冒泡
body = result.json()
outputs = body.get("outputs") or []
if body.get("status") != "completed" or not outputs:
    raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
user = (outputs[0].get("data") or {}).get("user")
if user is None:
    user = {"error": "user_not_found"}  # Agent 优雅处理
这里的「用户不存在」不是以 HTTP 404 返回的。2026-10-01 我用一个编造的 sec_user_id(MS4wLjABAAAA_this_id_does_not_exist_000000000000)调同一个端点,返回 HTTP 200、status: completed,outputs[0].data 里是这样的负载(run id c5123430-641b-4a5d-834a-3aae0885ab1c,删掉了 extra / log_pb):
{"status_code": 2, "status_msg": null, "user": null}这只是实测观察,所以判断放在负载上。无论哪种,失败都是即时的,并且能对应到触发它的那次请求。
Async 错误分散在时间上,难以归因:
# 假想:提交成功,但任务 10 秒后失败
task = await api.post("/hypothetical-async/user-profile", json={"sec_user_id": sec_uid})
# 暂时没错误……任务「处理中」

# 稍后检查时:
result = await api.get(f"/tasks/{task.id}")
# result.status 可能是:"failed"、"timeout"、"partial"、"expired"
# 这是哪个 sec_user_id 的?需要追踪。
# 能重试吗?也许。但原始上下文已经丢了。
3. 调试是线性的
Sync 工具失败时,trace 很简单(示意日志,不是抓取的真实 trace):
10:00:01.234 → 请求: POST /v1/api/douyin/app-v3/user-profile {"sec_user_id": "MS4w..."}
10:00:03.001 → 响应: 200 OK, 1.77s
10:00:03.002 → LLM 收到结果,继续推理
Async 工具失败时,trace 碎片化(同样是示意):
10:00:01.234 → 提交: POST /hypothetical-async/user-profile
10:00:01.456 → 拿到 task_id: task_xyz
10:00:05.000 → 轮询: GET /tasks/task_xyz → "processing"
10:00:10.000 → 轮询: GET /tasks/task_xyz → "processing"
10:00:15.000 → 轮询: GET /tasks/task_xyz → "failed"
10:00:15.001 → 为什么失败?查看任务详情……
10:00:15.200 → GET /tasks/task_xyz/details → "upstream_timeout"
10:00:15.201 → 重试?再提交一个新任务……
日志条目更多,分散在 15 秒里,而不是一次往返。Agent 的推理全程被阻塞,或者更糟,用过期数据继续。
4. 可组合性
Agent 把多个工具调用组合成决策工作流。Sync 让组合很自然(伪代码):
# Agent 的内部推理导致这个序列:
user = await get_user(user_id)
videos = await get_user_videos(user_id, count=10)
engagement = calculate_engagement_rate(videos)
decision = f"该创作者互动率 {engagement}%,{'高于' if engagement > threshold else '低于'}阈值"
每一步在下一步开始前完成。Agent 可以对中间结果推理,决定继续还是分支。
换成 async,组合需要编排(假想):
# 提交所有任务
user_task = await submit_task("get_user", user_id)
video_task = await submit_task("get_videos", user_id)

# 等两个都完成(其中一个失败怎么办?)
user = await wait_for_task(user_task, timeout=10)
videos = await wait_for_task(video_task, timeout=10)

# video_task 失败了,user 数据还用不用?
# user_task 成功但 video_task 超时,要不要重试?
# 分支逻辑爆炸
性能问题:「Sync 不是更慢吗?」
常见反对意见:「用 async 我可以提交 100 个任务,等结果陆续到达。Sync 意味着逐个等。」
这混淆了两件事:
- API 设计(sync vs async):服务端是立即返回结果,还是用任务系统
- 客户端并发:客户端是否并行发请求
你可以用 sync API + 并行客户端调用:
# Sync API + 并发客户端
async def get_profiles(sec_user_ids: list[str]) -> list[dict]:
    tasks = [
        api.post("/v1/api/douyin/app-v3/user-profile", json={"sec_user_id": s})
        for s in sec_user_ids
    ]
    results = await asyncio.gather(*tasks)
    return [r.json() for r in results]
    # 挂钟时间 ≈ 最慢的单次调用,而不是总和
每个 sync 请求各自完成;客户端并发发出,总挂钟时间取决于最慢的那一次调用,而不是逐个相加,上限是你的 key 适用的速率限制。
我们测了什么(小样本)
全部在 2026-10-01(UTC),同一个客户端,调 POST /v1/api/douyin/app-v3/user-profile:
- 10 次顺序调用,账号是上面的人民日报:10 次全部完成。9 次在 1.66 秒到 2.21 秒之间,1 次 7.16 秒,中位数 1.76 秒。(run id 包括
f817b42d-22a3-452e-8d8b-59b0bd42ba2e,慢的那次是fe48be04-0b3b-454d-8c93-65513f4abfdf。) - 1 次 vs 3 次并发:单次约 1.7 秒,三个并发挂钟约 1.7 秒(单次
72241124-a0f4-4f32-a948-9ec9deaf432d;并发506796c0-796a-40f7-a8ec-947d25efefb7、97799423-a91d-41a5-87dc-8c871f4adc96、ad8b973e-48a1-44e8-91c5-c489aec2123b)。
这是一个端点上的 14 次调用,不是基准测试。但它说明了两件事:客户端并发不需要 async API 也能并行;延迟有长尾,5 秒的客户端超时会砍掉十次里一次本来成功的调用。调用是无状态的,超时重试成本低,但超时值请根据自己的测量来定。
对有界的数据检索,我们认为这优于 async,因为:
- 你立即知道哪些成功、哪些失败
- 无任务管理开销
- 无轮询成本
- 服务端不需要维护任务状态
什么时候适合 Async
Sync 不总是合适。以下场景 async 可能是更好的选择:
1. 生成任务(视频、图片)
文本生成视频、图片生成通常要跑几十秒甚至更久
(粗略估计,因模型而异,不是 SandBase 的测量)。
很难放进一次 HTTP 请求里。
生成类任务可能是异步的。在 SandBase 上,图片、视频、音频生成走 Model API 的 /v1/run 调用面,而不是 /v1/api 数据路由;请求是同步完成还是返回 202 Accepted 等待轮询,由所选模型的 execution_mode 决定。请查看该模型的 execution_mode 和 Model API 文档里的参考,本文不涉及那个调用面。
2. 批量导出
「导出这个视频的所有 10,000 条评论」
需要大量分页请求。
数据量大到一次响应装不下、获取时间超过合理的 HTTP 超时,用 async 加下载链接是合理的。
3. 多步聚合
「计算该账号 90 天互动趋势」
需要获取 90 天数据 + 计算。
服务端需要跨多次数据获取做大量计算时,async 能避免 HTTP 超时问题。
规律
注意这些共同点:它们涉及创建或计算,不是检索。 数据检索(「给我这个用户的主页」「给我这个视频的统计」「搜索这个关键词」)通常一次请求就够快。底层数据已经存在,API 只需取出返回。
我们划的线:
- 数据检索 → sync(数据存在,取出即可)
- 数据生成/计算 → 常常是 async(结果尚不存在,必须创建;在 SandBase 上请查看模型的
execution_mode)
架构启示
对 API 提供方
如果你在为 Agent 消费构建数据 API:
- 默认 sync。 我们的经验法则:操作通常几秒内完成,就做成 sync。
- 说清楚耗时。 告诉客户端每个操作大概要多久,方便他们设超时。
- 正确使用 HTTP 语义。 200 成功、4xx 客户端错误、5xx 服务端错误、429 限流配 Retry-After header。
- 返回完整结果。 简单查询不要返回部分数据加「取更多」模式。
- Async 保留给生成。 只在操作确实太久、一次请求装不下时用任务模式。
对 Agent 开发者
如果你在构建消费数据 API 的 Agent:
- 优先 sync API。 集成、调试和维护更简单。
- 用客户端并发获取并行。
asyncio.gather()在 sync API 上给你并行执行。 - 按测量结果设超时。 先量你的端点,超时设在正常范围之上,超时就重试。无状态调用让重试很便宜。
- 保持工具函数简单。 工具函数应该是:调 API → 返回结果。如果需要状态管理,说明 API 设计不适合你的用例。
- 分离 sync 和 async 工作流。 如果两者都需要(数据检索 + 视频生成),放在不同 Agent 工具里,用不同的超时/重试策略。
SandBase 怎么落地
几百个异构社媒接口怎么归一成一个 Agent 契约 里描述的数据端点,调用方式相同,都走 POST /v1/api/<model>。截至 2026-10-01,公开目录展示抖音 262、TikTok 145、微博 52、小红书 34 个端点(浏览目录)。下面的目录卡片能看到其中两个数字。
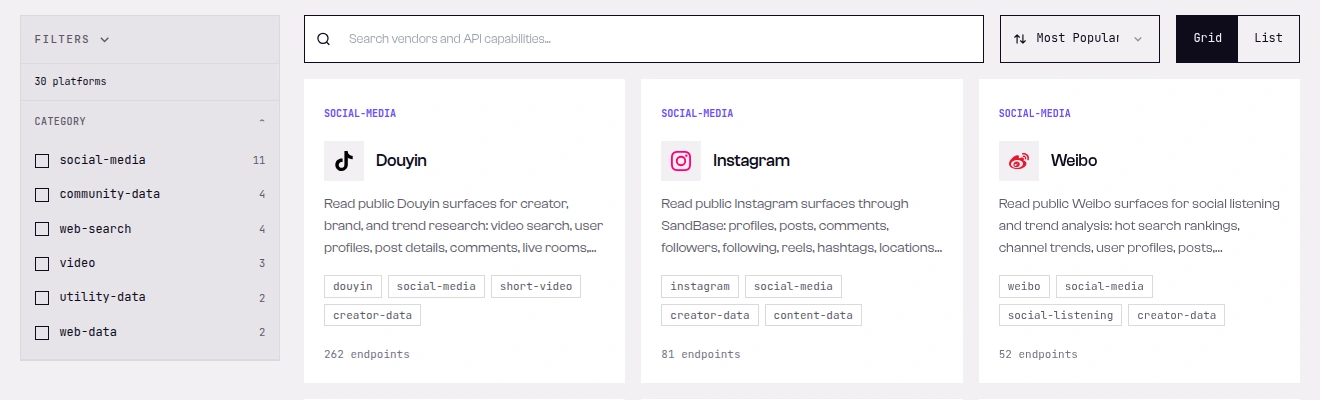
截图:SandBase API 目录网格显示抖音 262 个端点、微博 52 个,与上文数字一致(2026-10-02 截取)。
本文只核实了实测端点的 execution_mode,其他端点请看各自的参考页。我们没有公布整体延迟或成功率数据,所以本文唯一的数字就是上面那 14 次调用的样本。
如果这样的端点是 async 的,每一次快速调用都要承担不必要的开销:任务提交、任务存储、轮询或 webhook 投递、任务清理。这些开销纯粹来自 API 设计,而不是操作本身的需要。
动手试试:
反对意见回应
「Webhook 不比轮询高效吗?」
是的,但 webhook 需要:
- 客户端暴露公共端点
- Webhook 验证和安全
- 投递失败的重试逻辑
- webhook 丢失时的状态对账
对运行在开发者笔记本或 serverless 函数中的 Agent,这些基础设施都不存在。Sync 彻底去掉了这个需求。
「如果上游数据源慢怎么办?」
这主要是 API 提供方的问题,不是 Agent 开发者的:缓存和连接复用有助于让延迟保持稳定。如果某个上游一直慢到一次请求装不下,那个操作就该做成 async。大多数数据检索操作不是这样。
「Sync 限制吞吐量。」
只在顺序调用时。用并发请求时,吞吐量受限于你的 key 的速率限制和上游延迟,而不是请求/响应协议本身。
结论
数据 API 的 sync-only 不是妥协。它是匹配 AI Agent 在阻塞式工具循环里消费数据的架构:请求、接收、推理、重复。你在数据 API 上加的每一个 async 模式,都是对每个集成它的 Agent 开发者征收的复杂度税,这些复杂度主要服务的是提供方的基础设施,而不是开发者。
我们用的原则:如果数据已经存在、通常能在一次请求的超时内取到,就同步返回。 Async 留给结果真正不存在、必须被创建的操作。