Anthropic Prompt Caching 价格:读写各多少钱(2026)
Anthropic prompt caching 读写价格一览:5 分钟写入 1.25 倍、1 小时写入 2 倍、读取 0.1 倍。按当前 Claude 模型列出每百万 token 美元价,并给出回本计算和三个算例。
先说结论 —— 以下数字于 2026 年 10 月 4 日对照 Anthropic 官方价格页核对:
- 5 分钟缓存写入按基础输入价的 1.25 倍计费,1 小时缓存写入按 2 倍计费。
- 缓存读取多数模型是 0.1 倍;Claude Opus 5.5 是 0.05 倍,Fable 5.1 和 Mythos 5.1 是 0.025 倍。
- 5 分钟缓存读一次就回本,1 小时缓存要读两次。
- 每次命中都会免费刷新有效期,所以只有两次调用间隔超过 5 分钟时,5 分钟档才会吃亏。
Agent 每走一步都把同一段 5 万 token 的系统提示重发一遍,如果不做缓存,这 5 万 token 每次都按原价收。开了 prompt caching,账单就拆成三块:写缓存的价、读缓存的价,以及断点之后照常计费的部分。下面先把当前 Claude 模型的读写价格放进一张表,再算清 5 分钟和 1 小时两档各在什么情况下省钱。
需要先更正一点:本文早先版本把 1 小时写入写成 1.5 倍,还出现了 "persistent" 缓存类型,这两处都不符合当前 API。1 小时写入是 2 倍;缓存类型只有 "ephemeral",1 小时档通过 ttl 指定。
各模型读写价格
单位为美元/百万 token(MTok),来源是 Anthropic 价格页和 prompt caching 文档中的同一张表,2026-10-04 获取。
| 模型 | 基础输入 | 5 分钟写入 | 1 小时写入 | 缓存读取 | 输出 |
|---|---|---|---|---|---|
| Claude Fable 5.1 | 10 | 12.50 | 20 | 0.25 | 50 |
| Claude Opus 5.5 | 4 | 5 | 8 | 0.20 | 20 |
| Claude Sonnet 5.5 | 2 | 2.50 | 4 | 0.20 | 10 |
| Claude Haiku 4.5 | 1 | 1.25 | 2 | 0.10 | 5 |
| Claude Opus 5(旧版) | 5 | 6.25 | 10 | 0.50 | 25 |
| Claude Sonnet 5(旧版) | 2 | 2.50 | 4 | 0.20 | 10 |
| Claude Sonnet 4.6(旧版) | 3 | 3.75 | 6 | 0.30 | 15 |
背后的倍率只有三个:
| 操作 | 相对基础输入价 | 有效期 |
|---|---|---|
| 5 分钟写入 | 1.25 倍 | 5 分钟 |
| 1 小时写入 | 2 倍 | 1 小时 |
| 读取(命中) | 0.1 倍(Opus 5.5 为 0.05 倍;Fable 5.1、Mythos 5.1 为 0.025 倍) | 与对应写入相同 |
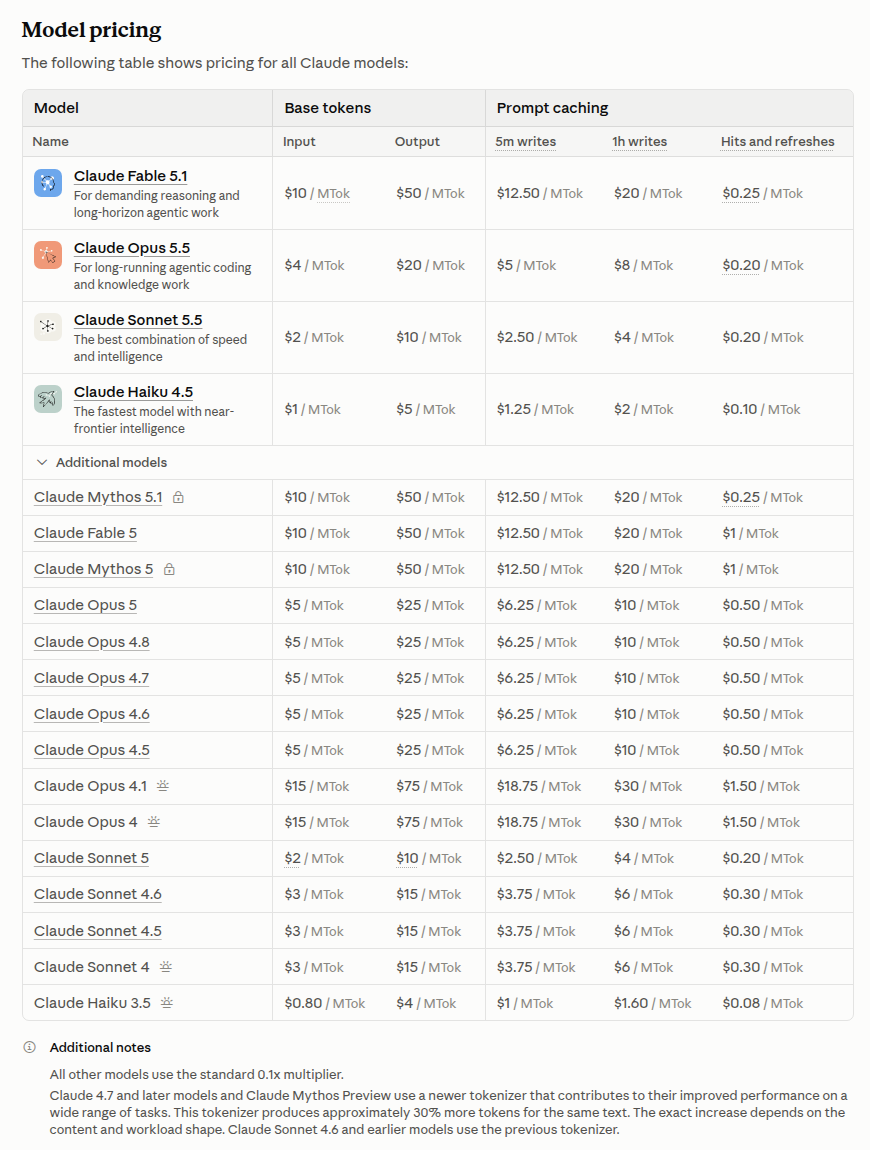
截图:Anthropic 模型价格表,上面的美元表格逐项抄自其中的 5m writes、1h writes 和 hits 三列(2026-10-04 截取)。
有两点容易漏看。第一,Opus 5.5 的读取倍率比别的模型低,所以它的缓存读取和 Sonnet 5.5 一样是 0.20 美元,尽管基础输入价是后者的两倍。第二,官方说明 Claude 4.7 及之后的模型换了新分词器,同样的文本大约多出 30% 的 token;以前在旧模型上量过的提示词,现在计数可能更高。
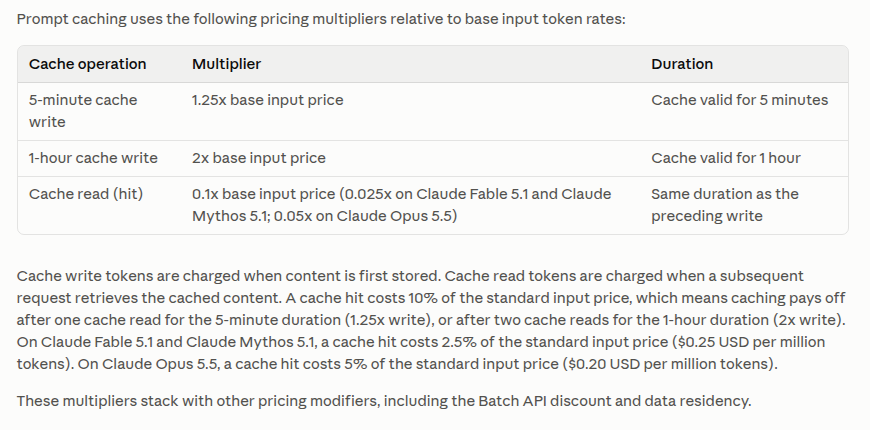
截图:官方倍率表和回本说明——5 分钟档读一次回本,1 小时档读两次回本(2026-10-04 截取)。
这些倍率还会和其他计费项叠加:Batch API 五折,以及 Claude 4.6 及之后模型使用 inference_geo: "us"(仅美国境内推理)时的 1.1 倍。
两档缓存的真实差别
机制是一样的:在稳定前缀的末尾加 cache_control,第一次请求写入,后续前缀完全相同的请求读取。
from anthropic import Anthropic

client = Anthropic()

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=1024,
    system=[
        {
            "type": "text",
            "text": large_system_context,  # 稳定的指令和文档
            "cache_control": {"type": "ephemeral"},  # 默认 5 分钟
            # 1 小时档:{"type": "ephemeral", "ttl": "1h"}
        }
    ],
    messages=[{"role": "user", "content": current_question}],
)
print(response.usage)
很多成本表算错,是因为没看清有效期怎么算。官方文档写得很明确:
- 默认有效期 5 分钟,每次命中都会免费刷新。
- 有效期从写入或读取那次请求的开始时刻算起。一个回答流式输出了 4 分钟,下一次调用只剩大约 1 分钟窗口。
- 5 分钟和 1 小时两档在延迟上表现相同,选哪档只关乎费用和调用间隔。
也就是说,5 分钟缓存不是“每过 5 分钟就失效”,而是“连续 5 分钟没人用才失效”。调用密集的 Agent 循环,能让 5 分钟缓存一直活着。
回本怎么算
设前缀为 P 个 token、基础输入价为 B。写一次再读 N 次,费用是 P × B ×(写入倍率 + N × 读取倍率);不缓存的 N+1 次调用是 P × B ×(N + 1)。以读取 0.1 倍为例(单位:P × B):
| 档位 | 写 1 读 1 | 写 1 读 2 | 不缓存同样次数 |
|---|---|---|---|
| 5 分钟(写入 1.25 倍) | 1.35 | 1.45 | 2/3 |
| 1 小时(写入 2 倍) | 2.10 | 2.20 | 2/3 |
5 分钟档读一次就划算(1.35 对 2);1 小时档读一次还略亏(2.10 对 2),读两次才划算(2.20 对 3),和官方说法一致。Opus 5.5、Fable 5.1 的读取倍率更低,回本点不变,只是之后每次读取更便宜。
三个算例
下面只计算被缓存的前缀。没缓存的提问部分和输出,开不开缓存都一样,因此不计入。假设每次调用都在有效期内开始。
算例一:Sonnet 5.5 上的快速工具循环。 前缀 5 万 token,连续调用 10 次,间隔只有几秒。
| 方案 | 算式(单价按每百万 token) | 前缀费用 |
|---|---|---|
| 不缓存 | 10 × 5 万 × 2 | 1.00 美元 |
| 5 分钟缓存 | 5 万 × 2.50 + 9 × 5 万 × 0.20 | 0.215 美元 |
| 1 小时缓存 | 5 万 × 4 + 9 × 5 万 × 0.20 | 0.29 美元 |
5 分钟档最便宜。1 小时写入多付的 0.075 美元完全用不上,因为没有一个间隔长到让 5 分钟缓存过期。
算例二:Sonnet 5.5 上的人工节奏对话。 同样 5 万 token 前缀,12 次调用,每 10 分钟一次,比如客服对话或边看边改的审阅流程。
| 方案 | 实际发生什么 | 前缀费用 |
|---|---|---|
| 不缓存 | 12 × 5 万 × 2 | 1.20 美元 |
| 5 分钟缓存 | 每次间隔都超过 5 分钟,12 次全是写入:12 × 5 万 × 2.50 | 1.50 美元 |
| 1 小时缓存 | 写 1 次(5 万 × 4)+ 读 11 次(11 × 5 万 × 0.20) | 0.31 美元 |
这里 5 分钟缓存比不缓存还贵:写入溢价付了 12 次,一次都没读到。1 小时档比不缓存省约 74%。
算例三:Opus 5.5 上的一次集中调用。 前缀 10 万 token,一口气调用 20 次。
| 方案 | 算式(单价按每百万 token) | 前缀费用 |
|---|---|---|
| 不缓存 | 20 × 10 万 × 4 | 8.00 美元 |
| 5 分钟缓存 | 10 万 × 5 + 19 × 10 万 × 0.20 | 0.88 美元 |
| 1 小时缓存 | 10 万 × 8 + 19 × 10 万 × 0.20 | 1.18 美元 |
差距这么大,主要因为 Opus 5.5 的读取只有 0.05 倍:19 次读取 10 万 token,总共才 0.38 美元。换成旧版 Opus 5(输入 5 美元、读取 0.1 倍),同样用 5 分钟档是 0.625 + 19 × 0.05 = 1.575 美元,不缓存则是 10 美元。
该选哪一档
| 调用节奏 | 选择 | 原因 |
|---|---|---|
| 两次调用间隔小于 5 分钟(工具循环、CI Agent、批处理步骤) | 5 分钟 | 每次命中都刷新有效期,便宜的写入就够了 |
| 间隔 5 到 60 分钟(真人对话、跑得超过 5 分钟的子 Agent) | 1 小时 | 避免每次停顿后重新付写入溢价 |
| 只调用一次、前缀不重复 | 不缓存 | 只写不读,比直接输入贵 25% 或 100% |
| 前缀低于模型最小长度 | 无法缓存 | 请求照常处理,不缓存也不报错 |
官方给出的判断标准也是这样:提示词使用频率高于每 5 分钟一次,就继续用 5 分钟缓存;低于每 5 分钟、但高于每小时一次,再用 1 小时缓存。
最小可缓存长度:Fable 5.1、Mythos 5.1、Opus 5.5、Opus 5、Sonnet 5.5、Fable 5、Mythos 5 为 512 token;Opus 4.8、Sonnet 5、Sonnet 4.6、Sonnet 4.5 为 1,024;Haiku 4.5 为 4,096。
通过 SandBase 实测(2026-10-04,UTC)
我们通过 SandBase 的 Anthropic 兼容接口 POST https://api.sandbase.ai/v1/messages(请求头 Authorization: Bearer $SANDBASE_API_KEY)调用 anthropic/claude-sonnet-5.5,发了四个请求。系统提示是一段合成的编号客服规则(不含真实用户数据),带 cache_control,max_tokens 为 16。前两个用默认 5 分钟,后两个换了前缀并加上 "ttl": "1h"。
第 3 个请求(msg_011CfgUpGiuaeS6vhjYru8eV,1 小时写入)和 3 秒后的第 4 个请求(msg_011CfgUpm7bJx471S9VtwoZl,读取)返回的 usage 如下,省略了 output_tokens_details、service_tier 和 inference_geo 三个键:
{"input_tokens": 25, "cache_creation_input_tokens": 3012, "cache_read_input_tokens": 0, "cache_creation": {"ephemeral_5m_input_tokens": 0, "ephemeral_1h_input_tokens": 3012}, "output_tokens": 3}{"input_tokens": 25, "cache_creation_input_tokens": 0, "cache_read_input_tokens": 3012, "cache_creation": {"ephemeral_5m_input_tokens": 0, "ephemeral_1h_input_tokens": 0}, "output_tokens": 3}5 分钟那一组表现相同,写入记在 ephemeral_5m_input_tokens 下。两档缓存都能透传,响应里的 model 字段为 claude-sonnet-5-5。这是四次请求里观察到的字段,不代表 SandBase 的书面承诺。
价格方面,10 月 4 日用同一个 Bearer key 请求 GET https://api.sandbase.ai/v1/models/anthropic/claude-sonnet-5.5,返回输入 2 美元、输出 10 美元,cache_write_multiplier 为 1.25,cache_read_multiplier 为 0.1;cache_write_1h_multiplier 字段为空。所以 SandBase 怎么计 1 小时写入我们还没有确认,这四次请求也没有和账单逐笔核对。不用 key 也能在公开的 Claude Sonnet 5.5 模型页看到价格。
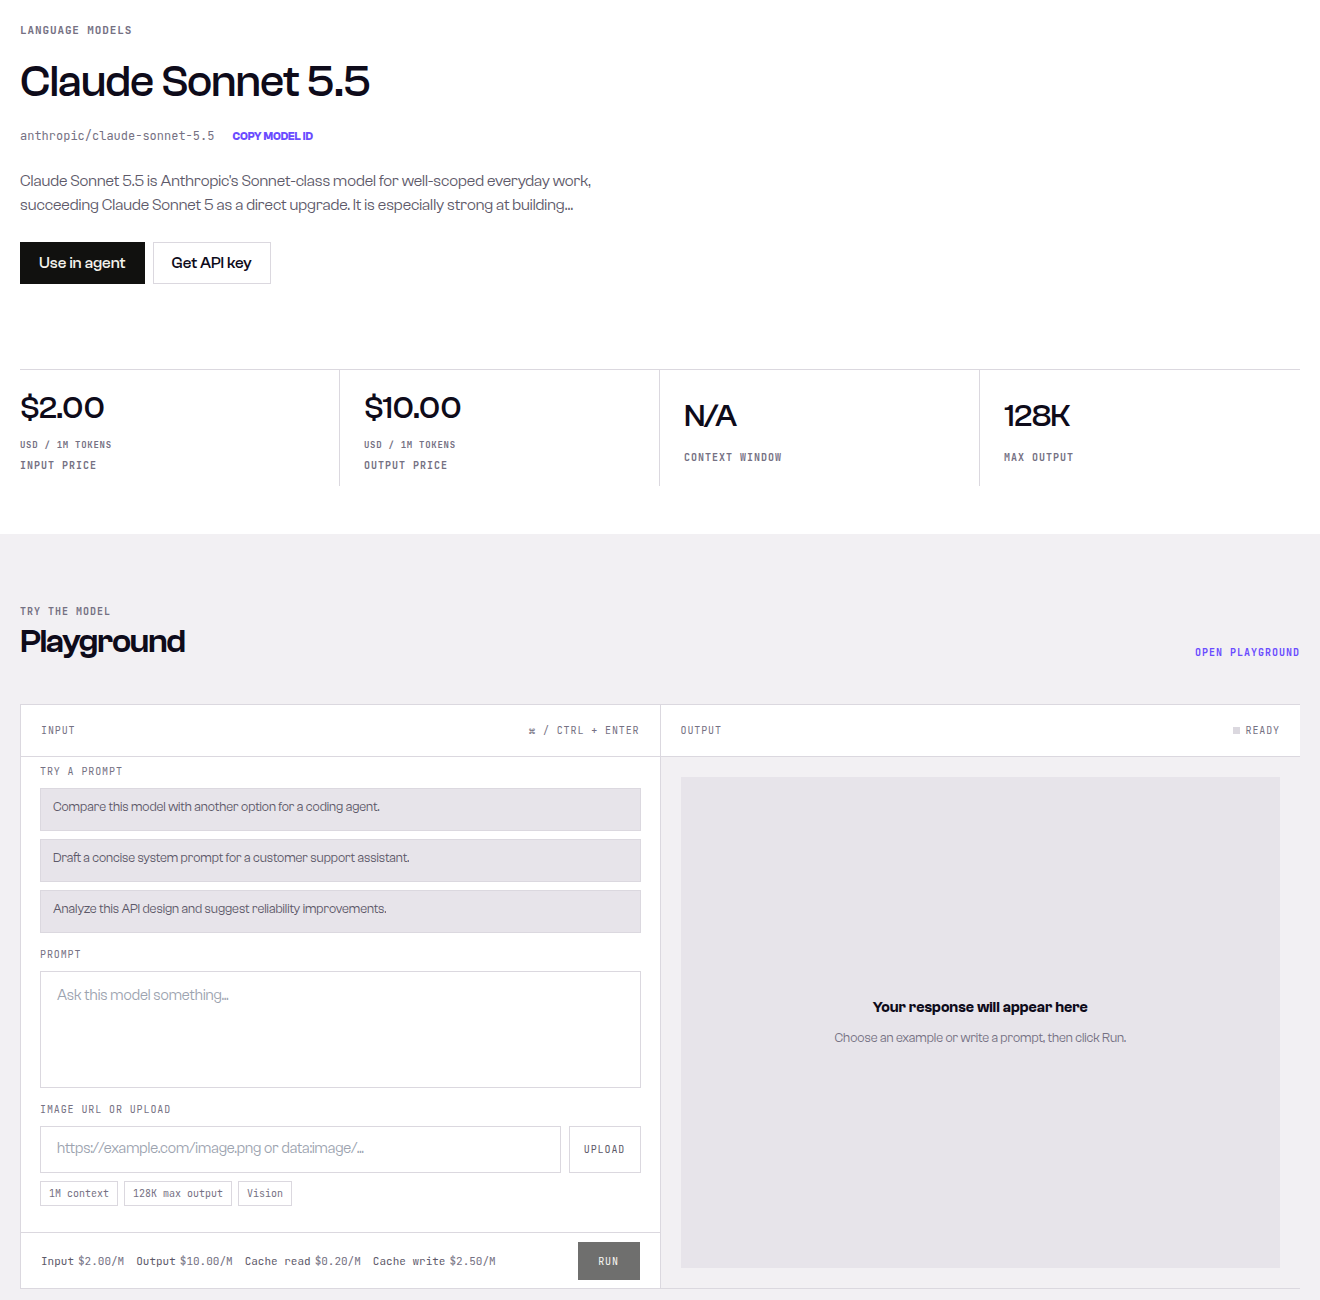
截图:SandBase 模型页列出 Sonnet 5.5 的输入、输出、缓存读取和缓存写入价格,与 Anthropic 的 5 分钟档一致(2026-10-04 截取)。
想自己试,可以在模型页复制模型 ID,再申请 SandBase API key。
落地时的几个坑
- 只缓存不变的部分。 工具定义、系统指令、载入的文档、对话里较早的轮次都合适。前缀按 tools、system、messages 的顺序拼接,断点及其之前任何改动都会让哈希变掉。
- 断点放在最后一个稳定块上。 时间戳、用户新消息放在断点之后没问题;放进断点之内,每次都是新写入,永远读不到。最多 4 个断点,向前回溯最多检查 20 个块。
- 两档可以混用,但有顺序。 1 小时的条目必须排在 5 分钟条目之前,比如 tools 和 system 用 1 小时,对话部分用 5 分钟。
- 留意静默失效。 改了
tool_choice、增删图片、换了思考配置,缓存都会失效。盯住读取 token 占输入的比例,如果你认为稳定的前缀总在产生写入,说明断点之前有东西在变。
Agent 场景下更完整的省钱思路,见 Anthropic Prompt Caching 实战;各家价格对比见 LLM API 定价指南。
FAQ
Anthropic 缓存写入多少钱?
5 分钟写入是基础输入价的 1.25 倍,1 小时写入是 2 倍。以 Claude Sonnet 5.5 为例,分别是每百万 token 2.50 和 4 美元;Opus 5.5 是 5 和 8 美元(2026-10-04 官方价格页)。
缓存读取多少钱?
多数模型是 0.1 倍,Sonnet 5.5 为 0.20 美元,Haiku 4.5 为 0.10 美元。Opus 5.5 是 0.05 倍(0.20 美元),Fable 5.1 和 Mythos 5.1 是 0.025 倍(0.25 美元)。
1 小时缓存值不值得多付写入费?
只有调用间隔超过 5 分钟、又短于 1 小时时才值得。调用更密集的话,每次命中都会免费续上 5 分钟,1 小时写入多付的钱就白花了。
不同 API key 之间共享缓存吗?
不同组织之间从不共享;在 Claude API 上,同一组织的不同 workspace 之间也相互隔离。Bedrock 和 Google Cloud 只做组织级隔离。
缓存会改变输出或上下文上限吗?
不会。官方说明开不开缓存,返回结果都一样;被缓存的 token 依然算在提示里,占用上下文窗口。缓存改变的是重复输入的价格,以及长提示的首 token 响应速度。