Claude Code 换模型实测:11 个模型跑 6 道编程题
Claude Code 换模型实测:通过 SandBase 把 Claude Code 接到 GPT-6.1 Sol、GPT-6 Luna、Kimi K3、Qwen3.8、DeepSeek V4 Pro 等 11 个模型,6 道 Python 仓库题各跑 2 次,用隐藏测试判分,对比通过率、轮数、耗时和按标价算的真实成本。
同一道分页 bug,GPT-6 Luna 在 Claude Code 里来回跑了 22 轮才修完,Claude Opus 5.5 只用了 5 轮。Claude Code 自己的 JSON 说 Luna 这次花了 $0.33,按 SandBase 标价算其实不到 1 美分。两个数字出自同一次运行,差了 50 倍。这篇实测要讲的,主要就是这个差距。
这次 Claude Code 换模型实测用的是 Claude Code 2.1.246,底层模型通过 SandBase 切换:清单里的 10 个模型,再加 1 个替补,每个模型做 6 道小型 Python 仓库题,每题 2 次,用 agent 看不到的隐藏测试判分。时间是 2026-10-03(UTC)13:40 到 14:15。想回答两个很实际的问题:哪些模型真能给 Claude Code 当引擎;Claude Code 不认识这个模型时,一次任务到底花多少钱。
先说结论
- 6 个模型 12/12 全过:GPT-6.1 Sol、GLM-5.3 Prime、Claude Sonnet 5.5、Kimi K3、Qwen3.8 Max 0902、Claude Opus 5.5。GPT-6 Luna、Grok 4.7 各 11/12;DeepSeek V4 Pro、MiniMax M3 各 10/12。
- GLM-5.3 根本没跑起来:SandBase 的
/v1/messages直接返回 HTTP 400,提示不支持 Anthropic 格式。换成支持该格式的 GLM-5.3 Prime 顶上,12/12。- 按标价算,单任务成本中位数从 GPT-6 Luna 的 $0.0071 到 Claude Opus 5.5 的 $0.54,大多数模型在 $0.10 到 $0.18 之间。
- Claude Code 的
total_cost_usd把所有非 Anthropic 模型都按每百万 token $5 / $25 计价,整场报了 $44.55,按 SandBase 标价估算只有 $17.16。- 测试范围:6 道标准库 Python 小题,每题 2 次,默认参数,单日单机。能说明哪些模型适合当 Claude Code 的引擎,不是通用编程排名。
怎么让 Claude Code 走 SandBase
Claude Code 说的是 Anthropic Messages 协议。SandBase 提供兼容的 POST /v1/messages,会按 model 字段路由到对应厂商,所以配置全靠环境变量:
ANTHROPIC_BASE_URL=https://api.sandbase.aiANTHROPIC_AUTH_TOKEN=$SANDBASE_API_KEY,以 Bearer 方式发送;记得 unsetANTHROPIC_API_KEY,免得它抢先生效ANTHROPIC_MODEL=<SandBase 模型 id>,ANTHROPIC_SMALL_FAST_MODEL和ANTHROPIC_DEFAULT_HAIKU/SONNET/OPUS_MODEL也设成同一个 id,让后台调用和 subagent 也用同一个模型(我们全都设了,没测过不设会怎样)CLAUDE_CONFIG_DIR=<一个新的临时目录>,不碰你平时的登录态、历史和设置
key 只放在环境变量里,仓库和配置目录里都不落盘。Claude Code 本身的用法(权限、CLAUDE.md、subagent)可以看我们的 Claude Code 完全指南。
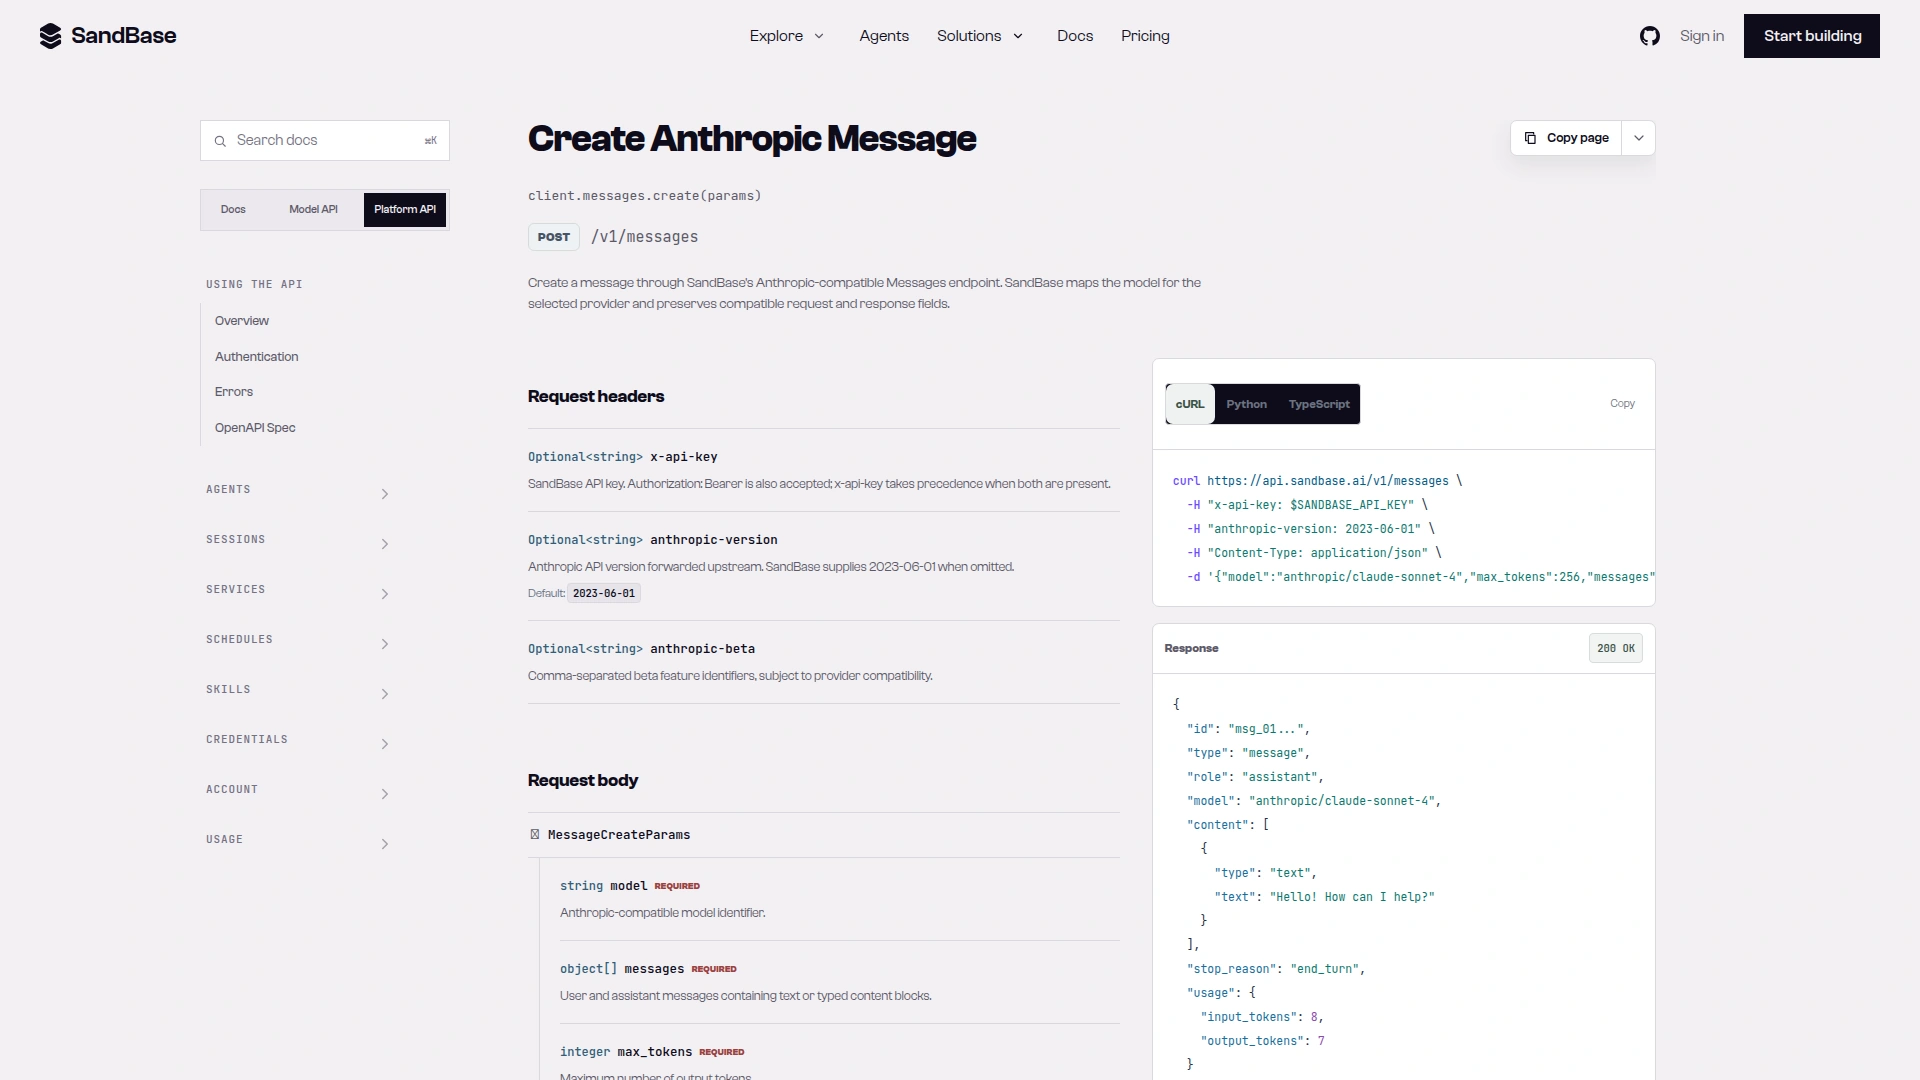
截图:SandBase 的 Anthropic 兼容 Messages 文档写明了 POST /v1/messages、Bearer 或 x-api-key 鉴权,以及会透传的 anthropic-version 请求头,本次测试里 Claude Code 走的就是这份契约(2026-10-03 截取)。
2026-10-03 我们没在 SandBase 文档里找到专门讲「给 Claude Code 换模型」的页面。Setup 指南讲的是把 SandBase 的工具接进 Claude Code,是另一件事。所以我们依据的是上面这份 Messages 文档。
踩到两个坑。第一,只要模型 id 不是 Anthropic 的,Claude Code 都会在 stderr 打一行 [claude-code:unrecognized_model],108 次运行无一例外。任务照样能跑,我们测到的唯一副作用是成本数字错了。第二,不是每个 SandBase 模型都接受 Anthropic 格式。GLM-5.3 的 12 次运行全部在 2 秒左右以 HTTP 400 结束。选定模型前,先发一条 /v1/messages 试试:我们这样试了 9 个非 Anthropic 模型 id,只有 GLM-5.3 拒绝。
6 道题
每道题是一个迷你仓库:1 到 4 个源文件,只用标准库,带 README 规格说明和一个会失败的可见测试。所有模型拿到同一段提示词:
Read README.md. Run the tests with `python3 -m pytest -q`, change the code so it meets the spec in README.md and the tests pass, then rerun the tests. Do not edit files under tests/.| 题目 | agent 要做什么 | 隐藏测试查什么 |
|---|---|---|
| T1 分页 | 修 0 起始的切片、向下取整的页数、has_prev | 越界页、非法参数、page_count(0)、page_info |
| T2 日期区间 | 重写一个很粗糙的 --range 解析 | 空白、单侧开放、2 月 30 日、闰日、拒绝 20260101、stderr 和退出码 2 |
| T3 LRU 缓存 | 从空壳实现 | in 不刷新热度、更新不触发淘汰、on_evict、pop、假值 |
| T4 计数器 | 把有竞态的计数器改成线程安全 | 并发下 reset() 原子、抛 ValueError 后锁不卡死、value 只读 |
| T5 重构 | 把两份已经走样的重复代码抽成 money.py | 负数的四舍五入、两个文件都改成 import、私有副本删掉、原有 5 个测试照过 |
| T6 CSV 导出 | 按引号规则实现 to_csv | 公式防护只针对字符串、引号规则、表头加引号、空字符串 |
判分规则:运行结束后,把可见测试换回我们的原始版本(防止 agent 改过),再拷入隐藏测试,全部通过才算过。隐藏测试在 Claude Code 退出之后才放进去。每次运行都是全新的临时目录和配置目录,--max-turns 40,超时 600 秒,开 --dangerously-skip-permissions,最多 5 个并行。PATH 最前面放了装好 pytest 8.3.3 的 venv,agent 不用浪费轮数去装依赖。正式跑之前,我们确认过每道题的可见测试在初始代码上都会失败,参考答案能通过全部隐藏测试。
结果
价格是 2026-10-03 的 SandBase 标价,取自 GET https://api.sandbase.ai/v1/models/<id> 里的 prompt_token_price 和 completion_token_price,单位是每百万 token 美元。这个接口和 GET /v1/tasks/<id>/cost 用的是同一个 Bearer key;不想调接口的话,公开的模型页面上也能看到同样的价格。
| 模型(SandBase id) | 输入 / 输出 $/M | 通过(12) | 轮数中位数 | 耗时中位数 | 单任务成本中位数 | Claude Code 自报(12 次合计) |
|---|---|---|---|---|---|---|
openai/gpt-6.1-sol | $2 / $10 | 12 | 23.5 | 114 秒 | $0.117 | $4.55 |
z-ai/glm-5.3-prime | $2.80 / $8.80 | 12 | 8.5 | 37 秒 | $0.106 | $1.93 |
anthropic/claude-sonnet-5.5 | $2 / $10 | 12 | 9 | 109 秒 | $0.124 | $1.56 |
moonshotai/kimi-k3 | $3 / $15 | 12 | 10 | 51 秒 | $0.136 | $2.75 |
alibaba/qwen3.8-max-0902 | $2 / $6 | 12 | 11.5 | 90 秒 | $0.181 | $6.12 |
anthropic/claude-opus-5.5 | $4 / $20 | 12 | 5 | 44 秒 | $0.540 | $7.64 |
openai/gpt-6-luna | $0.10 / $0.50 | 11 | 22 | 100 秒 | $0.0071 | $4.33 |
x-ai/grok-4.7 | $2 / $6 | 11 | 8 | 31 秒 | $0.128 | $3.31 |
deepseek/deepseek-v4-pro-0813 | $1.32 / $3.96 | 10 | 8.5 | 114 秒 | $0.046 | $2.90 |
minimax/minimax-m3 | $0.30 / $1.20 | 10 | 10.5 | 45 秒 | $0.044 | $9.46 |
z-ai/glm-5.3 | $1.40 / $4.40 | 0 | 无 | 无 | 无 | $0(HTTP 400) |
真正跑起来的 120 次(原定名单里的 9 个模型,加替补 GLM-5.3 Prime)里,过了 114 次。没有一次超时,没有一次撞到轮数上限,也没有一次改过测试文件。T1 到 T4 所有跑起来的模型全过,6 次失败都出在 T5 和 T6。
轮数能看出两种风格。Opus 5.5 步子迈得大,中位数 5 轮;GPT-6.1 Sol 和 GPT-6 Luna 喜欢小步快跑,22 到 24 轮。两种都能过。耗时和轮数也不挂钩:Sonnet 5.5 只用 9 轮,却要 109 秒,我们估计部分原因是那天下午它的上游很慢:试跑阶段给它发一句「Say OK.」,走 /v1/messages 花了 26 秒,其他模型都在 2 到 4 秒内返回;14:26 UTC 再测一次是 5.6 秒。
模型在哪里翻车
T5 重构:连 bug 一起搬走(4 次)。 DeepSeek V4 Pro 和 MiniMax M3 都在 T5 上挂了两次,挂法一模一样。规格要求税额「四舍五入,远离零」。orders.py 里那份旧实现遇到 0.5 一律往正无穷方向进位,正数没问题,负数就错了。两个模型都把这段逻辑原样搬进了 money.py,还在上面写了一句「away from zero」的 docstring,于是 apply_tax(-200, 25) 返回 0 而不是 -1。可见测试里没有负数,agent 看到全绿就收工了。其他模型都处理了负数。
T6 CSV:公式防护的边界(2 次)。 GPT-6 Luna 有一次把开头 - 的防护用到了整数 -5 上,输出 '-5,而规格只要求对字符串加防护。Grok 4.7 有一次写了 text[:1] in "=+-@"。在 Python 里空字符串「在」任何字符串里,于是空单元格变成了 '。两个模型的另一次 T6 都过了。
GLM-5.3:协议问题,不是编程问题(12 次)。 第一个请求就返回 HTTP 400,错误信息是 Model 'glm-5.3' does not support api_format 'anthropic',0 token,约 2 秒。对它来说,这次测试什么编程能力都没测到。
所有失败里,没有工具格式错误,没有超时,也没有中途 API 报错。每一次都是规格里某个没被测到的分支,agent 自己没去验证。用便宜模型的话,把规格里的边界情况写进可见测试,或者让强模型 review 一遍 diff。重试还是升级模型的取舍,可以看强模型一次过 vs 便宜模型多轮重试。
成本:Claude Code 的数字和标价
Claude Code 输出的 total_cost_usd 用的是它自带的价目表。Sonnet 5.5 和我们按标价估的分毫不差:SandBase 给 Sonnet 的标价是 $2 / $10,Claude Code 自带的价目表也是这个数。其他模型就全错了。我们把 96 次真正发出请求的非 Anthropic 运行全部反算了一遍(GLM-5.3 那 12 次报错用量为 0):Claude Code 一律按输入 $5、输出 $25 每百万 token 计价,缓存写入 1.25 倍,缓存读取 0.1 倍,相当于 Opus 档的价格。Opus 5.5 它也按 $5 / $25 算,而 SandBase 标价是 $4 / $20。
所以成本是我们自己算的:取 Claude Code JSON 里累计的 usage,输入和输出按标价,缓存写入乘模型卡里的 cache_write_multiplier,缓存读取乘 cache_read_multiplier。Kimi K3、Grok 4.7、DeepSeek V4 Pro、MiniMax M3、GLM-5.3 Prime 这 5 个模型卡上没有缓存写入倍率,不过它们报的缓存写入 token 本来就是 0,怎么定都不影响结果。这些仍然是估算:SandBase 的 GET /v1/tasks/<id>/cost 查不到 /v1/messages 的 id,没法逐次和账单对账。
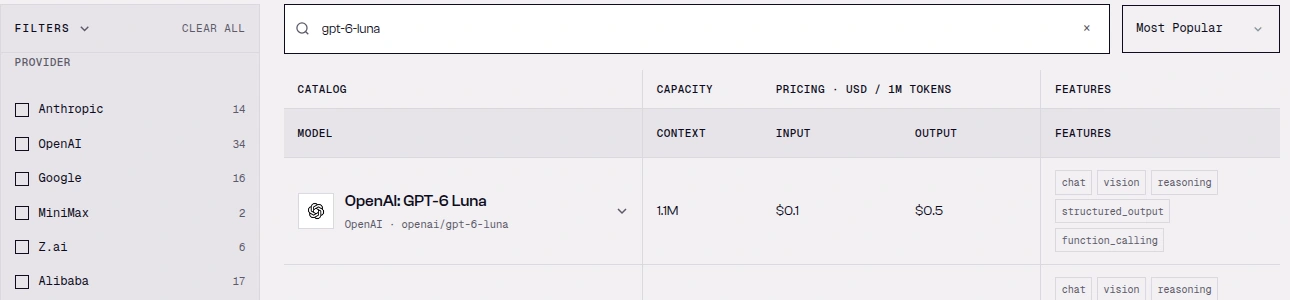
截图:GPT-6 Luna 的标价是输入 $0.10、输出 $0.50 每百万 token,所以它跑 22 轮也花不到 1 美分(2026-10-03 截取)。
Claude Code 每一轮都会重发系统提示词和工具定义,输入 token 占大头;只要路由支持缓存,大部分都会变成缓存读取。GPT-6.1 Sol、GPT-6 Luna、Sonnet 5.5、GLM-5.3 Prime 的缓存读取占全部 token 的 92% 到 94%。MiniMax M3 是例外,只有 11%:每次运行中位数 134,604 个未缓存输入 token,缓存读取只有 16,580。它每百万 $0.30,影响不大;换成贵模型就是另一回事了。
GPT-6 Luna 的单任务成本约为 GPT-6.1 Sol 的 1/16($0.0071 对 $0.117),通过率 11/12 对 12/12。这和我们之前的 Agent 用便宜模型够不够实测结论一致:那次短工具任务上,Luna 和 Sol 打平,成本约为 1/20。
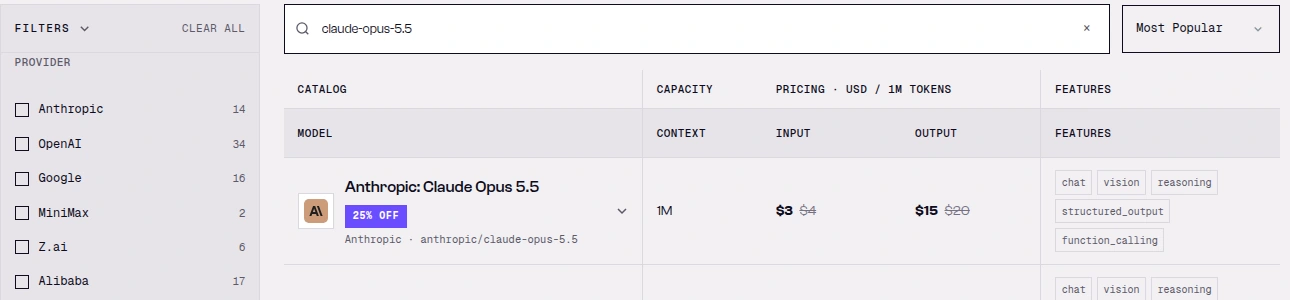
截图:2026-10-03 目录页显示 Claude Opus 5.5 打 75 折($3 / $15,原价 $4 / $20),但模型卡上仍是 $4 / $20,成本表按模型卡计算(2026-10-03 截取)。
最贵的是 Opus 5.5:12 次按标价共 $6.01,单任务中位数 $0.54。它的中位数运行写入缓存 94,059 token,读回只有 37,598;只跑 5 轮,写进去的缓存没什么机会复用。如果 75 折对这些调用生效,中位数大约是 $0.41,这一点我们没有核实。页面顶部还有一条「API Free Week」横幅,看内容针对的是数据类 API,表里的模型 token 价格不受它影响。
整场 132 次运行按标价合计 $17.16(Claude Code 自报 $44.55)。正式测试前的 2 次试跑($0.24)和下文脚本的 1 次演示运行($0.0069)不计入表格。
怎么选
| 你要的是 | 选 | 但是 |
|---|---|---|
| 最便宜、几乎全过 | GPT-6 Luna:11/12,单任务 $0.0071 | 小步多轮(中位数 22 轮),边界情况要写清楚 |
| 零失误、成本适中 | GPT-6.1 Sol、GLM-5.3 Prime、Sonnet 5.5 或 Kimi K3:12/12,$0.10 到 $0.14 | Sol 和 Sonnet 耗时中位数 109 到 114 秒,Prime 和 Kimi 不到 1 分钟 |
| 最快 | Grok 4.7(中位数 31 秒)或 GLM-5.3 Prime(37 秒) | Grok 漏了一次 CSV 边界 |
| 轮数最少、一步到位 | Claude Opus 5.5:中位数 5 轮 | 按标价,单任务成本是 $0.10 到 $0.14 那一档模型的 4 到 5 倍 |
| Luna 之外的便宜选项 | DeepSeek V4 Pro 或 MiniMax M3,约 $0.045 | 重构题都两次把舍入 bug 原样搬了过去 |
| 原版 GLM-5.3 | 目前没法在 SandBase 上给 Claude Code 用 | /v1/messages 返回 400,改用 GLM-5.3 Prime |
自己跑一遍
下面就是我们 2026-10-03 跑出下方结果的那个脚本。它把仓库拷到临时目录,用隔离的配置让 Claude Code 走 SandBase,最后读实时模型卡给这次运行算价。key 只从 SANDBASE_API_KEY 读。
#!/usr/bin/env bash
# Run Claude Code headless against SandBase on a throwaway copy of a repo,
# then price the run at the SandBase list price of the model.
# Usage: SANDBASE_API_KEY=... ./cc_sandbase.sh <sandbase-model-id> <repo-dir> "<prompt>"
set -euo pipefail
MODEL="$1"; SRC="$2"; PROMPT="$3"
: "${SANDBASE_API_KEY:?set SANDBASE_API_KEY in the environment}"

WORK="$(mktemp -d)"   # throwaway copy: the agent may run any command here
CFG="$(mktemp -d)"    # isolated Claude Code config, so your normal login is untouched
cp -R "$SRC"/. "$WORK"/
cd "$WORK"

env -u ANTHROPIC_API_KEY \
  CLAUDE_CONFIG_DIR="$CFG" \
  ANTHROPIC_BASE_URL="https://api.sandbase.ai" \
  ANTHROPIC_AUTH_TOKEN="$SANDBASE_API_KEY" \
  ANTHROPIC_MODEL="$MODEL" ANTHROPIC_SMALL_FAST_MODEL="$MODEL" \
  ANTHROPIC_DEFAULT_HAIKU_MODEL="$MODEL" ANTHROPIC_DEFAULT_SONNET_MODEL="$MODEL" \
  ANTHROPIC_DEFAULT_OPUS_MODEL="$MODEL" \
  DISABLE_TELEMETRY=1 DISABLE_ERROR_REPORTING=1 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 \
  perl -e 'alarm shift; exec @ARGV' 600 \
  claude -p "$PROMPT" --model "$MODEL" --output-format json --max-turns 40 \
    --dangerously-skip-permissions > "$CFG/result.json" 2> "$CFG/stderr.txt" || true

echo "work dir: $WORK"
python3 - "$MODEL" "$CFG/result.json" <<'EOF'
import json, os, sys, urllib.request
model, path = sys.argv[1], sys.argv[2]
run = json.load(open(path))
u = run.get("usage") or {}
req = urllib.request.Request(f"https://api.sandbase.ai/v1/models/{model}",
                             headers={"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"})
card = json.load(urllib.request.urlopen(req, timeout=60))["model_card"]
p_in, p_out = float(card["prompt_token_price"]), float(card["completion_token_price"])
read_mult = float(card.get("cache_read_multiplier") or 1)    # missing -> priced as normal input
write_mult = float(card.get("cache_write_multiplier") or 1)  # missing -> priced as normal input
cost = (u.get("input_tokens", 0) * p_in
        + u.get("cache_creation_input_tokens", 0) * p_in * write_mult
        + u.get("cache_read_input_tokens", 0) * p_in * read_mult
        + u.get("output_tokens", 0) * p_out) / 1e6
print(json.dumps({"model": model, "is_error": run.get("is_error"), "num_turns": run.get("num_turns"),
                  "duration_ms": run.get("duration_ms"),
                  "claude_code_reported_usd": run.get("total_cost_usd"),
                  "sandbase_list_price_usd": round(cost, 4),
                  "usage": {k: u.get(k, 0) for k in ("input_tokens", "cache_creation_input_tokens",
                                                     "cache_read_input_tokens", "output_tokens")},
                  "result": (run.get("result") or "")[:200]}, indent=1))
EOF
--dangerously-skip-permissions 的意思是 agent 执行任何 shell 命令都不再询问。只在这种一次性目录里用,别在放着凭据的代码仓库里用,也别配一个消费上限很高的 key。
实测记录(2026-10-03,UTC)。 14:17:01 我们用 openai/gpt-6-luna 和上面那段提示词,在 T1 分页仓库上跑了这个脚本,14:18:41 结束,输出如下(完整原样;result 是脚本自己截到 200 个字符的):
{
 "model": "openai/gpt-6-luna",
 "is_error": false,
 "num_turns": 20,
 "duration_ms": 97428,
 "claude_code_reported_usd": 0.34457125000000005,
 "sandbase_list_price_usd": 0.0069,
 "usage": {
  "input_tokens": 1879,
  "cache_creation_input_tokens": 19629,
  "cache_read_input_tokens": 342890,
  "output_tokens": 1642
 },
 "result": "Updated `pager.py` to use 1-indexed pagination, validate invalid inputs, calculate partial pages correctly, and set `page_info` flags according to the README spec. I did not edit anything under `tests"
}
之后我们把 T1 的隐藏测试拷进它的工作目录,10 个全过。num_turns、usage、total_cost_usd、result 是我们在 Claude Code 2.1.246 的 --output-format json 里观察到的字段,不是有文档保证的 schema,读的时候做好容错。接下来可以看 Anthropic Messages API 文档了解契约,或者申请一个 SandBase API key,在自己的仓库上跑一遍。
关于测试材料:6 道题都是我们为这次测试写的玩具仓库,不含第三方代码和个人数据。题目规格、提示词、判分规则和汇总数据都在本文里,逐次运行的日志和对话记录留在内部。
常见问题
除了 Claude,哪个模型最适合 Claude Code?
这 6 道题上,GPT-6.1 Sol、GLM-5.3 Prime、Kimi K3、Qwen3.8 Max 0902 都是 12/12,按标价单任务 $0.10 到 $0.18;GPT-6 Luna 11/12,只要 $0.0071。只有 6 道题、每题 2 次,当作候选名单看。
Claude Code 能用 GPT、Kimi、DeepSeek、Qwen 吗?
能,前提是走 Anthropic 兼容接口,比如 SandBase 的 /v1/messages。设好 ANTHROPIC_BASE_URL、ANTHROPIC_AUTH_TOKEN,把 ANTHROPIC_MODEL 设成 SandBase 的模型 id。我们试的 9 个非 Anthropic id 里 8 个能用,GLM-5.3 对 Anthropic 格式返回 HTTP 400。
为什么 Claude Code 显示的费用不准?
它不知道这些模型的价格。所有非 Anthropic 运行里,total_cost_usd 都和按 $5 / $25 每百万 token 算出的数字完全一致。整场它报 $44.55,按标价估算是 $17.16;光 MiniMax M3 就是 $9.46 对 $0.56。算钱请用 usage 自己算。
GPT-6 Luna 给 Claude Code 当引擎够用吗?
规格清楚的小任务,基本够用:11/12,唯一一次失败是规格边界,单任务不到 1 美分。它小步多轮(中位数 22 轮,约 100 秒)。把边界情况写进可见测试,或者让强模型 review 它的 diff。
Claude Code 换模型后,提示词缓存重要吗?
很重要。Claude Code 每轮都重发一大段系统提示词。GPT-6.1 Sol、Luna、Sonnet 5.5、GLM-5.3 Prime 的 token 有 92% 到 94% 是缓存读取,标价只有输入价的 0.05 到 0.2 倍。MiniMax M3 报的缓存读取很少,大部分输入按全价计。
局限
6 道规格清楚的标准库 Python 小题,不等于真实代码库;每题 2 次,也分不出只差一次失误的模型。参数都是默认值,没调 reasoning effort,没写 CLAUDE.md。耗时来自单台机器、经本地代理、最多 5 个并行、一个下午,只能看个大概。成本是按自报用量和标价估算的,不是对过账的账单,Opus 的折扣是否生效也没核实。GLM-5.3 Prime 是 GLM-5.3 失败后才加的替补,不在原始名单里。模型和路由随时会变,选定之前,用这个脚本在自己的仓库上再跑一遍。