大模型 Agent 工具调用实测:12 个模型跑 51 题
大模型 Agent 工具调用实测:GPT-6.1 Sol、Kimi K3、Qwen3.8、GLM-5.3、DeepSeek V4 Pro 等 12 个模型,17 道计分题各跑 3 次,对比准确率、单任务成本和延迟。
H2 这道题给所有模型同一页 20 条抖音视频,要求列出点赞数高于平均值的视频 ID。符合条件的只有 4 条。Claude Sonnet 5.5 三次分别列了 7 条、6 条、5 条,最低把点赞只有 337,922 的也算了进去,而平均值是 422,764。还有 6 个模型的 8 次运行干脆没交卷:1,500 token 的输出上限全花在写算术过程上,有几次连最后的答案行都写到一半就被切断了。
这次大模型 Agent 工具调用实测里,这个现象反复出现。我们在 2026-10-03(UTC)通过 SandBase 让 12 个模型用同一套 6 个数据工具、同一段系统提示词,做 17 道计分题,每题 3 次。调用工具这一步,所有模型都很干净;丢分几乎都发生在工具返回之后:要么让模型心算,要么模型从错的地方取了数。
先说结论
- 4 个模型满分 51/51:GPT-6.1 Sol、Grok 4.7、Kimi K3、Qwen3.8 Max Prime。MiMo v2.6 Pro 50/51;Claude Sonnet 5.5 垫底,44/51。
- 12 个模型的工具调用全部符合 schema(每个模型 89 到 104 次),选工具这一步拉不开差距。
- 22 次失误里有 10 次是心算写过程写到 1,500 token 被截断。把这些题用 4,000 token 重跑,27 次里过了 26 次。
- 按标价算,单任务成本中位数从 MiMo v2.6 Pro 的 $0.0018、MiniMax M3 的 $0.0019,到 GPT-6.1 Sol 的 $0.0069、Kimi K3 的 $0.0159、Qwen3.8 Max Prime 的 $0.0213。
- 测试范围:一类任务(中文社媒数据查询 + 统计),每题 3 次,默认参数,单日数据。不是通用模型排名。
这是 Claude Sonnet 5.5 和 GPT-6.1 Sol 对比实测的扩展版:同一套测试程序,同样的 10 道短题(T1 到 T10),再加 8 道更难的题(H1 到 H8),模型从 2 个扩到 12 个,新增的大多是国产大模型。
12 个模型和价格
下面的价格都是 2026-10-03 SandBase 的标价,取自 GET https://api.sandbase.ai/v1/models/<id> 里的 price_formula,单位是每百万 token 美元。
| 模型(SandBase id) | 输入 | 输出 |
|---|---|---|
openai/gpt-6.1-sol | $2 | $10 |
anthropic/claude-sonnet-5.5 | $2 | $10 |
x-ai/grok-4.7 | $2 | $6 |
moonshotai/kimi-k3 | $3 | $15 |
alibaba/qwen3.8-max-prime | $4 | $12 |
alibaba/qwen3.8-max-0902 | $2 | $6 |
z-ai/glm-5.3-prime | $2.80 | $8.80 |
z-ai/glm-5.3 | $1.40 | $4.40 |
deepseek/deepseek-v4-pro-0813 | $1.32 | $3.96 |
minimax/minimax-m3 | $0.30 | $1.20 |
xiaomi/mimo-v2.6-pro | $0.435 | $0.87 |
bytedance/seed-2.1-pro | $0.89 | $4.45 |
GPT-6.1 Sol 和 Grok 4.7 在提示词超过 272K、200K token 后会切到更高一档,本次没有任何请求接近这个长度。
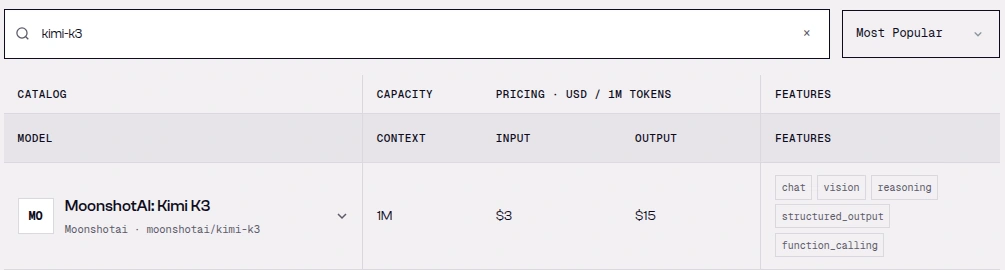
截图:SandBase 模型目录中 moonshotai/kimi-k3 的价格为每百万 token 输入 $3、输出 $15,本文 Kimi K3 的成本按这个费率计算(2026-10-03 截取)。
Kimi K3 的输出单价是 12 个模型里最贵的,单任务成本也只比 Qwen3.8 Max Prime 低。它的输入 token 中位数(2,870)是 12 个模型里最少的,和 GPT-6.1 Sol 的差距主要在输出:每个任务约 410 个输出 token、$15/百万,对方只有 110 个、$10/百万。
测试怎么做的:6 个工具、18 道题、精确比对
Claude Sonnet 5.5 走 SandBase POST /v1/messages(Anthropic 协议)。其余 11 个模型都走 SandBase POST /v1/chat/completions,用 OpenAI function tools,换模型只改 model 字段。每轮最多输出 1,500 token,每题最多 10 轮,temperature 和推理强度都用默认值。
6 个工具封装的是 SandBase 公开数据接口:douyin/search/user-search-v2、douyin/app-v3/user-profile、douyin/app-v3/user-post-videos、weibo/web-v2/hot-search、weibo/web-v2/realtime-search、xiaohongshu/app-v2/search-notes。
为了公平,测试程序按“工具名 + 参数”缓存每次返回,所有模型看到的是同一份缓存。T 组用的就是上一篇那份缓存,02:50 到 02:58(UTC)抓取,07:30 到 07:35 又补了三次小查询;难题额外需要的数据(星巴克中国的主页和两次微博搜索)在 07:50 左右抓取。正式运行在 07:36 到 08:16 左右,全部在 2026-10-03。模型如果请求了缓存里没有的东西,比如换了个搜索词,就会实时调用接口,这次结果也算在它自己的运行里。
标准答案用 Python 从同一份缓存算出:过滤、max、sum、sorted、字符串匹配,模型输出不参与出答案。T1(瑞幸咖啡粉丝数)到 T10(露营两个最大值)的完整题目见上一篇。难题如下:
| 题目 | 要做什么 | 考什么 |
|---|---|---|
| H1 | 按主页粉丝数给瑞幸咖啡、CottiCoffee 库迪咖啡、星巴克中国排序,并求和 | 三次查询、排序、三个七位数相加 |
| H2 | 列出点赞数严格高于本页平均值的视频 ID,按点赞从高到低 | 20 个数求均值、过滤、排序 |
| H3 | 微博热搜第 11 到 20 名的热度求和,并数出超过 10 万的有几条 | 十个大数相加 |
| H4 | 小红书分别搜“防晒霜”和“露营”,第一页点赞总数哪个大、是多少 | 两个列表分别求和 |
| H5 | 拿热搜第 2、3 名分别搜微博,报第一页帖子数 | 两条链式调用 |
| H6 | 抖音用户搜“露营”,粉丝超过 50 万的有几个,粉丝第三多的是谁 | 计数 + 排名 |
| H7 | 找昵称正好是“库迪咖啡”的账号 | 不计分(见下文) |
| H8 | 2026-10-02 发布的视频里,分享最多的是哪条,评论总数是多少 | 日期过滤、取最大、求和 |
12 个模型用的是同一段系统提示词,原文如下:
You are a research agent with tools for public Douyin, Weibo and Xiaohongshu data. Use the tools to answer; never guess numbers. If something can't be found, say so. Finish with ONE line that starts with FINAL: followed by a compact JSON object with exactly the keys requested.判分程序解析 FINAL: 后面的 JSON 对象,逐个字段比对:整数去掉逗号后比,布尔值统一小写后比,ID 和名称按字符串精确比对,列表(H1 的排名、H2 的 ID 列表)按顺序逐个元素比对。缺字段、JSON 解析失败、没有 FINAL: 行都算错;多出的字段不扣分。
H7 不计分,问题出在我们自己的题目上。题目要找昵称正好是“库迪咖啡”的账号,结果有两个这样的小号,粉丝都不到 40。不过各模型的反应挺说明问题:GPT-6.1 Sol 和 Qwen3.8 Max Prime 三次都把两个账号报了出来(Prime 有一次是选一个、再备注另一个);DeepSeek V4 Pro 三次也都列了两个,但写成了 JSON 数组,判分程序解析不了;Grok 4.7、Kimi K3、Seed 2.1 Pro 每次都只挑了同一个;其余模型时好时坏。我们内部的汇总文件只把“字段值是列表”的回答记为“两个都报”,所以那里 Qwen Prime 记 2 次、DeepSeek 记 0 次。
缓存的原始返回不公开,因为里面是第三方平台上真实账号的内容。题目、提示词、判分规则和汇总结果都写在本文里,足够你用自己的新快照重建这套测试;原始缓存和测试程序留在内部。
结果:准确率、成本、延迟
| 模型 | 每百万 token 输入 / 输出 | 简单题(T,30) | 难题(H,21) | 合计(51) | 单任务成本中位数 | 耗时中位数 | 截断次数 |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Sol | $2 / $10 | 30 | 21 | 51 | $0.0069 | 9.5 秒 | 0 |
| Grok 4.7 | $2 / $6 | 30 | 21 | 51 | $0.0139 | 8.7 秒 | 0 |
| Kimi K3 | $3 / $15 | 30 | 21 | 51 | $0.0159 | 8.5 秒 | 0 |
| Qwen3.8 Max Prime | $4 / $12 | 30 | 21 | 51 | $0.0213 | 8.4 秒 | 0 |
| MiMo v2.6 Pro | $0.435 / $0.87 | 30 | 20 | 50 | $0.0018 | 12.7 秒 | 1 |
| DeepSeek V4 Pro | $1.32 / $3.96 | 28 | 21 | 49 | $0.0069 | 10.2 秒 | 0 |
| GLM-5.3 | $1.40 / $4.40 | 29 | 20 | 49 | $0.0066 | 21.5 秒 | 1 |
| Qwen3.8 Max 0902 | $2 / $6 | 30 | 19 | 49 | $0.0112 | 12.3 秒 | 2 |
| GLM-5.3 Prime | $2.80 / $8.80 | 30 | 19 | 49 | $0.0130 | 9.8 秒 | 2 |
| MiniMax M3 | $0.30 / $1.20 | 28 | 20 | 48 | $0.0019 | 10.2 秒 | 1 |
| Seed 2.1 Pro | $0.89 / $4.45 | 29 | 19 | 48 | $0.0058 | 17.1 秒 | 3 |
| Claude Sonnet 5.5 | $2 / $10 | 27 | 17 | 44 | $0.0130 | 13.6 秒 | 0 |
51 次计分运行里,每个模型调用工具 89 到 104 次,没有一次不符合 schema。T9 那个不存在的账号,12 个模型每次都老实回答“没有”。
GPT-6.1 Sol 在 T 组上复现了上一篇的成绩(30/30,这组题的成本中位数 $0.0066),难题也全对。Sonnet 5.5 这次重新跑了 T 组,还是 27/30,但错的题和上次不一样。
分丢在哪
22 次失误分三类,最大的两类其实是同一个根源。
心算写过程被截断(10 次)。 Qwen3.8 Max 0902 两次、GLM-5.3 Prime 两次、GLM-5.3 一次、MiniMax M3 一次、MiMo v2.6 Pro 一次、Seed 2.1 Pro 三次,其中 8 次是 H2。接口返回 finish_reason: length,没有 FINAL 行。看输出结尾,模型都在逐条列累加过程,或者把 20 条视频画成表格;有几次 FINAL 已经开了头,写到列表中间被切断。我们只把这些题用每轮 4,000 token 重跑,27 次过了 26 次,GLM-5.3 又截断了一次:两轮合计输出 4,105 token,最后一轮撞上了上限。这不代表这些模型放宽预算就能 51/51,因为只重跑了出错的题;但它说明,大部分这类失误是预算耗尽,不是推理错了。
答错(11 次)。 Claude Sonnet 5.5 占 7 次,全是对工具结果做算术或计数,而且每次都有能解析的 FINAL 行:
- T5 平均点赞:答 422,762 和 415,962,正确是 422,764。
- T7 日期计数:答 17,正确是 19。
- H2:三次都多列了 1 到 3 条低于平均值的视频。
- H3 热度求和:答 1,822,122,正确是 1,832,122,正好差 10,000。
另外 4 次是没按要求取数。T4 要求按“主页”粉丝数比较,DeepSeek V4 Pro 一次、MiniMax M3 两次跳过了两次主页调用,直接拿搜索结果里的粉丝数相减,得出 1,298,178,比按主页算的 1,298,061 多 117。T2 上 DeepSeek V4 Pro 抄账号 ID 时把其中三个字符的顺序抄乱了,实时接口对这个 ID 返回空列表,模型如实说“没有返回视频”并答 null,只是没意识到 ID 是自己抄错的。这次调用格式合法,所以不会被算成无效工具调用。
漏写 FINAL(1 次)。 GLM-5.3 在 T5 上把正确平均值 422,764 写在了正文里,然后就停了,没写 FINAL 行。
不管选哪个模型,这两条经验都用得上:
- 统计放进代码里算。 大部分失误发生在模型心算 10 到 20 个数的时候。让工具直接返回总和、均值、排名或过滤后的列表,或者给 Agent 一个计算器工具,几行 Python 的事。
- 写清每个数从哪来。 搜索结果里已经带了粉丝数,“per profile”这几个字对两个模型就不够用。如果某个数必须来自某次调用,就写进工具描述里;或者干脆别在别的工具里返回这个数。
成本:同样的准确率,价格差了一个量级
这里的单任务成本,是各接口返回的 token 用量乘以上面的标价,不是账单,也没开 prompt caching。整个实验 675 次运行(含 4,000 token 重跑)按标价花了约 $7.54 的 LLM token;正式测试前还有一轮只跑 T1、T5、T9 的试跑,花了 $0.29,不计入任何表格。6 个数据接口在 2026-10-03 的 GET /v1/models/<id> 里 base_price 都是 0(免费)。
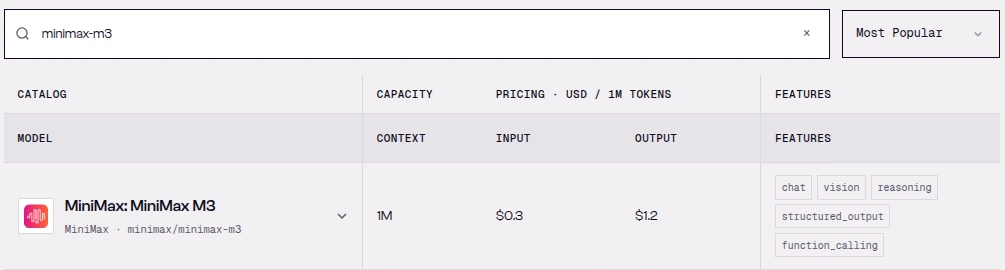
截图:SandBase 上 MiniMax M3 的标价是每百万 token 输入 $0.30、输出 $1.20,是本次最便宜的两档之一(2026-10-03 截取)。
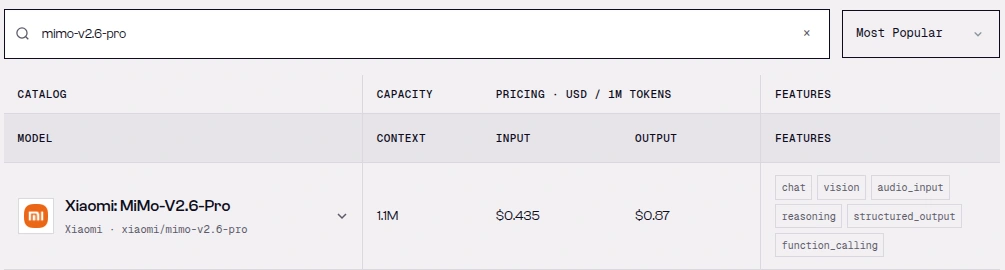
截图:小米 MiMo v2.6 Pro 的标价是每百万 token 输入 $0.435、输出 $0.87,输出单价是 12 个模型里最低的(2026-10-03 截取)。
按中位数算,每天跑 1,000 个这类任务,MiMo v2.6 Pro 约 $1.80,MiniMax M3 约 $1.90,GPT-6.1 Sol 约 $6.90,Kimi K3 约 $15.90,Qwen3.8 Max Prime 约 $21.30。这是用每个模型 51 次短任务外推的,但差距大到不怕一点噪声。MiMo 和 MiniMax 的单任务成本大约是 GPT-6.1 Sol 的四分之一。
价目表排不出这个顺序。Grok 4.7 的输出单价比 GPT-6.1 Sol 低($6 对 $10),单任务成本却是它的两倍,因为输入 token 中位数是 5,718 对 2,887。Grok 多出来的输入从哪来,我们没有单独拆。输出的差距更大:GPT-6.1 Sol 每个任务输出中位数只有 110 token,其余 11 个模型在 279(Grok 4.7)到 620(MiniMax M3)之间。GPT-6.1 Sol 的回答很短;对于会上报推理 token 的模型,按 usage 里的口径,推理 token 已计入 completion。
耗时中位数从 8.4 秒(Qwen3.8 Max Prime)到 21.5 秒(GLM-5.3)。最大的离群值来自 Claude Sonnet 5.5,一次 H3 跑了 259 秒;上一篇的试跑里 Sonnet 也出现过一次 259 秒。耗时包含 SandBase 网关,以及每次工具调用几毫秒的缓存读取,都从同一台机器测得。
怎么选
| 需求 | 先试 | 但是 |
|---|---|---|
| 短小工具任务、准确率优先、成本适中 | GPT-6.1 Sol:51/51,每任务 $0.0069 | 回答很简短,需要解释过程得另外要求 |
| 准确率优先,要第二、第三选择 | Kimi K3、Grok 4.7、Qwen3.8 Max Prime:都是 51/51 | 单任务成本是 GPT-6.1 Sol 的 2 到 3 倍 |
| 成本优先 | MiMo v2.6 Pro(50/51)或 MiniMax M3(48/51),每任务约 $0.002 | 输出预算给大一点,算术放进代码;MiniMax 还有两次没按“主页”取数 |
| 成本和 GPT-6.1 Sol 相近的另一个选择 | DeepSeek V4 Pro:中位数同为 $0.0069 | 简单题上有两次没照指令(取数来源、ID 抄错) |
| 需要 Claude 生态的特性 | Claude Sonnet 5.5 | 本次最低分(44/51),失误全是心算,先把算术挪进工具 |
再强调一次,这不是通用排名:只覆盖一类任务(中文社媒数据查询 + 统计),每题 3 次,默认参数。这里被截断的模型,调大 max_tokens 或调低推理强度后可能就没问题;写代码、读长文档的表现,这次也完全没测。
在 SandBase 上跑一遍类似的测试
一个 SandBase API Key 就能调到这 12 个模型和数据工具。其中 11 个走同一套 OpenAI 兼容的 Chat Completions 接口,换模型只改一个字符串。同一批数据接口,SandBase 目录页列的是 GET /apis/v1/<vendor>/...,本文用的是各接口 API 参考里的 Model API 路由 POST https://api.sandbase.ai/v1/api/<vendor>/<path>,两者别混用。
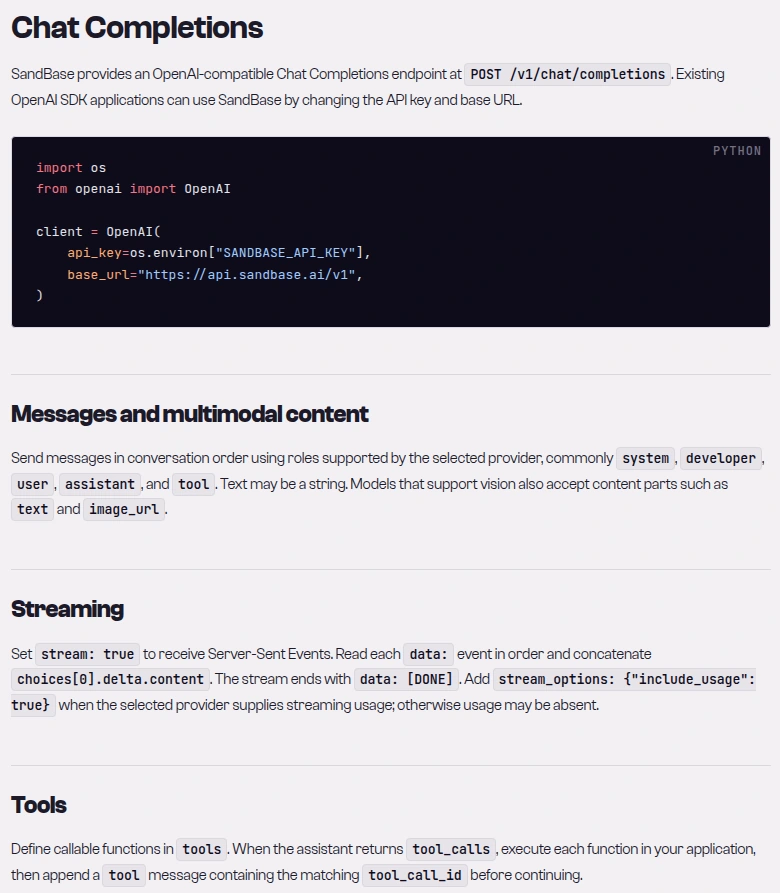
截图:SandBase Chat Completions 文档写明了 POST /v1/chat/completions,以及本次 11 个 OpenAI 兼容模型所用的 tool_calls / tool_call_id 循环(2026-10-03 截取)。
下面的示例把两条经验都用上了:工具在 Python 里算好点赞统计、只返回汇总值;循环遇到 finish_reason: length 直接报错,不悄悄吞掉。aweme_list、statistics.digg_count 等字段来自我们 2026-10-03 的实际返回,属于观测到的字段,不是文档保证,所以用 .get() 防御式读取。
import os
import json
import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
# SandBase 上任意 OpenAI 兼容模型,换模型只改 id
MODELS = ["openai/gpt-6.1-sol", "minimax/minimax-m3", "xiaomi/mimo-v2.6-pro"]


def call_data_api(model: str, params: dict) -> dict:
    """调用 SandBase 数据接口,只返回 outputs[0].data;没完成就直接报错。"""
    resp = requests.post(f"{BASE}/api/{model}", headers=HEADERS, json=params, timeout=120)
    resp.raise_for_status()
    body = resp.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs:
        raise RuntimeError(f"SandBase call did not complete: {body.get('status')} {body.get('error')}")
    return outputs[0].get("data") or {}


def douyin_video_stats(sec_user_id: str) -> dict:
    """账号第一页视频的点赞统计,在这里算好,不交给模型。"""
    data = call_data_api("douyin/app-v3/user-post-videos",
                         {"sec_user_id": sec_user_id, "max_cursor": 0, "count": 20})
    likes = [(item.get("statistics") or {}).get("digg_count") or 0  # 观测到的字段名
             for item in data.get("aweme_list") or []]
    if not likes:
        return {"videos": 0, "found": False}
    mean = sum(likes) / len(likes)
    return {"videos": len(likes), "likes_sum": sum(likes), "likes_mean_floor": sum(likes) // len(likes),
            "likes_max": max(likes), "above_mean": sum(x > mean for x in likes)}


TOOLS = [{"type": "function", "function": {
    "name": "douyin_video_stats",
    "description": "Like statistics for the first page (up to 20) of a Douyin account's videos.",
    "parameters": {"type": "object", "properties": {"sec_user_id": {"type": "string"}},
                   "required": ["sec_user_id"]}}}]
SYSTEM = "Use the tools to answer; never guess numbers. Finish with one line: FINAL: {json}."


def run(model: str, task: str, max_tokens: int = 4000) -> str:
    messages = [{"role": "system", "content": SYSTEM}, {"role": "user", "content": task}]
    for _ in range(10):
        resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS, timeout=240,
                             json={"model": model, "max_tokens": max_tokens,
                                   "tools": TOOLS, "messages": messages})
        resp.raise_for_status()
        body = resp.json()
        choice = body["choices"][0]
        msg = choice["message"]
        messages.append({k: v for k, v in msg.items() if k in ("role", "content", "tool_calls")})
        if choice.get("finish_reason") == "length":
            raise RuntimeError(f"{model}: output cut at max_tokens={max_tokens}")
        calls = msg.get("tool_calls") or []
        if not calls:
            return msg.get("content") or ""
        for call in calls:
            args = json.loads(call["function"].get("arguments") or "{}")
            messages.append({"role": "tool", "tool_call_id": call["id"],
                             "content": json.dumps(douyin_video_stats(**args))})
    raise RuntimeError("turn limit reached")


if __name__ == "__main__":
    task = ("For the Douyin account with sec_user_id "
            "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4, what is the average like count "
            "on the first page, rounded down? Keys: videos, average_likes.")
    for model in MODELS:
        print(model, run(model, task).strip().splitlines()[-1])
实测于 2026-10-03(UTC)。 我们在 13:59 到 14:01(UTC)原样跑了上面的程序。输入:T2、T5、T7 用过的人民日报公开抖音账号。每个模型的工具调用都发送 POST https://api.sandbase.ai/v1/api/douyin/app-v3/user-post-videos,body 为 {"sec_user_id": "MS4wLjABAAAA8U_l6rBzmy7bcy6xOJel4v0RzoR_wfAubGPeJimN__4", "max_cursor": 0, "count": 20}。GPT-6.1 Sol 那次调用的返回节选:
{"id": "14d98563-da7d-45b4-900a-aa1c4e3c6b92", "status": "completed",
 "model": "douyin/app-v3/user-post-videos",
 "outputs": [{"data": {"aweme_list": [
   {"aweme_id": "7692418769125199138", "statistics": {"digg_count": 9522}},
   {"aweme_id": "7692417622113111323", "statistics": {"digg_count": 3843}}],
  "has_more": 1}}]}
只展示 aweme_list 20 条中的前 2 条;每条只保留 aweme_id 和 statistics.digg_count,其余键都已省略。外层结构(id、status、model、outputs[0].data)有文档说明;data 里的字段是我们在这次返回里观察到的,不是文档字段。
程序输出:
openai/gpt-6.1-sol FINAL: {"videos":20,"average_likes":403206}
minimax/minimax-m3 FINAL: {"videos": 20, "average_likes": 403251}
xiaomi/mimo-v2.6-pro FINAL: {"videos": 20, "average_likes": 403304}
三个模型答的都是各自那次工具调用算出的 likes_mean_floor。三个数不一样,是因为每次都实时调用,点赞数还在涨。这也正是正式测试要回放缓存的原因。GET /v1/tasks/<id>/cost 显示,每个模型两次 LLM 调用合计:GPT-6.1 Sol $0.001608,MiniMax M3 $0.000461,MiMo v2.6 Pro $0.000349;每次数据调用 $0.000000。这个接口和 GET /v1/models/<id> 都需要和调用相同的 Authorization: Bearer Key;不带 Key 也能在公开模型页上看到价格。
请求字段见 抖音 user-post-videos API 文档。获取 SandBase API Key,换成你自己的模型列表跑一遍。
数据边界:这些都是公开数据的只读查询,需要 SandBase API Key。SandBase 不是抖音、微博、小红书的官方合作方,不涉及私密账号、私信、账号后台数据或任何账号操作。想看用同样思路搭的完整 Agent,可以参考跨平台选品 Agent 教程,统计都在 Python 里算,GPT-6.1 Sol 只负责写总结。想多了解本次表现靠前的 Kimi K3,可以看 Kimi K3 介绍。
常见问题
2026 年做 Agent 工具调用,哪个大模型最好?
在这组测试里,GPT-6.1 Sol、Grok 4.7、Kimi K3、Qwen3.8 Max Prime 都是 51/51,其中 GPT-6.1 Sol 最便宜,每任务 $0.0069。但这只是一类任务、每题 3 次,适合当“查询 + 统计”类 Agent 的候选名单,不是通用排名。
国产大模型做 Agent 工具调用靠谱吗?
在这些任务上靠谱。Kimi K3 和 Qwen3.8 Max Prime 满分,MiMo v2.6 Pro 只错一次,GLM-5.3、GLM-5.3 Prime、Qwen3.8 Max 0902、DeepSeek V4 Pro 都是 49/51。不论国产还是海外,12 个模型的工具调用都没有一次不符合 schema。
Kimi K3 和 GPT-6.1 Sol 怎么选?
两个都是 51/51。GPT-6.1 Sol 单任务成本中位数 $0.0069,Kimi K3 是 $0.0159,主要差在输出:Kimi 每个任务约 410 个输出 token、单价 $15/百万,GPT-6.1 Sol 只有 110 个、单价 $10/百万。耗时中位数 Kimi K3 略快(8.5 秒对 9.5 秒)。
做工具调用 Agent,最便宜又能用的是哪个?
MiMo v2.6 Pro 50/51,单任务成本中位数 $0.0018;MiniMax M3 48/51,$0.0019。两个都在 H2 上被 1,500 token 上限截断过一次,用 4,000 token 重跑都过了;MiniMax 另外有两次在 T4 上拿了搜索结果里的粉丝数。输出预算给足,算术放进代码。
Claude Sonnet 5.5 为什么分最低?
它的 7 次失误全是对工具结果做算术或计数:两次平均值、一次日期计数、三次过滤列表多列、一次求和差 10,000。它没有被截断过,也没有无效调用。把算术挪进工具,就绕开了它出错的那一步。
测试边界
只有一类任务:中文社媒数据查询 + 统计,17 道计分题,每题 3 次。temperature 和推理强度用默认值,每轮输出上限 1,500 token,没开 prompt caching,耗时从同一台机器测得。部分失误是截断,放大预算就好了,所以分数里也掺了“在这个上限下话多不多”。H7 因为我们自己的题目有歧义而不计分。612 次计分运行里只有 22 次失误,48 到 50 分这几个模型之间的先后,没法下确定结论。模型更新很快,上线前挑和你业务最像的题再跑一遍。