YouTube 频道研究 API 教程 | SandBase
用 Python 独立读取一条 YouTube 频道资料或一页上传视频,校验频道身份、保留本地化计数,区分高级信息与翻页 token。
频道资料和一页上传视频回答的是两个问题。前者帮助确认选中的账号身份,以及哪些公开显示指标可用;后者展示该频道返回的一批视频。它们都不是增长报告。研究一个已知频道,也不必先搜索话题,再遍历每条视频。
这次 2026-11-08 修订从选定的 channel_id 开始,提供 Channel Description 或 Channel Videos 两个独立首请求。证据来自当前免费 inspect 与公开保存样本,没有执行新的业务调用。原文 2026-09-28 UTC 的搜索到频道实验继续保留在历史章节;旧 web 路径不会被悄悄换成当前 web-v2 端点后仍称作原实测。
先说结论
- 第一次读取频道资料要传 channel_id;schema 将字段标为可选,还因为同一路由描述了后续 token 请求。
- 资料或上传列表选一项,只调用一次,检查 completed、outputs[0].data 和返回频道身份。
- 本地化计数和 null 原样保留。单个快照不能衡量增长,商业邮箱标志也不是邮箱地址。
- 资料的高级信息 token 与上传列表的翻页 token 用途不同,本轮均未执行续页。
沿用封面表达原有搜索到频道资料的概念。频道名称、认证徽章、显示数字、增长曲线和 agent 链路只是示意,不是核实过的身份、实际增长序列或本轮自动执行流程。
先确定要回答哪个问题
| 当前问题 | 选中端点 | 首次输入 |
|---|---|---|
| 公开身份与可用的频道指标 | Channel Description | channel_id、language_code en、country_code US、need_format true |
| 一页返回的上传视频 | Channel Videos | 相同频道与语言地区,省略 continuation_token |
显示名称、@handle、频道 URL 和 channel_id 不能随意互换。如果尚未拿到 ID,应使用对应现行接口单独解析。本例不会从搜索结果猜频道,也不会自动选择第一个同名创作者;选中了谁,直接决定研究结果在描述谁。
YouTube API 导航 提供更广的目录。若要研究一个已知视频下的讨论,参见评论首请求教程;短视频发现则是Shorts 教程 的独立任务,当前上传列表不是完整 Shorts 清单的保证。
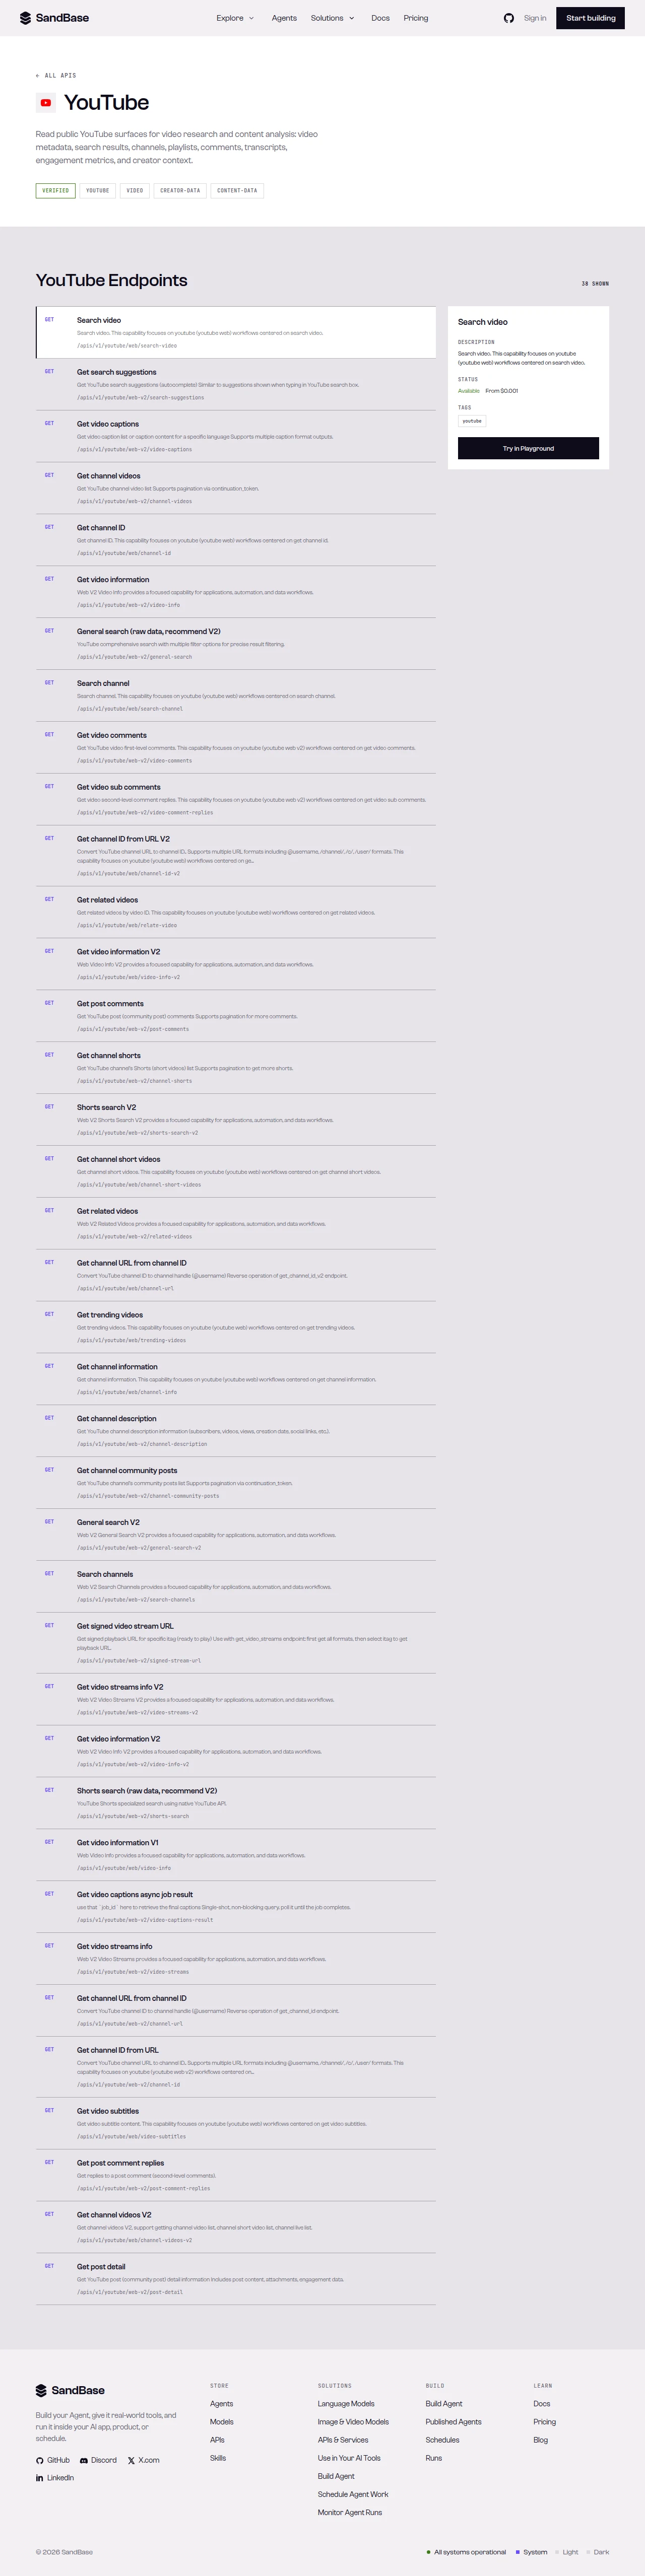 沿用原文章的历史 YouTube 目录。图中 38 项、From $0.001 标识和 search-video/channel-info 导航属于历史资料,不是本轮两个 web-v2 请求的新可用性检查。
已有 key、已连 agent 与新项目
项目已经配置 SANDBASE_API_KEY,就复用环境变量或密钥管理器。已连接的 agent 只需要频道 ID、任务和希望保存的输出,不必重新开户,也不要把 key 发到聊天中。
新项目可以把 setup Skill、Markdown quickstart 与具体端点一起交给 agent;账号准备步骤见快速入门。例如:“读取这个频道的一条资料记录,核对返回 ID,保留原始计数和未知值,拿到一次响应就停,不联系创作者也不跟随链接。”需要视频列表时,再把任务改成一页 uploads。
在 Python 环境安装 requests。下面用 UC 加 22 个字符的本地校验,拦截名称、URL 和明显错误的 ID。registry 把 channel_id 定义为字符串,没有声明这个正则;这是本示例明确采用的首请求限制,不是擅自增加上游 schema 约束。
import os
import re
import requests

API = "https://api.sandbase.ai/v1/api/youtube/web-v2"


def first_request(task, channel_id):
    if task not in ("profile", "uploads"):
        raise ValueError("Choose profile or uploads")
    if not isinstance(channel_id, str) or not re.fullmatch(r"UC[A-Za-z0-9_-]{22}", channel_id):
        raise ValueError("Provide a selected UC channel ID, not a name, handle or URL")
    payload = {"channel_id": channel_id, "language_code": "en",
               "country_code": "US", "need_format": True}
    route = "channel-description" if task == "profile" else "channel-videos"
    key = os.environ.get("SANDBASE_API_KEY", "").strip()
    if not key:
        raise ValueError("Set SANDBASE_API_KEY in your environment")
    try:
        response = requests.post(
            f"{API}/{route}",
            headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
            json=payload, timeout=(10, 90), allow_redirects=False,
        )
        if not 200 <= response.status_code < 300:
            raise RuntimeError(f"SandBase HTTP {response.status_code}; request stopped")
        body = response.json()
    except requests.RequestException:
        raise RuntimeError("Network request failed; inspect locally before another call") from None
    except ValueError:
        raise RuntimeError("SandBase returned invalid JSON") from None
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("SandBase request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Missing documented outputs[0]")
    data = outputs[0].get("data")
    if not isinstance(data, dict):
        raise RuntimeError("Missing documented outputs[0].data object")
    if task == "profile":
        if data.get("channel_id") != channel_id or not isinstance(data.get("title"), str):
            raise RuntimeError("Profile reference shape or selected channel ID does not match")
    else:
        channel = data.get("channel")
        if not isinstance(channel, dict) or channel.get("id") != channel_id:
            raise RuntimeError("Uploads channel identity does not match")
        videos = data.get("videos")
        if not isinstance(videos, list) or any(not isinstance(v, dict) for v in videos):
            raise RuntimeError("Missing videos array of objects")
    return data


if __name__ == "__main__":
    result = first_request("profile", "UCeu6U67OzJhV1KwBansH3Dg")
    print("Received fields:", sorted(result))
若改查上传列表,把主程序赋值替换为 result = first_request("uploads", "UCeu6U67OzJhV1KwBansH3Dg")。只想调用一次时,不要把这行追加在后面。helper 不传 continuation_token、不自动重试或跟随重定向;HTTP、JSON、未完成状态和参考结构错误都会停止,异常文本不回显 key 或上游完整错误正文。
结构检查针对当前简化参考:资料字段直接位于业务对象中;上传页包含 videos 以及 channel 对象,其 id 要与请求一致。合法的空 videos 数组可以通过,缺失数组或返回了不同频道则不行。可选字段完整返回,不为缺少的指标创造默认值。
为什么资料 schema 可选,首请求仍要传 ID
Channel Description 描述两个阶段:首次用 channel_id 取基础资料,后续用返回的 continuation_token 请求高级信息。统一 schema 将字段设为可选,是因为需要描述这两种情况,不是建议首次发送空对象。本教程只实现已知频道的第一阶段,不猜 token,也没有测试高级信息请求。
Channel Videos 则明确要求 channel_id。两个接口都将 country_code US、language_code zh-CN、need_format true 作为默认值。新 helper 主动使用英文/美国的简化输出;语言偏好不意味着频道简介或视频标题一定被翻译,也不会让缩写计数变得精确。
有日期的资料参考,不是新测量
公开保存的 Channel Description 样本 ID 是 2052034d-9439-4c44-92db-3db9579d6579,created_at 为 2026-10-07T17:36:23.063Z。输入使用 UCeu6U67OzJhV1KwBansH3Dg、country_code US、language_code zh-CN 和 need_format true。下面从真实保存字段裁剪,并不是刚运行上方英文参数代码得到的结果:
{
  "channel_id": "UCeu6U67OzJhV1KwBansH3Dg",
  "title": "CozyCraft",
  "subscriber_count": "12万位订阅者",
  "video_count": "222 个视频",
  "view_count": null,
  "creation_date": null,
  "country": null,
  "has_business_email": false
}
subscriber_count 和 video_count 应连同语言及观察时间保留原始显示字符串。缩写订阅数即使转换成数值也仍是近似值,不应在报表里产生额外精度。view_count、creation_date、country 为 null,只表示该样本不可用,不能补成零次观看、今天创建,或根据频道使用语言推断国家。
一个资料快照无法证明增长。即使有两条记录,也要先核对指标、范围和时间是否可比。不要把 10 月资料和下方不同日期的上传参考拼接成业绩趋势,它们是两个任务的独立参考,不是配对的长期实验。
has_business_email 是标志,不是邮箱地址,也不授权联系。verified 是响应中的标记,不等于独立身份核验。空 links、缺失标志和明确否定应分开保存。头像、横幅和 RSS URL 只是引用,本脚本不下载图片、不订阅 feed,也不发送消息。
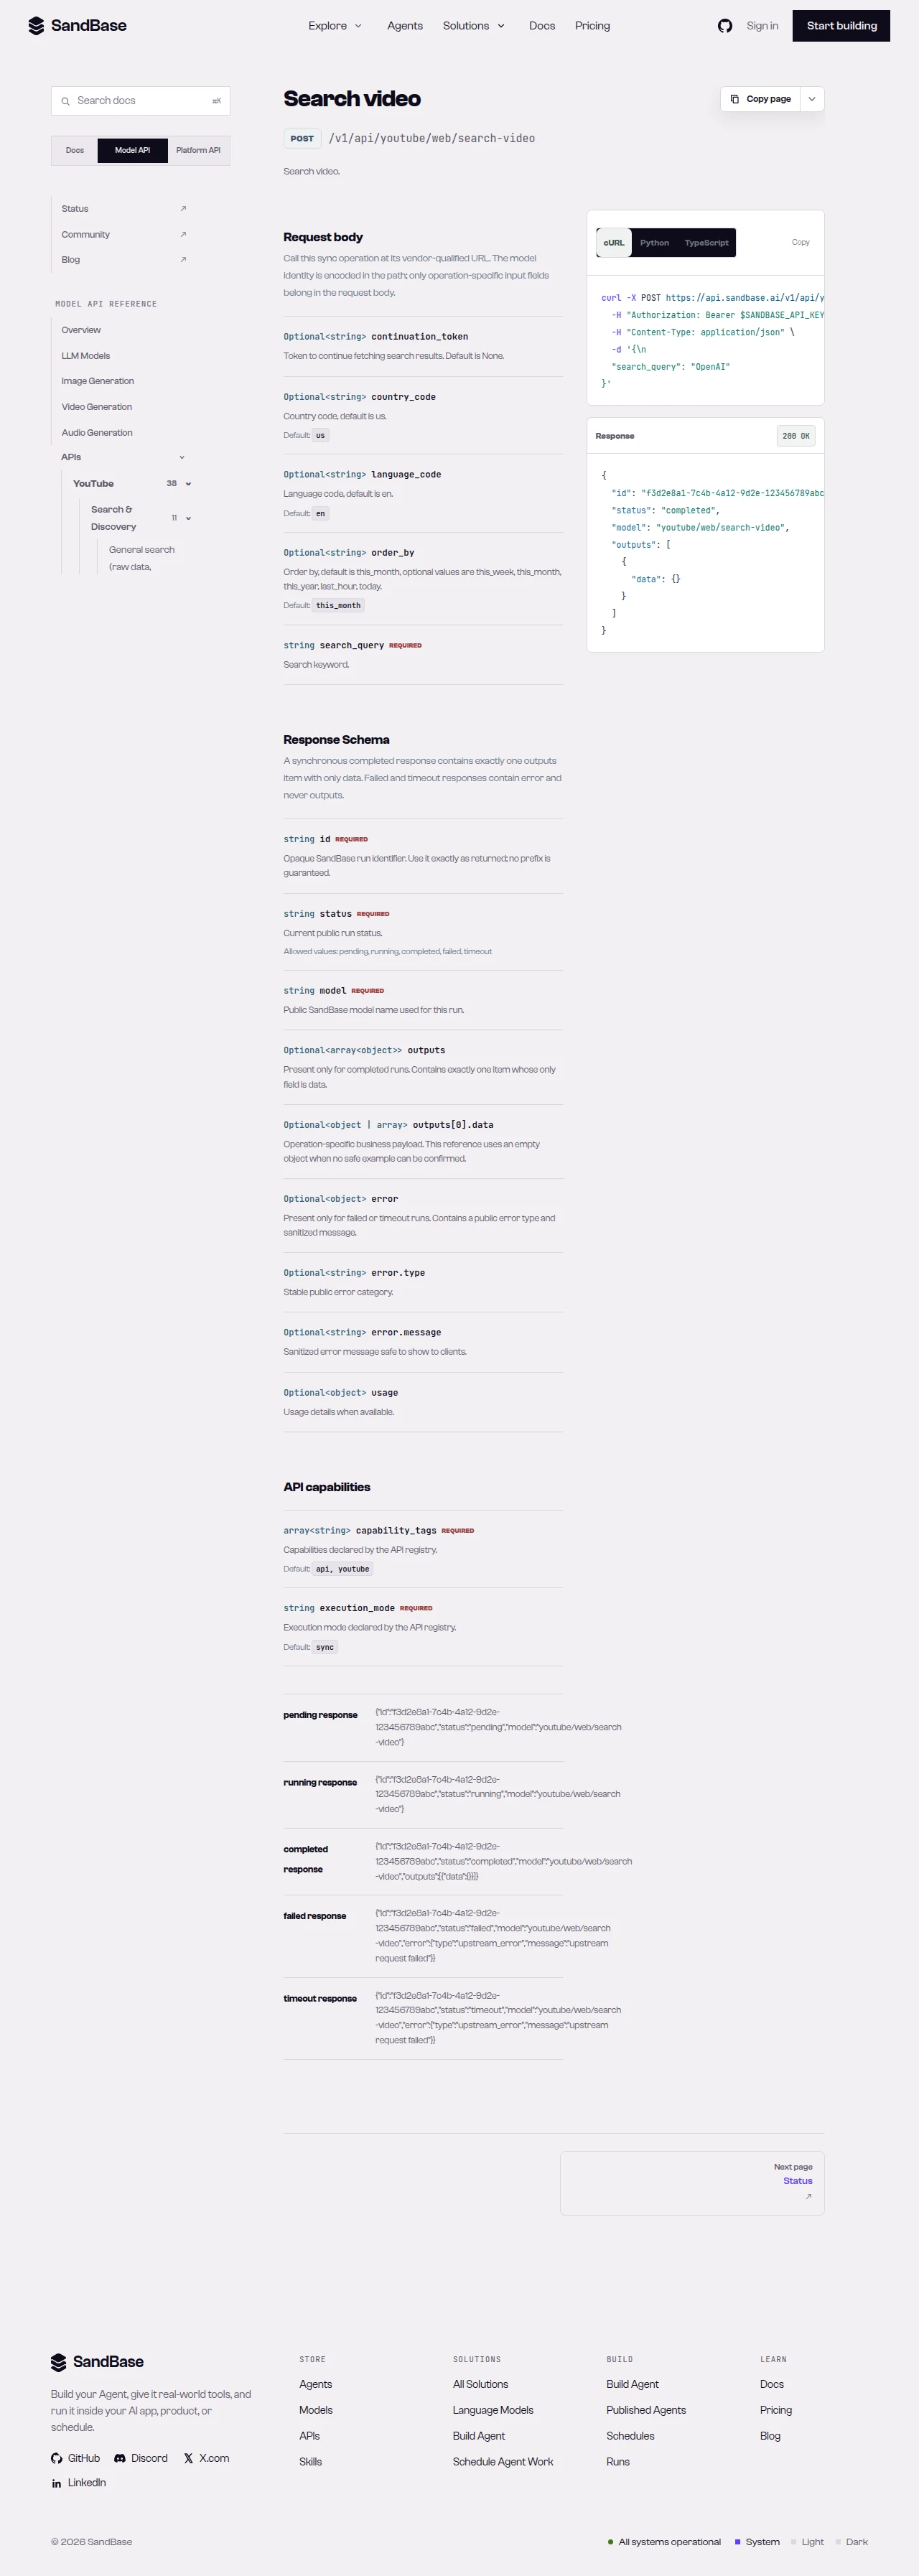 历史 web/search-video 参数参考,属于 9 月 28 日实验,不是当前 Channel Description 首请求。本轮未重新执行搜索或搜索续页。
把上传结果看作一页样本
Channel Videos 保存样本是 270ee769-7d3b-44e0-8e91-cb2cc6304832,created_at 为 2026-08-20T09:38:28.973Z。它同样使用该频道、US/zh-CN 和简化格式。完整保存响应中有 30 个视频,下面仅保留关联频道与一个视频,省略媒体和 token 字段:
{
  "channel": {
    "id": "UCeu6U67OzJhV1KwBansH3Dg",
    "name": "CozyCraft"
  },
  "videos": [
    {
      "video_id": "Y30C0VjUT78",
      "title": "you don't have to worry tonight… (minecraft music & ambience)",
      "published_time": "2天前",
      "duration": "11:00:00",
      "duration_accessibility": "11小时",
      "is_live": false
    }
  ]
}
30 是实际观察到的数量,不是固定页容量。当前 schema 没有数字 page、limit 或 sort,不能自行加上,也不能根据第一条结果就承诺按最新排序。这个响应是返回的上传样本,不是全量归档、频道私有分析或所有视频类型的完整清单。
保存每条视频的 video_id 和来源 URL 时,应关联返回频道。观看数与 published_time 可能是本地化显示文本;缺失观看数不是零,相对时间也不是精确发布时间。duration 和 duration_accessibility 表示时长,不是视频年龄;本例的 11 小时不代表“抓取前 11 小时发布”。is_live 标志不提供私密访问权,也不等于可以下载播放地址。
Channel Videos 的 continuation_token 用于后续另选的一页。保留其路由、频道与语言地区,不要用 Channel Description 高级信息 token 或其他频道的 token 替代。本轮没有执行续页往返,空页也不能单独证明整个频道没有视频。应先判断响应能说明什么,再设计下一次请求。
原 9 月 28 日实验保留在哪里
旧教程通过 youtube/web/search-video 搜索 machine learning tutorial,然后把返回频道 ID 交给 youtube/web/channel-info。搜索 run a8b82dc1-190d-4560-9fa2-3c98878bfad4 标为 2026-09-28 UTC,记录了 videos 列表、continuation_token 和 number_of_videos;当时观察的视频字段包括 video_id、title、author、channel_id、number_of_views、published_time、video_length。
频道信息 run eca232e4-ce65-45eb-ab7f-6da2c99c16bc 记录了 title、subscriber_count、video_count、view_count、verified、creation_date 和 country。原文只有这些 run ID 与字段描述,没有 JSON 响应代码块。本次保留这个证据局限,不补造历史载荷,也不把当前 web-v2 样本归到旧 web 端点名下。
旧 helper 优先使用 undocumented output 兜底,并把缺失数据默认成空对象;research 函数还可能从一次搜索自动遍历多个频道。所有原代码逐字保存在历史 Python 归档。它们是前一版文章的记录,不是现行推荐方案;当前接入请用上方已选任务的单次 helper。
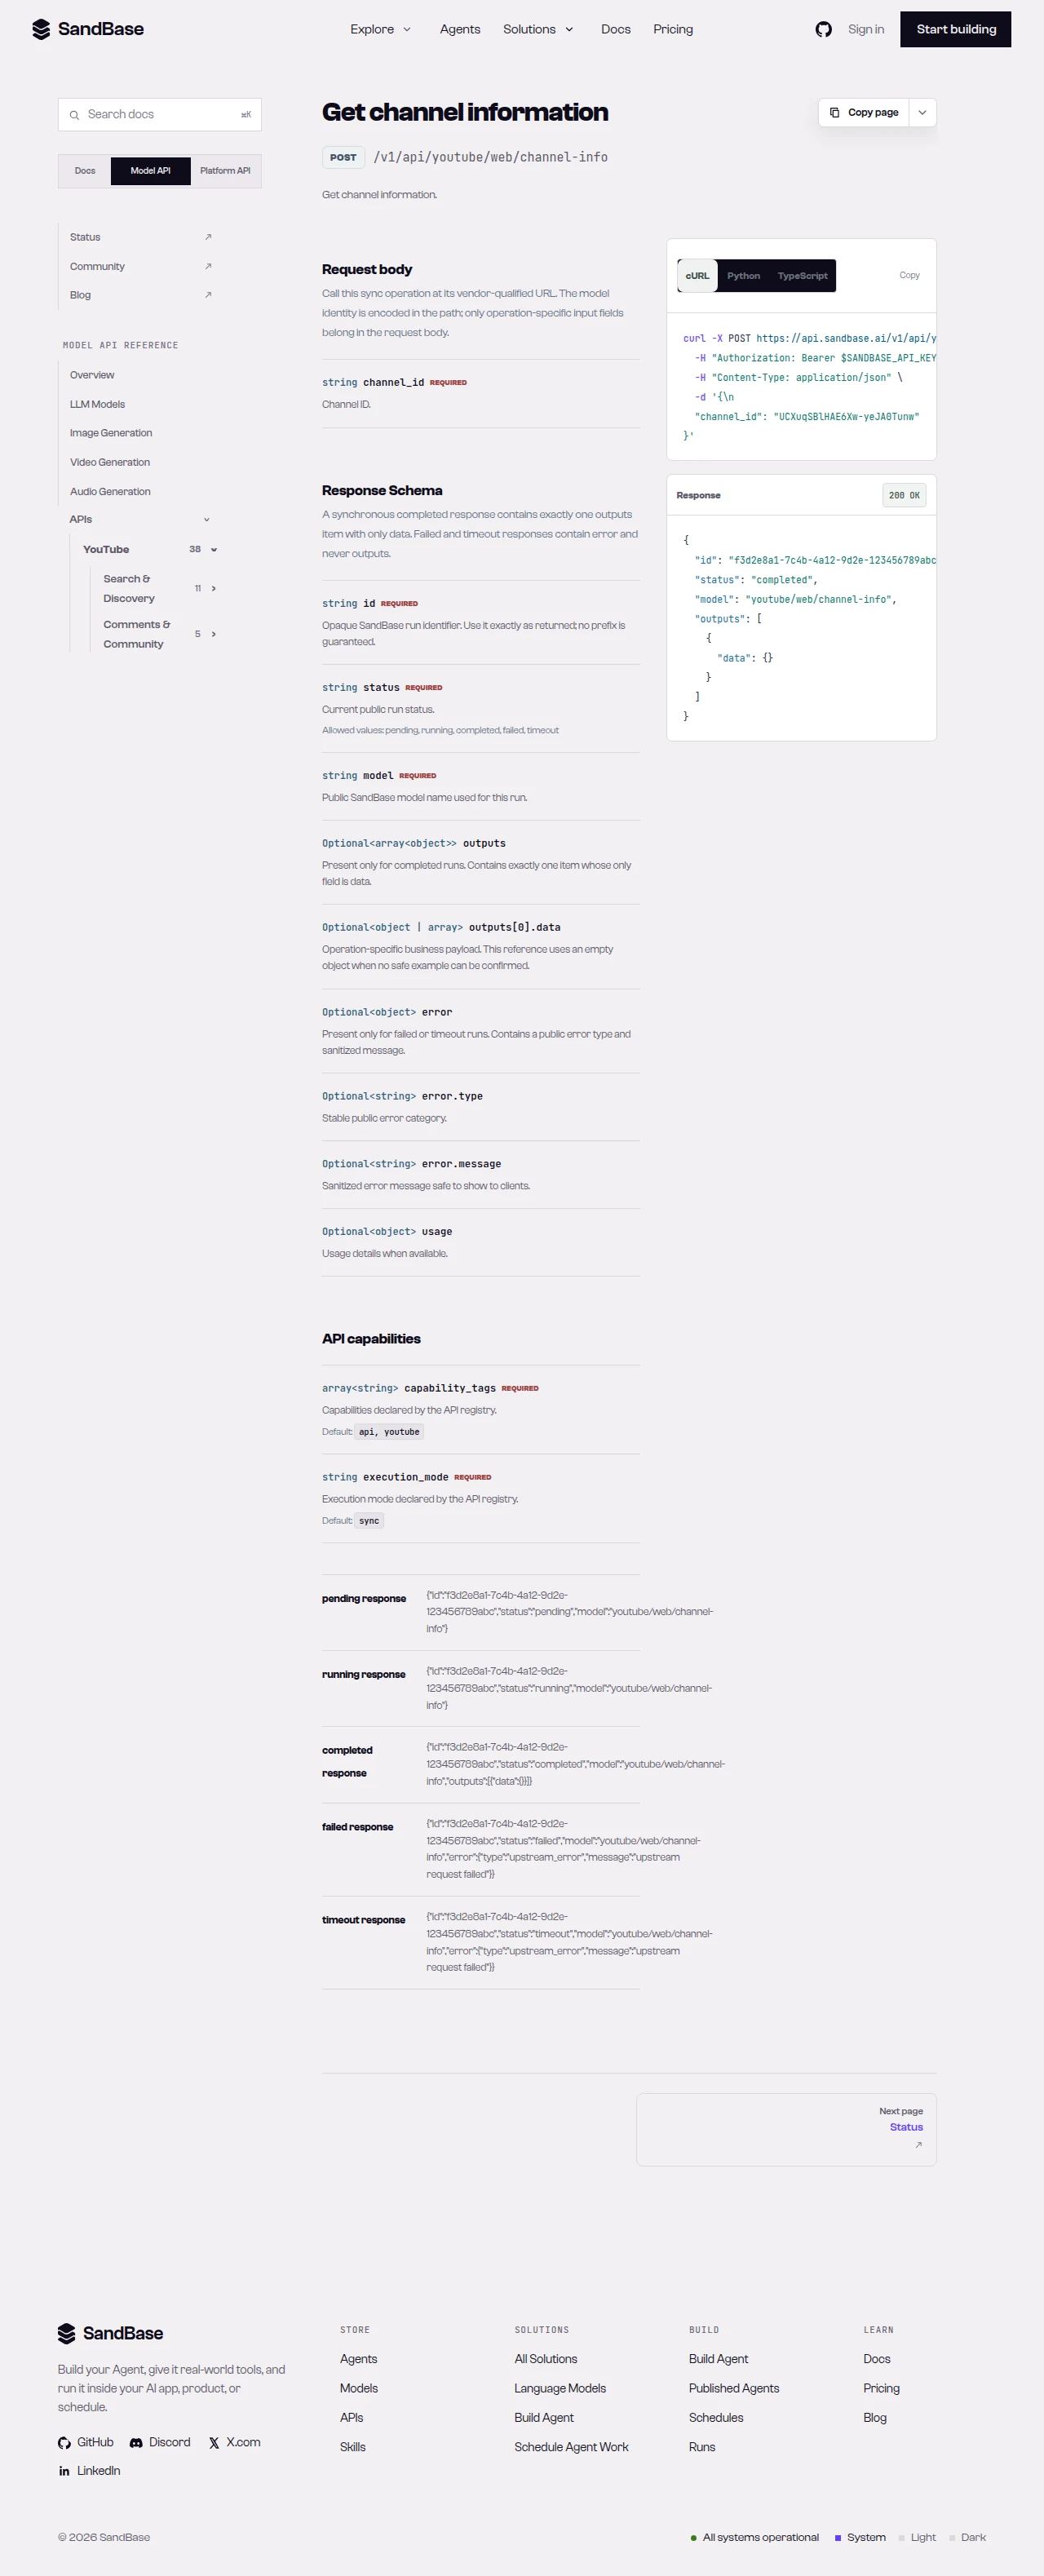 原实验的历史 web/channel-info 参考。这与当前 web-v2/channel-description 是不同路由,截图不能证明本轮新查了一次频道资料。
费用与研究判断
2026-11-08 免费 inspect 显示两个选中端点均为 0.001 美元/次,具备组织共享的每日 100 次合资格数据 API 额度,UTC 00:00 重置。资格不表示剩余额度、账户余额或实际扣费,也不保证免费成功。单个任务抵扣前为 0.001 美元,独立选择两项为 0.002 美元。
保存一次有效响应后,先问更多数据能否解决明确问题。资料可以支持基础创作者筛选,但未知值必须可见;一页视频能显示返回的标题类型,却不能证明穷尽全部话题。竞品增长需要时间一致、可比较的多次观察,当前首请求不会凭空生成历史。也不要无提示地扩展为每条视频的详情、评论、字幕和模型摘要链路。
常见问题
能传 handle 代替 channel_id 吗? 本 helper 要求选定的 UC 频道 ID。名称或 URL 使用适当现行端点单独解析,不猜第一个同名账号。
资料字段可选,为何不能直接发空对象? 同一路由描述首次 ID 请求与后续 token 高级信息请求。本例只实现第一阶段,因此需要明确频道。
高级信息能补齐 null 指标吗? 没有这样的保证。当前参考的三个字段为 null,本轮没有执行高级信息请求。
能要求最新十个上传吗? 选中的 schema 没有 limit、数字 page 或 sort。先看一页实际返回及其顺序,示例不承诺“最新十条”。
商业邮箱标志会给我联系方式吗? 不会。标志不是地址,也不是联系许可。
总结
已有频道 ID 后,选一次资料读取或上传页。核对返回身份,保留原始值,在追加频道或续页前停止判断。YouTube 导航可帮助选择另一个明确范围的任务。
觉得有用?分享给更多人