YouTube 公开数据 API:搜索与频道 | SandBase
用一个 REST API 搜索 YouTube 并读取公开的视频、频道、评论和字幕——一把 SandBase key,为 agent 而建。
YouTube 的公开视频、频道和字幕引用可用于媒体监测和内容调研。官方的 YouTube Data API 能做很多事,但那意味着一个带凭据的 Google Cloud 项目和一份要精打细算的每日配额;公开的 list 读取用 API key 即可,而私有和账号授权的操作需要 OAuth,字幕下载还另有一套流程。
SandBase 的 YouTube 公开数据 API 给你一条更简单的读取路径。它通过普通 REST 端点搜索 YouTube 并读取公开的视频、频道、评论和字幕——一把 SandBase API key,你这边不用建 Google Cloud 项目。下面的字段名和 JSON 结构都是用来说明大致形态的示例;具体参数和响应字段请以每个端点的在线 API 参考和一份真实响应为准。
这不是 Google 官方的 YouTube Data API。 如果你需要对自己账号做已认证操作、上传,或受 Google 管辖的配额,请用官方 YouTube Data API;当你的流程需要的是公开、只读的搜索和内容数据(调研、监测或补全)时,用 SandBase。想直接试?领取 SandBase API key,再浏览 YouTube 端点。
先说结论
- 一个 API 搜索 YouTube 并读取公开的视频、频道、评论、字幕和搜索建议。
- 本文的 Model API 端点用
POST /v1/api/youtube/<path>调用——只传该端点的参数,不用 Google Cloud 项目,一把SANDBASE_API_KEY。- 端点以自然标识为入参:
search_query、video_id、channel_id、channel_name或keyword。- 它只返回公开、只读数据。不能上传、没有账号操作、你这边也没有 Google OAuth;鉴权用 SandBase API key。
这次 2026-11-08 修订只核对两个已知视频的读取任务:Video Info 和 Video Comments,都使用 11 位 video_id。证据来自免费 inspect 与公开保存样本,没有新的业务调用。其余条目是历史目录导航,不代表所有端点刚刚复测。先选视频信息或一页评论,Python 首请求教程 提供错误处理与结构检查。
沿用封面为概念插画。名称、数字、徽章和多步流程不是新响应测量、身份认证或全部目录能力当前可用的承诺。
你到底需要哪个 YouTube API?
| 你的需求 | 选择 | 原因 |
|---|---|---|
| 上传、管理自己的频道,或对已认证账号操作 | 官方 YouTube Data API | OAuth 保护的账号操作(公开 list 读取用 API key);Google 管辖的配额。 |
| 搜索并读取公开的视频、频道、评论或字幕 | SandBase YouTube 公开数据 API | 普通 REST、一把 SandBase key、面向只读流程的结构化 JSON。 |
| 私密或仅账号可见的数据和分析 | 都不适用于公开流程 | 频道主分析和私密数据不在本篇公开数据的范围内。 |
从 YouTube API 能拿到什么
整个目录横跨一个 web 面和一个更新的 web-v2 面。按用途归类:
- 搜索 —— 综合搜索、视频搜索、Shorts 搜索,以及搜索建议。
- 视频 —— 视频信息、相关视频、视频流,以及带回复的评论。
- 频道 —— 从名称或 URL 解析出 channel id,再读取频道信息、视频、Shorts 和社区帖子。
- 字幕与转录 —— 单个视频的字幕和 subtitle。
原目录检查记录过个别调用的上游错误;这项历史观察不能证明端点当前被禁用,仍需分别核对所选端点的现行契约与可用性。
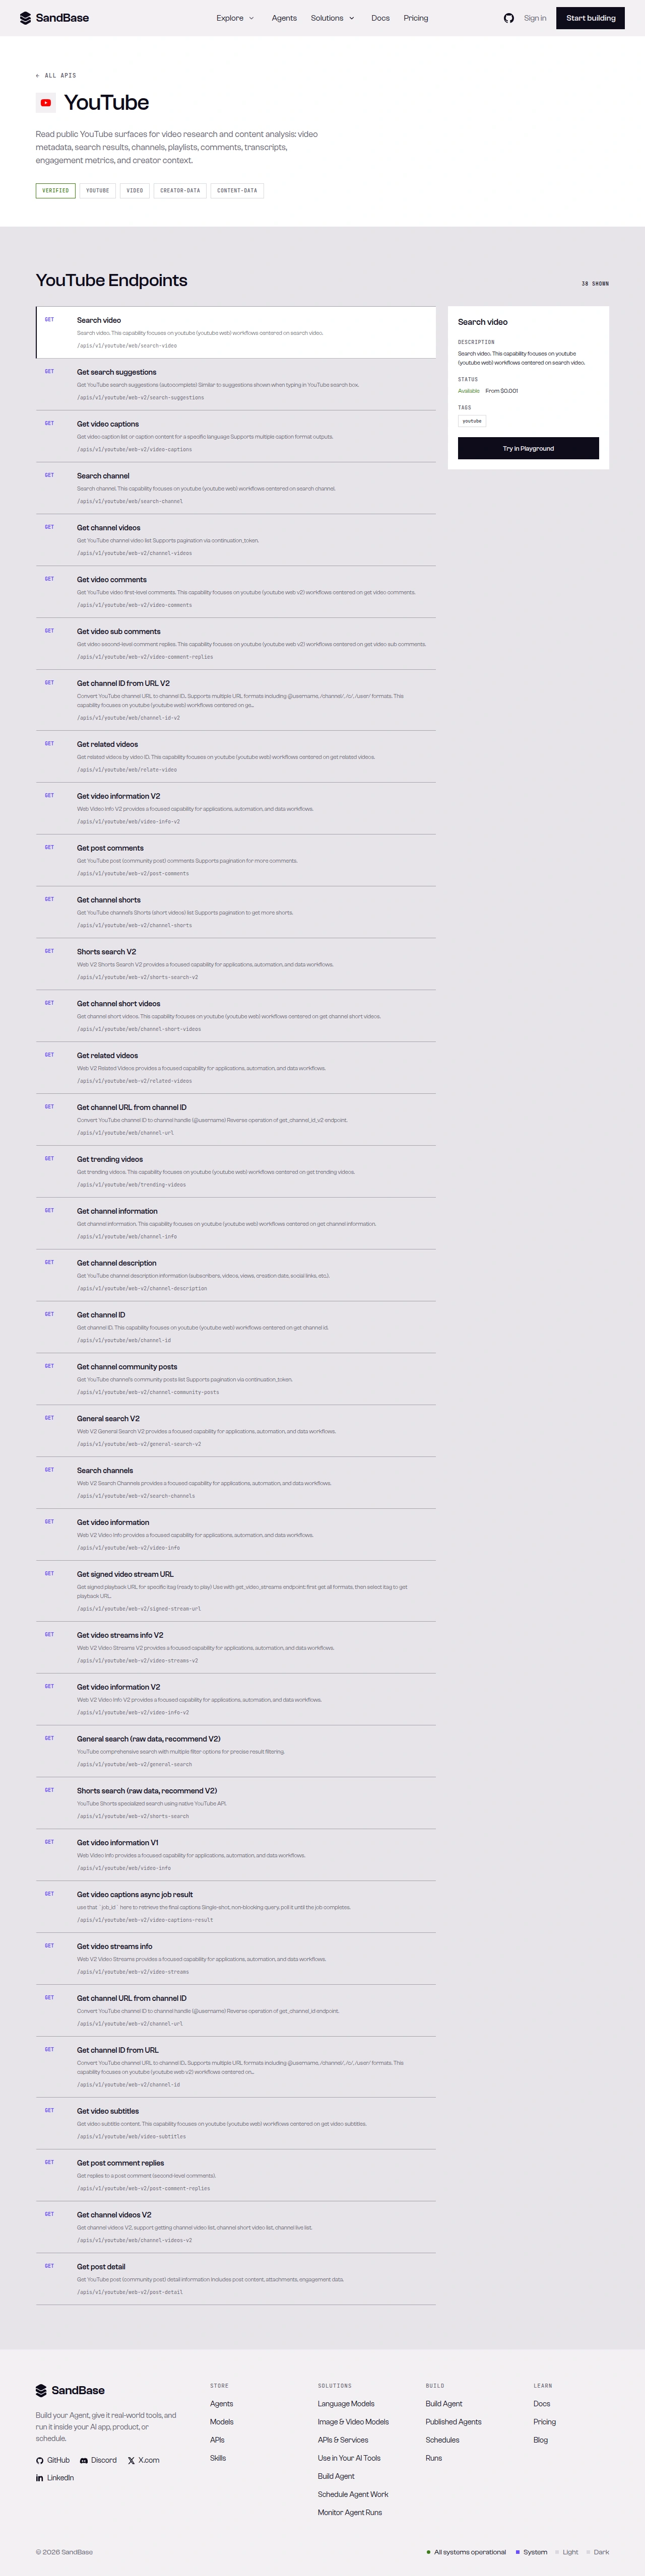 历史 YouTube 目录显示 38 项及 From $0.001 标识。数量、可用性和目录 GET 路径不是新的执行证据;当前选中 POST 端点的价格另行核对。
YouTube 提供的 vs. SandBase 补上的
公开数据来自 YouTube,SandBase 提供共同的鉴权和请求入口。每个端点仍有独立参数、业务结构、可用性和预算,不能因为信封相同就只检查一次 status,更不能自动串起搜索、频道和字幕全流程。视频信息中的字幕引用也不是已经下载的正文。
快速上手:只选一个已知视频任务
已经有 SandBase key,就复用本地环境中的配置;已连接 agent 只需视频 ID 与预期输出。新项目可以从 setup Skill、Markdown quickstart 和快速入门 开始。key 不要发到聊天里。研究一个已知视频,不必先解析频道、再抓取它的所有链接。
下面 curl 只读取一页顶层评论,使用 POST /v1/api/、明确的英文/美国显示偏好、简化格式和 top 排序。省略 continuation_token,不跟随重定向,也不自动重试。当前 schema 没有 page_size 或数字 offset;请传入已经选定的视频 ID,而不是完整 watch URL。
curl --fail --max-time 100 --retry 0 -X POST \
  https://api.sandbase.ai/v1/api/youtube/web-v2/video-comments \
  -H "Authorization: Bearer ${SANDBASE_API_KEY:?Set SANDBASE_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{"video_id":"dQw4w9WgXcQ","language_code":"en","country_code":"US","need_format":true,"sort_by":"top"}'
如果需要的是视频信息,单独选择 Video Info,只传 video_id、language_code en 和 need_format true;不要照搬评论特有的排序或地区字段。上方链接的 Python 教程实现两种选择,每次只执行一个请求。
消费结果前,必须确认 completed 和 outputs[0].data 对象。视频信息是扁平记录,应检查返回 video_id 与所选视频一致、title 类型符合参考;评论则是带 comments 对象数组的扁平对象。有效空数组和缺失结构不同,不应读取 undocumented output 兜底,更不能把缺失载荷默认成空对象。curl 只显示响应,实际解析检查见 Python 教程。
公开保存样本的日期是 2026 年 10 月 7 日:信息为 0db08ecb-a998-4c0c-bdb4-1a0057e0cb39,评论为 47d6201e-7702-4398-a94a-4f7b9b722ddf;两者保存的输入都只有 dQw4w9WgXcQ 的 video_id。它们不是用本例显式英文参数新执行的结果。评论样本包含 20 条,但这不是固定页容量,更不代表完整受众。显示计数可能本地化或缩写,null 与空字符串保留为未知,相对日期原样保存,不把缺失的简短计数补成零。
下面原频道解析 JSON 保留为历史示意信封,不是已核验的视频/评论结果,也不证明新调用。旧 Python 逐字保存于历史代码归档,不再作为当前首请求接入方案。
{
"id": "3cdfb9e9-51d0-4129-82cf-055edbdc1199",
"status": "completed",
"model": "youtube/web/channel-id",
"outputs": [
{
"data": {
"…": "示例响应结构——请以一份真实响应为准核对其中嵌套字段"
}
}
]
}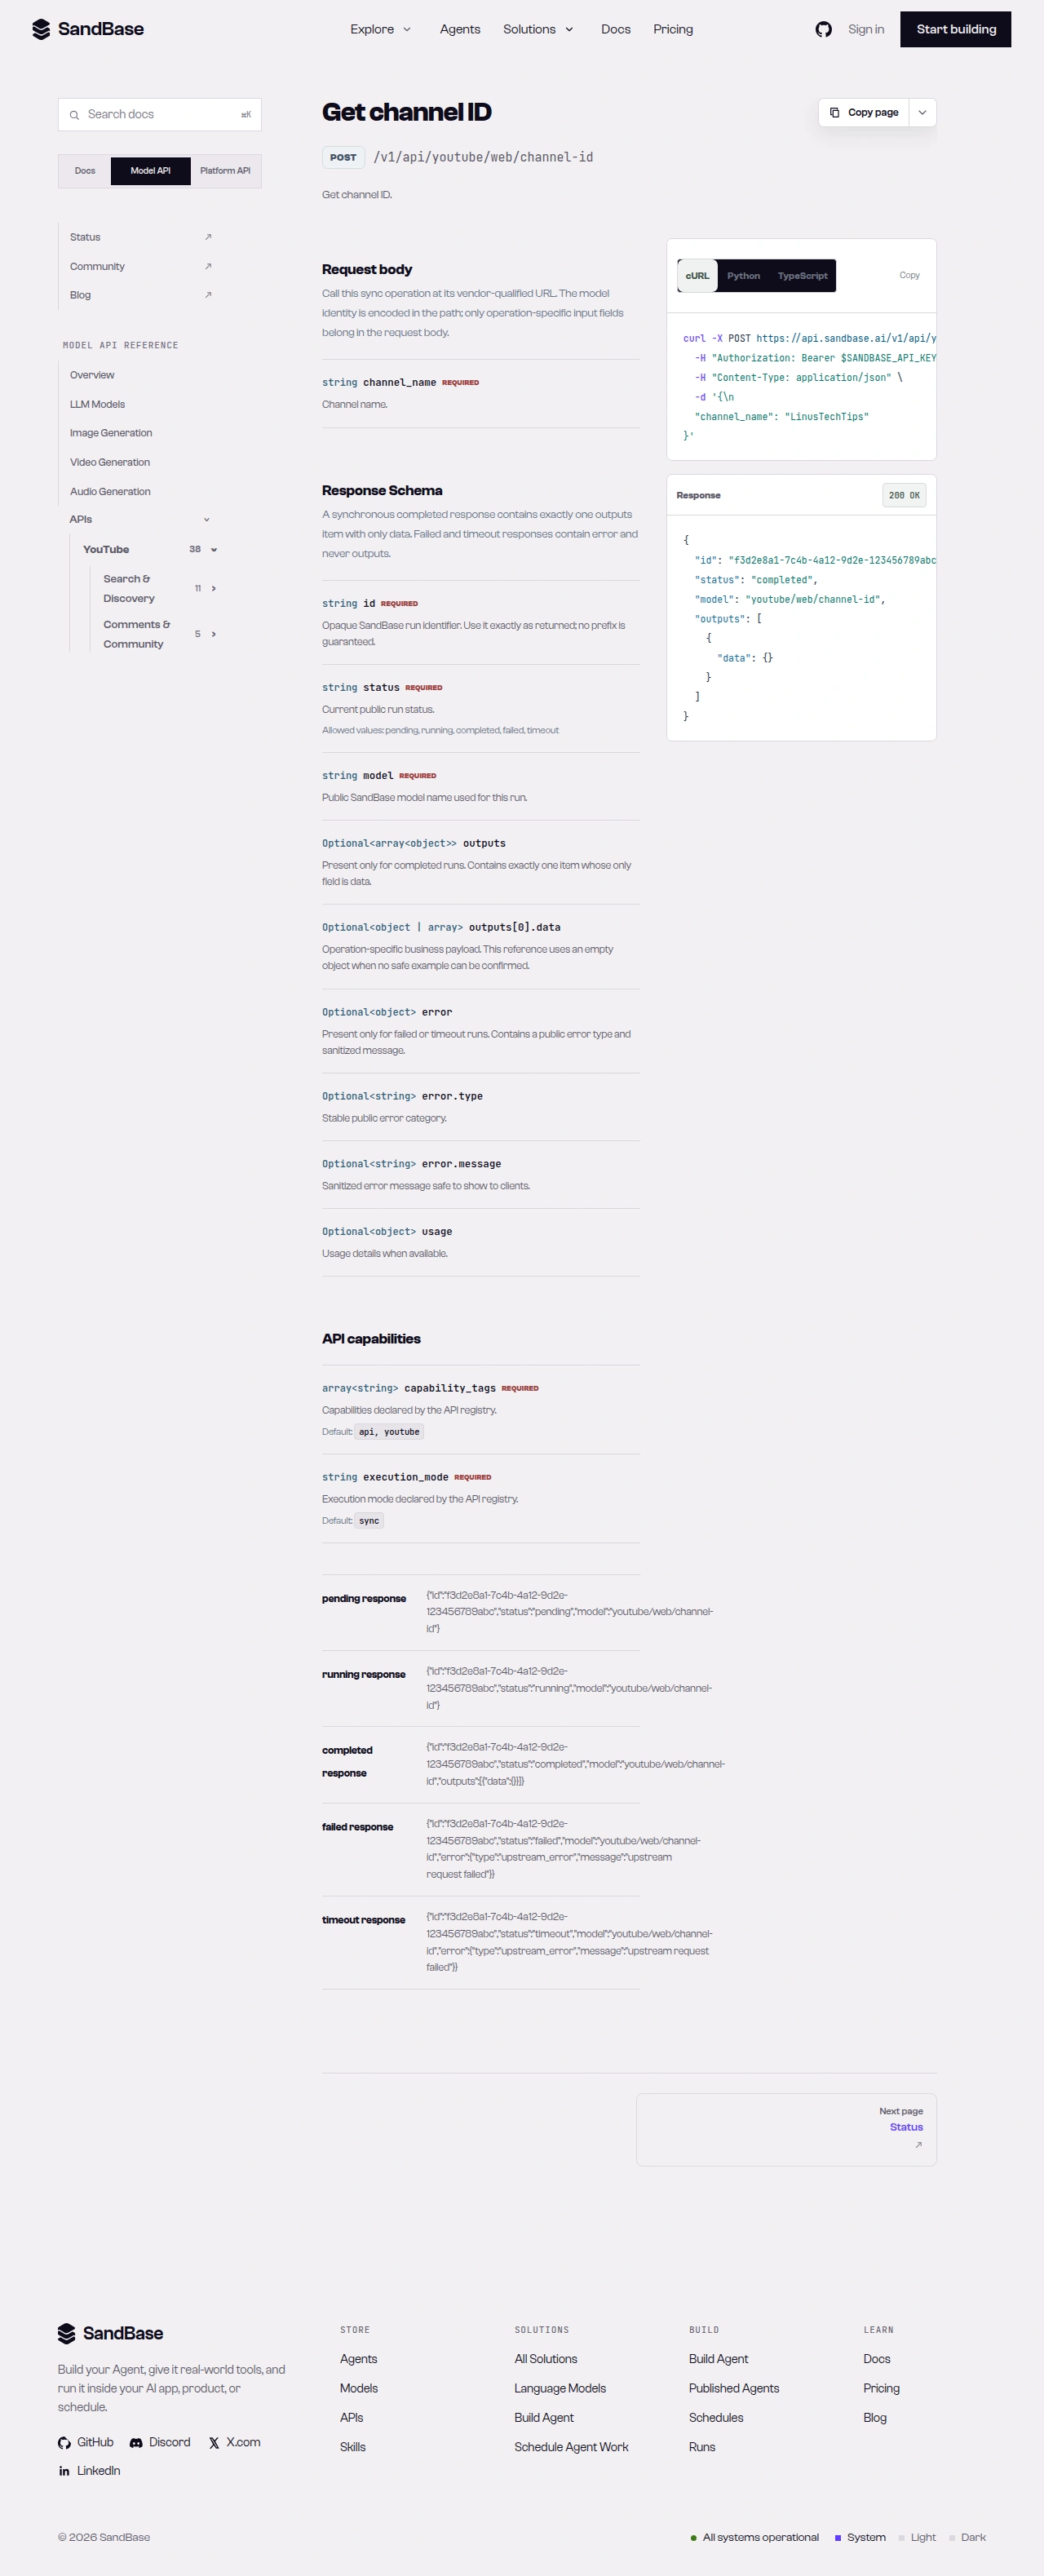 历史频道解析参数参考截图,没有展示当前选中的视频/评论请求或本轮新响应。
能力地图
下表沿用原文 9 月/10 月的目录导航。本轮只重新核对 video-info 与 video-comments 输入,其他端点需独立检查当前参数、业务结构和预算。
| 能力簇 | 代表端点 | 典型用途 |
|---|---|---|
| 搜索 | youtube/web-v2/general-search | 宽泛的话题与关键词发现 |
| 搜索建议 | youtube/web-v2/search-suggestions | 关键词扩展与联想调研 |
| 频道解析 | youtube/web/channel-id | 名称/URL → channel id |
| 频道内容 | youtube/web-v2/channel-videos | 列出一个频道的视频 |
| 视频信息 | youtube/web-v2/video-info | 元数据、作者、分类、字幕可用性 |
| 评论 | youtube/web-v2/video-comments | 互动与情感分析 |
| 字幕 | youtube/web-v2/video-captions | 转录流水线 |
分页方式因端点而异——若干端点接受一个可选的 continuation_token 请求参数。查每个端点的参考,确认它是否分页以及怎么分页。
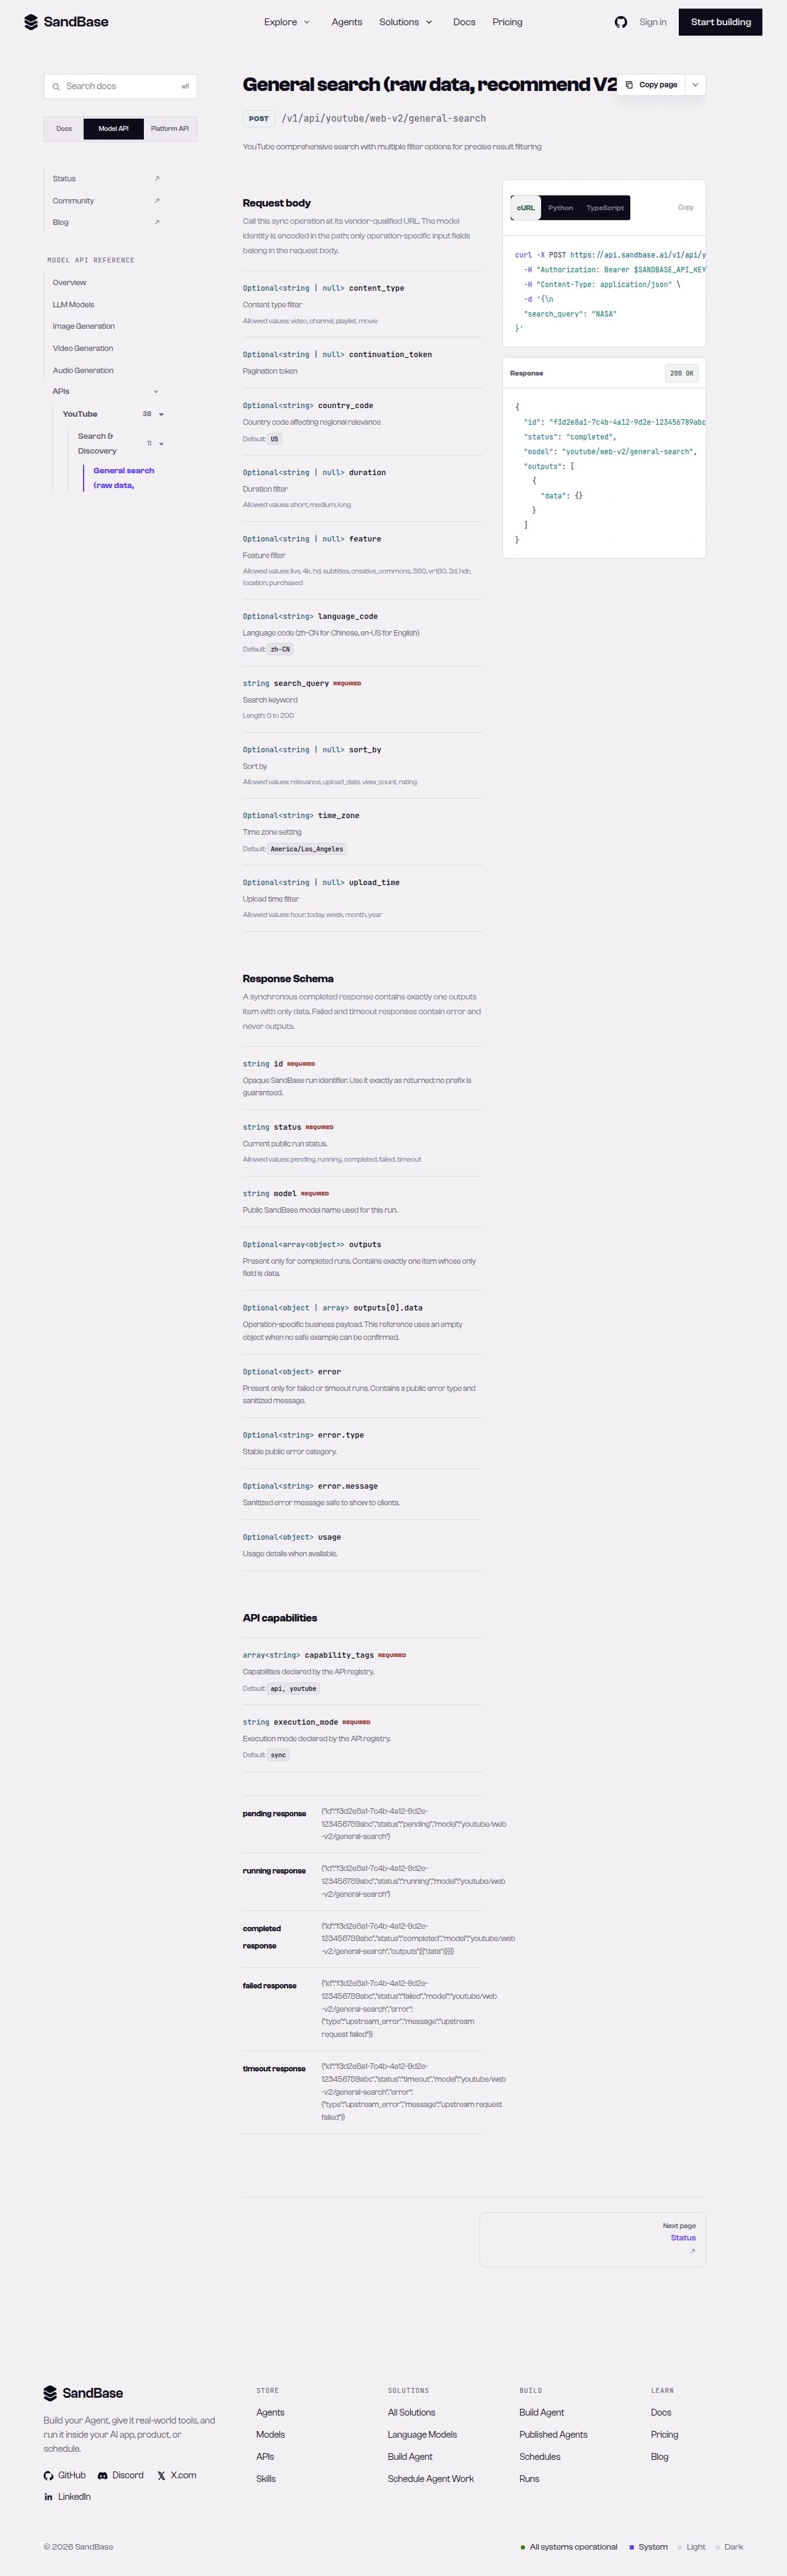 历史 general-search 参数参考,并非端点列表截图。这个独立端点的筛选和续页参数没有在本轮重新验证。
在追加调用前停下来
顶层 continuation_token 属于视频评论列表;单条评论的 reply_continuation_token 属于该线程,需要作为 continuation_token 传给独立的 Video Comment Replies。保留视频和父评论身份,不混用 token,也不从 ID 构造 token。将来的续页要保留排序和语言地区,并用真实响应验证;本轮没有执行任何续页往返。
top 是提供方排序,不是文档保证的点赞降序;newest 是另一种样本,不是保证完整的增量数据流。空评论数组不能证明讨论被关闭或删除。报告中记录排序、语言地区和采集条数,不把一页样本推广成全体观众。字幕 URL、缩略图和相关视频引用仍然只是数据,不会在本任务中被自动访问。
2026-11-08 两个选中端点均标价 0.001 美元/次,具备组织内共享的每日 100 次合资格数据 API 额度,UTC 00:00 重置。资格不是剩余额度或实际扣费检查。一个请求在额度抵扣前为 0.001 美元,独立选两项为 0.002 美元。更多页、楼中楼、字幕抓取和模型分析需要另外明确任务与预算,并未包含在此示例内。
拿到首个响应后去哪里
研究已知视频的讨论,查看评论教程:它已把当前首请求与 10 月 1 日多调用实验分开。视频信息帮助确认上下文,评论样本帮助发现值得追问的主题,但单靠其中任意一项,都不能描述全体受众的想法。
历史目录还包含 general-search/search-suggestions 话题发现,以及频道解析/频道视频等创作者研究。这些是另外的读者任务,串联前应分别验证参数与返回字段。频道研究教程 是相应导航入口,不意味着应默默加入当前评论请求。
字幕工作参见转录流程教程。视频信息里的轨道只是引用,轨道发现、语言选择与文本读取需要自己的检查。本轮没有重新测试字幕,也不声称一次 metadata 调用就包含完整转录文本。
边界与限制
- 只读、公开数据。 不能上传、不能做账号操作,也拿不到频道主分析。
- 速率与量级。 本次首请求遇到包括 429 在内的 HTTP 错误就停止;之后是否重试及其预算需要另行决定。
- 参数与结构随上游而定。 标识各异(
search_query、video_id、channel_id、channel_name、keyword);部分端点接受一个可选的continuation_token用于分页。先看真实响应、读 schema。 - 历史失败的证据有限。 过去的上游错误不能确定当前可用性,应核对具体端点。
- 这不是 Google 官方合作。 SandBase 只是提供对公开数据的统一访问;请遵守 YouTube 的条款以及你使用场景下适用的规则。
常见问题
我需要 Google Cloud 项目或 YouTube OAuth 吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权。这些读取端点不需要你建 Google Cloud 项目或管理 OAuth 配额。
用什么来标识视频或频道? 当前首任务使用 11 位 video_id。其他目录端点有各自的频道或搜索标识;已有视频 ID 不需要先执行频道解析。
分页怎么做? 选中评论端点的顶层 continuation_token 用于列表,单条评论的 reply_continuation_token 用于另一个回复请求。本轮没有验证续页往返,其他端点也需要各自核对参考。
能读私密视频或频道分析吗? 不能。这个 API 只返回公开数据。私密视频、仅不公开可见的数据和频道主分析都不在范围内。
能更高量级地采集字幕或评论吗? 查线上 YouTube API 列表看当前有哪些端点、各自支持什么参数,接入前先对照每个端点的参考确认可用性。
从一个已知视频开始
复用已有 key,选择 Video Info 或 Video Comments。保存一次有效响应,判断是否回答了问题,再决定是否追加页面或端点。Python 教程 提供明确错误处理;YouTube 目录 是导航,不是要求执行全部能力。
觉得有用?分享给更多人