YouTube 评论分析 API 教程:从一条视频读懂观众反应 | SandBase
分析 YouTube 视频的观众反应:用三个 SandBase 端点读取视频详情、翻页拉取一级评论、抽样回复楼层。无需 YouTube 登录,也不用建 Google Cloud 项目,只需一个 SandBase API Key。
新品宣传片一上线,评论区一天之内就变成了免费的焦点小组:有人夸配乐,有人说芯片才是硬伤,还有人换着三种说法问同一个问题。不管你是要写发布复盘、做达人报告,还是拆解竞品,想把这些反应总结出来,就得把评论当成数据来读,而不是一条条往下刷。
这篇教程用三个 SandBase 端点完成这件事:先读视频详情,再翻页拉取一级评论,最后展开回复最多的几个楼层,整理好交给模型去归纳。整体端点地图在 YouTube 公开数据 API 总览里,没看过的话建议先读那篇。
这里读的都是公开、只读数据:不需要 YouTube 账号,不需要 Google Cloud 项目,也不需要 SDK,只要一个 SandBase API Key 做鉴权。这三个端点目前在 SandBase 目录里标的是 Free。
参数和响应信封以端点 API 参考为准,而参考只保证信封结构。下文的业务字段名都来自我自己跑的调用(测试于 2026-10-01,UTC),属于实测观察,不是文档保证。正式依赖之前,请拿真实响应再核对一遍。
先说结论
- 起点是视频 id。
youtube/web-v2/video-info返回标题、频道、播放量、点赞数,以及一个评论数,可以先估算工作量。youtube/web-v2/video-comments每页大约返回 20 条一级评论,把响应里的continuation_token原样传回去就是下一页。- 有回复的一级评论会自带
reply_continuation_token,传给youtube/web-v2/video-comment-replies就能读这个楼层。- 一定要把
language_code设成en。默认值是zh-CN,会把响应里的数字和日期本地化。
为什么看评论,为什么不用官方 API
官方 YouTube Data API 有 commentThreads 和 comments 资源。如果你本来就有 Google Cloud 项目、配额也够用,直接用官方的没问题。麻烦在于前期准备:建项目、配凭据、按天盘算配额。要是只想复盘一次发布,或者让 Agent 按需读几条视频,这些准备工作反而占了大头。
SandBase 这条路范围更窄:只读公开评论和回复,返回清洗过的 JSON,一个 Key 搞定。它不能发评论、不能审核,也碰不到任何需要账号授权的东西。另外两篇教程分工不同:频道研究教程讲怎么找频道、看体量;字幕管线教程讲视频本身说了什么;这一篇讲观众怎么回应。
| 你的需求 | 用什么 |
|---|---|
| 做研究、复盘、总结用的公开评论和回复 | SandBase YouTube 公开数据 API |
| 管理、回复、审核自己频道的评论 | 官方 YouTube Data API + OAuth |
| 私密、仅账号可见的数据 | 两条路都不适用 |
流程一览
- 拿到视频 id:从链接里解析(
watch?v=<id>、youtu.be/<id>或/shorts/<id>)。如果手上只有话题关键词,可以用youtube/web/search-video搜出 id,频道研究教程里有完整示例。 - 读视频详情:
youtube/web-v2/video-info(参数video_id),拿标题、频道、播放、点赞和评论数。 - 翻页拉一级评论:
youtube/web-v2/video-comments(首页传video_id、sort_by,之后传continuation_token)。 - 展开最热闹的楼层:
youtube/web-v2/video-comment-replies(参数是该评论的reply_continuation_token)。 - 交给模型归纳:主题、情绪倾向、反复出现的问题。
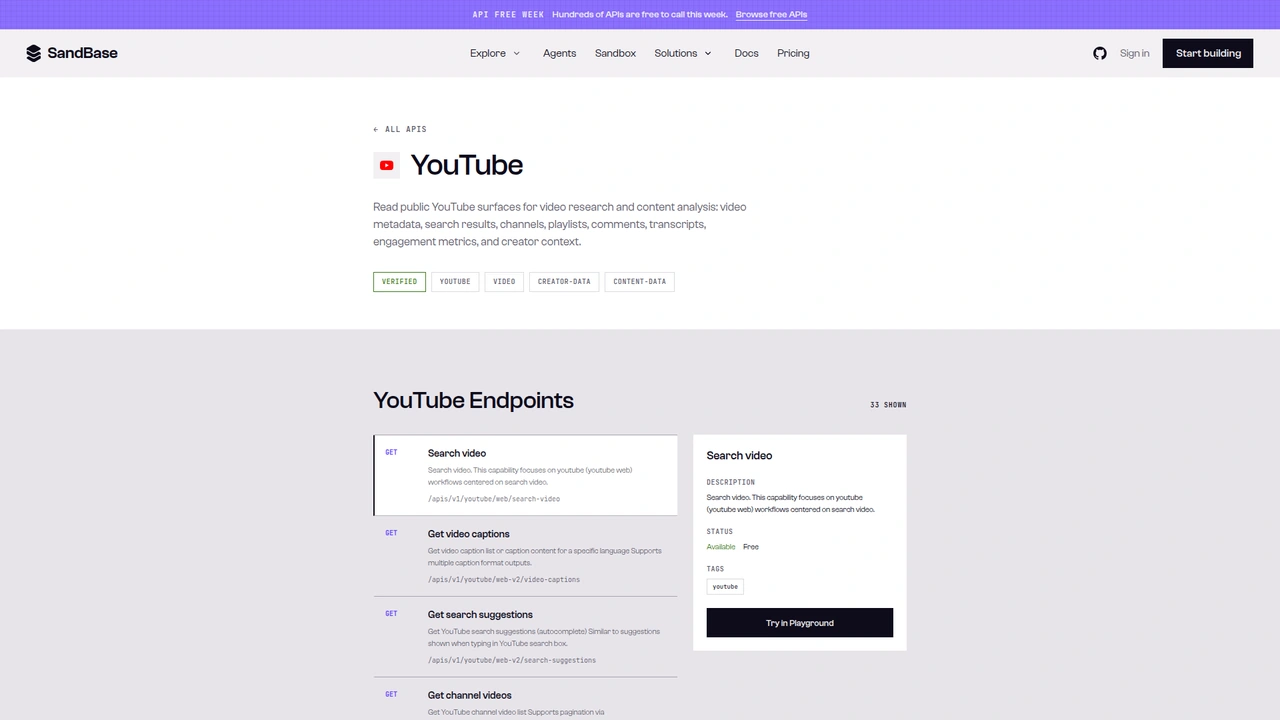 SandBase 上的 YouTube 目录页:33 个端点以
GET /apis/v1/youtube/... 形式列出,选中的 Search video 端点状态为 Available、Free。本教程调用的是 Model API 的 POST /v1/api/youtube/... 路由。
写代码前先把接口面说清楚。目录页展示的是 GET /apis/v1/youtube/<path>;本文用的是端点参考里的 Model API,也就是 POST /v1/api/youtube/<path>,JSON 请求体里只放该端点自己的参数。复制示例时请保留 POST 方法和 /v1/api/ 前缀,别和目录页的 GET 路径混用。
第 0 步:一个通用调用函数
import os
import re
import time
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call(path: str, payload: dict, retries: int = 2) -> dict:
    for attempt in range(retries + 1):
        resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=90)
        if resp.status_code >= 500 and attempt < retries:
            time.sleep(2 * (attempt + 1))  # 上游偶发错误,稍等重试
            continue
        resp.raise_for_status()
        body = resp.json()
        if body.get("status") != "completed":
            raise RuntimeError(body.get("error", {}).get("message", f"{path} did not complete"))
        # 参考文档写的是 outputs[0].data;部分调用会返回顶层 output,两种都读。
        output = body.get("output")
        if output is None and body.get("outputs"):
            output = body["outputs"][0].get("data", {})
        return output or {}
    return {}

def video_id_from_url(url: str) -> str:
    m = re.search(r"(?:v=|youtu\.be/|/shorts/|/embed/)([A-Za-z0-9_-]{11})", url)
    if not m:
        raise ValueError(f"no video id in {url}")
    return m.group(1)

def to_int(text) -> int:
    """'474' -> 474, '7.5K' -> 7500, '1.2M' -> 1200000, None/'' -> 0."""
    if text is None:
        return 0
    s = str(text).replace(",", "").strip().upper()
    mult = 1
    if s.endswith("K"):
        mult, s = 1_000, s[:-1]
    elif s.endswith("M"):
        mult, s = 1_000_000, s[:-1]
    try:
        return int(float(s) * mult)
    except ValueError:
        return 0
参考文档里,完成态响应的数据在 outputs[0].data。这次测试的所有 YouTube 调用也都是这个结构。不过我在 SandBase 其他平台端点上见过顶层 output,所以函数两种都读,有 output 时优先用它。加重试是因为我最早的一次评论调用直接回了 HTTP 503,同样的请求过一会儿再发就成功了。
to_int 存在的原因是:这些响应里几乎所有计数都是字符串。视频的 view_count 是纯数字字符串,评论的 like_count 却是缩写("7.5K"、"11K"),在默认语言下还会被本地化。第 2 步会细说。
第 1 步:读视频详情
def read_video(video_id: str) -> dict:
    v = call("youtube/web-v2/video-info", {"video_id": video_id, "language_code": "en"})
    return {
        "video_id": video_id,
        "title": v.get("title"),
        "channel": v.get("author"),
        "channel_id": v.get("channel_id"),
        "published": v.get("publish_date"),
        "views": to_int(v.get("view_count")),
        "likes": to_int(v.get("like_count")),
        "comment_count": v.get("comment_count"),  # 形如 "600" 的字符串,也可能是 None
    }
测试用的是 Made by Google 频道的一条公开产品宣传片《Google Pixel 11 Pro | Meet 11》(GNuXueQ1BYc)。run 7cdb6ca7-c07e-40c6-bc60-737cfb399591 返回的 outputs[0].data 节选如下(之后重跑一次 a8bbc61e-d8d3-4d45-9167-dbce8db97779,结果一致):
{
  "title": "Google Pixel 11 Pro | Meet 11",
  "author": "Made by Google",
  "channel_id": "UCIG1k8umaCIIrujZPzZPIMA",
  "channel_handle": "@madebygoogle",
  "publish_date": "2026-08-10T09:18:13-07:00",
  "view_count": "394650",
  "like_count": "7009",
  "comment_count": "600",
  "category": "Science & Technology",
  "is_unlisted": false,
  "playability_status": "OK"
}
完整响应比这大得多,还带了 captions、chapters、thumbnails、available_countries 和 description。做评论分析时最有用的是 comment_count:看一眼就知道翻 3 页是能覆盖讨论,还是连开头都不够。
这个字段也可能是 null。我在 OpenAI 的《Introducing GPT-4o》直播回放上试过(run 4659dbe8-0c6e-4cbb-a7af-8c4f44eb42b9),comment_count 返回 null;同一条视频调 video-comments,拿到的是空的 comments 列表和 null 的 token(run ca8e3dd0-cbd7-4210-a14a-2805603a3bec)。单凭 API 我没法确认是这条视频关了评论,还是上游这次什么都没返回。不管哪种,看到 null 就先确认一下,别直接塞进队列。
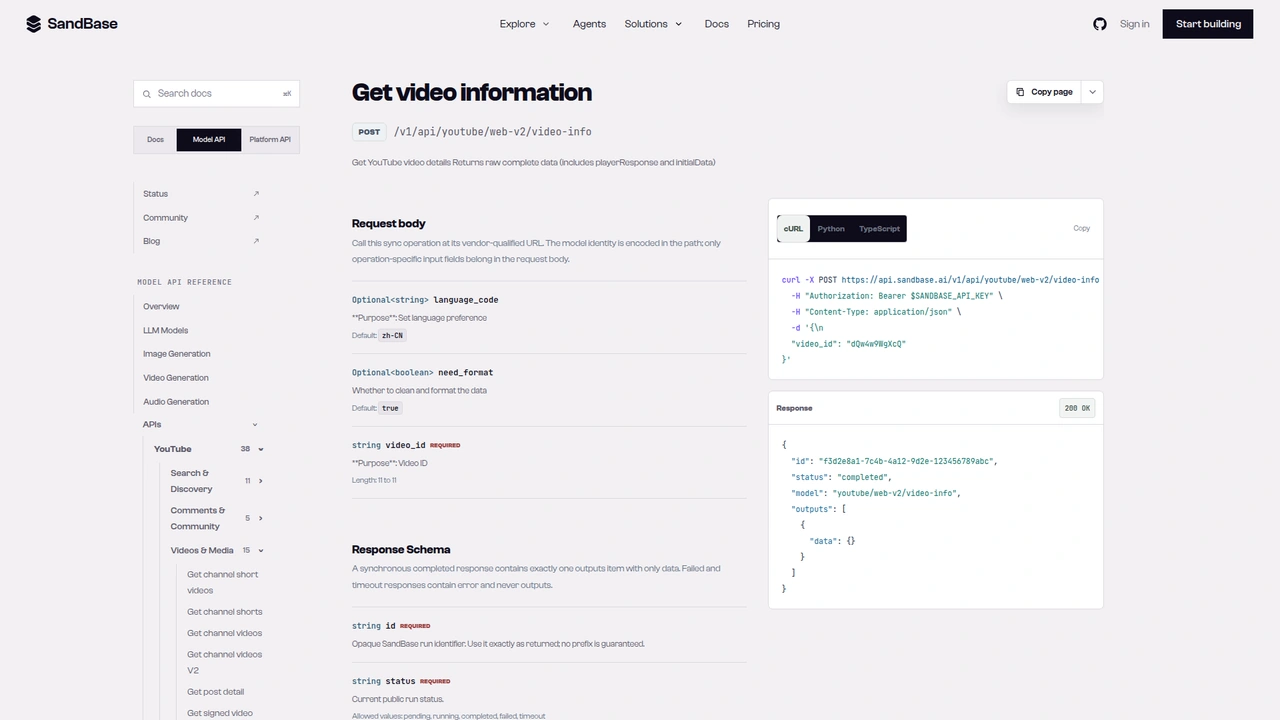
youtube/web-v2/video-info 参考页:POST /v1/api/youtube/web-v2/video-info,必填 11 位 video_id,可选 language_code(默认 zh-CN)和 need_format(默认 true)。文档里的响应示例 outputs[0].data 是空的。
第 2 步:翻页拉取一级评论
def top_level_comments(video_id: str, max_pages: int = 3, sort_by: str = "top") -> list[dict]:
    payload = {"video_id": video_id, "sort_by": sort_by, "language_code": "en"}
    out = []
    for _ in range(max_pages):
        page = call("youtube/web-v2/video-comments", payload)
        for c in page.get("comments") or []:
            out.append({
                "comment_id": c.get("comment_id"),
                "text": c.get("content", ""),
                "likes": to_int(c.get("like_count")),
                "replies": to_int(c.get("reply_count")),
                "reply_token": c.get("reply_continuation_token"),
                "when": c.get("published_time"),
            })
        token = page.get("continuation_token")
        if not token:
            break
        payload = {"video_id": video_id, "continuation_token": token, "language_code": "en"}
    return out
Pixel 这条视频的第一页(run 6a15e813-0975-424e-a08a-07975dc706d5)返回 20 条评论和一个非空的 continuation_token。下面是其中一条,已去掉 author 对象:
{
  "comment_id": "UgyqM6dj...",
  "content": "If only the tensor was half as good as this marketing.",
  "like_count": "157",
  "like_count_a11y": "157 likes",
  "published_time": "1 month ago",
  "reply_count": "2",
  "reply_count_text": "2 replies",
  "reply_continuation_token": "Eg0SC0dOdVh1ZVExQlljGAYy...",
  "reply_level": 0
}
每条评论原本还有一个 author 对象,里面是昵称、频道 id、头像和认证标记。我在函数里直接丢掉了。分析观众反应,要的是“说了什么、有多少人认同”,而不是“谁说的”;不存这些字段,也就不会把个人信息带进你的数据库。
翻页和参考描述的一致:把返回的 continuation_token 作为下一次请求的 continuation_token,返回为空就停。我在另一条高热度视频上验证过,第二页(run 21210ef3-0cdd-4ad9-9ad3-9e28a55155d1)又给了 20 条新评论,和第一页的 comment_id 没有重叠,同时带着下一页的 token。即便如此,后面的汇总函数还是做了去重,因为文档并没有保证各页之间绝不重叠。
这一步有三个地方出乎我的意料:
- 默认语言会改掉你的数字。
language_code默认是zh-CN。早期一次没设语言的调用(另一条老视频,runc12ba06d-d2ae-420f-bd99-d72b40069013)里,点赞数是"32万",时间是"1年前";设成en之后,同一条视频上的这类字段变成"7.5K"、"1 year ago"这样的格式。每次都显式传上。 top不等于按点赞排序。sort_by可选top或newest。top列表的第二页(run82cafd48-fc3a-480c-ae50-03864d83d026)里,4 天前一条 17 赞的评论和几年前几十万赞的评论排在一起。它跟的是 YouTube 自己的排序逻辑。想要“最多赞”,拿到数据后按likes本地排序。- 没有回复的评论不带回复 token。 只有
reply_count大于 0 的楼层才有reply_continuation_token。判断时检查 token 本身,别只看数字。
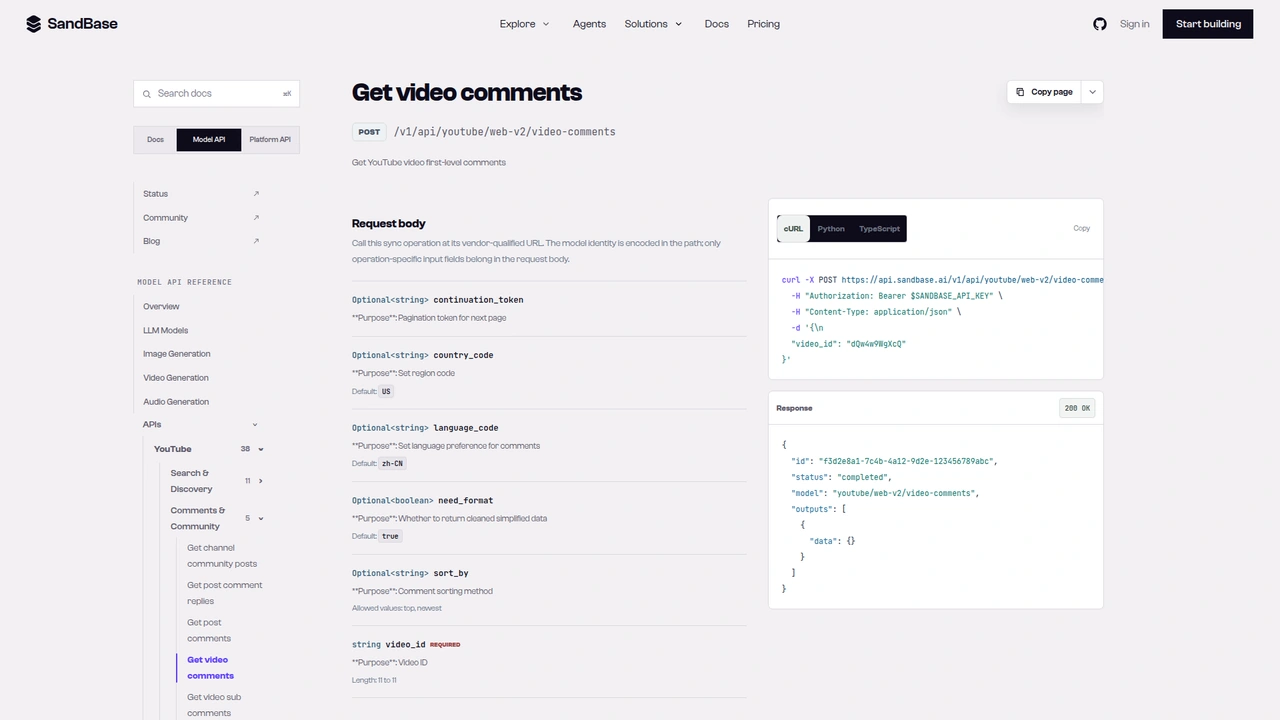
youtube/web-v2/video-comments 参考页:可选 continuation_token、country_code(默认 US)、language_code(默认 zh-CN)、need_format 和 sort_by(top 或 newest),必填 11 位 video_id。
第 3 步:展开回复最多的楼层
def first_replies(reply_token: str) -> list[dict]:
    page = call("youtube/web-v2/video-comment-replies",
                {"continuation_token": reply_token, "language_code": "en"})
    return [{"text": r.get("content", ""), "likes": to_int(r.get("like_count"))}
            for r in page.get("comments") or []]
回复接口只要一个 token,不用再传视频 id,token 本身已经指明了是哪个楼层。响应的键名和一级评论一样,也是 comments 加 continuation_token;每条回复的 reply_level 是 1,comment_id 是“父评论 id + 后缀”的形式。
真正影响设计的坑在这里。Pixel 视频上最热闹的楼层 reply_count 是 "36",但回复调用(run 249fe9fe-4f7a-4ef9-b50e-90da4a17ff11)只返回了 8 条,continuation_token 是 null。加上 country_code: "US" 再试一次(run d965b8af-9927-4708-8f13-4e8632841cb6),还是这 8 条、还是 null。也就是说,在清洗后的格式里,回复页的 token 为 null 并不代表楼层已经读完。
我又用 need_format: false 看了未清洗的原始响应(run f50e9fe6-96bc-42a3-8571-2af0e2c91c4c)。那是 YouTube 的原始结构,但里面确实有一个“展开更多回复”的 continuation token。把它再传回同一个端点(run d1c96510-5c14-41a3-a094-31fc801721b7),拿到了剩下的 28 条,8 加 28 正好对上 36。如果你需要完整楼层,可以这么做:
def raw_reply_tokens(node):
    """在未清洗(need_format=False)的回复响应里遍历查找 continuation token。"""
    if isinstance(node, dict):
        cmd = node.get("continuationCommand")
        if isinstance(cmd, dict) and cmd.get("token"):
            yield cmd["token"]
        for v in node.values():
            yield from raw_reply_tokens(v)
    elif isinstance(node, list):
        for v in node:
            yield from raw_reply_tokens(v)

def next_reply_token(reply_token: str):
    raw = call("youtube/web-v2/video-comment-replies",
               {"continuation_token": reply_token, "language_code": "en", "need_format": False})
    tokens = list(raw_reply_tokens(raw))
    return tokens[-1] if tokens else None
我把它当兜底方案,而不是主路径。每翻一页多花一次调用,而且依赖的是一个没有任何文档约束的上游原始结构。做情绪分析的话,最热的五到十个楼层各读第一页回复,通常已经能看清争论集中在哪儿。主流程就是这么设计的。
还有个小怪现象:回复本身的 reply_count 是 "0",同一条回复的 reply_count_a11y 却写着 "1 reply"。回复层级的计数别拿来做任何判断。
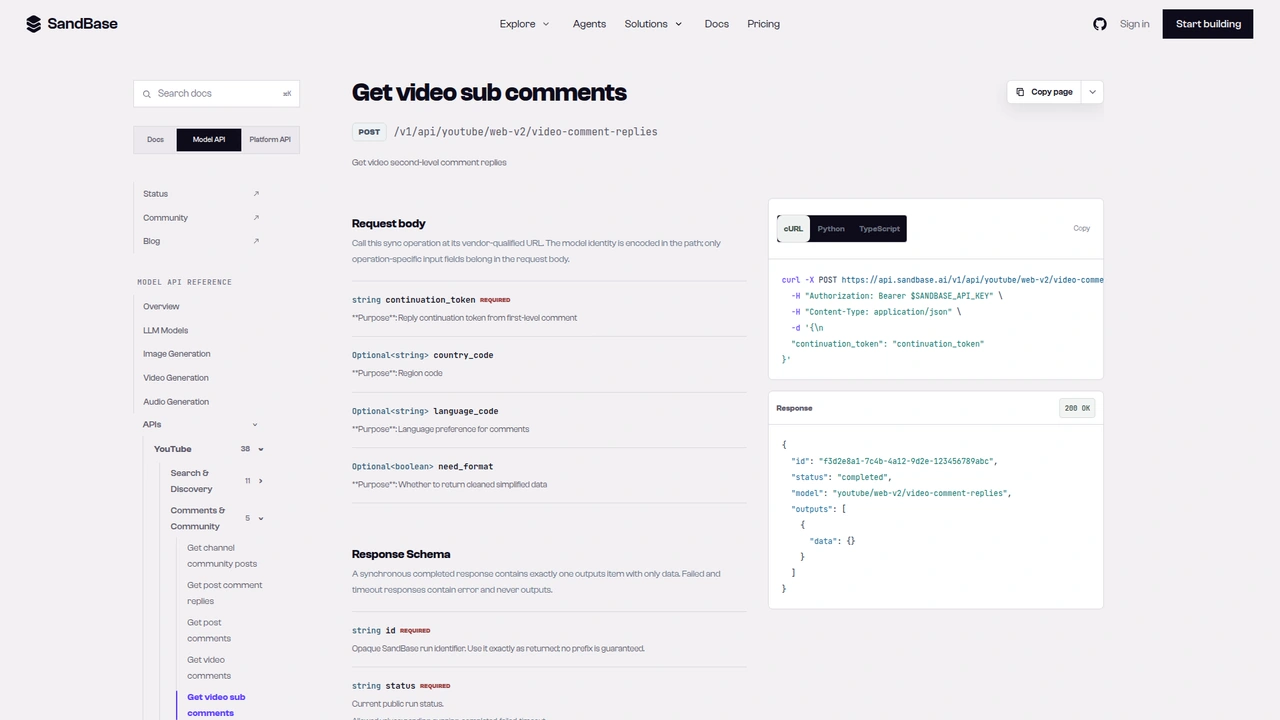
youtube/web-v2/video-comment-replies 参考页,标题为“Get video sub comments”:必填 continuation_token(说明为一级评论给出的回复 token),可选 country_code、language_code 和 need_format。
串起来:每条视频一份反应记录
def analyze_video(video_id: str, comment_pages: int = 2, threads_to_expand: int = 3) -> dict:
    video = read_video(video_id)
    comments = top_level_comments(video_id, comment_pages)
    # 按 comment_id 去重,以防分页重叠。
    seen, unique = set(), []
    for c in comments:
        if c["comment_id"] not in seen:
            seen.add(c["comment_id"])
            unique.append(c)
    # 只展开回复最多的楼层:争论都在那里。
    busiest = sorted((c for c in unique if c["reply_token"]), key=lambda c: c["replies"], reverse=True)
    for c in busiest[:threads_to_expand]:
        c["reply_sample"] = first_replies(c["reply_token"])
    questions = [c["text"] for c in unique if "?" in c["text"]]
    return {"video": video, "comments": unique, "questions": questions}

report = analyze_video(video_id_from_url("https://www.youtube.com/watch?v=GNuXueQ1BYc"))
我在 Pixel 视频上完整跑了一遍,共 6 次调用:video-info(f2fd60da-9f2e-4bd7-a9ec-b3c5e381df31)、两页评论(807d5158-e110-47db-b790-8ba9ff74464c、274438ca-9c43-466d-b44b-d4293d997537)、三次回复(1299f8fc-c2a6-4b13-9c93-8d44573909c8、9b827f63-e3b1-45fc-baf6-2564f12fe5e7、3e086713-c5e7-4315-9c1a-ebc059c72cab)。结果:在视频报告的 600 条评论里收集了 40 条一级评论,展开了回复数为 36、6、4 的三个楼层(分别抽到 8、6、4 条回复),其中 6 条评论带问号。
样本量是故意压小的,但已经能看出这条视频的反应轮廓:夸配乐、夸广告本身;对 Tensor 芯片的怀疑;把续航当成最在意的点;老款 Pixel 用户在问值不值得升级。这是我读这 40 条评论得出的印象,不是统计出来的分布。正式出报告时,把 comment_pages 调大,再把 report 整个交给模型,提示词可以写成“把这些评论归成几个主题,每个主题标注正面、负面或混合,再列出观众提出的不同问题”。记得把点赞数一起放进去,让模型知道一条 797 赞的评论比 0 赞的分量重。
调用量随页数线性增长:视频本身 1 次,每 20 条一级评论 1 次,每展开一个楼层 1 次。一条 600 评论的视频读全,光一级评论就要 31 次左右,还不算回复。批量处理多条视频时,用适度并发,并按 video_id 做缓存。
文档保证与实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/youtube/web-v2/video-info,参数 video_id | 参考文档有记录 |
POST /v1/api/youtube/web-v2/video-comments,参数 video_id、sort_by(top/newest)、continuation_token | 参考文档有记录 |
POST /v1/api/youtube/web-v2/video-comment-replies,参数 continuation_token | 参考文档有记录 |
language_code 默认值 zh-CN | 参考文档有记录 |
信封 id / status / model / outputs[0].data | 参考文档有记录 |
视频 title、author、view_count、like_count、comment_count | 仅实测观察 |
评论 content、like_count、reply_count、reply_continuation_token、published_time | 仅实测观察 |
页面级 comments 和 continuation_token 键 | 仅实测观察 |
楼层未读完时回复页就返回 continuation_token: null | 仅实测观察 |
need_format: false 原始响应里的“更多回复”token | 仅实测观察 |
常见用法
发布反应复盘
在发布后第一天和第一周,分别对自家和竞品的发布视频跑一遍,把主题和问题并排比较。输入:两个视频 id。输出:两份反应记录。端点:video-info、video-comments、video-comment-replies。
从评论里挖文档 FAQ
把某个产品所有教程视频里带问号的评论收集起来,聚类之后,就是一份“文档没讲清楚的地方”清单。输入:一组视频 id。输出:去重后的问题列表。端点:video-comments。
达人与赞助前的评估
谈合作之前,抽样看看达人最近几条视频的评论:观众是在具体讨论内容,还是基本只刷表情。输入:该频道近期的视频 id。输出:带点赞数的评论样本。端点:video-info、video-comments。
舆情跟踪
用 sort_by: "newest" 定时拉取,观察某个事件之后讨论怎么发展。分歧往往最先出现在回复最多的楼层里。输入:一个视频 id。输出:上次运行之后的新评论。端点:video-comments、video-comment-replies。
实用提示
- 始终传
language_code: "en"(或你的目标语言),默认的zh-CN会本地化数字和日期。 - 计数按字符串解析。 会遇到
"600"、"7.5K"和null,排序和加权用解析后的数字。 - 先看
comment_count。 我的测试里,null的评论数对应的是空评论列表。 - 一级评论用返回的
continuation_token翻页,为空就停,并按comment_id去重。 - 回复 token 为
null不代表读完了。 拿已读回复数和父评论的reply_count对一下。 - 丢掉作者字段。 做反应分析很少需要评论者身份,而且那属于个人信息。
- 5xx 要重试。 有一次调用返回 HTTP 503,重试后成功。
- 只读公开数据。 不发评论、不点赞、不做审核。
常见问题
需要 YouTube 账号或 Google Cloud 项目吗?
不需要。用 SANDBASE_API_KEY 向 SandBase 鉴权即可,这几个只读端点不需要你这边做 YouTube 登录或 Google OAuth。
收费吗? 这三个端点目前在 SandBase 目录里标的是 Free,最新状态以目录页为准。
每页返回多少条评论? 我的调用里是每页 20 条一级评论。这是实测观察,文档没有规定页大小。
长楼层的回复能全部拿到吗?
我的测试中,清洗后的响应只给到第一页回复就停了。上面那个 need_format: false 的兜底方法找到了下一页 token,把一个 36 条回复的楼层读全了。它依赖没有文档的原始结构,正式使用前请先自己验证。
sort_by: "top" 是按点赞从高到低吗?
不严格是。它跟 YouTube 自己的排序走,新旧评论会混在一起。需要严格顺序就按解析后的 like_count 本地排。
小结
在 YouTube 上,一个视频 id 就能走完“观众反应”的完整闭环:video-info 估算讨论规模,video-comments 用 continuation token 翻页,video-comment-replies 打开大家争得最凶的楼层。设好语言、解析好计数、盯住回复 token,你就能得到一份干净的记录,让模型归纳出主题和问题。其他 YouTube 端点见 YouTube 公开数据 API 总览。准备好了就可以开始: