抖音达人视频研究 API 教程 | SandBase
按关键词找抖音达人,读主页资料,翻页拉取作品,再按播放和点赞排序:四个 SandBase 端点串成一条链路。无需抖音登录或 SDK,但仍需 SandBase API Key。
手上有一个关键词,想知道两件事:抖音上哪些账号在做这个题材?它们的作品里,哪几条真正跑出来了?
热榜回答的是“全站现在什么火”,达人研究是反过来的:先圈定几个账号,再把它们的历史作品翻一遍。这篇抖音达人视频研究 API 教程用四个 SandBase 端点把这件事串起来:关键词搜达人 → 读主页资料 → 翻页拉作品 → 按播放和点赞排序。端点全景可以先看抖音公开数据 API 总览。
读的都是公开、只读数据。不需要抖音账号,也不需要 SDK,一个 SandBase API Key 就够了。这四个端点目前在 SandBase 目录里标的是 Free。
参数和响应信封以端点 API 参考为准,参考只保证信封结构。下文出现的业务字段名都来自我自己跑的调用(测试于 2026-10-01,UTC),属于实测观察,不是文档保证。
先说结论
douyin/search/user-search-v2把关键词变成候选达人列表。我实测时,结果里的user_id就是sec_user_id格式,后面两步可以直接用。douyin/app-v3/user-profile返回主页资料:昵称、抖音号、简介、认证信息、粉丝数和获赞总数。douyin/app-v3/user-post-videos用max_cursor加has_more翻页拉作品。点赞、评论、分享都有,但play_count在我的调用里一直是 0。douyin/app-v3/multi-video-statistics一次最多查 50 个作品的播放量。按aweme_id关联回去,再排序。
播放量为什么要单独查一次
第一版代码我直接拿作品列表排序,结果每条都是 play_count: 0。我在下文用的杂志账号上翻了三页、共 60 条,全是 0;之前试的一个全国性新闻账号,第一页也一样。点赞、评论、分享、收藏倒是都有数。
答案写在 multi-video-statistics 的参考说明里:抖音的大多数接口已经不再返回作品播放量,要拿播放量只能走这个接口。所以链路里多了第四步。好在成本不高,一次调用能覆盖 50 条作品。
这会影响排序的设计。点赞来自作品列表,播放来自统计接口,每个数字从哪一次调用来,要分清楚。同一条作品,我还碰到过两边 share_count 对不上的情况(作品列表里是 16,统计接口里是 2)。所以我只从统计接口取 play_count,其他指标都用作品列表的。
| 你的需求 | 用什么 |
|---|---|
| 做研究用的公开达人资料和作品互动数据 | SandBase 抖音公开数据 API |
| 发作品、管理自己的账号、授权数据合作 | 抖音开放平台等官方渠道 |
| 私密内容、仅粉丝可见内容、需账号授权的数据 | 两者都不适用 |
整体流程
- 搜达人:
douyin/search/user-search-v2(keyword、cursor)。 - 读主页:
douyin/app-v3/user-profile(sec_user_id)。 - 翻作品:
douyin/app-v3/user-post-videos(sec_user_id、max_cursor、count)。 - 补播放量:
douyin/app-v3/multi-video-statistics(aweme_ids,逗号分隔,最多 50 个)。 - 排序:按播放、点赞或赞播比。
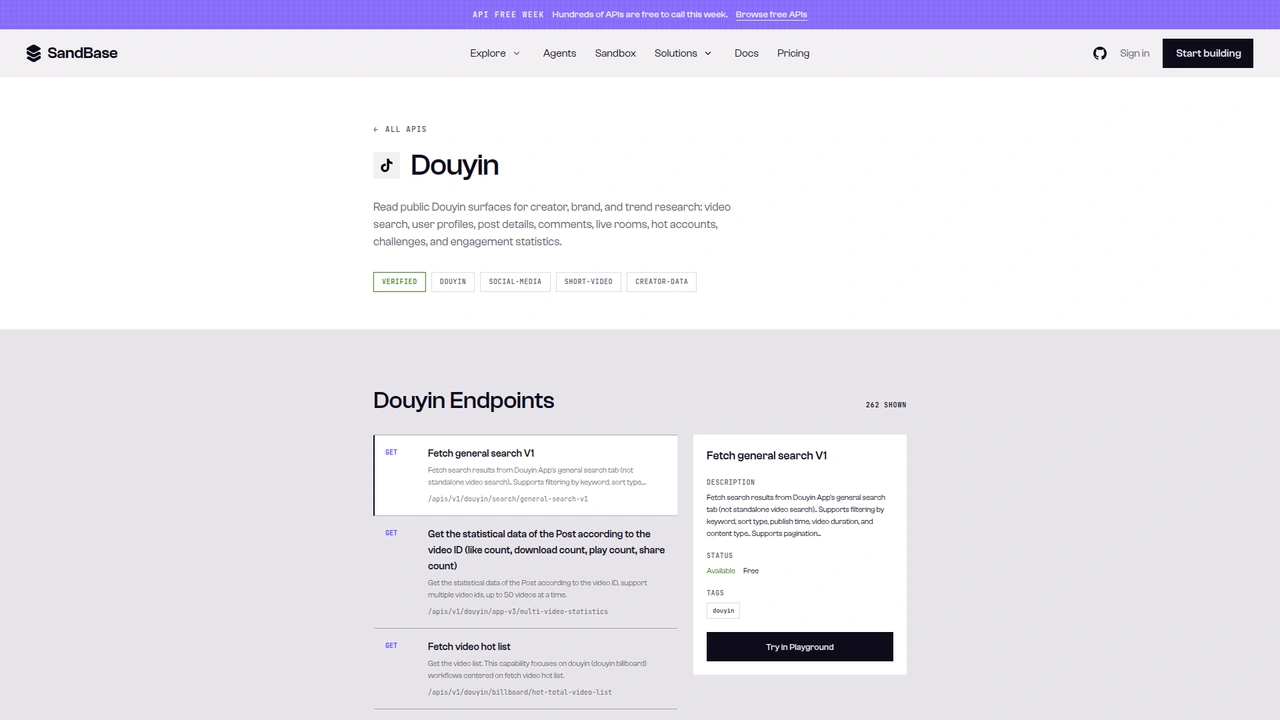 SandBase 上的抖音目录页。端点以
GET /apis/v1/douyin/... 的形式列出,其中有 app-v3/multi-video-statistics;右侧面板显示选中端点为 Available、Free。本教程调用的是 Model API 的 POST /v1/api/douyin/... 路由。
注意别把两种路由搞混。目录页展示的是 GET /apis/v1/douyin/<path>,本教程用的是端点参考里的 Model API:POST /v1/api/douyin/<path>,JSON 请求体里只放该端点自己的参数。参考页的生成示例如果带了别的字段,以参考为准。复制代码时保留 POST 方法和 /v1/api/ 前缀。
第 0 步:一个通用调用函数
import os
import time
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call(path: str, payload: dict, retries: int = 2) -> dict:
    for attempt in range(retries + 1):
        try:
            resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=90)
            resp.raise_for_status()
            break
        except requests.RequestException:
            if attempt == retries:
                raise
            time.sleep(2 * (attempt + 1))
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error", {}).get("message", f"{path} did not complete"))
    # 参考文档写的是 outputs[0].data;顶层 output 也兼容
    output = body.get("output")
    if output is None and body.get("outputs"):
        output = body["outputs"][0].get("data", {})
    return output or {}
参考文档里,成功响应的业务数据在 outputs[0].data。这次测试里抖音的每次调用都是这个结构。代码同时兼容顶层 output,因为我在 SandBase 其他平台端点上见过这种返回。
data 里面的层级各端点不一样:搜索结果外面还包了一层 data,旁边是 code;主页、作品列表和统计接口都没有这一层。所以只有第 1 步要再取一次 .get("data")。加重试是因为我对同一个 API 域名发的一次截图请求在 TLS 层断开了,重发一次就好了。
第 1 步:按关键词搜达人
def search_creators(keyword: str, pages: int = 1) -> list[dict]:
    cursor, creators = 0, []
    for _ in range(pages):
        page = call("douyin/search/user-search-v2", {"keyword": keyword, "cursor": cursor})
        data = page.get("data", {}) or {}
        for u in data.get("user_list", []) or []:
            creators.append({
                "sec_user_id": u.get("user_id"),
                "name": u.get("nick_name"),
                "followers": u.get("fans_cnt"),
                "total_likes": u.get("like_cnt"),
                "posts": u.get("publish_cnt"),
            })
        if not data.get("has_more"):
            break
        cursor = data.get("cursor")
    return creators
我搜的是“中国国家地理”。每页返回 30 个账号,带 has_more: true 和 cursor: 30。把这个 cursor 原样传回去就拿到第二页(run id 563bdc12-2bbc-403f-b918-a1b964306571 和 4b610646-336c-49b7-9f64-3b35cac0da98)。排第一的是杂志主账号,粉丝约 564 万。后面跟着它的几个子品牌(景观、频道、地道风物、探索),再往后夹着几个不相干的科普号。
这里有两个细节。
第一,字段名叫 user_id,值却是 MS4wLjABAAAA... 这种形式,也就是 app-v3 端点要的 sec_user_id,直接传给主页接口就能用。
第二,参考页的描述说这个接口“支持按粉丝数和用户类型过滤”,但请求 schema 里只有 keyword 和 cursor 两个参数。没写进 schema 的过滤参数我没有传。真要过滤,就在拿回来的列表上按 fans_cnt 自己筛。
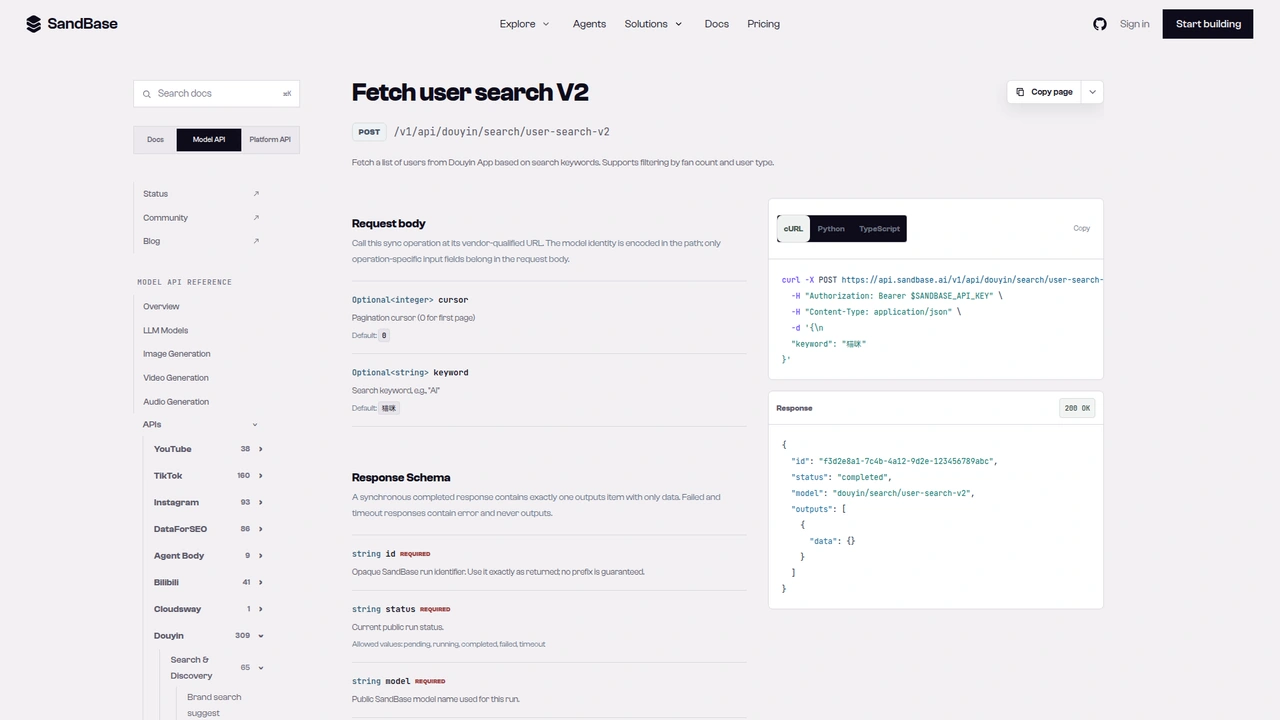
douyin/search/user-search-v2 的参考页:POST /v1/api/douyin/search/user-search-v2,参数是可选的 cursor(默认 0)和 keyword。文档里的响应示例中 outputs[0].data 是空的。
第 2 步:读主页资料
def read_profile(sec_user_id: str) -> dict:
    user = call("douyin/app-v3/user-profile", {"sec_user_id": sec_user_id}).get("user", {}) or {}
    return {
        "name": user.get("nickname"),
        "douyin_id": user.get("unique_id"),
        "bio": user.get("signature"),
        "verified_as": user.get("enterprise_verify_reason") or user.get("custom_verify"),
        "followers": user.get("follower_count"),
        "total_likes": user.get("total_favorited"),
        "videos": user.get("aweme_count"),
    }
杂志主账号这次的返回(run id 046c8eae-9a2c-411c-9914-3c8f5ed1f754):unique_id 是 zggjdl,粉丝约 564 万,获赞约 2,566 万,企业认证为《中国国家地理》杂志社有限公司。
作品数和搜索结果对不上:主页的 aweme_count 是 538,搜索里的 publish_cnt 是 545。之前试的那个新闻账号差得更多,大约 12,300 对 15,900。这两个数都只能当近似值,需要精确数量时,以你实际翻到的作品为准。
第 3 步:翻页拉作品
def list_videos(sec_user_id: str, max_pages: int = 3) -> list[dict]:
    max_cursor, videos = 0, []
    for _ in range(max_pages):
        page = call("douyin/app-v3/user-post-videos",
                    {"sec_user_id": sec_user_id, "max_cursor": max_cursor, "count": 20})
        for a in page.get("aweme_list", []) or []:
            stats = a.get("statistics", {}) or {}
            videos.append({
                "aweme_id": a.get("aweme_id"),
                "created": a.get("create_time"),
                "desc": (a.get("desc") or "")[:60],
                "likes": stats.get("digg_count"),
                "comments": stats.get("comment_count"),
                "shares": stats.get("share_count"),
                "saves": stats.get("collect_count"),
            })
        if not page.get("has_more"):
            break
        max_cursor = page.get("max_cursor")
    return videos
参考的说法是:第一页 max_cursor 传 0,之后传上一页响应里的 max_cursor。实测也是这样。每页 20 条,has_more: 1,max_cursor 看起来是毫秒级时间戳,而每条作品的 create_time 是秒级。下面是第一页的节选(run id 28936f25-f639-471c-9f9b-1204e408db4c):
{
  "has_more": 1,
  "max_cursor": 1789444800000,
  "aweme_list": [
    {
      "aweme_id": "7690953381636017446",
      "desc": "【预告片】生命奇观2 川西山地 ...",
      "create_time": 1790740800,
      "is_top": 0,
      "statistics": {
        "play_count": 0,
        "digg_count": 845,
        "comment_count": 34,
        "share_count": 16,
        "collect_count": 43
      }
    }
  ]
}
这里的 play_count: 0 就是开头说的那个问题。另外,列表里视频和别的形式混在一起:有些条目的 aweme_type 是 68,看起来是图文作品。统计接口对它们一样能返回播放量。只想要视频的话,先自己抽几条看看,再按 aweme_type 过滤。
参考里还有个可选的 sort_type,但说明只写到“optional values are as follows:”,后面没有列出取值,所以我没传。同类的 web/user-post-videos 也存在,本教程用 app-v3,因为这是我实测跑通的那条。
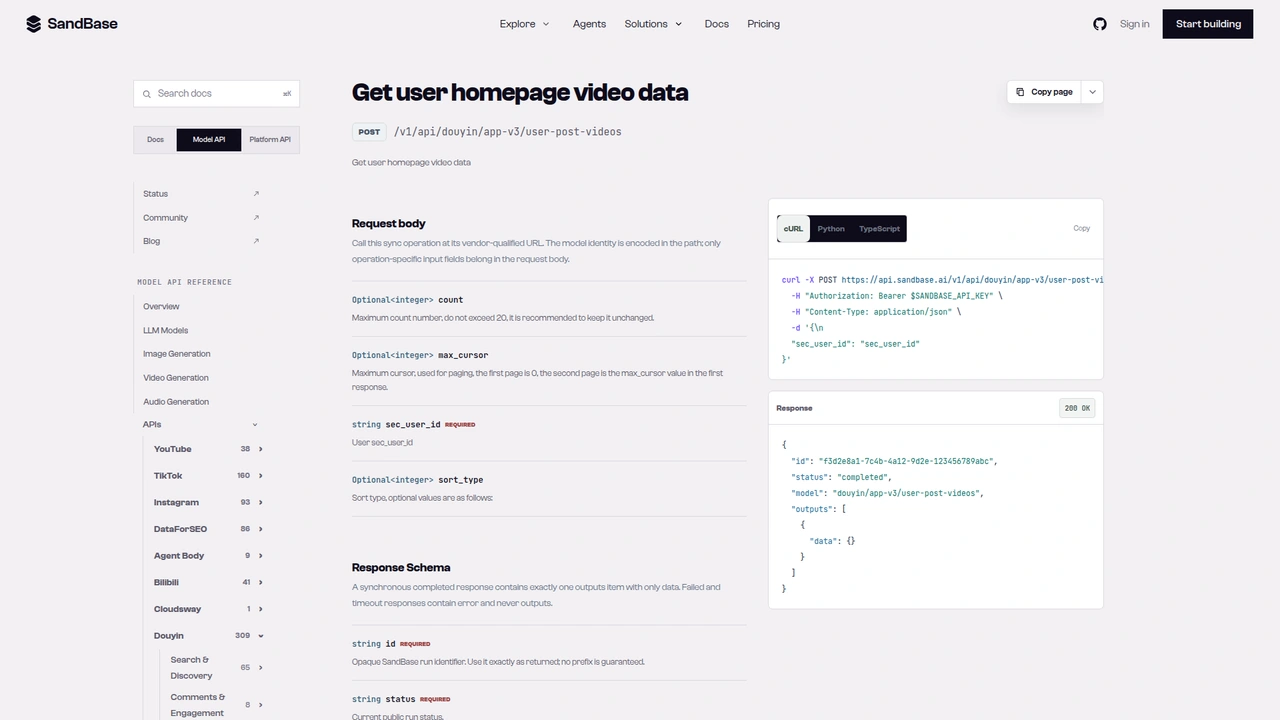
douyin/app-v3/user-post-videos 的参考页:必填 sec_user_id,可选 count(不超过 20)、max_cursor 和 sort_type。sort_type 的说明没有列出任何取值。
第 4 步:补播放量并排序
def add_play_counts(videos: list[dict]) -> list[dict]:
    plays = {}
    for i in range(0, len(videos), 50):  # 参考规定每次最多 50 个 id
        ids = ",".join(v["aweme_id"] for v in videos[i:i + 50])
        stats = call("douyin/app-v3/multi-video-statistics", {"aweme_ids": ids})
        for s in stats.get("statistics_list", []) or []:
            plays[str(s.get("aweme_id"))] = s.get("play_count")
    for v in videos:
        v["plays"] = plays.get(str(v["aweme_id"]))
    return videos

def rank(videos: list[dict], key: str = "plays", top: int = 5) -> list[dict]:
return sorted(videos, key=lambda v: v.get(key) or 0, reverse=True)[:top]我跑的几次里,statistics_list 每个 id 对应一条,字段有 aweme_id、play_count、digg_count、share_count,有时还有 download_count。作品列表里播放量为 0 的那条图文,在这里查出来是 70,966 次(run id dc35d090-ba7a-4391-a4f4-da78349bc42b)。
关联时用字符串 id。两个接口返回的 aweme_id 都是字符串,这么长的数字也确实更适合当字符串用。
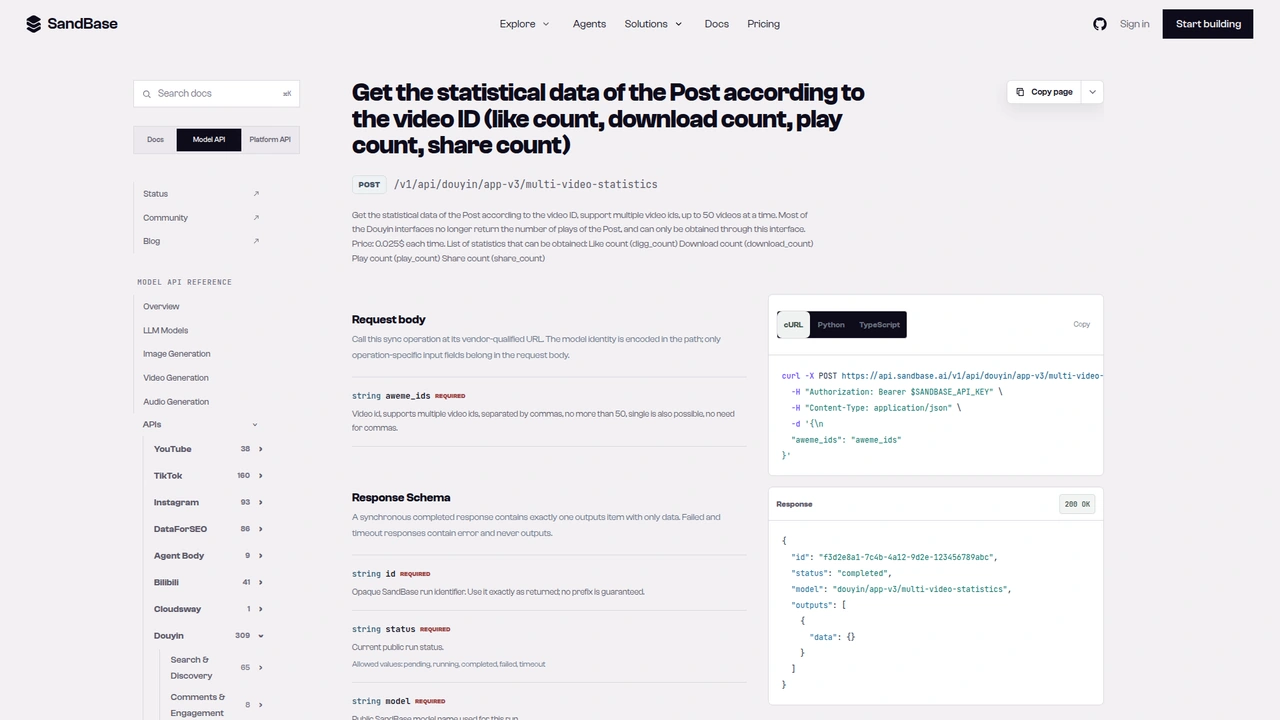
douyin/app-v3/multi-video-statistics 的参考页:只有一个必填的 aweme_ids 字符串,逗号分隔,最多 50 个。说明里写着抖音大多数接口已不再返回播放量。说明里还有一行按次计费的“Price”;这个端点目前在 SandBase 目录里标的是 Free,正式使用前请以目录为准。
串起来跑一遍
creators = search_creators("中国国家地理", pages=2)
target = creators[0]
profile = read_profile(target["sec_user_id"])
videos = add_play_counts(list_videos(target["sec_user_id"], max_pages=3))

for v in rank(videos, "plays"):
    rate = (v["likes"] or 0) / v["plays"] if v.get("plays") else 0
print(f"{v['plays']:>12,} plays {v['likes']:>10,} likes {rate:.1%} {v['desc'][:30]}")完整脚本我原样跑了一遍,一共八次调用:搜索两次,主页一次,作品列表三次(1eca7db3-03b1-4af2-866b-30e69a24c249、3042978c-8207-4915-9fea-a6e6c5d17c1c、d4a0422d-d0d3-409a-b057-4e3600902272),统计接口两次,覆盖 60 条作品(c67a86e8-4129-4205-8790-fa4510bc1b2c、6ab3f851-f942-436f-8121-0fb222cb77fa)。
这 60 条覆盖了 2026 年 1 月初到 9 月底的作品,分布非常不均。前两名播放量分别约 9,040 万和 8,700 万,第三名约 1,143 万,而 60 条的中位数只有约 37 万。前五名的赞播比在 1.5% 到 4.1% 之间。
这正是这条链路最有用的地方:账号的平均数会把几条爆款藏起来。播放量说明哪些题材拿到了流量,赞播比说明观众到底买不买账。
研究多个达人时,就遍历搜索得到的候选列表,每个 sec_user_id 存一条记录,里面放主页资料和排好序的作品。一个达人翻三页,一共五次调用:主页一次,作品列表三次,统计一次。把这些记录交给模型,可以让它比较各账号的爆款率,总结每个达人表现最好的题材,或者找出播放量全靠一条爆款撑着的账号。
文档保证 vs. 实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/douyin/search/user-search-v2,参数 keyword、cursor | 参考文档已写明 |
POST /v1/api/douyin/app-v3/user-profile,参数 sec_user_id | 参考文档已写明 |
POST /v1/api/douyin/app-v3/user-post-videos,参数 sec_user_id、max_cursor、count | 参考文档已写明 |
POST /v1/api/douyin/app-v3/multi-video-statistics,参数 aweme_ids(最多 50 个) | 参考文档已写明 |
信封 id / status / model / outputs[0].data | 参考文档已写明 |
搜索 data.user_list[] 的 user_id(sec_user_id 格式)、nick_name、fans_cnt,以及 cursor、has_more | 仅实测观察 |
主页 user.unique_id、follower_count、total_favorited、aweme_count、enterprise_verify_reason | 仅实测观察 |
作品列表 aweme_list[].statistics、has_more、max_cursor;play_count 返回 0 | 仅实测观察 |
统计 statistics_list[] 的 aweme_id、play_count、digg_count | 仅实测观察 |
常见用法
投放前筛达人
搜一个品类关键词,读主页,再按近期作品的播放中位数排序,而不是只看粉丝数。输入是关键词,输出是一张达人排名表,四个端点都会用到。
官方账号内容复盘
把某个品牌号或媒体号最近的作品翻一遍,看哪些题材能跑出来。输入是一个 sec_user_id,输出是按播放量和赞播比排好的作品列表。用到 user-post-videos 和 multi-video-statistics。
子品牌横向对比
像这次搜索结果里看到的,媒体集团常常有好几个账号。把主账号和各子品牌的单条平均播放放在一起比。输入是搜索候选列表,输出是各账号的单条播放,四个端点都会用到。
作品发布后的追踪
每天对一组固定的 aweme_id 重跑一次统计接口,把数字存下来。每次最多 50 个 id,输出是播放量时间序列。只用 multi-video-statistics。
实用提醒
- 别用作品列表里的
play_count排序。 我的每次调用里它都是 0,播放量请从multi-video-statistics取。 - 同一个指标只从一个接口取。 同一条作品,两个接口的
share_count对不上。 - 用返回的游标翻页。 搜索传回
cursor,作品列表传回max_cursor;has_more为假就停。 - 作品形式是混着的。 作品列表里图文和视频混在一起。
- 计数只是近似值。 主页的
aweme_count和搜索的publish_cnt对不上:杂志账号差 7 条,新闻账号差了约 3,600 条。 - 业务字段只是实测观察。 正式依赖之前,先用真实响应核对一遍。
- 只研究公开账号。 存账号级和作品级的指标就够了,不要收集观众或评论者的个人信息。
常见问题
需要抖音账号或登录吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权,这几个只读端点不需要你提供抖音账号或 OAuth。
收费吗? 这四个端点目前在 SandBase 目录里标的是 Free,最新状态以目录页为准。
sec_user_id 从哪里来?
从搜索结果来。我实测时,user_list 里每一项的 user_id 已经是 sec_user_id 格式。
为什么播放量是 0?
我测试时,作品列表返回的 play_count 都是 0。multi-video-statistics 的参考说明写着抖音大多数接口已不再返回播放量,用它一次查最多 50 个 id 即可。
和热榜监测有什么区别? 热榜监测教程看的是全站在火什么;这篇从你选定的账号出发,读的是这些账号自己的作品。
收个尾
有一个关键词,就能开始做抖音达人研究。搜索给出账号 id,主页给出资料卡,作品列表给出作品和互动数据,再用一次统计接口补上作品列表里缺的播放量。按 aweme_id 关联起来,任何一个达人的作品都能按传播和反馈排出来。其他抖音端点见抖音公开数据 API 总览。准备好了就从这里开始: