Twitter 关键词搜索 API 教程 | SandBase
搭一套 Twitter/X 关键词搜索工作流:搜时间线、翻页结果、给作者建档——一个 SandBase 密钥,无需 Twitter 登录、无需 SDK。
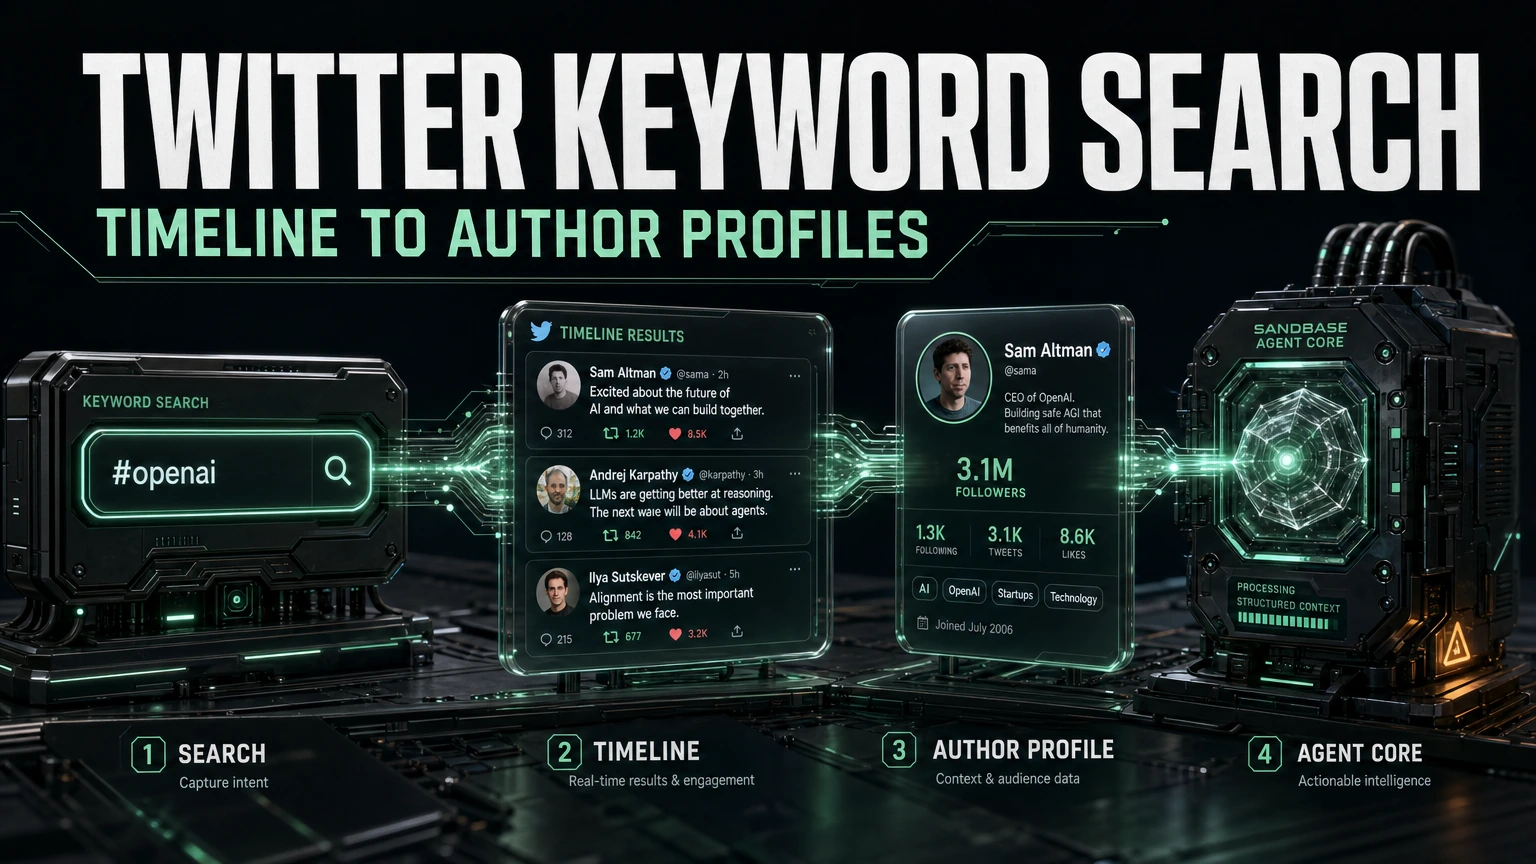
想知道 X 上有哪些人在讨论某个产品,先把一次关键词搜索读明白,再决定是否追查作者。本文用 SandBase 搜索公开 Twitter/X 内容,解释返回字段、原帖链接和分页规则,并保留按作者账号查询资料的 Python 流程。只需要 SandBase API 密钥,不需要登录 Twitter/X,也不用安装 X SDK。
先完成搜索和结果检查即可;作者资料是可选的补充。端点参考列出了输入参数、HTTP 返回结构和业务字段示例,但不同记录未必包含所有字段,代码仍要处理缺失值。
先说结论
- 用
search-timeline搜公开帖子;需要作者背景时,再调用user-profile。- 每次请求使用
POST /v1/api/twitter/web/<path>,请求体只放端点参数,以SANDBASE_API_KEY鉴权。- HTTP 结果从
outputs[0].data读取;搜索结果中的screen_name可作为资料接口的screen_name。- 翻页时把响应的
next_cursor传给请求参数cursor,同时设置预算和去重规则。
接入范围
本文通过 Bearer API key 向 SandBase 鉴权,读取公开搜索结果。它不会以 X 账号身份登录、发帖、发私信或读取私有消息。需要账号授权的操作应另行集成,不在本教程范围内。
工作流一览
- 向
twitter/web/search-timeline传入keyword,查看返回的帖子。 - 如果需要了解作者,把帖子中的
screen_name作为screen_name传给twitter/web/user-profile。
HTTP 响应外层包含 id、status、model 等运行信息。完成态的数据位于 outputs[0].data。先检查请求是否成功、运行是否完成,再解析业务字段。
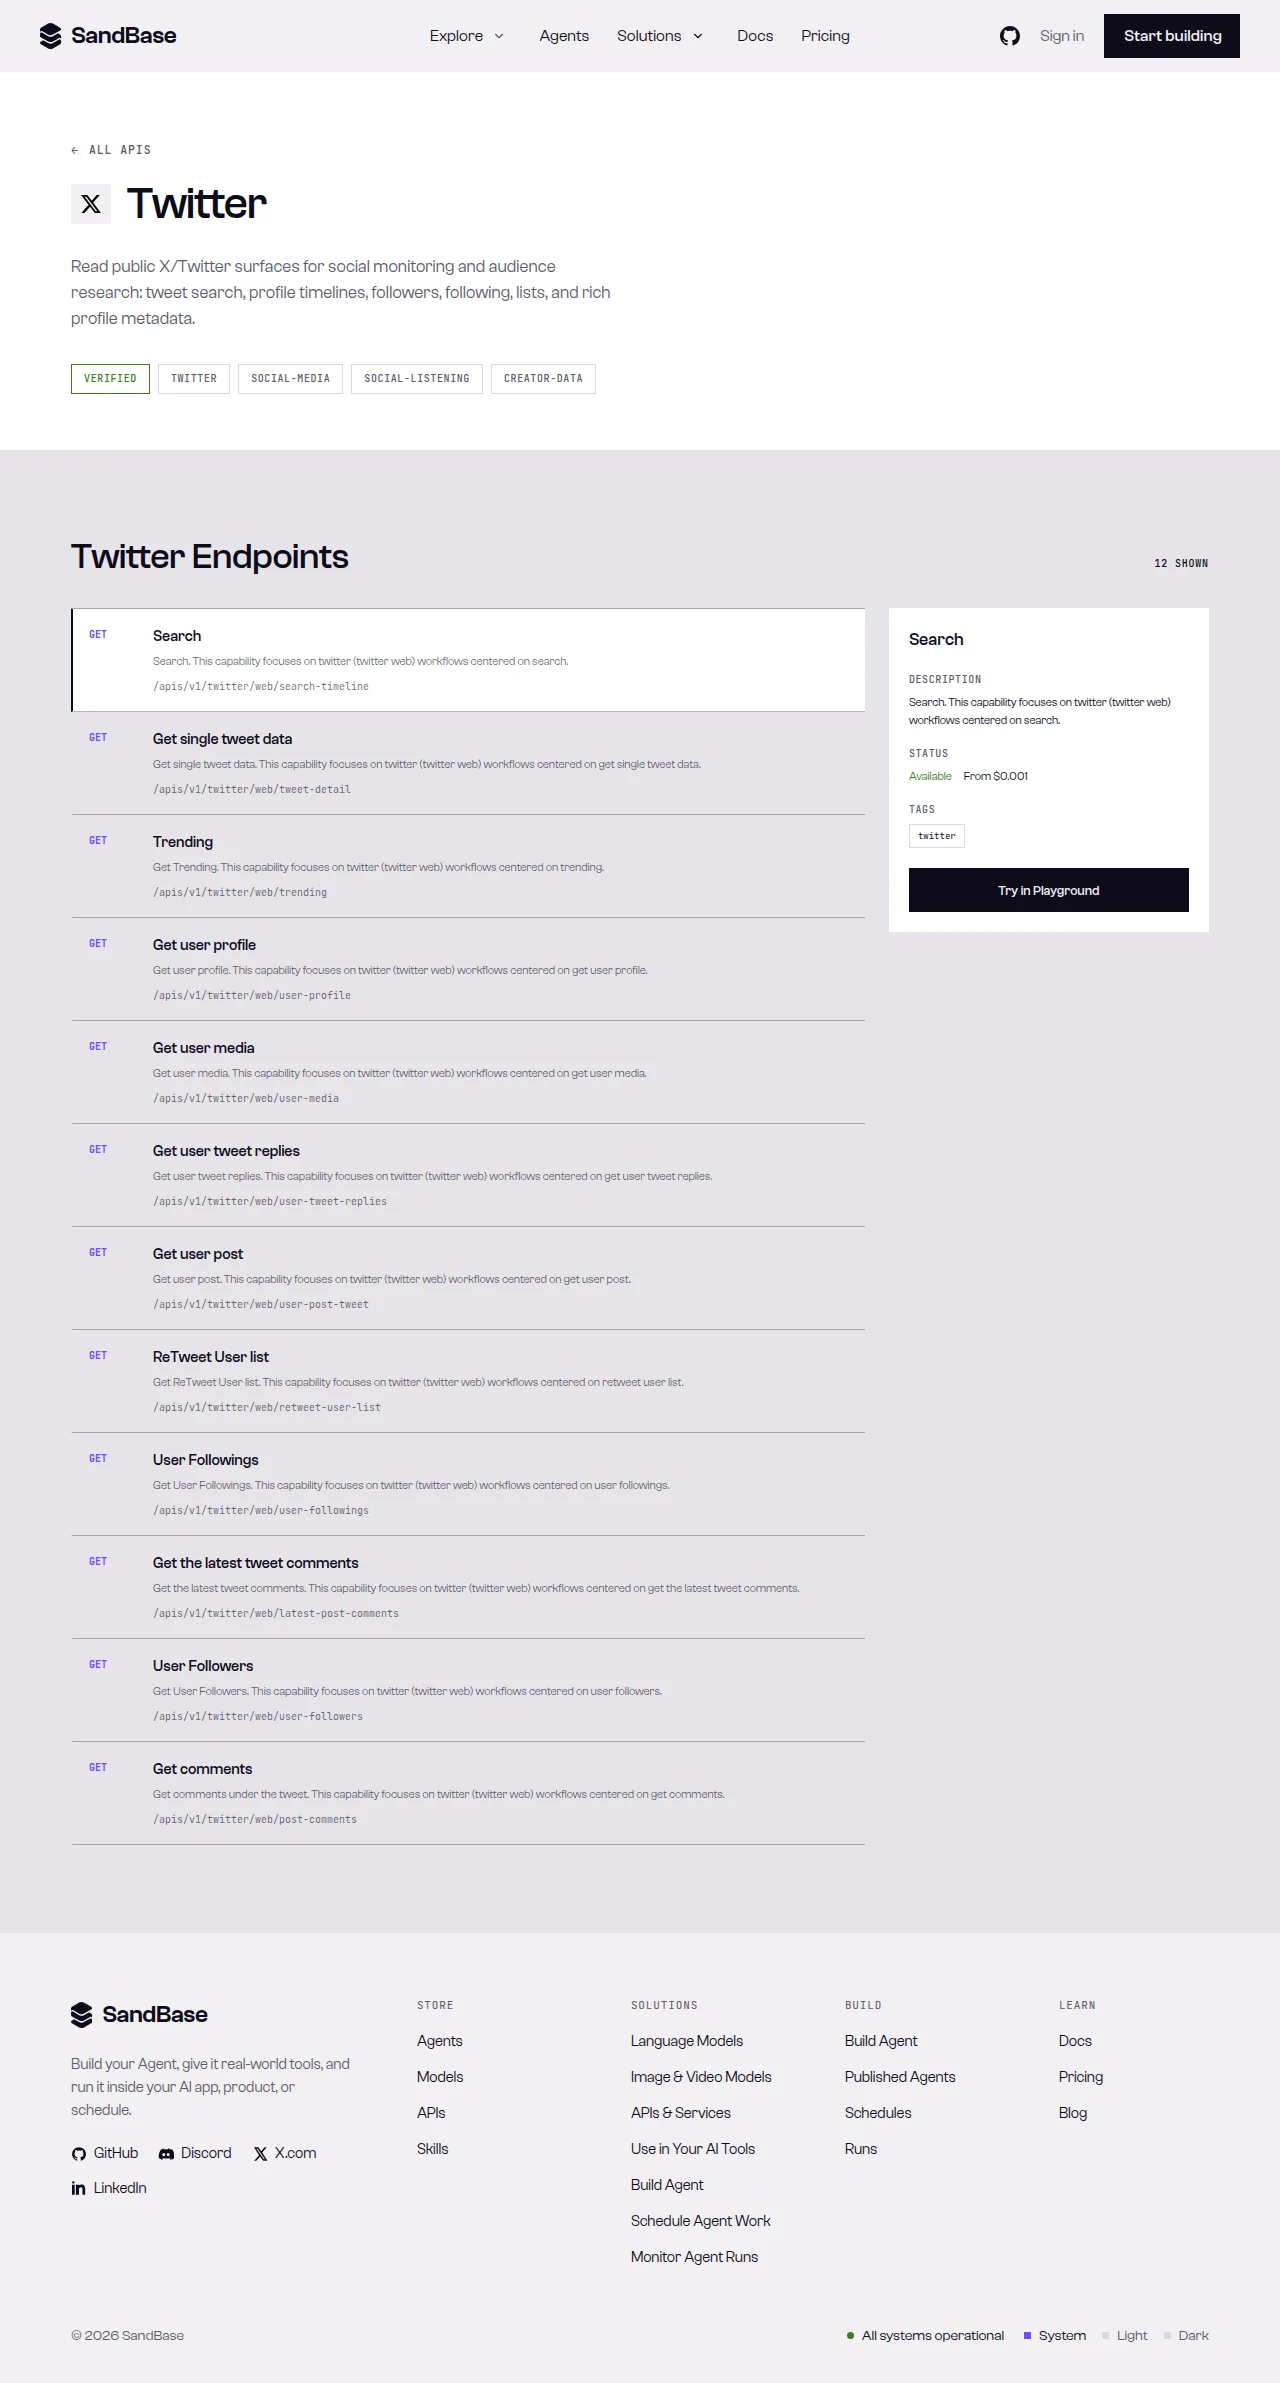 原文保留的目录截图,展示搜索和作者资料端点。其中 GET /apis/v1 是目录展示的接口形式;本文代码使用文档规定的 Model API POST /v1/api 路由。
第 0 步:先发送一次请求
在本机或服务器环境设置 SANDBASE_API_KEY,再执行下面的命令。keyword 是必填参数,这里显式选用文档默认的 Top。search_type 还接受 Latest、Media、People 和 Lists;不同模式的返回内容不同,不能把每个条目都当成帖子。
curl --fail-with-body --silent --show-error \
  'https://api.sandbase.ai/v1/api/twitter/web/search-timeline' \
  -H "Authorization: Bearer ${SANDBASE_API_KEY:?Set your SandBase API key}" \
  -H 'Content-Type: application/json' \
  --data '{"keyword":"AI agents","search_type":"Top"}' \
  -o x-search.json
打开 x-search.json,先核对 HTTP 响应和运行状态。密钥不要放进浏览器端代码、共享笔记本或公开请求日志。
Python 使用同一套 HTTP 结构
运行 python -m pip install requests,并在同一个脚本或笔记本中依次执行后面的 Python 代码块。Python 进程也需要读取环境中的 SANDBASE_API_KEY。
import os
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call(path: str, payload: dict) -> dict:
    resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=60)
    resp.raise_for_status()
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(f"{path} did not complete: status={body.get('status')!r}")
    # Direct HTTP calls in this tutorial use outputs[0].data.
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs:
        raise RuntimeError("Completed HTTP response has no outputs array")
    first = outputs[0]
    data = first.get("data") if isinstance(first, dict) else None
    if not isinstance(data, dict):
        raise RuntimeError("Expected an object at outputs[0].data")
    return data
这个 helper 专用于直接 HTTP 调用。HTTP 文档使用 outputs[0].data;11 月 4 日的工具调用记录使用 output[0].data,两者外层字段都是数组。把整个 output 数组返回,并不等于取出第一项里的 data,也不能据此给 HTTP 教程增加第二套解析规则。
第 1 步:搜索时间线
data = call("twitter/web/search-timeline", {"keyword": "AI agents", "search_type": "Top"})
tweets = data.get("timeline", [])
next_cursor = data.get("next_cursor")
print(len(tweets), "tweets, more:", bool(next_cursor))
不只看返回了多少条
直接 HTTP 响应中的帖子列表位于 outputs[0].data.timeline。把 tweet_id 当字符串保存,screen_name 是作者账号,text 是返回的正文。创建时间、互动数等字段存在时再记录;缺失不代表零。conversation_id 标识对话,不能代替单条帖子的 ID。
优先保存接口提供的原帖 URL。没有 URL、但有作者账号和帖子 ID 时,可以构造 https://x.com/<handle>/status/<id>,与摘要一起保存。嵌套的 quoted 对象属于另一条被引用帖子,不要把它的文字或互动数混入外层帖子。
已有核验记录,2026 年 11 月 4 日: SandBase 的核验笔记记录了两次以 AI agents、Top 搜索的调用。工具调用完成后,output[0].data.timeline 有 20 条,全部带有 tweet_id 和 screen_name;直接 HTTP curl 调用也完成,outputs[0].data.timeline 有 19 条,全部有帖子 ID 和作者账号。这只是那两次调用的观测,不保证每页数量,也不能计算成功率或解释数量差异。本次文章修订没有重新运行这些请求。
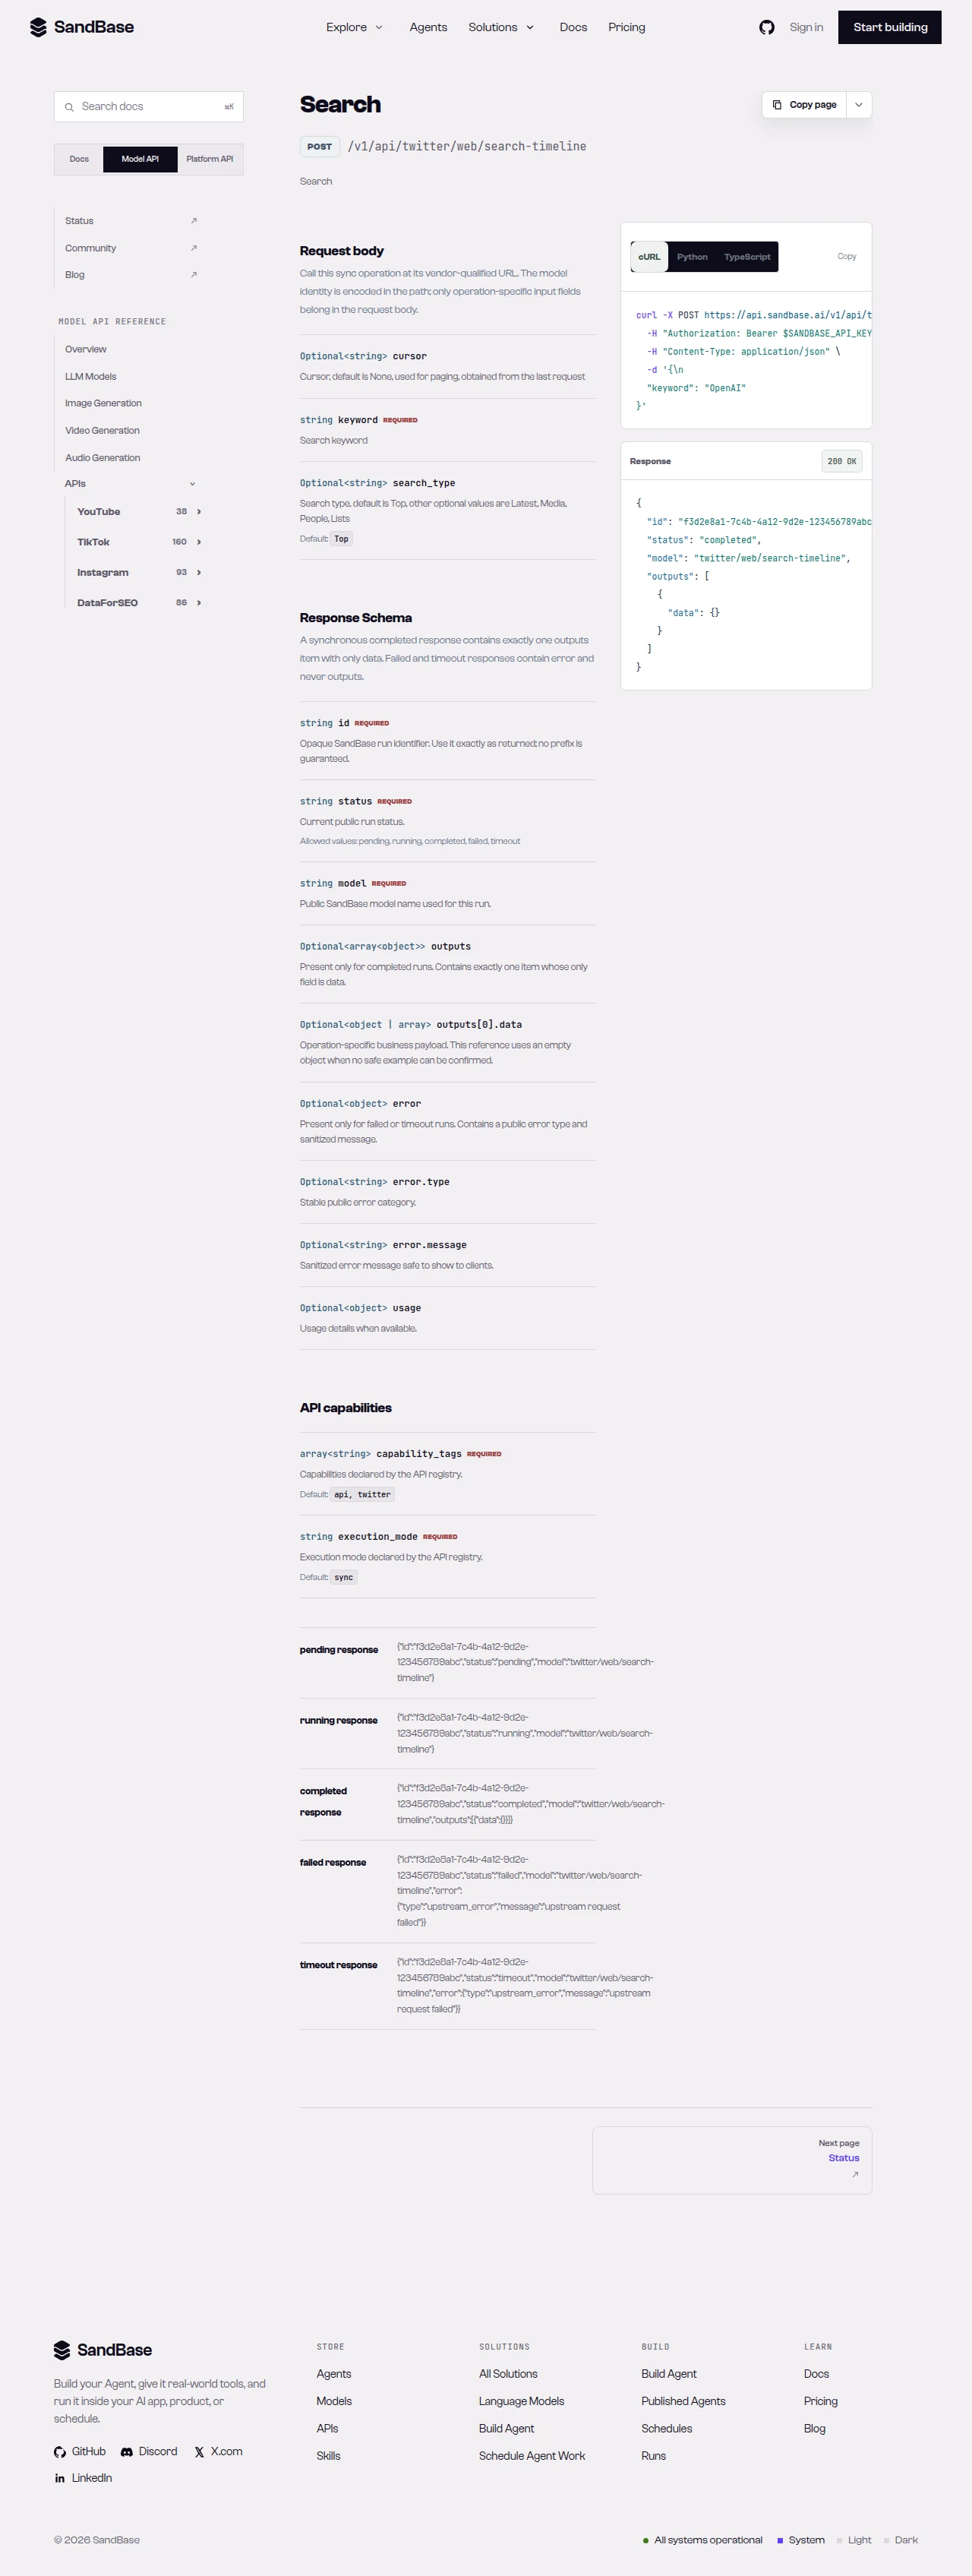 原文保留的 search-timeline 参考截图;当前参数和返回示例请查阅文末的实时参考页。
翻页、停止与去重
继续搜索时,把返回的 next_cursor 放进下一次请求的 cursor,保持 keyword 和 search_type 不变。响应字段名和请求参数名并不相同。游标是不可编辑的字符串,不要拆解,也不要跨查询复用。
开始循环前先定页数、时间或费用上限。没有可用游标、游标重复、空页或预算耗尽时都应停止;如果一页没有新增帖子 ID,也应停下来检查。这是客户端的防御规则,并不表示接口保证能遍历全部匹配内容。
跨页按 tweet_id 去重后,再统计或汇总帖子。作者去重另算:同一个 screen_name 可以发多条不同帖子。本文 Python 示例只抓一页搜索结果并可选查询作者,尚未实现自动分页循环。
第 2 步:按需补充作者资料
screen_names = {t.get("screen_name") for t in tweets if isinstance(t, dict) and t.get("screen_name")}

for name in list(screen_names)[:5]:
    profile = call("twitter/web/user-profile", {"screen_name": name})
    print(name, "-", profile.get("name"), "|", profile.get("friends"), "following")
user-profile 参考页 接受 screen_name,可使用结果中存在的 screen_name。资料查询提供的是账号背景,不能独立证明帖子的说法。用 .get() 读取实际返回的字段,缺失值保留为未知。示例里的 friends 是该账号关注的人数,不是粉丝数;本次修订没有重新测试资料查询。
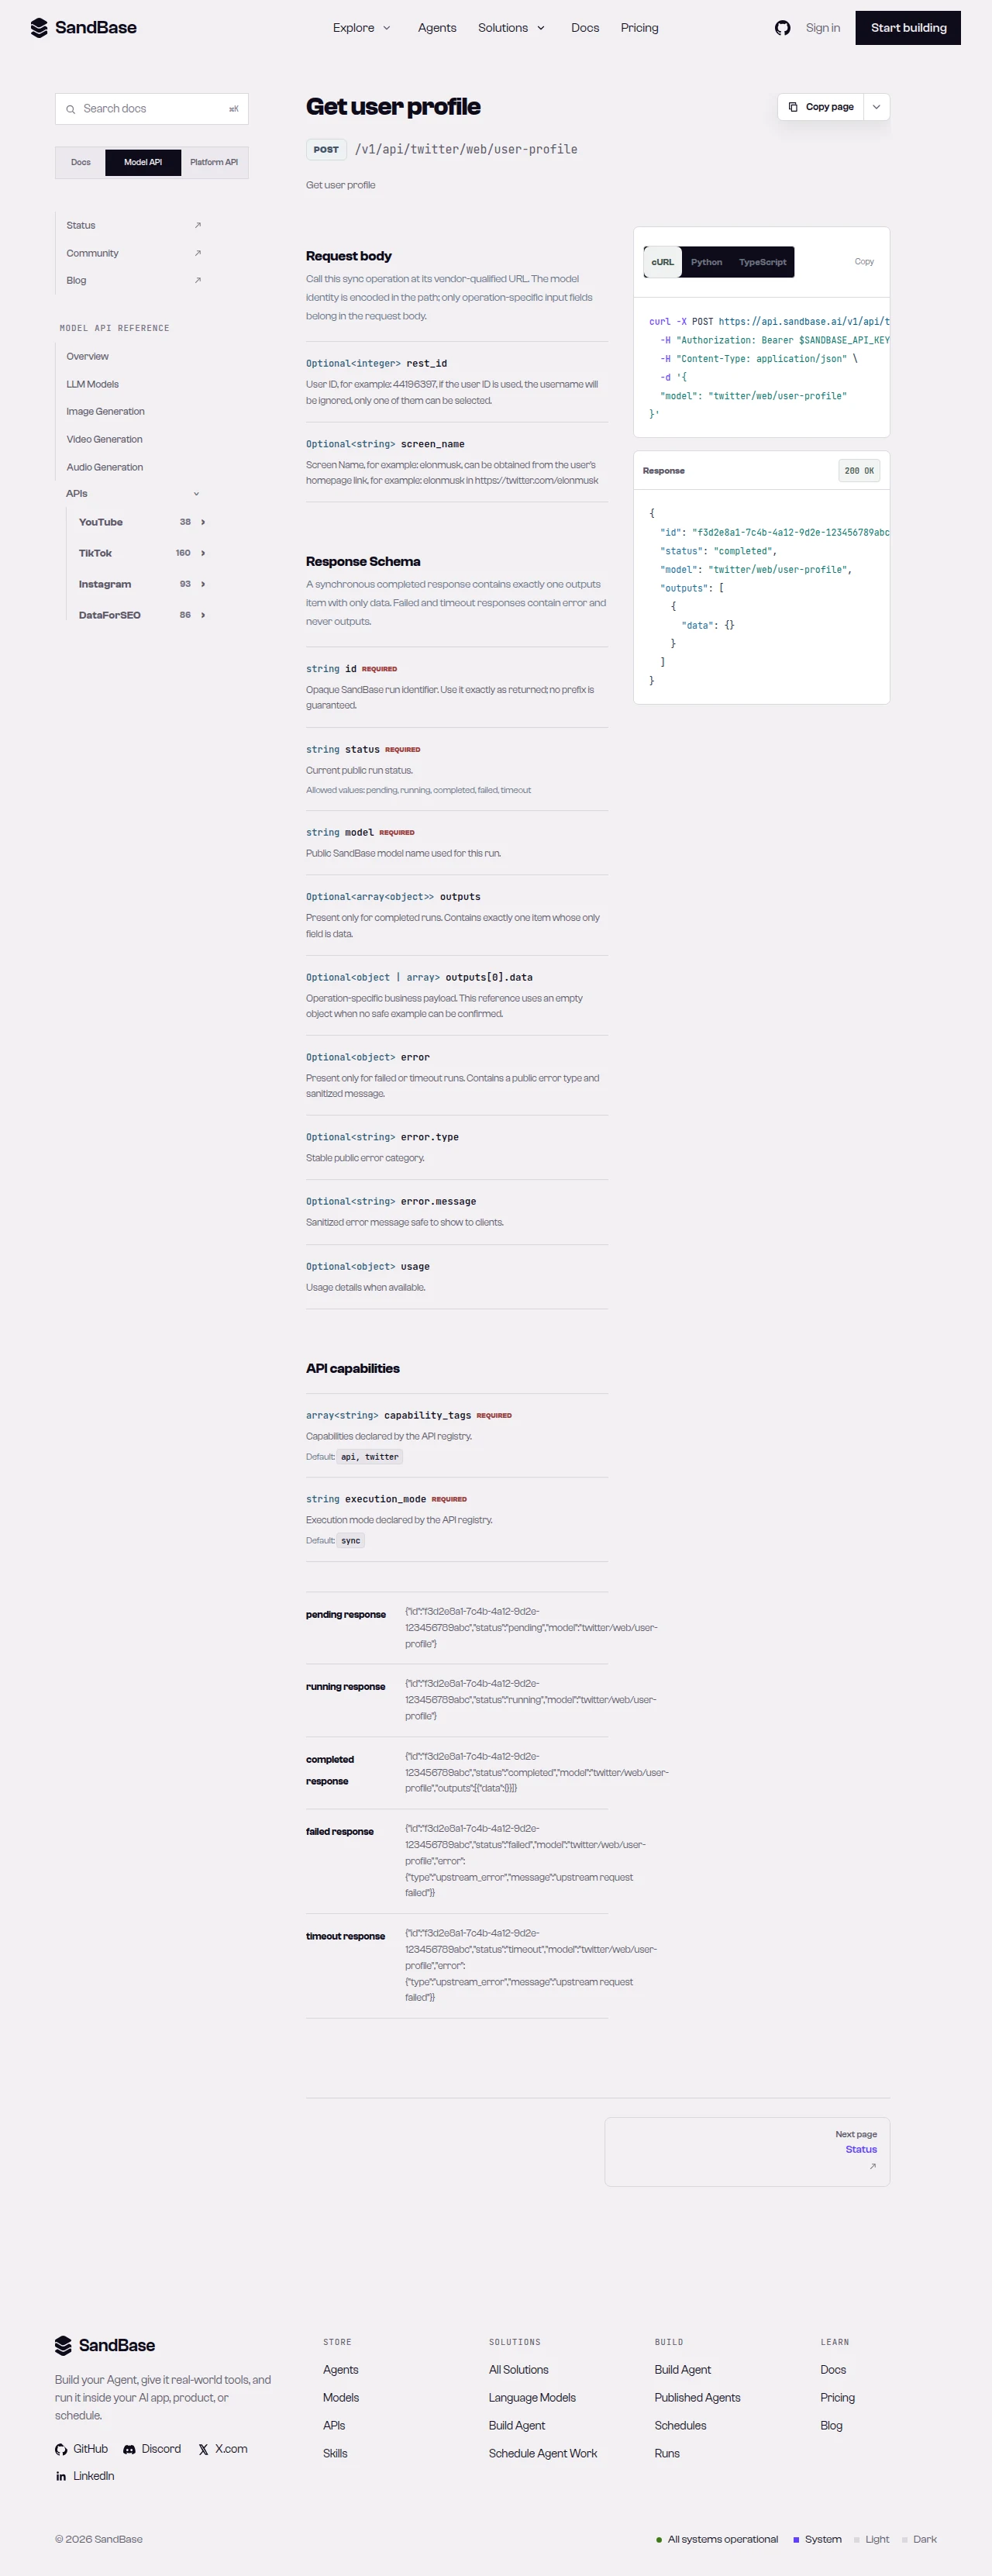 历史版本的 user-profile 参考截图,展示 screen_name 和 rest_id。当前界面和结构请以实时参考页为准。
把搜索与作者资料串起来
def research(keyword: str, max_authors: int = 5):
    data = call("twitter/web/search-timeline", {"keyword": keyword})
    tweets = data.get("timeline", [])
    seen, authors = set(), []
    for t in tweets:
        if len(authors) >= max_authors:
            break
        if not isinstance(t, dict):
            continue
        name = t.get("screen_name")
        if name and name not in seen:
            seen.add(name)
            profile = call("twitter/web/user-profile", {"screen_name": name})
            authors.append({"screen_name": name, "profile": profile})
    return {"tweets": tweets, "authors": authors}
两个端点都使用 HTTP 完成态返回结构,call(...) 统一检查运行状态和数据位置。搜索获得的 screen_name 再进入资料接口。max_authors 限制本轮资料调用次数;同一个作者只查一次,设为零时只返回搜索结果。
可以怎样使用结果
品牌与产品发布观察
按产品名或话题标签搜索,在限定预算内翻页,比较多次采样中新增的帖子。需要了解发言背景时再查作者。结果只能说明所采集样本中的变化,不能直接认定为全站提及量的变化。
竞品与创作者研究
收集相关帖子的作者账号,去重后查询资料,按实际返回的字段整理候选名单。本文示例打印的是关注数,并没有按粉丝数排名;如果需要排序,先确认目标字段的含义及是否缺失。
话题与情绪采样
有正文和互动数据时,可以将样本交给下游模型做分类。保留查询词、模式、采集时间和原帖链接,便于回看模型判断。单页搜索不构成完整舆情分析,也不能证明情绪分类准确。
实操要点
- 先设预算。 每次翻页和作者查询都会增加 API 调用。当前价格、免费额度及适用范围以端点页面为准,不把某次免费调用推广为永久免费。
- 区分帖子和作者。 按帖子 ID 去重统计内容,按账号去重限制资料查询。重复作者不等于重复帖子。
- 只读取公开内容。 本教程不涉及发帖、私信或需要账号授权的数据。
失败请求和不完整证据
运行状态为 completed 不代表结果完整或内容真实。搜索结果只是当前关键词和模式下的样本;文档示例可能经过裁剪,正文也可能需要回到原帖核查。不要据此声称已获得完整历史、全部讨论串或经验证的情绪结论。
请求失败时,检查 HTTP 状态和错误体,先核对鉴权、参数名及数据位置,保留诊断信息时不要泄露密钥。临时错误可以有限退避重试,但不应无限重试。解析失败不是“没有搜索结果”,应保留响应排查并明确报告限制。
常见问题
需要 Twitter/X 开发者账号或登录吗?
不需要。这个公开读取流程用 SANDBASE_API_KEY 向 SandBase 鉴权,不要求读者提供 X 登录或 OAuth。
怎样从帖子找到作者?
结果包含 screen_name 时,将它作为 screen_name 传给 user-profile。缺少账号的记录先跳过,不猜测作者。
怎样读取下一页?
把响应的 next_cursor 作为下一次请求的 cursor,保持关键词和搜索模式不变。再按前面的预算、重复游标、空页及去重规则决定是否继续。
能读取私有帖子或私信吗? 不能。这里讨论的是公开只读接口,不涵盖私有或账号授权内容。
下一步:核对搜索,再补作者背景
从一个关键词开始,检查返回结构并保存去重后的原帖链接,再决定是否扩大搜索。作者资料可以帮助理解账号背景,但不会替你核实帖子中的主张。更多端点见 Twitter 公开数据 API 汇总。
打开 Search API 参考和 Playground,核对当前参数、响应示例、价格和额度。
若想把独立脚本接入托管运行环境,可以进一步了解 SandBase Personal Agents,并查看 Session 和 MCP 配置要求。本文没有演示创建托管 Agent 或完成 Agent Session。相关英文指南集中在 Research Agents & Search APIs 主题页。
觉得有用?分享给更多人