用一个 API 做 B 站创作者调研:一套实用工作流 | SandBase
搭一套 B 站创作者调研工作流:读趋势、搜话题、给创作者建档——一把 SandBase key,不用 B 站登录。
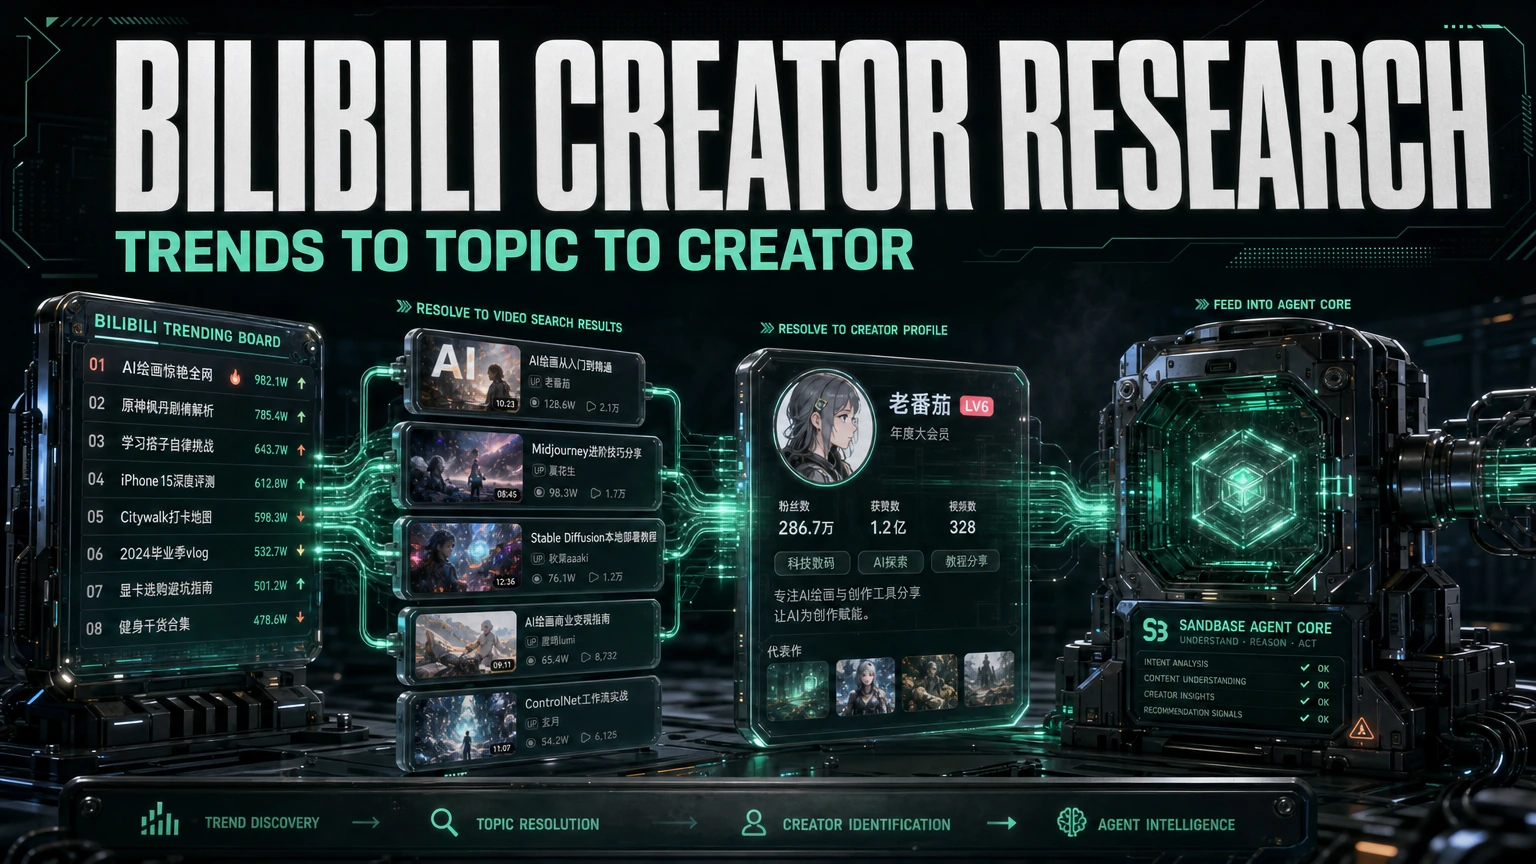
在 B 站做创作者调研,归根到底是三个动作:看什么在热、搜一个话题的视频和创作者、给内容背后的创作者建档。这篇教程用 SandBase B 站 API 把这三个动作串成一套 B 站创作者调研工作流——不用 B 站登录,不用爬虫。端点 API 参考是每个参数和响应信封的权威来源;下面展示的业务载荷字段名只是一个示例结构、并非保证的 schema,请以你所调端点的一份真实响应为准核对。
如果你想先看完整的端点全景,从 B 站公开数据 API hub 开始。这一篇是落地的工作流。
先说结论
- 三步:
hot-search(趋势)→search-all(话题)→user-profile(创作者)。- 每次都是
POST /v1/api/bilibili/<path>,一把SANDBASE_API_KEY;响应共用{ id, status, model, outputs }信封。- B 站端点把载荷包在一个上游的
{ code, data, message }对象里,所以有用的字段在data.data下。- 只是公开、只读数据,你这边也不能发帖。这个公开数据流程不需要 Bilibili 登录或 OAuth,但仍需要一把 SandBase API key。
工作流全貌
| 步骤 | 端点 | 输入 | 你拿到 |
|---|---|---|---|
| 1. 读趋势 | bilibili/web/hot-search | 必填 limit(整数) | 排名的热门关键词列表 |
| 2. 搜话题 | bilibili/app/search-all | keyword | 匹配的视频和创作者 |
| 3. 给创作者建档 | bilibili/web/user-profile | uid | 昵称、等级、签名 |
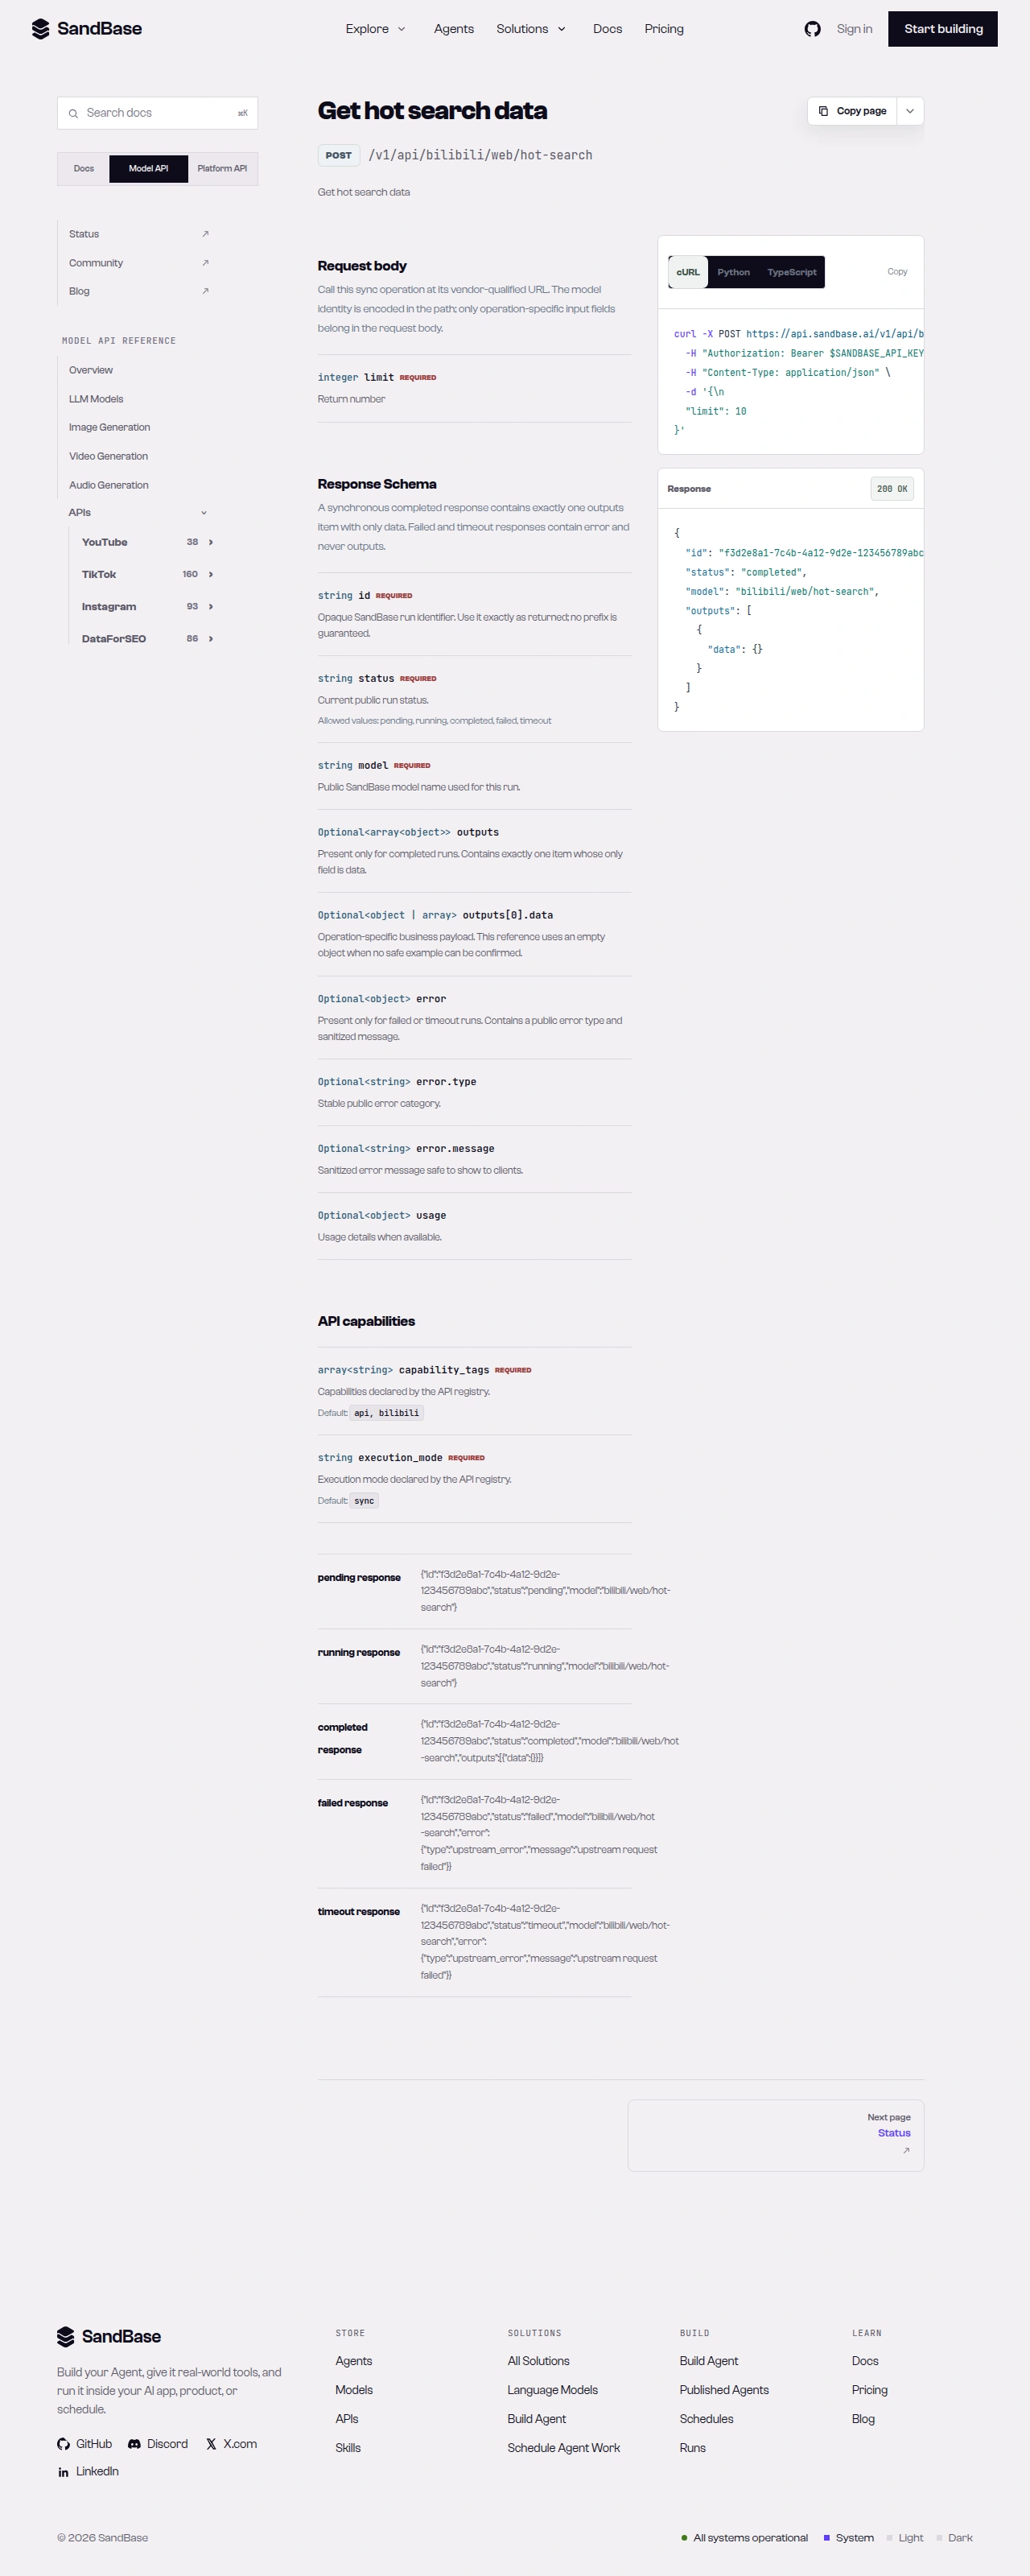 端点的 API 参考是每个参数名和响应路径的权威来源。
第 1 步 —— 读趋势榜
先写一个判 status 并解包上游 data 的帮助函数,再读热搜榜:
import os
import requests

BASE = "https://api.sandbase.ai/v1/api/bilibili"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}


def call(path: str, payload: dict) -> dict:
    resp = requests.post(f"{BASE}/{path}", headers=HEADERS, json=payload, timeout=90)
    resp.raise_for_status()
    body = resp.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error", {}).get("message", "request did not complete"))
    # 参考只保证信封,业务字段随端点而定,以真实响应为准;
    # 因此防御式解包。
    data = body["outputs"][0]["data"]
    # B 站把载荷包在一个上游 { code, data, message } 对象里
    return data.get("data", {})


trending = call("web/hot-search", {"limit": 10}).get("trending", {}).get("list", [])
for item in trending[:5]:
    print(item.get("keyword"), item.get("heat_score"))
每一项带一个关键词和一个热度分。字段名并非保证的 schema——以一份真实响应为准核对,因为榜单一直在变。
第 2 步 —— 搜一个话题
挑一个关键词,拉匹配的视频和创作者。search-all 接一个 keyword,在 data.item 下返回一个列表:
results = call("app/search-all", {"keyword": trending[0].get("keyword")})
# 参考只保证信封,业务字段随端点而定,以真实响应为准;因此用 .get() 取值
items = results.get("item", [])
# 每一项带一个 goto/type、一个 uri 和作者信息;
# 读 schema 并看一份真实响应,对准你需要的字段
print(len(items), "results")
search-all 的响应把列表嵌在 data.item 下,并带一个 pagination 块用于下一页。迭代之前先看一份真实响应,弄清视频 id 和创作者 id 各自在哪。
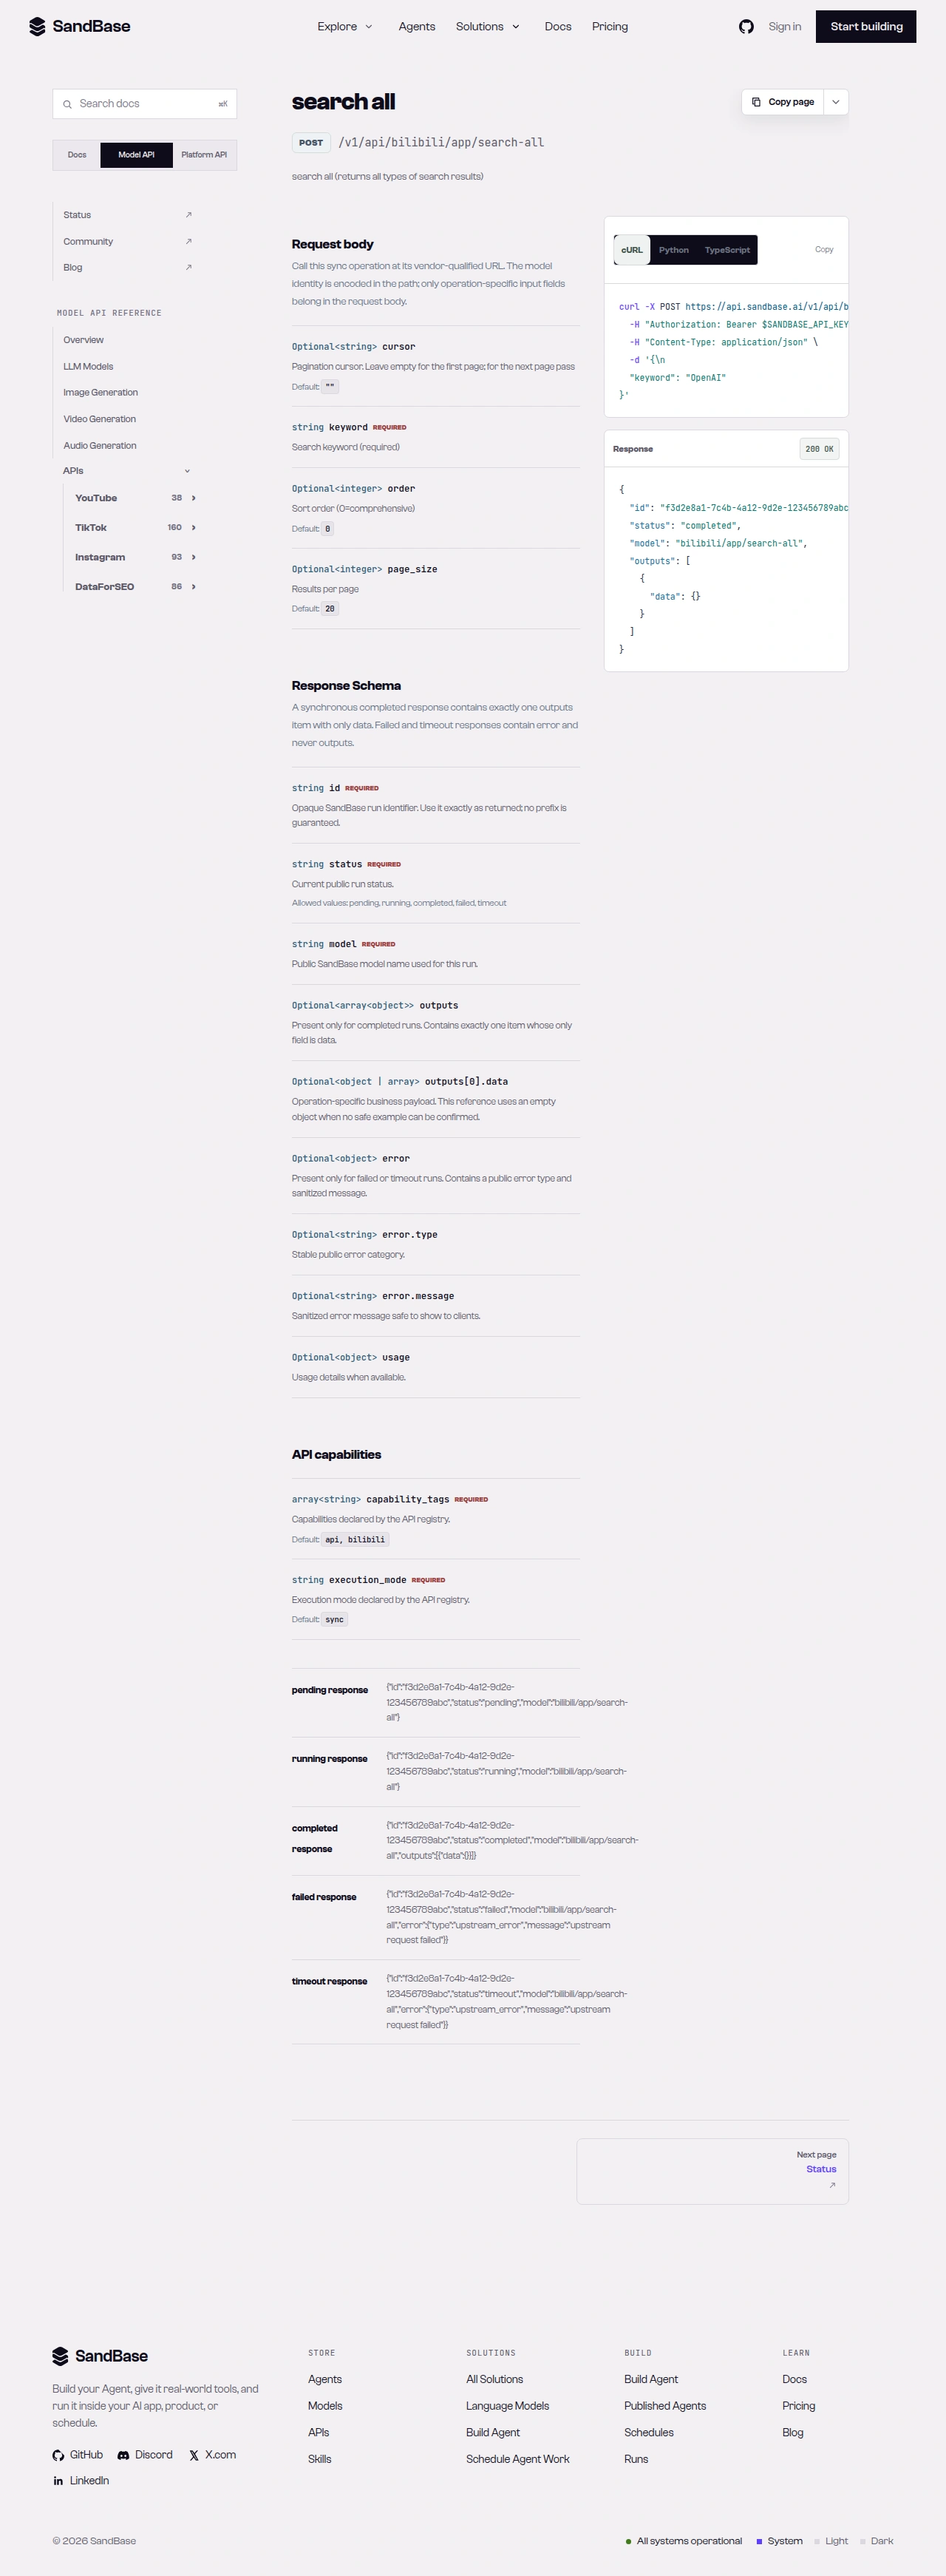 search-all 在 data.item 下返回一个列表——迭代前先读 schema。
第 3 步 —— 给创作者建档
对你在第 2 步浮现出的一个创作者 id(uid),附上账号上下文。user-profile 接一个 uid:
creator = call("web/user-profile", {"uid": "946974"})
# 参考只保证信封,业务字段随端点而定,以真实响应为准;因此用 .get() 取值
print(creator.get("name"), creator.get("level"))
资料读取返回像 name、level、sign 和 sex 这样的字段。下面是一个示例响应结构——字段名并非保证的 schema,请把字段名和数值当作示例,以一份真实响应为准核对:
{
  "id": "cbc4c9c1-84e7-4ea6-9e3f-f5e759c11475",
  "status": "completed",
  "model": "bilibili/web/user-profile",
  "outputs": [
    {
      "data": {
        "code": 0,
        "data": { "mid": "946974", "name": "…", "level": 6, "sign": "…" }
      }
    }
  ]
}注意双层嵌套:outputs[0].data 是 SandBase 信封载荷,而有用的资料在它内层的 data 下。上面的 call 帮助函数已经帮你解开一层。
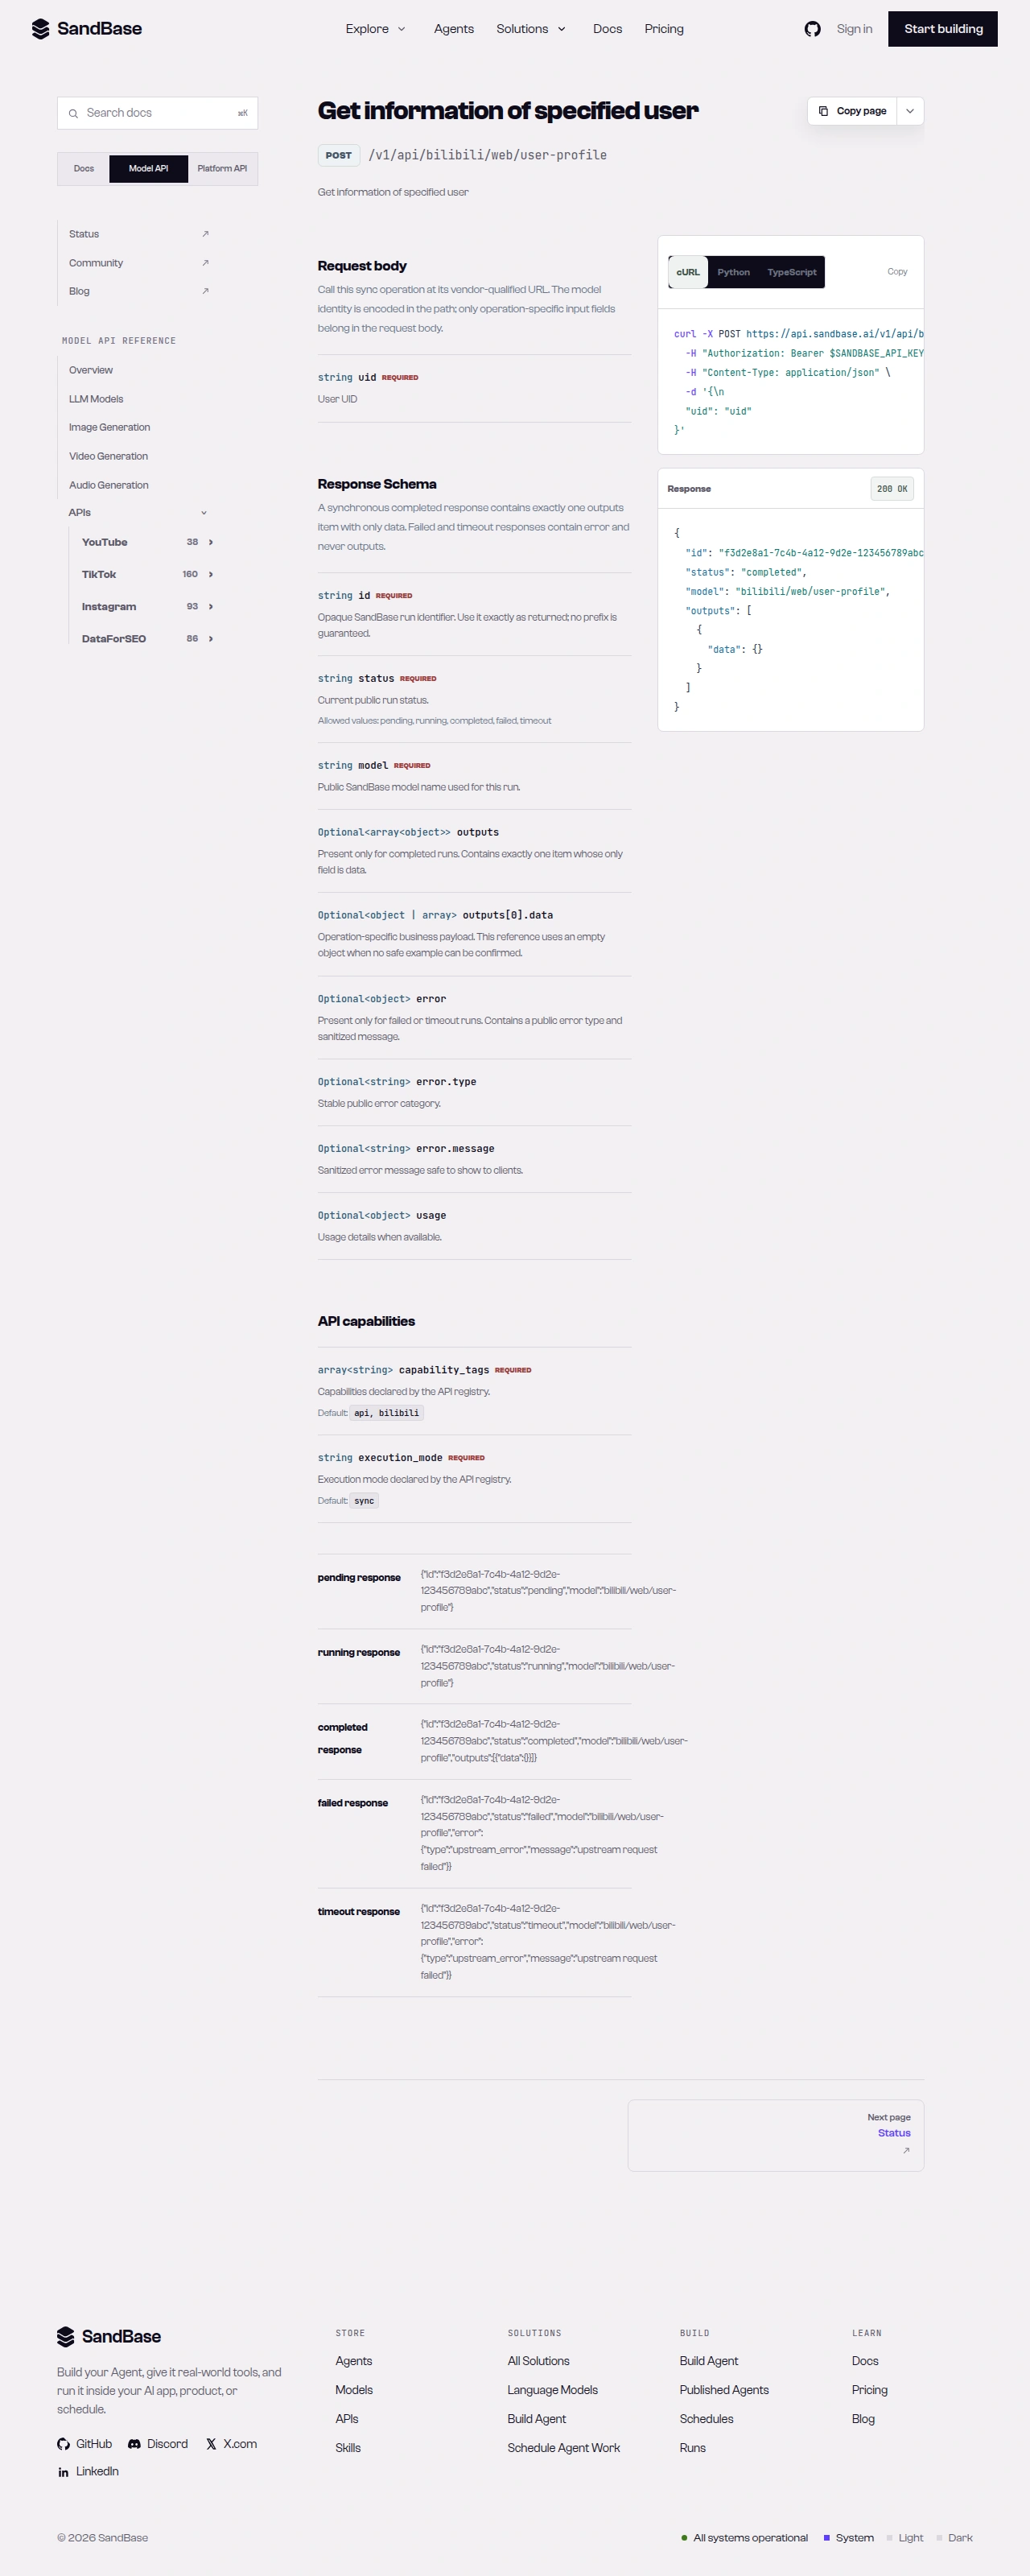 user-profile 在上游 data 对象下返回昵称、等级和签名。
把它串起来
一次最小的创作者调研过程长这样:
# 参考只保证信封,业务字段随端点而定,以真实响应为准;因此用 .get() 取值
trending = call("web/hot-search", {"limit": 10}).get("trending", {}).get("list", [])
report = []

for topic in trending[:10]:
    hits = call("app/search-all", {"keyword": topic.get("keyword")})
    report.append({
        "topic": topic.get("keyword"),
        "heat": topic.get("heat_score"),
        "result_count": len(hits.get("item", [])),
    })
    # 对你从 hits 里提取的创作者 uid,按 schema 调 user-profile
因为每次调用共用同一个信封和同一个 call 帮助函数(包括 data.data 的解包),加重试或速率退避是一处改动的事。当你需要的不止这些读取时,查线上 B 站列表找到合适的端点,接入前先确认它的参数。
处理粗糙的边角
- 注意双层嵌套。 B 站透传一个上游
{ code, data, message }对象,所以有用的载荷在data.data下。在帮助函数里解开一层。 - 迭代前先看
search-all。 它的列表在data.item下,是结构化的,不是扁平的——从真实响应里对准字段,用它的pagination块翻页。 - 对
status分支。failed或timeout的请求带error而没有outputs。call帮助函数已经强制这一点。 - 尊重速率限制。 作为客户端韧性措施,遇到 HTTP 429 这类瞬时错误时用退避重试。
- 只是公开数据。 不登录、不发帖,也拿不到私密/仅账号可见的内容。
组合这套工作流
同样的统一信封让它可组合。把趋势关键词换成任意话题,再加第四次读取——比如某个视频的评论——它就用同一个 call 帮助函数、同一套判状态和解包接进来。你也可以把中间那步铺开:对前 N 个趋势关键词,各跑一次 search-all,把数量收进一张表,这样一次过程就给你一份”什么在热、每个话题承载多少内容”的排名快照。因为这些读取共用一种结构,从一个快速脚本走到一个定时任务,基本上只是加个退避和一个存每轮结果的地方。
为什么在 API 层做这件事
你当然可以在浏览器里打开 B 站手动抄数字,但那不 scale,也给不了你可以做趋势的结构化数据。把这三次调用排成定时任务,就把定性的浏览变成了可度量的信号:能逐时画图的热度分、能去重的话题、以及能按等级和粉丝量加权的创作者。因为调用返回的是命名的 JSON 字段(在一次一致的解包之后),每一轮都能干净地落进一张表,再和上一轮做 diff——新的趋势话题、某个关键词上新冒出的创作者,以及平台在看什么的变化。
常见问题
我需要 B 站登录或 OAuth 吗?
不需要。你用自己的 SANDBASE_API_KEY 向 SandBase 鉴权,这三次读取都不需要你这边有 B 站账号或 OAuth。调用它们时你仍然要提供一把 SandBase API key。
为什么 hot-search 要传 limit,又要解包 data.data?
hot-search 用一个 limit 参数决定返回多少条趋势项,所以要显式传。而因为 B 站透传一个上游 { code, data, message } 对象,有用的载荷在 data.data 下——在你的 call 帮助函数里解开这一层。两者都以端点参考为准核对。
search-all 的结果怎么翻页?
下一次调用时带上 search-all 接受的分页请求参数,不要假设固定的每页大小。具体参数名以端点参考为准,迭代前先对着一份真实响应核对。
下一步
你现在有了一套可复用的创作者调研工作流,建立在三次公开、只读的调用上。