跨平台选品 Agent:TikTok Shop、小红书、抖音一次查清
用 Python 写一个跨平台选品 Agent:同一个商品词,查 TikTok Shop 商品、小红书笔记和商品、抖音视频,统计在代码里算,GPT-6.1 Sol 只负责写一页选品简报。
第一次跑「portable blender / 便携榨汁杯」这组简报,TikTok Shop 搜 portable blender 只回了 10 个商品,个个有销量,前三名占了 96% 的销量。看上去像是被几家卖家垄断的赛道。可同一个请求重试一次,就回了 30 个完全不同的商品,还带翻页 token;拉满两页 60 个商品后,前三名的份额其实是 65% 左右。第一次那 10 个只是个「兜底短列表」,不是市场本身。
这篇教程做的是一个跨平台选品 Agent:输入一个商品词,它去 TikTok Shop 看商品(价格、销量、评分),去小红书看笔记和商城商品,再去抖音看视频,每个平台导出一份 CSV,最后让 LLM 根据代码算好的数字写一页选品简报。适合要在备货、上新之前先看证据的卖家和 Agent 开发者。实际做下来,大部分功夫花在识别第一次那种「坏样本」上。
先说结论
- 一把 SandBase API Key 搞定五个数据端点:TikTok Shop 搜索和商品详情、小红书笔记搜索和商品搜索、抖音视频搜索。2026-10-03 这五个端点在目录里都标为 Free。
- 计数、中位数全在 Python 里算。
openai/gpt-6.1-sol只写文字,另有一段检查会把文字里不在统计结果中的数字挑出来。六份简报每份输入 284~290 token、输出 269~485 token,约 $0.003~$0.005 一份。- 最后一轮测试里,TikTok Shop 搜索 21 次调用有 10 次回的是兜底短列表(5 或 10 个商品,
has_more: false)。代码会重试,并且绝不把它混进完整的一页里;如果重试全都是短列表,简报就只能基于短列表,同时提示 LLM 把不足 30 的样本标为「样本偏少」。- 小红书的中位数在相隔几分钟的几次运行之间波动很大(同一个词 160.5~354)。一次运行只是一个样本,别当测量值用。
简报里有什么
本文查的是 TikTok Shop 美国站,所以这一侧用英文词搜;小红书和抖音用中文词。我测了两组:「portable blender / 便携榨汁杯」和「sunscreen / 防晒霜」。两种语言的词搜出来的不是同一批商品,所以跨平台只比「形状」(集中度、价格带、互动量级),不比绝对总数。
| 信号 | 端点 | 代码算什么 |
|---|---|---|
| 商品、价格、销量、评分 | tiktok/shop-web/search-products-list | 有销量的商品数、价格中位数、总销量、前三名销量占比、有评价商品的评分中位数 |
| 销冠的星级分布 | tiktok/shop-web/product-detail-v2 | 1、2 星评价占比 |
| 相关笔记 | xiaohongshu/app-v2/search-notes | 笔记数、点赞+收藏+评论中位数、收藏中位数、近 90 天笔记数、视频笔记数 |
| 小红书商城商品 | xiaohongshu/app-v2/search-products | 商品卡数量、标价中位数 |
| 短视频 | douyin/search/video-search-v2 | 视频数、点赞中位数、点赞+收藏+评论+分享中位数、近 90 天视频数 |
| 文字简报 | openai/gpt-6.1-sol,走 /v1/chat/completions | 120~180 词,只用算好的数字 |
正式运行中每次发 11~13 个 HTTP 请求,墙钟时间 55 秒左右。
数据边界
这里用的是公开、只读数据,需要一把 SandBase API Key。SandBase 不是 TikTok、小红书或抖音的官方合作方。不碰私密账号、私信、商家后台数据、订单,也不做任何账号操作。CSV 里只留笔记和视频的 id 与计数,不存作者和正文。
| 需求 | 用什么 |
|---|---|
| 上新前调研公开商品、笔记、视频 | SandBase 公开数据端点(本文) |
| 自己店铺的订单、库存、广告 | TikTok Shop Partner Center |
| 自己的小红书账号或店铺 | 小红书开放平台 |
| 自己的抖音账号数据 | 抖音开放平台 |
哪些端点靠得住
候选端点在 SandBase registry 里都是启用状态,2026-10-03(UTC)实测都能跑通:
| 端点 | 实测情况 | 是否采用 |
|---|---|---|
tiktok/shop-web/search-products-list | 完整页 30 个商品,带 has_more 和 page_token;但经常回兜底短列表 | 用,加重试 |
tiktok/shop-web/product-detail(v1) | 能完成,但 global_data.product_info 只有空的 seller_id,没有评分 | 不用 |
tiktok/shop-web/product-detail-v2 | 有星级分布和类目路径;偶发 HTTP 503 + upstream error 400 | 用,可选 |
xiaohongshu/app-v2/search-notes | 每页 20 条笔记,带计数和时间戳 | 用 |
xiaohongshu/app-v2/search-products | 每次 20 张卡,其中 18~19 张是带 price_info 的商品卡 | 用 |
douyin/search/video-search-v2 | 每页 7~8 张卡,每个视频带 statistics | 用 |
说下商品详情的失败。之前有测试提过这个接口会报「region mismatch」,我一次也没见到这句话。我见到的是:同一个美区商品 id,有时成功,有时回 HTTP 503 和 upstream error 400。当天大约 20 次练习运行里,有 4 次重试三遍后放弃了星级分布;最后正式的 6 次全部成功。所以代码把它当可选项,失败了简报里就不出现星级字段。还有一种「区域」问题容易跟它混淆:同一个商品传 region: "GB"(c0788442-4d80-49e6-92fc-a1f69ac2d21c),返回的是 completed,但带着 region_supported: false 和 supported_regions(ID、JP、MX、MY、PH、SG、TH、US、VN),尽管参考页列了 GB。代码只用 US;要换区域,先看 region_supported。
搜索接口的参考页写明 search_word 必填,另有 offset、page_token 和 region(默认 US):
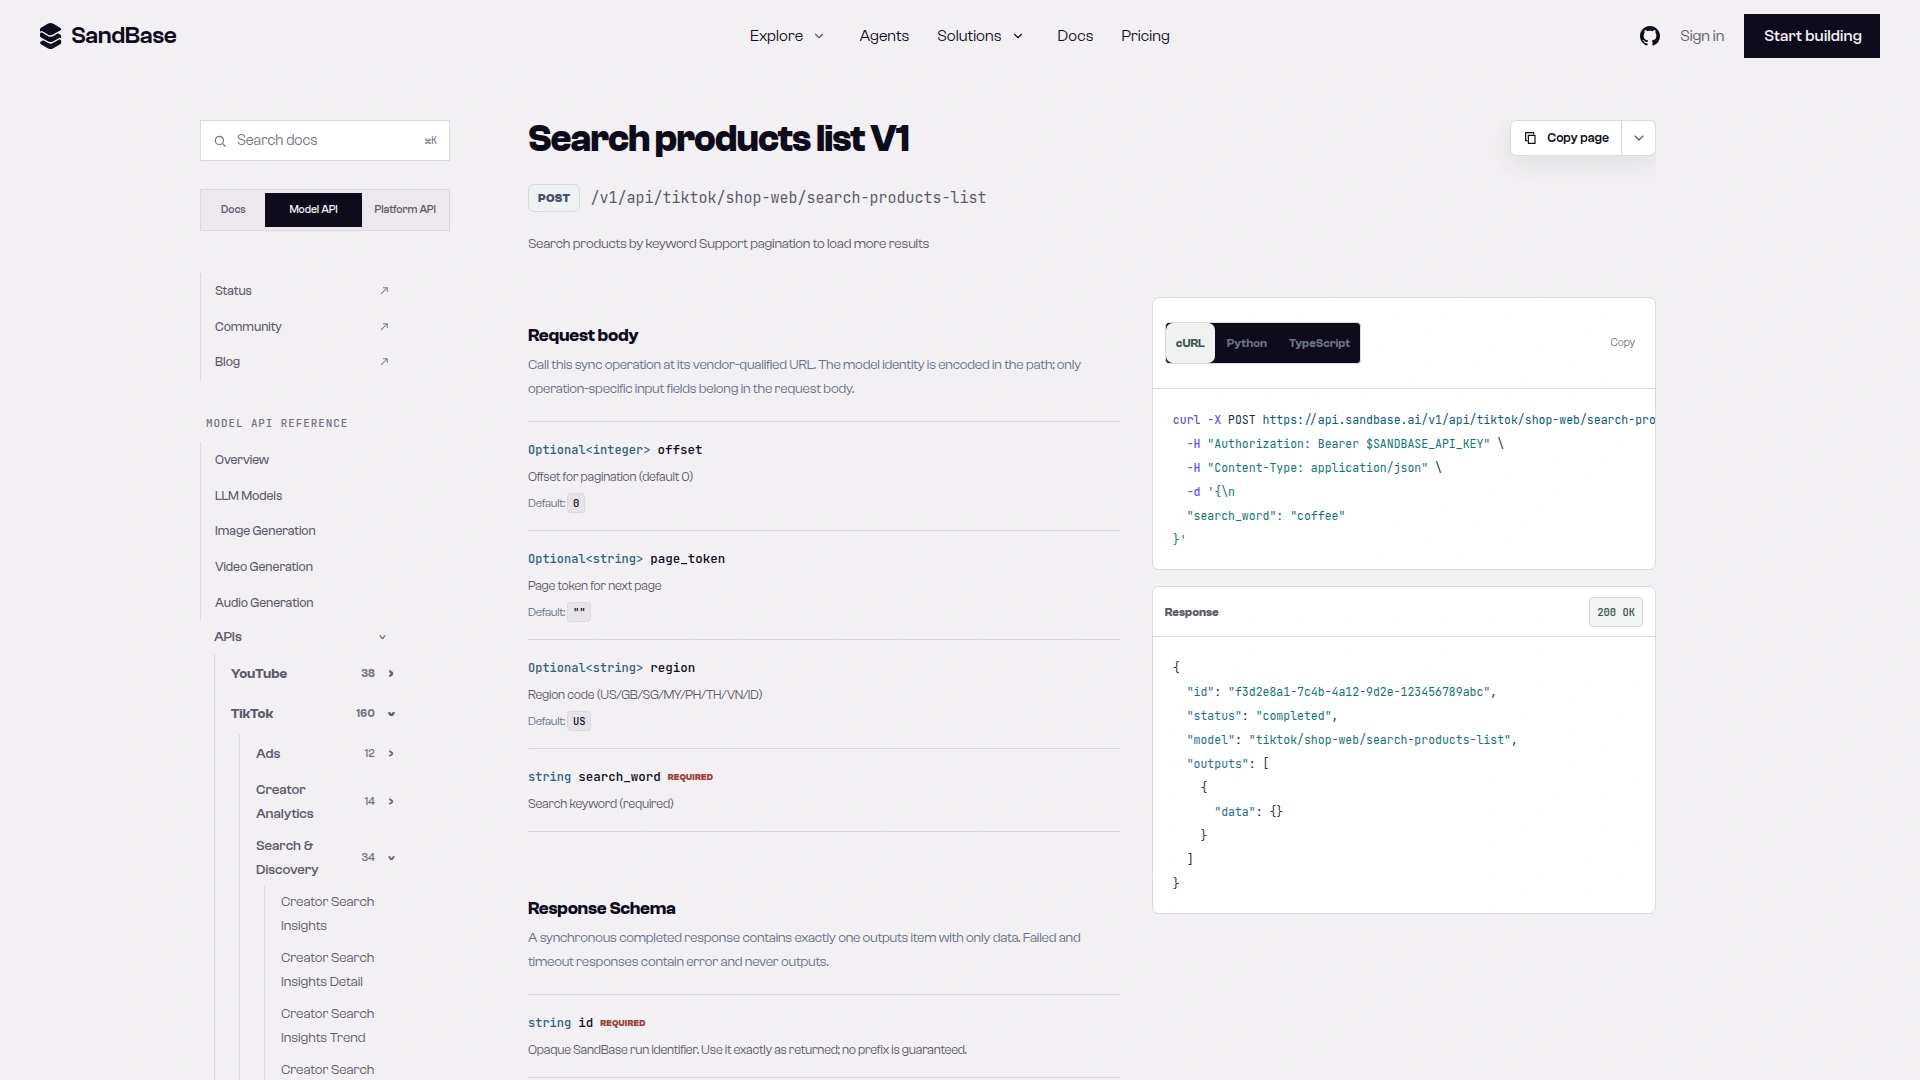 截图:search-products-list 参考页给出 POST 路由和 Agent 发送的四个字段;示例里 outputs[0].data 是空对象,所以下文的字段都来自实测调用(2026-10-03 截取)。
实测记录:2026-10-03(UTC)
输入就是上面两组通用商品词,TikTok 区域为 US。每个请求都是 POST https://api.sandbase.ai/v1/api/<vendor>/<path>,带 Authorization: Bearer $SANDBASE_API_KEY,JSON body 只放该端点自己的字段,程序只读 outputs[0].data。下面出现的业务字段名都来自这些调用,属于实测观察,不是文档保证,所以代码一律用 .get() 读。
curl -s https://api.sandbase.ai/v1/api/tiktok/shop-web/search-products-list \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"search_word": "portable blender", "region": "US", "offset": 0, "page_token": ""}'某次运行的第一次调用(788a0b0d-6927-4c25-9bac-0046471254fb)回的是短列表,重试(02a0296a-504e-4aeb-916d-93ba80a96a49)拿到完整页。截短后保留一张品牌自营商品卡:
{"code": 0, "message": "success", "data": {
  "has_more": true,
  "load_more_params": {"api_source": 2, "offset": 30, "page_token": "20261003043528F72A01878A90B7109715"},
  "products": [{
    "product_id": "1732254901028033219",
    "brand_info": {"brand_name": "ZHENMI"},
    "sold_info": {"sold_count": 24647},
    "rate_info": {"review_count": "2394", "score": 4.1},
    "product_price_info": {"currency_name": "USD", "sale_price_decimal": "32.99", "origin_price_decimal": "99.99"}
}]}}短列表长这样:products 只有 10 个,has_more: false,load_more_params 里 offset: 0、page_token 为空。不管我传什么 offset 和 token,这个词每次回的都是同样 10 个商品 id(防晒霜则固定是 5 个)。代码就靠这个特征识别它。
product-detail-v2 传 {"product_id": "1731581114818794403", "region": "US"}(f5d014ea-b8bb-494a-8c64-c505b58eb6d9),返回一个 components_map 列表,其中 product_info 组件里有:
{"reviews_info": {"review_ratings": {"overall_score": 4.3, "review_count": "12280",
  "rating_result": {"1": "1355", "2": "348", "3": "619", "4": "1086", "5": "8872"}}}}
bread_crumbs 组件是 TikTok Shop、Household Appliances、Kitchen Appliances、Juicers & Blenders。整个响应约 487 KB,代码只留星级分布。
search-notes 传 {"keyword": "便携榨汁杯", "page": 1, "search_id": "", "search_session_id": ""}(ace7c7d1-cf41-4638-8088-fca7eea678ba),search_id 和 search_session_id 跟 data 平级返回,data.items[].note 有 20 条。去掉 id、正文和时间戳后的一条:
{"type": "video", "liked_count": 2885, "collected_count": 5744, "comments_count": 20,
 "shared_count": 600, "timestamp": "<unix 秒级时间戳,已隐去>"}
把这两个 id 带回去请求 page: 2,探测时拿到了 20 条新笔记;不带的话第 2 页会和第 1 页重叠。即使带上,两页有时也只有 30~35 条不重复的笔记,所以代码按 id 去重。
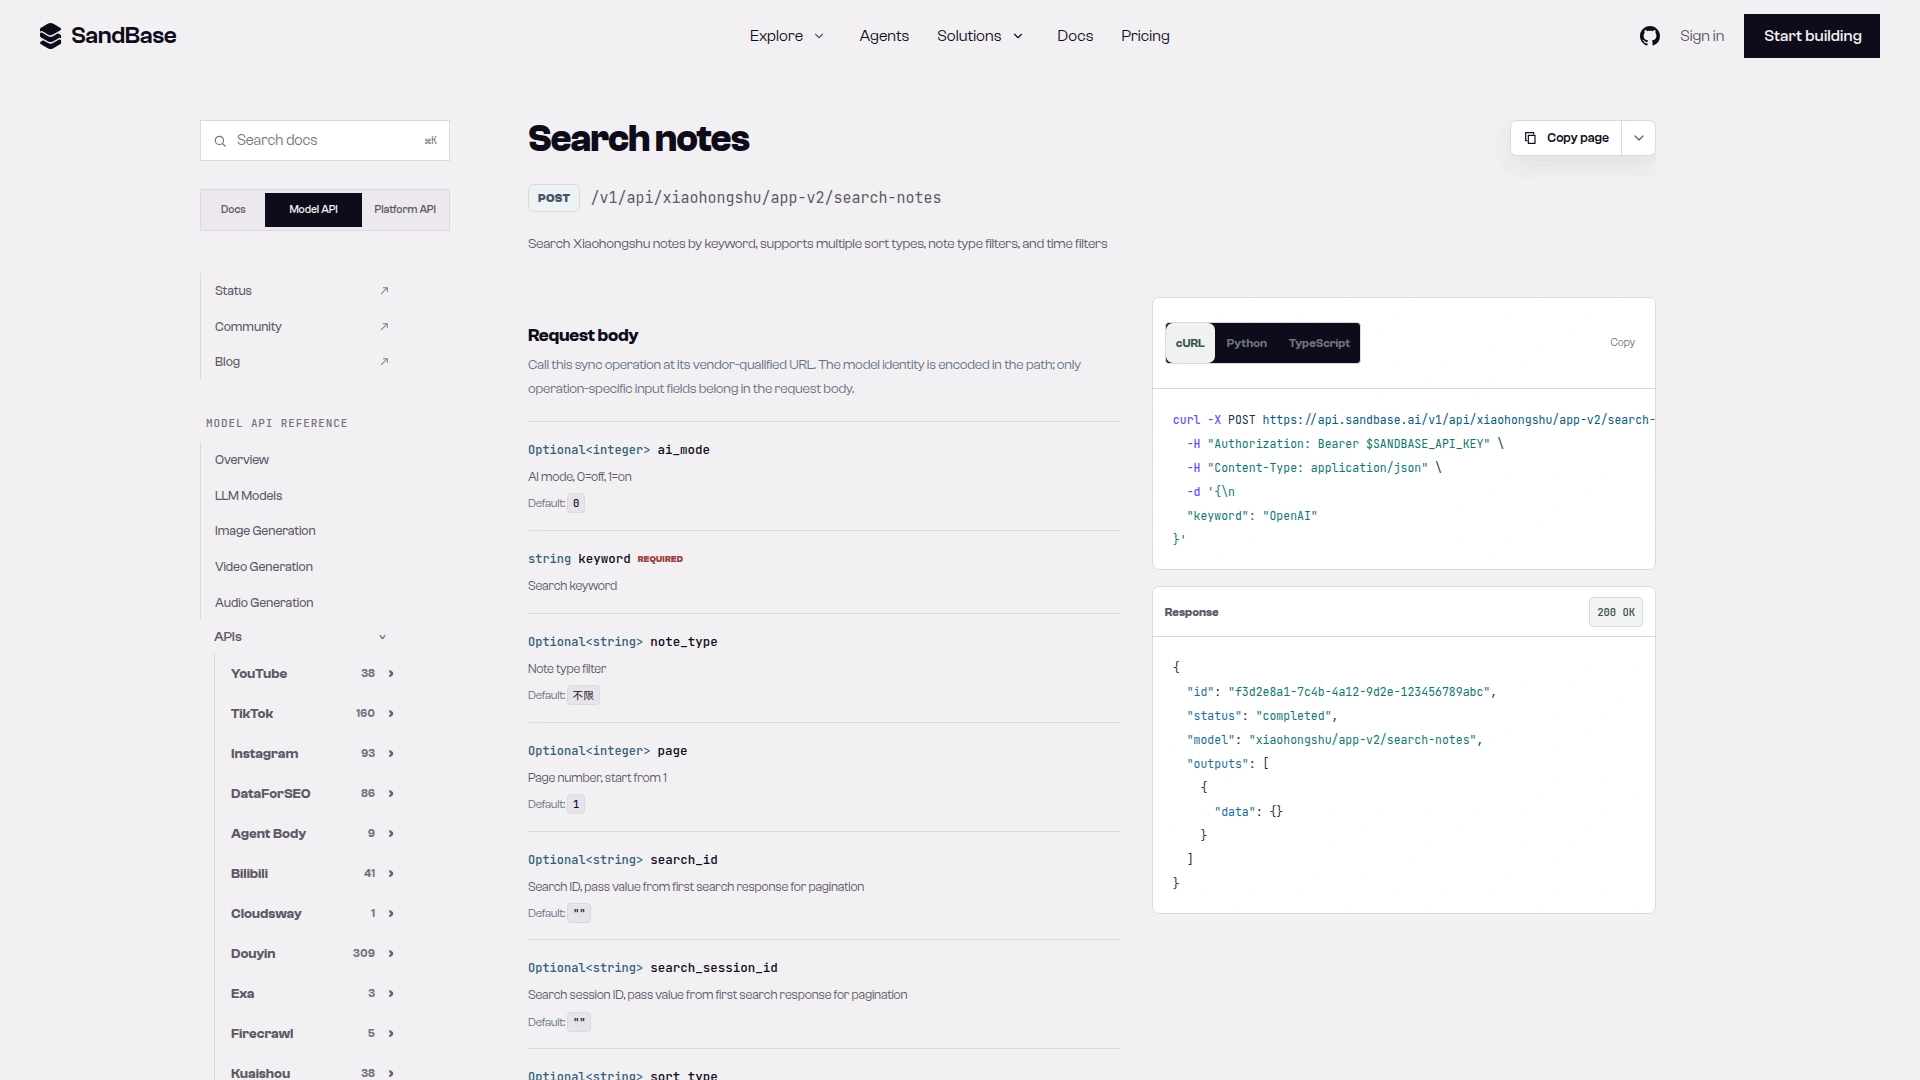 截图:search-notes 参考页写明 page,以及要从首次响应里取回的 search_id 和 search_session_id,Agent 翻第 2 页就是这么传的(2026-10-03 截取)。
search-products 传 {"keyword": "便携榨汁杯"}(0922a59c-2179-48af-a249-4395c022e7e3),卡片在 data.module.data 下,20 张里 19 张的 card_name 是 cosmos_search_goods_card。一张品牌商品卡:
{"title": "小米·米家随行便携榨汁杯2 家用小型多功能水果奶昔电动搅拌果汁机",
 "price_info": {"price": 89.9, "origin_price": 89.9, "foreign_price": "≈$13.57", "symbol": "$"}}
price 看起来是人民币。foreign_price 是换算值,币种在几次运行里变过(一次英镑,一次美元),代码不用它。销量只以「12k+ sold」这样的文字标签出现,我也没算。
video-search-v2 传 {"keyword": "便携榨汁杯", "cursor": 0}(65d1a688-2f06-4401-8744-619eb8894eda),数据直接放在 outputs[0].data 里,没有另外四个端点那层 code/data 包装。business_config.has_more 为 1,business_config.next_page 里有 cursor: 8 和 search_id,翻页还要带上 business_config.backtrace。8 张卡里 7 张是视频,1 张是相关搜索。一个视频的统计:
{"digg_count": 233, "comment_count": 61, "share_count": 122, "collect_count": 54, "play_count": 0}我看过的每张卡 play_count 都是 0,所以简报不用播放量。
完整代码
单文件,200 行左右,只依赖标准库和 requests。运行:python3 product_brief.py "portable blender" "便携榨汁杯"。
#!/usr/bin/env python3
"""Cross-platform product research brief: TikTok Shop + Xiaohongshu + Douyin for one product.

Usage: python3 product_brief.py "portable blender" "便携榨汁杯"
Writes tiktok_shop.csv, xiaohongshu_notes.csv, douyin_videos.csv and brief.md.
"""
import csv
import json
import os
import re
import sys
import time
from statistics import median

import requests

BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
NOW = time.time()


def call(model: str, params: dict, retries: int = 2) -> dict:
    """POST /v1/api/<model>; return outputs[0].data or raise with status/error."""
    for attempt in range(retries + 1):
        try:
            resp = requests.post(f"{BASE}/api/{model}", headers=HEADERS, json=params, timeout=120)
            body = resp.json()
        except requests.RequestException as err:  # dropped connection or truncated body
            if attempt == retries:
                raise RuntimeError(f"{model}: {err}") from err
            time.sleep(3 * (attempt + 1))
            continue
        if resp.status_code >= 500 and attempt < retries:
            time.sleep(3 * (attempt + 1))  # upstream hiccup: back off, then retry
            continue
        outputs = body.get("outputs") or []
        if resp.status_code != 200 or body.get("status") != "completed" or not outputs:
            raise RuntimeError(f"{model}: HTTP {resp.status_code} {body.get('status')} {body.get('error')}")
        return outputs[0].get("data") or {}
    raise RuntimeError(f"{model}: retries exhausted")


def num(x) -> float:
    """Counts arrive as ints or numeric strings; anything else counts as 0."""
    try:
        return float(x)
    except (TypeError, ValueError):
        return 0.0


def med(values):
    values = [v for v in values if v is not None]
    return round(median(values), 2) if values else None


def tiktok_shop(keyword: str, pages: int = 2, region: str = "US") -> list[dict]:
    rows, offset, token = [], 0, ""
    for _ in range(pages):
        for _attempt in range(4):  # a short fallback set (has_more false) comes back often; retry it
            data = call("tiktok/shop-web/search-products-list",
                        {"search_word": keyword, "region": region, "offset": offset, "page_token": token})
            page = data.get("data") or {}
            if page.get("has_more"):
                break
            time.sleep(2)
        if rows and not page.get("has_more"):
            break  # don't mix the fallback set into a full first page
        for p in page.get("products") or []:
            price = p.get("product_price_info") or {}
            rate = p.get("rate_info") or {}
            rows.append({"product_id": p.get("product_id"), "title": (p.get("title") or "")[:80],
                         "brand": (p.get("brand_info") or {}).get("brand_name") or "",
                         "price": num(price.get("sale_price_decimal")), "currency": price.get("currency_name"),
                         "sold": int(num((p.get("sold_info") or {}).get("sold_count"))),
                         "rating": num(rate.get("score")), "reviews": int(num(rate.get("review_count")))})
        more = page.get("load_more_params") or {}
        if not page.get("has_more") or not more.get("page_token"):
            break
        offset, token = more.get("offset", offset + 30), more["page_token"]
    return rows


def tiktok_star_mix(product_id: str, region: str = "US") -> dict:
    """Star histogram of one listing from product-detail-v2; returns {} if the call fails."""
    try:
        data = call("tiktok/shop-web/product-detail-v2", {"product_id": product_id, "region": region})
    except RuntimeError as err:
        print(f"  product-detail-v2 skipped: {err}")
        return {}
    comps = {c.get("component_name"): c.get("component_data") or {}
             for c in (data.get("data") or {}).get("components_map") or [] if isinstance(c, dict)}
    hist = ((comps.get("product_info") or {}).get("reviews_info") or {}).get("review_ratings", {}).get("rating_result") or {}
    total = sum(num(v) for v in hist.values())
    low = num(hist.get("1")) + num(hist.get("2"))
    return {"top_listing_star_reviews": int(total),
            "top_listing_low_star_share": round(low / total, 3) if total else None}


def xhs_notes(keyword: str, pages: int = 2) -> list[dict]:
    rows, ids = [], {"search_id": "", "search_session_id": ""}
    for page in range(1, pages + 1):
        data = call("xiaohongshu/app-v2/search-notes", {"keyword": keyword, "page": page, **ids})
        ids = {k: data.get(k) or "" for k in ids}  # paging tokens sit next to `data`
        for item in (data.get("data") or {}).get("items") or []:
            n = item.get("note") or {}
            if n.get("id"):
                rows.append({"note_id": n["id"], "type": n.get("type"), "likes": int(num(n.get("liked_count"))),
                             "saves": int(num(n.get("collected_count"))),
                             "comments": int(num(n.get("comments_count"))),
                             "age_days": round((NOW - num(n.get("timestamp"))) / 86400)})
    return list({r["note_id"]: r for r in rows}.values())  # drop duplicates across pages


def xhs_goods_prices(keyword: str) -> list[float]:
    data = call("xiaohongshu/app-v2/search-products", {"keyword": keyword})
    cards = ((data.get("data") or {}).get("module") or {}).get("data") or []
    return [num((c.get("content") or {}).get("price_info", {}).get("price"))
            for c in cards if c.get("card_name") == "cosmos_search_goods_card"]


def douyin_videos(keyword: str, pages: int = 3) -> list[dict]:
    rows, params = [], {"keyword": keyword, "cursor": 0}
    for _ in range(pages):
        data = call("douyin/search/video-search-v2", params)
        for card in data.get("business_data") or []:
            a = (card.get("data") or {}).get("aweme_info") or {}
            s = a.get("statistics") or {}
            if a.get("aweme_id"):
                rows.append({"aweme_id": a["aweme_id"], "likes": int(num(s.get("digg_count"))),
                             "comments": int(num(s.get("comment_count"))), "shares": int(num(s.get("share_count"))),
                             "saves": int(num(s.get("collect_count"))),
                             "age_days": round((NOW - num(a.get("create_time"))) / 86400)})
        cfg = data.get("business_config") or {}
        nxt = cfg.get("next_page") or {}
        if not cfg.get("has_more") or not nxt:
            break
        params = {"keyword": keyword, "cursor": nxt.get("cursor"), "search_id": nxt.get("search_id", ""),
                  "backtrace": cfg.get("backtrace", "")}
    return list({r["aweme_id"]: r for r in rows}.values())


def summarize(tt, star, notes, prices, videos) -> dict:
    sold = sorted((r["sold"] for r in tt), reverse=True)
    rated = [r["rating"] for r in tt if r["reviews"] > 0]
    eng = lambda r: r["likes"] + r["saves"] + r["comments"]  # noqa: E731
    return {
        "tiktok_shop": {"listings": len(tt), "with_sales": sum(1 for s in sold if s > 0),
                        "median_price_usd": med([r["price"] for r in tt]), "total_sold": sum(sold),
                        "top3_sold_share": round(sum(sold[:3]) / sum(sold), 3) if sum(sold) else None,
                        "median_rating_reviewed": med(rated), **star},
        "xiaohongshu": {"notes": len(notes), "median_engagement": med([eng(n) for n in notes]),
                        "median_saves": med([n["saves"] for n in notes]),
                        "posted_last_90d": sum(1 for n in notes if n["age_days"] <= 90),
                        "video_notes": sum(1 for n in notes if n["type"] == "video"),
                        "goods_cards": len(prices), "median_goods_price_cny": med(prices)},
        "douyin": {"videos": len(videos), "median_likes": med([v["likes"] for v in videos]),
                   "median_engagement": med([eng(v) + v["shares"] for v in videos]),
                   "posted_last_90d": sum(1 for v in videos if v["age_days"] <= 90)},
    }


def narrate(stats: dict, en_kw: str, zh_kw: str) -> tuple[str, dict]:
    prompt = (f"Product: '{en_kw}' (TikTok Shop US) / '{zh_kw}' (Xiaohongshu, Douyin). "
              "Write a 120-180 word stocking brief: demand signal, competition, price band, risks, and one "
              "next check. Sample sizes are listings, notes, goods_cards and videos; call one under 30 thin. "
              "Use only numbers that appear in this JSON; do not compute new ones.\n"
              + json.dumps(stats, ensure_ascii=False))
    resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS, timeout=180,
                         json={"model": "openai/gpt-6.1-sol", "max_completion_tokens": 800,
                               "messages": [{"role": "user", "content": prompt}]})
    resp.raise_for_status()
    body = resp.json()
    return body["choices"][0]["message"]["content"] or "", body.get("usage") or {}


def unknown_numbers(text: str, stats: dict) -> list[str]:
    """Numbers in the narrative that are not in the stats JSON (percent forms of shares allowed)."""
    known = set()
    for v in re.findall(r"\d+(?:\.\d+)?", json.dumps(stats)):
        known |= {v, v.rstrip("0").rstrip(".") if "." in v else v}
        if float(v) < 1:  # shares may be quoted as percentages
            known |= {f"{float(v) * 100:.1f}".rstrip("0").rstrip("."), str(round(float(v) * 100))}
    found = [n.replace(",", "") for n in re.findall(r"\d[\d,]*(?:\.\d+)?", text)]
    return sorted({n for n in found if n not in known})


def write_csv(path: str, rows: list[dict]):
    with open(path, "w", newline="", encoding="utf-8-sig") as f:
        if rows:
            w = csv.DictWriter(f, fieldnames=list(rows[0]))
            w.writeheader()
            w.writerows(rows)


if __name__ == "__main__":
    en_kw, zh_kw = sys.argv[1], sys.argv[2]
    tt = tiktok_shop(en_kw)
    top = max(tt, key=lambda r: r["sold"]) if tt else None
    star = tiktok_star_mix(top["product_id"]) if top else {}
    notes, prices, videos = xhs_notes(zh_kw), xhs_goods_prices(zh_kw), douyin_videos(zh_kw)
    write_csv("tiktok_shop.csv", tt)
    write_csv("xiaohongshu_notes.csv", notes)
    write_csv("douyin_videos.csv", videos)
    stats = summarize(tt, star, notes, prices, videos)
    text, usage = narrate(stats, en_kw, zh_kw)
    flags = unknown_numbers(text, stats)
    with open("brief.md", "w", encoding="utf-8") as f:
        f.write(f"# Product brief: {en_kw} / {zh_kw}\n\n```json\n{json.dumps(stats, ensure_ascii=False, indent=2)}\n```\n\n")
        f.write(text + "\n\n" + (f"Check these numbers: {', '.join(flags)}\n" if flags else "Numbers check: OK\n"))
    print(json.dumps(stats, ensure_ascii=False, indent=2))
    print(text)
    print("unverified numbers:", flags or "none", "| usage:", usage)
改代码之前,先知道这几个取舍:
- 用中位数,不用平均数。 防晒霜里有个标着「COMING SOON」的商品,价格 3000 美元、销量 0。平均价会被它明显拉高,中位数几乎不动。
- 兜底短列表的处理。
has_more为 false 的页最多试四次。第 1 页是完整的、第 2 页却一直是短列表时,循环直接停,不把那 5 个或 10 个无关的兜底商品塞进样本。如果第 1 页一直没恢复,简报就建立在短列表上,所以 prompt 要求模型标出样本偏少。代价是:真正很短的第 2 页也会被丢掉。对宽泛的商品词,我没遇到过这种情况。 - 两边的「互动」口径不一样。 小红书是点赞+收藏+评论,抖音还加了分享。两个中位数不能当同一个指标比。
- 数字检查。
unknown_numbers把 LLM 文字里的每个数字拿去跟统计 JSON 对,允许把占比写成百分数。最后六次运行一个都没标出来。但它分辨不了「数字对、句子放错」这种情况。
为什么让 GPT-6.1 Sol 写文字
在我们的 Claude Sonnet 5.5 和 GPT-6.1 Sol 工具调用对比里,GPT-6.1 Sol 短任务 30 次全对,单任务成本中位数约 $0.0066。那次测试也说明了模型容易在哪翻车:对原始工具输出做平均和计数。所以这里模型根本看不到原始商品列表,它只拿到每个平台十来个数字的 JSON,负责写成文字。
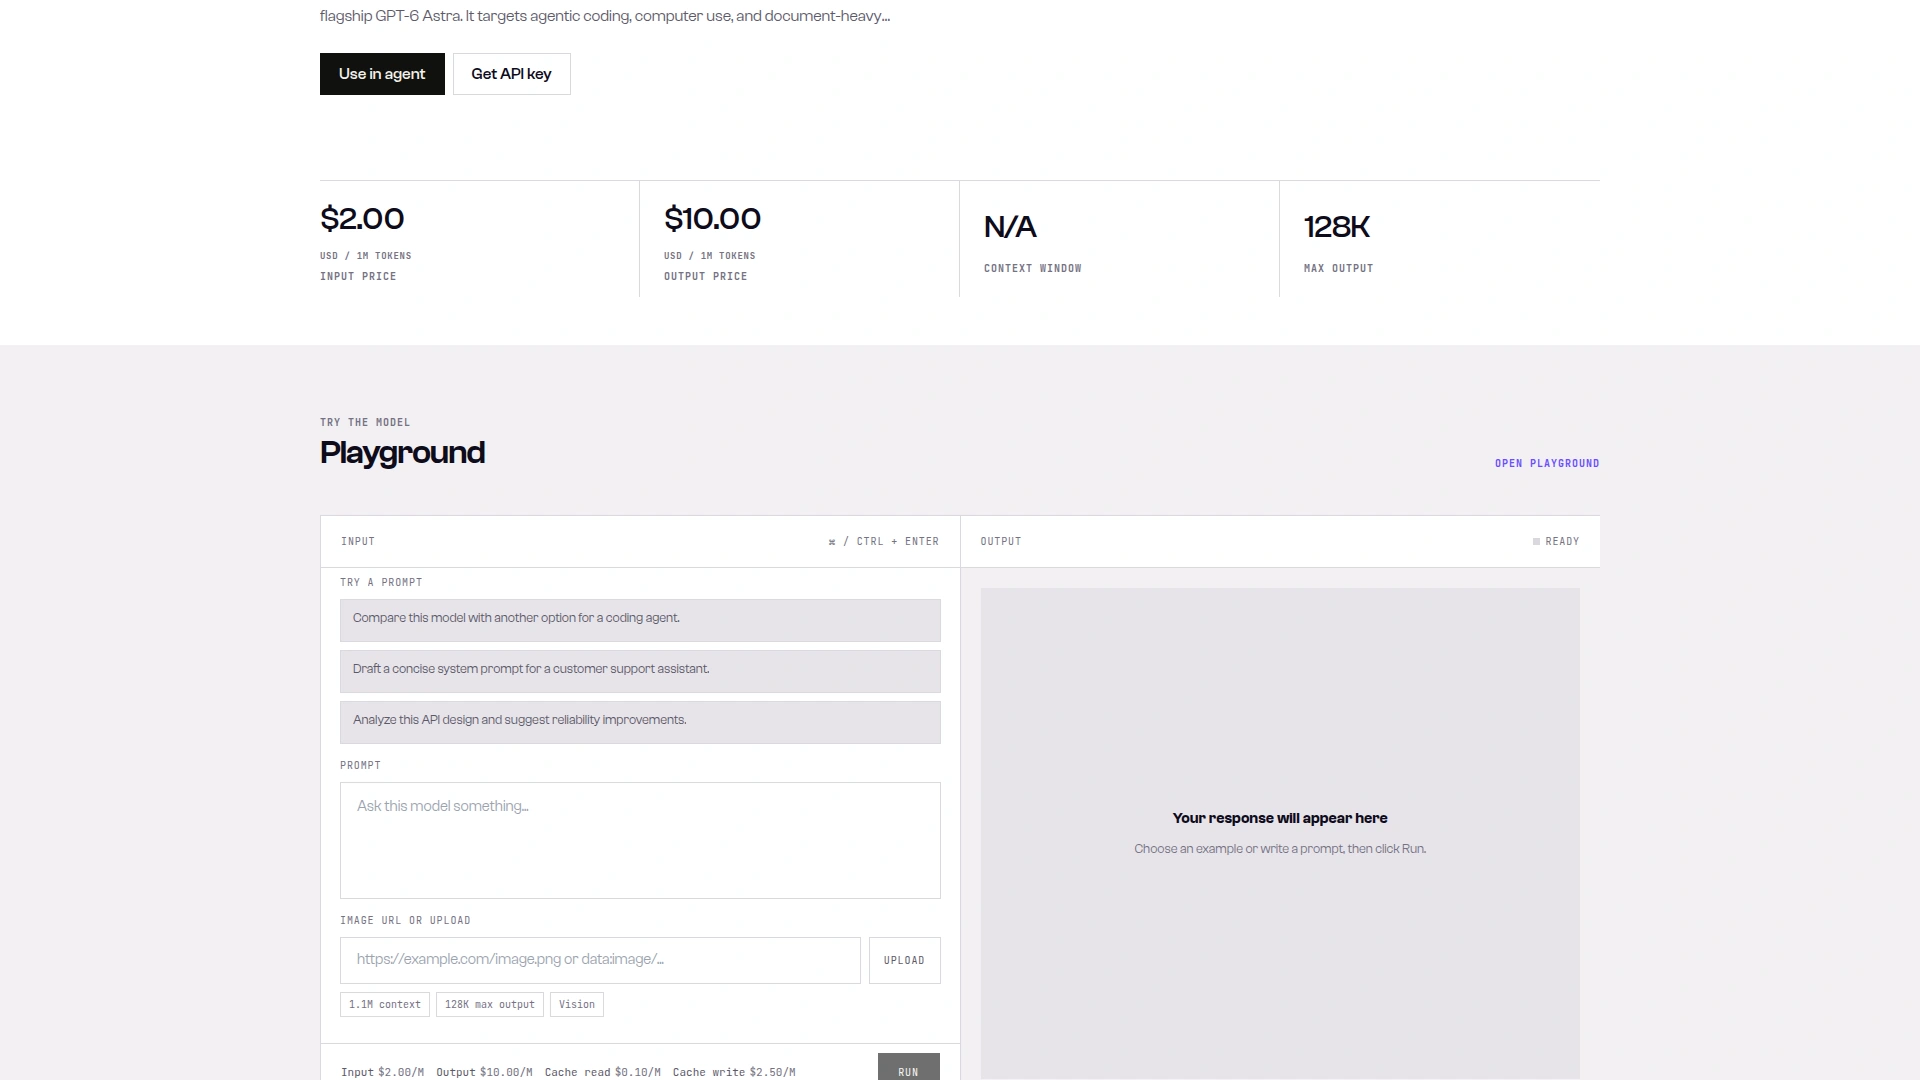 截图:GPT-6.1 Sol 模型页标价为输入 $2.00 / 百万 token、输出 $10.00 / 百万 token,下面的成本就按这个算(2026-10-03 截取)。
正式的六份简报,prompt 284~290 token,completion 269~485 token,其中推理 token 0~213。按 $2/M 输入、$10/M 输出算(目录里另有 prompt 超过 272K 的更高档,这里远远用不到),每份 $0.0033~$0.0054,六份合计 $0.027。数据调用按当天标价不花钱:下面的抖音模型页写的是 Free,另外四个数据端点当天 GET /v1/models/<model> 返回的 base_price 也都是 "0"。这是 2026-10-03 的标价,不是承诺。
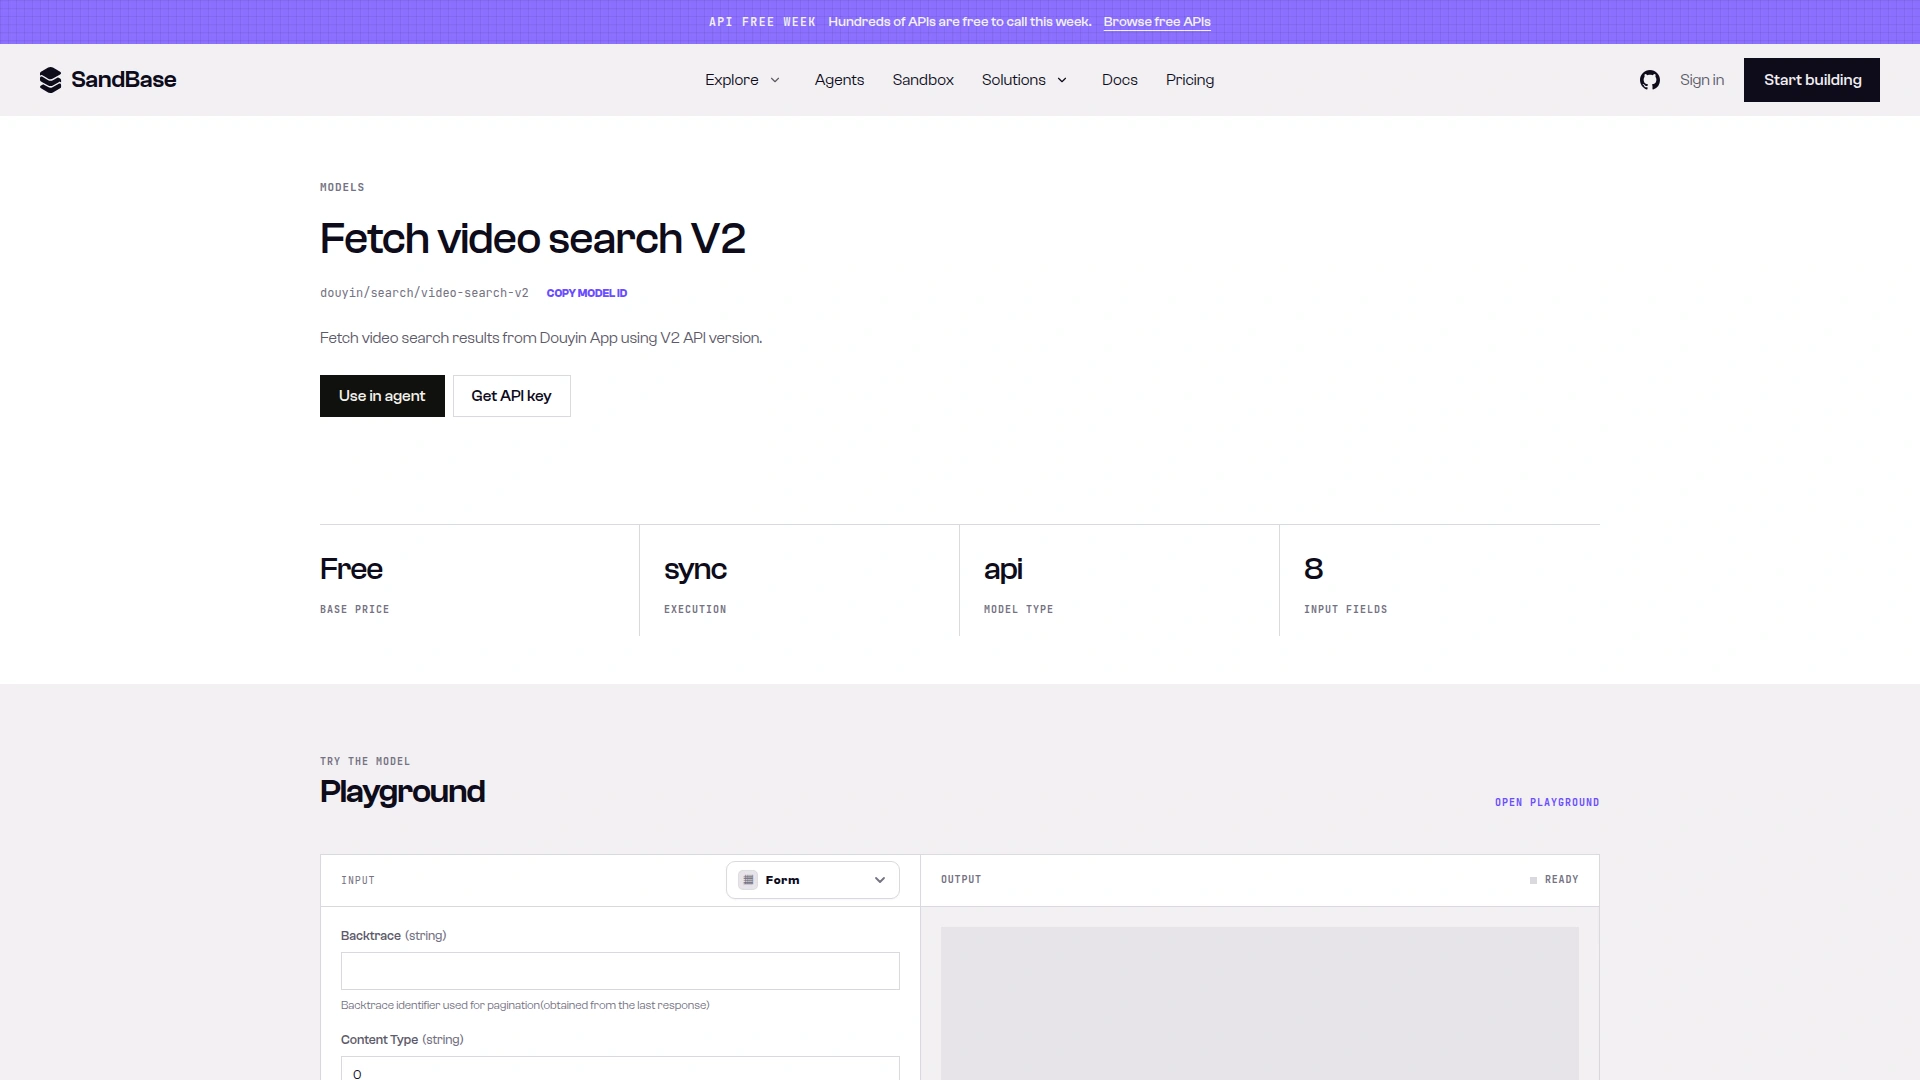 截图:douyin/search/video-search-v2 模型页显示基础价格 Free、同步执行、8 个输入字段,包括 Agent 翻页用的 cursor、search_id 和 backtrace(2026-10-03 截取)。
每组词跑三次的结果
2026-10-03 UTC 04:33~04:38,每组词各跑三次。三次之间的范围:
| 指标 | portable blender / 便携榨汁杯 | sunscreen / 防晒霜 |
|---|---|---|
| TikTok 保留的商品数 | 60、60、60 | 60、60、30 |
| TikTok 价格中位数(美元) | 16.09~16.86 | 20.91~23.20 |
| TikTok 前三名销量占比 | 0.636~0.654 | 0.421~0.615 |
| TikTok 评分中位数(有评价的商品) | 4.45~4.5 | 4.7 |
| 销冠 1、2 星占比 | 0.139 | 0.04~0.138 |
| 小红书去重后笔记数 | 30~40 | 32~40 |
| 小红书互动中位数 | 160.5~354 | 52~79.5 |
| 小红书商品标价中位数(人民币) | 57.99~59.9 | 54~103.25 |
| 抖音视频数 | 16~21 | 20 |
| 抖音点赞中位数 | 101~152 | 8,887~8,899 |
TikTok Shop 只要拿到完整样本就很稳,跑一次像样的结果,价格带和集中度就能用。防晒霜有一次销冠换了个商品,低星占比从 0.138 变成 0.04,所以这个数字旁边一定要写明是哪个商品。小红书最飘:「便携榨汁杯」的互动中位数在每隔两分钟的三次运行里依次是 263.5、354、160.5,练习运行里更是 61~354。抖音变化小一些,但结果偏旧:约 20 个视频里只有 3~5 个是近 90 天发的,因为默认按相关度排序。
这是程序写的一份简报片段(就是上面 02a0296a... 那次搜索所在的运行,LLM 调用 3eb63d10-25c2-412a-90b2-a6de9dab4770,输入 284、输出 485 token):
Competition: TikTok sales are concentrated: top-listing concentration, measured by top3_sold_share, is 0.654. Enter cautiously rather than assuming demand is evenly accessible. Price band: The data establish median price anchors, not a defensible range: USD 16.86 on TikTok and CNY 59.9 on Xiaohongshu. Xiaohongshu’s 19 goods_cards are a thin sample.
数字检查结果是 OK。文字偏保守,甚至有点过于保守,但没有编数字。简报是英文的;中文 prompt 我没测过。
局限和下一步
测试范围先说清楚:两组商品词,TikTok Shop 只测了 US,同一天正式跑 6 次、练习约 20 次。其他 TikTok 区域、长尾词、几十次以上的调用量都没测。三个平台的搜索排序都有个性化,也随时间变,所以简报描述的是「那一刻搜索展示了什么」,不是市场全貌。
可以往这几个方向扩:
- 跑两三次,保留范围。 成本很低,也是我找到的唯一能压住小红书波动的办法。
- 低星占比高就去读评价。 TikTok Shop 选品调研 API 教程里用
product-reviews-v2翻评价原文。 - 单平台挖深。 需要排序、时间筛选或追达人,看小红书选品调研 API和抖音达人视频调研。
动手的话,先拿一把 SandBase API Key,LLM 这一步参考 Chat Completions 指南。
常见问题
一个关键词能同时查 TikTok Shop、小红书和抖音吗?
不太行。TikTok Shop 美区商品是英文的,所以这边用英文词,小红书和抖音用中文词。两个词搜出来的不是同一批商品,跨平台比集中度和价格带,别比总数。
TikTok Shop 为什么只回了 5 个或 10 个商品?
那是兜底短列表:has_more 为 false,page_token 为空,不管传什么 offset 都是同一批商品 id。最后一轮 21 次搜索调用里出现了 10 次。程序每页最多请求四次;6 次正式运行里有 1 次第 2 页始终没恢复,简报只保留了 30 个商品。
小红书搜索会给笔记总数吗?
我看到的响应里没有。简报统计的是实际拿到的笔记(两页,最多 40 条,去重后),这是样本量,不代表话题有多大。
一份简报多少钱?
按 2026-10-03 的标价,五个数据端点都是 Free。GPT-6.1 Sol 调用最多用了 290 输入、485 输出 token,约 $0.0054。每天给 20 个商品各出一份,LLM 费用大约 $0.11。大批量跑之前先看一眼模型页。
为什么不让 LLM 直接读原始商品数据?
模型最容易在算数上出错,而一个 TikTok 商品详情响应就有约 487 KB。Python 把数算好,模型围绕这些数写字,检查环节再把不在统计里的数字挑出来。