跨平台比价 Agent:Google、亚马逊、TikTok Shop
用 Python 写一个跨平台比价 Agent:同一款商品同时查 Google 商品卡、亚马逊和 TikTok Shop 美国站,型号匹配在代码里做,拿不准的标题才交给 GPT-6 Luna,人工核对精确率 94%。
同一个 Stanley Quencher 40 oz 保温杯,我隔四分钟跑了两次比价。第一次,代码认定是「这款杯子」的 27 张 Google 商品卡里,有 24 张来自 eBay、Mercari、Poshmark、Whatnot 这类转卖平台,Google 一侧中位价 $50;第二次 Google 只回了 6 张能匹配上的卡片,一张转卖都没有,中位价 $47.50。亚马逊两次都稳定在 $64 左右。做比价,难的不是算中位数,而是搞清楚哪些商品真是同一个东西、又是从哪儿来的。
这篇教程写的是一个比价 Agent,跨平台查三款品牌商品:Google 搜索结果页里的商品卡、亚马逊、TikTok Shop,全部是美国站。每款商品它会拉列表,在代码里判断哪些是同一件商品(标题归一化、型号、容量和尺寸),只把判断不了的标题交给便宜的 LLM,标出变体和异常价格,最后按来源打印美元最低价、中位价和最高价。适合想把比价做成可重复任务的开发者和定价分析同学。
先说结论
- 五个候选端点里有两个跑不通:SandBase 上的两条 Google Shopping 路由(
serp/google/shopping/live/advanced和merchant/google/products/live/advanced)都返回 completed,但里面的 DataForSEO 状态码是 40402「Invalid Path」。所以 Agent 改读 Google 自然搜索结果里的popular_products商品卡。- 人工逐条核对一整轮结果:Agent 计入价格的 99 条匹配里有 93 条确实是目标商品,精确率 94%。LLM 判成 match 的 8 条全对。错的 6 条是两条带「Lite」的标题、一条纯蓝牙不带接收器的套装,以及三条 Stanley 转卖标题(另一个系列、不同杯盖、可能不止一个)。
- 价格比样本稳。两轮下来,Logitech MX Master 3S 中位价亚马逊 $88.99,Google 商品卡 $99~$104.50,TikTok Shop $109.74。
- LLM 这一步用
openai/gpt-6-luna,每轮(三款商品)$0.00042~$0.00068。2026-10-03 数据端点在目录里标为 Free,页面顶部挂着「API Free Week」横幅。
比的是哪三款
选这三款,是因为它们型号清楚,同时都有一堆长得很像的「兄弟款」:
| 商品 | 代码要排除的近似款 |
|---|---|
| Anker Nano 充电宝,10000 mAh、30 W、自带 USB-C 线 | 45 W 版 Nano、5000 mAh 版 Nano、Nano 三合一、MagGo、Zolo、两只装 |
| Logitech MX Master 3S | MX Master 3、4、2S,「for Mac」「for Business」,键鼠套装 |
| Stanley Quencher H2.0 FlowState 40 oz | 14、20、30、64 oz,ProTour,Fluted,替换杯盖和吸管 |
| 来源 | 端点 | 代码读哪些字段 |
|---|---|---|
| Google 商品卡 | dataforseo/v3/serp/google/organic/live/advanced | popular_products 里的标题、卖家、price.current |
| 亚马逊搜索 | dataforseo/v3/merchant/amazon/products/live/advanced | amazon_serp 和 amazon_paid:标题、ASIN、price_from、URL 里的 slug |
| TikTok Shop 美国站搜索 | tiktok/shop-web/search-products-list | products:标题、品牌、sale_price_decimal |
| 拿不准的标题 | openai/gpt-6-luna,走 /v1/chat/completions | 每条判 match、variant 或 unclear |
最后两轮,每轮 15~17 次 HTTP 调用,耗时 148~171 秒。慢的是亚马逊,单次 10~41 秒。
数据边界
这里用的都是抓取那一刻的公开商品信息,只读,地区是美国(DataForSEO location_code 2840,TikTok region US)。需要一把 SandBase API Key。SandBase 不是 Google、亚马逊或 TikTok 的官方合作方,不碰卖家后台、订单、私密数据,也不做任何账号操作。价格就是商品页当时显示的价格,除此之外不代表对任何零售商的判断。Google 商品卡里的卖家名是 Google 展示的,本文只做汇总,不点名。
| 需求 | 用什么 |
|---|---|
| 研究多个渠道的公开售价 | SandBase 公开数据端点(本文) |
| 给联盟站拉亚马逊商品数据 | Amazon Product Advertising API |
| 管自己 Merchant Center 里的商品 | Google Merchant API |
| 管自己 TikTok Shop 的商品和订单 | TikTok Shop Partner Center |
哪些端点能用
五个候选端点在 SandBase 目录里都是启用状态。2026-10-03(UTC)我逐个实调了一遍:
| 端点 | 实际情况 | 是否采用 |
|---|---|---|
serp/google/shopping/live/advanced | HTTP 200、completed,但 tasks[0].status_code 是 40402「Invalid Path」,没有结果 | 否 |
merchant/google/products/live/advanced | 同样 40402,location_code 和 location_name 两种写法都试过 | 否 |
serp/google/organic/live/advanced | 每次 2~3 个 popular_products 区块,16~40 张商品卡 | 是 |
merchant/amazon/products/live/advanced | 每次 100~123 条 | 是 |
tiktok/shop-web/search-products-list | has_more 为 true 时 25 个商品,但经常回短列表 | 是,带重试 |
DataForSEO 官方文档里,Google Shopping 商品是任务式接口:先提交任务,再回来取结果。SandBase 没有对应的 task_post 模型,GET /v1/models/dataforseo/v3/merchant/google/products/task_post 返回 404。于是退而求其次,读 Google 普通结果页上的商品卡:每张都有卖家和价格,只是数量少、噪声大,比不上真正的 Shopping 标签页。
返回结构也要留意。SandBase 参考页写的是:completed 的响应里只有一个 outputs 元素,里面只有 data:
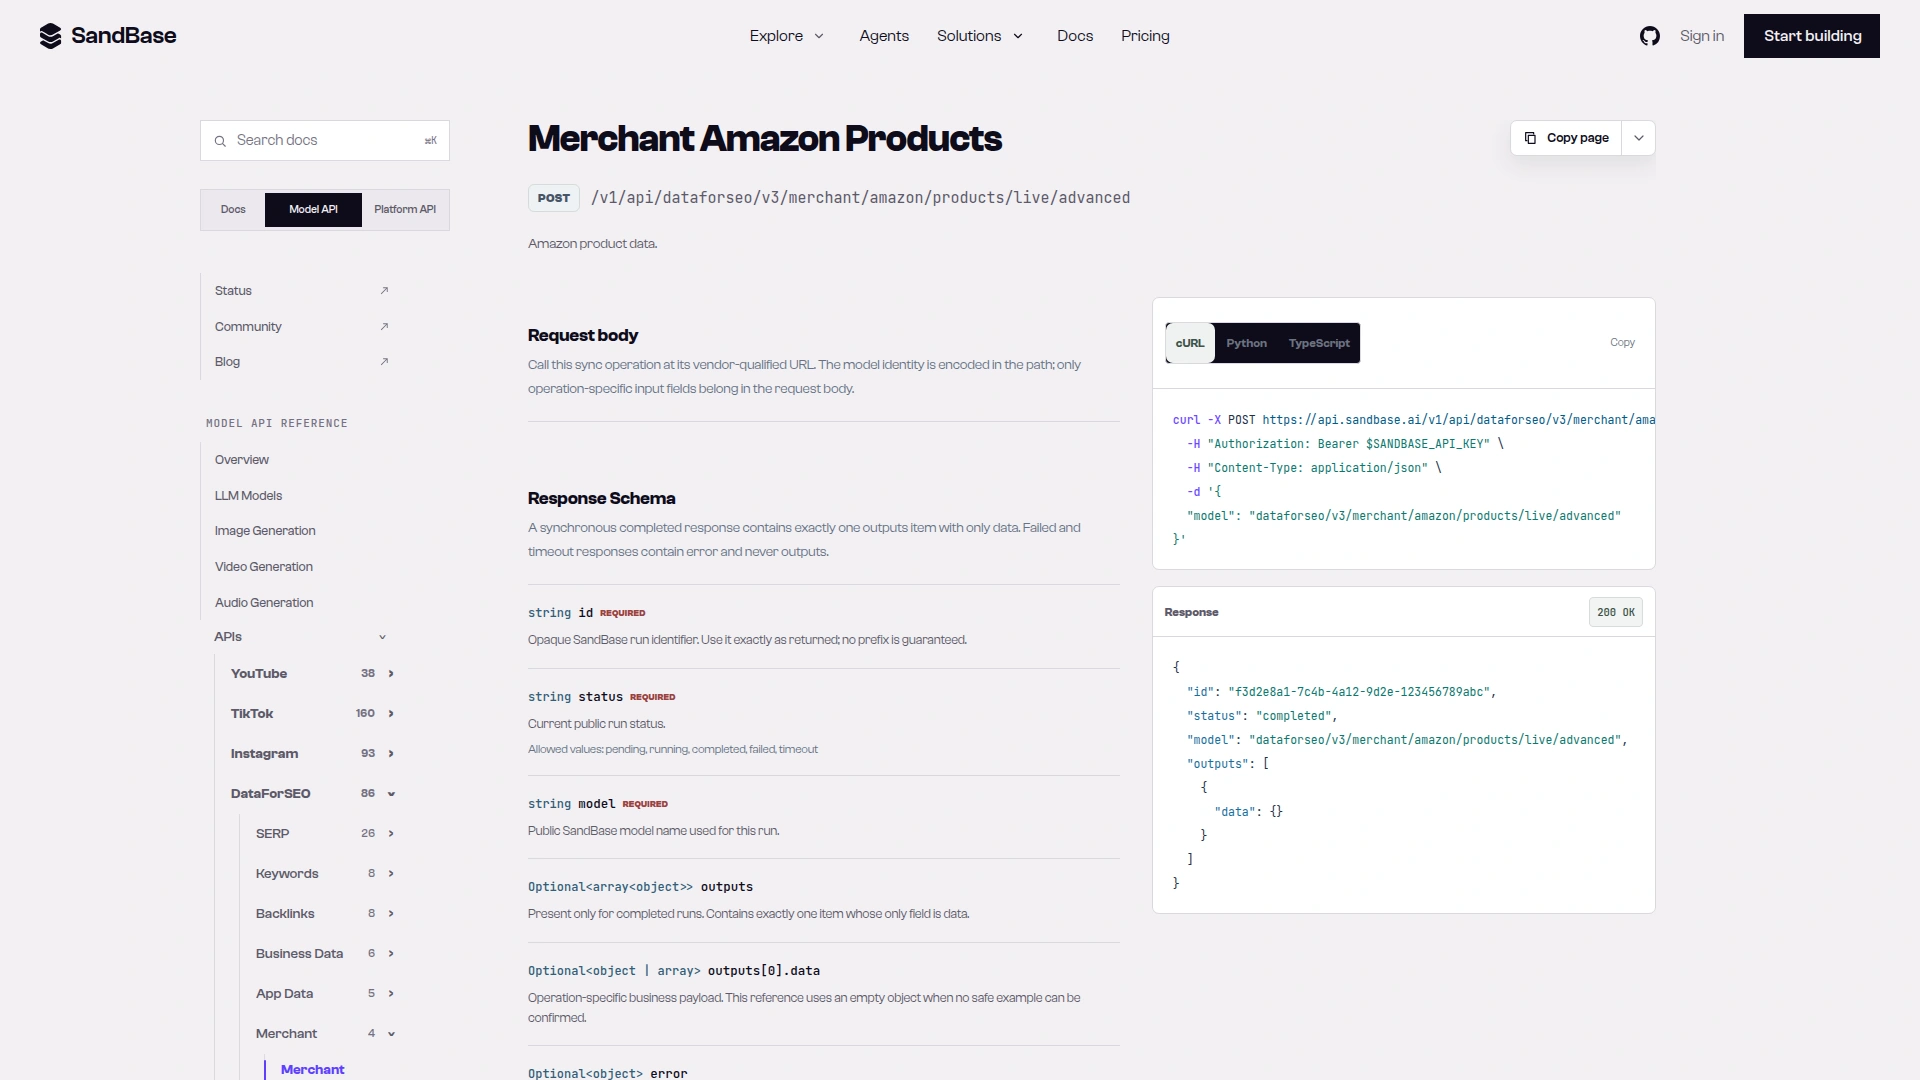
截图:亚马逊商品参考页写明 POST /v1/api/dataforseo/v3/merchant/amazon/products/live/advanced,载荷在 outputs[0].data;实调时 DataForSEO 的外层结构直接放在 outputs[0] 里(2026-10-03 截取)。
实际调用时,三个 DataForSEO 端点都把 DataForSEO 自己的外层结构(status_code、tasks 等)直接放在 outputs[0],没有 data 这一层;TikTok 则是 outputs[0].data。所以程序的读取函数先找 outputs[0].data,没有就退回 outputs[0],再没有才看顶层 output,状态不是 completed 一律报错。DataForSEO 还得再查一层:40402 是包在一个 completed 的 SandBase 任务里回来的,所以只要 tasks[0].status_code 不是 20000,代码就抛错。
实测记录:2026-10-03(UTC)
输入只有上面三款品牌商品,不涉及任何个人数据。每个请求都是 POST https://api.sandbase.ai/v1/api/<model>,带 Authorization: Bearer $SANDBASE_API_KEY,请求体只放该端点自己的字段。下面出现的字段名都是这几次响应里实际看到的,不是文档承诺,所以代码一律用 .get() 读。
curl -s https://api.sandbase.ai/v1/api/dataforseo/v3/merchant/amazon/products/live/advanced \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"keyword": "Anker Nano Power Bank 10000mAh 30W", "language_code": "en_US", "location_code": 2840}'
任务 4bea800c-c5d8-49e1-b2d9-e599c02ded92 回了 113 条。下面只放第一条;条目里的其他键(URL、图片、评分、配送信息等)和外层的其他键都省略了。
{"id": "4bea800c-c5d8-49e1-b2d9-e599c02ded92", "status": "completed",
 "outputs": [{"status_code": 20000, "status_message": "Ok.",
   "tasks": [{"status_code": 20000, "result": [{"datetime": "2026-10-03 13:53:30 +00:00",
     "items": [{"type": "amazon_serp", "rank_absolute": 1,
                "title": "Nano Power Bank,10,000mAh 30W Portable Charger,Built-in USB-C Cable",
                "data_asin": "B0C9CJKCH3", "price_from": 49.99, "currency": "USD"}]}]}]}]}
这个数据源里的亚马逊标题经常不带品牌名,所以代码还会去 URL slug 里找品牌(这条是 Anker-Portable-Charger-...)。
Google 请求体结构一样,只是 "language_code": "en",外加 "depth": 20。任务 49caa77e-9417-425a-aa04-4235cb615d6b 里有 16 张商品卡。下面是品牌自己在 Newegg 上的店铺那张,省略了 image_url、rating、product_identifiers 等键:
{"type": "popular_products_element",
 "title": "Anker Nano Power Bank, 10,000mAh Portable Charger with Built-in USB-C Cable, 30W Recharging, 30W Max Output with USB-C&A, for iPhone 17/16/15 Series,",
 "seller": "Newegg.com - Anker Official Store",
 "price": {"currency": "USD", "current": 54.99, "displayed_price": "$54.99",
           "is_price_range": false, "max_value": null, "regular": null}}
同样的请求体发给 serp/google/shopping/live/advanced(任务 e8c93b6a-8421-4508-8c32-e987b66d71d9),返回 completed,task 是这样的(其他键省略):
{"status_code": 40402, "status_message": "Invalid Path.", "cost": 0, "result": null}TikTok Shop 发 {"search_word": "Anker Nano Power Bank 30W", "region": "US", "offset": 0, "page_token": ""}:第一次(任务 67542af5-da6e-405c-8402-b953bc9f14f0)回了 15 个商品的短列表,has_more: false;紧接着第二次(0c087924-c820-47c5-9925-81edf24cf946)回了完整的 25 个,has_more: true。完整页里的一个商品,其他键省略:
{"product_id": "1732594588728267232",
 "title": "Anker Nano Power Bank (30W, Built-In USB-C Cable) Phone Chargeable Smartphone Charging",
 "product_price_info": {"currency_name": "USD", "sale_price_decimal": "49.99"},
 "sold_info": {"sold_count": 0}}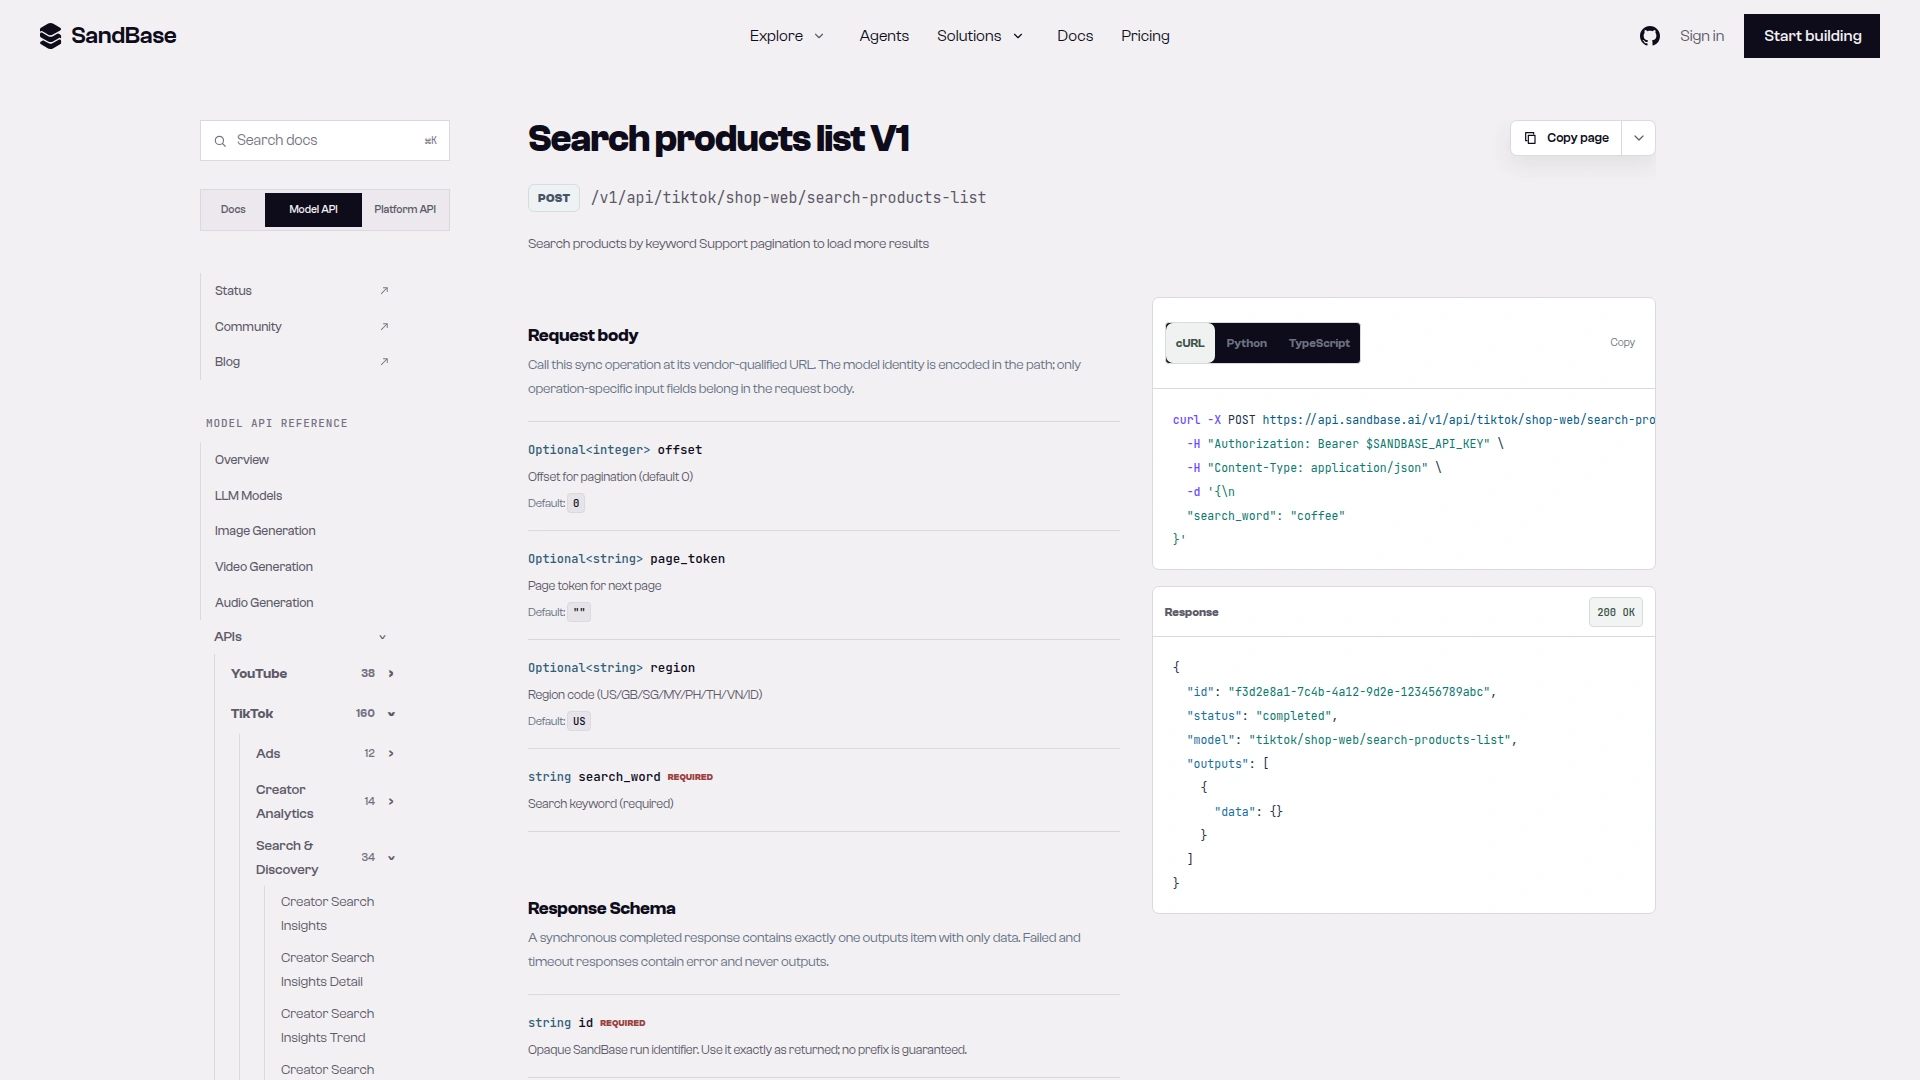
截图:TikTok Shop 搜索参考页把 search_word 列为必填,另有 offset、page_token、region,正是 Agent 发送的四个字段(2026-10-03 截取)。
完整程序
单文件,标准库加 requests。设好 SANDBASE_API_KEY 后运行 python3 price_compare.py,会生成带判定结果的 listings.csv,并打印价格表。
#!/usr/bin/env python3
"""Cross-platform price comparison agent: Google product cards, Amazon and TikTok Shop (US).
Usage: python3 price_compare.py
Writes listings.csv (every listing with its verdict) and prints a min/median/max price table per source.
"""
import csv
import json
import os
import re
import time
from statistics import median
import requests
BASE = "https://api.sandbase.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}"}
US = {"location_code": 2840} # DataForSEO location code for the United States
PRODUCTS = [
{"name": "Anker Nano Power Bank (10K, 30W, built-in USB-C cable)", "query": "Anker Nano Power Bank 10000mAh 30W",
"tiktok": "Anker Nano Power Bank 30W", "brand": "anker", "family": r"\bnano\b.*\b(power ?bank|charger)\b",
"attrs": {"mah": 10000, "w": 30}, "model_no": r"\ba1259", # Anker's model number for this power bank
"other_models": r"3-in-1|maggo|magnetic|zolo|prime|powercore|connector|instacord|retractable"},
{"name": "Logitech MX Master 3S", "query": "Logitech MX Master 3S", "tiktok": "Logitech MX Master 3S",
"brand": "logitech", "family": r"\bmx master\b", "attrs": {"mx": "3s"},
"other_models": r"for mac|for business|\bbiz\b|combo|keys"},
{"name": "Stanley Quencher H2.0 FlowState 40 oz", "query": "Stanley Quencher H2.0 40 oz",
"tiktok": "Stanley Quencher 40 oz", "brand": "stanley", "family": r"\bquencher\b", "attrs": {"oz": 40, "gen": 2},
"other_models": r"fluted|protour|pro tour|iceflow|travel tumbler"},
]
ACCESSORY = r"\b(for|fits?|fit for|compatible with)\s+(the\s+)?(stanley|logitech|anker)\b|\breplacement\b|" \
r"\bcase for\b|\bboot\b|\bprotector\b|\bstraw cover\b|\blid kit\b"
BUNDLE = r"\b\d+\s*(pack|pcs|pieces|count)\b|\bpack of \d+|\bbulk\b|\bbundle\b|\bpromo(tional)?\b|\bcustom\b|" \
r"\bimprinted\b|\bpersonalized\b|\bset of\b|&\s*anker|\bwith anker\b"
USED = r"\b(used|renewed|refurbished|pre-owned|open box|excellent condition)\b"
def call(model: str, params: dict) -> dict:
"""POST /v1/api/<model>. Prefer outputs[0].data, fall back to outputs[0], then output."""
resp = requests.post(f"{BASE}/api/{model}", headers=HEADERS, json=params, timeout=120)
body = resp.json()
if resp.status_code != 200 or body.get("status") != "completed":
raise RuntimeError(f"{model}: HTTP {resp.status_code} {body.get('status')} {body.get('error')}")
out = (body.get("outputs") or [None])[0]
data = out.get("data", out) if isinstance(out, dict) else body.get("output")
if data is None:
raise RuntimeError(f"{model}: completed without a payload")
return data
def dataforseo_items(model: str, params: dict) -> list[dict]:
"""DataForSEO wraps results in tasks[0].result[0].items; status_code 20000 means OK."""
task = (call(model, params).get("tasks") or [{}])[0]
if task.get("status_code") != 20000:
raise RuntimeError(f"{model}: DataForSEO {task.get('status_code')} {task.get('status_message')}")
return ((task.get("result") or [{}])[0] or {}).get("items") or []
def google_shopping(query: str) -> list[dict]:
"""Product cards ('popular_products') from a live Google SERP; each card carries seller and price."""
items = dataforseo_items("dataforseo/v3/serp/google/organic/live/advanced",
{"keyword": query, "language_code": "en", "depth": 20, **US})
cards = [c for i in items if i.get("type") == "popular_products" for c in i.get("items") or []]
return [{"source": "google", "id": (c.get("product_identifiers") or {}).get("data_docid"),
"title": c.get("title") or "", "seller": c.get("seller") or "", "extra": "",
"price": (c.get("price") or {}).get("current"), "currency": (c.get("price") or {}).get("currency")}
for c in cards]
def amazon(query: str) -> list[dict]:
items = dataforseo_items("dataforseo/v3/merchant/amazon/products/live/advanced",
{"keyword": query, "language_code": "en_US", **US})
return [{"source": "amazon", "id": i.get("data_asin"), "title": i.get("title") or "", "seller": "",
"extra": (i.get("url") or "").split("/")[3] if (i.get("url") or "").count("/") > 3 else "",
"price": i.get("price_from"), "currency": i.get("currency")}
for i in items if i.get("type") in ("amazon_serp", "amazon_paid")]
def tiktok_shop(query: str, tries: int = 4) -> list[dict]:
"""First page of TikTok Shop US search. A short fallback list (has_more false) is retried."""
for _ in range(tries):
page = call("tiktok/shop-web/search-products-list",
{"search_word": query, "region": "US", "offset": 0, "page_token": ""}).get("data") or {}
if page.get("has_more"):
break
time.sleep(2)
return [{"source": "tiktok", "id": p.get("product_id"), "title": p.get("title") or "", "seller": "",
"extra": (p.get("brand_info") or {}).get("brand_name") or "",
"price": float((p.get("product_price_info") or {}).get("sale_price_decimal") or 0) or None,
"currency": (p.get("product_price_info") or {}).get("currency_name")}
for p in page.get("products") or []]
def normalize(title: str) -> str:
t = title.lower().replace("™", "").replace("®", "").replace("™", "").replace("h2.o", "h2.0")
t = re.sub(r"(\d),(\d{3})", r"\1\2", t) # 10,000 -> 10000
t = re.sub(r"\b(\d+)k\b(?!\s*dpi)", lambda m: f"{int(m[1]) * 1000}mah", t) # 10K -> 10000mah
t = re.sub(r"\b1\.(18|2)\s*l\b", "40 oz", t) # 1.18 L / 1.2 L is the 40 oz cup
return re.sub(r"\s+", " ", t)
def attributes(t: str) -> dict:
return {"mah": {int(x) for x in re.findall(r"(\d{4,5})\s*mah", t)},
"w": {float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*w\b", t)},
"oz": {int(x) for x in re.findall(r"(\d+)\s*(?:fl\.?\s*)?(?:oz|ounce)", t)},
"gen": {int(x) for x in re.findall(r"\bh(\d)\.0\b", t)},
"mx": set(re.findall(r"mx master\s*(\d+s?)\b", t))}
def classify(row: dict, spec: dict) -> tuple[str, str]:
"""Rule-based verdict: match, variant, accessory, other or ambiguous (sent to the LLM)."""
t = normalize(row["title"])
if re.search(ACCESSORY, t):
return "accessory", "accessory wording"
if spec["brand"] not in f"{t} {row['extra'].lower()} {row['seller'].lower()}":
return "other", "brand missing"
if not re.search(spec["family"], t):
return "other", "model family missing"
if m := re.search(BUNDLE, t):
return "variant", f"bundle or multi-pack ({m[0].strip()})"
if m := re.search(USED, t):
return "variant", f"condition ({m[0]})"
if m := re.search(spec["other_models"], t):
return "variant", f"different model ({m[0]})"
if spec.get("model_no") and re.search(spec["model_no"], t):
return "match", "model number"
found, missing = attributes(t), []
for key, want in spec["attrs"].items():
if not found[key]:
missing.append(key)
elif want not in found[key]:
return "variant", f"{key} {sorted(found[key])} vs {want}"
return ("ambiguous", "missing " + ", ".join(missing)) if missing else ("match", "all attributes present")
def llm_judge(spec: dict, rows: list[dict]) -> tuple[list[str], dict]:
"""Ask a cheap model about listings the rules could not decide. Titles only, one call per product."""
if not rows:
return [], {}
lines = "\n".join(f"{i}. {r['title']} | seller: {r['seller'] or r['extra'] or 'n/a'}" for i, r in enumerate(rows))
prompt = (f"Reference product: {spec['name']}.\nFor each numbered listing, answer 'match' only if the title "
"clearly identifies this exact product (any color is fine), 'variant' if it is a different size, "
"capacity, model or a bundle, and 'unclear' if the title does not say enough. Return JSON "
'{"verdicts": ["match", ...]} in the same order.\n' + lines)
resp = requests.post(f"{BASE}/chat/completions", headers=HEADERS, timeout=120,
json={"model": "openai/gpt-6-luna", "max_tokens": 2000, # leaves room for reasoning
"response_format": {"type": "json_object"},
"messages": [{"role": "user", "content": prompt}]})
resp.raise_for_status()
body = resp.json()
try:
verdicts = json.loads(body["choices"][0]["message"]["content"] or "{}").get("verdicts") or []
except json.JSONDecodeError: # truncated or malformed answer: treat every listing as unclear
verdicts = []
verdicts = [v if v in ("match", "variant", "unclear") else "unclear" for v in verdicts]
return (verdicts + ["unclear"] * len(rows))[:len(rows)], {"id": body.get("id"), **(body.get("usage") or {})}
def compare(spec: dict) -> tuple[list[dict], dict]:
rows, seen = [], set()
for fetch, query in ((google_shopping, spec["query"]), (amazon, spec["query"]), (tiktok_shop, spec["tiktok"])):
for r in fetch(query):
if (r["source"], r["id"], r["title"], r["seller"]) not in seen: # Amazon repeats ASINs as ads
seen.add((r["source"], r["id"], r["title"], r["seller"]))
rows.append(r)
for r in rows:
r["product"] = spec["name"]
r["verdict"], r["reason"] = classify(r, spec)
unsure = [r for r in rows if r["verdict"] == "ambiguous"]
verdicts, usage = llm_judge(spec, unsure)
for r, v in zip(unsure, verdicts):
r["verdict"], r["reason"] = v, f"LLM: {v} ({r['reason']})"
matched = [r["price"] for r in rows if r["verdict"] == "match" and r["price"]]
mid = median(matched) if matched else 0
for r in rows: # a matched title at under half or over twice the cross-source median needs a human look
if r["verdict"] == "match" and r["price"] and not 0.5 * mid <= r["price"] <= 2 * mid:
r["verdict"], r["reason"] = "price_check", f"price {r['price']} vs cross-source median {mid}"
return rows, usage
def price_table(rows: list[dict]) -> list[dict]:
out = []
for source in ("google", "amazon", "tiktok"):
got = [r for r in rows if r["source"] == source]
prices = [r["price"] for r in got if r["verdict"] == "match" and r["price"] and r["currency"] == "USD"]
out.append({"source": source, "listings": len(got), "matched": len(prices),
"variants_flagged": sum(r["verdict"] == "variant" for r in got),
"price_checks": sum(r["verdict"] == "price_check" for r in got),
"min_usd": min(prices) if prices else None,
"median_usd": round(median(prices), 2) if prices else None,
"max_usd": max(prices) if prices else None})
return out
if __name__ == "__main__":
started = time.strftime("%Y-%m-%d %H:%M UTC", time.gmtime())
all_rows, report = [], {"fetched_at": started, "location": "United States", "products": []}
for spec in PRODUCTS:
rows, usage = compare(spec)
all_rows += rows
report["products"].append({"product": spec["name"], "table": price_table(rows), "llm_usage": usage})
with open("listings.csv", "w", newline="", encoding="utf-8") as f:
w = csv.DictWriter(f, fieldnames=["product", "source", "id", "title", "seller", "extra", "price",
"currency", "verdict", "reason"])
w.writeheader()
w.writerows(all_rows)
print(json.dumps(report, indent=1))每款商品打印出的 table 按来源各一行,比如第一轮正式运行(fetched_at 2026-10-03 13:42 UTC)里的这一行:
{"source": "amazon", "listings": 104, "matched": 6, "variants_flagged": 14, "price_checks": 1,
 "min_usd": 79.99, "median_usd": 88.99, "max_usd": 118.99}
匹配规则怎么走
规则按固定顺序执行,顺序本身就是设计的一部分:
- 先挑配件。「Case for Anker…」「Lid replacement for Stanley…」、硅胶杯底套,这些标题里都有商品名,放到后面会一路过关。第一轮里,亚马逊 Stanley 搜索的 106 条中有 39 条在这一步就被拦下。
- **品牌和型号系列。**品牌可以出现在标题、卖家、TikTok 的品牌字段或亚马逊 URL slug 里。
- 套装、成色、兄弟款。「Pack of 2」、促销批量、「renewed」、「for Business」、「ProTour」之类,判为
variant并写明原因。只标记不丢弃,listings.csv里看得到。 - **型号或属性。**Anker 的 A1259(Google 结果里 Anker 官网商品 URL 上的型号)单独出现就算匹配。否则规格里的每个属性都必须出现且一致:容量和功率、「MX Master」后面的版本号、杯子容量和 H2.0 代数。有冲突值就是变体;缺值就判
ambiguous。 - **剩下拿不准的交给 LLM。**只有这些标题会发给 GPT-6 Luna,每款商品一次调用,结果是 match、variant 或 unclear。unclear 不计入价格。
- **价格兜底。**匹配上的商品,价格低于跨来源中位数的一半或高于两倍,改判
price_check。这一步抓到了一个非美国网站上标价 $999 的商品、几条 $13~$28.62 的低价转卖、$200 和 $250 的高价转卖,还有一个标题里没写「combo」的 $249.98 键鼠套装。它也标出了一个 $139.99 的亚马逊配色款,这个价格可能是真的,所以这一步只做标记,不做删除。
归一化处理的是开发时把朴素匹配搞崩的几种写法:「10,000mAh」「10K」「H2.O」「1.18 L」;另外加了一个 DPI 保护,免得鼠标的「8K DPI」被当成电池容量。
两轮结果
2026-10-03 13:42 和 13:46(UTC)各跑一次。「匹配」只数有美元价格的匹配;两轮不同时,表格里按「第一轮,第二轮」的顺序写。
| 商品 | 来源 | 条数 | 匹配 | 最低 USD | 中位 USD | 最高 USD |
|---|---|---|---|---|---|---|
| Anker Nano 10K 30W | Google 商品卡 | 29, 35 | 8, 9 | 45.10, 49.99 | 54.49, 53.99 | 72.17, 61.99 |
| 亚马逊 | 123, 111 | 5 | 49.99 | 54.99 | 54.99 | |
| TikTok Shop | 25 | 1 | 49.99 | 49.99 | 49.99 | |
| Logitech MX Master 3S | Google 商品卡 | 16 | 9, 10 | 89.99 | 99, 104.50 | 129.99 |
| 亚马逊 | 104, 107 | 6 | 79.99 | 88.99 | 118.99 | |
| TikTok Shop | 25 | 6 | 99.99 | 109.74 | 137.79 | |
| Stanley Quencher 40 oz | Google 商品卡 | 40, 16 | 27, 6 | 30, 40 | 50, 47.50 | 79.99, 62 |
| 亚马逊 | 106, 100 | 29, 30 | 39.99 | 64.24, 64.28 | 109.99 | |
| TikTok Shop | 25 | 8 | 52.85 | 56.75 | 68.71 |
我的几点判断:
- **亚马逊和 TikTok Shop 稳,Google 不稳。**Stanley 商品卡第一次 40 张、第二次 16 张,卖家构成也完全不同。Google 至少跑两三次,留区间。
- **大多数「匹配」其实是颜色款。**Anker 在亚马逊的 5 条匹配全是同一款充电宝的不同颜色 ASIN,价格不是 $49.99 就是 $54.99;Stanley 在亚马逊的 29~30 条匹配大多是不同配色,从 $39.99 到 $109.99。要锁定某一个 SKU,就把颜色写进规格。
- **输出的大头是标记。**第一轮有 99 条计价匹配,同时标出了 87 条变体和 11 条价格待查。光是 Anker 的亚马逊搜索就有 33 条变体:45 W 版、三合一、两只装、MagGo 套装。
- **TikTok Shop 的短列表很常见。**两轮共 16 次 TikTok 调用,10 次回的是
has_more: false、只有 5、15 或 20 个商品的短列表。代码会重试到has_more为 true 为止,最多四次,仍拿不到就保留短列表。这两轮每款商品最终都拿到了 25 个商品的完整页,最差的一次用了四次。
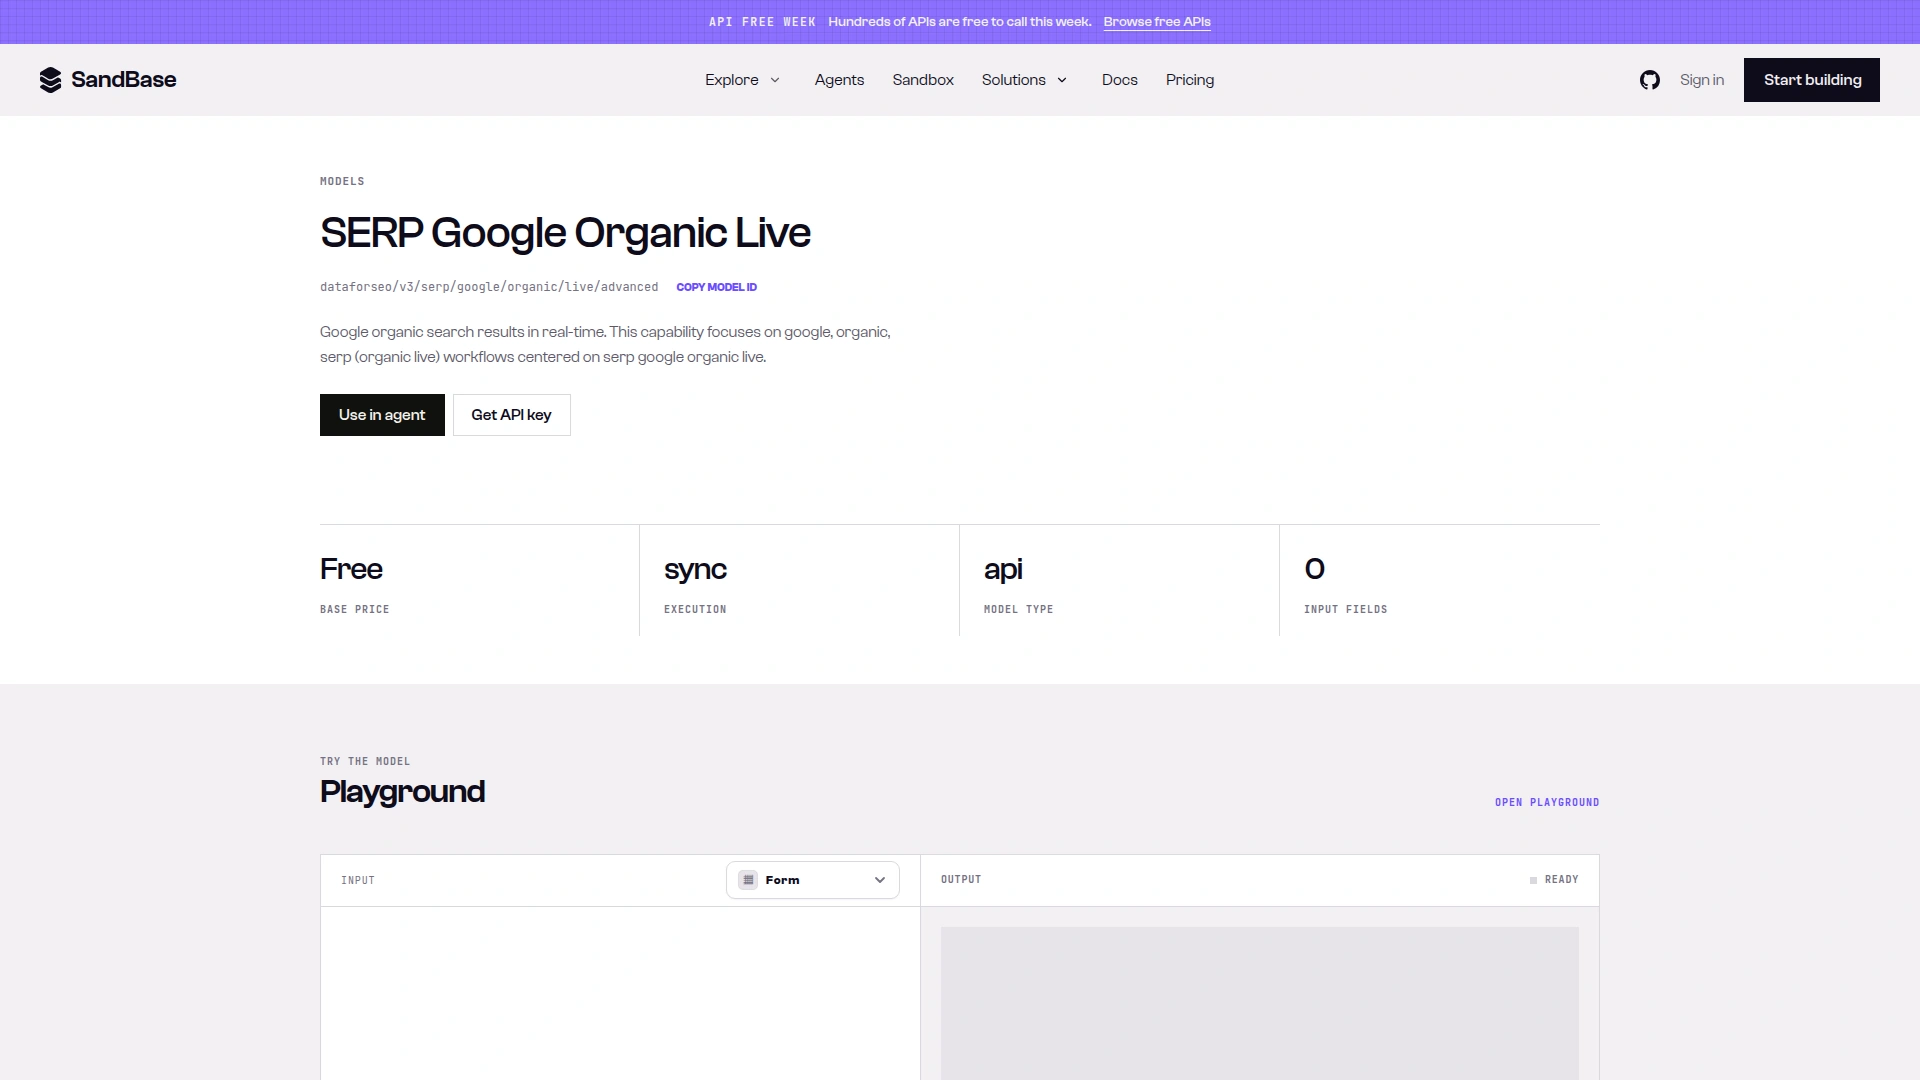
截图:SERP Google Organic Live 模型页显示基础价格 Free、同步执行,页面顶部是「API Free Week」横幅,这是下文成本部分所依据的当日价格(2026-10-03 截取)。
匹配到底准不准
第一轮里 Agent 计入价格的匹配一共 99 条,我只看标题和卖家逐条核对。判定标准:标题指向的就是目标商品(同型号、同容量或尺寸、单件,颜色和联名款不限)就算对。结果 93 条对,精确率 94%。
| 商品 | 来源 | 计价匹配 | 正确 |
|---|---|---|---|
| Anker Nano 10K 30W | Google / 亚马逊 / TikTok | 8 / 5 / 1 | 8 / 5 / 1 |
| Logitech MX Master 3S | Google / 亚马逊 / TikTok | 9 / 6 / 6 | 7 / 5 / 6 |
| Stanley Quencher 40 oz | Google / 亚马逊 / TikTok | 27 / 29 / 8 | 24 / 29 / 8 |
被我判错的 6 条:两张写着「MX Master 3S Lite」的 Google 商品卡(这个名字我没能在 Logitech 那边确认),一条亚马逊「蓝牙版、不带接收器」的套装,还有三条 Stanley 转卖标题:一条是翻盖杯盖,一条是 Adventure 系列,一条写的是复数「Tumblers」,可能不止一个。把「lite」「no receiver」「adventure」加进变体规则,其中四条就能拦住。其中两条属于见仁见智:不带接收器的套装依然是 MX Master 3S,「Adventure Quencher」也曾被用来称呼这款杯子;如果这两条算对,精确率是 99 条里 95 条。要说明的是,这轮之前我用几次开发运行调过规则,所以这些数字是在「熟悉的商品」上测出来的;换新商品,在补上它们的近似款之前,精确率会低一些。
那一轮 LLM 判了 16 条:8 条判 match,按我的标注全对;另外 8 条判 unclear,比如只写了「Anker Nano Power Bank」、没写容量的标题,这些都没计入价格。我也回头翻了被拒、但标题里带型号系列的商品,找漏判:品牌检查至少挡掉了四条:亚马逊两条 Stanley 大概率就是这款杯子,但标题和 URL slug 里都没有品牌名;Google 两张商品卡把鼠标品牌写成「Logicool」(Logitech 在日本的名字)和「Logi tech」。所以本文能说清楚的是精确率,召回率没有测。
为什么用 GPT-6 Luna,花了多少
我们的 Agent 便宜模型分档实测里,GPT-6 Luna 在短工具任务上 51/51 全对,单任务成本约为 GPT-6.1 Sol 的 1/20。这里只是给少量标题分三类,便宜档就够。
最后两轮共 4 次 Luna 调用,输入 286~440 token,输出 297~739 token,其中推理 token 就占了 256~705。这也是 max_tokens 设成 2000 的原因:我第一次设成 400,答到一半被截断,JSON 解析不了。GET /v1/tasks/<id>/cost 显示每次 $0.000193~$0.000398,第一轮合计 $0.00068,第二轮 $0.00042,和每百万 token 输入 $0.10、输出 $0.50 的标价对得上。
数据调用当天按标价不花钱:GET /v1/models/<id> 对三个端点都返回 base_price: "0",我在 /v1/tasks/<id>/cost 里查的三次数据调用也都结算为 $0.000000。这两个接口要带同一把 Bearer Key;公开模型页上也能看到同样价格。我截到的 DataForSEO 模型页和目录页都挂着「API Free Week」横幅,所以定时任务上线前请再确认一次价格。DataForSEO 外层结构里自带的 cost 字段(亚马逊 0.0033、Google 0.004)是供应商自己的记账,不是你在 SandBase 的账单。
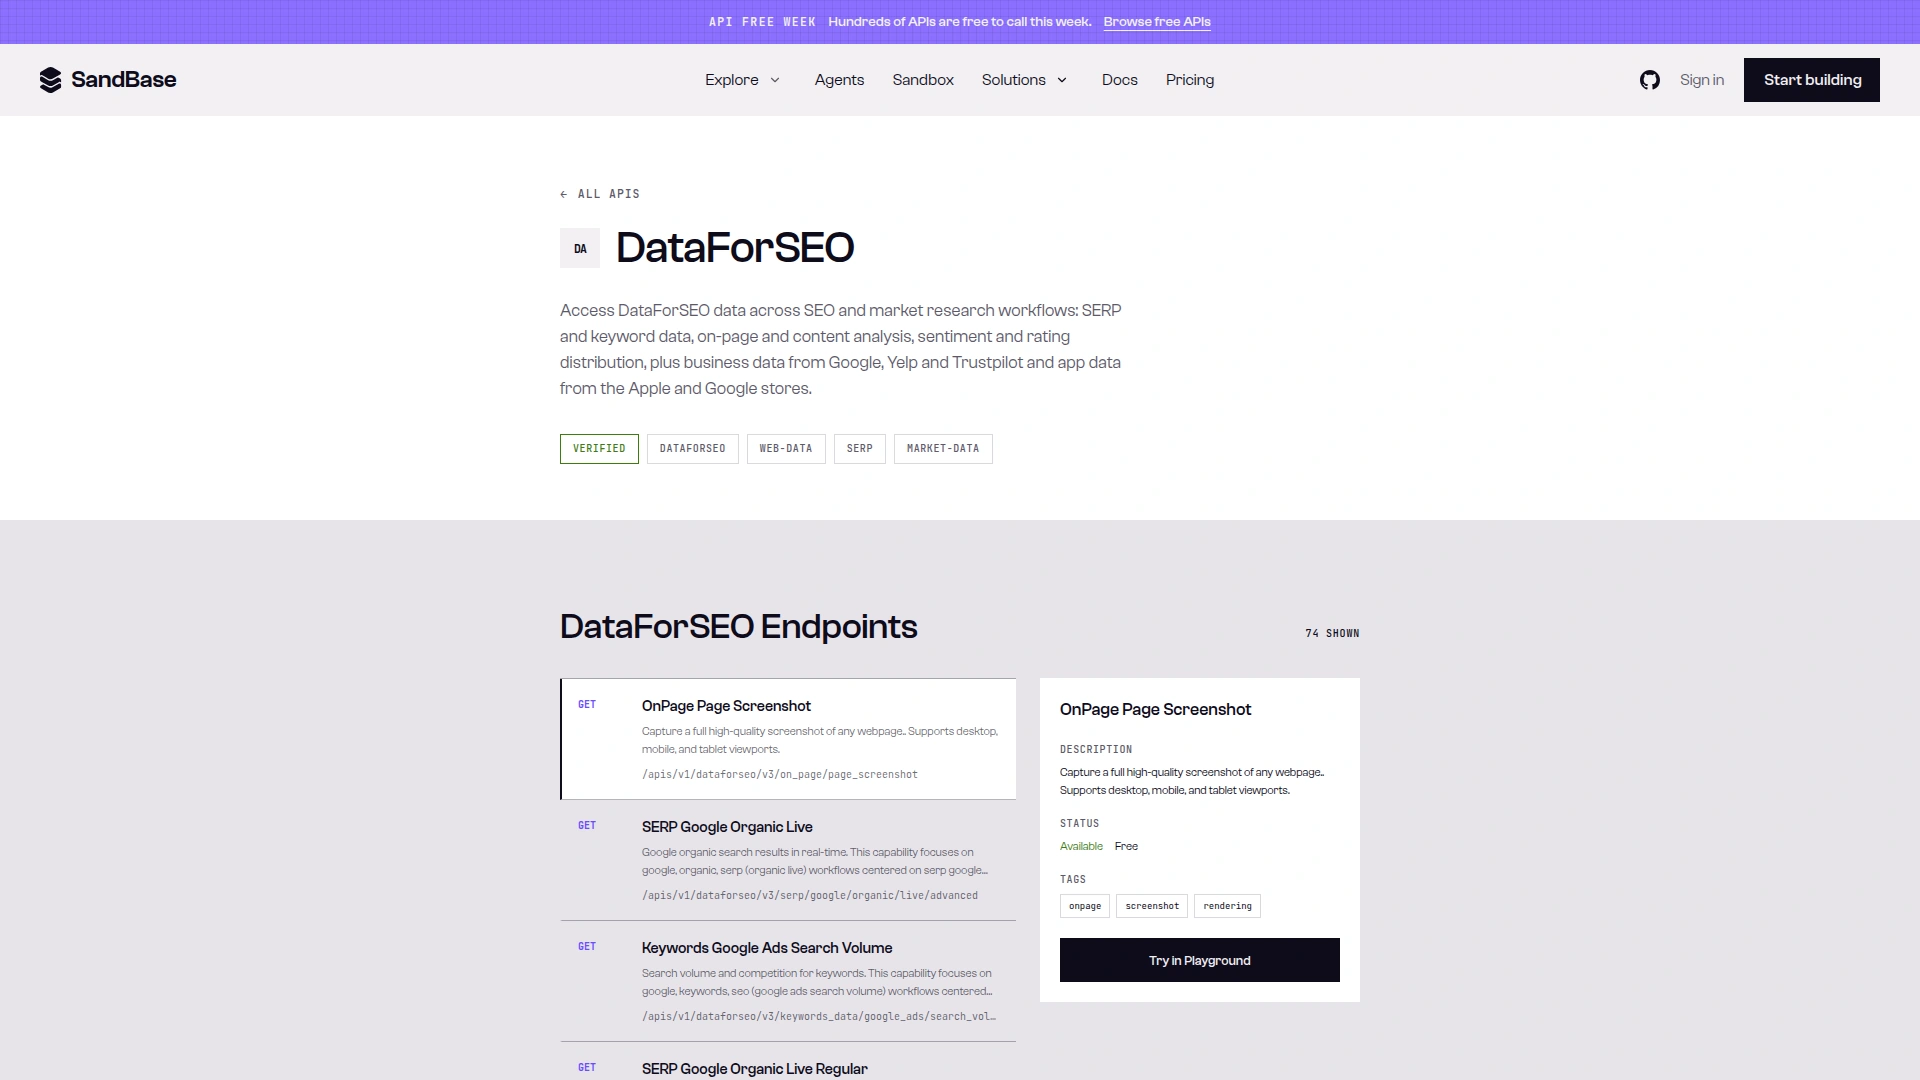
截图:DataForSEO 目录页列出 74 个端点,状态为 Available、Free,并挂着 API Free Week 横幅,所以「免费」只是当天的观察(2026-10-03 截取)。
局限和下一步
测试范围:三款品牌商品,只测美国,一天之内两轮正式运行加若干开发运行,每个来源只看第一页。没测其他国家、无品牌商品,也没测结果页里不出商品卡的查询。各平台排序带个性化、随时在变,一轮结果只描述那一刻的那批商品,不是市场全貌。
可以往这几个方向扩展:
- **给 Google 商品卡加卖家过滤。**只看全新零售价,就在算中位数前剔除或标记转卖平台卖家,第一轮就是反例。
- **锁定 SKU。**需要精确到某一个货号时,把颜色或料号写进规格,别只写型号系列。
- **定时跑、留历史。**每轮存一份
listings.csv,比较区间,不比单个数字。 - 单个来源往深挖。DataForSEO 关键词研究 Agent 讲了更多 SERP 端点;TikTok Shop 选品数据教程 讲了商品详情和评价。
想自己跑一遍,先看亚马逊商品 API 参考和 Chat Completions 指南,然后申请一把 SandBase API Key。
常见问题
为什么不直接用 Google Shopping 端点?
2026-10-03 实测,SandBase 上两条 Google Shopping 路由都在 completed 的任务里返回 DataForSEO 状态码 40402「Invalid Path」。DataForSEO 文档里 Google Shopping 商品是任务式接口,SandBase 目录里没有。能用的替代方案就是 Google 普通结果页上的商品卡。
Agent 怎么判断两条商品是同一件?
主要靠代码:先归一化标题,检查品牌和型号系列,排除配件、套装和兄弟款,再拿型号、容量、功率或尺寸和规格比对。只有缺属性的标题才交给 LLM。人工核对下,99 条计价匹配里 93 条正确。
这些价格都是新品价吗?
不一定。Google 商品卡里有 eBay、Mercari、Poshmark、Whatnot 的卖家,有一轮 Stanley 的 27 条匹配里他们占了 24 条。代码会标出写了「renewed」「used」的标题和异常价格,但标题没写的成色,它看不出来。
跑一轮要多少钱?
2026-10-03 数据端点标为 Free,结算 $0;LLM 这一步每轮(三款商品)$0.00042~$0.00068。活动结束后可能变价,先看模型页。
能换成我自己的商品吗?
可以。在 PRODUCTS 里加一项:搜索词、品牌、型号系列的正则、要比对的属性,以及要排除的兄弟款。先跑一次,把 listings.csv 里看到的近似款补进 other_models,再信中位数。