Instagram 公开数据 API:资料、帖子和 Reels | SandBase
用一套 REST API 读取 Instagram 公开资料、帖子、Reels、粉丝、评论和话题。无需 Instagram OAuth 或 SDK,一把 SandBase Key,为 Agent 而建。
用程序抓 Instagram 的公开数据,麻烦的从来不是你要做的那个功能,而是开头那一个小时:绕登录墙、维护 token、还要一个个字段去试,才知道粉丝数到底藏在哪个字段里。浏览器里明明看得到的公开数据,真要稳定地接进 Agent,往往先变成一个独立的小工程。
SandBase 的 Instagram 公开数据 API 就是来省掉这段的。它通过一组普通 REST 端点 /v1/api/{vendor}/{path},读取 Instagram 的公开资料、帖子、Reels、粉丝、评论和话题——一把 SandBase Key、同步返回 JSON,不走 Instagram OAuth,也不用装 SDK。端点参考只保证信封(id、status、model 和 outputs[0].data);下面展示的业务字段是示例结构、并非保证的 schema,请以真实响应为准核对具体字段。要直接做一个应用,可继续看 Instagram Reels 竞品监控工作流。
这不是 Meta 官方的 Instagram Graph API。 如果你要管理已授权的 Business/Creator 账号、发布内容、或读取只有账号所有者才能看的 insights,请用 Meta 的 Instagram Platform。而如果你的工作流需要的是公开、只读的发现或监控数据,就用 SandBase。想上手的话:获取 SandBase API Key、浏览 Instagram 端点。
先说结论
- 一套 API 读取 Instagram 资料、粉丝/关注、帖子、Reels、快拍、评论、话题和地点数据。
- 每个能力是独立的
POST /v1/api/instagram/<path>端点——body 里只传该端点的参数,无 SDK,一把SANDBASE_API_KEY。- 接口有
v1/v2/v3三代 schema。查询一个已知的公开用户名,请看 V2 单账号请求小节;原 V1、V3 示例仍按各自版本使用。- 只返回公开、只读数据;不能发帖、不走 Instagram OAuth 登录、也无法访问私密账号;用一把 SandBase API Key 鉴权。
你需要哪种 Instagram API?
| 你的需求 | 选谁 | 原因 |
|---|---|---|
| 发布内容、回复评论、或查看已授权的专业账号 | Meta Instagram Graph API | Meta 官方 API 为 Business/Creator 账号管理和所有者 insights 而设计。 |
| 读取公开的资料、帖子、Reel、话题、地点或粉丝数据 | SandBase Instagram 公开数据 API | 普通 REST 调用、一把 SandBase Key、只读工作流的结构化 JSON。 |
| 访问私密账号、私信、或需登录才能看的数据 | 都不行 | 这类数据不在公开数据 API 的范围内。 |
Instagram API 能拿到什么
这套 Instagram 公开数据 API 面向的是公开、只读的发现和监控场景——不做账号管理、也不碰私密数据。做分析、监控、研究类 Agent 会用到的数据,基本都在里面,按用途分几类:
- 用户数据——资料与简介、profile/brief 视图、用户 ID 与用户名互转、历史用户名、粉丝与关注列表、相似与相关账号。
- 内容——某用户的帖子、Reels、被标记帖子、转发、快拍和精选;按 ID、URL 或 shortcode 取单条帖子;oEmbed 数据。
- 互动——帖子评论、评论回复、点赞,以及评论/文案翻译。
- 发现——按话题、地点、音乐取帖子;explore 信息流和推荐 Reels。
- 搜索——用户、话题、地点(含按坐标)、音乐、Reels,以及综合搜索。
- 工具——media ID 与 shortcode 互转,以及从 URL 提取 shortcode。
- 批量——一个
bulk组,覆盖 profile、posts、hashtag-posts、search 和内容抽取;接入前请以线上 catalog 为准确认可用端点。
不用记这份清单。下面这个调用模式,对每一个接口都一样。
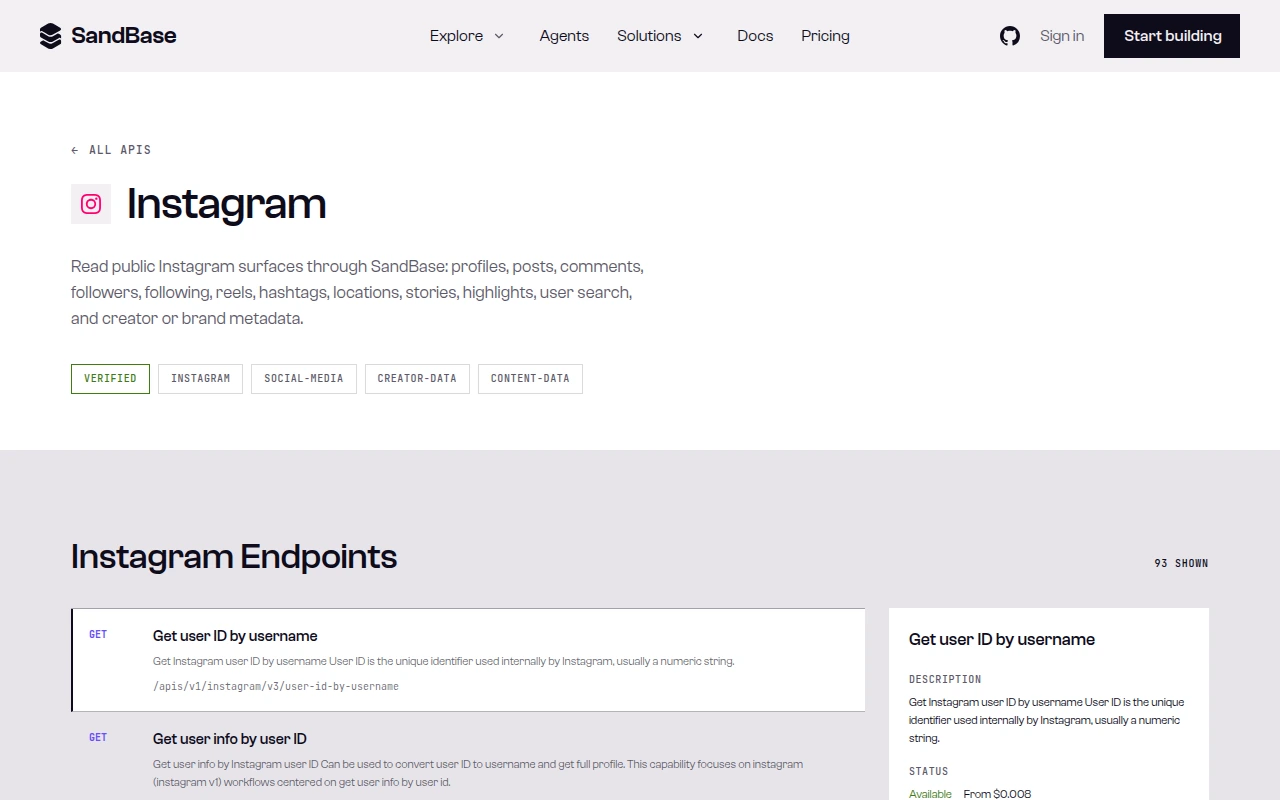 沿用的历史 catalog 截图:带标签的概览、端点列表和 GET 路径。不是 2026 年 11 月 5 日新截图,也不证明 V2 业务响应。
Instagram 提供什么,SandBase 补什么
公开数据本身来自 Instagram,SandBase 既不拥有也不运营 Instagram,它做的是为合规的公开数据场景提供一层统一的 API 接入:每个能力对应一个固定的端点名,鉴权收敛成一把 Key,响应结构也稳定可预期。这样一来,“先按用户名查到账号 → 再拉粉丝 → 再读他们的近期帖子”这样一条链路,Agent 就能顺着一套约定走完,不用为每一步各配一套鉴权和解析。
快速上手:第一次调用
每个能力都有自己的 REST 端点,路径为 /v1/api/{vendor}/{path},与 model 名一一对应——instagram/v1/user-info-by-username 就在 /v1/api/instagram/v1/user-info-by-username 调用。SandBase 没有专属 SDK,这些都是普通 HTTP 调用。按用户名取资料:
import os
import requests

resp = requests.post(
    "https://api.sandbase.ai/v1/api/instagram/v1/user-info-by-username",
    headers={
        "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={"username": "nasa"},  # 只传该端点的参数
)
resp.raise_for_status()
body = resp.json()  # 同步返回,JSON 即结果,无需轮询
if not isinstance(body, dict):
    raise RuntimeError("Instagram response must be a JSON object")
if body.get("status") != "completed":
    error = body.get("error")
    message = error.get("message") if isinstance(error, dict) else None
    raise RuntimeError(
        message if isinstance(message, str) and message.strip()
        else "Instagram request did not complete"
    )

# 业务字段是示例结构、并非保证的 schema,请用防御式读取。
profile = body["outputs"][0]["data"].get("data", {}).get("user", {})
print(profile.get("username"), profile.get("edge_followed_by", {}).get("count"))curl -X POST https://api.sandbase.ai/v1/api/instagram/v1/user-info-by-username \
-H "Authorization: Bearer $SANDBASE_API_KEY" \
-H "Content-Type: application/json" \
-d '{"username": "nasa"}'这个端点只有 username 一个必填参数。调哪个能力已经写在 URL 里了,所以 body 里只放这个端点自己的参数就行。数据端点都是 sync 模式,请求返回的 JSON 就是最终结果,没有 task ID,也不用轮询。
响应的外层结构是固定的:一个 id、一个 status(成功时是 completed)、model 名称,再加一个 outputs 数组,真正的业务数据放在它唯一那个元素的 data 里。下面是 user-info-by-username 的示例响应结构——其中业务字段是示例结构、并非保证的 schema,资料对象字段很多、这里只截取一部分,粉丝数等实时数值也会随时间变化;请以真实响应为准核对具体字段:
{
  "id": "1997037f-ddc0-40ab-b96f-dc32a524ebb0",
  "status": "completed",
  "model": "instagram/v1/user-info-by-username",
  "outputs": [
    {
      "data": {
        "data": {
          "user": {
            "username": "nasa",
            "full_name": "NASA",
            "is_verified": true,
            "is_private": false,
            "biography": "Making the seemingly impossible, possible. ✨",
            "external_url": "https://www.nasa.gov/",
            "edge_followed_by": { "count": 104335721 },
            "edge_follow": { "count": 89 },
            "edge_owner_to_timeline_media": { "count": 4934 }
          }
        }
      }
    }
  ]
}
如果 status 是 failed 或 timeout,响应里会有 error(带 type 和脱敏过的 message),且不会有 outputs,所以取 outputs[0].data 之前先判断一下 status。另外注意资料本身在 outputs[0].data.data.user 这一层——第一次接的时候,先打一条真实响应出来,把路径对准一次。
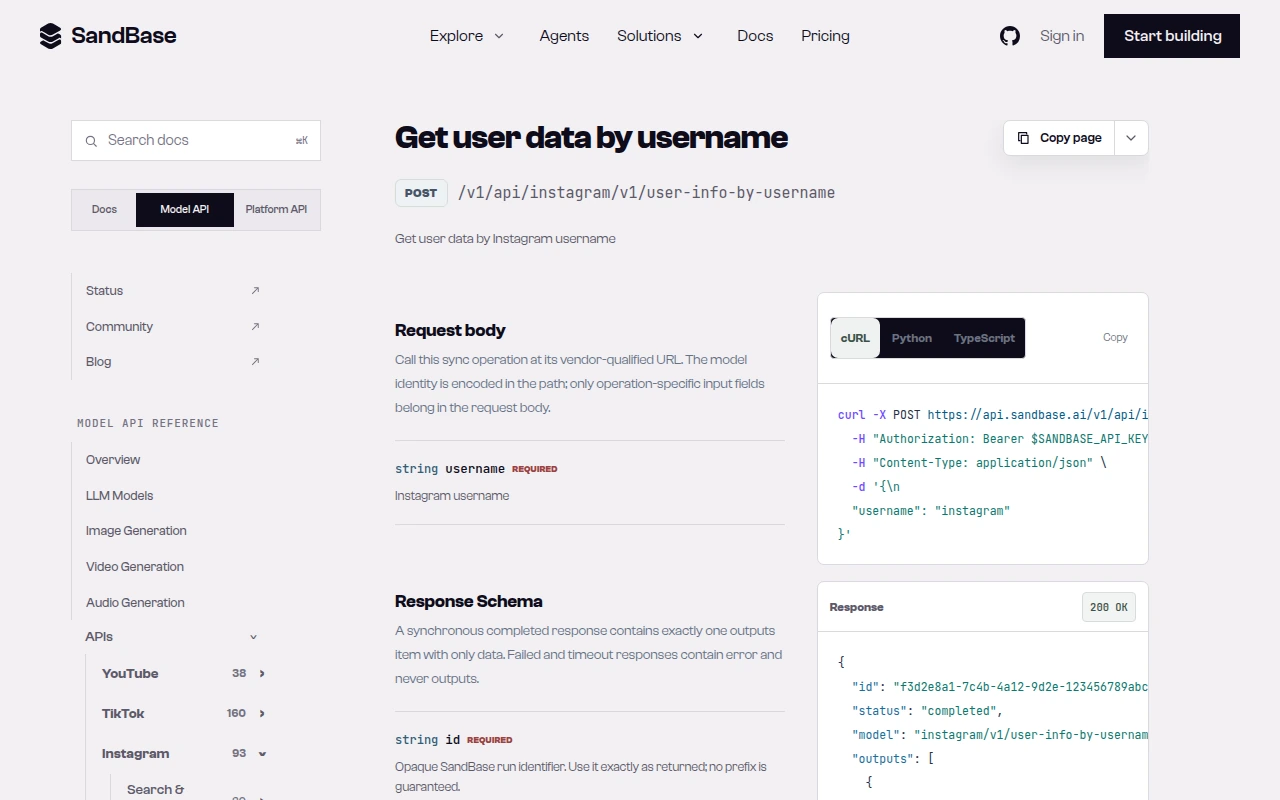 沿用的历史 V1 参考截图:展示 vendor-qualified POST 路由及操作参数,不作为 V2 响应契约或本轮新增 API 实测的证据。
用 Python 请求 Instagram 公开账号资料
手里已经有一个公开账号的用户名,只想补一条达人候选或品牌研究记录,就从 Instagram User Profile V2 请求参考 开始。下面用 Python requests 调用 Model API 的 POST 路由,不是目录里的 GET 路径。请求体只传一个不带 @ 的 username,Key 放在服务端环境变量中。若你已知数字用户 ID,也可以改传字符串类型的 user_id;二者择一,不是两个字段都必填。
边界先说清:这里只做公开、只读的单账号查询,不拉粉丝名单,也不访问私密账号、私信或仅账号所有者可见的 insights。这段代码标为 not run:未调用真实 API。2026 年 11 月 5 日运行的是离线 mock,用来检查请求设置和错误分支,不代表接口可用性或业务成功已验证。收到成功的 HTTP 状态,仍不能判断资料查询是否完成;raw_response 只留在内存中,供获准的响应核验使用,不记录 Key 或完整响应。
# Request-only example: NOT RUN against the real API; offline mocks only.
import os
import requests

endpoint = "https://api.sandbase.ai/v1/api/instagram/v2/user-info"
key = os.environ["SANDBASE_API_KEY"]  # server environment; never log it
username = "nasa"  # one public handle, without @

if not key.strip():
    raise ValueError("Set SANDBASE_API_KEY in the server environment")
if not username or username.startswith("@"):
    raise ValueError("Use one username without @")

try:
    response = requests.post(
        endpoint,
        headers={
            "Authorization": f"Bearer {key}",
            "Content-Type": "application/json",
        },
        json={"username": username},
        timeout=(5, 30),
    )
    response.raise_for_status()
    raw_response = response.json()  # retain for approved schema validation only
except requests.exceptions.JSONDecodeError:
    raise RuntimeError("Response was not valid JSON") from None
except requests.Timeout:
    raise RuntimeError("Profile request timed out; no profile was validated") from None
except requests.RequestException:
    raise RuntimeError("Profile request failed at the HTTP/transport layer") from None
except ValueError:
    raise RuntimeError("Response was not valid JSON") from None

print("JSON received for review; business success and profile remain unvalidated.")
timeout=(5, 30) 只是客户端示例配置,不是延迟实测或服务 SLA。JSON 可以是 null、数组或对象,这段代码都只接收,不据此认定拿到了有效资料。JSON 解码异常同时属于 requests 异常和 ValueError,因此先捕获它,避免误报成传输失败。末尾那句输出只表示 JSON 已收到、待核验,不表示查询成功。
这里暂不交付 V2 业务解析器。下一步需要用户核准脱敏的完整成功响应和失败 fixture,确认顶层类型、业务状态、outputs 结构,以及到 profile 的唯一字段路径。上面的 V1 示例和 V2 文档里的截短 payload 都不能代替完整契约;别沿用 V1 的解析路径,也别逐层尝试多个 data 路径,直到碰巧读到值。
研究记录中的空值也要保留边界。简介、网站或分类为空时,可能没有可用信息;计数缺失或为 null,就记为未知,不能填成零。未知布尔标记也不是 false。follower_count 是粉丝数量,不是粉丝身份名单或历史序列;is_verified 是账号标记,不是身份认证;is_private 不会赋予私密内容的读取权限,也不承诺能拿到邮箱。
以后若要用 Python 给 Instagram 用户名补充研究资料,应把请求失败单独记录,别把超时当成“简介为空的有效账号”。客户端如何保存研究记录,不等于端点支持原生 bulk 输入。本节无需分页,也不提供候选列表循环或 CSV 导出;不承诺实时数据、受众人口画像或不限量免费访问。请求与字段边界依据 2026 年 11 月 5 日查阅的 V2 公开参考,完整响应契约仍待核准。
能力速查
| 能力簇 | 代表接口 | 典型用途 |
|---|---|---|
| 用户资料与 ID | instagram/v1/user-info-by-username | 把用户名解析成资料字段和用户 ID |
| 粉丝 / 关注 | instagram/v3/user-followers | 受众与关系网分析(分页) |
| 帖子与 Reels | instagram/v3/user-posts、instagram/v3/user-reels | 内容监控、互动追踪 |
| 评论与翻译 | instagram/v3/post-comments、instagram/v3/bulk-translate-comments | 情感分析、多语言评论处理 |
| 话题 / 地点 / 音乐 | instagram/v2/hashtag-posts、instagram/v3/hashtag-posts | 趋势与活动发现 |
| 搜索 | instagram/v3/search-users | 查找账号、话题或地点 |
| ID 工具 | instagram/v1/shortcode-to-media-id | 把帖子 URL 转成 media ID |
接口分 v1、v2、v3 三代。查询一个已知公开用户名时,请按 V2 单账号请求小节 处理,不套用通用的 V3 优先规则。表格和列表示例保留原版本标签,其中字段路径和分页规则不能搬到 V2。
常见用例
用 Instagram profile API 做达人发现
先用 instagram/v1/user-info-by-username 解析账号,再读 edge_followed_by.count、分类和简介,按体量和领域筛出候选达人。输入:一个用户名或一批候选。输出:每个达人一条可对比的资料记录。端点:user-info-by-username,需要先找候选时配合 instagram/v3/search-users。
若已知一个公开账号的用户名,请看 V2 单账号请求与字段边界;这里不迁移原 V1 示例,也不新增 bulk 输入。
用 Instagram Reels API 做竞品监控
定时拉某竞品的近期帖子和 Reels,比较不同时间点的互动变化。输入:一个用户名。输出:带计数的帖子/Reels 时间序列。端点:instagram/v3/user-posts 和 instagram/v3/user-reels。
用 Instagram hashtag API 做活动研究
拉某活动或主题标签下的近期帖子,判断热度并找出高互动账号。输入:一个话题(不带 #)。输出:分页的话题帖子列表。端点:instagram/v2/hashtag-posts,feed_type 设为 top(用 pagination_token 翻页)。在 2026-10-01 的一次测试里,instagram/v3/hashtag-posts 更像按时间排列的最新帖子流,大多互动很低,适合看最新内容而不是热门内容。完整工作流看 Instagram 话题标签研究教程。
一个小工作流:取某账号的粉丝
支持分页的列表端点都用同一套约定:第一次请求不传 max_id,之后每次把上一页返回的游标带上,接着往下翻。下面就是”先查账号、再一页页拉粉丝”的写法:
import os
import requests

BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",  # key 不要写死在代码里
    "Content-Type": "application/json",
}

def call(endpoint, **params):
    resp = requests.post(f"{BASE}/{endpoint}", headers=HEADERS, json=params)
    resp.raise_for_status()
    body = resp.json()
    if not isinstance(body, dict):
        raise RuntimeError("Instagram response must be a JSON object")
    if body.get("status") != "completed":            # 读 outputs 前先判断 status
        err = body.get("error")
        message = err.get("message") if isinstance(err, dict) else None
        raise RuntimeError(
            message if isinstance(message, str) and message.strip()
            else "Instagram request did not complete"
        )
    return body["outputs"][0]["data"]

def all_followers(username, pages=3):
    collected, cursor = [], None
    for _ in range(pages):
        params = {"username": username, "count": 100}
        if cursor:
            params["max_id"] = cursor
        data = call("instagram/v3/user-followers", **params)
        collected.extend(data.get("users", []))
        cursor = data.get("next_max_id")   # 分页游标在 data 里
        if not cursor:
            break  # 没有更多分页
    return collected

followers = all_followers("nasa", pages=2)
print(f"共收集 {len(followers)} 个粉丝")
游标在响应的 data.next_max_id 里,下一页请求把它当作 max_id 传进去,取不到就说明翻到底了。count 每页 1–100 条(默认 12)。有一点是我看了真实响应才发现的:资料字段藏在好几层里面,游标也在 data 里而不是最外层——所以我会先拉一条真实 payload 把路径对准,再动手写解析,而不是照着想当然写。
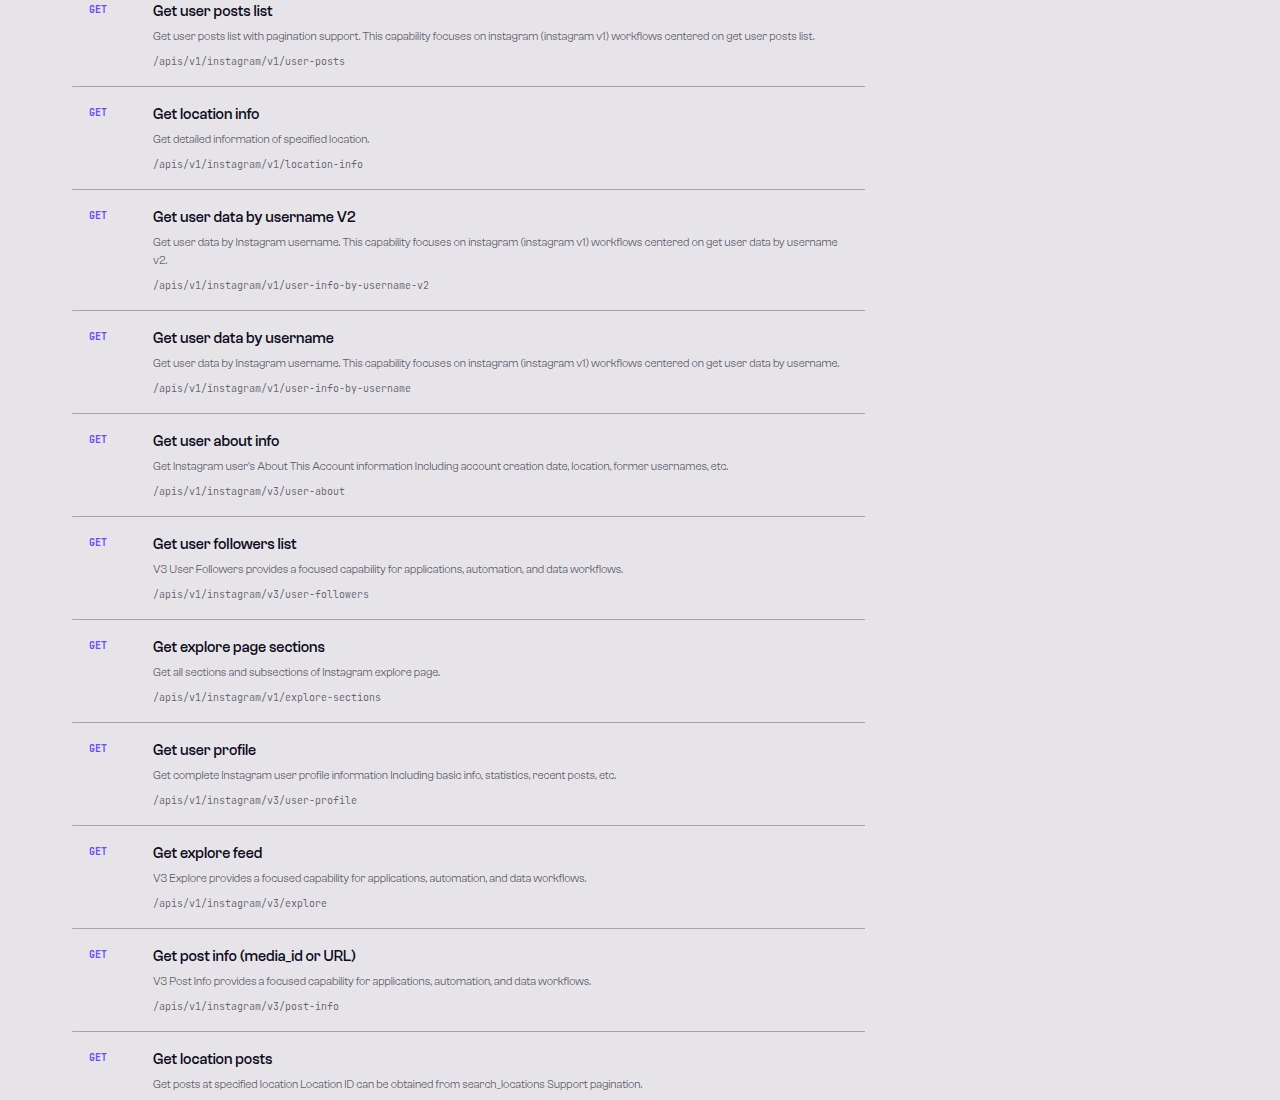 沿用的历史端点列表截图,展示
user-followers、user-posts、user-about 等说明和路径,不证明 V2 字段结构或当前接口执行情况。
边界与限制
- 只读公开数据。 这些端点只读公开资料和内容,不能发帖、点赞、关注或私信,私密账号也拿不到。
- 注意速率和量级。 数据能不能拿到、拿多全,都按尽力而为对待:空结果和 HTTP 429 要做好退避重试;控制并发与节奏,接入更高量级的任务前先按线上 catalog 确认可用端点。
- 字段结构会随来源变。 响应字段跟着上游走,不同端点、不同版本都可能不一样。别照着文档想当然,先拉一条真实响应,按实际结构来写。
- 这不是和 Instagram 的官方合作。 SandBase 只是把公开数据的接入方式统一了,并不会给你超出源数据本身的权限。具体怎么用,请自行遵守 Instagram 的条款和相关隐私规定。
常见问题
需要 Instagram token 或应用审核吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权,不必注册 Instagram 应用,也不用为这些读取接口管理 OAuth。
v1、v2、v3 有什么区别?
是同一个平台的三代 schema。v3 覆盖最全、也最新,大多数列表端点都支持分页;v1/v2 继续保留,方便那些已经在用它们的项目不用改。
怎么把帖子 URL 转成 media ID?
先从 URL 里取出 shortcode(即 instagram.com/p/<shortcode>/ 中的那段),调用 instagram/v1/shortcode-to-media-id;如果你只有原始 URL,可先用 instagram/v3/extract-shortcode 提取。
调用是同步的吗?
是。Instagram 数据端点是 sync 模式——JSON 响应就是结果,没有轮询步骤。
分页怎么用?
支持分页的列表端点用 max_id 游标:首次请求省略它,之后传上一次响应返回的值取下一页。count 控制每页大小(user-followers 最多 100,默认 12)。
能读私密账号或需要登录才能看的数据吗? 不能。API 只返回公开数据。私密账号、私信,以及任何得登录成某个用户才能做的操作,都不在范围内。
某个任务该调哪个端点?
查询一个已知公开用户名,先看 V2 request-only 说明。其他任务按能力簇选端点,再核对该版本的参考。原示例中,取信息流用 instagram/v3/user-posts,取话题热门帖子用 instagram/v2/hashtag-posts(feed_type 设为 top),找账号用 instagram/v3/search-users。
能拿 Reels、快拍和精选吗?
可以。Reels 用 instagram/v3/user-reels,当前快拍用 instagram/v3/user-stories,保存的精选用 instagram/v3/user-highlights(配合 highlight-stories)。
触发限流会怎样? 高负载下可能返回 HTTP 429。用有上限的指数退避重试;控制并发与节奏,而不是全速循环打单条调用。
从一次资料请求开始
已有一个公开用户名,就从 V2 单账号请求 开始,核准响应 fixture 后再写业务解析。下面保留的 V1 参考仍对应原快速上手示例,不是 V2 的响应契约。准备好了就:
觉得有用?分享给更多人