Instagram Reels 竞品监控 API:Python 实战
用关键词搜索、创作者 Reels、帖子详情和评论接口搭建可复现的 Instagram Reels 公开竞品监控。
能用的 Reels 竞品监控不能只列播放量最高的帖子。它需要固定的竞品集合、明确的观察窗口、创作者基线,以及区分「一次偶然爆款」和「长期反复奏效的内容格式」的方法。本文用 SandBase Instagram API 目录中的四个公开数据接口完成这条链路。
实测日期为 2026 年 10 月 25 日(UTC),关键词是 “AI tools”。文中的嵌套字段来自当日响应,不代表 Instagram 永远维持同一结构。需要先了解全部接口时,可读 Instagram 公开数据 API 指南。
先说结论
- 关键词 Reels 搜索负责发现市场,创作者 Reels 负责建立稳定基线。
- 保存 shortcode、抓取时间和原始计数,所有比率在本地计算。
- 搜索使用
pagination_token,创作者列表使用page_info.end_cursor;两种游标不能混用。- 评论只保留聚合主题和数量,不应积累评论者身份信息。
实测响应链路
搜索结果位于 data.items,同一响应还返回 count 和顶层 pagination_token。第一条结果对研究问题存在明显噪声,因此排序前必须先做标题与文案相关性过滤。单条 Reel 包含 shortcode、播放量和评论数,足以建立一条带日期的发现记录。
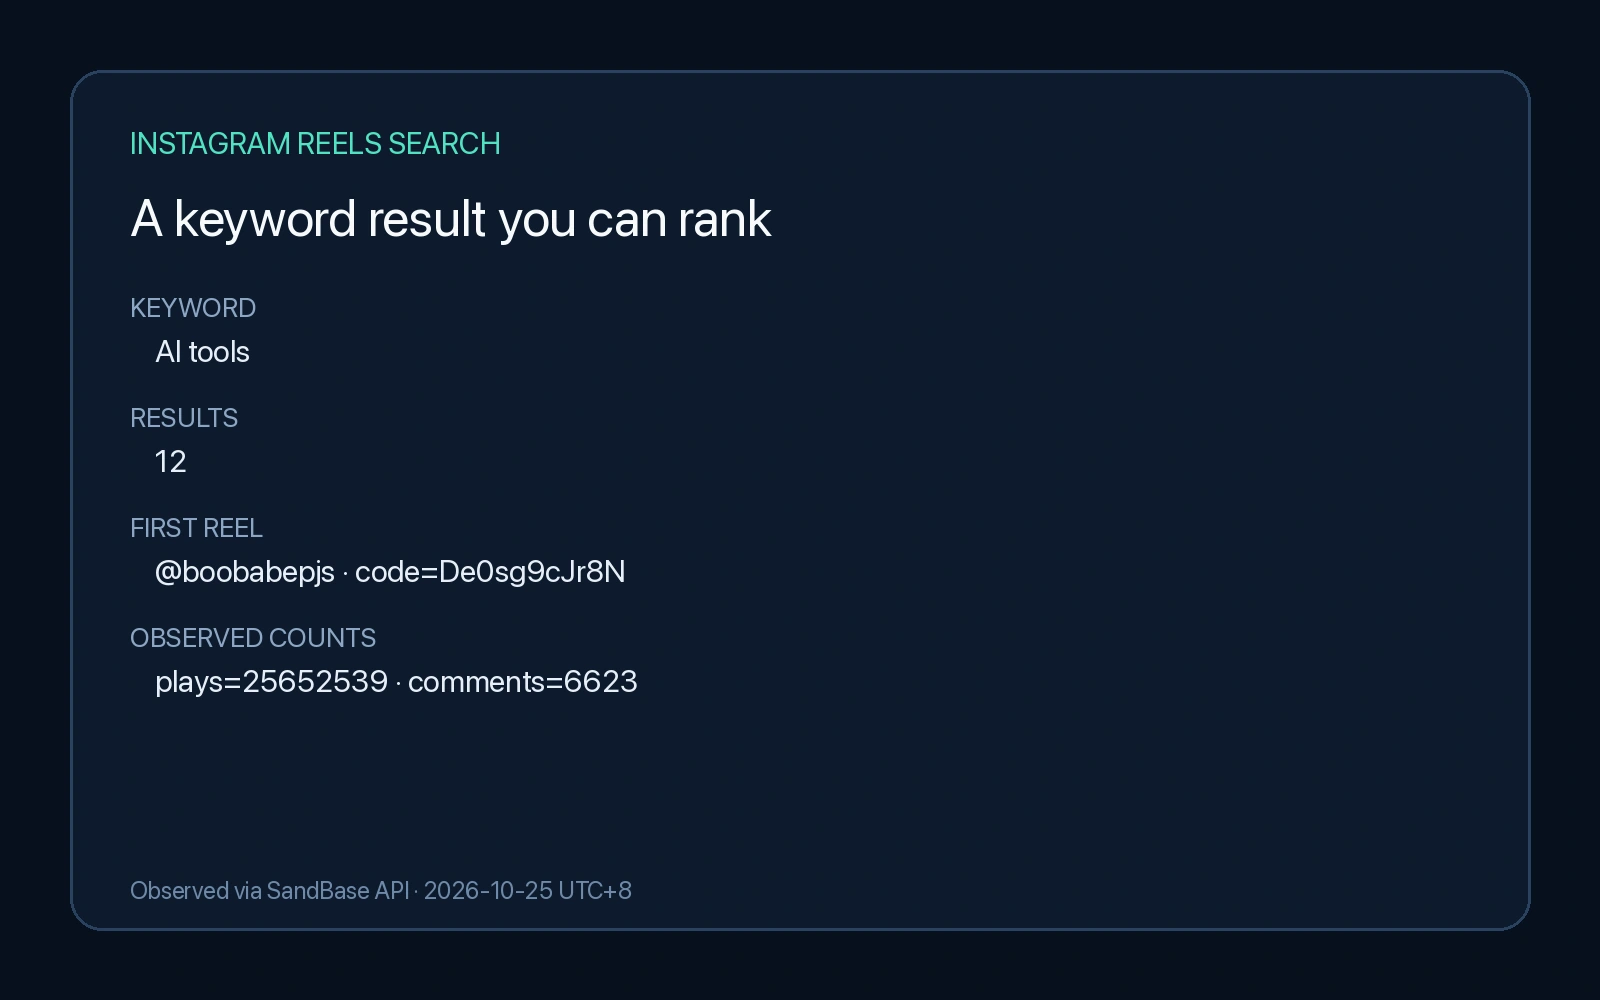 实测搜索返回创作者、shortcode、播放量、评论数和翻页令牌。
user-reels 返回创作者历史及 page_info。向后翻页要把 end_cursor 放进 after;关键词搜索则继续使用 pagination_token。
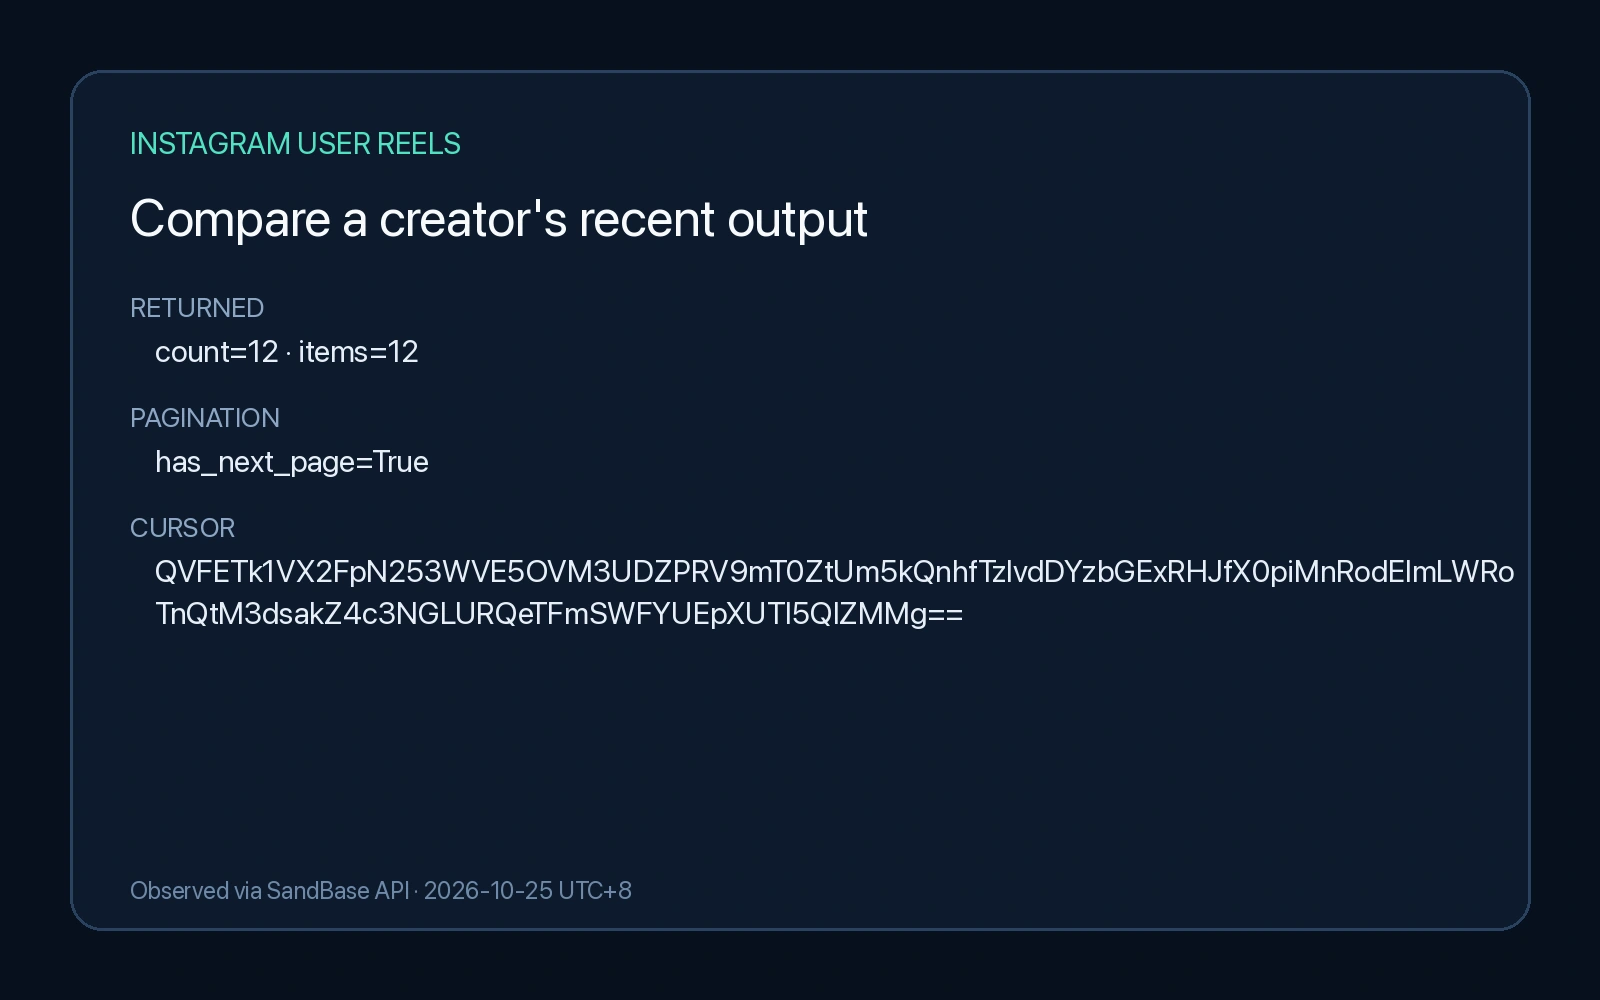 创作者历史提供基线,用来判断一条高播放作品是否只是离群值。
评论请求使用 sort_by: popular,也会返回自己的分页令牌。评论能够补足播放量看不到的重复问题和反对意见,但监控报告只需要主题,不需要用户档案。
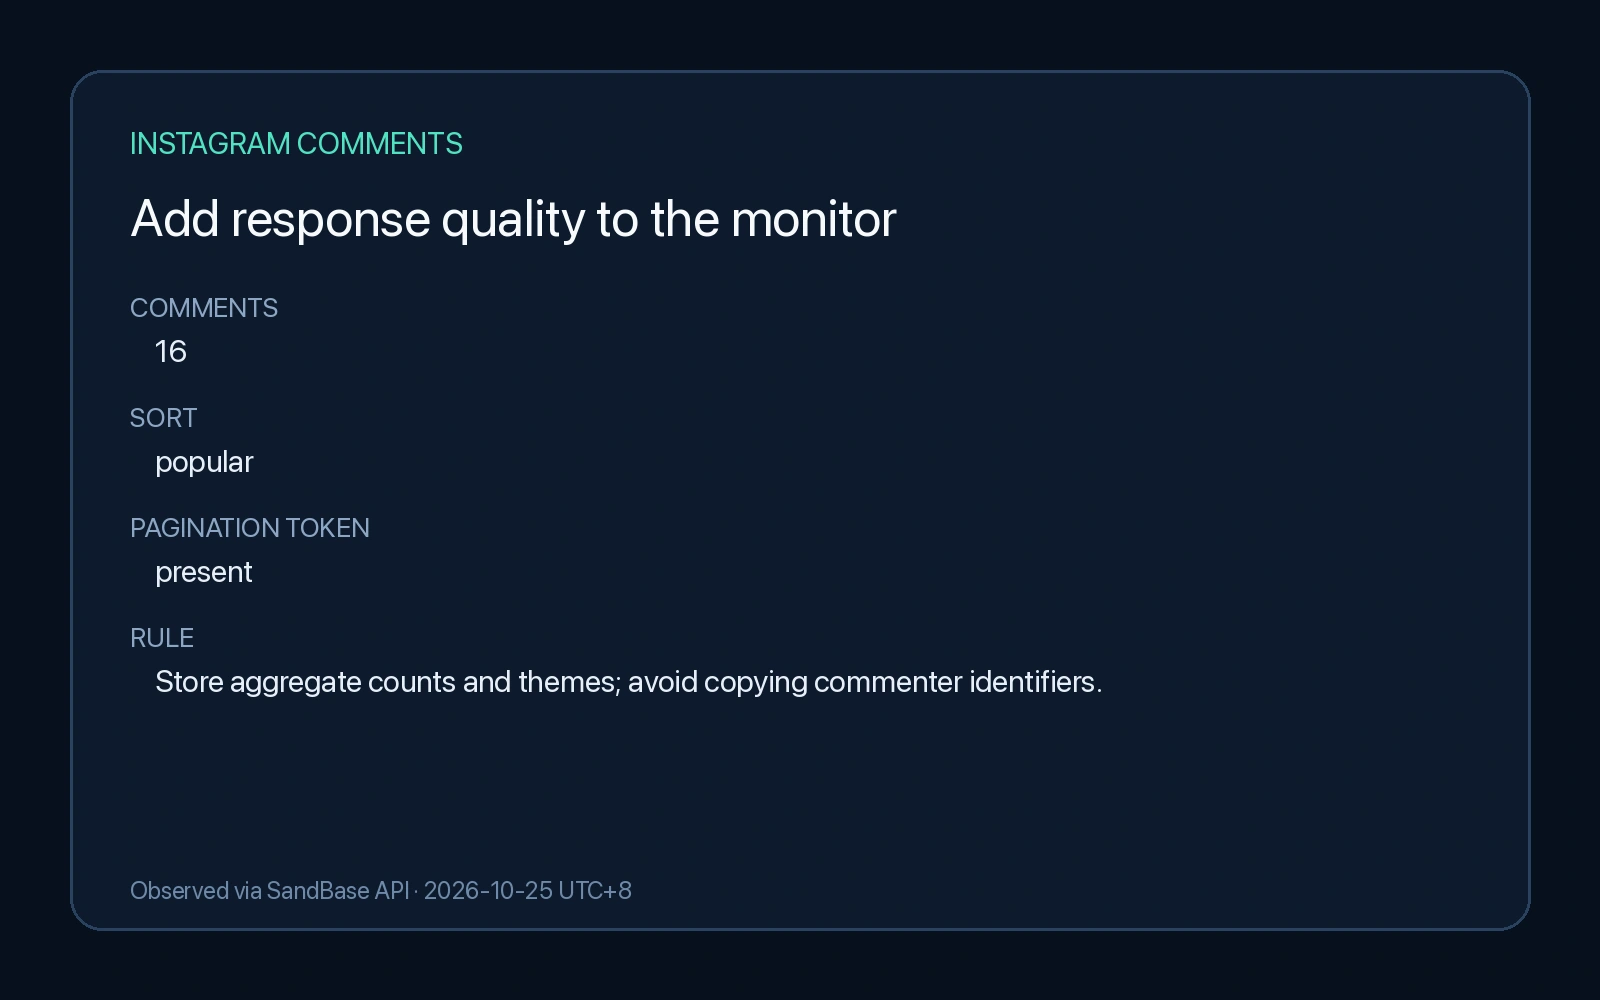 提炼评论主题即可改善选题,不必建立评论者数据库。
安装和严格调用函数
python -m pip install requests
export SANDBASE_API_KEY="your_key_here"
import os, time, requests
BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
"Content-Type": "application/json"}
def call(model, payload, retries=2):
for attempt in range(retries + 1):
r = requests.post(f"{BASE}/{model}", headers=HEADERS,
json=payload, timeout=90)
if r.status_code < 500 and r.status_code != 429:
r.raise_for_status(); break
if attempt == retries: r.raise_for_status()
time.sleep(2 ** attempt)
body = r.json()
if body.get("status") != "completed":
raise RuntimeError(body.get("error") or body.get("status"))
try: return body["outputs"][0]["data"]
except (KeyError, IndexError, TypeError) as exc:
raise RuntimeError("Missing outputs[0].data") from exc搜索并正确翻页
def search_reels(keyword, pages=2):
    token, rows, seen = None, [], set()
    for _ in range(pages):
        payload = {"keyword": keyword}
        if token: payload["pagination_token"] = token
        page = call("instagram/v2/search-reels", payload)
        for reel in (page.get("data") or {}).get("items") or []:
            code = reel.get("code")
            if not code or code in seen: continue
            seen.add(code)
            caption = reel.get("caption") or {}
            user = caption.get("user") or {}
            rows.append({"code": code, "username": user.get("username"),
                         "caption": caption.get("text"),
                         "plays": reel.get("ig_play_count"),
                         "likes": reel.get("like_count"),
                         "comments": reel.get("comment_count"),
                         "captured_at": "2026-10-25"})
        token = page.get("pagination_token")
        if not token: break
    return rows
本次第二页实测需要同时发送原关键词和令牌。任务状态应把查询条件与游标一起保存,这也方便之后审计。
加入创作者基线
def creator_reels(username, pages=2):
    after, rows = None, []
    for _ in range(pages):
        payload = {"username": username, "first": 12}
        if after: payload["after"] = after
        page = call("instagram/v3/user-reels", payload)
        rows.extend(page.get("items") or page.get("data") or [])
        info = page.get("page_info") or {}
        if not info.get("has_next_page"): break
        after = info.get("end_cursor")
        if not after: raise RuntimeError("missing end_cursor")
    return rows
基线建议用中位数而不是平均数,否则一条爆款会拉高整个账号。报告必须同时写样本量与抓取日期。单条播放量除以创作者样本中位数,可以得到直观的相对指数;它只能说明相对表现,不能证明某个 Hook 导致了结果。
入选短名单后再调用帖子详情和热门评论:
def inspect_reel(code):
    info = call("instagram/v2/post-info", {"code_or_url": code})
    comments = call("instagram/v2/post-comments", {
        "code_or_url": code, "sort_by": "popular"
    })
    raw = (comments.get("data") or {}).get("items") or []
    sample = [{"position": i, "text": item.get("text")}
              for i, item in enumerate(raw[:50]) if item.get("text")]
    return {"post": info.get("data"), "comment_sample": sample}
先本地排序再补详情,可以减少无效调用和等待时间。最小化文本样本只用于有上限的主题提取,聚合主题和数量写入报告后立即丢弃;原始评论对象及其中的用户资料不能落库。
参数速查
| 接口 | 必填 | 可选项 | 分页 |
|---|---|---|---|
instagram/v2/search-reels | keyword | pagination_token | 搜索返回的 token |
instagram/v3/user-reels | username | first、after、last、before | page_info.end_cursor |
instagram/v2/post-info | code_or_url | 无 | 无 |
instagram/v2/post-comments | code_or_url | sort_by、pagination_token | 响应 token |
生产环境护栏
竞品名单应由研究负责人确认,并限制每次运行的账号数和页数。数据采用追加快照,不要用新播放量覆盖旧记录。媒体签名 URL 会过期,也不应进入日志;稳定引用应使用 shortcode 或公开帖子链接。结构变化需要报警,可选字段为空则不必报警。
报告里要把观察与推断分开:「抓取时播放 592,961」是观察,「这个开头造成高播放」是推断。周报可以列相对指数最高的作品、反复出现的 Hook 和问题、样本量与人工检查链接。
常见问题
- 没有用户名时,保留发现记录但跳过创作者补全。
- 多页重复帖子按 shortcode 去重。
- 媒体 URL 过期时使用 shortcode 找回公开帖子。
- 缺少点赞数就保留为空,不能拿播放量代替。
- 创作者基线随时间变化属于正常现象,应比较同规则的带日期快照。
这能代替账号后台数据吗?
不能。这里只观察公开帖子。触达、留存和转化等自有账号指标需要 Instagram 授权产品与对应权限。
可以算互动率吗?
只有分母明确且确实可用时才可以。应精确标注是基于播放量还是粉丝数,并保留原始计数。
当前参数去哪里核对?
以 Instagram API 目录为准;接口可用性和嵌套字段可能在本文实测后变化。