TikTok Creator Search Insights API:自动发现内容缺口
用 TikTok Creator Search Insights、受众维度、趋势和相关视频搭建内容缺口研究流程,并正确处理游标分页。
TikTok Creator Search Insights 不只是热门词榜单。它会标出平台认为存在「内容缺口」的搜索词,还能继续查看受众维度、趋势背景和相关视频。把这四类信息串起来,就能做一个实用的选题研究流程:先广泛发现,再用真实视频验证,最后由编辑决定是否立项。
本文使用 SandBase TikTok API 目录里的四个接口,所有调用完成于 2026 年 10 月 25 日(UTC)。正文中的字段来自当日真实响应,只代表实测观察;参数约束仍以接口页为准。如果目标是找账号、看主页和近期作品,请读另一篇 TikTok 创作者研究 API 指南。
先说结论
- 发现阶段使用
creator-search-insights和tab: content_gap,不能只凭热度自行判断「供给不足」。query_id_str必须按字符串保存,详情和趋势接口都依赖它。- 选题进入 Brief 前,再用相关视频接口检查搜索结果是否真的匹配。
- 受众维度为空就是未知,不能补成 0,也不能让模型猜一个画像。
这次实测拿到了什么
首个请求限定 Science、英文、10 条结果以及 content_gap 标签,响应包含 10 个词、cursor: 10 和 has_more: true。第一条是 “mount hood”,平台标签为 content_gap,热度 70,相关视频数 1,020。这些数值只是当时快照,不是流量预测,也不是 SEO 难度。
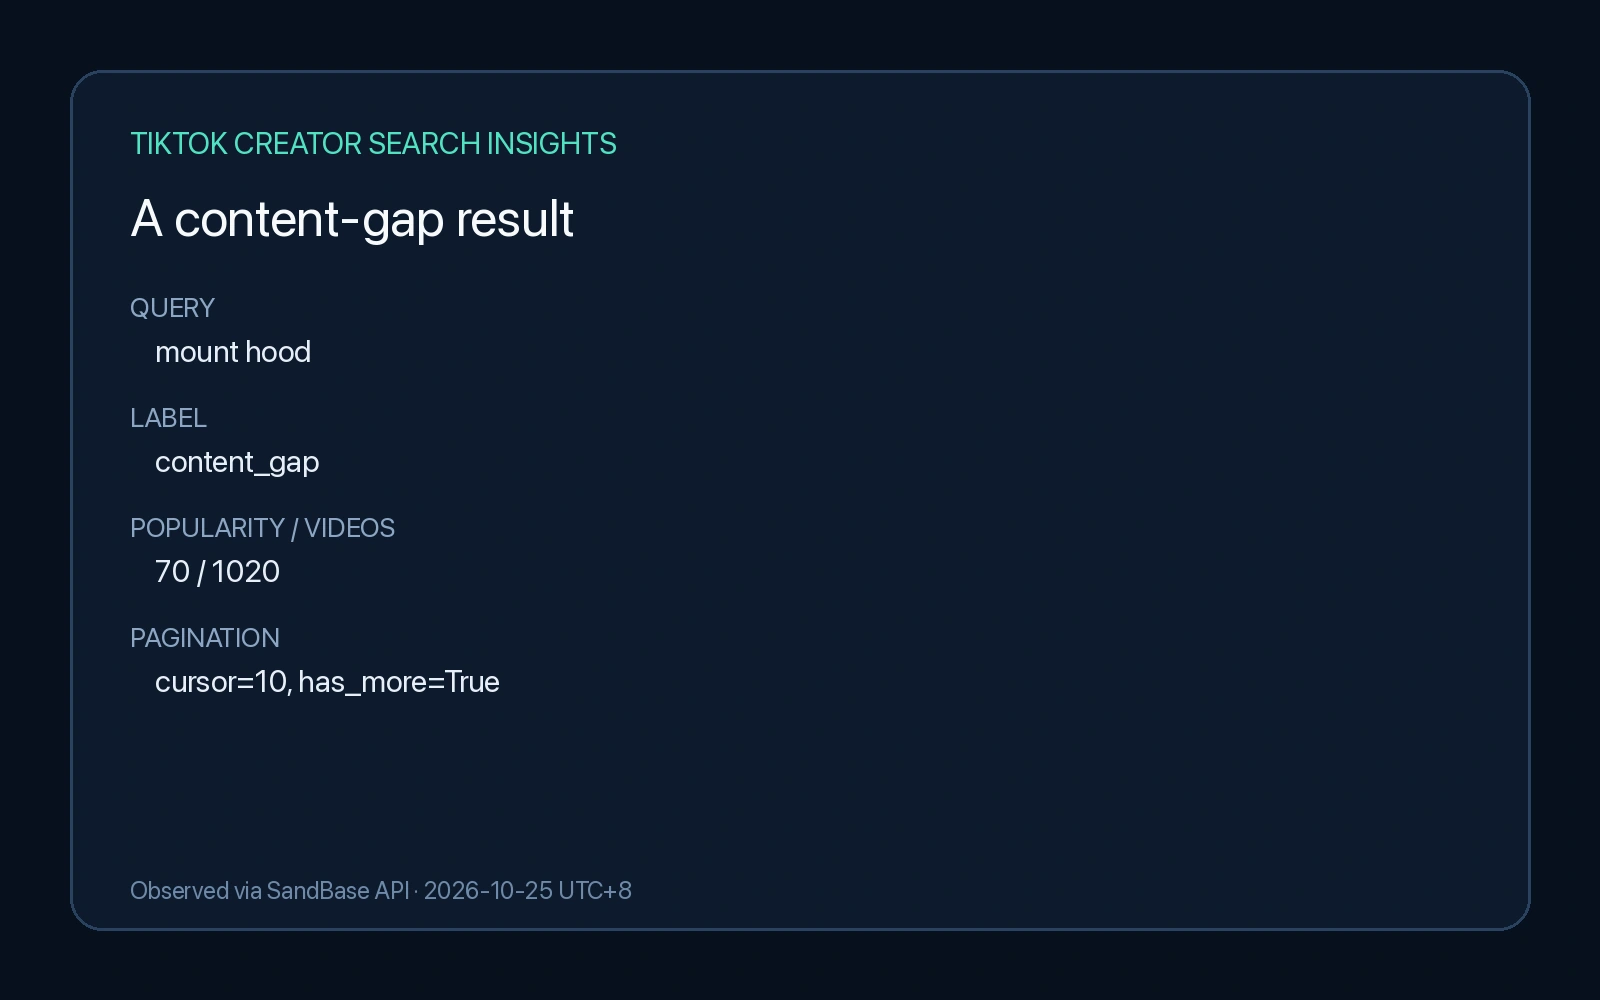 10 月 25 日实测返回的第一条内容缺口及分页游标。
详情请求使用 past_30_days 和 age,country,响应出现 age、location、demographics 等字段,但某些维度可能很稀疏。正确做法是保留未知状态,而不是拼出一个看似完整的受众画像。
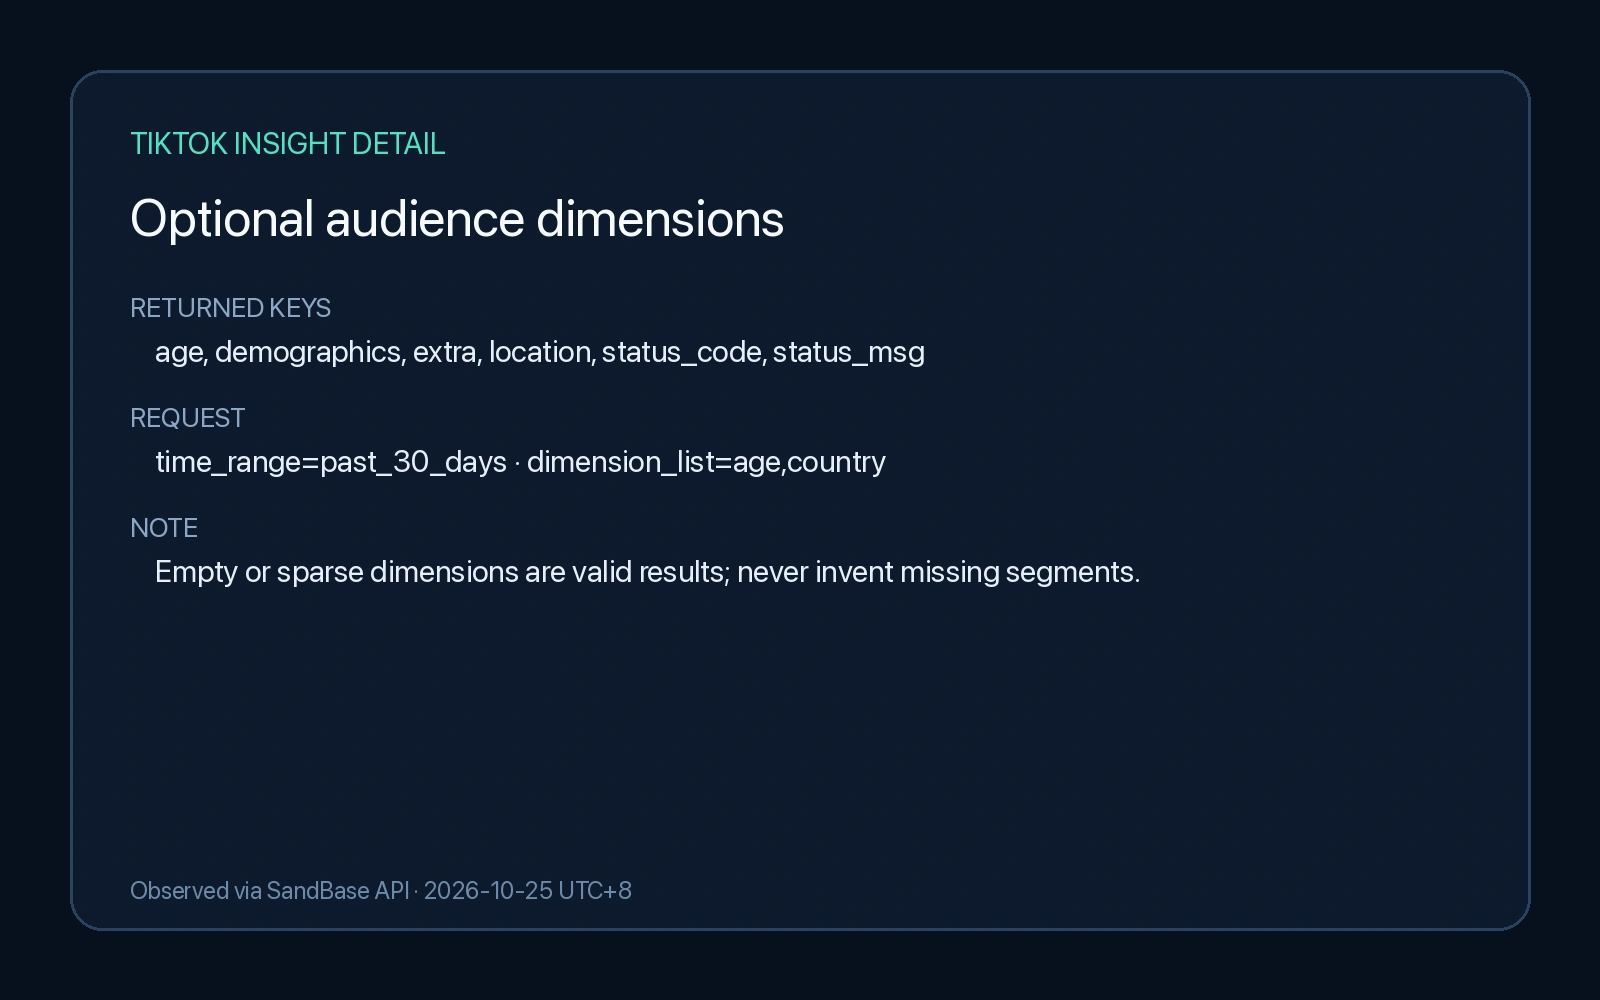 详情接口可以返回可选受众维度;数据稀疏时必须如实保留。
相关视频接口在 search_item_list[].aweme_info 下返回 10 条作品及分页字段;顶层 aweme_list 在本次响应中为空。它负责把抽象机会变成可人工检查的作品:当前内容是否真的回答了这个搜索、结果是否跑偏、选题是否适合自己的产品。
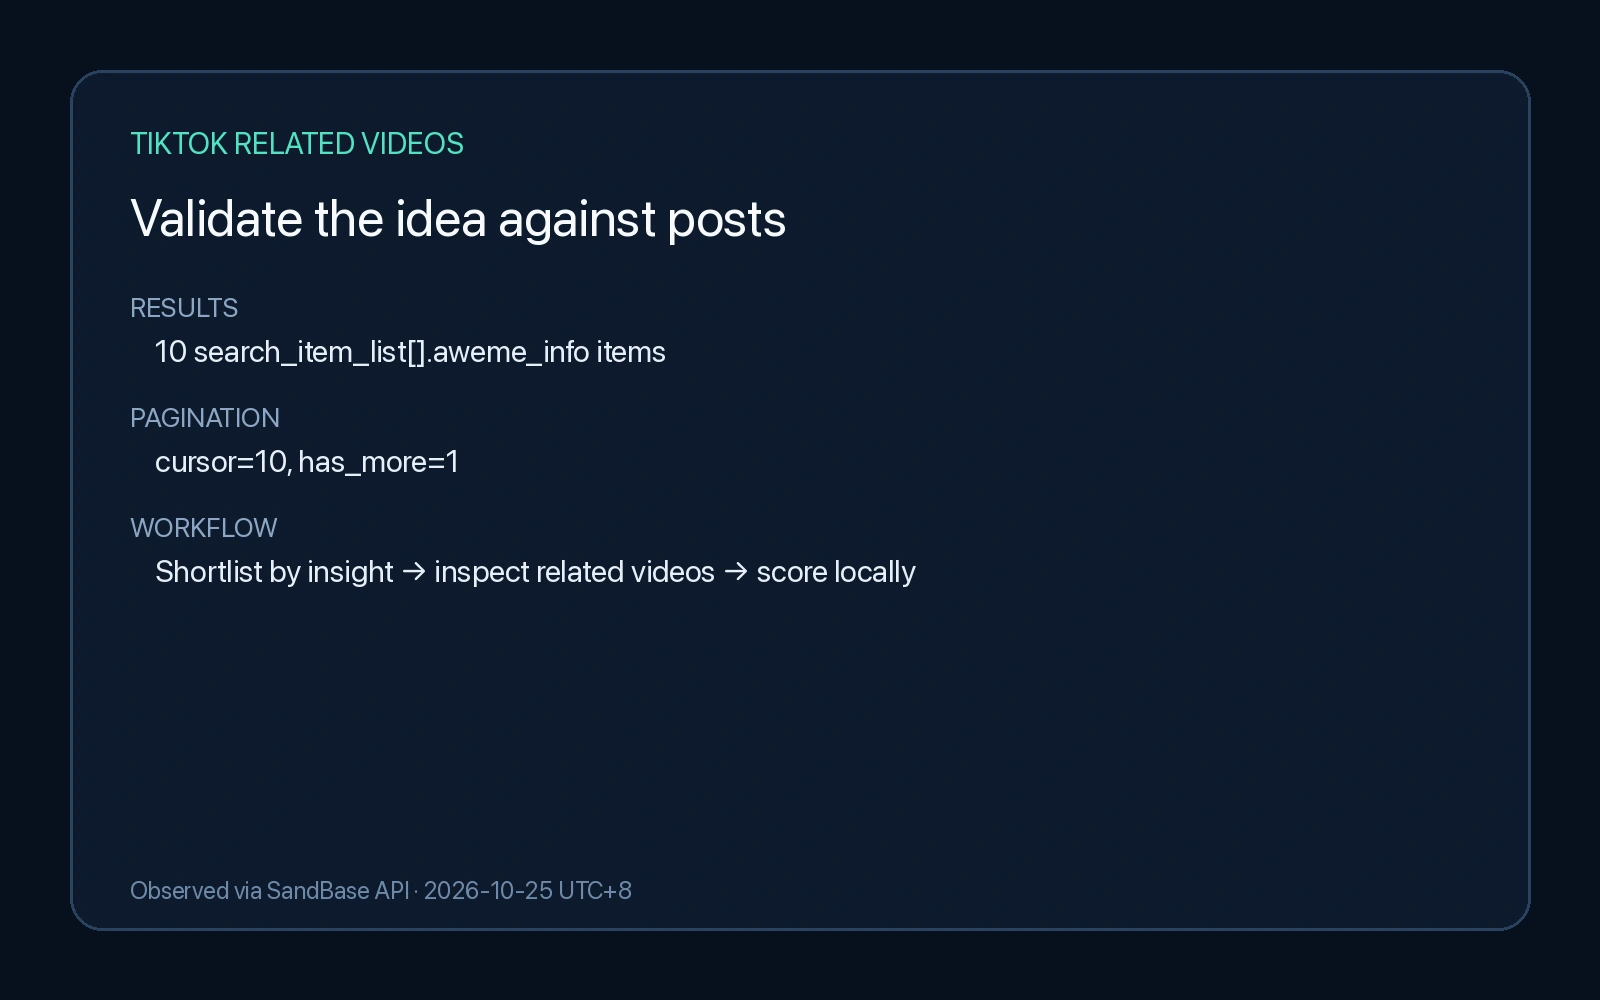 相关视频是进入选题 Brief 之前最关键的验证步骤。
先写一个严格的调用函数
python -m pip install requests
export SANDBASE_API_KEY="your_key_here"
SandBase 数据接口使用 POST /v1/api/<model>。下面的函数只读取文档约定的 outputs[0].data;任务未完成或响应形状不对时直接报错。
import os, time, requests

BASE = "https://api.sandbase.ai/v1/api"
HEADERS = {"Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
           "Content-Type": "application/json"}

def call(model, payload, retries=2):
    for attempt in range(retries + 1):
        response = requests.post(f"{BASE}/{model}", headers=HEADERS,
                                 json=payload, timeout=90)
        if response.status_code < 500 and response.status_code != 429:
            response.raise_for_status()
            break
        if attempt == retries:
            response.raise_for_status()
        time.sleep(2 ** attempt)
    body = response.json()
    if body.get("status") != "completed":
        raise RuntimeError(body.get("error") or body.get("status"))
    try:
        return body["outputs"][0]["data"]
    except (KeyError, IndexError, TypeError) as exc:
        raise RuntimeError("Missing outputs[0].data") from exc
发现内容缺口并翻页
def discover(category="Science", language="en", pages=2):
    cursor, rows, seen = 0, [], set()
    for _ in range(pages):
        page = call("tiktok/app-v3/creator-search-insights", {
            "tab": "content_gap", "limit": 20, "offset": cursor,
            "category_filters": category,
            "language_filters": language,
        })
        for item in page.get("inspiration_list") or []:
            query_id = item.get("query_id_str")
            if not query_id or query_id in seen:
                continue
            seen.add(query_id)
            rows.append({
                "query_id": query_id,
                "query": item.get("query_text"),
                "labels": item.get("query_labels") or [],
                "popularity": item.get("popularity"),
                "video_count": item.get("video_num"),
                "trend": item.get("trending_seq") or [],
            })
        if not page.get("has_more"):
            break
        cursor = page.get("cursor")
        if cursor is None:
            raise RuntimeError("has_more=true but cursor is missing")
    return rows
记录里要保留平台返回的 content_gap 标签。热度高值得研究,但不能单独证明需求没有被满足。翻页时按 query_id_str 去重,因为实时推荐列表可能在两次请求之间变化。
给一个候选词补齐证据
def enrich(row):
    detail = call("tiktok/app-v3/creator-search-insights-detail", {
        "query_id_str": row["query_id"], "time_range": "past_30_days",
        "dimension_list": "age,country",
    })
    trend = call("tiktok/app-v3/creator-search-insights-trend", {
        "query_id_str": row["query_id"],
        "from_tab_path": "TRENDING,TOPICS",
        "query_analysis_required": True,
    })
    videos = call("tiktok/app-v3/creator-search-insights-videos", {
        "keyword": row["query"], "offset": 0, "count": 20,
    })
    related = [item.get("aweme_info")
               for item in videos.get("search_item_list") or []
               if item.get("aweme_info")]
    return {**row, "detail": detail, "trend_context": trend,
            "videos": related}
如需排序,应采用简单、可解释的本地公式,并记录公式版本。例如用热度除以视频数平方根,再给正向趋势少量加分。这只是内部排队分数,绝不能写成 TikTok 官方指标。
参数速查
| 接口 | 必填 | 常用可选项 | 分页 |
|---|---|---|---|
creator-search-insights | 无 | tab、limit、offset、类别和语言 | 返回 cursor 作为下一次 offset |
creator-search-insights-detail | query_id_str | 时间范围、维度、自定义日期 | 本次未观察到分页 |
creator-search-insights-trend | query_id_str | 来源路径、是否分析查询 | 本次未观察到分页 |
creator-search-insights-videos | keyword | count、offset | 响应中的 cursor/has-more |
上线时要加的护栏
发现页可以短时缓存,但必须保存抓取时间。只重试网络错误、429 和 5xx;同一份 400 请求不要原样重放。日志可以记运行 ID,不能记 API Key。每次任务要限制最大页数;响应结构改变时应隔离该批次,而不是悄悄输出空表。
选题进入 Brief 前还应有人工门槛:打开多条相关视频,确认语言和搜索意图,检查结果是否仍然新鲜,并排除歧义词造成的假相关。公开数据适合研究,不等于获得了转载创作者视频或收集个人信息的授权。
常见问题
- 受众数据很少: 保持为空,继续参考趋势和相关视频。
- 下一页出现重复词: 用
query_id_str去重。 - JavaScript 中 ID 发生变化: 全程使用字符串字段,不要转浮点数。
- 两次结果顺序不同: 实时推荐面会变化,应比较带日期的快照。
- 没有
outputs[0].data: 让任务失败并保留响应,不能回退到猜测字段。
FAQ
内容缺口标签能保证视频爆吗?
不能。它是平台对搜索词的当时标签,不是对某个账号、创意或发布时间的预测。
能否只监控一个垂直领域?
可以。先用类别和语言过滤,再加自己的关键词白名单。当前可选值以 TikTok API 目录里的接口 Schema 为准。
要不要让大模型自动决定选题?
大模型适合在确定性过滤之后归纳主题。最终页面要保留原始词、分数和相关视频,交给编辑核对。