TypeSafe Jev 1.14:它是决策模型,不是聊天机器人
Jev 1.14 的类型化决策、$0.042/M 输入价格、概率输出、多语言更新、实验性图片能力与 SandBase decisions API。
Jev 1.14 虽然出现在模型目录里,但把它当聊天模型调用会从第一步就走偏。它不写回答,而是接收应用状态和一组类型化问题,返回选项、评分、概率或框。代码再根据置信度决定自动执行还是交给人。我们第一次请求偷懒传了 options 数组,直接 400;换成文档要求的 criteria 映射才得到有效结果。
TypeSafe 在 2026 年 10 月 14 日发布 Jev 1.14,这是第二版公开的 “System One” 决策模型。价格是每百万输入 token $0.042,输出不计费。稳定文本路径适合路由、分类和打分;图片、Box 和 262K 长上下文仍是官方明确标注“不够稳定”的实验功能。
先说结论
- Jev 不生成自由文本,只返回预先声明的
choice、score、noul概率和实验性box。 - 当前价格为输入 $0.042/M,输出 $0/M。
- 默认限制是每请求 64K、每问题 32K;上游 danger-zone header 可把两者提高到 262K。
- 我们 10 月 26 日在 SandBase 上把一条 SSO 故障正确分到
technical=1.0,紧急概率为 0.63。 - 适合放进确定性工作流,不适合解释、写作、多轮聊天、音频或视频。
System One 模型是什么
Jev 1.14 是 TypeSafe AI 的闭源决策模型。官方把流程概括为 state → question → decision → action:程序提供记录或文档,声明问题和答案形状,再用普通 if 处理概率。
 TypeSafe 10 月 14 日发布页把稳定的小幅模型改进和实验功能分开。截图于 2026-10-26。
它和 LLM 的 JSON mode 有本质差别:JSON mode 仍在生成 token,可能需要校验和重试;Jev 的接口把结果限制在问题类型里。不会类型错误,不等于不会判断错误。一个高置信度的错标签仍然是错,所以阈值和业务评测集不能省。
| 项目 | Jev 1.14 |
|---|---|
| 发布 | TypeSafe AI,2026-10-14 |
| SandBase ID | typesafe/jev-1.14 |
| 上游 ID | jev-1.14.0 |
| 稳定输入 | 字符串、对象或数组形式的文本 state |
| 稳定输出 | Choice、Score、Noul |
| 实验功能 | 图片、Box、262K 长上下文 |
| 默认上下文 | 每请求 64K、每问题 32K |
| 价格 | 输入 $0.042/M,输出免费 |
四种问题,各有边界
choice 从 criteria 映射里选一项,同时返回完整概率分布;score 在自定义量尺上定位;noul 给出一个命题为真的概率;1.14 新增的 box 返回归一化框坐标和置信度,目前仍属实验功能。
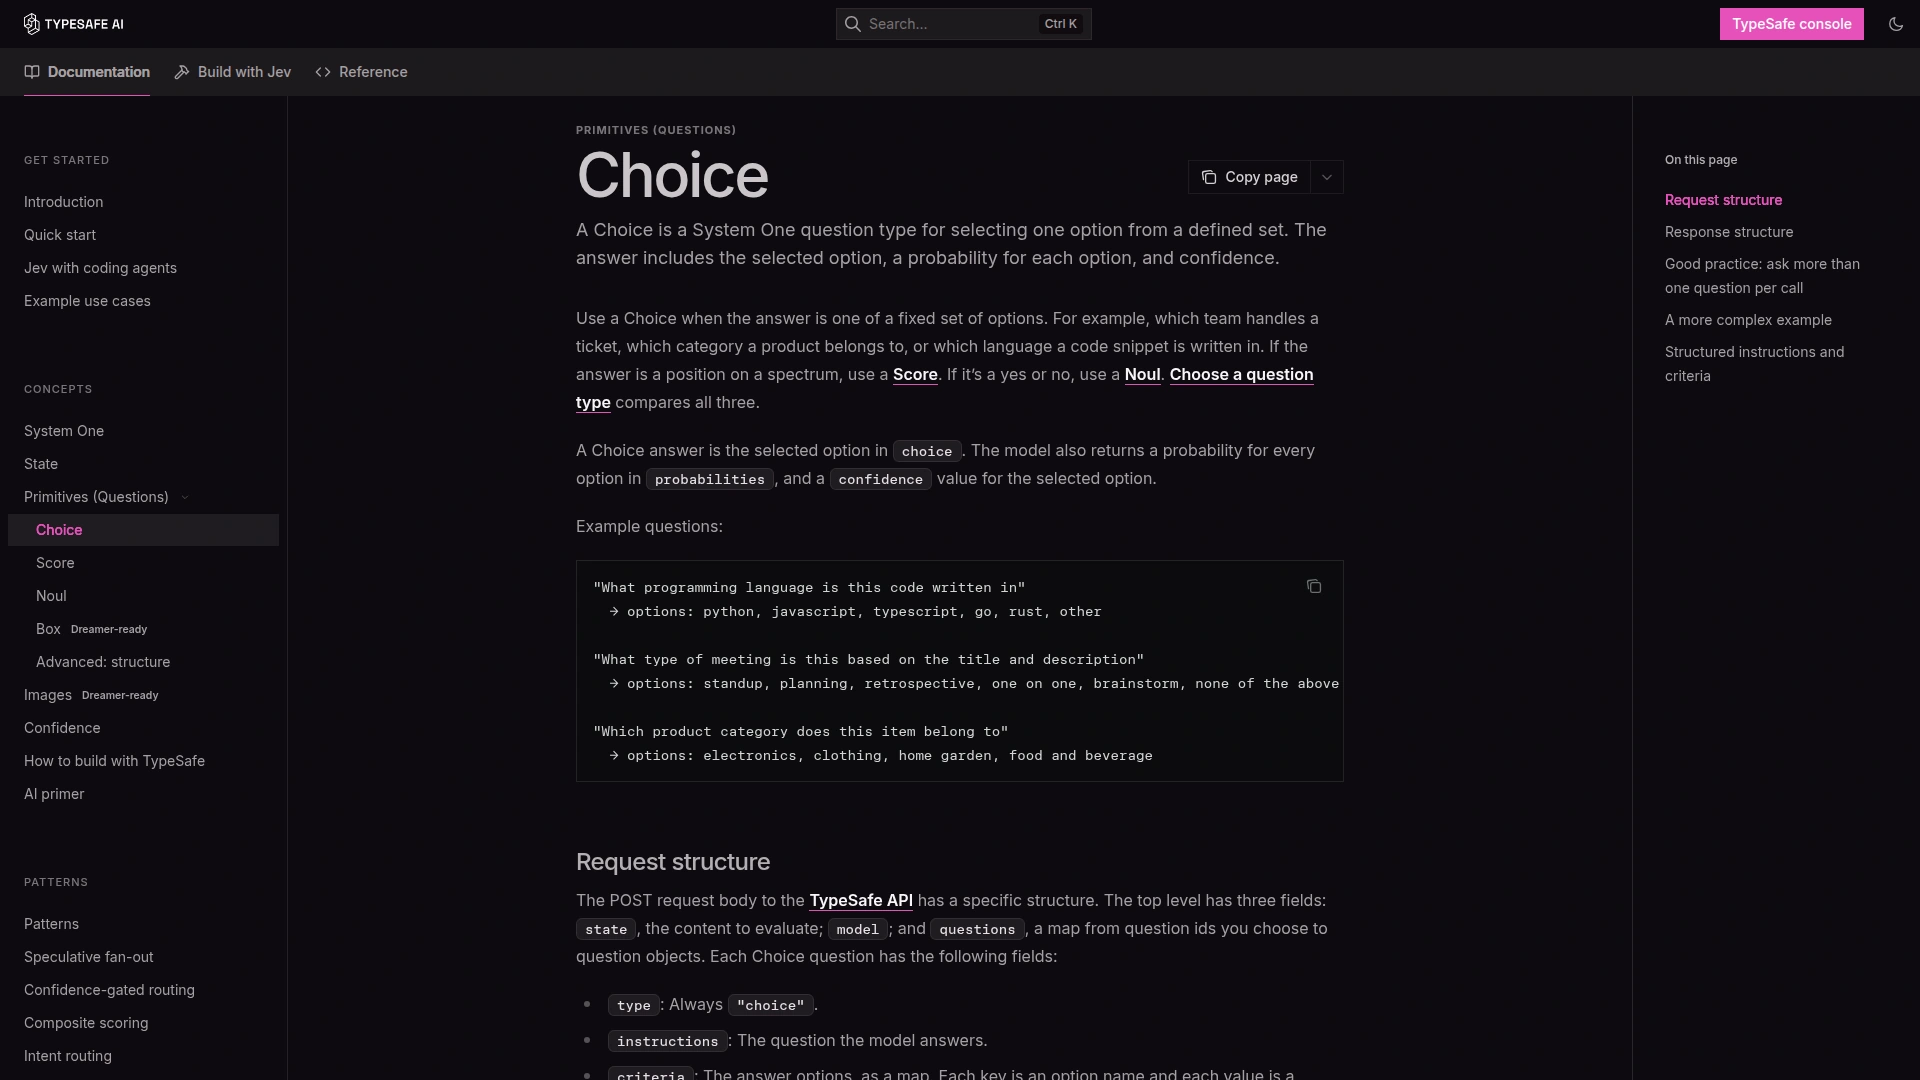 Choice 文档要求每个候选项在
criteria 中有清楚边界,返回结果带概率分布。截图于 2026-10-26。
一次请求可以针对同一份 state 并行问多个独立问题,例如工单队列、紧急程度、情绪和是否需要人工复核。但这不是推理链:同一请求里的问题不能依赖另一个问题的答案,条件逻辑要留在代码里。
我们实际跑通的请求
第一次调用使用 options: ["billing", "technical", "account"],SandBase 返回 400。正确写法是 criteria 对象:键是允许值,值解释每个选项负责什么。
curl https://api.sandbase.ai/v1/decisions \
  -H "Authorization: Bearer $SANDBASE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model":"typesafe/jev-1.14",
    "state":{"ticket":"启用 SSO 后三位同事无法登录,但发票正常。"},
    "questions":{
      "queue":{"type":"choice","instructions":"哪个团队处理?","criteria":{
        "billing":"扣款、发票和支付问题",
        "technical":"配置和认证故障",
        "account":"资料或订阅管理"
      }},
      "urgent":{"type":"noul","instructions":"是否需要紧急处理?"}
    }
  }'
返回值选择 technical,概率和 confidence 都是 1;urgent 为 0.63。用量是 371 输入、55 输出 token,按当前公式约 $0.000016,输出不计费。
一个概率不是指令。应用可以在队列 confidence 高于 0.8 时自动分单,但把 0.4–0.8 的紧急程度交给人。这些阈值属于产品政策,不是 Jev 给出的事实。
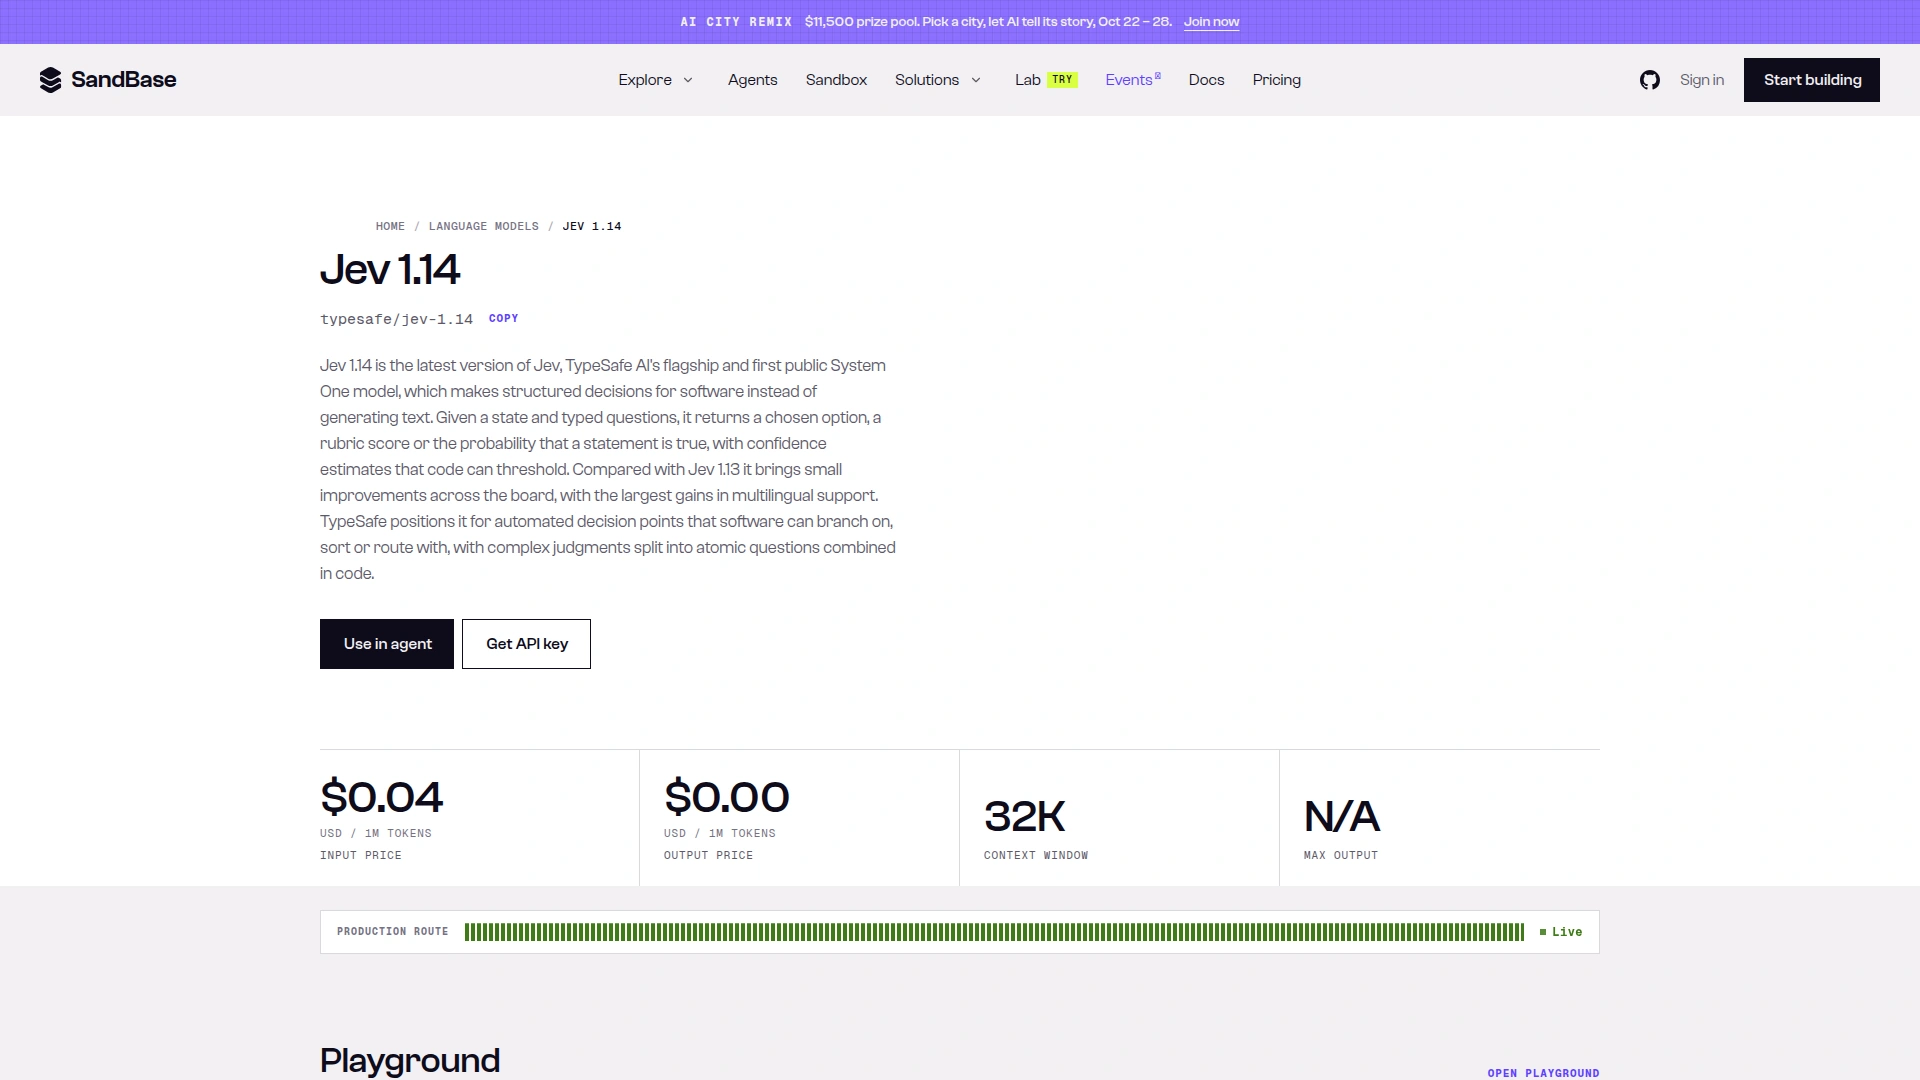 SandBase 当前列出
typesafe/jev-1.14:输入约 $0.04/M,输出 $0,页面显示每问题 32K 上下文。截图于 2026-10-26。
SandBase 通过 /v1/decisions 转发原生决策结构,并把响应中的模型名改为平台 ID;它不训练 Jev。
价格和真正的成本单位
371 token 的请求按公式是 $0.000015582。若一个月跑 100 万次相同大小的请求,共 3.71 亿输入 token,约 $15.58。把多个独立问题放在一次请求里,可以避免重复发送 state,但每个问题的 instructions 与 criteria 仍计入输入。
| 方案 | 输出 | 适合 | 风险 |
|---|---|---|---|
| Jev 1.14 | 类型化概率 | 路由、审核、排序 | 不解释,阈值要评测 |
| 小型 LLM + JSON Schema | 生成 JSON | 抽取兼解释 | 解析、重试、输出费用 |
| 规则引擎 | 确定分支 | 明确政策 | 模糊语言容易脆 |
| 人工审核 | 判断与解释 | 高风险歧义 | 慢且贵 |
更可靠的组合通常是:明确规则先处理,模糊中间段交给 Jev,置信度落在审核区间时升级给人或大模型。可继续看 5 种 Agent 设计模式 和 生产 Agent 护栏指南。
1.14 更新和限制
TypeSafe 称这版整体小幅提升,最大收益预期在多语言。但文档仍明确说英语最好,CJK 能处理但水平不等。中文工单必须用自己的样本验证,不能拿一句发布说明代替评测。
图片、box 和 262K 长上下文都需要上游 danger-zone 控制。TypeSafe 直说这些功能还有太多 jaggedness,不为生产场景背书。SandBase 当前公开 schema 只明确暴露 state 和 questions;除非具体路由写明并有一次带日期的成功调用,不要假定实验 header 与 assets 已透传。
常见问题
Jev 1.14 是 LLM 吗?
它能理解自然语言并做判断,但不是聊天或文本生成模型,输出是类型化决策和概率。
价格是多少?
TypeSafe 与 SandBase 当前都列出输入 $0.042/M,输出不计费。
Noul 是什么?
Noul 是 yes/no 问题类型,返回 0 到 1 的概率,而不是生成“是”或“否”。
能读图片吗?
TypeSafe 提供实验性图片输入和 Box 类型,但明确说尚不适合生产;还要核对你使用的路由是否透传相关字段。
应该用 alias 还是固定版本?
如果业务阈值依赖概率分布,应该固定版本。移动 alias 可能在代码不变时改变结果。
Jev 1.14 的价值恰恰在于它拒绝当聊天机器人。把 state 写清楚,用 criteria 拉开相邻选项,把最后权力留给代码。从 Jev 1.14 模型页 开始,然后用自己的标注样本校准阈值,再自动化有后果的分支。