Kimi K3.1 Pro 发布:降价三分之一、11 月 4 日开放权重,网络安全能力被主动削弱
Kimi K3.1 Pro 于 2026 年 10 月 23 日发布,API 每百万 token 输入 2 美元、输出 10 美元,权重承诺 11 月 4 日前开放。哪些已确认、网络安全数据过滤意味着什么,以及 reasoning_effort 实测花了多少钱。
Kimi K3.1 Pro 这次发布,对开发者真正有用的是两个数字,都不是跑分。
第一个是 2 / 10:API 每百万输入、输出 token 的美元价格,输入、缓存命中和输出三项都比 Kimi K3 便宜三分之一。第二个是 11 月 4 日,月之暗面承诺在这天之前放出完整权重。路透社报道时,把它主动削弱模型网络攻击能力这件事放在了标题里。这件事和其他发布内容,都可以对照这两个数字来看。
本文写给正在考虑把 Agent 或编码任务从 Kimi K3、或者从闭源模型切到 K3.1 Pro 的开发者。我把 10 月 23 日官方公布的内容和第三方报道分开,又补了一个 reasoning_effort 的小测试。原因很简单:这个参数对账单的影响,可能比降价本身还大。
先说结论
- 月之暗面于 2026 年 10 月 23 日(北京时间 24 日)发布 Kimi K3.1 Pro 和 K3.1 Pro Highspeed,上线 Kimi 网页版、Kimi Work、Kimi Code 和 Kimi API。完整权重承诺“11 月 4 日前”发布,截至 10 月 25 日还不能下载。
- API 价格:输入 2 美元、缓存命中 0.20 美元、输出 10 美元(每百万 token),整个 1M 上下文统一计价。Highspeed 的普通输入、输出和缓存写入都翻倍,缓存命中仍是 0.20 美元。
- 官方称开放权重版本在中期训练和 RL 阶段都剔除了网络安全相关数据,内部漏洞利用测试的 pass@3 从 90.5% 降到 81.0%。这个测试没有公开,外部无法复现。
- 模型始终开启推理,默认
max。我们通过 SandBase 做的两题测试里,日志排障题用max的输出 token 是low的 2.9 倍,结论却一样。- 现在能做的:先在 API 上测,显式设置推理强度。自部署计划等权重、许可证和独立评测出来再定。
官方发布了什么、什么时候
Kimi 官方技术博客称 K3.1 Pro 是“K3.1 系列的第一个模型”,也是月之暗面目前最强的 3T 级开放权重模型。架构没有变:它是在 Kimi K3 基础上加大后训练算力,在“数百个下游领域”做联合 RL 得到的。
| 日期(2026) | 事件 | 来源 |
|---|---|---|
| 10 月 23 日 | K3.1 Pro 与 Highspeed 上线 Kimi 网页版、App、Kimi Work、Kimi Code 和 API | Kimi 博客 |
| 10 月 24 日 | 路透社报道其剔除网络安全数据,以及 11 月 4 日的权重日期 | 路透社(Yahoo 转载) |
| 10 月 24 日 | 官方价格页列出 API 与会员价格,注明“10 月 24 日核对” | Kimi 价格页 |
| 11 月 4 日前 | 承诺发布完整权重 | Kimi 博客 |
有两个可用性细节容易漏掉。Kimi 企业版默认关闭这个模型,需要管理员手动开启。另外,API 客户可以申请零数据保留(Zero Data Retention)。之前因为数据合规不敢用的团队,可以重新评估一下。
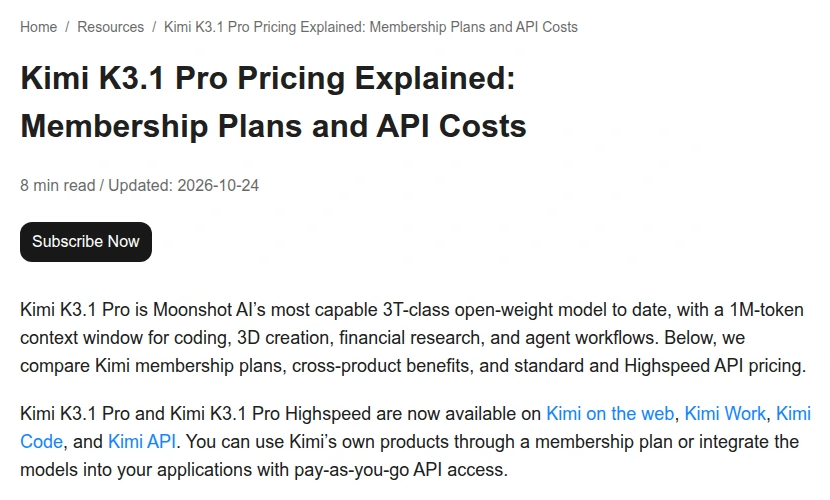 月之暗面价格页,2026-10-25 截图。页面日期为 10 月 24 日,列出两个模型和四个渠道。下文的 API 价格来自同一页面下方的价格表。
已确认、官方自称、暂时无法核实
多数发布报道直接照搬了官方的跑分图。这张图里,有的分数是月之暗面自己跑的,有的是从别家报告里抄来的,编码测试大多还是放在 Claude Code harness 里跑。所以它是厂商的自我陈述,不是中立榜单。
| 说法 | 10 月 25 日状态 | 来源 |
|---|---|---|
| 10 月 23 日发布、1M 上下文 | 官方确认 | Kimi 博客 |
| Highspeed 快 2–3 倍 | 厂商自报,我们未实测 | Kimi 博客 |
| API 2 / 10 美元,缓存命中 0.20 美元 | 官方确认 | Kimi 价格页 |
| Terminal-Bench 4.0:65.7%,Opus 5.5 为 66.4%,GPT-6 Astra 为 58.2% | 厂商自报 | Kimi 博客脚注(Claude Code harness;对手分数取各家自报与官方榜单中的较高值) |
| BenchCAD 带工具 92.7%,Opus 5.5 为 96.2% | 厂商自报 | Kimi 博客 |
| Kimi Hallu Bench Hard 上的陈述级幻觉率从 23.4%(K3)降到 8.3% | 厂商自报,内部压力测试;官方说明这不代表日常使用的错误率 | Kimi 博客。The Implicator 指出 API 快速入门文档在另一个数据集上给的是 6.85% |
| 过滤后 xdev-bench-hard 从 90.5% 降到 81.0% | 厂商自报,测试未公开 | Kimi 博客;路透社注明“未经独立核实” |
| 总参数 2.8T、激活 104B(MoE) | 官方 X 账号发布帖提到,技术博客未写 | Kimi 在 X 上的发布帖,Gigazine 转引 |
| 开放权重与许可证条款 | 尚未发布 | 承诺 11 月 4 日前 |
有一处差距很明显。据 The Implicator 解读官方图表,K3.1 Pro 在 Terminal-Bench Science 上只有 38.1,GPT-6 Astra 是 68.1,Opus 5.5 是 63.3。日常终端编码,它已经接近闭源头部模型。科学计算类终端任务,它还差得远。如果你的 Agent 主要干后一类活,那个编码头条分数说明不了什么。
不少媒体还引用了 Artificial Analysis 的智能指数分数。我们使用的 Artificial Analysis 快照(v4.3,2026-10-19 抓取)早于发布日,所以这里不引用具体数字。等有日期的快照收录这个模型后,我们再补上。
真正的热点:主动削弱网络攻击能力
这一点让 K3.1 Pro 的讨论超出了“又一个模型发布”的范围。官方说,随着后训练规模扩大,模型的漏洞研究能力一直在涨。追查下去,原因是通用中期训练语料里混着网络安全内容,RL 环境里也有相关任务。所以开放权重版本把这两部分都剔掉了,只保留通用编码任务。
效果用 xdev-bench-hard 衡量。这是月之暗面内部的漏洞利用测试集,题目复现了 Linux 内核、Node.js、Exim 等软件里真实披露过的漏洞。未过滤的检查点 pass@3 为 90.5%,发布版本为 81.0%。官方原则是“不发布会推进网络攻击能力绝对前沿的开放权重”,并称 K3.1 Pro 的能力仍落后于已公开至少三个月的闭源前沿模型。
先别急着接受这个结论,有三点要注意:
- 测试没公开。 外部没人能复现 xdev-bench-hard,81.0% 只能和官方自己的图表比。据 The Implicator,同一张图里 DeepSeek V4.1 Flash 是 85.7%。
- 81% 依然很高。 The Implicator 提到,Kimi K3 在同一测试上只有 33.3%。过滤后的 K3.1 Pro 利用漏洞的能力仍远超上一代。过滤压低了增幅,但没有让它停下来。
- 权重发出去就收不回。 官方博客没回答微调能否把剔除的能力补回来。路透社也点出了结构性问题:权重一旦扩散,开发者限制访问、监控使用和更新防护的能力都会变弱。
时间点也解释了为什么大家这么关注。发布前两天,PHP 紧急修复了两个存在十多年的漏洞,研究人员借助前沿模型把它们做成了可用的利用链。详见 PHP2Shell:AI 找到的漏洞,对开发者意味着什么。在这样一周里承诺放出 3T 级权重,网络安全能力是绕不开的话题,月之暗面也确实正面回应了。对开发者来说,结论比安全争论更具体:如果打算 11 月 4 日后自部署,安全评审时应该假定模型的漏洞利用能力依然可观,不能当作已经移除。
价格:账单到底怎么变
价格页显示,1,048,576 token 的上下文窗口内统一计价,没有长上下文加价。
| 模型 | 输入 | 缓存命中 | 5 分钟缓存写入 | 1 小时缓存写入 | 输出 |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $0.20 | $2.00 | $4.00 | $10.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $4.00 | $8.00 | $20.00 |
| Kimi K3(对照) | $3.00 | $0.30 | — | — | $15.00 |
单位:美元 / 每百万 token。数据来自月之暗面价格页,官方注明 2026-10-24 核对。
Agent 场景的成本,关键看缓存命中价。举一个编码 Agent 常见的调用:每次输入 180,000 token,其中 150,000 是命中缓存的仓库前缀,输出 6,000 token。这里假设缓存已经预热,没有新的缓存写入。
| 每 1,000 次调用 | 未缓存输入 | 缓存命中 | 输出 | 合计 |
|---|---|---|---|---|
| K3.1 Pro,命中缓存 | $60 | $30 | $60 | $150 |
| K3.1 Pro,无缓存 | $360 | — | $60 | $420 |
| K3.1 Pro Highspeed,命中缓存 | $120 | $30 | $120 | $270 |
| Kimi K3,命中缓存 | $90 | $45 | $90 | $225 |
升级 Highspeed 之前,先看这一行。缓存命中价没有翻倍,所以缓存占比高的 Agent 换 Highspeed,实际是 1.8 倍成本,不是 2 倍。但为一个“快 2–3 倍”的说法多付 80%,代价依然不小,而且这个速度我们还没实测。
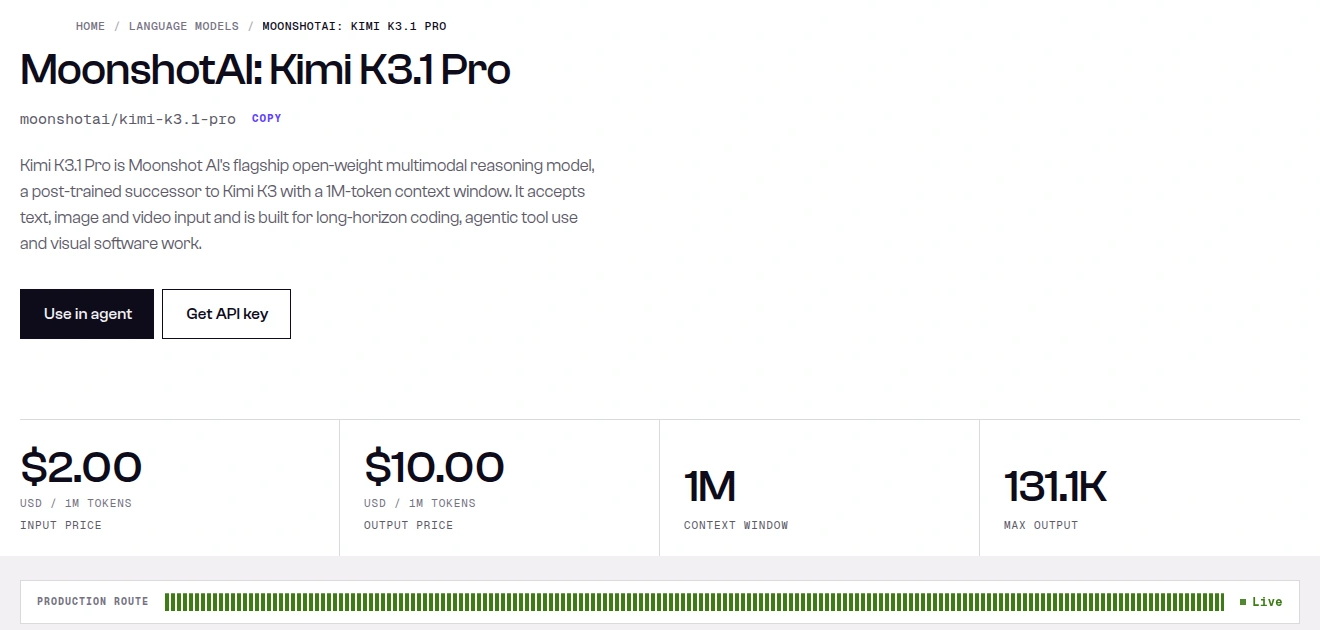 SandBase 模型目录,2026-10-25:
moonshotai/kimi-k3.1-pro 按官方 2 / 10 美元标价,上下文 1M,输出上限 131.1K。当天 SandBase 上还没有 Highspeed 版本。
推理强度:真正影响账单的参数
价格页写明 K3.1 Pro“始终推理”,reasoning_effort 可选 low、high、max,默认 max。The Implicator 援引发布当天的独立测量,称这个模型输出 token 偏多。默认 max 符合这个说法,但这些报道没有拆分推理强度的影响。
所以我做了个小测试。2026-10-25,通过 SandBase 上的 Kimi K3.1 Pro 发了两道题,每个强度各跑一次。第一题是日志排障:一段 SQLAlchemy 连接池耗尽的日志,要求 120 词内作答。第二题是上面那张表里的缓存成本计算。
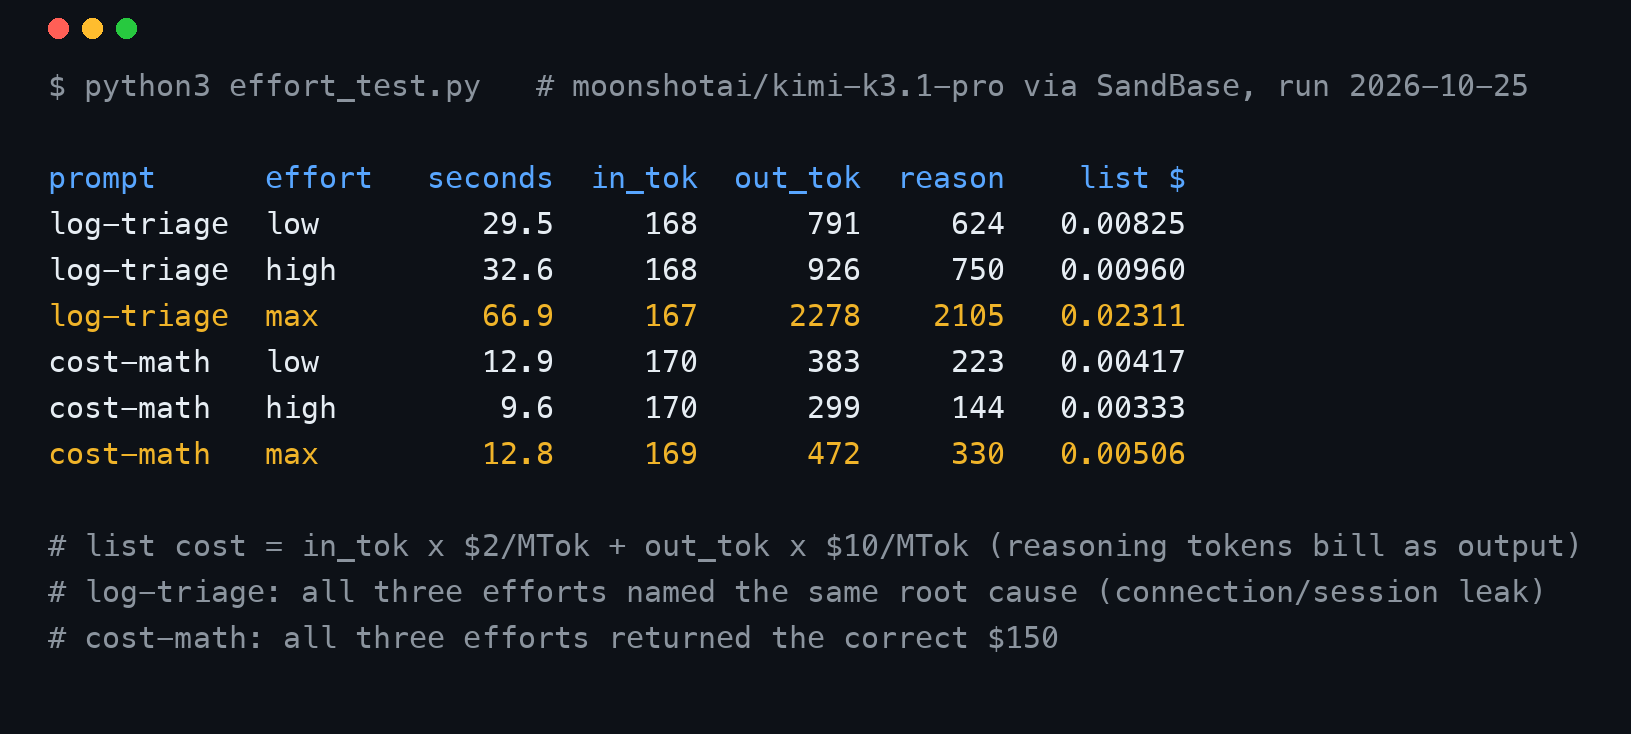 我们 2026-10-25 通过 SandBase 的实测,每格只跑一次。费用按 API 返回的 token 用量和官方标价计算,推理 token 按输出计费。
结果如下,只对这两道题成立:
- 日志排障题,
max耗时是low的 2.3 倍(66.9 秒对 29.5 秒),输出 token 是 2.9 倍(2,278 对 791)。三档给出的根因都是连接或会话泄漏。max的答案多考虑了流式响应和后台任务,更周全一点,但low的答案已经能直接用。 - 算账题,三档都算出了正确的 150 美元,token 差距不大(299–472)。
两道题、每格一个样本,这不是 benchmark。但它说明了一个实际问题:在 Agent 循环里调用 K3.1 Pro 却不设 reasoning_effort,每一步都会按 max 付费,不需要深度推理的步骤也一样。路由、抽取、简单工具调用用 low 或 high 就行。max 留给真正需要深度的规划或调试步骤。
开发者现在可以做什么
- 权重出来之前,先用 API 测。 官方把托管版本作为 K3.1 Pro 提供。如果它在你的任务上赢不了现有模型,可下载的权重大概率也改变不了结论。
- 按步骤固定推理强度。 显式传
reasoning_effort,并记录completion_tokens_details.reasoning_tokens。账单超支,大多能在这个字段里找到原因。 - 保持前缀稳定。 缓存命中只要输入价的十分之一。官方提醒,前缀靠前的位置一旦改动,后面的部分都无法复用。所以时间戳、每轮工具结果这类易变内容要放在最后。
- 暂时别围绕 11 月 4 日排自部署计划。 许可证、文件大小和推理部署要求都还没公布。承诺的日期不等于已经交付。
- 如果你在用 Kimi K3, 切换只需要改模型 ID,价格还更低。可以先对照我们之前的 Kimi K3 介绍,看看会失去什么,再用自己的回归集测一遍,然后改默认值。
常见问题
Kimi K3.1 Pro 什么时候发布的? 2026 年 10 月 23 日(北京时间 24 日),当天上线 Kimi 网页版、App、Kimi Work、Kimi Code 和 Kimi API。
Kimi K3.1 Pro 开源吗? 官方称其为开放权重模型,承诺 2026 年 11 月 4 日前发布完整权重。截至 10 月 25 日还不能下载,许可证也没公布。
Kimi K3.1 Pro API 多少钱? 每百万 token 输入 2 美元、缓存命中 0.20 美元、输出 10 美元。Highspeed 为 4 / 0.20 / 20 美元。没有长上下文加价。
月之暗面真的削弱了它的黑客能力吗? 官方称剔除网络安全数据后,内部漏洞利用测试从 90.5% 降到 81.0%。这个测试没公开,结果也没经过独立核实。和 Kimi K3 相比,它在这类任务上依然强得多。
K3.1 Pro 和 Highspeed 有什么区别? 官方称 Highspeed 快 2–3 倍。普通输入、输出和缓存写入都是两倍价格,缓存命中价不变。
总结
Kimi K3.1 Pro 是一个更便宜、更强的 Kimi K3:编码能力有说服力,科学计算类终端任务是短板。网络安全过滤是一次真实的尝试,但现在还无法审计。眼下它是值得测试的托管模型,几天后可能变成值得认真评审的一套权重。可以先在 SandBase 模型页上试用,记得显式设置 reasoning_effort。自部署的事,等 11 月 4 日的文件和许可证真正出来再说。
资料核对于 2026-10-25:Kimi K3.1 Pro 技术博客、Kimi K3.1 Pro 价格页、路透社(Yahoo 转载)、The Implicator、Gigazine。推理强度测试为我们当天通过 SandBase 自行运行。