TikTok Shop 选品调研 API 教程 | SandBase
用四个 SandBase 端点评估一个 TikTok Shop 赛道:按关键词搜商品,看评分分布和评价原文,再拉出卖家的整店商品。无需 TikTok 登录,只需一个 SandBase API Key。
我往 TikTok Shop 美国站发的头三次关键词搜索,返回的都是 products: [],外加一句 success。没报错,也没任何提示。后来用第一个关键词“coffee”再搜一次,30 条商品和翻页 token 一下子全回来了。
这是我用 API 做 TikTok Shop 选品时学到的第一课:空结果不等于没结果,代码得分得清这两种情况。
这篇教程写给想在入场前先摸清一个品类的开发者和分析师。输入一个关键词,流程会搜索公开商品,挑出卖得最好的那个,读它的星级分布和一批评价原文,再把这个卖家店里的其他商品拉出来。整条链路用四个 SandBase 端点完成,可以直接交给 Agent 跑。想先看 TikTok 全部端点的话,可以读 TikTok 公开数据 API 总览。
读的全是公开、只读数据。不需要 TikTok 账号,也不需要 SDK,有一个 SandBase API Key 就行。本文用到的几个 Shop 端点,目前在 SandBase 目录里标的是 Free。
参数和响应信封以端点 API 参考为准,参考只保证信封结构。下文出现的业务字段名都来自我自己跑的调用(测试于 2026-10-01,UTC),属于实测观察,不是文档保证。
先说结论
tiktok/shop-web/search-products-list返回商品卡片:价格、销量、评分、品牌和seller_id都在里面。翻页用响应里给的offset和page_token。product-detail-v2能补上类目路径和完整的星级分布,但我跑的几次都没返回商品自己的价格和标题,这两项要从搜索卡片里取。product-reviews-v2按page_start翻评价;seller-products-list用一个不透明的search_params游标翻整店商品。- 我测下来,搜索在 US、SG、MY 都能用,详情和评价只有 US 能用。美国站搜索时不时返回空页,所以代码里加了重试。
先摸底:哪些端点靠得住
shop-web 这一组端点比本文用到的多。动手设计之前,我把每个端点都实测了一遍。结果直接决定了这篇教程怎么写:
| 端点 | 实测情况 |
|---|---|
search-products-list | US、SG、MY 可用,US 间歇性返回空页 |
search-products-list-v2 | US 返回空结果,嵌套更深;SG 有一次上游 400 |
product-detail(v1) | 调用完成,但商品本身的 seller_id 为空,也没有价格 |
product-detail-v2 | US 可用:星级分布、类目路径、同店推荐 |
product-detail-v3 | 每次都是上游 400,参考里的示例 id 也一样 |
product-reviews-v2 | US 可用;SG、MY 商品返回上游 400 |
seller-products-list | US、SG 可用,支持游标翻页 |
products-by-category-id | 试过的类目 id 全部上游 400,包括 products-category-list 返回的 id |
所以按类目浏览这条路暂时走不通,整条链路只能从搜索开始。
还有一个意外:参考文档的地区列表里写了 GB,但用 GB 搜索时返回的是 region_supported: false,外加一个 supported_regions 列表:ID、JP、MX、MY、PH、SG、TH、US、VN(run 30cb8c1c-f1d0-426d-8d8e-674de98f7751)。换地区之前,先看一眼这个字段。
| 你的需求 | 用什么 |
|---|---|
| 做调研用的公开商品、评分、评价和店铺商品数据 | SandBase TikTok Shop 公开数据 API |
| 开店卖货、管理自己的店铺、订单或达人分佣数据 | TikTok Shop 官方卖家和合作伙伴 API |
| 买家隐私或仅账号可见的数据 | 两条路都不适用 |
流程一览
- 用
search-products-list(search_word、region、offset、page_token)搜关键词,空页要重试。 - 按销量给商品排序,顺手统计零销量商品的占比。
- 用
product-detail-v2(product_id、region)读商品信号:类目路径和星级分布。 - 用
product-reviews-v2(product_id、page_start)抽样评价原文。 - 用
seller-products-list(seller_id、search_params)拉卖家整店商品。
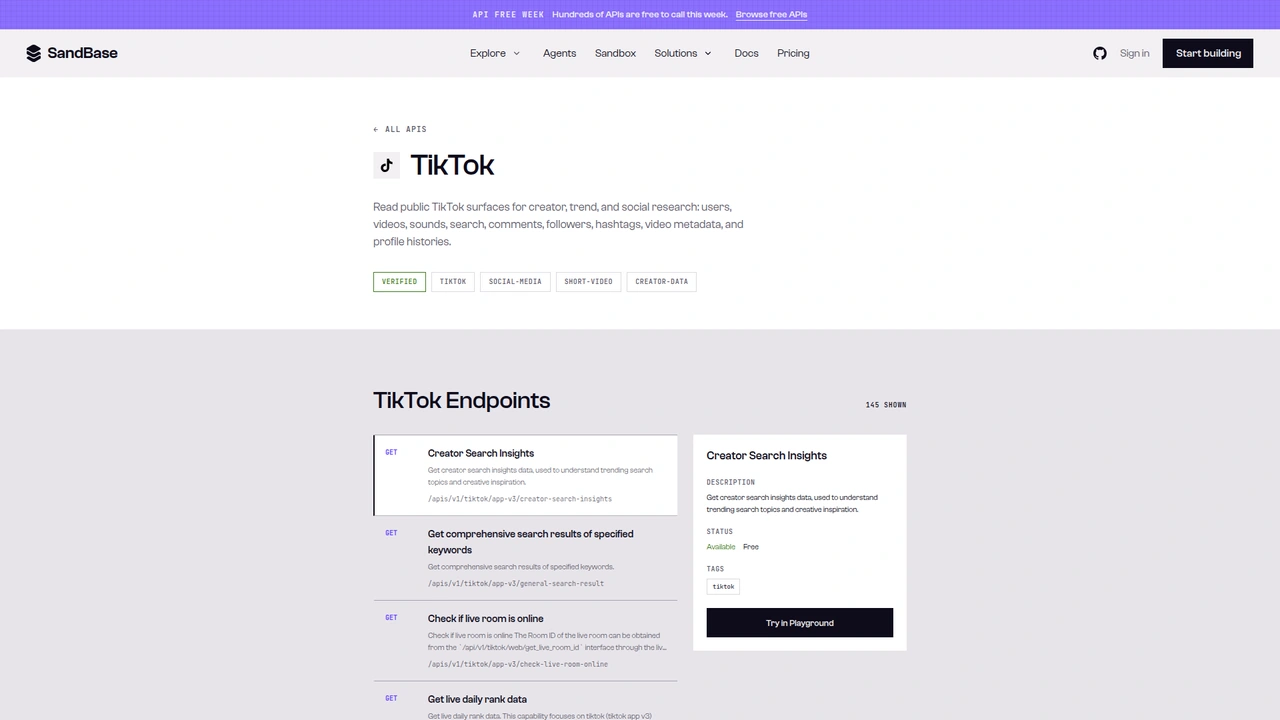 SandBase 上的 TikTok 目录页:145 个端点以
GET /apis/v1/tiktok/... 路径列出,选中的端点标着 Available、Free。本教程调用的是 Model API 的 POST /v1/api/tiktok/... 路由。
写代码前先把接口面说清楚。目录页展示的是 GET /apis/v1/tiktok/<path>;本文用的是端点参考里的 Model API,也就是 POST /v1/api/tiktok/<path>,请求体是端点参数组成的 JSON。复制示例时,记得保留 POST 方法和 /v1/api/ 前缀。
第 0 步:一个通用调用函数
import os
import time
import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}
REGION = "US"


def call(path: str, payload: dict, retries: int = 2) -> dict:
    for attempt in range(retries + 1):
        resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=90)
        if resp.status_code >= 500 and attempt < retries:
            time.sleep(2 * (attempt + 1))  # 上游偶发失败:退避后重试
            continue
        resp.raise_for_status()
        body = resp.json()
        if body.get("status") != "completed":
            raise RuntimeError(body.get("error", {}).get("message", f"{path} did not complete"))
        # 文档结构是 outputs[0].data;同时兼容顶层 `output`。
        output = body.get("output")
        if output is None and body.get("outputs"):
            output = body["outputs"][0].get("data", {})
        return output or {}
    raise RuntimeError(f"{path} kept failing")


def listing(p: dict) -> dict:
    price = p.get("product_price_info") or {}
    seller = p.get("seller_info") or {}
    rate = p.get("rate_info") or {}
    return {
        "product_id": str(p.get("product_id")),
        "title": p.get("title"),
        "brand": (p.get("brand_info") or {}).get("brand_name"),
        "seller_id": seller.get("seller_id"),
        "shop": seller.get("shop_name"),
        "price": price.get("sale_price_decimal"),
        "currency": price.get("currency_name"),
        "sold": (p.get("sold_info") or {}).get("sold_count"),
        "score": rate.get("score"),
        "reviews": rate.get("review_count"),
    }
参考文档写的完成态结构是 outputs[0].data,我这次调的 Shop 端点也都是这个结构。函数里顺带兼容了顶层 output,因为 SandBase 其他平台的端点返回过这种结构。另外,Shop 接口会在 outputs[0].data 里再包一层 data,旁边是 code 和 message,所以后面每一步都会再取一次 .get("data")。
失败的样子和我预想的不一样。地区不对、商品不支持时,返回的不是 4xx,而是 HTTP 503,响应体里写着 upstream error 400。函数对 5xx 重试两次后就抛异常,地区配错时几秒内就会报错,不会一直空转。
listing() 负责把商品卡片整理成统一格式。我跑的几次里,搜索结果、同店推荐和卖家商品列表用的都是同一种卡片结构,一个解析函数就能通吃。
第 1 步:搜索赛道,空页重试
def search_products(word: str, pages: int = 2, empty_retries: int = 2) -> list[dict]:
    rows, offset, token = [], 0, ""
    for _ in range(pages):
        payload = {"search_word": word, "region": REGION, "offset": offset, "page_token": token}
        for _ in range(empty_retries + 1):
            data = call("tiktok/shop-web/search-products-list", payload).get("data", {})
            if data.get("products"):
                break  # 这里的空页多半是偶发的,重试一下
        rows += [listing(p) for p in data.get("products", []) or []]
        more = data.get("load_more_params") or {}
        if not data.get("has_more") or not more.get("page_token"):
            break
        offset, token = more.get("offset", 0), more["page_token"]
    return rows
翻页完全跟着响应走。“mushroom coffee”的第一页(run 5bb26751-92ef-453c-8766-75dde7b8a575)返回 30 条商品、has_more: true,load_more_params 里是 offset: 30 和一个 page_token。把这两个值原样传回去,第二页(run 694682ab-8809-4b83-837a-9c58f076dbd7)又给了 30 条,和第一页没有重复。
下面是另一次调用(7f1495f2-9bac-4c2c-9132-2007d910d0ef)里品牌自营店 Micro Ingredients 的卡片节选:
{
  "has_more": true,
  "load_more_params": {"api_source": 2, "offset": 30, "page_token": "20261001031049DC4BD36BAFE739165F2A"},
  "products": [
    {
      "product_id": "1729385057785057965",
      "title": "Micro Ingredients Organic Instant 10 in 1 Mushroom Coffee Powder",
      "brand_info": {"brand_name": "Micro Ingredients"},
      "sold_info": {"sold_count": 219808},
      "rate_info": {"review_count": "28866", "score": 4.7},
      "product_price_info": {
        "currency_name": "USD",
        "sale_price_decimal": "24.95",
        "origin_price_decimal": "27.95"
      },
      "seller_info": {"seller_id": "7494949083499694765", "shop_name": "Micro Ingredients"}
    }
  ]
}
有两处类型要处理:
- 价格是小数字符串;
review_count是字符串,sold_count却是整数。比较之前先统一类型。 - 数字会变。同一个商品,这张卡片上是 28,866 条评价,同一天另一次调用里是 29,017 条。所以每个数字都要连同抓取时间一起存。
真正的坑是空页。美国站搜“mushroom coffee”时,连着两次返回 products: []、has_more: false(run dfafb1ab-debd-48d7-97ae-f758a56d3817 和 1e5f5e65-f911-4705-8063-625b699e5474),第三次就正常回来 30 条。不过,空结果也可能真的是“没有匹配”,所以重试几次之后,代码就接受空结果,不会无限循环。
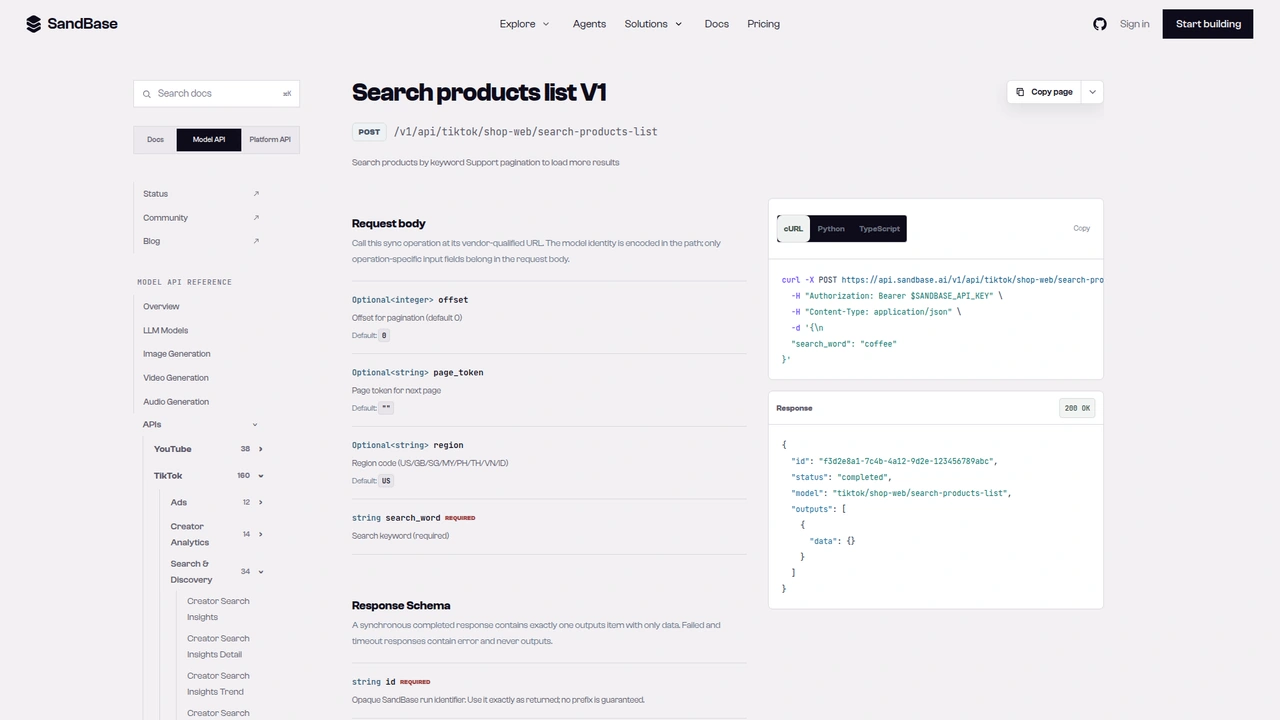
tiktok/shop-web/search-products-list 参考页:POST /v1/api/tiktok/shop-web/search-products-list,必填 search_word,可选 offset、page_token、region。响应示例里 outputs[0].data 是空对象。
第 2 步:读星级分布和类目
def product_signals(product_id: str) -> dict:
    data = call("tiktok/shop-web/product-detail-v2",
                {"product_id": product_id, "region": REGION}).get("data", {})
    comp = {c.get("component_name"): c.get("component_data") or {}
            for c in data.get("components_map", []) if isinstance(c, dict)}
    ratings = (comp.get("product_info", {}).get("reviews_info") or {}).get("review_ratings", {})
    crumbs = comp.get("bread_crumbs", {}).get("bread_crumbs", []) or []
    return {
        "category_path": [b.get("name") for b in crumbs][1:],  # 去掉根节点 "TikTok Shop"
        "score": ratings.get("overall_score"),
        "review_count": ratings.get("review_count"),
        "star_histogram": ratings.get("rating_result"),
        "more_from_shop": [listing(p) for p in comp.get("feed_list_more_from", {}).get("products", []) or []],
}详情接口返回的不是一个商品对象,而是一份页面布局:components_map 是一串带名字的组件,好几个还是 null。我跑的几次里,product_detail 组件本身带着 skip_data_return: true,没有数据。这就是价格和标题要从搜索卡片里取的原因。
不过 product-detail-v2 给的其他东西很有用(run 644c0d78-6d14-49ea-988b-f3b08d36d161):
bread_crumbs:Food & Beverages → Drinks → Coffeeproduct_info.reviews_info.review_ratings:overall_score: 4.7;rating_result星级分布里,五星 25,363 条,一星 1,195 条;review_count: "29017"feed_list_more_from:同一家店的其他商品,也是商品卡片格式related_link:相关搜索词
这个接口的响应很大,另一个商品的响应超过了 1 MB,大部分是推荐卡片。只解析你要的部分,其余的丢掉,别整包塞给模型。
第 3 步:抽样评价原文
def sample_reviews(product_id: str, pages: int = 2) -> list[dict]:
    reviews = []
    for page in range(1, pages + 1):
        data = call("tiktok/shop-web/product-reviews-v2",
                    {"product_id": product_id, "region": REGION, "page_start": page}).get("data", {})
        for r in data.get("product_reviews", []) or []:
            if r.get("review_text"):
                # 只留星级和正文;评价者昵称、id、头像一律丢掉
                reviews.append({
                    "rating": r.get("review_rating"),
                    "verified": r.get("is_verified_purchase"),
                    "variant": r.get("sku_specification"),
                    "text": r["review_text"],
                })
        if not data.get("has_more"):
            break
return reviews参考文档里,page_start 是从 1 开始的页码。我跑的两页(第 1 页 2cd6b7b5-b41c-4197-bfcb-247ef1418e06,第 2 页 22fd29c7-f3d9-485f-95e5-2e0b4312bbeb)每页最多 20 条,has_more: true。之前在另一个商品上测两页时,两页的评价 id 没有重复。有些评价只有星级、正文为空,函数会跳过这些。
每条评价里还带着打了码的昵称、评价者 id 和头像链接。做选品调研用不上这些,入库前就丢掉,只留星级、是否已验证购买、规格(比如 28oz、14oz)和正文。
筛选参数我没摸清楚。参考里列了 filter_type(默认 1)和 filter_value(说明是星级筛选,默认 6)。我传了 filter_type: 2, filter_value: 1,返回的还是以五星为主(run 0d3b40e6-a885-456a-84cd-cd6ceef5e7d6)。所以我保持默认值,星级构成直接看第 2 步的分布。
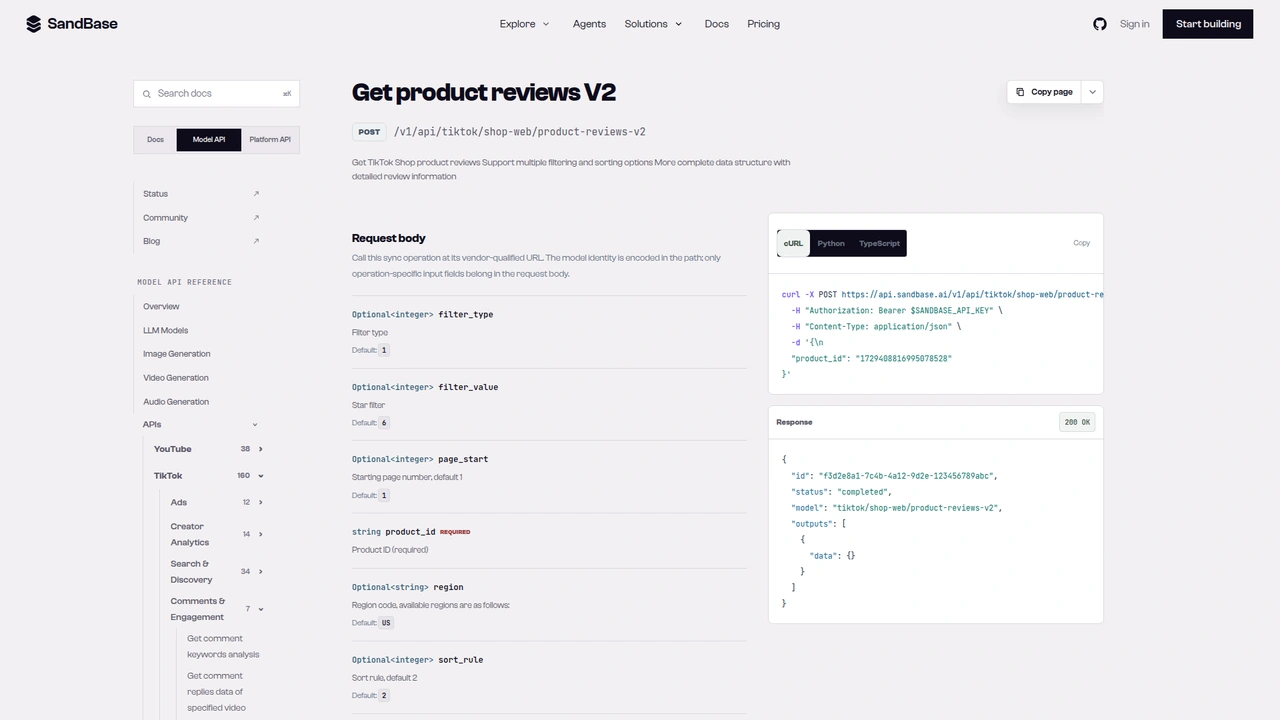
tiktok/shop-web/product-reviews-v2 参考页:必填 product_id,可选 filter_type、filter_value、page_start、region(默认 US)和 sort_rule。
第 4 步:拉卖家整店商品
def seller_catalog(seller_id: str, pages: int = 2) -> list[dict]:
    items, cursor = [], ""
    for _ in range(pages):
        data = call("tiktok/shop-web/seller-products-list",
                    {"seller_id": seller_id, "region": REGION, "search_params": cursor}).get("data", {})
        items += [listing(p) for p in data.get("products", []) or []]
        cursor = (data.get("load_more_params") or {}).get("search_params")
        if not data.get("has_more") or not cursor:
            break
    return items
这里的游标是不透明的。第 1 页(run ac77c278-b76c-4921-9eda-73737e8ac823)返回 30 个商品,load_more_params.search_params 是一串以 30_ 开头的字符串。第 2 页(run c37a49bf-3b09-43f0-b7bd-173cb0643db0)带上这串字符串,又返回 30 个。原样传回去就行,别自己拼。
这个端点的 -v2 版本参数名叫 searchParams,游标以 next_search_param 的形式包在 component_data 里返回。两个版本没法直接互换。
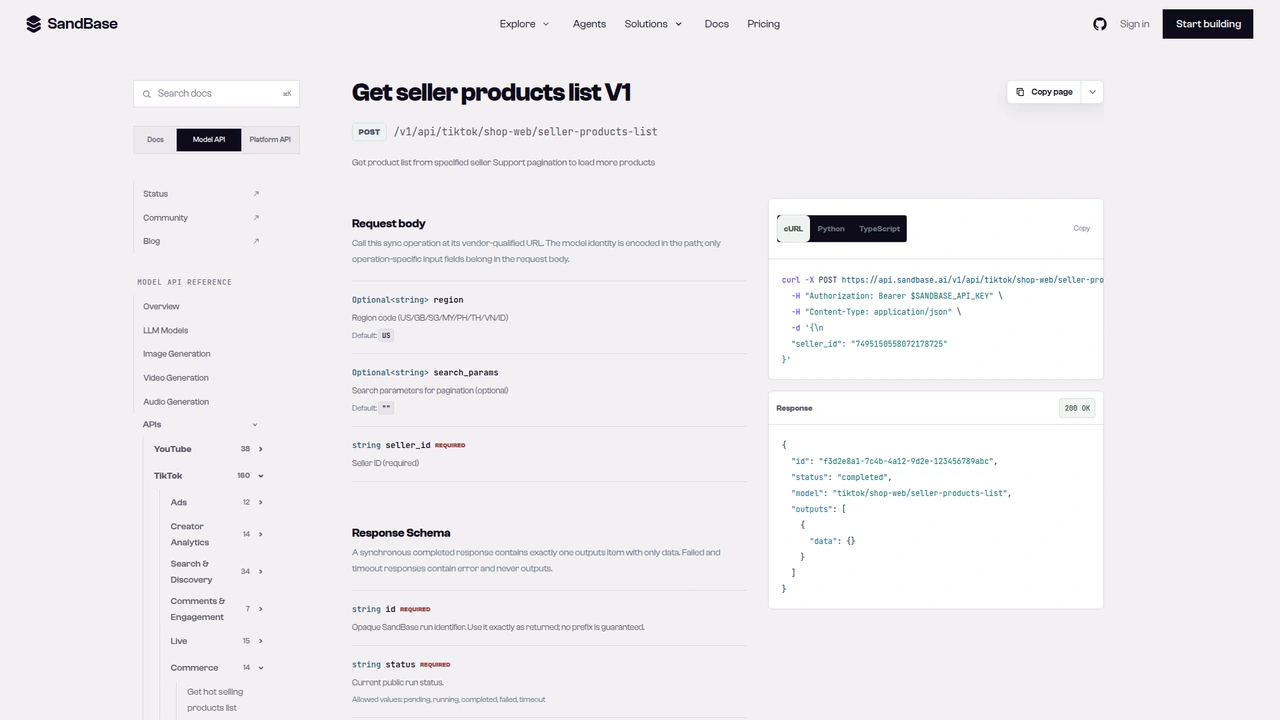
tiktok/shop-web/seller-products-list 参考页:必填 seller_id,可选的 search_params 说明为分页参数。
串起来:一份赛道报告
def research_niche(word: str, top_n: int = 1) -> dict:
    results = search_products(word)
    ranked = sorted(results, key=lambda r: r["sold"] or 0, reverse=True)
    report = {"keyword": word, "listings_seen": len(results),
              "zero_sales_share": round(sum(1 for r in results if not r["sold"]) / max(len(results), 1), 2),
              "products": []}
    for top in ranked[:top_n]:
        signals = product_signals(top["product_id"])
        catalog = seller_catalog(top["seller_id"]) if top["seller_id"] else []
        report["products"].append({
            **top,
            **{k: v for k, v in signals.items() if k != "more_from_shop"},
            "review_sample": sample_reviews(top["product_id"]),
            "shop_listings_read": len(catalog),
            "shop_top_sellers": sorted(catalog, key=lambda p: p["sold"] or 0, reverse=True)[:3],
        })
    return report
我原样跑了一遍 research_niche("mushroom coffee"),一共 7 次调用:搜索 2 页、详情 1 次、店铺商品 2 页、评价 2 页。报告一共看到 60 条商品,其中 27% 零销量。销量第一的是 Micro Ingredients 的蘑菇咖啡:售价 $24.95,已售 219,808 件,评分 4.7,类目路径是 Food & Beverages → Drinks → Coffee。
拉出整店商品之后,故事就不一样了。在我读到的 60 个商品里,这家店卖得最好的前三名是胶原蛋白粉(已售 1,377,502 件)、维生素 D3 K2 和牛至油补充剂。蘑菇咖啡只是它的副线,主业是保健品。光看关键词搜索,是看不出这一层的。
零销量占比也值得细看。在“coffee”和“mushroom coffee”的结果里,有好几个商品标题挂着头部品牌的名字,卖家却是不相干的小店,销量只有 0 到 5 件。把一个商品算作竞品之前,先对一下 brand 和 shop。
文档保证 vs. 实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/tiktok/shop-web/search-products-list,参数 search_word、offset、page_token、region | 参考文档已列明 |
POST /v1/api/tiktok/shop-web/product-detail-v2,参数 product_id、region、seller_id | 参考文档已列明 |
POST /v1/api/tiktok/shop-web/product-reviews-v2,参数 product_id、page_start 及筛选项 | 参考文档已列明 |
POST /v1/api/tiktok/shop-web/seller-products-list,参数 seller_id、search_params | 参考文档已列明 |
信封 id / status / model / outputs[0].data | 参考文档已列明 |
卡片字段 sold_info、rate_info、product_price_info、seller_info、brand_info | 仅实测观察 |
has_more、load_more_params.offset / page_token / search_params | 仅实测观察 |
components_map、bread_crumbs、review_ratings.rating_result | 仅实测观察 |
| 地区支持(详情和评价仅 US 可用;GB 不支持) | 仅实测观察 |
常见用法
进货前先估赛道
拿几个关键词各跑一份报告,横向比较头部商品的销量、零销量占比和评分分布。
- 输入:关键词
- 输出:每个赛道一份报告
- 端点:
search-products-list、product-detail-v2
从评价里找产品缺口
给头部两三个商品各拉几页评价,让模型按规格归纳反复出现的差评点。
- 输入:商品 id
- 输出:按主题归类的评价样本
- 端点:
product-reviews-v2
摸清竞品店铺
对每个头部卖家拉一遍整店商品,看它还卖什么、靠哪条产品线撑着。
- 输入:卖家 id
- 输出:按销量排序的店铺商品
- 端点:
seller-products-list
从达人追到商品
如果你已经在追踪某个品类的带货达人,可以配合 TikTok 达人调研教程,顺着他们视频挂的商品往下查。
实用提示
- 空搜索页先别信。 重试一两次,再下“没结果”的结论。
- 按端点确认地区支持。 我测下来,详情和评价只有 US 能用,GB 搜索直接返回
region_supported: false。 - 价格和标题从卡片取。 我跑的几次里,
product-detail-v2都跳过了商品本身的组件。 - 翻页跟着给的游标走。 搜索用
offset加page_token,评价用page_start,店铺商品用search_params。 - 统一类型,记录时间。 计数字段字符串和整数混着来,调用之间还会变。
- 不存评价者身份。 只留星级和正文。
- 只读公开数据。 不碰订单、店铺管理和买家数据。
- 商品链接也能当入口。
product-id-by-share-link能把shop.tiktok.com/us/pdp/...链接解析成product_id(run6158dfd3-5dce-4456-bd80-80fe450b237b)。短分享链接我没测。
测试范围说在前面:同一天里测了两个美国站赛道,外加几次 SG 和 MY 搜索。没做过压测,空页在其他时段出现得多频繁,我也说不准。
常见问题
需要 TikTok 或 TikTok Shop 账号吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权就行,这几个只读端点不需要 TikTok 登录,也不用走 OAuth。
收费吗? 本文用到的 Shop 端点目前在 SandBase 目录里标的是 Free,以目录页当前状态为准。
能按类目浏览,不用关键词吗?
products-category-list 能返回类目树,但我试过的每个 id 调 products-by-category-id 都是上游失败。现阶段还是用关键词搜索。
为什么不用 product-detail-v3?
我测的每一次它都上游失败,参考里的示例 id 也一样。美国站商品用 product-detail-v2 是通的。
美国以外的站点能用吗? SG 和 MY 的搜索能用,但我试的 SG、MY 商品调详情和评价都失败了。完整链路只在 US 跑通。
小结
想初步摸清一个 TikTok Shop 赛道,有一个关键词就够了:搜出带价格和销量的商品,读头部商品的星级构成和评价原文,再看这个卖家店里还卖什么。给空搜索页加上重试,事先确认地区支持,整条链路就能作为一个 Agent 任务跑完。
其他 TikTok 端点的用法,可以看 TikTok 公开数据 API 总览。准备好了就可以开始: