小红书笔记调研 API 教程 | SandBase
从关键词搜索第一页或已知笔记 ID 的评论第一页开始接入小红书 API;核对当前参数、响应与计费,保留历史调研证据。
手里只有品类关键词,和已经选定一条笔记,是两种不同的接入任务。前者需要先拿搜索结果;后者直接读评论就够了,再搜一次反而可能选错对象。这篇小红书笔记调研 API 教程先把两条路分开:关键词搜索第一页,或已知 note_id 的评论第一页。
2026-11-08 本次更新核对的是免费 inspect、当前请求 schema 和公开参考响应,没有执行付费业务调用。原文 2026-10-01 UTC 的防晒霜调研仍保留在后半篇,不能当作今天重新跑通的证明。小红书 API 总览列出其他能力;如果你研究的是商品、SKU 和商品评价,另看商品调研教程。
先说结论
- 搜索与评论二选一,新示例只发一次请求,不自动选笔记、翻页或接 LLM。
- 使用 Model API 的 POST 路由,只读取文档化的
outputs[0].data。- 搜索参考样本是
code: 0加data.items,没有success;评论样本则有code: 0、success: true和data.comments。- 缺失的互动指标保留为未知,第一页只能算样本,不能当作品类排名或完整讨论。
先选小红书笔记调研 API 的第一步
| 已有输入 | 对应端点 | 本次请求的起点 |
|---|---|---|
| 品类或话题关键词 | 搜索笔记 | 必填 keyword;page: 1;两个搜索 ID 留空 |
| 已确认的公开笔记 ID | 笔记评论 | note_id;cursor: "";index: 0;pageArea: "UNFOLDED" |
搜索的默认值包括 ai_mode: 0、sort_type: "general",以及 source: "explore_feed"、note_type: "不限"、time_filter: "不限"。代码显式发送前两个选项,后三项交给服务端默认值,不猜其他筛选枚举。评论默认排序是 latest_v2。虽然 schema 没把 note_id、share_text 单独标成必填,参考说明仍要求用其中一种指明目标。本例只处理已知 ID,不混入分享链接解析。
这里有一个容易误接的地方:搜索参考文案把 xsec_token 和详情、评论关联起来,但当前这个 app-v2/note-comments schema 没有声明 xsec_token 参数。不要凭这句话制造字段,也不需要让客户把登录 cookie 或 token 发给 agent。不同路由的契约不能混用,后文旧 web-v3 失败记录更不能作为修改当前 app-v2 请求的依据。
已有 Key、已连接 agent、新项目怎么接
已经有 SandBase Key,就复用本地 SANDBASE_API_KEY 或项目已有的密钥配置。agent 已连接 SandBase,就复用现成连接并检查所选端点,不必再申请 Key。新项目可以把 setup skill 和 Markdown quickstart 交给 agent,附上任务、关键词或已知笔记 ID;密钥仍放在本地配置,不贴到对话里。
可以这样描述任务:“使用我已有的 SandBase 连接,先检查 schema,只读取这个关键词的小红书搜索第一页。失败就报告错误,不自动重试、翻页、选笔记或调用 LLM。”如果你已有目标笔记,把要求换成“这个 note_id 的评论第一页”。这样先约定一次请求的边界,再决定要不要扩展。
Python 环境先执行 python3 -m pip install requests,把下面内容存为 first_request.py,本地配置 Key 后运行 python3 first_request.py。默认主程序只搜一次 sunscreen,可以换成自己的关键词。若要改为评论,把主程序两行替换为 result = first_request("comments", os.environ.get("XIAOHONGSHU_NOTE_ID")) 和 print("Comments:", len(result["data"]["comments"])),并先在本地配置该 ID。是替换任务,不是再追加一次调用。
单次请求,明确检查两层结果
这里调用的是 POST /v1/api/xiaohongshu/app-v2/<operation>,请求体只放该接口参数,不使用目录页展示的 GET 路径。下面的判断只针对这两个参考样本,不是所有小红书端点通用的成功码规则。
import os
import re
import requests


def first_request(task, value):
    if not isinstance(value, str) or not value.strip():
        raise ValueError("Provide a keyword or a known note_id")
    if task == "search":
        path, field = "search-notes", "items"
        params = {"keyword": value.strip(), "page": 1,
                  "search_id": "", "search_session_id": "",
                  "ai_mode": 0, "sort_type": "general"}
    elif task == "comments":
        if not re.fullmatch(r"[0-9a-fA-F]{24}", value):
            raise ValueError("Use a known 24-character hex note_id, not a URL")
        path, field = "note-comments", "comments"
        params = {"note_id": value, "cursor": "", "index": 0,
                  "pageArea": "UNFOLDED", "sort_strategy": "latest_v2"}
    else:
        raise ValueError("Choose search or comments")
    key = os.environ.get("SANDBASE_API_KEY", "").strip()
    if not key:
        raise RuntimeError("Set SANDBASE_API_KEY locally")
    try:
        response = requests.post(
            f"https://api.sandbase.ai/v1/api/xiaohongshu/app-v2/{path}",
            headers={"Authorization": f"Bearer {key}"}, json=params,
            timeout=(10, 90), allow_redirects=False,
        )
        if not 200 <= response.status_code < 300:
            raise RuntimeError(f"SandBase HTTP {response.status_code}")
        body = response.json()
    except ValueError:
        raise RuntimeError("SandBase returned invalid JSON") from None
    except requests.RequestException:
        raise RuntimeError("SandBase network request failed; not retried") from None
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("SandBase request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Missing documented outputs[0].data")
    payload = outputs[0].get("data")
    if not isinstance(payload, dict):
        raise RuntimeError("Missing documented outputs[0].data")
    if type(payload.get("code")) is not int or payload["code"] != 0:
        raise RuntimeError("Unexpected Xiaohongshu provider status")
    if "success" in payload and payload["success"] is not True:
        raise RuntimeError("Xiaohongshu provider reported failure or malformed success")
    data = payload.get("data")
    if not isinstance(data, dict) or not isinstance(data.get(field), list):
        raise RuntimeError(f"Missing Xiaohongshu data.{field} list")
    if any(not isinstance(item, dict) for item in data[field]):
        raise RuntimeError(f"Malformed Xiaohongshu data.{field} entry")
    return payload


if __name__ == "__main__":
    result = first_request("search", "sunscreen")
    print("Search items:", len(result["data"]["items"]))
空列表可以是正常的第一页结果;列表缺失、类型不对、状态失败或信封不存在都必须报错。搜索样本没给 success,所以不能强制要求它出现;如果返回显式失败值,则不能忽略。还要检查整数 code: 0,避免把错误响应变成“没有笔记”。服务端若换了结构,应先核对契约,而不是再加一层静默兼容。
打印的数量仅指本页数组长度,搜索卡片可能包含非笔记内容,不代表总量。函数保留原始 payload,不提取用户身份,也不把缺失指标补成 0。连接或读取超时、跳转、非 2xx、非法 JSON 都只尝试一次,错误消息不回显密钥与上游正文。401/403 先查鉴权,402 查账户计费上下文,429 查限流,再决定是否单独发起下一次请求。
当前价格和本次未验证的边界
2026-11-08 免费 inspect 显示,两端点的 base price 均为每次 $0.01,符合组织每天 100 次共享免费数据 API 额度的资格,00:00 UTC 重置。本次没查询剩余额度。一次请求可按抵扣前 $0.01 估算,不能承诺一定免费;扩大任务前应再次检查当前价格。
本次没有重新执行分页、详情或完整调研链路。搜索公开样本经过裁剪,不能靠它确认完整续页状态;评论参考里的 cursor 也被截断,不能直接复制当作下一页令牌。后文保留的翻页记录只解释旧实验,不能替代当前完整响应与单独验证。
历史实验:2026-10-01 的防晒霜笔记
旧实验串联了联想词、两页搜索、详情和评论。历史代码归档逐字保留两语各六段 Python,并记录 SHA256。旧代码包含顶层 output 兼容、自动重试、分页和缺值补零;仅供追溯,不应照抄运行。当前接入请用前面的单次 helper。
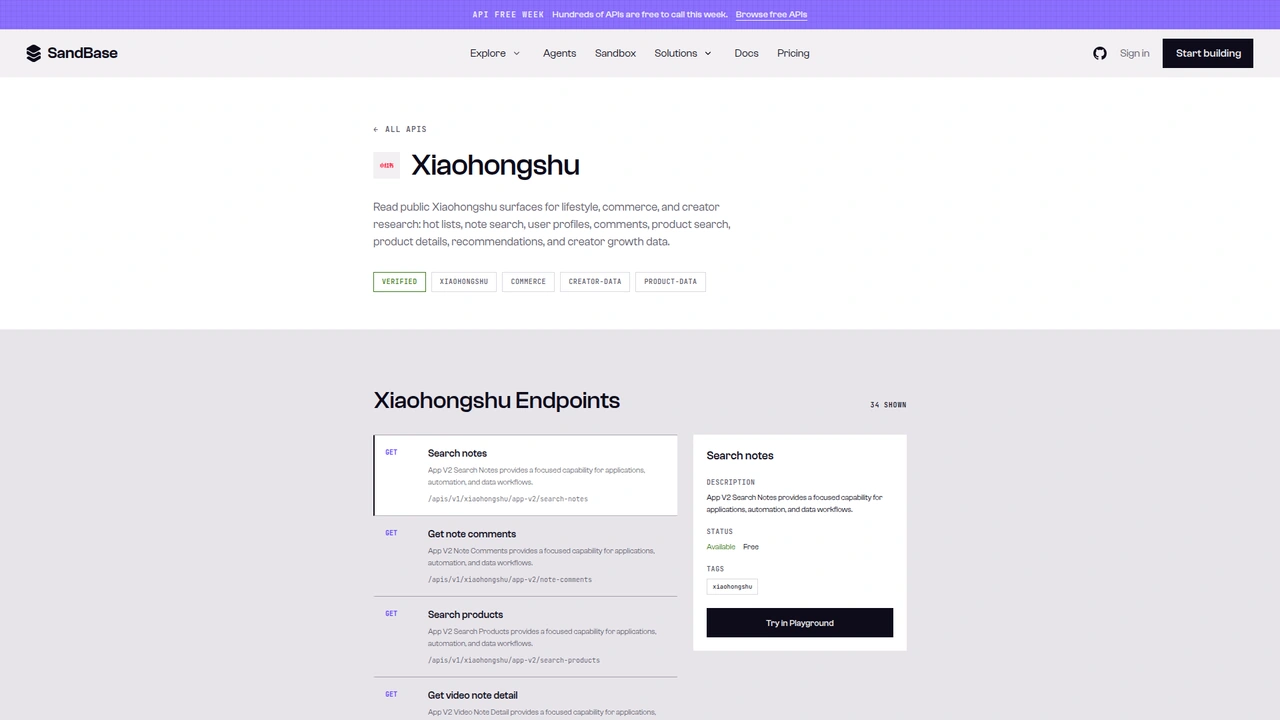 历史目录截图,2026-10-01。端点数量与 Free 活动标价只反映当时页面,不代表当前计费。上面的代码使用 Model API POST 路由。
联想词与搜索观察
关键词“防晒霜”的联想调用 74a3e360-568a-4688-b9c4-f347d630a1a0 给出推荐、清爽不油腻、正确涂法、男生和军训等角度。这是旧 web-v3/search-suggest 实验,它用 code: 1000 和 success: true,不能据此把 1000 当成当前两个 app-v2 样本的成功码。
第 1 页 829c7829-b1d4-4588-abcb-bdabd4f2a16a 返回 20 项,在 data 旁带有 page: 1、next_page: 2 和两个搜索 ID;第 2 页 c578ddab-1bfe-42f9-ac33-509e5bb39206 返回另外 20 项,ID 不变、next_page: 3。其中出现 model_type: "ads" 卡片。同样搜两页,一次去重得到 40 条、另一次只有 30 条,说明结果会漂移,不能把样本当稳定排名。旧卡片里的互动与身份字段都是当时观察,新 helper 不做排名与身份导出。
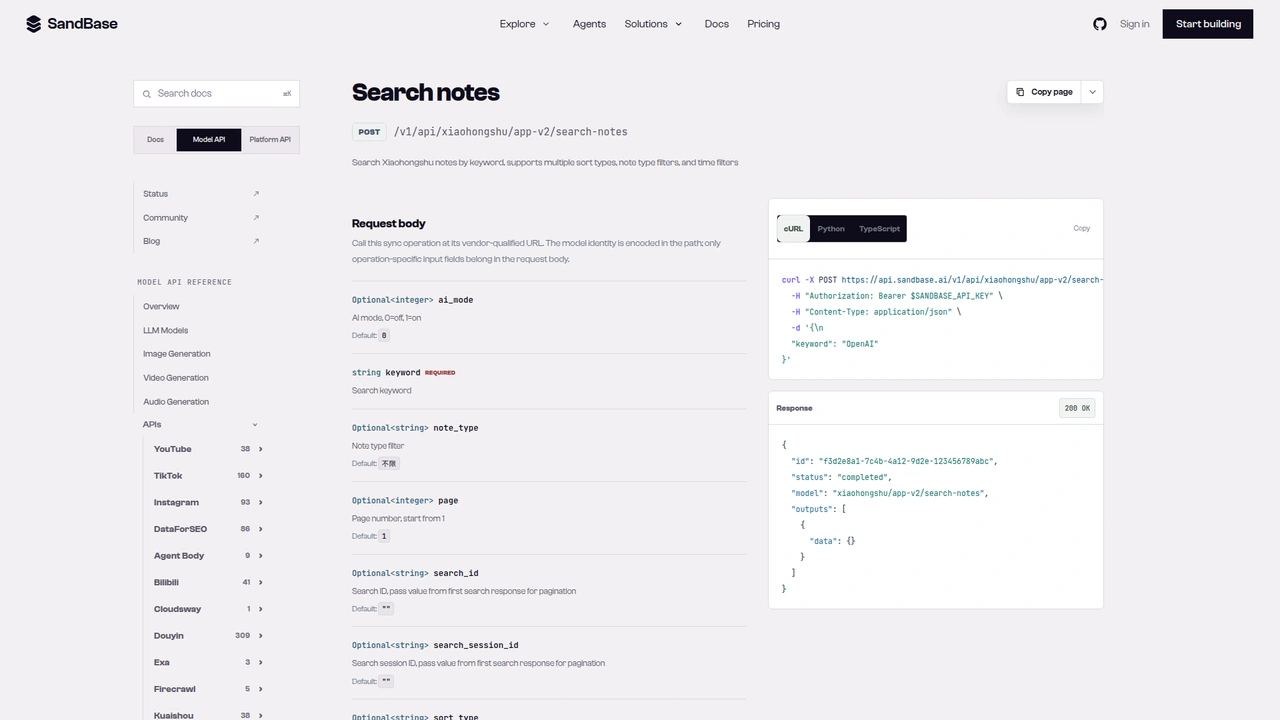 历史搜索参考页,2026-10-01:关键词与分页参数。当时的空响应示例不能替代本次核对的当前公开样本。
详情观察:成功码不等于选对笔记
旧图文详情把笔记放在 wrapper 的 note_list,视频详情则是平铺列表。把图文 ID 传给视频接口时,fd0b3c04-618a-4a9b-8098-153badd96660 虽然返回 code: 0,却是两条无关视频。请求成功不能替代资源 ID 核对。这两个详情端点都不在本次可执行流程里。
下面保留公开品牌笔记的裁剪返回,来自旧 run f90a6662-0eb4-49b5-a76b-88ffe488d085;640fbaba-3390-4935-a269-08ba2162937c 当时再次读取,数字相同:
{
  "code": 0,
  "success": true,
  "data": [
    {
      "model_type": "note",
      "note_list": [
        {
          "id": "6a749cd70000000005021fd8",
          "type": "normal",
          "title": "莎莎周边已就位!晒单抽亲签💙",
          "desc": "夏日养肤,谁还没用这套!\n维稳抗应激、深层修护、清洁净肤……",
          "liked_count": 4297,
          "collected_count": 136,
          "comments_count": 193,
          "shared_count": 86,
          "time": 1786071657,
          "ip_location": "Shanghai",
          "view_count": 0,
          "hash_tag": [
            {"name": "理肤泉B5面膜PRO", "type": "topic"},
            {"name": "理肤泉超级B5精华", "type": "topic"}
          ],
          "user": {"nickname": "理肤泉larocheposay", "red_official_verified": false}
        }
      ]
    }
  ]
}
这里的 view_count: 0 不能证明实际浏览量为零;品牌账号的 red_official_verified: false 也不能用于区分全部品牌与素人。不要依赖这两个值偷懒做排名。指标缺失就保留未知,算比例必须同时有有效计数和正的分母。旧图文详情也曾返回视频笔记但缺少视频信息块,这不代表今天已经验证了可用的 fallback。
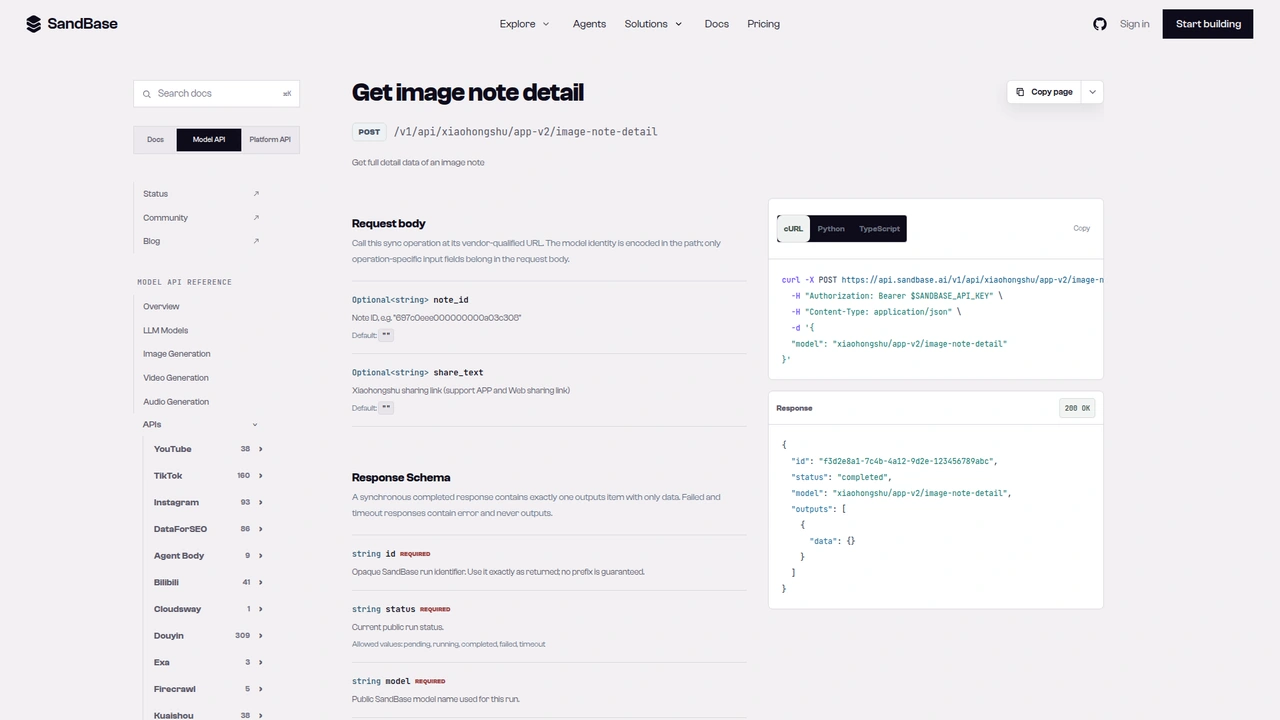 历史图文详情参考页,2026-10-01。它属于归档实验,当前 helper 不调用该端点。
评论观察与分页边界
旧实验把 JSON 字符串 cursor 原样传回(dbfada10-3360-4a16-a0fd-e0cd1b2db866),又试了拆分字段(a01020cc-24ea-4d94-aea9-64bfa31b921e),当时均得到相同的后 10 条评论。新 helper 两种续页方式都没实现,下一页需要完整的新响应和单独验证。
旧品牌笔记按 like_count 排时,第一条是 0 赞、18 回复,后面才是 97、41、30 赞,顺序不是严格的数值降序。评论计数和回复字段也是当时观察。样本可以帮助发现待调查的问题,不能代表所有读者,更不能直接证明购买意愿。
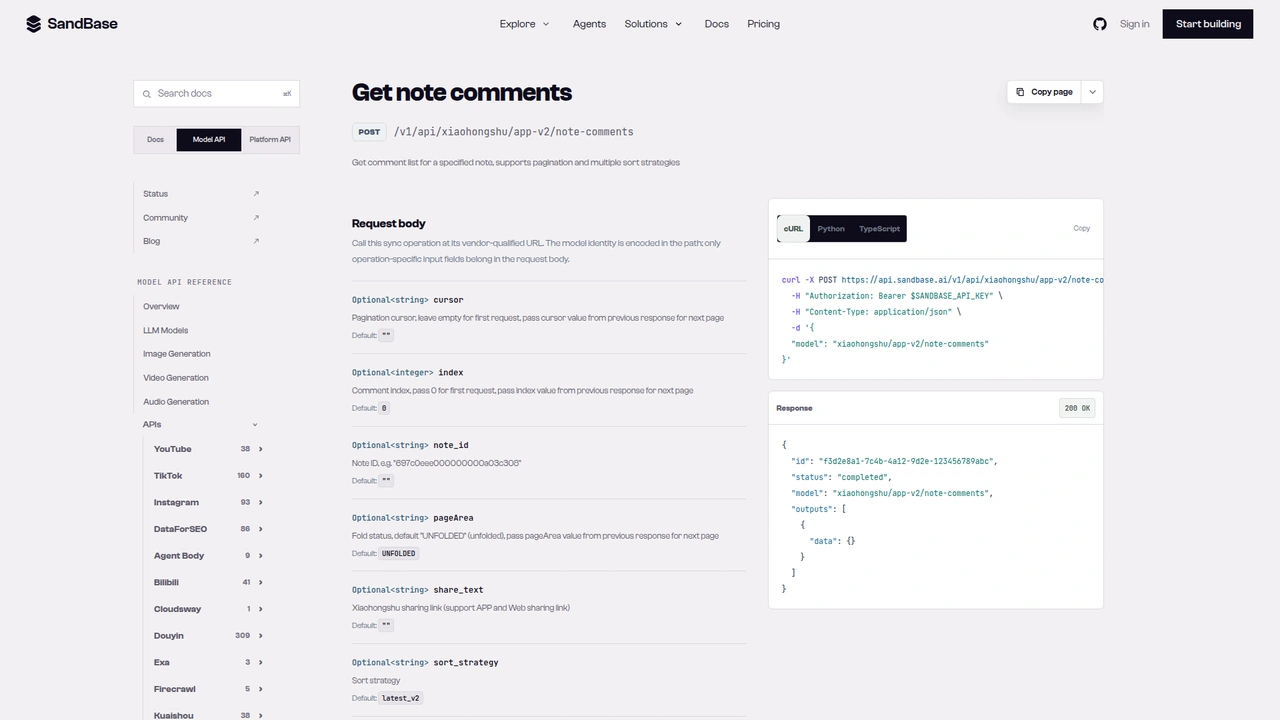 历史评论参考页,2026-10-01:cursor、index、note_id、pageArea、share_text 和 sort_strategy。当前首页默认值已在 2026-11-08 单独核对。
原品类报告,不是当前榜单
2026-10-01 的 research_topic("防晒霜") 使用两次搜索 be1bcdab-01f0-41c8-ba6c-7d64f74ab394、1ad8a233-75c2-4054-afa0-14e8396eb072,去重后 30 条,视频占 23%,点赞中位数 84,前五条中三条是视频。搞笑视频约 15.6 万赞、6,700 收藏,防晒盘点约 2.2 万赞、2.55 万收藏,品牌抽奖则是 4,297 赞、136 收藏。收藏可能更接近需要回看的资料,但这里只覆盖一个关键词、一个日期,不能推广成品类规律。
原计划两次搜索加每条候选一次详情、一次评论,五条候选就是 12 次,加联想词为 13 次,尚未算重试。这是旧流程调用量,不是今天的一次请求报价,也不证明额外端点已重新验证。旧实验还把 app-v2 搜索 token 交给 web-v3/note-detail 试了三次,均为 HTTP 503 包上游 400;本文不推荐据此添加 token fallback。
常见问题
需要小红书账号或登录吗? 这两个请求 schema 使用 SandBase API 鉴权,不要求小红书登录 cookie。它们也不提供私密或需账号权限内容的访问授权。
评论可以用分享链接吗?
参考说明支持 share_text 作为替代输入;这个 helper 有意只校验已知 note_id。本次没验证分享链接路径。
为什么搜索不要求 success: true?
当前公开搜索样本没有这个字段,强制要求会误拒绝样本。代码检查整数 code: 0 和目标列表,同时拒绝显式矛盾的 success 值。
可以让 agent 继续翻页、自动打开最好的笔记吗? 这是下一项独立任务。先核对完整真实返回,约定筛选标准和请求预算,再实现;不能把旧代码或截断 token 当作已验证的流程。
可以做市场排名吗? 第一页能提出研究问题,不能代表整个市场。缺失指标、广告卡、结果漂移以及未确认的浏览量都会影响比较。
从手里已有的输入选对第一条请求,把样本与局限一起保存,再决定后面的研究范围。
2026 年 SandBase Xiaohongshu 枢纽的标价对比,见 2026 年最佳 Xiaohongshu API:价格对比。
觉得有用?分享给更多人