用一个 API 搭建 YouTube 转录管道 | SandBase
用 Python 串联 YouTube 字幕任务:发现语言轨道、指定语言获取正文、保存 SRT,并保留视频来源和时间码供研究使用。
拿到字幕语言列表,还不能直接交给 LLM 做摘要。这篇教程面向用 Python 处理 YouTube 研究材料的开发者:从频道找到视频,检查字幕轨道,再选择语言获取正文、保存 SRT。已经知道视频 ID 或 URL 时,可以直接从字幕步骤开始。请求使用 SandBase Bearer key,密钥应留在服务端。
实测日期:2026 年 11 月 5 日(UTC),使用 HTTP Model API。 NASA 频道解析为 UCLA_DiR1FfKNvjuUpBHmylQ,首个列表返回 30 个视频。首条视频 Zezt6EsG9WE 返回 20 种字幕语言;选择 en、设置 format=srt 后取得 160 条带时间码的字幕,以 UTF-8 保存并原样读回。这些是当次观察,不是固定页大小或可用性承诺。下方代码使用这次响应中核实的路径,缺必要数据时会停止。
如果你想先看完整的端点全景,从 YouTube 公开数据 API hub 开始。这一篇是落地的管道。
先说结论
- 频道发现路径:
channel-id→channel-videos→video-info→video-captions;选择语言后,还需再次请求字幕端点获取正文。- 每次都是
POST /v1/api/youtube/<path>,一把SANDBASE_API_KEY;响应共用{ id, status, model, outputs }信封。- 把
channel_id和每个video_id作为稳定的键在各步之间往下传。- 只是公开、只读的字幕;仍需一把 SandBase key,但你这边没有 Google Cloud 项目或 OAuth。
管道全貌
| 步骤 | 端点 | 输入 | 你拿到 |
|---|---|---|---|
| 1. 解析频道 | youtube/web/channel-id | channel_name | 稳定的 channel_id |
| 2. 列出视频 | youtube/web-v2/channel-videos | channel_id | 视频列表;续页信息需核实 |
| 3. 读取视频 | youtube/web-v2/video-info | video_id | 视频元数据;字幕信息需核实 |
| 4. 发现轨道 | youtube/web-v2/video-captions | video_id 或 video_url,不指定语言 | 可用字幕语言 |
| 5. 获取正文 | 同一个字幕端点 | 视频输入、选定的 language_code、format=srt | SRT 格式的 content |
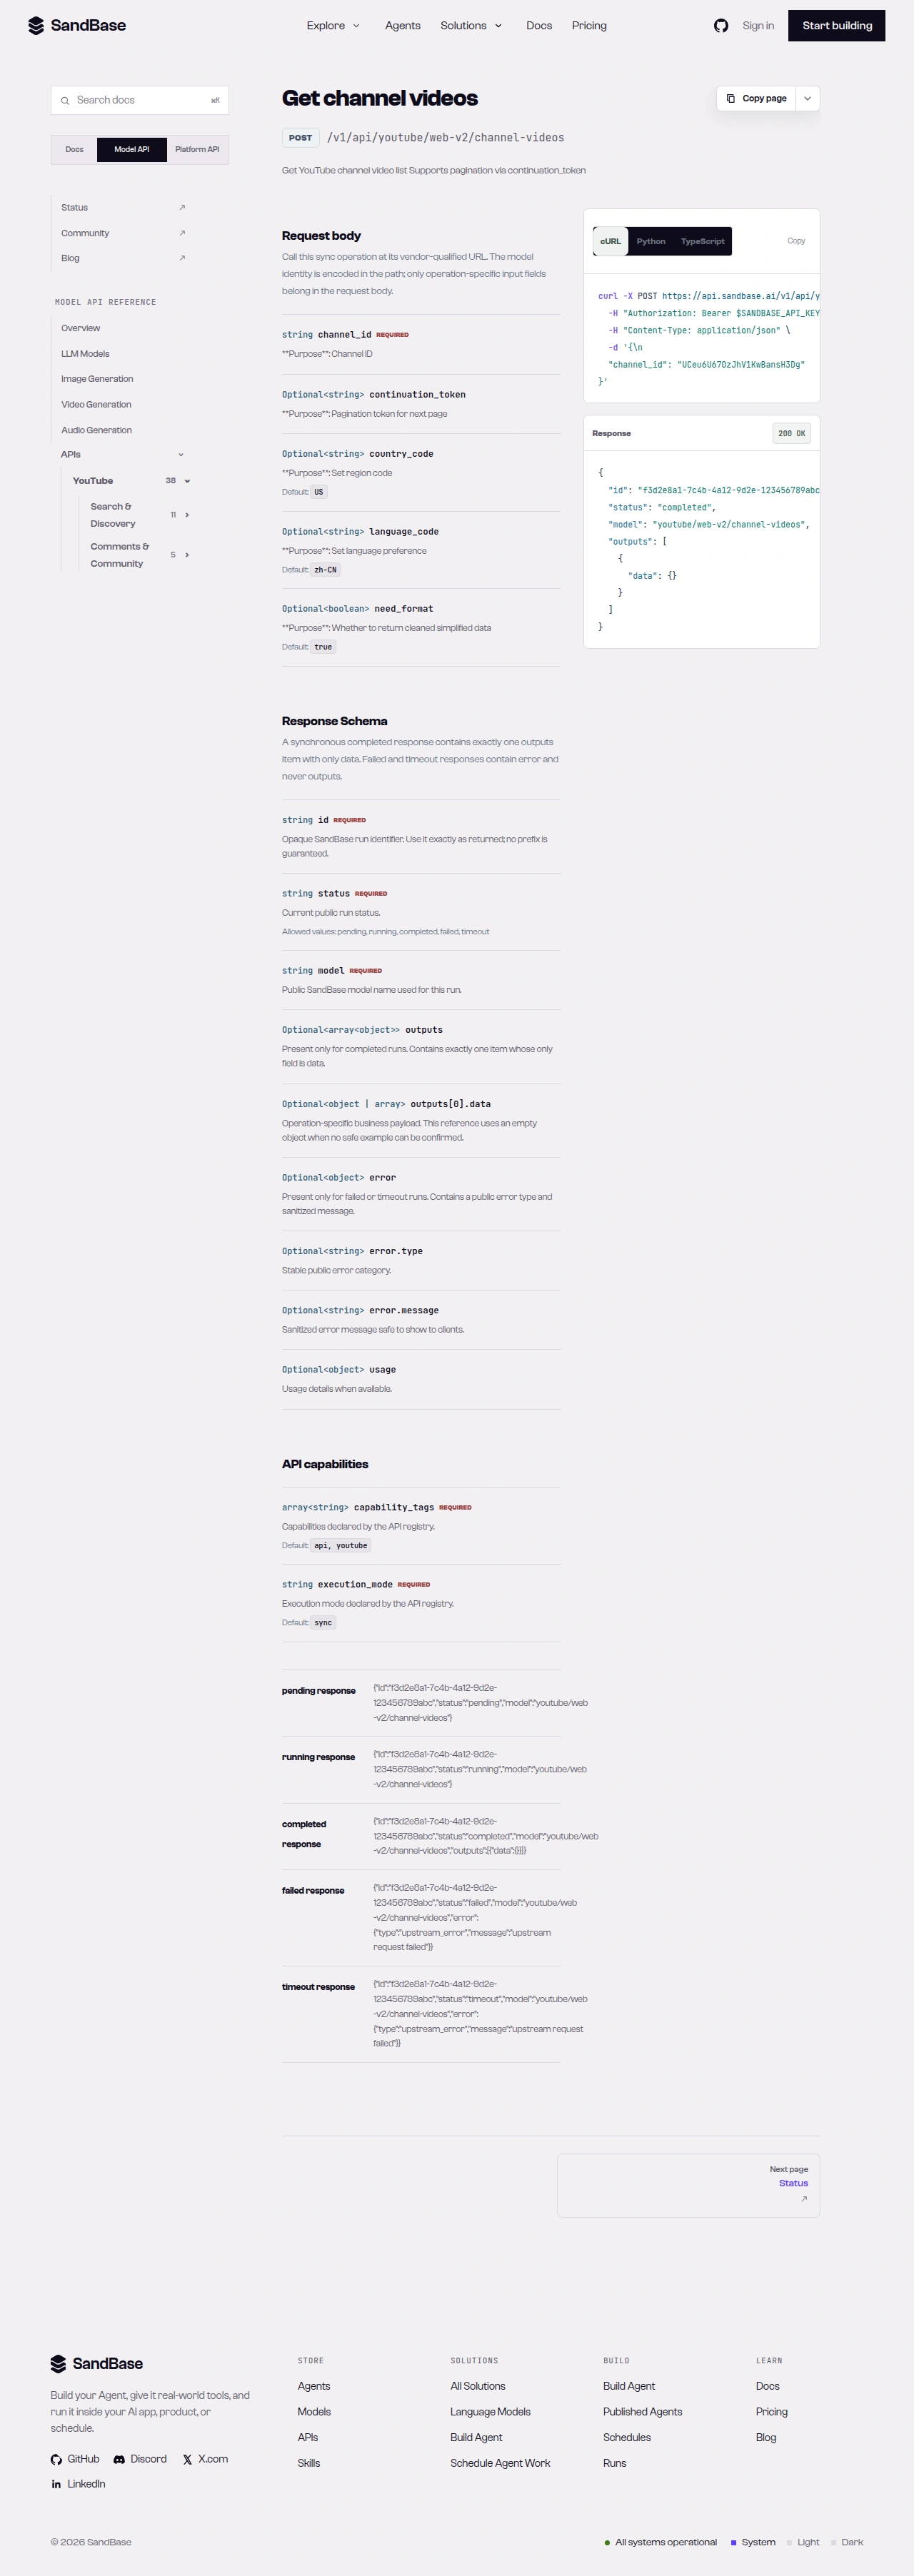 原有 channel-videos 参考截图,展示请求参数。图中的空示例负载不能验证业务字段映射。
第 1 步 —— 解析频道
你通常从频道名称开始,而不是 ID。先解析 channel_id,再在后续步骤复用。先运行 python -m pip install requests,并在环境中设置 SANDBASE_API_KEY。使用 Python 3.10+ 按顺序执行下方代码块,调用 Model API POST 路由,不是目录的 GET 请求:
import os
import requests

BASE = "https://api.sandbase.ai/v1/api/youtube"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}


def call(path: str, payload: dict) -> dict | list:
    resp = requests.post(f"{BASE}/{path}", headers=HEADERS, json=payload, timeout=120)
    resp.raise_for_status()
    body = resp.json()
    if not isinstance(body, dict) or body.get("status") != "completed":
        raise RuntimeError("SandBase request did not complete")
    outputs = body.get("outputs")
    if not isinstance(outputs, list) or not outputs or not isinstance(outputs[0], dict):
        raise RuntimeError("Completed response has no valid outputs array")
    data = outputs[0].get("data")
    if not isinstance(data, (dict, list)):
        raise RuntimeError("Completed response has no data object or array")
    return data


channel = call("web/channel-id", {"channel_name": "NASA"})
if not isinstance(channel, dict) or not channel.get("channel_id"):
    raise ValueError("Channel response has no channel_id")
channel_id = channel["channel_id"]
print(channel_id)
这个 call 帮助函数在碰 outputs 之前先判 status——下面每一步都复用它。外层解析器会拒绝缺失的数据,不会悄悄返回空对象。后续检查针对本次观察到的结构;字段结构变更应当作为接入错误处理,而不是当成空数据。
第 2 步 —— 列出频道的视频
把 channel_id 传进去列出近期上传。本次响应将视频记录放在 videos 中,将下一页信息放在 continuation_token 中:
listing = call("web-v2/channel-videos", {"channel_id": channel_id})
if not isinstance(listing, dict) or not isinstance(listing.get("videos"), list):
    raise ValueError("Channel listing has no videos array")
videos = [v for v in listing["videos"] if isinstance(v, dict) and v.get("video_id")]
if not videos:
    raise ValueError("Channel listing contains no usable video IDs")
first = videos[0]
print(first.get("video_id"), "-", first.get("title"))
实测将首个响应的 continuation_token 连同相同 channel_id 传回后,又取得 30 个视频,两页的视频 ID 没有重叠。这只验证了一次续页,不代表已获取完整频道历史。批量任务应设置页数和调用预算,按视频 ID 去重;没有新游标或游标重复时停止,不无限循环。
第 3 步 —— 读取视频的元数据
拉字幕之前,先读取视频元数据,作为研究记录的背景:
info = call("web-v2/video-info", {"video_id": first.get("video_id")})
if not isinstance(info, dict):
    raise ValueError("Video metadata is not an object")
print(info.get("title"), "|", info.get("author"), "|", info.get("category"))
print(info.get("view_count"), "views,", info.get("length_seconds"), "seconds")
本次元数据含 title、author、category、view_count、length_seconds 和 captions。其中部分计数是字符串,参与计算前需要规范类型。元数据不能保证稍后的字幕下载成功,下一步仍需直接查询轨道。
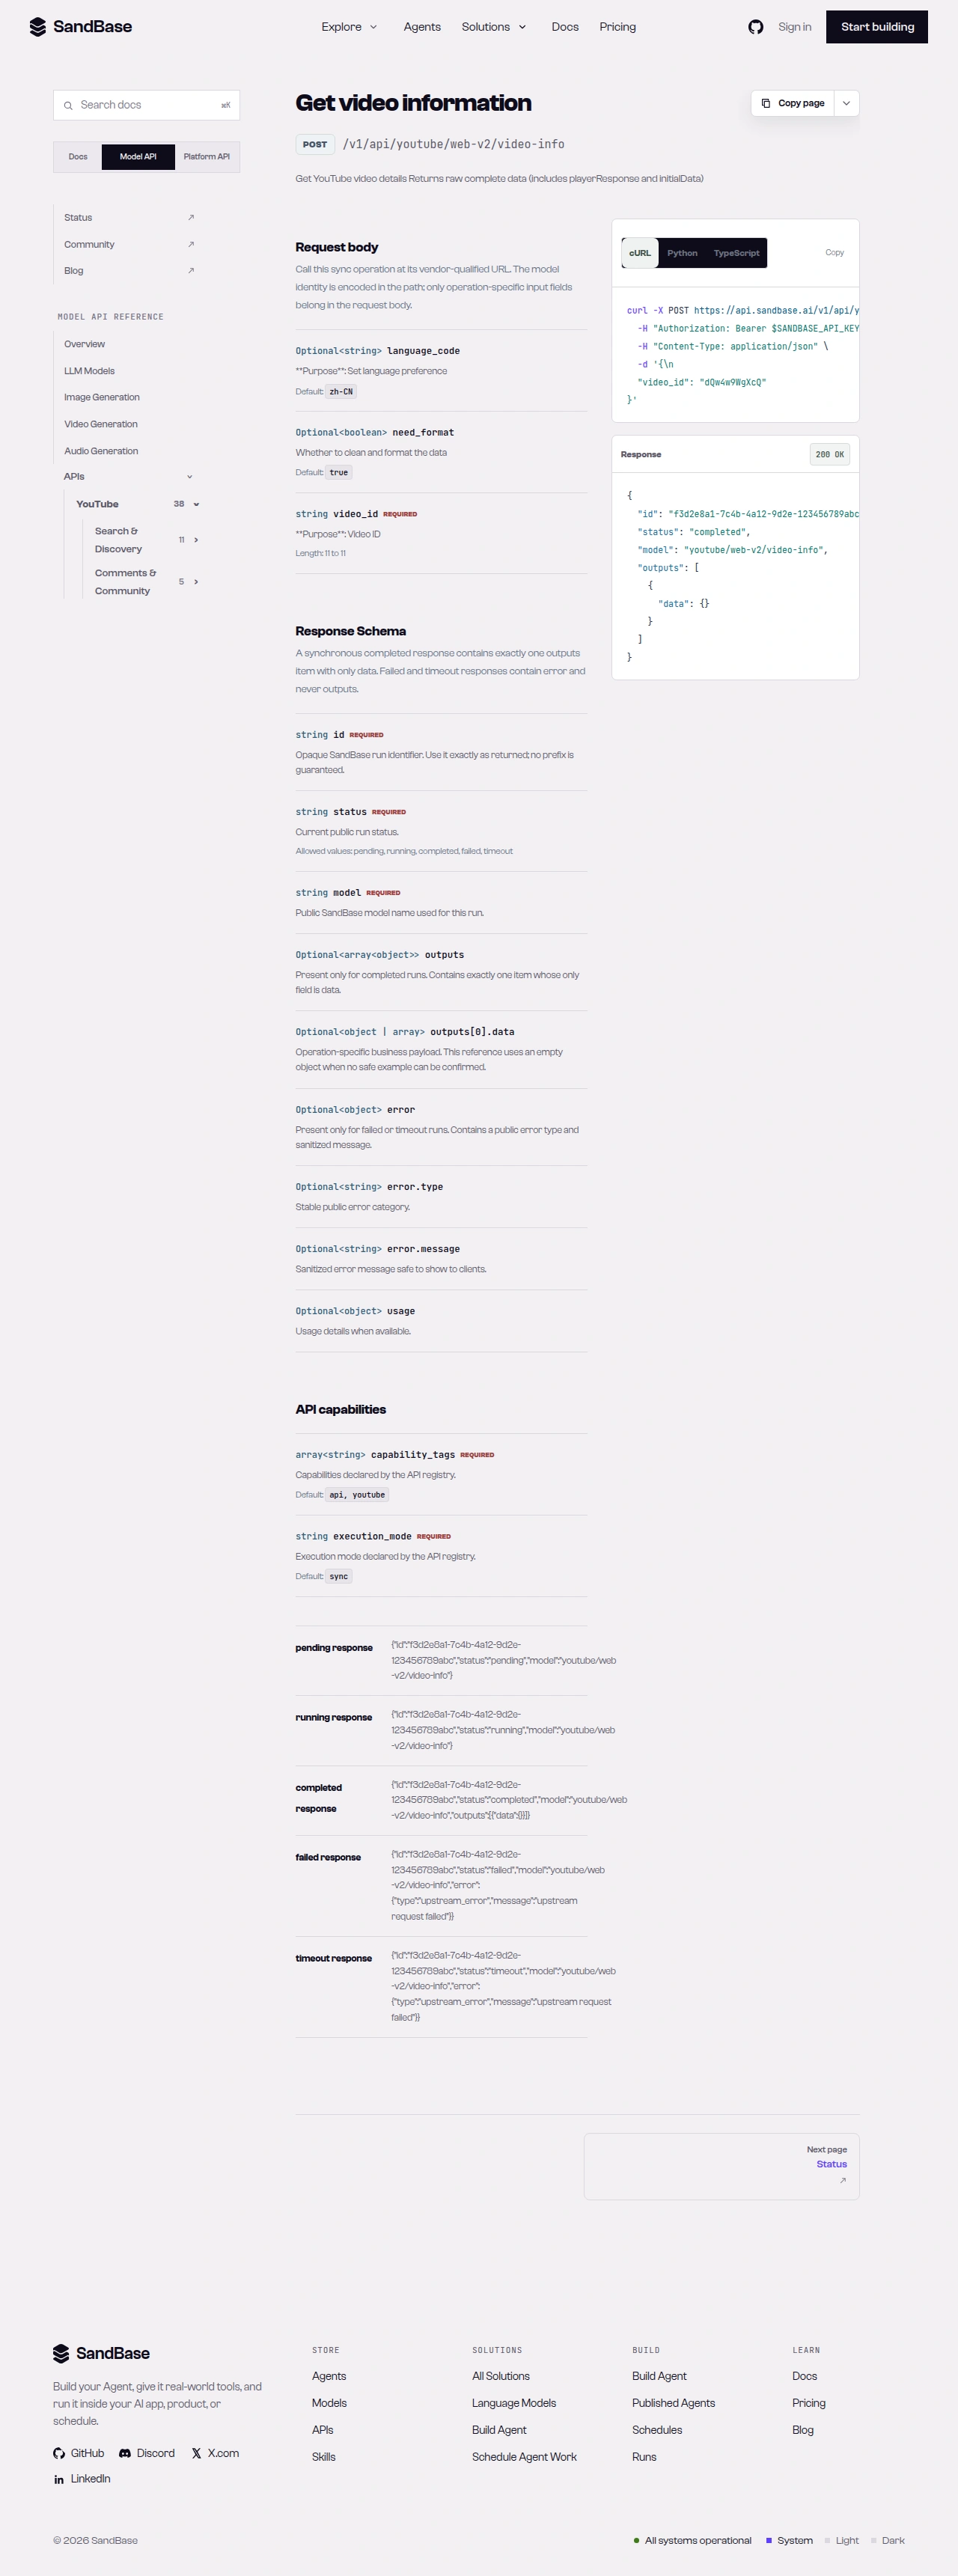 保留的 video-info 历史参考截图,展示参数与参考页面,不是本次字幕获取测试的截图。
第 4 步 —— 发现字幕轨道
不传 language_code,先查询这个视频有哪些轨道。沿用频道示例时,先确认视频 ID 的字段映射确实取到了值:
video_id = first.get("video_id")
if not video_id:
    raise ValueError("Select a video ID before requesting captions")
result = call("web-v2/video-captions", {"video_id": video_id})
if not isinstance(result, dict) or not isinstance(result.get("captions"), list):
    raise ValueError("Caption discovery has no captions array")
languages = [t["language_code"] for t in result["captions"]
             if isinstance(t, dict) and isinstance(t.get("language_code"), str) and t["language_code"]]
if not languages:
    raise ValueError("No caption tracks were returned")
print(languages)
这一步拿到的是选语言的信息,不是字幕正文。本次发现响应为对象,含 captions 和 video_id,轨道记录含 language_code 与 language_name。先查看打印出的语言代码,再决定获取哪条;不能假设另一个视频也有英文或自动字幕。
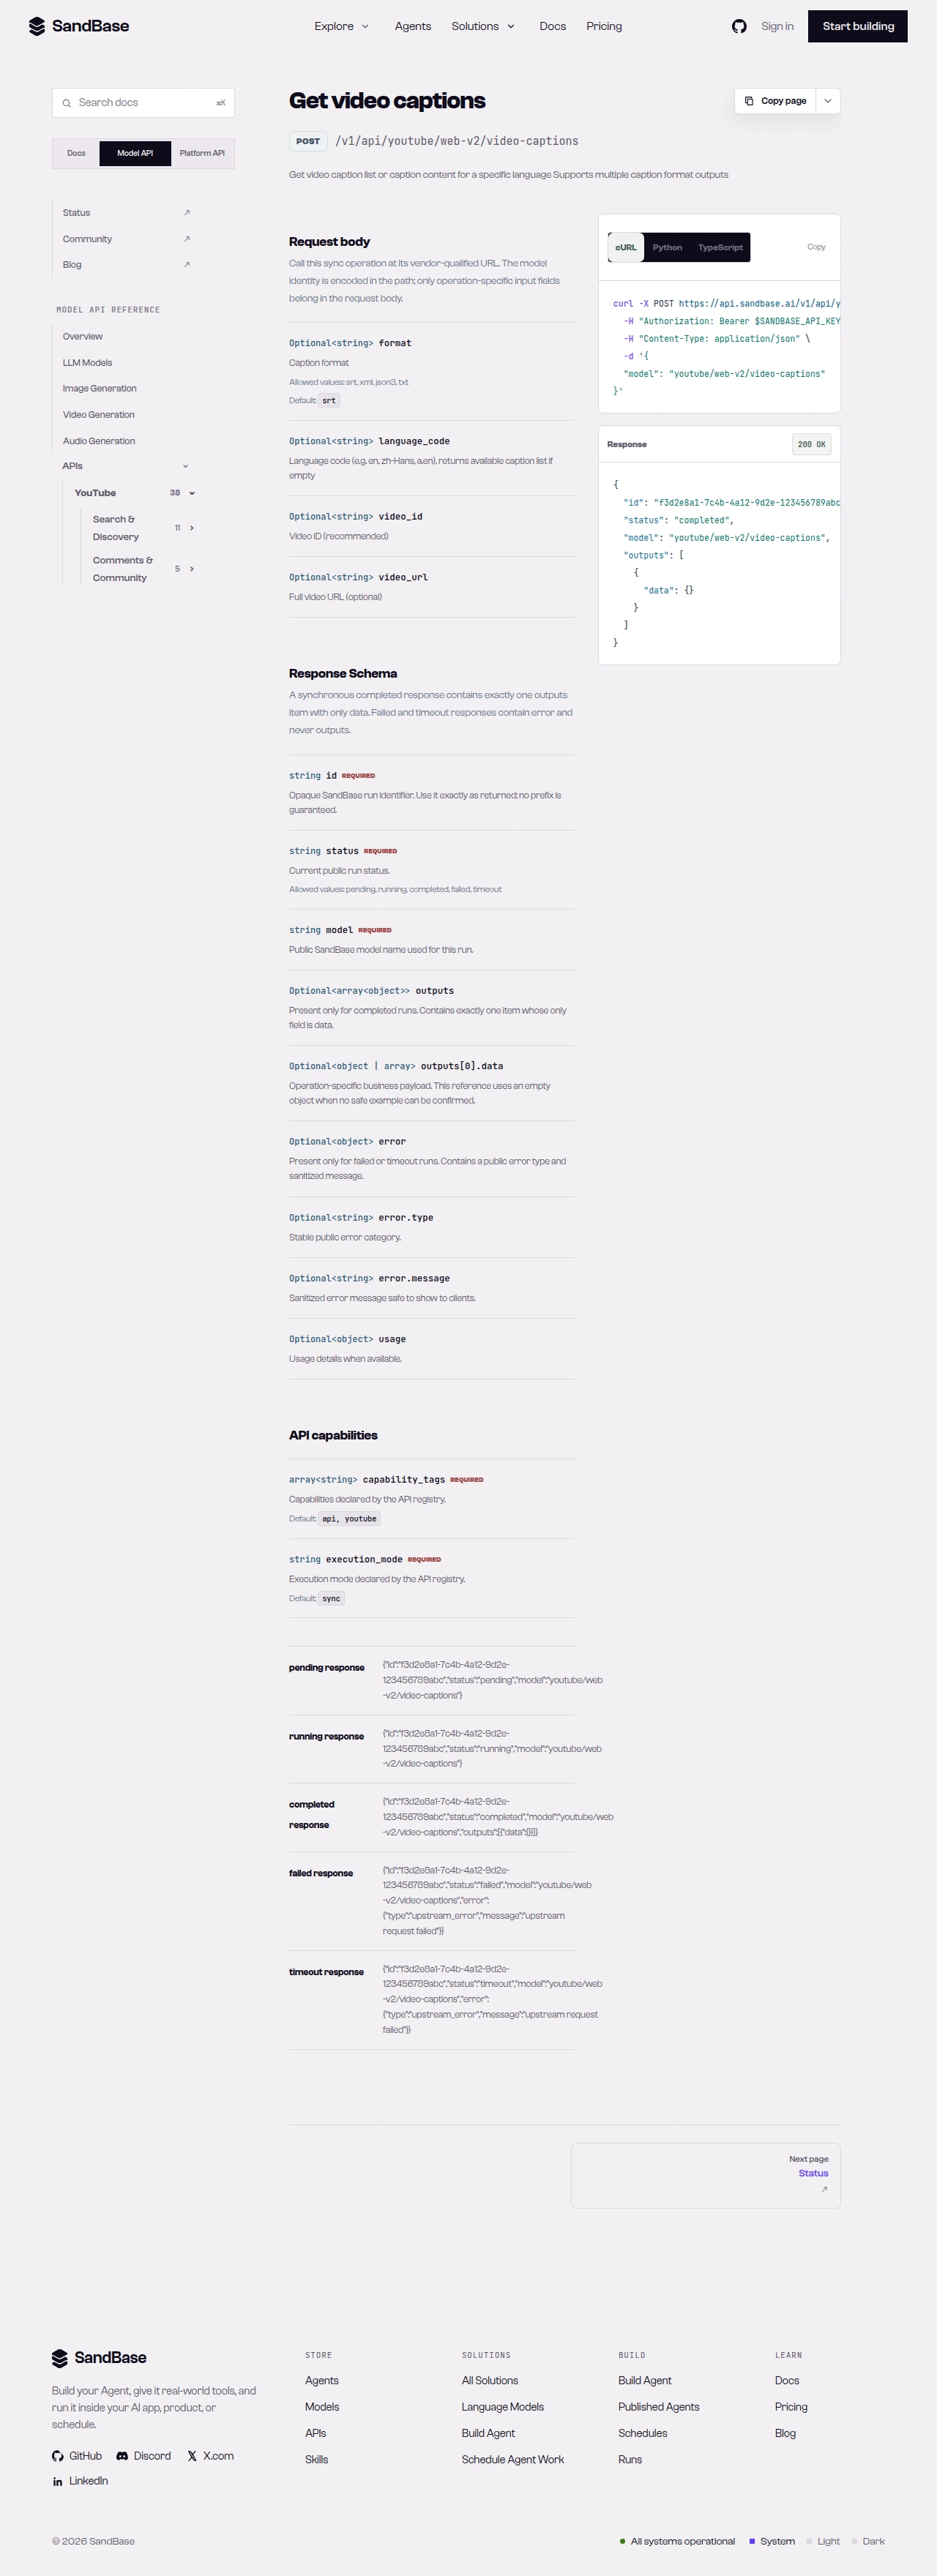 保留的 video-captions 参考截图。选择语言和获取正文请以当前参考为准,图中旧生成请求省略了视频输入,请使用当前参考,不要照抄旧请求。
选定字幕语言后,再获取转录正文
字幕接口的两次请求承担不同任务。先提供 video_id 或 video_url,将 language_code 留空,发现可用轨道;再使用同一视频输入和刚返回的语言代码发起第二次请求,获取该轨道的正文。不要把另一个视频支持的语言当作当前视频的可用选项。
YouTube captions API 参考 提供当前参数和 Playground。README 将选定格式的字幕正文命名为 content,放在 outputs[0].data 下。下方保存函数会核对视频、语言、格式和非空正文后再写文件。参数表把两个视频标识分别列为可选,不等于可以省略视频输入;README 要求提供 ID 或 URL。
下面只有在该视频返回的列表中存在英文时才请求 en。如果需要其他语言,应明确修改选择,不悄悄替换成另一种语言:
language_code = "en"
if language_code not in languages:
    raise ValueError("Choose a language_code from the printed available tracks")
caption = call("web-v2/video-captions", {
    "video_id": video_id,
    "language_code": language_code,
    "format": "srt",
})
规划采集任务时,要把发现轨道和下载选定轨道分开计数,并查看参考页的当前价格。语言列表只能说明可选项,不能作为视频说过什么的证据,更不应直接交给摘要步骤当正文。
保存 SRT,并衔接研究任务
需要起止时间码时,将 format 设为 srt。选定语言的请求完成后,先检查返回的 content 是非空字符串,再以 UTF-8 写入 .srt 文件。保留字幕序号、时间行和空行;不要把整个 JSON 响应写进 SRT 文件,也不要把轨道发现结果当字幕保存。
保存函数将字幕原文与来源记录分开写入。时间行检查能发现明显的错误输出,但不是完整的 SRT 格式验证器。对同一个视频和语言再次运行时,会替换 captions/ 中的对应文件。
import json
import re
from datetime import datetime, timezone
from pathlib import Path


def save_srt(data: dict, video_id: str, language_code: str, directory: Path) -> Path:
    if not isinstance(data, dict):
        raise ValueError("Caption result is not an object")
    if (data.get("video_id") != video_id or data.get("language_code") != language_code
            or data.get("format") != "srt"):
        raise ValueError("Caption result does not match the requested video, language and format")
    content = data.get("content")
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Caption content is empty or missing")
    if not re.search(r"^\d{2}:\d{2}:\d{2},\d{3} --> \d{2}:\d{2}:\d{2},\d{3}", content, re.M):
        raise ValueError("Caption content has no SRT timing line")
    if not re.fullmatch(r"[A-Za-z0-9_-]{11}", video_id) or not re.fullmatch(r"[A-Za-z0-9.-]+", language_code):
        raise ValueError("Unsafe output filename")
    directory.mkdir(parents=True, exist_ok=True)
    path = directory / f"{video_id}.{language_code}.srt"
    path.write_text(content, encoding="utf-8")
    path.with_suffix(".source.json").write_text(json.dumps({
        "video_id": video_id,
        "source_url": f"https://www.youtube.com/watch?v={video_id}",
        "language_code": language_code,
        "format": "srt",
        "retrieved_at": datetime.now(timezone.utc).isoformat(),
    }, ensure_ascii=False, indent=2), encoding="utf-8")
    return path


saved = save_srt(caption, video_id, language_code, Path("captions"))
print(saved)
在文件旁记录来源视频 URL 和选定语言,方便研究时回到原视频核对。采集日期与视频发布日期分别保存。如果还要生成供 LLM 阅读的纯文本,保留原始 SRT:去掉时间码后,只凭整理过的文字很难定位原句及其上下文。
YouTube Research Skill 声明了字幕端点依赖,并要求在有时间码时引用。拿到字幕后,可以按这个任务入口组织带来源的研究简报。安装 Skill 和配置 MCP 是另外的步骤,详见 Skill 页面;本文没有演示一次实际的 Skill 运行,也不表示存在自动上传 SRT 的集成。
将获取结果接入索引
保存 SRT 不等于已经完成索引。本次验证到字幕文件与来源记录落盘为止。接入你自己的索引器前,先确定如何保留字幕时间码和视频来源。
逐视频记录三个状态:轨道发现是否完成、是否选到可用语言、是否保存了非空字幕正文。满足这些条件后,才把材料交给你自己的索引器。缺字幕与请求失败要分开记录,避免把失败请求误当成一份空文档。索引和摘要仍由应用实现,不是上面的代码已经提供的能力。
处理粗糙的边角
- 处理轨道缺失。 空轨道列表会让代码停止。本次抽样视频均有字幕,空列表分支由离线测试覆盖,不能称为已找到并验证了真实无字幕样本。请求失败也不等于没有字幕。
- 有意识地翻页。 接入前核对频道端点当前的参数和返回值,不猜游标路径,也不把第一页当成整个频道。
- 对
status分支。call会拒绝未完成的响应和畸形outputs,错误没有结构化 message 时也不会被当作成功。 - 区分错误与空结果。 本次缺视频输入与无效语言均返回 HTTP 400,helper 会抛错,不会保存空字幕。生产环境可对 HTTP 429 设置有限退避;本次没有人为触发限流。
- 读 schema。 字段名和嵌套会随端点版本不同——先看一份真实响应、对准路径,再动手。
统一 API 层解决了什么
同一个 Bearer 鉴权的 HTTP 帮助函数,可以集中处理请求。各端点的业务负载仍需分别检查,再映射到你自己的记录中。频道列表、视频元数据与字幕正文共用响应外层,不代表它们内部字段一致。
代价是应用通过 SandBase 获取公开数据,而不是自行掌控底层抓取。字幕可用性和上游访问状态可能变化。保存来源与获取状态,研究时才能区分“材料缺失”和“已经成功获取”;字段映射失效时,应重新核对当前参考。
常见问题
需要 Google 账号或 OAuth 吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权。这条管道读的是公开、只读的字幕,你这边不用 Google Cloud 项目、不用 YouTube Data API 配额,也不用 OAuth。
频道的视频怎么翻页?
本次已将首个响应的 continuation_token 连同相同频道 ID 传回 channel-videos,取得第二页。没有新游标或新记录时停止,并设置调用预算。两页结果不代表完整频道历史。
video-captions 会返回字幕文本吗?
不带 language_code 时,返回可用字幕轨道;传入该视频实际返回的语言代码后,按选定格式获取字幕正文。先发现轨道,再选语言,不假设每个视频都有字幕或必定支持某种语言。
没有字幕轨道的视频,也能拿到转录吗? 这条流程使用可访问公开视频已有的字幕轨道,不承诺为无字幕视频做音频转录,也不承诺私有视频访问或绕过访问限制。没有字幕时,应把它记录为研究输入缺失,而不是正文为空。
本次 HTTP 响应摘录
调用 POST /v1/api/youtube/web-v2/video-captions,请求体为 {"video_id":"Zezt6EsG9WE","language_code":"en","format":"srt"}。2026 年 11 月 5 日的 run 6884d7cd-e433-4cd5-8ef1-db0854cc30bf 返回以下裁剪结果,仅保留第一条字幕;完整结果有 160 条。
{"id":"6884d7cd-e433-4cd5-8ef1-db0854cc30bf","status":"completed","outputs":[{"data":{"video_id":"Zezt6EsG9WE","language_code":"en","format":"srt","content":"1\n00:00:02,135 --> 00:00:03,069\nThink about"}}]}另一次仅传 video_url 的发现请求返回相同语言代码集合。缺视频输入与 language_code=zz-invalid 被拒绝,这些观察不是完整错误码清单。私有视频、ASR、XML/JSON3/TXT 输出、自动重试和实际 Skill 研究均未测试。
下一步
先选一个可访问的公开视频,在字幕参考页查看它的可用语言,再取回选定轨道、保存 SRT 和来源信息,并核对一处时间码。等这些步骤在你的实际响应上跑通后,再接入索引或研究任务,最后扩展到频道采集。
觉得有用?分享给更多人