从零搭一个小红书 KOL 筛选和笔记搜索 Agent(2026):一把 API 密钥
用一把 API 密钥搭小红书达人短名单和笔记搜索:蒲公英筛创作者,关键词搜笔记,再交给模型写简报。公开只读。
小红书商业开放平台的 OAuth,筛不了一个从没授权给你的达人。旁边通常是另一把只出数据的 MCP 密钥,或者一套现成的飞书监听。SandBase 上已有七月的打分 CSV,也有笔记调研的搜索脚本。两篇都不是「蒲公英短名单 + 关键词笔记」这一套,也都不是 Skill 路径。
这里的小红书 KOL 数据接口,指蒲公英(PGY)上的公开达人读取。笔记搜索是第二个环:一个关键词,再看返回的笔记卡片。两环共用一把 SANDBASE_API_KEY,模型服务也走这把密钥。只做公开只读。结构化 JSON、爬虫、官方 OAuth 怎么选,先看 给 AI Agent 选社交数据接口。同一双环在抖音上的写法是 抖音竞品监控。选完再搭。
先说结论
- 环 A 按投放节奏筛蒲公英达人。环 B 更频繁地听一个品牌或品类关键词。简报既要点名达人、又要点出正在赢的笔记时,两个环一起跑。
- 2026-11-08,小红书 hub 页头是 67 of 67。旧文写的是截至 2026-10-01 的 34。67 是当天页头,不是冻结数字。
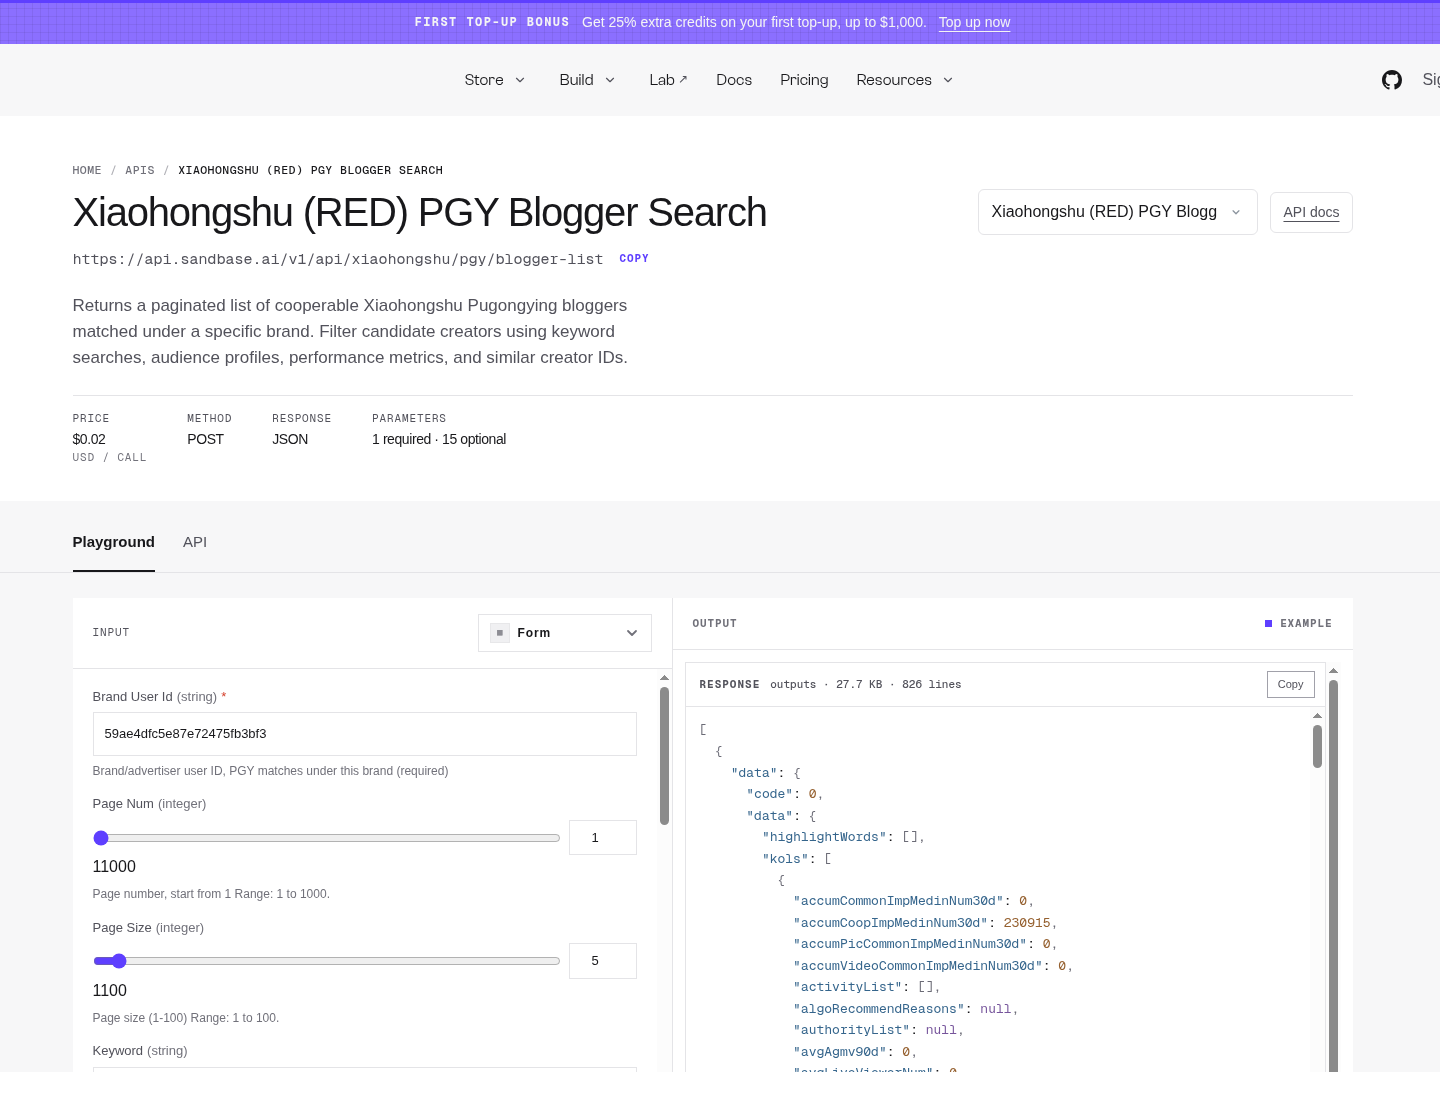
- 三个蒲公英接口当天标价 0.02 美元,页面没有每日免费额度那句话。
xiaohongshu/app-v2/search-notes是 0.01 美元,页面写明计入组织每天 100 次免费数据调用(UTC 零点重置)。本文没有跑inspect。- 在 Claude Code、Cursor、Codex 里走 Skill 或 MCP。REST 读
outputs[0].data。打分 CSV 和笔记翻页留在各自的旧文。
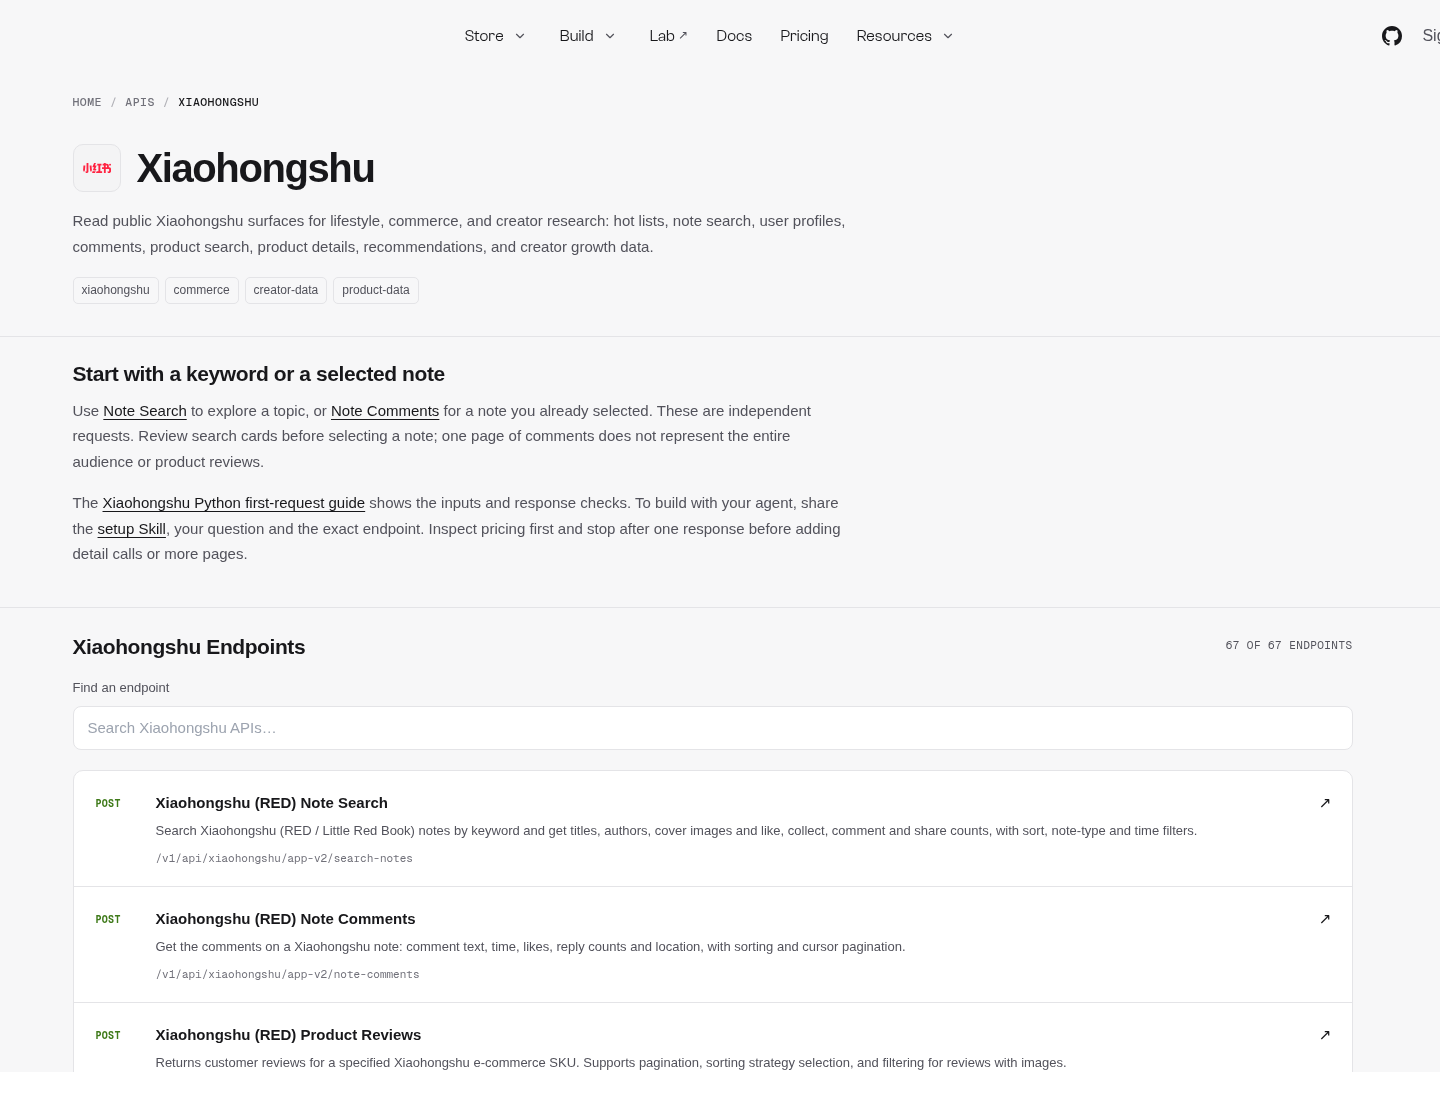 SandBase 小红书数据接口页:67 个笔记搜索、蒲公英达人与公开主页相关端点。
你在搭的两个环
环 A 回答:这个品牌、这个垂类,公开蒲公英名单里谁合适。环 B 回答:固定达人名单之外,这个关键词下出现了哪些笔记。两边都是只读。产出是短名单、Markdown 简报、webhook,或三样都要。
| 环 A,达人短名单 | 环 B,笔记搜索 | |
|---|---|---|
| 问题 | 谁适合这个品牌和垂类? | 这个关键词下有哪些笔记? |
| 你自己留着的输入 | 品牌 brand_user_id,外加标签和粉丝筛选 | 品牌词和品类词 |
| 和账单匹配的节奏 | 一轮投放,不是每小时 | 一天几次,不是每 15 分钟 |
| 数据接口 | pgy/blogger-list,再抽样详情、粉丝走势、已发笔记 | 可选联想,然后 app-v2/search-notes,只对留下的卡片开详情或评论 |
| 模型服务 | 判断是否匹配 brief | 总结体裁、标签和评论里的问题 |
只要达人名单,跑 A。只有关键词、还没有达人 id,跑 B。搜索没命中,不等于名单那一调用失败。
环 A:达人短名单
传入 brand_user_id,翻 xiaohongshu/pgy/blogger-list,再对少数 userId 拉 blogger-detail、blogger-fans-history 和一页 app-v2/user-posted-notes,让模型打合度。测过的 CSV、200 人预算和 2026-10-01 的运行记录在 小红书 KOL 筛选教程。这篇不重贴。
那天的教程发送了嵌套的 fans.count,以及 blogger.content_tag 数组。嵌套的粉丝区间确实筛过了。扁平的 fans_number_lower / fans_number_upper 被接受,但没有生效。2026-11-08 的参数表里已经没有这两个扁平字段。表把 blogger 和 fans 标成字符串。同一页的 Playground 示例却把 blogger 显示成对象。以当天 inspect 返回的形状为准。十月的运行是那天的证据,不是今天的模式保证。
 蒲公英
blogger-list 参考页:每次 $0.02,必填 brand_user_id;该页不展示共享免费额度说明。
环 B:笔记搜索
可以先用 xiaohongshu/web-v3/search-suggest 扩品类词,再调 xiaohongshu/app-v2/search-notes。model_type 不是笔记的卡片先丢掉,再按赞和收藏排。只对留下的卡片开图文或视频详情,以及评论第一页。测过的搜索、详情、评论脚本,包括 2026-10-01 一张 model_type 为 ads 的卡片和翻页注意点,在 小红书笔记调研。当天的搜索参考页仍写着一页里会混卡片类型,样本也不是大盘排名或销量。
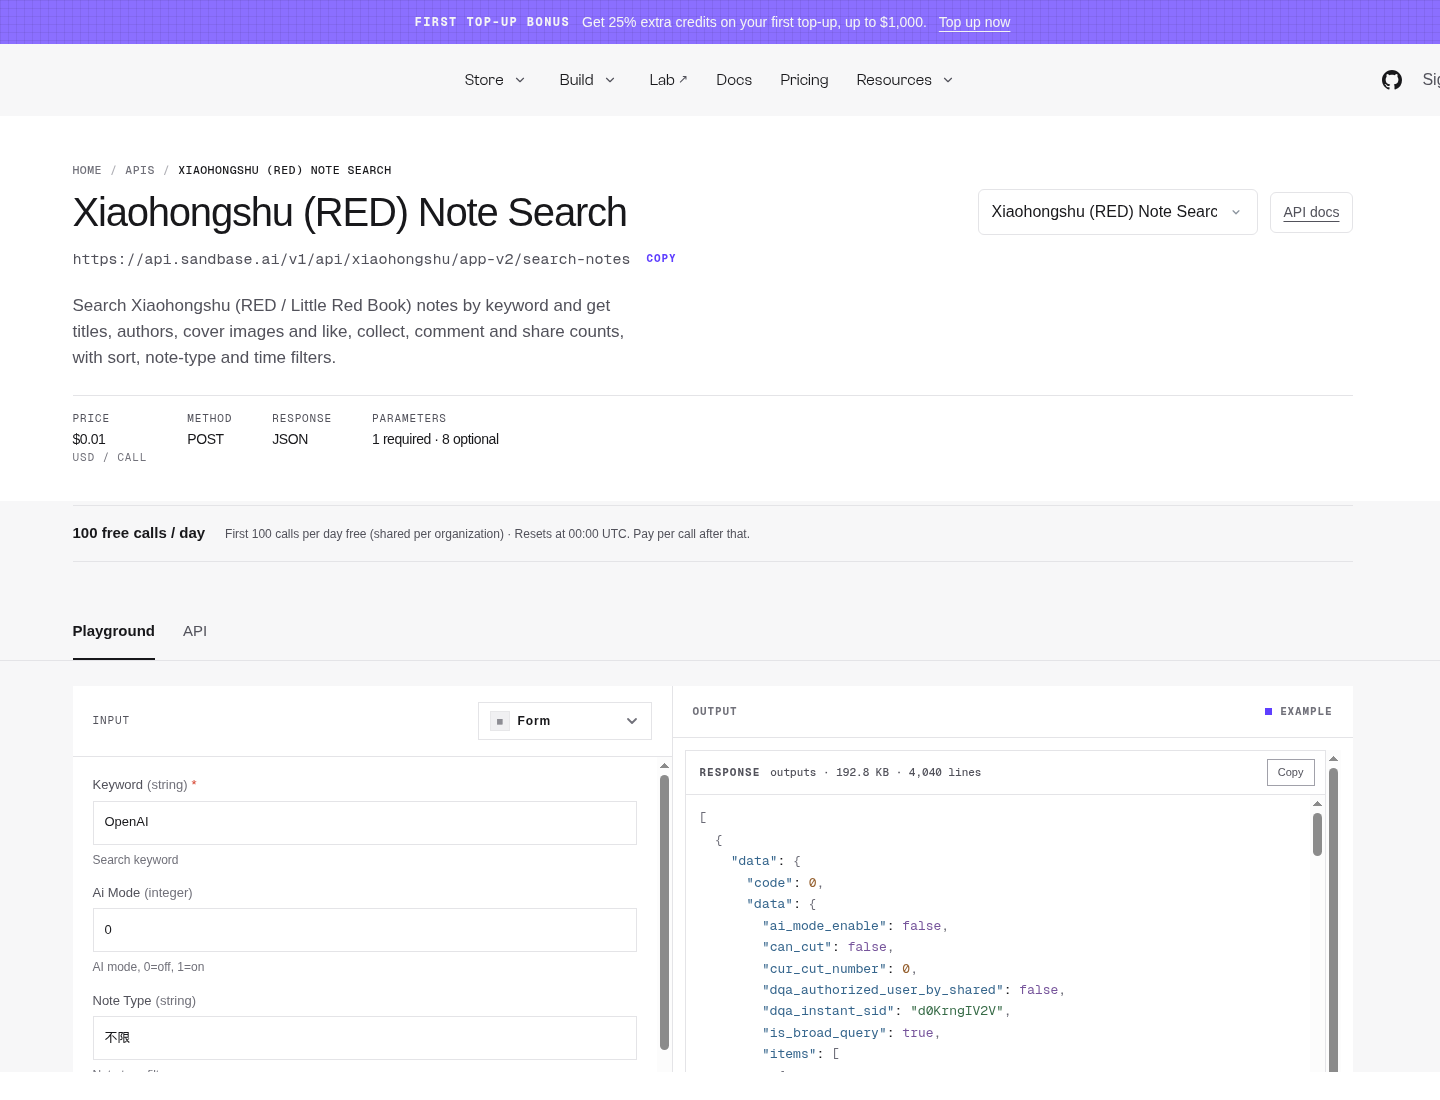
app-v2/search-notes:每次 $0.01,必填 keyword,并标注组织每日前 100 次免费调用。
前提和边界
REST 用 SandBase 的 API 密钥。编码助手走 Skill 时,用浏览器登录。下面这句不是终端命令,密钥也不进对话:
set up https://www.sandbase.ai/SKILL.mdSKILL.md 在 2026-11-08 的版本行是 0.3.9:discover 和 inspect 免费,只有 run 扣余额,而且不要默认每个接口都有每日免费额度。安装留在 Skill 与 MCP 指南。AI 工具页 是同一扇门,并写着符合条件的新账号有 1 美元起始额度。定价页 把同一项写成 starter credits,没有重复这个美元数,入账前到控制台确认。
当天定价:符合条件的数据接口,每个组织每天共享 100 次,UTC 零点重置。读目录和价格是 0 美元。失败不收费。Build 按次。代码沙箱当时免费,可能有公平使用上限,改价前会公告。模型调用不占这 100 次。首页 FAQ 写明模型调用另计。SandBase 不拥有小红书。
| 这个 Agent | 小红书自己的广告和蒲公英后台 | |
|---|---|---|
| 能读谁 | 公开的蒲公英列表行和公开笔记 | 授权了应用的品牌或代理商账号 |
| 凭证 | 一把 API 密钥,或 Skill 的浏览器登录 | 小红书自己的开发者应用 |
| 动作 | 没有 | 该授权允许的投放和发布路径 |
| 什么时候用 | 公开达人研究和品类监听 | 你自己品牌已授权的蒲公英或广告账号 |
blogger-list 的 FAQ 在 2026-11-08 写着:调这条 SandBase 路由,不必另申请小红书开发者密钥。官方文档中心 https://ad-market.xiaohongshu.com/docs-center?articleId=3181 当天返回 HTTP 200,抓到的 HTML 没有正文,所以这里不引用它的 scope。Cookie 登录、设备自动化和私信,不是这套研究的默认路径。
先对齐 id 和关键词
brand_user_id 是蒲公英名单要去匹配的品牌账号。七月教程用过 59ae4dfc5e87e72475fb3bf3,并把它标成完美日记的公开品牌账号。2026-11-08 的 Playground 芯片仍把这个 id 和一个美妆内容标签放在一起。同一页 README 的示例请求用的是 5dcfa5370000000001006030,没有写出账号名。本文没有再解析这两个 id。
响应字段表写了 data.kols[]、fansNum、30 日增长、内容标签、预估 CPM 和 businessNoteCount。该页示例 JSON 里还有 userId。当天核对过的字段表行没有列出它。七月的运行读的是 kols[].userId,再传给详情、粉丝走势和已发笔记。你自己的返回里看见这个 id,再往下串。
详情和评论用的 note_id,在搜索参考页上是 data.items[].note.id。同一张表写 note.type 为 normal(图文)或 video。xsec_token 被描述成卡片上观察到的 token。选定的 app-v2/note-comments 模式没有这个入参。不要把它发出去,也不要把它当成 SandBase 密钥。
只有显示名时,用 xiaohongshu/app-v2/search-users,必填 keyword,0.01 美元,页面有免费额度那句话。表单上的可选项是 page、search_id、source。本文没有调用它。hub 上还有 search-note、hot-search 这类短路径,是目录里的旁支。这个双环用下面的带版本 id。
调用小红书 KOL 接口和笔记搜索接口
目录页展示的是 GET 列表。真正调用走 Model API:
POST https://api.sandbase.ai/v1/api/<vendor>/<path>
请求体只放该接口的参数。完成态的业务负载在 outputs[0].data。status 不是 completed,或这个字段缺失,这一轮就失败。run id 不是负载。下面的辅助函数是文档里的信封。本文没有执行它。这个写作环境没有 API 密钥,也没有去要。
import os
import requests

def call_api(model: str, params: dict) -> dict:
    response = requests.post(
        f"https://api.sandbase.ai/v1/api/{model}",
        headers={
            "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
            "Content-Type": "application/json",
        },
        json=params,
        timeout=90,
    )
    response.raise_for_status()
    body = response.json()
    outputs = body.get("outputs") or []
    if body.get("status") != "completed" or not outputs or outputs[0].get("data") is None:
        raise RuntimeError(
            f"SandBase call did not complete: {body.get('status')} {body.get('error')}"
        )
    return outputs[0]["data"]
路径 1:Skill 或 MCP
把 Skill 那句贴进 Claude Code、Cursor 或 Codex,完成浏览器登录,新开一轮会话让工具加载。然后只要一个有界的周期:
Discover a Xiaohongshu PGY blogger list tool and a Xiaohongshu search notes tool.
Inspect each one. Read the price and whether it shares the daily free data allowance.
Do not run anything until I confirm.
Then run one blogger-list page for this brand_user_id, page_num 1, page_size 5.
Then run one search-notes call for this keyword, page 1, with empty search_id and search_session_id.
Summarize creators and note cards. Do not invent fields that were not in the output.
sandbase_discover 和 sandbase_inspect 免费,sandbase_run 才花钱。本文点名的接口也先 inspect。客户端配置在 Skill 指南,这篇不重复。
路径 2:REST
下面的 id 在 2026-11-08 是活的。价格是当天参考页上的。「有免费句」指页面出现 “First 100 calls per day free (shared per organization)”,且 FAQ 把该接口算进共享池。「无免费句」指 FAQ 写从余额扣费,免费额度条不在。这是页面,不是 inspect 的返回。
| 环 | 接口 | 与参考页一致的请求体 | 标价 | 免费句 |
|---|---|---|---|---|
| A | xiaohongshu/pgy/blogger-list | 必填 brand_user_id。可选 page_num(从 1)、page_size(1–100)、keyword、blogger、fans 等 | $0.02 | 无 |
| A | xiaohongshu/pgy/blogger-detail | 必填 user_id | $0.02 | 无 |
| A | xiaohongshu/pgy/blogger-fans-history | 必填 user_id。可选 date_type(整数 1–12;标注原文是 ~1=7d、2=30d、3=90d) | $0.02 | 无 |
| A 抽样 | xiaohongshu/app-v2/user-posted-notes | 0 个必填、3 个可选:user_id、share_text、cursor。传 user_id。第一页 cursor 留空 | $0.01 | 有 |
| B 可选 | xiaohongshu/web-v3/search-suggest | 0 个必填。可选 keyword | $0.01 | 有 |
| B | xiaohongshu/app-v2/search-notes | 必填 keyword。第 1 页的 search_id 和 search_session_id 留空。之后两页把两个 id 都传回 | $0.01 | 有 |
| B 可选 | image-note-detail 与 video-note-detail | 0 个必填。note_id 或 share_text | $0.01 | 有 |
| B 可选 | xiaohongshu/app-v2/note-comments | 0 个必填。note_id 或 share_text。第一页 cursor 留空。折叠默认是 UNFOLDED | $0.01 | 有 |
xiaohongshu/pgy-v2/blogger-v2 是另一条达人搜索:当天 0.071429 美元,52 个可选字段,FAQ 同样是从余额扣,没有免费句。它不是 pgy/blogger-list 的便宜别名。
目录说明在 小红书公开数据 API。微博和小红书一起上线的那篇是 微博 + 小红书数据接口。
下面这一轮没有执行。page_size: 5 是小样本,不是上限。原始 data 存下来。美妆标签用的是 Playground 芯片的形状,放在代码里,是因为参数表仍把 blogger 标成字符串。发出去之前先确认。
# Not executed on this page. Inspect price and free_quota before a real shortlist.
listed = call_api(
    "xiaohongshu/pgy/blogger-list",
    {
        "brand_user_id": brand_user_id,
        "page_num": 1,
        "page_size": 5,
        "blogger": {"content_tag": ["美妆"]},
    },
)
notes = call_api(
    "xiaohongshu/app-v2/search-notes",
    {"keyword": keyword, "page": 1, "search_id": "", "search_session_id": ""},
)
后续页要把 search_id 和 search_session_id 一起带回。一个关键词的 id 不能拿到另一个词上用。data 里的业务字段用 .get() 读,缺的计数保持未知。模型走同一把密钥,基址 https://api.sandbase.ai/v1。简报要引用返回里的 id。写得很顺却没有 id,这一轮算失败。
路径 3:代码沙箱,或你已经在跑的闹钟
要在对话外去重或追加 CSV,用同一把密钥开代码沙箱。定价页 写着当时免费。沙箱页 是每次运行一个兼容 E2B 的工作区。SDK 怎么接,在 一把 Key 的技术栈 和 E2B 替代。沙箱不代替小红书调用。
定价 FAQ 写着可以测试、发布成 API,或排期。打开的 Agents 页 是托管 Session。排期没用过之前,继续用 cron 或 GitHub Actions。和 OpenAI 沙箱的差别见 OpenAI Agents API 路径。
费用草算
算术来自公开页面。100 次免费调用由组织里符合条件的数据接口共享,不给小红书单留。
一页名单是 0.02 美元,没有免费句。五次详情加五次粉丝走势再是 0.20 美元,措辞相同。五次 user-posted-notes 各 0.01 美元,页面有免费句,所以在资格不变时占用 100 次里的 5 次。一次联想加四次 search-notes 再占 5 次,单价 0.01 美元。草算是三条蒲公英路由从第一次调用起共 0.22 美元,外加 10 次有免费句的 app-v2 或 web-v3 调用。
超出额度之后,搜索笔记按页面标价 0.01 美元一次。一个关键词每 15 分钟轮询一次,在短名单开始前就是 96 次。七月那张约 610 次、三条蒲公英路由从第一次就计费的 200 人表,留在 筛选教程。开跑前用今天的卡片重算。
模型简报每轮一次短补全,价格看模型卡。这里不报 token 总数。失败不收费。用 inspect 再看 free_quota 仍是 0 美元。
SandBase、厂商 MCP,和小红书自己的后台
数字取自各页 2026-11-08 的原文。
| 环归谁 | 模型和数据是不是一把密钥 | 页面上写了什么 | |
|---|---|---|---|
| SandBase | 归你。短名单、监听和时钟自己写 | 是。数据、简报、可选代码沙箱共用一个余额 | 上面的小红书 hub,当天 67 of 67 |
| DataXAPI 蒲公英 和 笔记搜索 | Agent 仍要自己写 | 他们的密钥 | 10 个蒲公英接口,每次 0.0400 美元。笔记搜索 0.0200 美元,最多 20 条。小红书索引页写 26 个接口。失败不收费。MCP 返回是他们裁过的形状 |
| Just One API 和 Wellbyte 蒲公英搜索 | Agent 仍要自己写 | 他们的密钥 | Just One 目录写这些接口只读取、不发布笔记。这次抓取没有拿到美元单价。Wellbyte 的创作者搜索页写成功 30 credits,失败 0 |
| Qovia 笔记搜索 | Agent 仍要自己写 | 他们的密钥 | 参考页是活的。可见价格行是 “$5 per 1k”。本文不把它折成单次美元 |
| 小红书广告文档中心 | 已授权的品牌流程 | 他们的开发者应用 | HTTP 200,这次抓取没有正文。工作是品牌自己的授权后台时用它 |
DataXAPI 的中文说明 写免费试用最多 333 次。AgentKey 的 RedNote 页 返回的是文档壳,这里不打分。
简报和读取共用一把密钥,而且接受轮询,用 SandBase。其余怎么选,看下面的 FAQ。
边界
公开数据,尽力而为。参考页保证信封。蒲公英行是某个 brand_user_id 下的公开匹配,和登录后的蒲公英后台不是同一视图。七月那篇在非达人品牌账号上看到 interMidNum 为 0。候选人用 kols[]。
第一次没有快照,笔记都会像新的。先存快照,第二次再发简报。再成功一次就再计一次费。守平台条款。不要存 Cookie,也不要跑登录态设备。model_type 没说是笔记之前,广告卡片就还是卡片。67 of 67 是 2026-11-08 的页头,会变。
FAQ
不用营销平台 OAuth,怎么用小红书 KOL 数据接口?
做公开达人研究,用厂商密钥读蒲公英列表。品牌或代理商授权属于小红书自己的后台。在 SandBase 上:brand_user_id 进 xiaohongshu/pgy/blogger-list,再拉详情、粉丝走势和一页 app-v2/user-posted-notes,然后让模型打分。discover 和 inspect 免费。完整 CSV 在七月教程。2026-11-08 那三个蒲公英页面是 0.02 美元,且没有免费额度那句话。放量前用 inspect 确认。
品牌或品类的小红书笔记搜索 Agent 怎么搭?
加一个不依赖固定达人名单的环。可选 xiaohongshu/web-v3/search-suggest,再调 xiaohongshu/app-v2/search-notes:keyword、第 1 页、search_id 和 search_session_id 留空。之后的页把两个 id 传回。丢掉非笔记卡片。只对留下的卡片开详情和评论样本。深度脚本在笔记调研文。2026-11-08 搜索笔记是 0.01 美元,页面把它算进组织每天共享的 100 次免费数据调用。
什么时候用 SandBase,什么时候用 DataXAPI、Just One 或小红书官方接口?
环留在自己仓库、模型共用一把密钥、而且接受轮询,用 SandBase。接口面已经统一在 DataXAPI、Just One、Wellbyte 或 Qovia,就继续。授权品牌账号用小红书自己的后台。闹钟交给别人,用现成监听。
接下来
打开 小红书 hub,inspect 一个接口。价格和额度仍符合预期时,再跑一页名单或一次关键词搜索。接入方式见 社交数据接口指南,抖音上的同一形状见 竞品监控,长打分脚本见 七月 KOL 筛选,长搜索脚本见 笔记调研,目录见 小红书 hub 文章,安装见 Skill 指南,同一把密钥和代码沙箱见 一把 Key 的技术栈。