小红书公开数据 API | SandBase
用一个 REST API 搜索小红书公开的笔记、商品、用户和图片。无需小红书登录,无需 SDK,一把 SandBase key,为 agent 而建。
小红书是中国的生活方式和购物发现引擎——商品测评、美妆和旅行笔记、创作者种草,还有一个左右着千万人消费决策的搜索框。这直接对应到消费者调研、商品监测和达人发现。但想用程序拿到这些数据,通常得逆向 app、管理 token,还要在 app 每次改版时重建爬虫。
SandBase 的小红书公开数据 API 把这层搭建成本去掉了。它通过普通 REST 端点搜索小红书公开的笔记、商品、用户和图片——一把 SandBase API key,不用小红书登录,也不用 SDK。下面的字段名和 JSON 结构都是用来说明大致形态的示例;具体参数和响应字段请以每个端点的在线 API 参考和一份真实响应为准。
这不是小红书的官方开放平台。 如果你需要已认证的成员操作或一份授权的数据协议,请用小红书官方渠道;当你的流程需要的是公开、只读的数据(调研、监测)时,用 SandBase。想直接试?领取 SandBase API key,再浏览小红书端点。
先说结论
- 一个 API 搜索小红书公开的笔记、商品、用户和图片,并读取商品详情。
- 本文的 Model API 端点用
POST /v1/api/xiaohongshu/<path>调用——只传该端点的参数,不用 SDK,一把SANDBASE_API_KEY。search-notes与search-products/search-users接一个keyword;product-detail、product-reviews、product-recommendations接一个sku_id。分页是每个端点各自的请求参数——多数搜索端点用page(从 1 开始),具体查各端点的参考。- 它只返回公开、只读数据。不能发帖、你这边不用登录、也拿不到私密数据;鉴权用 SandBase API key。
你到底需要哪个小红书 API?
| 你的需求 | 选择 | 原因 |
|---|---|---|
| 发帖、以成员身份操作,或用账号授权数据 | 小红书官方渠道 | 成员和账号操作走小红书官方。 |
| 搜索公开的笔记、商品、用户或读商品详情 | SandBase 小红书公开数据 API | 普通 REST、一把 SandBase key、面向只读流程的结构化 JSON。 |
| 私密或仅账号可见的数据 | 都不适用于公开流程 | 这类数据不在本篇公开数据的范围内。 |
从小红书 API 能拿到什么
整个目录建立在一个 app-v2 面上。按用途归类:
- 搜索 —— 按
keyword搜笔记、商品、用户、图片和群组。 - 商品 —— 按
sku_id读商品详情、评价和推荐。 - 笔记与话题 —— 笔记评论和话题 feed。
- 创作者 —— 创作者灵感和热门灵感 feed。
动手前请查每个端点的在线 API 参考确认参数;可用性因端点而异。
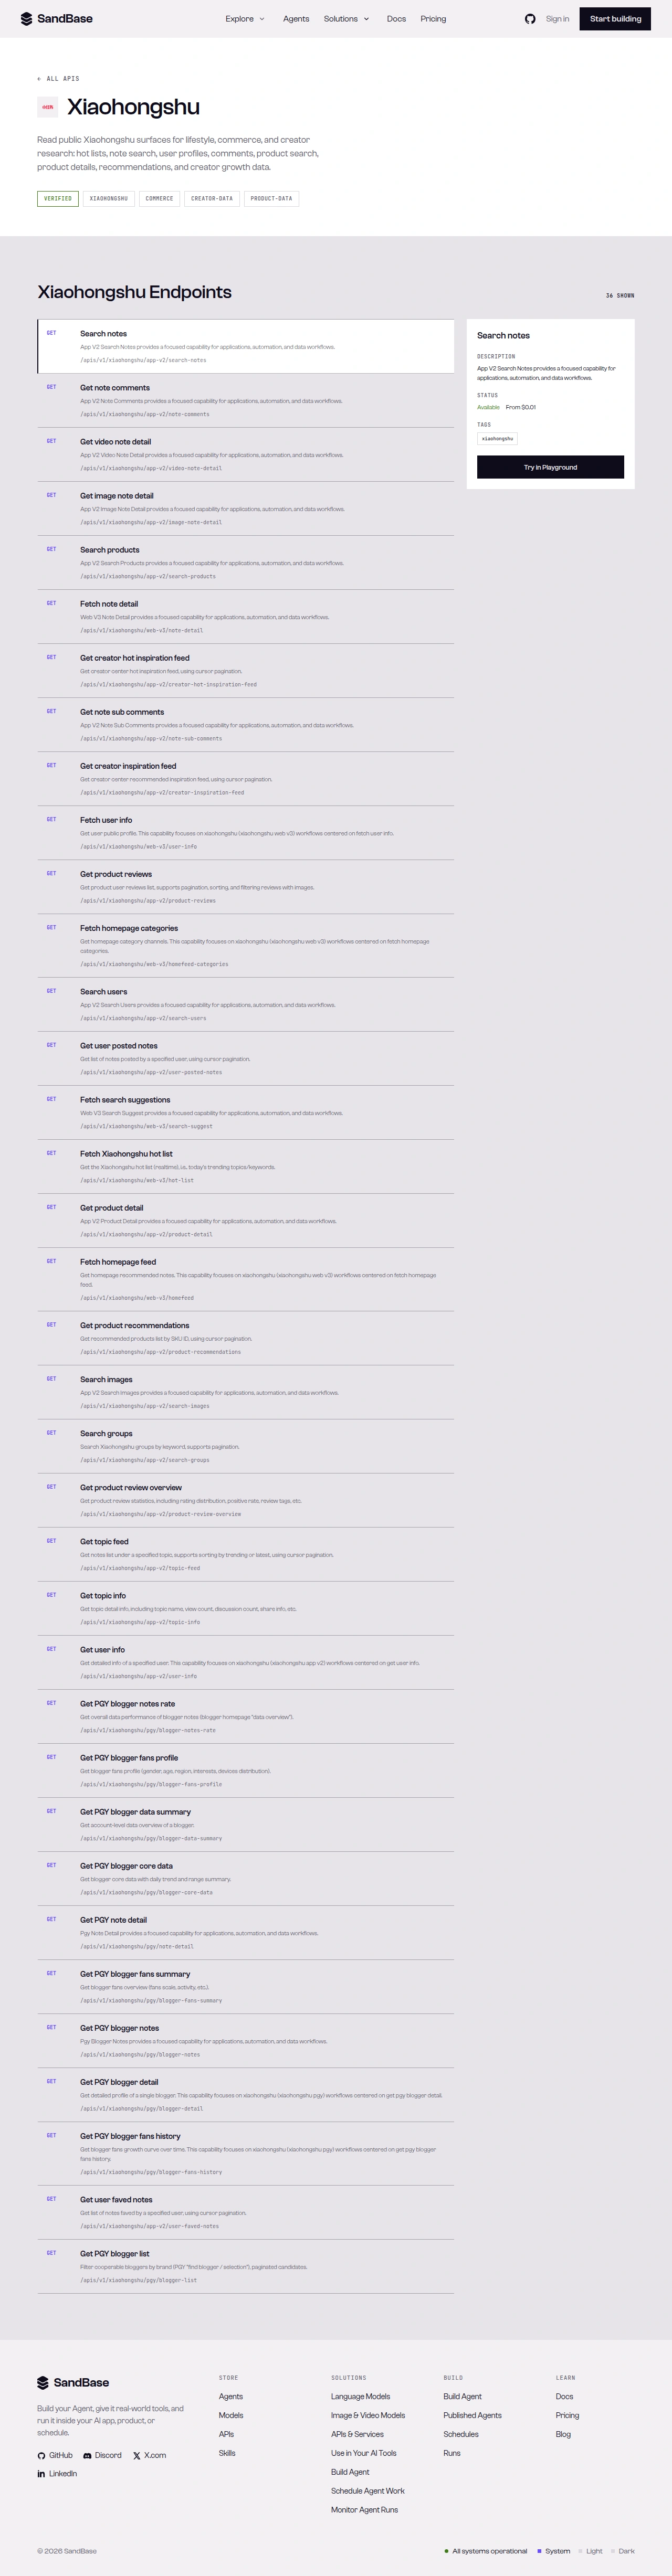 SandBase 上的小红书 API 页面——带标签的概览,加上端点列表,每个端点标有路径。
小红书提供的 vs. SandBase 补上的
公开数据来自小红书。SandBase 并不拥有或运营小红书,它只是为符合条件的公开数据流程提供一个统一的 API 层。每一项能力变成一个稳定端点,鉴权收敛成一把 key,响应都是可预期的 JSON——于是 agent 可以沿着同一套约定串起”搜一个关键词 → 打开一个商品 → 拉它的评价”,而不用再维护一个爬虫。
快速上手:第一次调用
SandBase 有不止一个 API 面。目录里可能会展示 /apis/v1/... 下的 GET 路径;本文用的是每个端点 API 参考里带厂商前缀的 Model API 路径。不要替换 HTTP 方法或 URL——按你所选端点的参考文档来。
按关键词搜索公开笔记:
import os
import requests

resp = requests.post(
    "https://api.sandbase.ai/v1/api/xiaohongshu/app-v2/search-notes",
    headers={
        "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={"keyword": "护肤"},
)
resp.raise_for_status()
body = resp.json()
if body.get("status") != "completed":
    error = body.get("error", {})
    raise RuntimeError(error.get("message", "Xiaohongshu request did not complete"))

payload = body["outputs"][0]["data"]
# 字段路径仅为示例——请以一份真实响应为准核对具体键名。
inner = payload.get("data") or {}
items = inner.get("items", [])
print(len(items), "notes on this page")
# 翻页时,在下一次调用里传该端点自己的分页请求参数
# (search-notes:page 从 1 开始,外加 search_id / search_session_id)。
curl -X POST https://api.sandbase.ai/v1/api/xiaohongshu/app-v2/search-notes \
-H "Authorization: Bearer $SANDBASE_API_KEY" \
-H "Content-Type: application/json" \
-d '{"keyword": "护肤", "page": 1}'每个响应都用同一个 SandBase 信封:一个 id、一个 status、model 名称,以及一个 outputs 数组,其中唯一一项在 data 下携带载荷。只有这个信封是保证的;data 里嵌套的业务字段由上游那一面决定,所以以端点参考和一份真实响应为准。读 outputs[0].data 之前先判 status,并查每个端点的参考了解它的运行模式。下面只是一个示例响应结构——里面嵌套的字段名和数值都是示例,并非保证的 schema,请以一份真实响应为准核对(载荷会变、数值也会随时间变):
{
  "id": "9ca6d841-5dbd-42f8-9fea-a02bfe56b07e",
  "status": "completed",
  "model": "xiaohongshu/app-v2/search-notes",
  "outputs": [
    {
      "data": {
        "…": "示例响应结构——请以一份真实响应为准核对其中嵌套字段"
      }
    }
  ]
}
failed 或 timeout 的请求会带上 error 而没有 outputs。不同端点的响应结构不一样——先看一份真实响应,再按端点逐一对准字段路径。
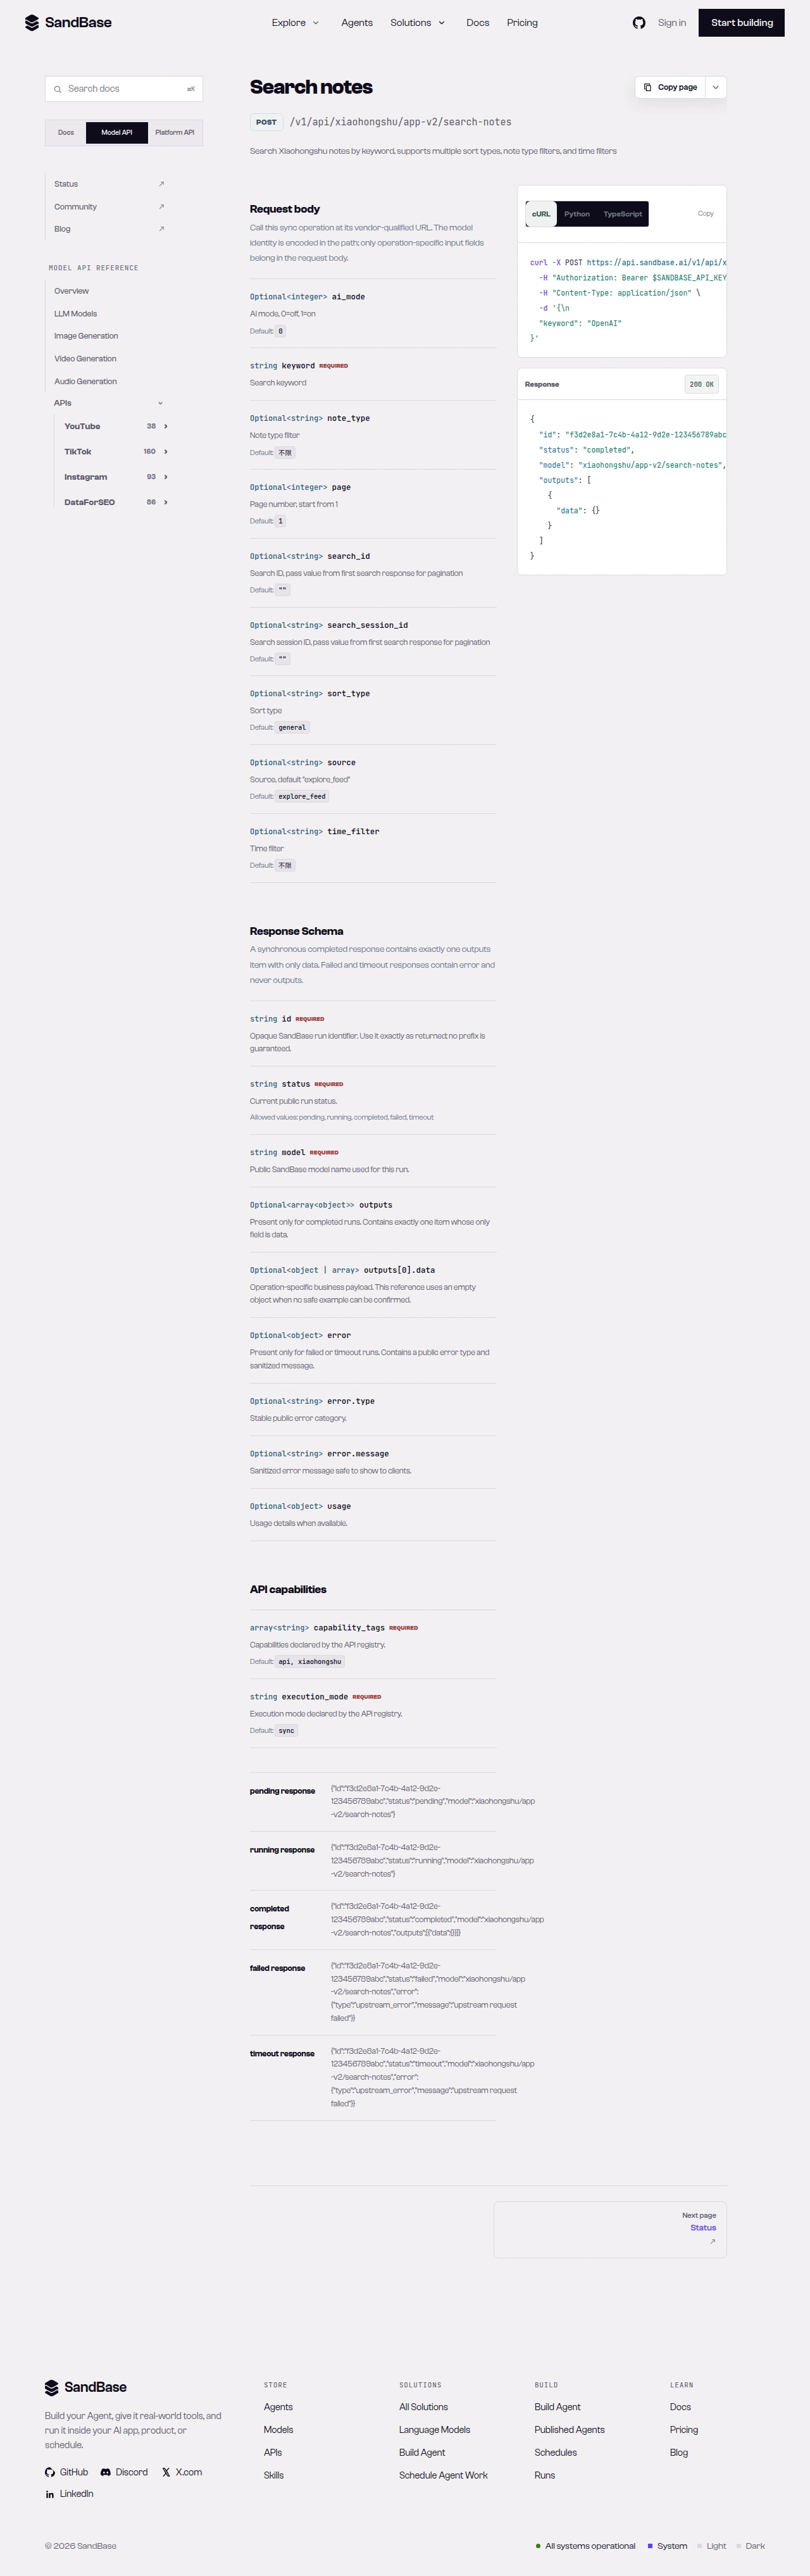 端点的 API 参考是每个参数名和响应路径的权威来源。
能力地图
| 能力簇 | 代表端点 | 典型用途 |
|---|---|---|
| 笔记搜索 | xiaohongshu/app-v2/search-notes | 关键词内容发现 |
| 商品搜索 | xiaohongshu/app-v2/search-products | 购物与选品调研 |
| 用户搜索 | xiaohongshu/app-v2/search-users | 达人发现 |
| 商品详情 | xiaohongshu/app-v2/product-detail | 按 sku_id 读商品 |
| 商品评价 | xiaohongshu/app-v2/product-reviews | 评价与情感分析输入 |
分页是每个端点各自的请求参数,不是把返回值传回去:search-notes 用 page(从 1 开始)外加 search_id 和 search_session_id;search-products 和 search-users 用 page(从 1 开始)外加 search_id;product-reviews 用 page(从 0 开始);product-recommendations 用 cursor_score。具体分页参数看每个端点的 schema。
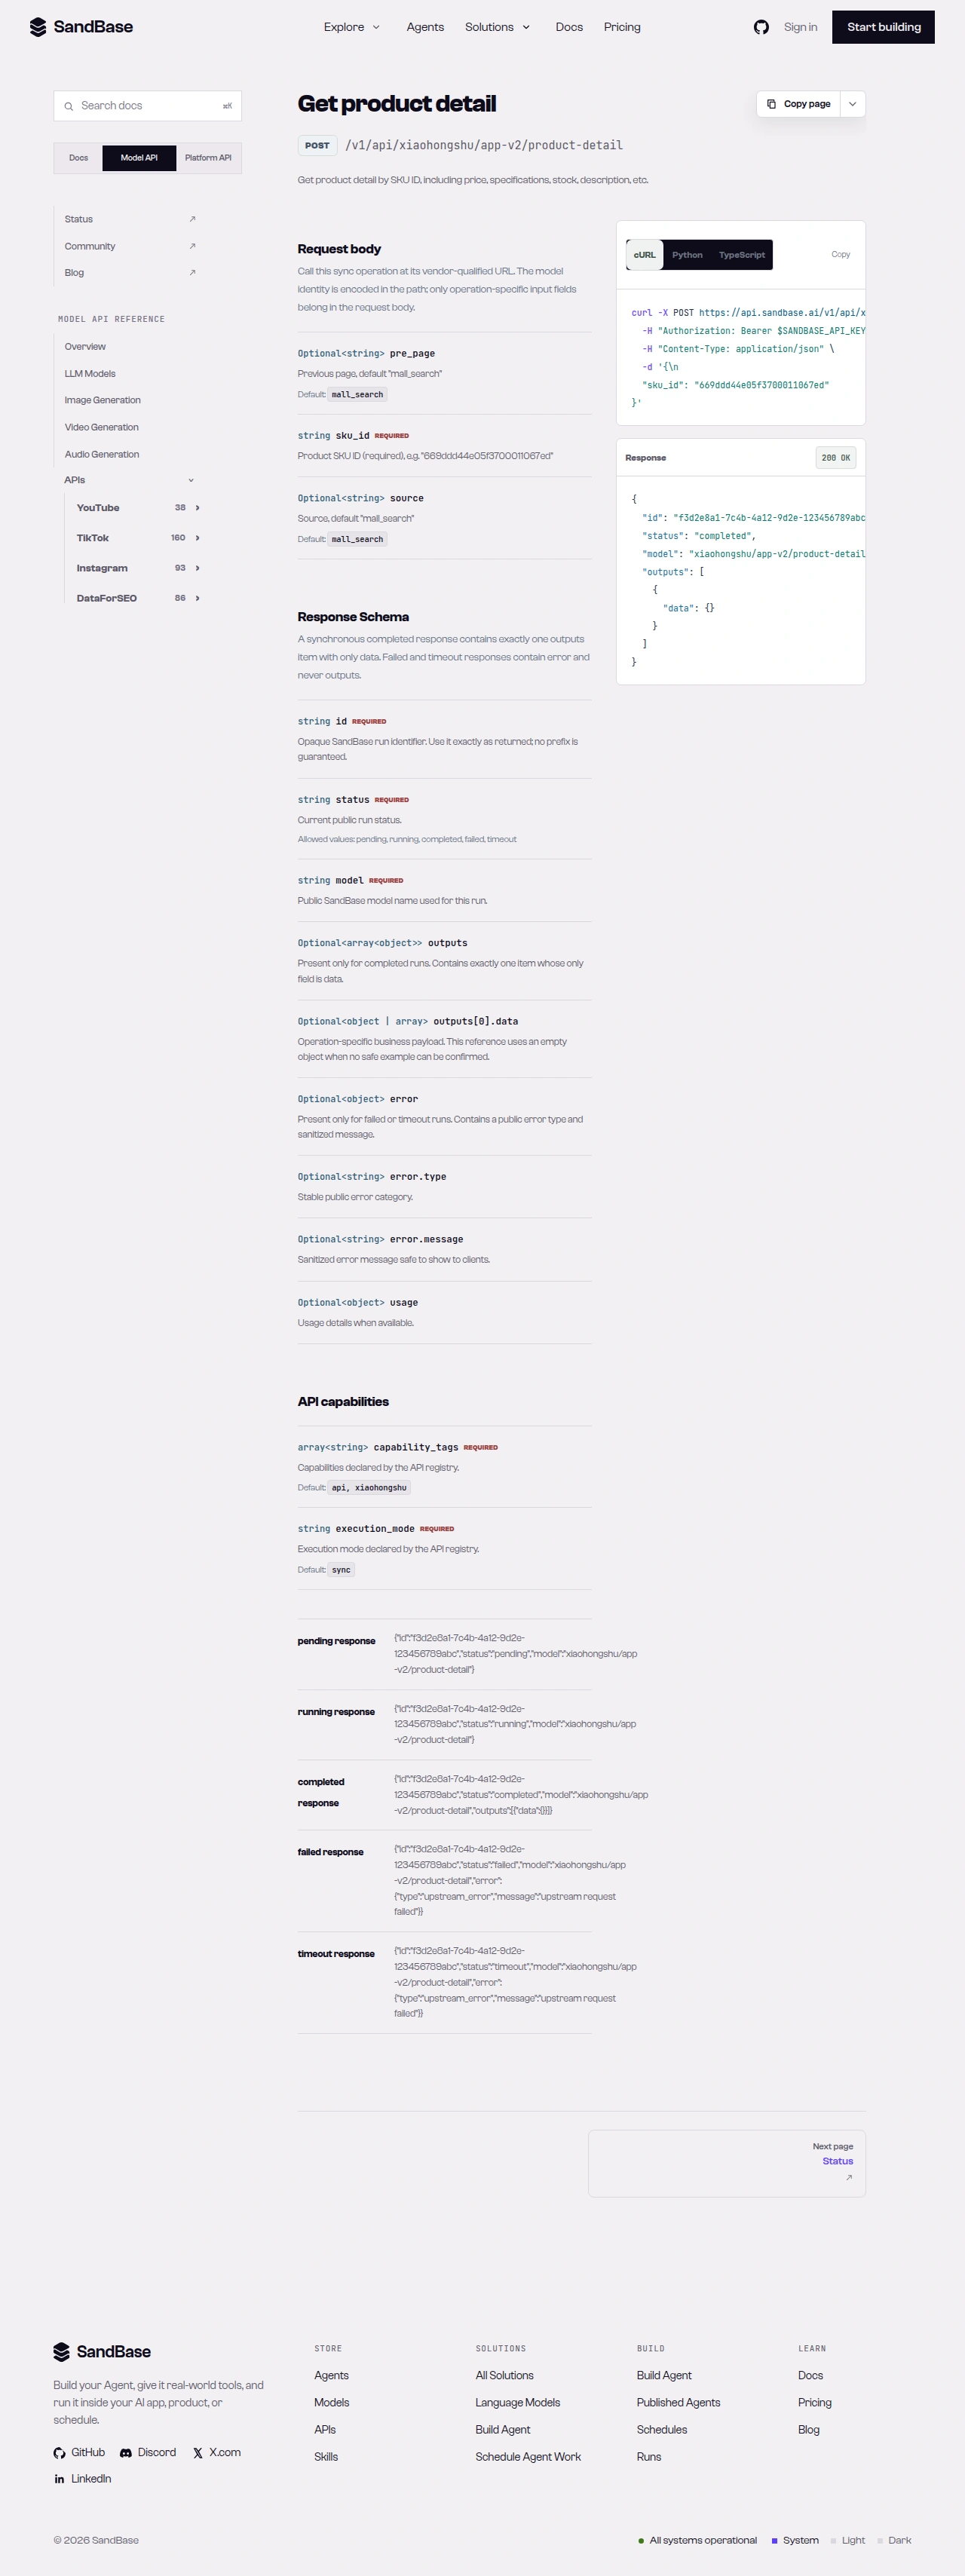 小红书端点列表的一部分,在 app-v2 面上。
在 agent 工作流里串联调用
因为每个端点共用同一套鉴权和同一个响应信封,agent 可以从一个关键词走到一个商品的评价,而不用为每个页面单独写特例。一个常见的消费者调研模式是这样:
- 搜关键词。 用
keyword调xiaohongshu/app-v2/search-notes或search-products,再通过递增该端点的page请求参数翻页(search-notes 从 1 开始)。 - 打开商品。 用
sku_id调xiaohongshu/app-v2/product-detail拿它的结构化详情。 - 读评价。 用同一个
sku_id调xiaohongshu/app-v2/product-reviews拿评价和情感输入。
每一步都返回同样的 { id, status, model, outputs } 结构,所以你的 agent 只需判一次 status,读 JSON 的那段代码在每一步都能复用。
常见用例
用小红书笔记搜索 API 做内容发现
用一个关键词调 xiaohongshu/app-v2/search-notes,围绕某话题摸清笔记,再通过递增 page 请求参数翻页(从 1 开始)。输入:关键词。输出:匹配笔记。端点:search-notes。
用小红书商品 API 做购物调研
用 xiaohongshu/app-v2/search-products 搜索,再用 product-detail 按 sku_id 读一个商品。输入:先关键词,再 sku_id。输出:商品结果和详情。端点:search-products、product-detail。完整工作流看如何做小红书选品调研。
用小红书用户搜索 API 做达人发现
用一个关键词调 xiaohongshu/app-v2/search-users,围绕某垂类找创作者。输入:关键词。输出:匹配用户。端点:search-users。
为什么在 API 层做这件事
你当然可以让无头浏览器去抓小红书、解析 app 的载荷,但那条路很脆:app 会变,token 会轮换,你维护的是一个爬虫而不是在做功能。通过一个统一 API 读取,意味着你的代码依赖命名的 JSON 字段和一个统一的响应信封,而不是 app 内部结构。鉴权是一把 key;而且因为每个端点都返回同样的 { id, status, model, outputs } 结构,重试、日志和错误处理都集中在一个你写一次、到处复用的帮助函数里。
这种一致性正是让工作流对 agent 可组合的原因。把一个关键词换成另一个、把一个 sku_id 换成另一个,代码路径完全一样。再加第四次读取——比如某个商品的推荐——它就接在同一个判状态的帮助函数后面。实际的回报是:你把时间花在数据对你的调研意味着什么上,而不是花在跟一个不断变化的目标较劲、维持爬虫存活上。当你需要的不止单次读取时,查线上列表找到合适的端点,接入前先确认它的参数。
边界与限制
- 只读、公开数据。 不能发帖、关注,也拿不到私密/仅账号可见的数据。
- 速率与量级。 把响应当作尽力而为的读取;作为客户端韧性措施,遇到 HTTP 429 这类瞬时错误时用退避重试。
- 参数与结构随上游而定。
search-products接keyword;product-detail、product-reviews、product-recommendations接sku_id。只有 SandBase 信封是保证的——里面嵌套的业务字段是示例,并非保证的 schema。分页是每个端点各自的请求参数(page、search_id、cursor_score等),不是把返回值传回去。先看真实响应、读 schema。 - 对照在线参考确认端点。 可用性和字段可能变化;在依赖某个具体端点之前先确认。
- 这不是小红书官方合作。 SandBase 只是提供对公开数据的统一访问;请遵守小红书的条款以及你使用场景下适用的规则。
常见问题
我需要小红书开发者应用或登录吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权。这些读取端点不需要小红书账号或你这边的 OAuth。
用什么来标识搜索或商品?
search-notes、search-products、search-users 接 keyword;product-detail、product-reviews、product-recommendations 接 sku_id。
分页怎么做?
分页是每个端点各自的请求参数,不是把返回值再传回去。多数搜索端点用 page(从 1 开始;product-reviews 从 0 开始),部分还要带 search_id/search_session_id,product-recommendations 用 cursor_score。具体看每个端点的 schema。
能读私密或仅账号可见的数据吗? 不能。这个 API 只返回公开数据。私密和账号授权的内容都不在范围内。
从一次笔记搜索开始
创建一把 SandBase API key,用一个关键词调 search-notes,先看清返回的 schema,再扩展到商品、用户或评价。准备好之后: