B站视频评论与弹幕分析 API 教程 | SandBase
从一个 BV 号出发分析 B站观众反应:用四个 SandBase 端点读取视频数据、翻页热评、抽样楼中楼回复,并把弹幕按分钟分桶。无需 B站登录,只需一个 SandBase API Key。
一家科技媒体发了条两分钟的发布会速览,第二天早上,视频下面已经有 2,199 条评论,播放器上飘过 1,404 条弹幕。评论区在吵价格,弹幕则是在对着某一秒的画面吐槽。想知道观众怎么看一场发布会、一支预告片或者竞品的广告,B站其实给了你两路信号,而且两路都得变成数据才好分析。
这篇教程从一个 BV 号出发,用四个 SandBase 端点完成整条链路:读视频数据,翻页拉热评,展开回复最多的几条楼中楼,再把弹幕按播放分钟分桶。整体端点地图可以先看 B站公开数据 API 总览。
这里读的都是公开、只读数据。不需要 B站账号,不需要 Cookie,也不需要 SDK,只要一个 SandBase API Key 做鉴权。这四个端点目前在 SandBase 目录里标的是 Free。
参数和响应信封以端点 API 参考为准,参考只保证信封结构。下文出现的业务字段名都来自我自己跑的调用(测试于 2026-10-01,UTC),属于实测观察,不是文档保证。正式依赖之前,请用真实响应再核对一遍。
先说结论
- 一个 BV 号就够了。
bilibili/web/one-video返回标题、UP 主、stat(播放、点赞、投币、收藏、评论、弹幕),还有aid和弹幕要用的cid。bilibili/app/video-comments每页 20 条热评。翻页时把返回的cursor.next作为整数next_offset传回去。bilibili/web/comment-reply用bv_id加父评论的rpid读楼中楼,pn翻页。bilibili/web/video-danmaku用cid取弹幕,返回的是 XML 字符串,不是 JSON。弹幕多的视频只拿到一部分。
为什么要同时看评论和弹幕
评论是观众看完之后的整体态度,弹幕是看的过程中对具体某一秒的即时反应。只看评论,你知道大家在吵价格,却不知道视频哪一段最“炸”;只看弹幕,你有了时间线,但很难读出完整的观点。两者合起来,才是一份像样的观众反应报告。
B站的开放平台主要面向管理自己内容、走授权的创作者和合作方。要读别人公开视频下的反应,很多人最后只能自己写爬虫、维护 Cookie 和请求签名,而这些东西随时会变。做一次发布会复盘,这部分维护成本往往比分析本身还高。
SandBase 这条路范围更窄:用一个密钥读公开的视频数据、评论、回复和弹幕,不发评论、不点赞,也不碰任何需要账号的东西。B站创作者研究教程讲的是热搜、搜索和 UP 主画像;这篇只看一件事:观众对某一条视频说了什么。
| 你的需求 | 用什么 |
|---|---|
| 做研究或反应总结用的公开评论、回复、弹幕 | SandBase B站公开数据 API |
| 管理、回复或审核自己账号下的内容 | B站官方创作者工具和开放平台 |
| 私密、充电专属或仅账号可见的数据 | 两条路都不适用 |
流程一览
- 从链接(
bilibili.com/video/BV...)里取出 BV 号。 - 用
bilibili/web/one-video(bv_id)读视频:标题、UP 主、stat、aid、cid。 - 用
bilibili/app/video-comments(bv_id、mode,之后加next_offset)翻页拉热评。 - 用
bilibili/web/comment-reply(bv_id、rpid、pn)展开回复最多的楼。 - 用
bilibili/web/video-danmaku(cid)读弹幕,按播放分钟分桶。 - 把评论、回复和弹幕时间线交给模型做总结。
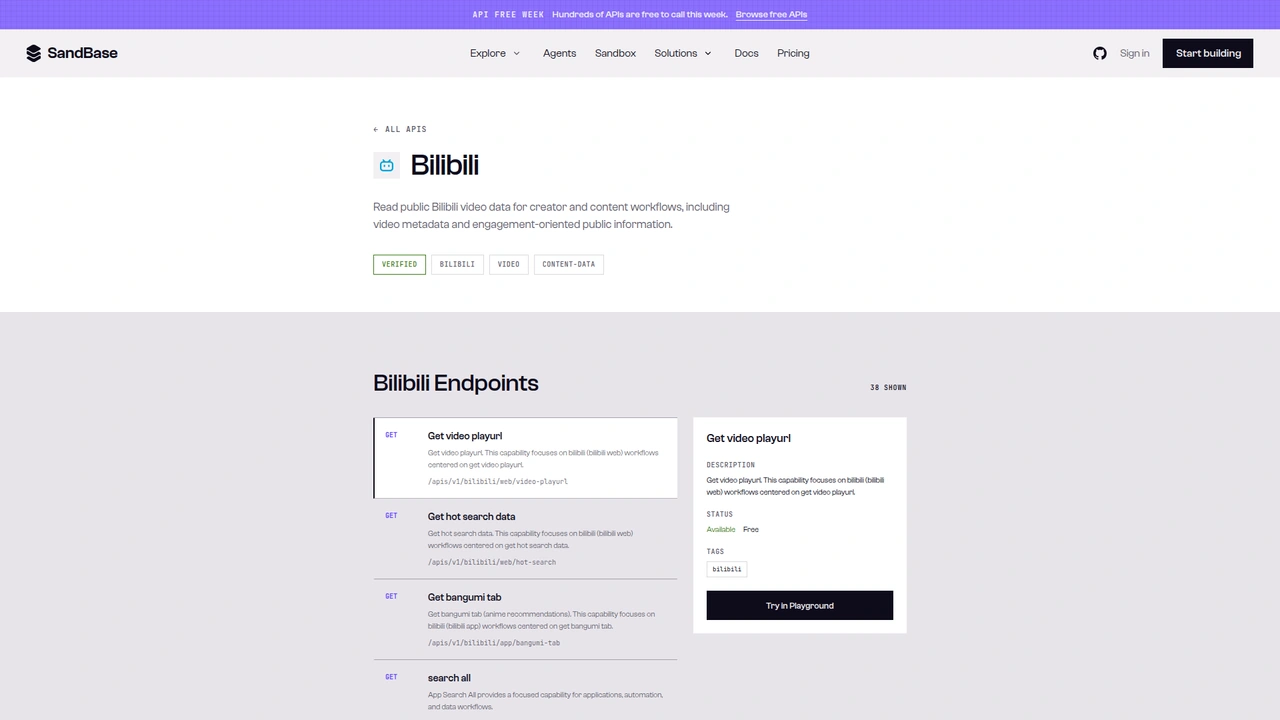 SandBase 上的 B站目录页:共显示 38 个端点,形式是
GET /apis/v1/bilibili/...;右侧选中的“Get video playurl”状态为 Available、Free。本教程调用的是 Model API 的 POST /v1/api/bilibili/... 路由。
写代码前先把接口面说清楚。目录页展示的是 GET /apis/v1/bilibili/<path>;本文用的是端点参考里的 Model API,也就是 POST /v1/api/bilibili/<path>,JSON 请求体里只放该端点自己的参数。参考页里 app/video-comments 的 cURL 示例在请求体里放了一个 model 字段,我实际调用时没带它也能正常返回,因为路径本身已经指明了端点。复制示例时请保留 POST 方法和 /v1/api/ 前缀,别和目录页的 GET 路径混用。
第 0 步:一个通用调用函数
import os
import re
import time
import xml.etree.ElementTree as ET
from collections import Counter

import requests

API = "https://api.sandbase.ai/v1/api"
HEADERS = {
    "Authorization": f"Bearer {os.environ['SANDBASE_API_KEY']}",
    "Content-Type": "application/json",
}

def call(path: str, payload: dict, retries: int = 2):
    for attempt in range(retries + 1):
        try:
            resp = requests.post(f"{API}/{path}", headers=HEADERS, json=payload, timeout=90)
        except requests.exceptions.ConnectionError:
            if attempt < retries:
                time.sleep(2 * (attempt + 1))  # TLS 连接被断开,重试
                continue
            raise
        if resp.status_code >= 500 and attempt < retries:
            time.sleep(2 * (attempt + 1))
            continue
        resp.raise_for_status()
        body = resp.json()
        if body.get("status") != "completed":
            raise RuntimeError(body.get("error", {}).get("message", f"{path} did not complete"))
        # 文档结构是 outputs[0].data;同时兼容顶层 `output`。
        output = body.get("output")
        if output is None and body.get("outputs"):
            output = body["outputs"][0].get("data")
        print(f"  {path}: run {body.get('id')}")
        return output
    return None

def bvid_from_url(url: str) -> str:
    m = re.search(r"(BV[0-9A-Za-z]{10})", url)
    if not m:
        raise ValueError(f"no BV id in {url}")
    return m.group(1)

def clean_text(message: str) -> str:
    # 回复开头是“回复 @某人 :”,去掉昵称,只留内容。
    return re.sub(r"^回复\s*@[^::]+[::]\s*", "", message or "").strip()
参考文档写的完成态结构是 outputs[0].data,这次测试里 B站的每次调用也都是这个结构。我在 SandBase 其他平台的端点上见过顶层 output,所以函数两种都读,有 output 时优先用它。和别的平台相比,这里有两点不一样:
- 函数返回的是
data里的原样内容,不一定是字典。 JSON 类端点返回的是 B站自己的外壳{code, data, message, ttl},有用的字段还要再往下取一层data;弹幕端点返回的则是一整段 XML 字符串。 - 重试同时覆盖连接错误和 5xx。 我对测试视频的第一次
one-video调用,还没拿到 HTTP 状态码就在 TLS 层断开了,同样的请求重试一次就成功了。
clean_text 是因为回复文本里会带上被回复者的昵称。做反应分析要的是观点,不是人名。
第 1 步:读视频数据
def read_video(bv_id: str) -> dict:
    v = (call("bilibili/web/one-video", {"bv_id": bv_id}) or {}).get("data") or {}
    stat = v.get("stat") or {}
    return {
        "bv_id": bv_id,
        "aid": v.get("aid"),
        "cid": v.get("cid"),  # 第一个分 P;多 P 视频在 `pages` 里
        "title": v.get("title"),
        "channel": (v.get("owner") or {}).get("name"),
        "published": v.get("pubdate"),  # Unix 秒
        "duration": v.get("duration"),
        "views": stat.get("view"),
        "likes": stat.get("like"),
        "coins": stat.get("coin"),
        "favorites": stat.get("favorite"),
        "shares": stat.get("share"),
        "comments": stat.get("reply"),
        "danmaku": stat.get("danmaku"),
    }
测试视频是科技媒体“科技美学”发布的公开速览视频《两分钟发布会 | 小米 18 Pro / Pro Max亮相…》(BV19uhb6mEWd,发布于 2026-09-23 UTC)。run id 11f78f98-533c-463e-8b1f-c8de5c165752 的 outputs[0].data 节选如下:
{
  "code": 0,
  "data": {
    "aid": 117321125400871,
    "bvid": "BV19uhb6mEWd",
    "cid": 42143190519,
    "title": "两分钟发布会 | 小米 18 Pro / Pro Max亮相 小米平板9 小米手环11 小米手表S5 还有咖啡机??",
    "owner": { "name": "科技美学" },
    "pubdate": 1790178608,
    "duration": 710,
    "pages": [{ "cid": 42143190519, "page": 1, "duration": 710 }],
    "stat": {
      "view": 247824, "like": 6310, "coin": 445, "favorite": 741,
      "share": 266, "reply": 2199, "danmaku": 1404
    }
  },
  "message": "OK"
}
计数都是普通整数,不用像 YouTube 那样解析“7.5K”之类的字符串。stat.reply 告诉你评论量有多大,stat.danmaku 让你对第 4 步心里有数。cid 是唯一没法从链接里直接拿到的 id。one-video 已经把它带回来了,省掉一次 bilibili/web/video-parts 调用;我单独调了一次 video-parts(run f3862a4d-034b-451e-b924-c452af230b24),对这个单 P 视频返回的是同一个 cid。多 P 视频的话,遍历 pages,每个分 P 分别读弹幕。
bilibili/web/bv-to-aid 这次也没用上:后面用到的评论端点直接接受 bv_id,而 one-video 本来就会返回 aid。另外,这条视频的 tname(分区名)是空的。
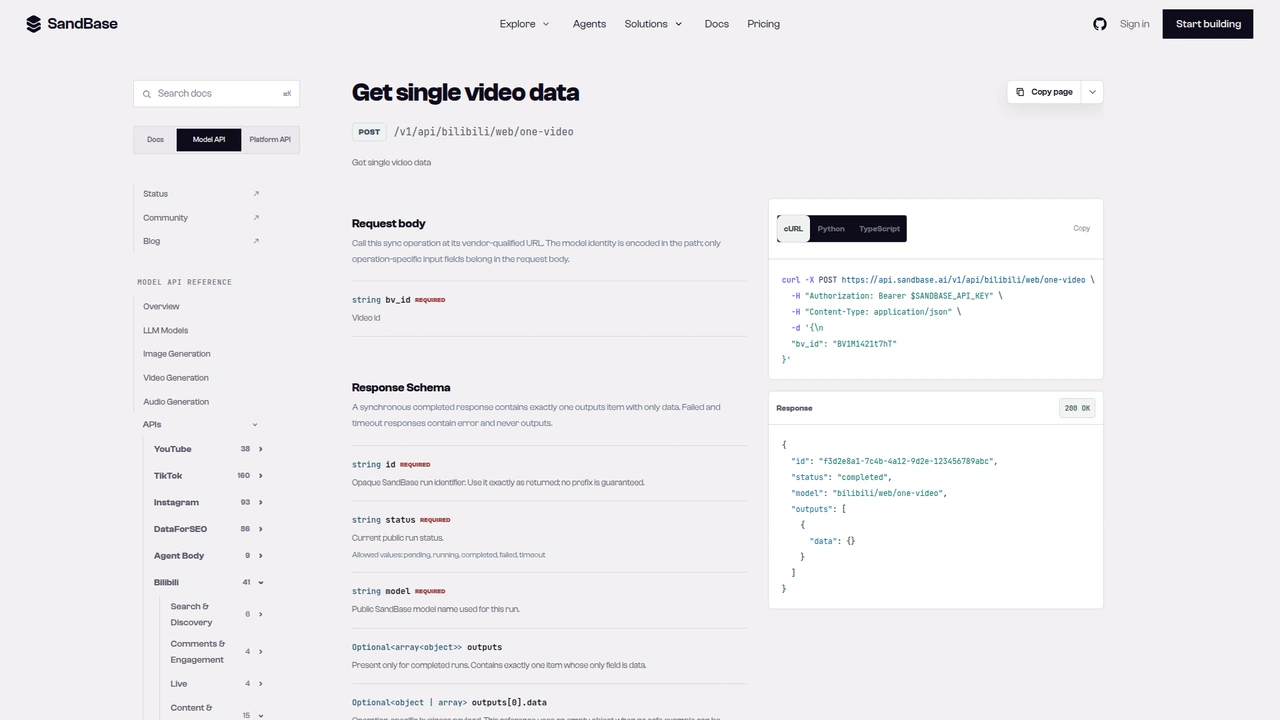
bilibili/web/one-video 参考页(Get single video data):POST /v1/api/bilibili/web/one-video,只有一个必填字符串参数 bv_id。文档的响应示例里 outputs[0].data 是空对象。
第 2 步:翻页拉热评
def top_comments(bv_id: str, max_pages: int = 3, mode: int = 3) -> list[dict]:
    payload = {"bv_id": bv_id, "mode": mode}  # 3 = 热度,2 = 时间
    out, seen = [], set()
    for _ in range(max_pages):
        data = (call("bilibili/app/video-comments", payload) or {}).get("data") or {}
        for r in data.get("replies") or []:
            if r.get("rpid") in seen:
                continue
            seen.add(r.get("rpid"))
            out.append({
                "rpid": str(r.get("rpid")),
                "text": clean_text((r.get("content") or {}).get("message", "")),
                "likes": r.get("like", 0),
                "replies": r.get("rcount", 0),
                "ctime": r.get("ctime"),
            })
        cursor = data.get("cursor") or {}
        if cursor.get("is_end") or not cursor.get("next"):
            break
        payload = {"bv_id": bv_id, "mode": mode, "next_offset": cursor["next"]}
    return out
我最开始用的是 bilibili/web/video-comments,参数是 bv_id 加页码 pn,后来因为它不稳定才换掉。第 1 页(run b1b5caeb-43f0-43de-b4e9-44f20245f03c)返回 20 条评论,page.count 为 2199;第 2 页(run fa847910-aa82-4166-b3b4-17cf5357f45d)一条都没有,page.count 变成 0。重试第 2 页(6f7e6258-f781-4ffb-b00b-a6b1bc168090)又正常了,第 3 页(139f2dca-660c-4fa9-9c25-d5caef347687)又是空的。空页和“已经翻到底”长得一模一样,用它翻页很难写对。
app 版端点稳定得多。第一页(run 98654147-fe5a-4a47-8a2a-b23282e23575)返回 20 条评论,外加一个 cursor 对象:
{
  "all_count": 2199,
  "is_begin": true,
  "is_end": false,
  "mode": 3,
  "name": "热门评论",
  "next": 2,
  "pagination_reply": { "next_offset": "CAEiAggC" },
  "support_mode": [2, 3]
}
这里有两个看起来都像游标的字段,只有一个符合参数定义。参考里 next_offset 是整数,把字符串 "CAEiAggC" 传过去,直接返回 HTTP 400:expected integer, but got string。改传 cursor.next 就对了:next_offset: 2(run 9706405a-a879-4769-a3b5-918945e400b0)返回 20 条新评论,rpid 和第一页没有重复,next 变成 3;next_offset: 3(run af057287-9ad9-44b6-b434-4bb7c0ae93b3)又是 20 条,next 为 4。函数遇到 is_end 就停,同时按 rpid 去重,因为文档没有保证页与页之间一定不重叠。
每条评论里观察到 rpid、like、rcount、ctime 和 content.message,另外还有一个 member 对象,装着评论者的昵称、头像和 mid。函数把身份相关字段全部丢掉,保留下来的一条长这样:
{ "rpid": "314848758273", "text": "哈哈,我花这钱来买安卓?哈哈哈哈哈", "likes": 92, "replies": 21 }回复数请用 rcount,别用 count。这条评论的 rcount 是 21,count 却是 47;第 3 步的回复接口报出的总数是 21,和 rcount 一致。count 多出来的 26 是什么,从接口本身看不出来。
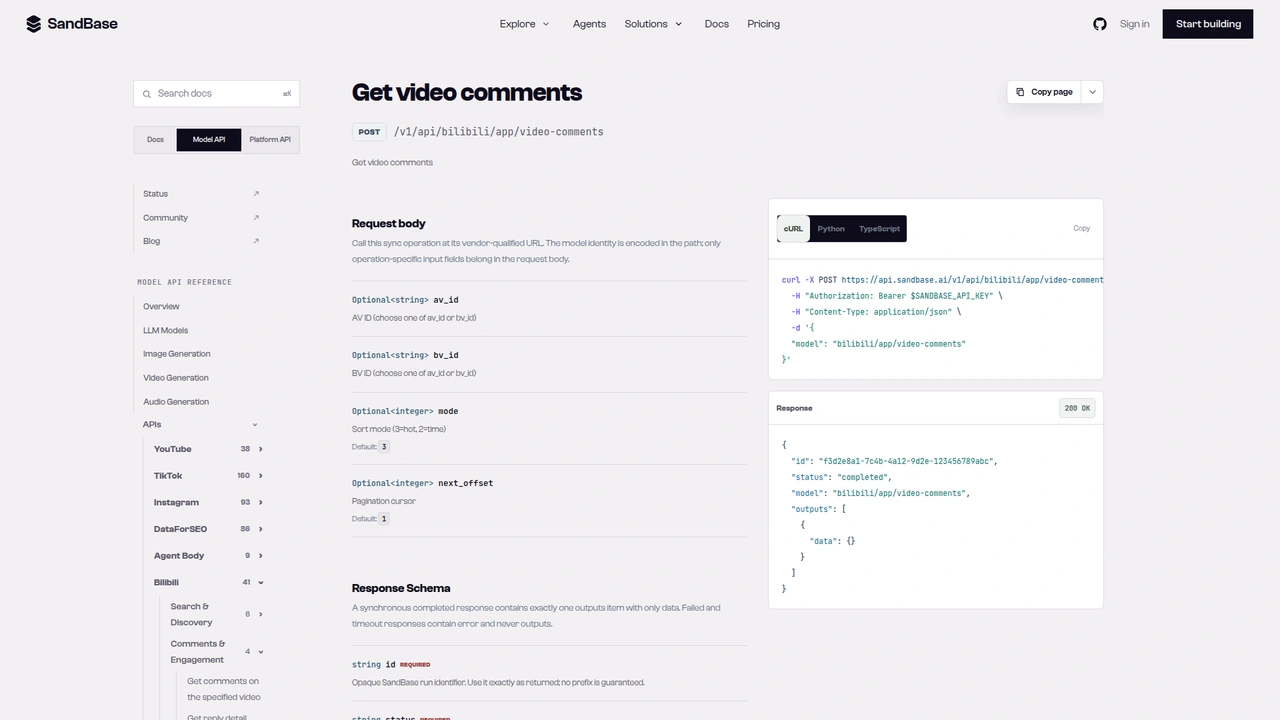
bilibili/app/video-comments 参考页:可选的 av_id 或 bv_id(二选一)、mode(3 为热度,2 为时间,默认 3),以及整数类型的分页游标 next_offset,默认值为 1。
第 3 步:展开回复最多的楼
def thread_replies(bv_id: str, rpid: str, max_pages: int = 2) -> list[dict]:
    out = []
    for pn in range(1, max_pages + 1):
        data = (call("bilibili/web/comment-reply", {"bv_id": bv_id, "rpid": rpid, "pn": pn}) or {}).get("data") or {}
        if not (data.get("page") or {}).get("count"):
            # 遇到过一次:某页返回 count 为 0、没有回复,重试后恢复正常。
            data = (call("bilibili/web/comment-reply", {"bv_id": bv_id, "rpid": rpid, "pn": pn}) or {}).get("data") or {}
        batch = data.get("replies") or []
        out += [{"text": clean_text((r.get("content") or {}).get("message", "")), "likes": r.get("like", 0)}
                for r in batch]
        page = data.get("page") or {}
        if not batch or pn * (page.get("size") or 20) >= (page.get("count") or 0):
            break
    return out
comment-reply 要传视频的 bv_id 和父评论的 rpid,pn 可选。上面那条 21 个回复的楼,第 1 页(run b3d5734d-0e61-4890-9cab-ab4e37b4800b)返回 20 条回复,page 为 {count: 21, num: 1, size: 20},另外有一个 root 对象装着父评论本身。第 2 页(run 54035a3e-044e-4bfa-8247-48a10125db05)却是空的,count 为 0,和 web 版评论接口的毛病一样;重试(1d3c6dc2-a2ba-4fd3-b883-bbd68c9b0c72)后 page.num 为 2、count 为 21,恢复正常。所以函数在 count 为 0 时会重试一次。循环在 pn * size 覆盖 count 时停下,不会去请求本来就不存在的页。
clean_text 在回复里最有用。这一页 20 条回复里有 15 条以 回复 @某某 : 开头,等于把另一个用户的昵称写进了你的数据。去掉这个前缀,回复内容照样读得通(比如“iPhone Air,12G+256G,国行,常年5000左右…”),昵称就不进库了。
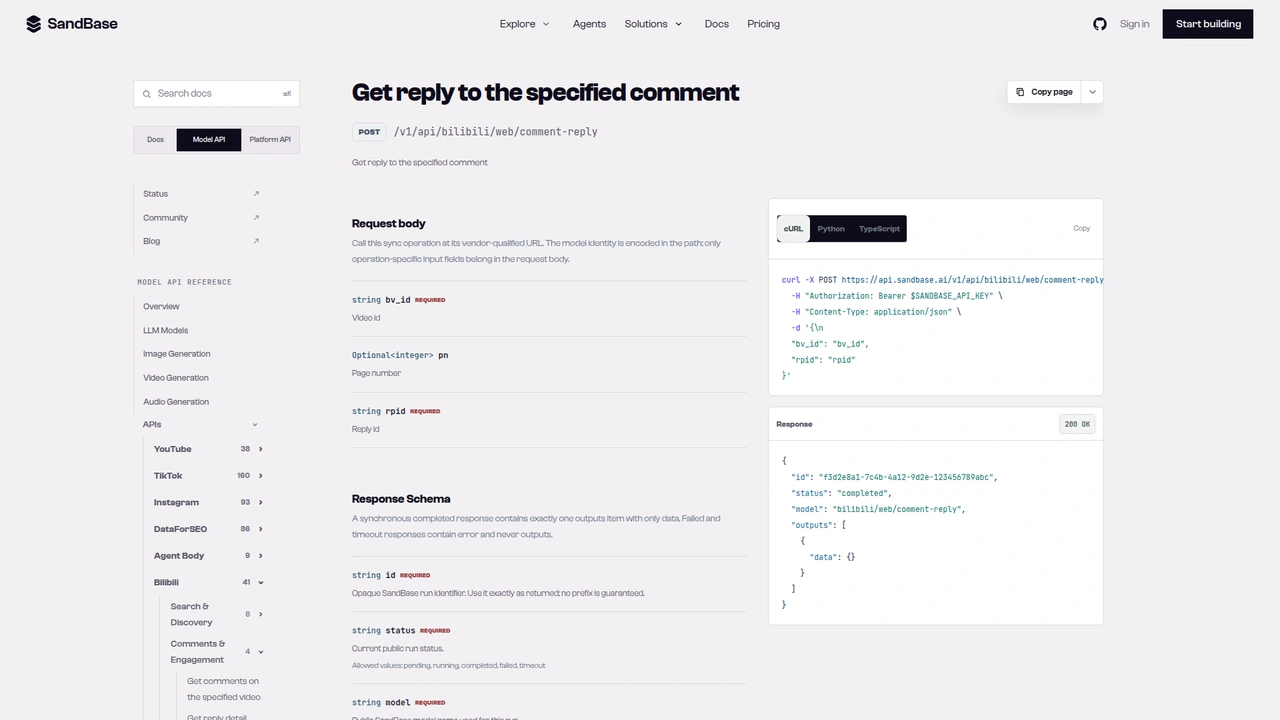
bilibili/web/comment-reply 参考页(Get reply to the specified comment):必填字符串 bv_id 和 rpid,可选整数页码 pn。
第 4 步:读弹幕,按分钟分桶
def danmaku(cid) -> list[dict]:
    xml_text = call("bilibili/web/video-danmaku", {"cid": str(cid)})
    if not isinstance(xml_text, str) or not xml_text.strip():
        return []
    root = ET.fromstring(xml_text.encode("utf-8"))
    rows = []
    for d in root.findall("d"):
        attrs = (d.get("p") or "").split(",")
        # 只保留播放时间(第一个字段)和文本,其余全部丢弃。
        rows.append({"t": float(attrs[0]) if attrs and attrs[0] else 0.0, "text": d.text or ""})
    return rows
这一步最出乎我意料。参考里 outputs[0].data 的类型写的是 object | array,而弹幕接口(run 3a0efcf1-8b87-43bd-a60f-b3393d4f8ce2)返回的是一段 123,221 个字符的 XML 字符串。节选:
<i>
  <chatid>42143190519</chatid>
  <maxlimit>1500</maxlimit>
  <d p="99.22400,1,25,16777215,…">懂了:pro性能不足 max烫手</d>
  <d p="390.45500,5,25,16765698,…">我为什么要在手机背屏上弹吉他?</d>
</i>
每个 <d> 元素是一条弹幕,p 属性是逗号分隔的一串值。这条视频里第一个值始终落在 0.7 到 707.9 之间,正好在 710 秒的时长内,所以我把它当作播放时间(秒)来用。后面的字段里有一个看起来像发送者哈希的值。函数只保留时间和文本,其余全部丢掉。
拿到之后先数一下条数。这条视频的 XML 里正好有 1,404 个 <d>,和 stat.danmaku 一致。换一条更早、弹幕更多的视频(BV1M1421t7hT,stat.danmaku 为 3,281),同一个接口只返回了 1,200 条,maxlimit 是 1,000(run 196f4179-b89e-457b-ae43-88828b7bef66)。所以弹幕多的视频,拿到的只是样本,别把它的条数当成视频的弹幕总数来报。
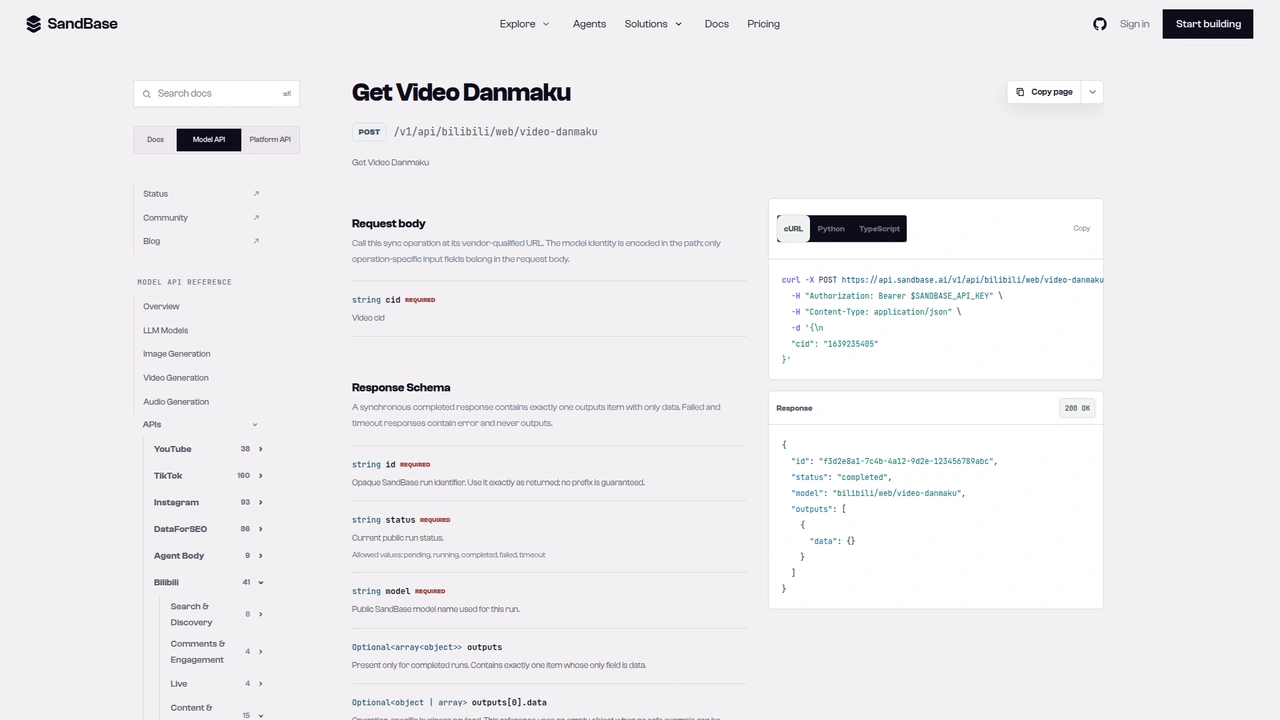
bilibili/web/video-danmaku 参考页(Get Video Danmaku):只有一个必填字符串 cid。示例响应里 outputs[0].data 是空对象,而我实际调用拿到的是 XML 字符串。
串起来:每条视频一份反应记录
def analyze(bv_id: str, comment_pages: int = 3, threads: int = 3) -> dict:
    video = read_video(bv_id)
    comments = top_comments(bv_id, comment_pages)
    busiest = sorted(comments, key=lambda c: c["replies"], reverse=True)[:threads]
    for c in busiest:
        c["reply_sample"] = thread_replies(bv_id, c["rpid"])
    dm = danmaku(video["cid"]) if video.get("cid") else []
    per_minute = Counter(int(d["t"] // 60) for d in dm)
    repeated = Counter(d["text"].strip() for d in dm if d["text"].strip()).most_common(10)
    return {
        "video": video,
        "comments": comments,
        "danmaku_count": len(dm),
        "danmaku_per_minute": dict(sorted(per_minute.items())),
        "danmaku_repeated": repeated,
        "danmaku_sample": [d["text"] for d in dm[:200]],
    }

report = analyze(bvid_from_url("https://www.bilibili.com/video/BV19uhb6mEWd/"))
我把这段代码完整跑了一遍,一共 11 次调用:one-video 一次(a8abc9c6-d802-410a-8e47-01192919cc77),热评三页(ca89f260-162e-429b-a9c4-2bb79ea01195、7bcadf99-7938-47d5-80fd-2a7505e0b9ca、647f6ca4-0535-46f2-a59b-ae913ef4373e),三条楼共六页回复(第一页是 d8fe09de-1123-4096-a067-33bab9194d8f),弹幕一次(e3c4c8af-d0b7-44ba-84b4-1c630fc8fc72)。
结果是:2,199 条评论里拉到 60 条热评;三条楼分别有 54、27、30 个回复,抽到 40、27、30 条;带问号的评论 9 条;1,404 条弹幕全部读到。
弹幕时间线明显前重后轻:第 1 分钟 210 条,第 2 分钟 184 条,第 10 分钟最少,只有 55 条,第 8 分钟又冒到 163 条。重复最多的弹幕是数字:“0” 出现 99 次,“2” 33 次,“1” 30 次。观众在回答什么,接口本身看不出来,但 “0” 集中在第 40 秒和第 460 秒附近,要看的话我会先跳到这两处。
下面是我读这 60 条评论的印象,不是统计出来的分布:价格是绝对的主线。点赞最多的一条(368 赞)认为厂商已经把国补算进了发布会定价,不少人拿价格和 iPhone 比,也有人质疑背屏和局部防窥到底有没有用。这类归纳交给模型做最合适:把 report 整个传进去,提示词可以写“把这些评论按主题分组,标注正面、负面或混合,列出不重复的问题,并指出哪几分钟的弹幕最密集”。点赞数要一起带上,模型才知道 368 赞的评论比 0 赞的分量重。
调用次数随页数增长:视频一次,每 20 条热评一次,每 20 条回复一次,每个 cid 的弹幕一次。
文档保证 vs. 实测观察
| 项目 | 状态 |
|---|---|
POST /v1/api/bilibili/web/one-video,参数 bv_id | 参考文档已列明 |
POST /v1/api/bilibili/app/video-comments,参数 bv_id/av_id、mode、整数 next_offset | 参考文档已列明 |
POST /v1/api/bilibili/web/comment-reply,参数 bv_id、rpid、pn | 参考文档已列明 |
POST /v1/api/bilibili/web/video-danmaku,参数 cid | 参考文档已列明 |
信封 id / status / model / outputs[0].data | 参考文档已列明 |
上游外壳 {code, data, message},以及 stat、aid、cid、owner、pages | 仅实测观察 |
评论 rpid、like、rcount、content.message,cursor.next / is_end | 仅实测观察 |
回复 page.count / num / size 和 root | 仅实测观察 |
弹幕以 XML 字符串返回,p 第一个值为播放秒数 | 仅实测观察 |
弹幕多的视频返回条数少于 stat.danmaku | 仅实测观察 |
web 版评论、回复接口偶发 count: 0 的空页 | 仅实测观察 |
常见用法
发布会反应复盘
对品牌官方的发布会视频,以及之后各家媒体的速览视频都跑一遍。对比评论主题,再把弹幕时间线和视频分段对齐。
- 输入:几个 BV 号
- 输出:每条视频一份反应记录
- 端点:全部四个
预告片、广告的高光时刻
弹幕带时间戳,评论没有。把弹幕按 10 秒或 30 秒分桶,看预告片哪几秒反应最强烈,再去读最密的几个桶里的弹幕原文。
- 输入:BV 号
- 输出:按秒分桶的直方图和弹幕样本
- 端点:
one-video、video-danmaku
挖掘常见问题
把一个产品所有教程、测评视频下带问号的评论收集起来做聚类,就能看出文档和客服还缺哪些答案。
- 输入:BV 号列表
- 输出:去重后的问题清单
- 端点:
app/video-comments
商单前的受众检查
谈合作之前,抽一下 UP 主近期视频的热评,看观众是在认真讨论内容,还是基本在玩梗。
- 输入:近期视频的 BV 号
- 输出:带点赞数的评论样本
- 端点:
one-video、app/video-comments
实用提示
- 拆两层。 先取
outputs[0].data(或output),再取 B站自己的data。 - 热评翻页用整数
cursor.next。 字符串形式的pagination_reply.next_offset会被参数校验拒掉。 - 空页重试一次。 web 版评论和回复接口返回
count: 0的空页,有时只是偶发。 - 回复数看
rcount, 不要看count。 - 弹幕按 XML 解析, 报总数之前先和
stat.danmaku对一下。 - 去掉身份信息。 丢掉
member、mid,弹幕p只留时间,回复里的回复 @昵称 :前缀也要去掉。 - 连接错误也要重试, 不只是 5xx。我有一次调用在 TLS 层断开,重试后成功。
- 只读公开数据。 不发评论,不点赞,不做审核。
常见问题
需要 B站账号或 Cookie 吗?
不需要。你用 SANDBASE_API_KEY 向 SandBase 鉴权,这几个只读端点不需要你这边登录 B站。
收费吗? 这四个端点目前在 SandBase 目录里标的是 Free,以目录页当前状态为准。
要先把 BV 号转成 aid 吗?
这条链路不用。one-video 会返回 aid 和 cid,评论端点直接接受 bv_id。如果别的端点需要 aid,可以用 bilibili/web/bv-to-aid。
弹幕接口会返回全部弹幕吗?
不一定。1,404 条弹幕的视频和 stat.danmaku 完全一致;弹幕 3,281 条的视频只返回了 1,200 条。
能按最新排序拉评论吗?
参考里 mode: 2 是按时间排序。本文用的是默认的热度排序(mode: 3)。
小结
一个 BV 号就能拿到 B站的两路反应信号:one-video 告诉你规模并给出 cid,app/video-comments 用整数游标翻页拉热评,comment-reply 打开争论最激烈的楼,video-danmaku 告诉你观众在哪几秒最想说话。记得拆两层、空页重试、把弹幕多的视频当样本看,就能得到一份可以交给模型归纳主题、问题和逐分钟时间线的记录。
其他 B站端点的用法,可以看 B站公开数据 API 总览。准备好了就可以开始: